Índice NGRAM (HQbird): busca por substring com LIKE '%...%' e CONTAINING
Um índice NGRAM encontra linhas por uma substring de um valor de texto, de modo que
WHERE col LIKE '%error 404%' não precisa ler a tabela inteira.
Ele usa n-gramas esparsos, o método de busca de código do GitHub
(a implementação segue o SereneDB).
Sintaxe
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Uma coluna
CHAR,VARCHARouBLOB SUB_TYPE TEXT, ou uma expressão com resultado de texto ou BLOB de texto. - Qualquer conjunto de caracteres e collation é permitido, também sem distinção de maiúsculas/minúsculas e de acentos
(
UNICODE_CI,UNICODE_CI_AI) e collations ICU (UNICODE,UTF8com um locale). - Um índice parcial (
WHERE) é usado apenas se a consulta tiver a mesma condição. - Não permitido:
UNIQUE,DESCENDING, várias colunas,CONCURRENTLY, BLOBs binários, arrays. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXfuncionam como de costume.SHOW INDEXimprimeNGRAM INDEX,isql -ximprimeCREATE NGRAM INDEX.- O ODS do banco de dados deve ser 13.1 (o padrão do Firebird 5).
Consultas que usam o índice
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- o padrão é um parâmetro
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- com um índice COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- veja "CONTAINING" abaixo
- O padrão deve ter uma parte literal de pelo menos 3 caracteres (entre
%e_). Um padrão constante sem essa parte não usa o índice. Um parâmetro sem essa parte gera uma varredura completa (o resultado continua correto). - O índice pode ser combinado com outros índices (
AND). - O
LIKEé sempre verificado novamente para cada linha encontrada, então o índice nunca altera o resultado de uma consulta. ORde váriosLIKEusa o índice para cada um deles.- Não usado para:
SIMILAR TO,STARTING WITH,=, intervalos,IS NULL,ORDER BY,MIN/MAX.
Collations
As chaves do índice são feitas da mesma forma canônica do texto que o LIKE compara.
Assim, com uma collation sem distinção de maiúsculas/minúsculas, o LIKE é sem distinção de maiúsculas/minúsculas, e o índice encontra
as mesmas linhas:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- encontra 'Café', 'CAFE', 'café'
A forma canônica das collations ICU depende da versão da ICU, como para índices comuns.
Após uma mudança da biblioteca ICU, reconstrua o índice
(ALTER INDEX ... INACTIVE, depois ACTIVE).
CONTAINING
col CONTAINING 'x' não diferencia maiúsculas/minúsculas. Ele usa um índice NGRAM em dois casos:
coléUTF8com uma collation Unicode sem distinção de maiúsculas/minúsculas (UNICODE_CI,UNICODE_CI_AI): um índice na própria coluna;- qualquer outra collation: um índice
COMPUTED BY (UPPER(col)). Escreva a consulta como de costume,col CONTAINING 'x': o otimizador encontra o índiceUPPERsozinho.
Não usado para conjuntos de caracteres multibyte diferentes de UTF8 e UNICODE_FSS
(por exemplo SJIS_0208) com suas collations padrão: ali o CONTAINING
compara bytes, não caracteres.
BLOBs de texto
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- usa note_body_up_ng
- O índice tem os gramas do BLOB inteiro, de qualquer tamanho. O servidor monta os gramas
em janelas de 64K caracteres e mantém apenas gramas distintos, então a memória para as chaves
depende do número de gramas distintos, não do tamanho do BLOB. Um BLOB em um conjunto de caracteres
multibyte é lido inteiro, como o
LIKEo lê. - O BLOB é lido quando uma linha é inserida, quando o BLOB é alterado, e mais uma vez
quando a coleta de lixo remove a versão antiga. Um
UPDATEde outras colunas mantém o mesmo BLOB e não o lê (também para um índiceCOMPUTED BY (UPPER(body))). - O índice tem uma entrada para cada grama distinto de uma linha. Documentos longos repetem muitos gramas: os arquivos-fonte do Firebird dão 0,3 entradas por caractere, linhas curtas 1,4.
- Carregue os dados primeiro, depois crie o índice (veja “Tamanho e custo”).
Saída do plano:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Tamanho e custo
Medido nas linhas do código-fonte do Firebird (953 000 linhas, 27 milhões de caracteres):
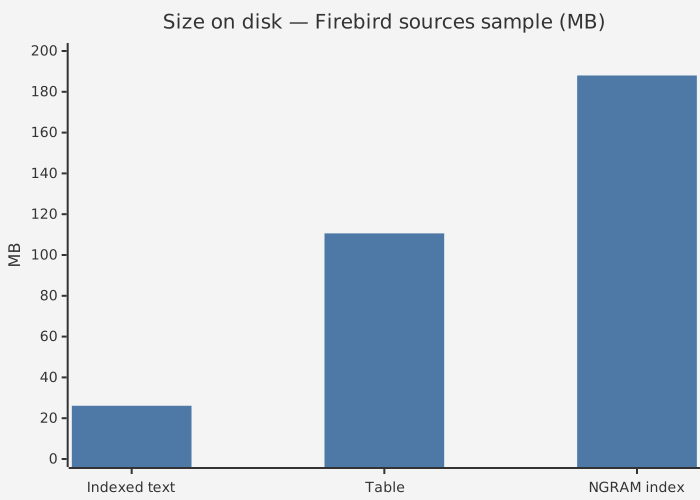
índice de 188 MB (7,2× o texto, 1,7× a tabela), criado em 16 s;
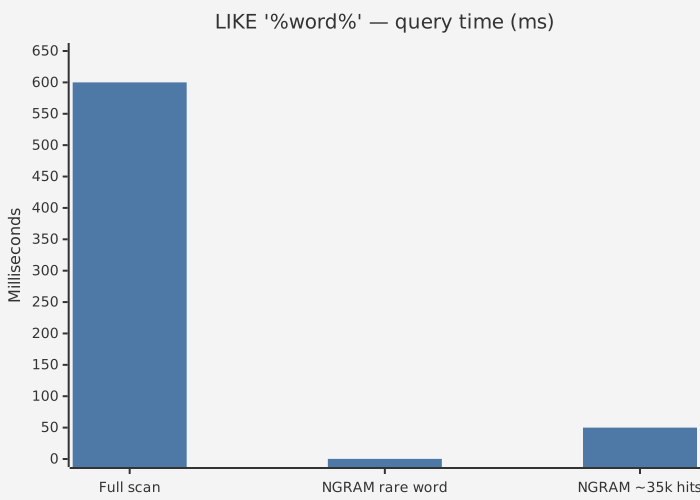
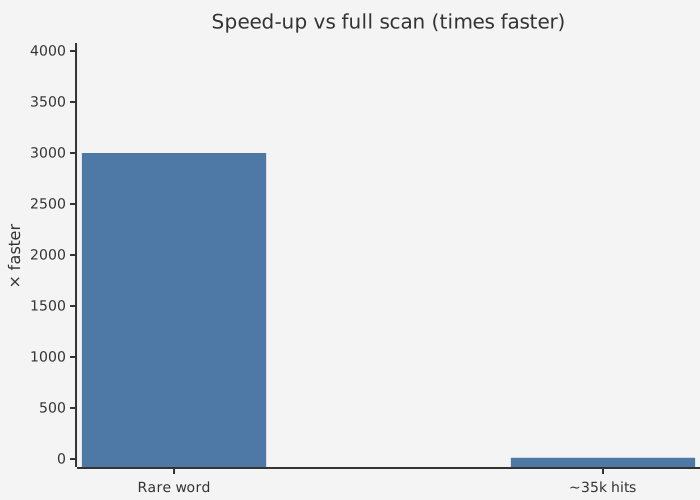
LIKE '%word%' de 12 a 4000 vezes mais rápido que uma varredura completa (de 0,2 ms para palavras raras
a 50 ms para uma palavra em 35 000 linhas, contra 600 ms da varredura).
Com UNICODE_CI_AI a varredura é 6 vezes mais lenta (3,5 s), o índice não:
LIKE e CONTAINING são de 20 a 8000 vezes mais rápidos.
Velocidade da consulta
| Caso | Tempo | vs varredura completa |
|---|---|---|
| Varredura completa da tabela | 600 ms | 1× |
| NGRAM, palavra rara | 0,2 ms | ~3000× |
| NGRAM, palavra em ~35 000 linhas | 50 ms | 12× |
Varredura completa com UNICODE_CI_AI |
3,5 s | só a varredura é 6× mais lenta |
Tamanho do índice
| Objeto | Tamanho | Relativo |
|---|---|---|
| Texto indexado | ~26,1 MB | 1× |
| Tabela | ~110,6 MB | ~4,2× o texto |
| Índice NGRAM | 188 MB | 7,2× o texto, 1,7× a tabela |
| Criação do índice | 16 s | — |
Custo de carga em massa
Para uma carga em massa, crie o índice após a carga, ou deixe-o INACTIVE durante a carga.
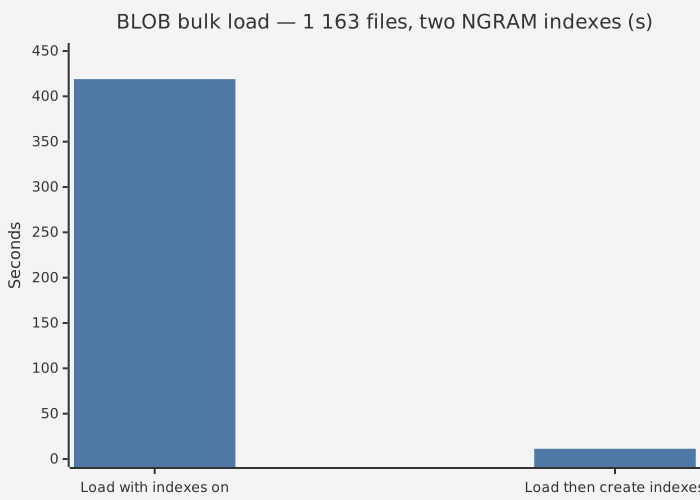
1 163 arquivos-fonte (28 milhões de caracteres) como BLOBs:
| Abordagem | Tempo |
|---|---|
| Carga com dois índices NGRAM ativos | 419 s |
| Carga sem índices, depois criar ambos | 0,6 s + 10,7 s = 11,3 s |
- Cerca de 1,4 entradas de índice por caractere de texto (cada entrada é um hash de gram de 8 bytes e um número de registro). Espere um índice várias vezes maior que o texto.
- Cada inserção adiciona cerca de 1,4 entradas de árvore B por caractere: inserções em uma tabela com índice NGRAM são muito mais lentas do que sem ele. O alvo são dados majoritariamente de acréscimo (logs, mensagens, documentos) com atualizações raras.
- Atualizações inserem apenas os novos grams. Os grams antigos são removidos pela coleta de lixo quando nenhuma versão de registro precisa mais deles.
- A criação do índice deixa 5% de espaço livre em cada página, como
CONCURRENTLYfaz. Os grams de um registro estão em muitas páginas-folha; sem espaço livre, as primeiras atualizações após a criação dividem quase todas as páginas-folha. - Um
UPDATEque não altera a coluna indexada (para um índice sobre uma expressão: as colunas que a expressão usa) não calcula grams de forma alguma. - A criação do índice ordena todos os grams: o espaço temporário é de cerca de 20 bytes por gram.
ParallelWorkersacelera a criação.
Compatibilidade com servidores sem suporte a NGRAM
O índice é armazenado em ODS 13.1. Sua condição (RDB$CONDITION_BLR) começa com uma expressão de guarda
que falha com um erro de conversão. Um servidor sem suporte a NGRAM
(Firebird 5.0.x padrão, HQbird mais antigo):
- abre o banco de dados;
SELECTdá resultados corretos e não usa o índice NGRAM; - recusa
INSERTeUPDATEna tabela com o erroconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(assim o índice nunca é corrompido); - permite
DELETEe sweep (o índice mantém entradas extras: apenas um custo de tamanho); - não consegue ativar o índice.
Testado com Firebird 5.0.4.1812 padrão e HQbird 5.0.4.1773.
Ferramentas de terceiros podem mostrar o índice como DESCENDING com uma cláusula WHERE.
O gbak faz backup e restauração de índices NGRAM (a restauração deve ser feita pelo HQbird com suporte a NGRAM).
Uma restauração padrão falha em um índice NGRAM em uma coluna BLOB (attempt to index BLOB column)
e deixa o banco de dados offline (gfix -online o coloca online sem esse índice).