NGRAM index (HQbird): vyhledávání podřetězců pomocí LIKE '%...%' a CONTAINING
NGRAM index nachází řádky podle podřetězce textové hodnoty, takže
WHERE col LIKE '%error 404%' nemusí procházet celou tabulku.
Používá sparse n-grams, metodu vyhledávání v kódu na GitHubu
(implementace vychází ze SereneDB).
Syntaxe
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Jeden sloupec
CHAR,VARCHARneboBLOB SUB_TYPE TEXT, nebo výraz s textovým výsledkem nebo výsledkem typu textový BLOB. - Povolena je jakákoli znaková sada a kolace, také kolace nerozlišující velikost písmen a diakritiku
(
UNICODE_CI,UNICODE_CI_AI) a kolace ICU (UNICODE,UTF8s locale). - Částečný index (
WHERE) se použije jen tehdy, pokud má dotaz stejnou podmínku. - Nejsou povoleny:
UNIQUE,DESCENDING, více sloupců,CONCURRENTLY, binární BLOBy, pole. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXfungují jako obvykle.SHOW INDEXvypíšeNGRAM INDEX,isql -xvypíšeCREATE NGRAM INDEX.- ODS databáze musí být 13.1 (výchozí pro Firebird 5).
Dotazy, které index používají
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- Vzor musí mít literální část o délce alespoň 3 znaky (mezi
%a_). Konstantní vzor bez takové části index nepoužije. Parametr bez takové části vede k úplnému procházení tabulky (výsledek je přesto správný). - Index lze kombinovat s jinými indexy (
AND). LIKEse pro každý nalezený řádek vždy znovu ověří, takže index nikdy nemění výsledek dotazu.ORněkolikaLIKEpoužije index pro každý z nich.- Nepoužívá se pro:
SIMILAR TO,STARTING WITH,=, rozsahy,IS NULL,ORDER BY,MIN/MAX.
Kolace
Klíče indexu jsou tvořeny ze stejné kanonické podoby textu, kterou porovnává LIKE.
Takže u kolace nerozlišující velikost písmen je LIKE nerozlišující velikost písmen a index najde
stejné řádky:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
Kanonická podoba kolací ICU závisí na verzi ICU, stejně jako u běžných
indexů. Po změně knihovny ICU index přestavte
(ALTER INDEX ... INACTIVE, poté ACTIVE).
CONTAINING
col CONTAINING 'x' nerozlišuje velikost písmen. NGRAM index použije ve dvou případech:
coljeUTF8s kolací Unicode nerozlišující velikost písmen (UNICODE_CI,UNICODE_CI_AI): index na samotném sloupci;- jakákoli jiná kolace: index
COMPUTED BY (UPPER(col)). Dotaz pište jako obvykle,col CONTAINING 'x': optimalizátor najde indexUPPERsám.
Nepoužívá se pro vícebajtové znakové sady jiné než UTF8 a UNICODE_FSS
(například SJIS_0208) s jejich výchozími kolacemi: tam CONTAINING
porovnává bajty, ne znaky.
Textové BLOBy
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- Index obsahuje gramy celého BLOBu libovolné délky. Server vytváří gramy
v oknech po 64K znacích a uchovává jen jedinečné gramy, takže paměť pro klíče
závisí na počtu jedinečných gramů, ne na velikosti BLOBu. BLOB ve vícebajtové
znakové sadě se čte celý, stejně jako ho čte
LIKE. - BLOB se čte při vložení řádku, při změně BLOBu a ještě jednou
při garbage collection, která odstraňuje starou verzi.
UPDATEjiných sloupců zachová stejný BLOB a nečte ho (také pro indexCOMPUTED BY (UPPER(body))). - Index má jednu položku pro každý jedinečný gram řádku. Dlouhé dokumenty mnoho gramů opakují: zdrojové soubory Firebirdu dávají 0,3 položky na znak, krátké řádky 1,4.
- Nejprve načtěte data, poté vytvořte index (viz „Velikost a náklady").
Výstup plánu:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Velikost a náklady
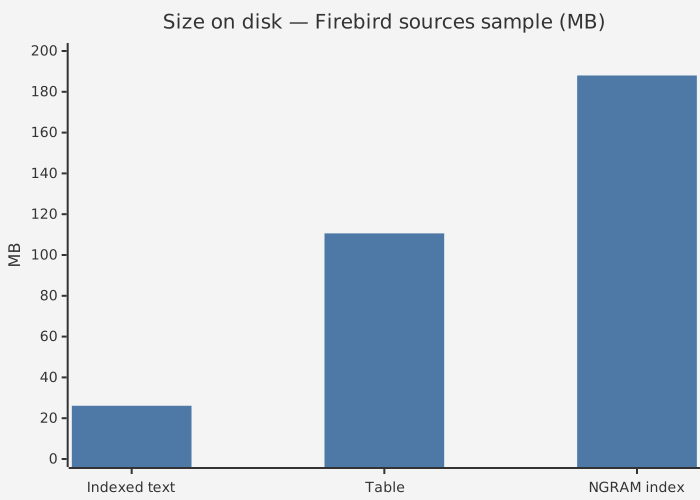
Měřeno na řádcích zdrojového kódu Firebirdu (953 000 řádků, 27 milionů znaků):
index 188 MB (7,2× text, 1,7× tabulka), vytvořen za 16 s;
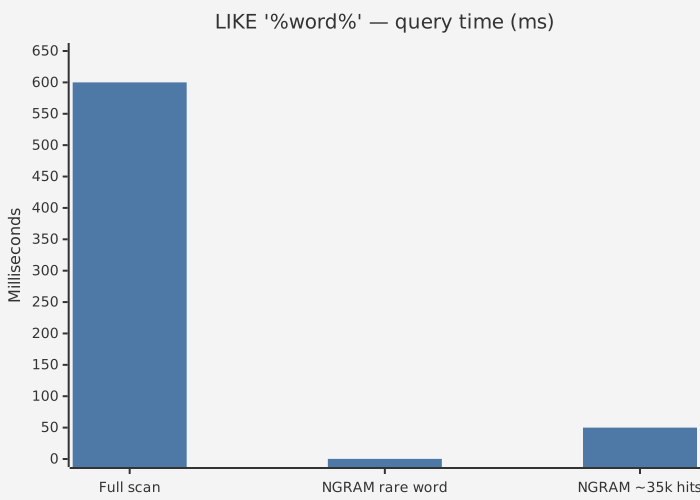
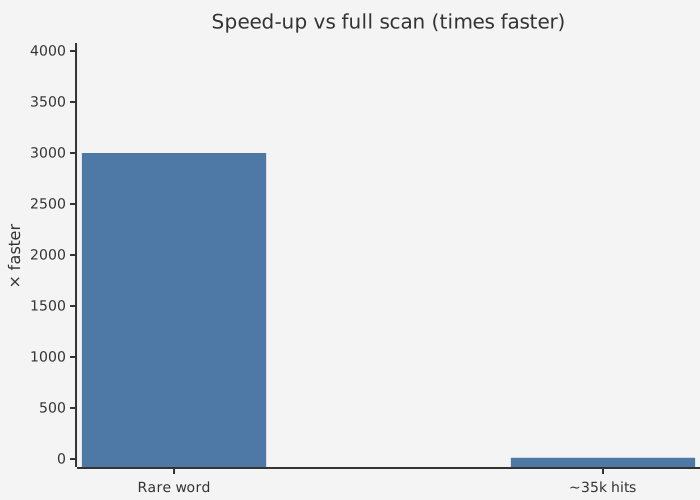
LIKE '%word%' 12 až 4000krát rychlejší než úplné procházení tabulky (od 0,2 ms pro vzácná slova
po 50 ms pro slovo ve 35 000 řádcích, oproti 600 ms pro procházení).
S UNICODE_CI_AI je procházení 6krát pomalejší (3,5 s), index ne:
LIKE a CONTAINING jsou 20 až 8000krát rychlejší.
- Přibližně 1,4 položky indexu na znak textu (každá položka je 8bajtový hash gramu a číslo záznamu). Očekávejte index několikrát větší než text.
- Každý insert přidá přibližně 1,4 položky B-stromu na znak: inserty do tabulky s NGRAM indexem jsou mnohem pomalejší než bez něj. Cílem jsou převážně doplňovaná data (logy, zprávy, dokumenty) se vzácnými aktualizacemi.
- Aktualizace vkládají jen nové gramy. Staré gramy odstraní garbage collection, jakmile je už žádná verze záznamu nepotřebuje.
- Vytvoření indexu ponechá v každé stránce 5 % volného místa, stejně jako
CONCURRENTLY. Gramy jednoho záznamu jsou v mnoha listových stránkách; bez volného místa první aktualizace po vytvoření rozdělí téměř každou listovou stránku. UPDATE, který nemění indexovaný sloupec (u indexu na výraz: sloupce, které výraz používá), gramy vůbec nepočítá.- Pro hromadné načtení vytvořte index až po načtení, nebo ho během načítání nastavte na
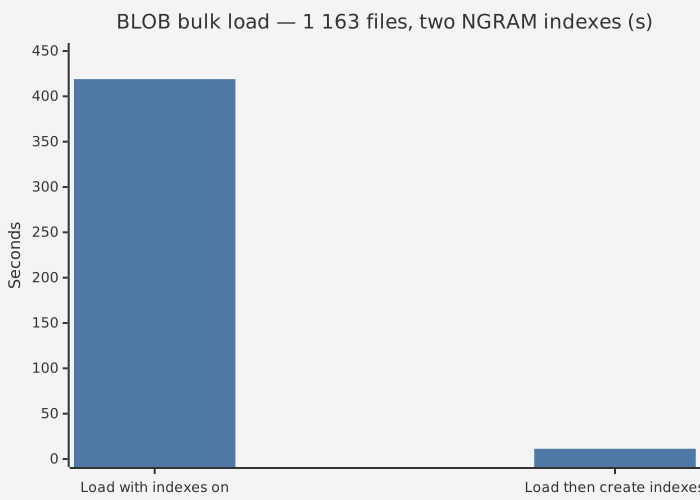
INACTIVE. 1 163 zdrojových souborů (28 milionů znaků) jako BLOBy: načtení se dvěma NGRAM indexy 419 s; načtení bez indexů 0,6 s, poté vytvoření obou indexů 10,7 s. - Vytvoření indexu třídí všechny gramy: dočasný prostor je přibližně 20 bajtů na gram.
ParallelWorkersvytvoření zrychlí.
Kompatibilita se servery bez podpory NGRAM
Index je uložen v ODS 13.1. Jeho podmínka (RDB$CONDITION_BLR) začíná ochranným
výrazem, který selže s chybou převodu. Server bez podpory NGRAM
(standardní Firebird 5.0.x, starší HQbird):
- otevře databázi;
SELECTdává správné výsledky a NGRAM index nepoužívá; - odmítne
INSERTaUPDATEdo tabulky s chybouconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(takže index se nikdy nepoškodí); - povolí
DELETEa sweep (index si ponechá nadbytečné položky: jde jen o náklad na velikost);
- nemůže index aktivovat.
Testováno se standardním Firebird 5.0.4.1812 a HQbird 5.0.4.1773.
Nástroje třetích stran mohou index zobrazovat jako DESCENDING s klauzulí WHERE.
gbak zálohuje a obnovuje NGRAM indexy (obnovu musí provést HQbird s podporou NGRAM).
Standardní obnova selže u NGRAM indexu na sloupci BLOB (attempt to index BLOB column)
a ponechá databázi offline (gfix -online ji přivede online bez tohoto indexu).