Index NGRAM (HQbird) : recherche de sous-chaînes avec LIKE '%...%' et CONTAINING
Un index NGRAM trouve des lignes par une sous-chaîne d’une valeur texte, de sorte que
WHERE col LIKE '%error 404%' n’a pas besoin de lire toute la table.
Il utilise des n-grammes creux, la méthode de la recherche de code GitHub
(l’implémentation suit SereneDB).
Syntaxe
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Une colonne
CHAR,VARCHARouBLOB SUB_TYPE TEXT, ou une expression dont le résultat est un texte ou un BLOB texte. - Tout jeu de caractères et tout collationnement sont autorisés, y compris insensibles à la casse et aux accents
(
UNICODE_CI,UNICODE_CI_AI) et les collationnements ICU (UNICODE,UTF8avec une locale). - Un index partiel (
WHERE) n’est utilisé que si la requête a la même condition. - Non autorisés :
UNIQUE,DESCENDING, plusieurs colonnes,CONCURRENTLY, les BLOB binaires, les tableaux. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXfonctionnent comme d’habitude.SHOW INDEXafficheNGRAM INDEX,isql -xafficheCREATE NGRAM INDEX.- L’ODS de la base de données doit être 13.1 (la valeur par défaut pour Firebird 5).
Requêtes qui utilisent l’index
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- Le motif doit avoir une partie littérale d’au moins 3 caractères (entre
%et_). Un motif constant sans une telle partie n’utilise pas l’index. Un paramètre sans une telle partie donne un balayage complet (le résultat reste correct). - L’index peut être combiné avec d’autres index (
AND). LIKEest toujours vérifié à nouveau pour chaque ligne trouvée, donc l’index ne change jamais le résultat d’une requête.ORde plusieursLIKEutilise l’index pour chacun d’eux.- Non utilisé pour :
SIMILAR TO,STARTING WITH,=, les plages,IS NULL,ORDER BY,MIN/MAX.
Collationnements
Les clés de l’index sont faites de la même forme canonique du texte que celle comparée par LIKE.
Ainsi, avec un collationnement insensible à la casse, LIKE est insensible à la casse, et l’index trouve
les mêmes lignes :
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
La forme canonique des collationnements ICU dépend de la version d’ICU, comme pour les index
ordinaires. Après un changement de la bibliothèque ICU, reconstruisez l’index
(ALTER INDEX ... INACTIVE, puis ACTIVE).
CONTAINING
col CONTAINING 'x' est insensible à la casse. Il utilise un index NGRAM dans deux cas :
colestUTF8avec un collationnement Unicode insensible à la casse (UNICODE_CI,UNICODE_CI_AI) : un index sur la colonne elle-même ;- tout autre collationnement : un index
COMPUTED BY (UPPER(col)). Écrivez la requête comme d’habitude,col CONTAINING 'x': l’optimiseur trouve lui-même l’indexUPPER.
Non utilisé pour les jeux de caractères multi-octets autres que UTF8 et UNICODE_FSS
(par exemple SJIS_0208) avec leurs collationnements par défaut : là, CONTAINING
compare des octets, pas des caractères.
BLOB texte
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- L’index contient les grammes du BLOB entier, de toute longueur. Le serveur fabrique les grammes
par fenêtres de 64K caractères et ne conserve que les grammes distincts, donc la mémoire pour les clés
dépend du nombre de grammes distincts, pas de la taille du BLOB. Un BLOB dans un jeu de caractères multi-octets
est lu en entier, comme
LIKEle lit. - Le BLOB est lu lors de l’insertion d’une ligne, lors de la modification du BLOB, et une fois de plus
lorsque le garbage collection supprime l’ancienne version. Un
UPDATEd’autres colonnes conserve le même BLOB et ne le lit pas (également pour un indexCOMPUTED BY (UPPER(body))). - L’index a une entrée pour chaque gramme distinct d’une ligne. Les documents longs répètent beaucoup de grammes : les fichiers source de Firebird donnent 0,3 entrée par caractère, les lignes courtes 1,4.
- Chargez d’abord les données, puis créez l’index (voir « Taille et coût »).
Sortie du plan :
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Taille et coût
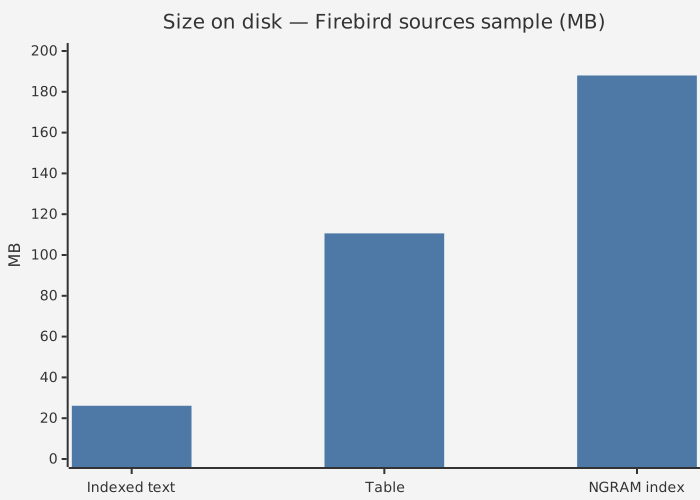
Mesuré sur les lignes du code source de Firebird (953 000 lignes, 27 millions de caractères) :
index de 188 Mo (7,2 x le texte, 1,7 x la table), construit en 16 s ;
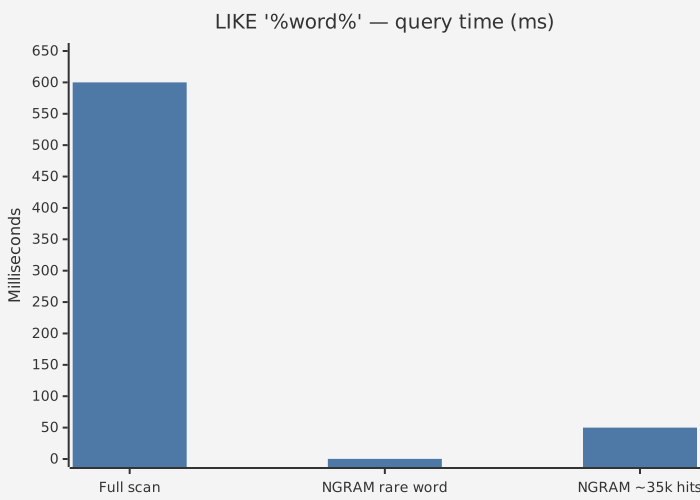
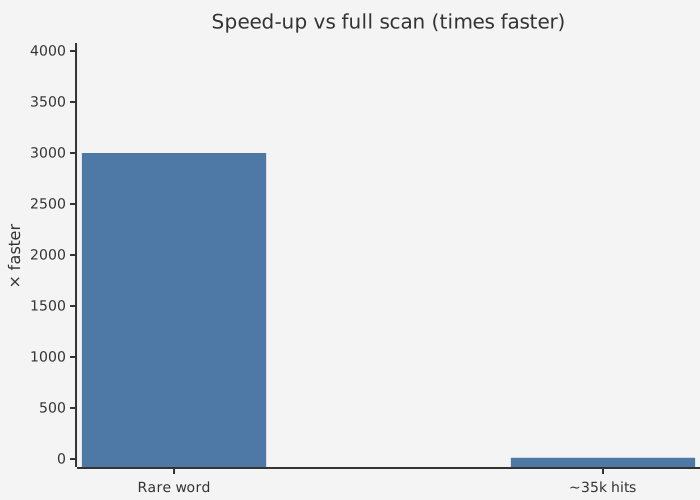
LIKE '%word%' de 12 à 4000 fois plus rapide qu’un balayage complet (de 0,2 ms pour les mots rares
à 50 ms pour un mot présent dans 35 000 lignes, contre 600 ms pour le balayage).
Avec UNICODE_CI_AI, le balayage est 6 fois plus lent (3,5 s), l’index non :
LIKE et CONTAINING sont de 20 à 8000 fois plus rapides.
- Environ 1,4 entrée d’index par caractère de texte (chaque entrée est un hachage de gramme de 8 octets et un numéro d’enregistrement). Attendez-vous à un index plusieurs fois plus gros que le texte.
- Chaque insertion ajoute environ 1,4 entrée B-tree par caractère : les insertions dans une table avec un index NGRAM sont bien plus lentes que sans lui. La cible est constituée de données principalement en ajout (journaux, messages, documents) avec de rares mises à jour.
- Les mises à jour n’insèrent que les nouveaux grammes. Les anciens grammes sont supprimés par le garbage collection lorsqu’aucune version d’enregistrement n’en a plus besoin.
- La création de l’index laisse 5 % d’espace libre dans chaque page, comme le fait
CONCURRENTLY. Les grammes d’un enregistrement sont répartis dans de nombreuses pages feuilles ; sans espace libre, les premières mises à jour après la création divisent presque toutes les pages feuilles. - Un
UPDATEqui ne modifie pas la colonne indexée (pour un index sur une expression : les colonnes utilisées par l’expression) ne calcule pas du tout de grammes. - Pour un chargement en masse, créez l’index après le chargement, ou rendez-le
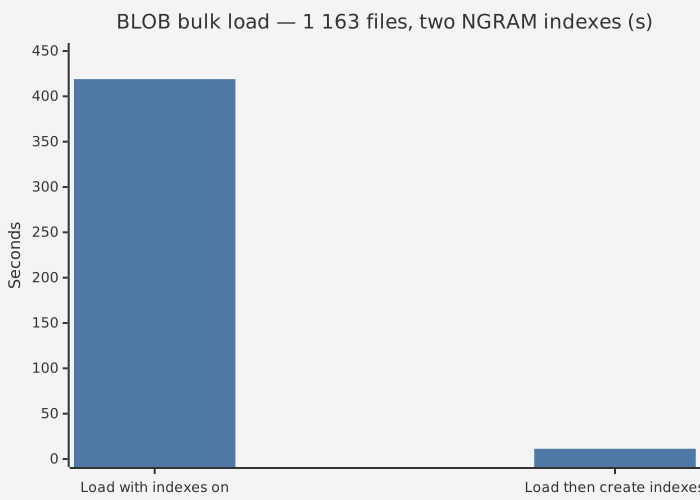
INACTIVEpendant le chargement. 1 163 fichiers source (28 millions de caractères) sous forme de BLOB : chargement avec deux index NGRAM 419 s ; chargement sans index 0,6 s, puis création des deux index 10,7 s. - La création de l’index trie tous les grammes : l’espace temporaire est d’environ 20 octets par gramme.
ParallelWorkersaccélère la création.
Compatibilité avec les serveurs sans prise en charge de NGRAM
L’index est stocké en ODS 13.1. Sa condition (RDB$CONDITION_BLR) commence par une expression de garde
qui échoue avec une erreur de conversion. Un serveur sans prise en charge de NGRAM
(Firebird 5.0.x standard, HQbird plus ancien) :
- ouvre la base de données ;
SELECTdonne des résultats corrects et n’utilise pas l’index NGRAM ; - refuse
INSERTetUPDATEdans la table avec l’erreurconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(ainsi l’index n’est jamais corrompu) ; - autorise
DELETEet le sweep (l’index conserve des entrées supplémentaires : seulement un coût en taille) ;
- ne peut pas activer l’index.
Testé avec Firebird 5.0.4.1812 standard et HQbird 5.0.4.1773.
Les outils tiers peuvent afficher l’index comme DESCENDING avec une clause WHERE.
gbak sauvegarde et restaure les index NGRAM (la restauration doit être effectuée par HQbird avec prise en charge de NGRAM).
Une restauration standard échoue sur un index NGRAM sur une colonne BLOB (attempt to index BLOB column)
et laisse la base de données hors ligne (gfix -online la remet en ligne sans cet index).