Indeks NGRAM (HQbird): wyszukiwanie podciągów za pomocą LIKE '%...%' i CONTAINING
Indeks NGRAM znajduje wiersze po podciągu wartości tekstowej, dzięki czemu
WHERE col LIKE '%error 404%' nie musi czytać całej tabeli.
Wykorzystuje rzadkie n-gramy, metodę wyszukiwania kodu GitHub
(implementacja zgodna z SereneDB).
Składnia
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Jedna kolumna
CHAR,VARCHARlubBLOB SUB_TYPE TEXT, albo wyrażenie z wynikiem tekstowym lub tekstowym BLOB. - Dozwolony jest każdy zestaw znaków i sortowanie, także nieczułe na wielkość liter i akcenty
(
UNICODE_CI,UNICODE_CI_AI) oraz sortowania ICU (UNICODE,UTF8z lokalizacją). - Indeks częściowy (
WHERE) jest używany tylko wtedy, gdy zapytanie ma ten sam warunek. - Niedozwolone:
UNIQUE,DESCENDING, kilka kolumn,CONCURRENTLY, binarne BLOBy, tablice. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXdziałają jak zwykle.SHOW INDEXwyświetlaNGRAM INDEX,isql -xwyświetlaCREATE NGRAM INDEX.- ODS bazy danych musi być 13.1 (domyślny dla Firebird 5).
Zapytania, które używają indeksu
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- Wzorzec musi mieć część literalną o długości co najmniej 3 znaków (między
%a_). Stały wzorzec bez takiej części nie używa indeksu. Parametr bez takiej części powoduje pełne skanowanie (wynik jest nadal poprawny). - Indeks można łączyć z innymi indeksami (
AND). LIKEjest zawsze sprawdzany ponownie dla każdego znalezionego wiersza, więc indeks nigdy nie zmienia wyniku zapytania.ORkilkuLIKEużywa indeksu dla każdego z nich.- Nieużywany dla:
SIMILAR TO,STARTING WITH,=, zakresów,IS NULL,ORDER BY,MIN/MAX.
Sortowania
Klucze indeksu są tworzone z tej samej formy kanonicznej tekstu, którą porównuje LIKE.
Zatem przy sortowaniu nieczułym na wielkość liter LIKE jest nieczuły na wielkość liter, a indeks znajduje
te same wiersze:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
Forma kanoniczna sortowań ICU zależy od wersji ICU, tak jak dla zwykłych
indeksów. Po zmianie biblioteki ICU przebuduj indeks
(ALTER INDEX ... INACTIVE, następnie ACTIVE).
CONTAINING
col CONTAINING 'x' jest nieczułe na wielkość liter. Używa indeksu NGRAM w dwóch przypadkach:
coltoUTF8z nieczułym na wielkość liter sortowaniem Unicode (UNICODE_CI,UNICODE_CI_AI): indeks na samej kolumnie;- dowolne inne sortowanie: indeks
COMPUTED BY (UPPER(col)). Zapisz zapytanie jak zwykle,col CONTAINING 'x': optymalizator sam znajduje indeksUPPER.
Nieużywany dla wielobajtowych zestawów znaków innych niż UTF8 i UNICODE_FSS
(na przykład SJIS_0208) z ich domyślnymi sortowaniami: tam CONTAINING
porównuje bajty, a nie znaki.
Tekstowe BLOBy
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- Indeks zawiera gramy całego BLOBa, o dowolnej długości. Serwer tworzy gramy
w oknach po 64K znaków i zachowuje tylko różne gramy, więc pamięć na klucze
zależy od liczby różnych gramów, a nie od rozmiaru BLOBa. BLOB w wielobajtowym
zestawie znaków jest czytany w całości, tak jak czyta go
LIKE. - BLOB jest czytany przy wstawianiu wiersza, przy zmianie BLOBa i jeszcze raz
gdy garbage collection usuwa starą wersję.
UPDATEinnych kolumn zachowuje ten sam BLOB i nie czyta go (także dla indeksuCOMPUTED BY (UPPER(body))). - Indeks ma jeden wpis dla każdego różnego gramu wiersza. Długie dokumenty powtarzają wiele gramów: pliki źródłowe Firebirda dają 0,3 wpisu na znak, krótkie linie 1,4.
- Najpierw wczytaj dane, potem utwórz indeks (patrz „Rozmiar i koszt”).
Wynik planu:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Rozmiar i koszt
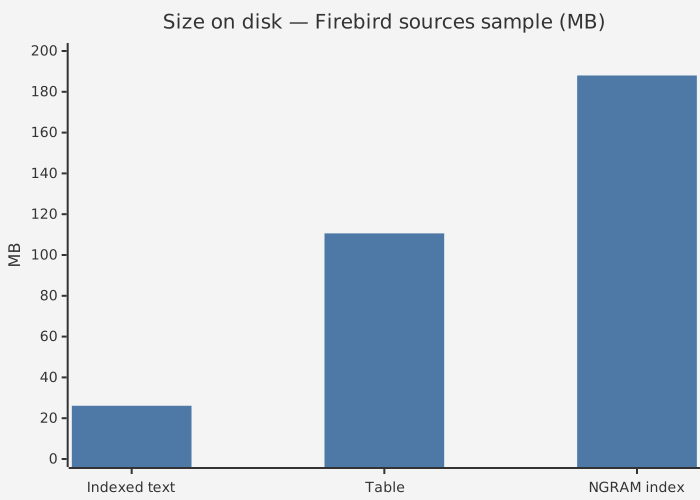
Zmierzone na liniach kodu źródłowego Firebirda (953 000 wierszy, 27 milionów znaków):
indeks 188 MB (7,2 x tekst, 1,7 x tabela), zbudowany w 16 s;
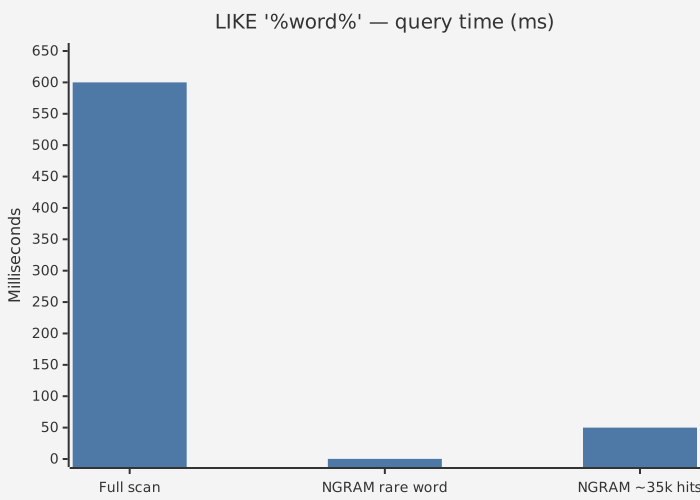
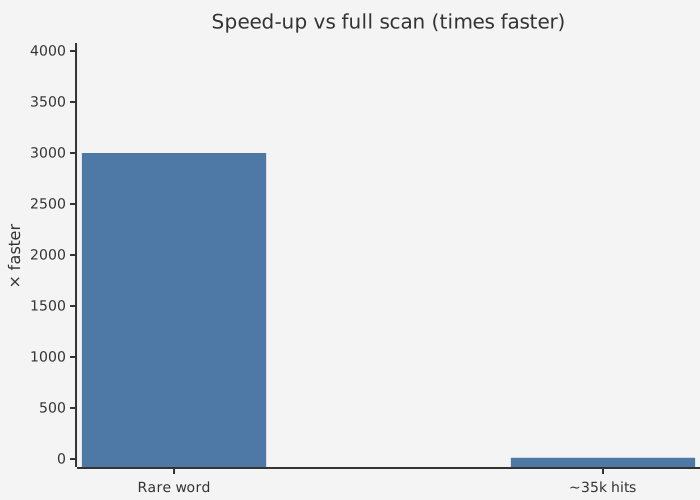
LIKE '%word%' od 12 do 4000 razy szybciej niż pełne skanowanie (od 0,2 ms dla rzadkich słów
do 50 ms dla słowa w 35 000 wierszy, wobec 600 ms dla skanowania).
Przy UNICODE_CI_AI skanowanie jest 6 razy wolniejsze (3,5 s), indeks nie:
LIKE i CONTAINING są od 20 do 8000 razy szybsze.
- Około 1,4 wpisu indeksu na znak tekstu (każdy wpis to 8-bajtowy hash gramu i numer rekordu). Spodziewaj się indeksu kilkakrotnie większego niż tekst.
- Każde wstawienie dodaje około 1,4 wpisów drzewa B na znak: wstawianie do tabeli z indeksem NGRAM jest znacznie wolniejsze niż bez niego. Przeznaczeniem są dane głównie dopisywane (logi, komunikaty, dokumenty) z rzadkimi aktualizacjami.
- Aktualizacje wstawiają tylko nowe gramy. Stare gramy są usuwane przez garbage collection, gdy żadna wersja rekordu ich już nie potrzebuje.
- Tworzenie indeksu pozostawia 5% wolnego miejsca na każdej stronie, tak jak
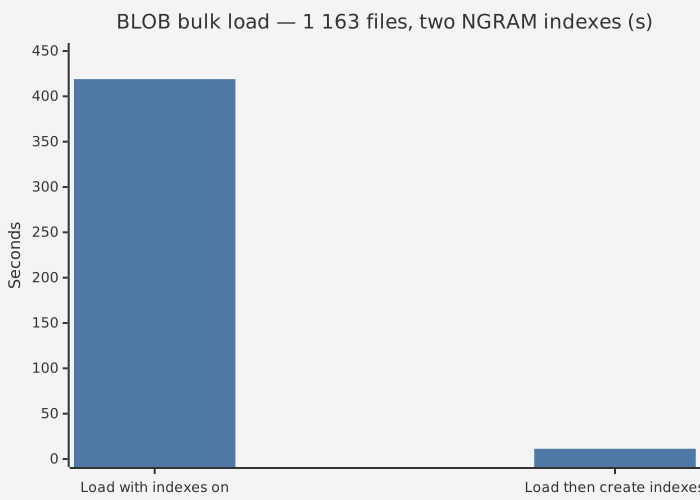
CONCURRENTLY. Gramy jednego rekordu są w wielu stronach liści; bez wolnego miejsca pierwsze aktualizacje po utworzeniu dzielą prawie każdą stronę liścia. UPDATE, który nie zmienia indeksowanej kolumny (dla indeksu na wyrażeniu: kolumn używanych przez wyrażenie), w ogóle nie oblicza gramów.- Przy ładowaniu zbiorczym utwórz indeks po załadowaniu albo ustaw go jako
INACTIVEpodczas ładowania. 1 163 plików źródłowych (28 milionów znaków) jako BLOBy: ładowanie z dwoma indeksami NGRAM 419 s; ładowanie bez indeksów 0,6 s, następnie utworzenie obu indeksów 10,7 s. - Tworzenie indeksu sortuje wszystkie gramy: miejsce tymczasowe to około 20 bajtów na gram.
ParallelWorkersprzyspiesza tworzenie.
Zgodność z serwerami bez obsługi NGRAM
Indeks jest przechowywany w ODS 13.1. Jego warunek (RDB$CONDITION_BLR) zaczyna się od wyrażenia strażnika,
które kończy się błędem konwersji. Serwer bez obsługi NGRAM
(standardowy Firebird 5.0.x, starszy HQbird):
- otwiera bazę danych;
SELECTdaje poprawne wyniki i nie używa indeksu NGRAM; - odrzuca
INSERTiUPDATEdo tabeli z błędemconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(więc indeks nigdy nie ulega uszkodzeniu); - pozwala na
DELETEi sweep (indeks zachowuje dodatkowe wpisy: to tylko koszt rozmiaru);
- nie może aktywować indeksu.
Testowane ze standardowym Firebird 5.0.4.1812 i HQbird 5.0.4.1773.
Narzędzia firm trzecich mogą pokazywać indeks jako DESCENDING z klauzulą WHERE.
gbak tworzy kopię zapasową i przywraca indeksy NGRAM (przywracanie musi być wykonane przez HQbird z obsługą NGRAM).
Standardowe przywracanie kończy się niepowodzeniem na indeksie NGRAM na kolumnie BLOB (attempt to index BLOB column)
i pozostawia bazę danych offline (gfix -online przywraca ją online bez tego indeksu).