Індекс NGRAM (HQbird): пошук підрядка за допомогою LIKE '%...%' і CONTAINING
Індекс NGRAM знаходить рядки за підрядком текстового значення, тож
WHERE col LIKE '%error 404%' не потребує читання всієї таблиці.
Він використовує розріджені n-грами, метод пошуку коду GitHub
(реалізація наслідує SereneDB).
Синтаксис
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Один стовпець
CHAR,VARCHARабоBLOB SUB_TYPE TEXT, або вираз із текстовим результатом чи результатом у вигляді текстового BLOB. - Дозволено будь-який набір символів і будь-яке сортування, також нечутливі до регістру та діакритики
(
UNICODE_CI,UNICODE_CI_AI) та сортування ICU (UNICODE,UTF8з локаллю). - Частковий індекс (
WHERE) використовується, лише якщо запит має ту саму умову. - Не дозволено:
UNIQUE,DESCENDING, кілька стовпців,CONCURRENTLY, бінарні BLOB, масиви. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXпрацюють як зазвичай.SHOW INDEXвиводитьNGRAM INDEX,isql -xвиводитьCREATE NGRAM INDEX.- ODS бази даних має бути 13.1 (типове значення для Firebird 5).
Запити, що використовують індекс
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- Шаблон повинен мати буквальну частину щонайменше з 3 символів (між
%і_). Постійний шаблон без такої частини не використовує індекс. Параметр без такої частини дає повне сканування (результат усе одно правильний). - Індекс можна поєднувати з іншими індексами (
AND). LIKEзавжди перевіряється повторно для кожного знайденого рядка, тож індекс ніколи не змінює результат запиту.ORкількохLIKEвикористовує індекс для кожного з них.- Не використовується для:
SIMILAR TO,STARTING WITH,=, діапазонів,IS NULL,ORDER BY,MIN/MAX.
Сортування
Ключі індексу складаються з тієї самої канонічної форми тексту, яку порівнює LIKE.
Тож із сортуванням, нечутливим до регістру, LIKE нечутливий до регістру, і індекс знаходить
ті самі рядки:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
Канонічна форма сортувань ICU залежить від версії ICU, як і для звичайних
індексів. Після зміни бібліотеки ICU перебудуйте індекс
(ALTER INDEX ... INACTIVE, потім ACTIVE).
CONTAINING
col CONTAINING 'x' нечутливий до регістру. Він використовує індекс NGRAM у двох випадках:
colмає типUTF8із нечутливим до регістру сортуванням Unicode (UNICODE_CI,UNICODE_CI_AI): індекс на самому стовпці;- будь-яке інше сортування: індекс
COMPUTED BY (UPPER(col)). Запит пишеться як зазвичай,col CONTAINING 'x': оптимізатор сам знаходить індексUPPER.
Не використовується для багатобайтових наборів символів, відмінних від UTF8 і UNICODE_FSS
(наприклад, SJIS_0208), з їхніми типовими сортуваннями: там CONTAINING
порівнює байти, а не символи.
Текстові BLOB
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- Індекс містить грами всього BLOB, будь-якої довжини. Сервер формує грами
вікнами по 64K символів і зберігає лише різні грами, тож пам’ять для ключів
залежить від кількості різних грамів, а не від розміру BLOB. BLOB у багатобайтовому
наборі символів читається повністю, як його читає
LIKE. - BLOB читається під час вставлення рядка, під час зміни BLOB і ще раз,
коли збирання сміття видаляє стару версію.
UPDATEінших стовпців зберігає той самий BLOB і не читає його (також для індексуCOMPUTED BY (UPPER(body))). - Індекс має один запис для кожного різного граму рядка. Довгі документи повторюють багато грамів: вихідні файли Firebird дають 0.3 запису на символ, короткі рядки — 1.4.
- Спершу завантажте дані, потім створіть індекс (див. «Розмір і вартість»).
Вивід плану:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Розмір і вартість
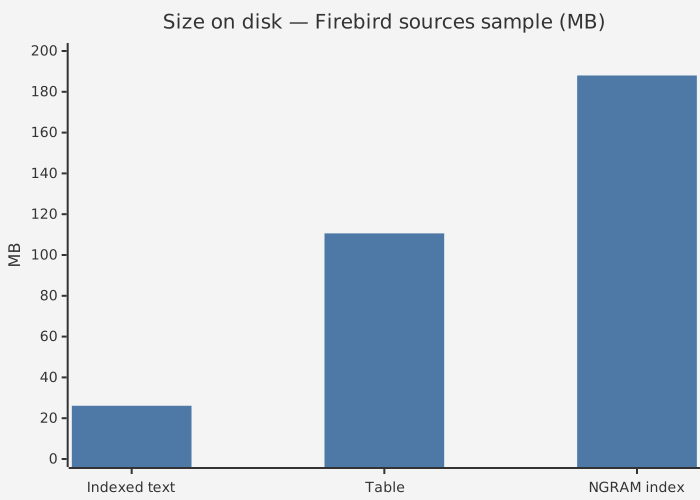
Виміряно на рядках вихідного коду Firebird (953 000 рядків, 27 мільйонів символів):
індекс 188 МБ (7.2 x текст, 1.7 x таблиця), створений за 16 с;
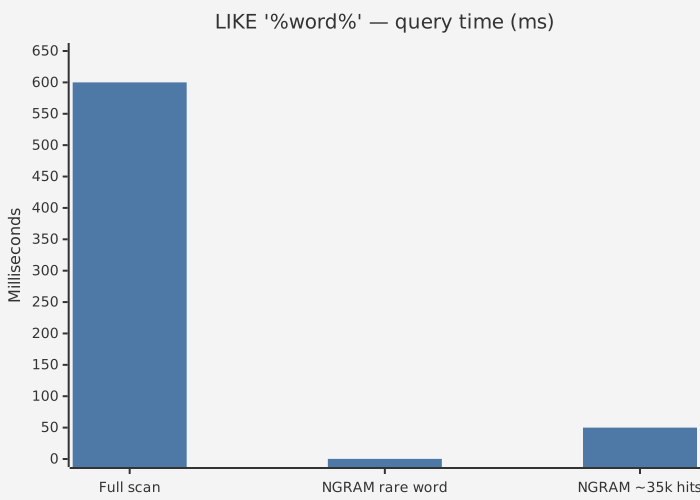
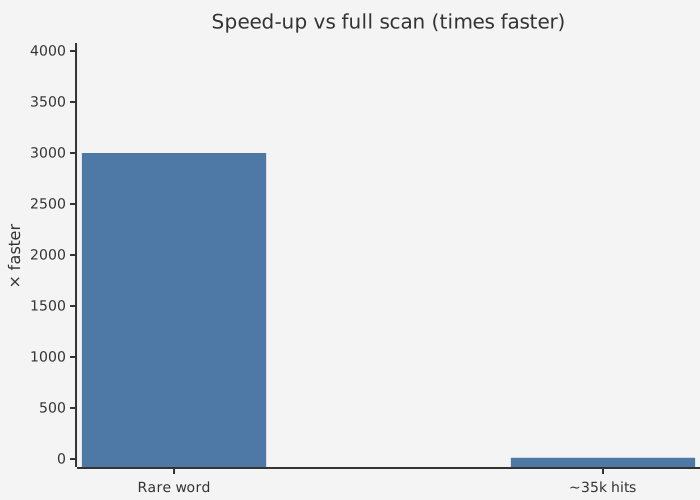
LIKE '%word%' від 12 до 4000 разів швидше за повне сканування (від 0.2 мс для рідкісних слів
до 50 мс для слова в 35 000 рядках, проти 600 мс для сканування).
З UNICODE_CI_AI сканування в 6 разів повільніше (3.5 с), а індекс — ні:
LIKE і CONTAINING від 20 до 8000 разів швидше.
- Приблизно 1.4 запису індексу на символ тексту (кожен запис — це 8-байтовий хеш граму і номер запису). Очікуйте індекс у кілька разів більший за текст.
- Кожне вставлення додає близько 1.4 записів B-дерева на символ: вставлення в таблицю з індексом NGRAM набагато повільніші, ніж без нього. Цільове призначення — переважно дописувані дані (журнали, повідомлення, документи) з рідкісними оновленнями.
- Оновлення вставляють лише нові грами. Старі грами видаляються збиранням сміття, коли жодна версія запису їх більше не потребує.
- Створення індексу залишає 5% вільного місця на кожній сторінці, як це робить
CONCURRENTLY. Грами одного запису розміщені в багатьох листових сторінках; без вільного місця перші оновлення після створення розщеплюють майже кожну листову сторінку. UPDATE, що не змінює індексований стовпець (для індексу на виразі: стовпці, які використовує вираз), взагалі не обчислює грами.- Для масового завантаження створіть індекс після завантаження або зробіть його
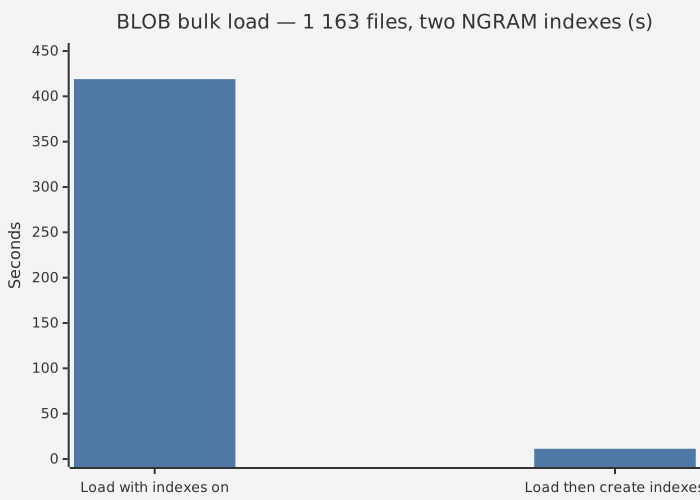
INACTIVEпід час завантаження. 1 163 вихідні файли (28 мільйонів символів) як BLOB: завантаження з двома індексами NGRAM — 419 с; завантаження без індексів — 0.6 с, потім створення обох індексів — 10.7 с. - Створення індексу сортує всі грами: тимчасовий простір — близько 20 байтів на грам.
ParallelWorkersприскорює створення.
Сумісність із серверами без підтримки NGRAM
Індекс зберігається в ODS 13.1. Його умова (RDB$CONDITION_BLR) починається з вартового
виразу, який завершується помилкою перетворення. Сервер без підтримки NGRAM
(стандартний Firebird 5.0.x, старіший HQbird):
- відкриває базу даних;
SELECTдає правильні результати й не використовує індекс NGRAM; - відхиляє
INSERTіUPDATEу таблицю з помилкоюconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(тож індекс ніколи не пошкоджується); - дозволяє
DELETEі sweep (індекс зберігає зайві записи: це лише витрати на розмір);
- не може активувати індекс.
Перевірено зі стандартним Firebird 5.0.4.1812 і HQbird 5.0.4.1773.
Сторонні інструменти можуть показувати індекс як DESCENDING з умовою WHERE.
gbak створює резервні копії та відновлює індекси NGRAM (відновлення має виконувати HQbird з підтримкою NGRAM).
Стандартне відновлення завершується помилкою на індексі NGRAM на стовпці BLOB (attempt to index BLOB column)
і залишає базу даних офлайн (gfix -online повертає її онлайн без цього індексу).