Índice NGRAM (HQbird): búsqueda de subcadenas con LIKE '%...%' y CONTAINING
Un índice NGRAM encuentra filas por una subcadena de un valor de texto, de modo que
WHERE col LIKE '%error 404%' no necesita leer toda la tabla.
Utiliza n-gramas dispersos, el método de búsqueda de código de GitHub
(la implementación sigue a SereneDB).
Sintaxis
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Una columna
CHAR,VARCHARoBLOB SUB_TYPE TEXT, o una expresión con un resultado de texto o BLOB de texto. - Se permite cualquier conjunto de caracteres y colación, también insensible a mayúsculas y acentos
(
UNICODE_CI,UNICODE_CI_AI) y colaciones ICU (UNICODE,UTF8con una configuración regional). - Un índice parcial (
WHERE) se usa solo si la consulta tiene la misma condición. - No permitido:
UNIQUE,DESCENDING, varias columnas,CONCURRENTLY, BLOB binarios, arrays. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXfuncionan como de costumbre.SHOW INDEXimprimeNGRAM INDEX,isql -ximprimeCREATE NGRAM INDEX.- El ODS de la base de datos debe ser 13.1 (el predeterminado para Firebird 5).
Consultas que usan el índice
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- El patrón debe tener una parte literal de al menos 3 caracteres (entre
%y_). Un patrón constante sin tal parte no usa el índice. Un parámetro sin tal parte da un escaneo completo (el resultado sigue siendo correcto). - El índice se puede combinar con otros índices (
AND). LIKEse verifica siempre de nuevo para cada fila encontrada, por lo que el índice nunca cambia el resultado de una consulta.ORde variosLIKEusa el índice para cada uno de ellos.- No se usa para:
SIMILAR TO,STARTING WITH,=, rangos,IS NULL,ORDER BY,MIN/MAX.
Colaciones
Las claves del índice se componen de la misma forma canónica del texto que compara LIKE.
Así, con una colación insensible a mayúsculas LIKE es insensible a mayúsculas, y el índice encuentra
las mismas filas:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
La forma canónica de las colaciones ICU depende de la versión de ICU, como para los índices
ordinarios. Tras un cambio de la biblioteca ICU, reconstruya el índice
(ALTER INDEX ... INACTIVE, luego ACTIVE).
CONTAINING
col CONTAINING 'x' es insensible a mayúsculas. Usa un índice NGRAM en dos casos:
colesUTF8con una colación Unicode insensible a mayúsculas (UNICODE_CI,UNICODE_CI_AI): un índice sobre la propia columna;- cualquier otra colación: un índice
COMPUTED BY (UPPER(col)). Escriba la consulta como de costumbre,col CONTAINING 'x': el optimizador encuentra el índiceUPPERpor sí mismo.
No se usa para conjuntos de caracteres multibyte distintos de UTF8 y UNICODE_FSS
(por ejemplo SJIS_0208) con sus colaciones predeterminadas: allí CONTAINING
compara bytes, no caracteres.
BLOB de texto
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- El índice tiene los gramas de todo el BLOB, de cualquier longitud. El servidor genera los gramas
en ventanas de 64K caracteres y conserva solo los gramas distintos, por lo que la memoria para las claves
depende del número de gramas distintos, no del tamaño del BLOB. Un BLOB en un conjunto de caracteres
multibyte se lee entero, como lo lee
LIKE. - El BLOB se lee cuando se inserta una fila, cuando se modifica el BLOB, y una vez más
cuando la recolección de basura elimina la versión antigua. Un
UPDATEde otras columnas conserva el mismo BLOB y no lo lee (también para un índiceCOMPUTED BY (UPPER(body))). - El índice tiene una entrada por cada grama distinto de una fila. Los documentos largos repiten muchos gramas: los archivos fuente de Firebird dan 0.3 entradas por carácter, las líneas cortas 1.4.
- Cargue primero los datos, luego cree el índice (véase “Tamaño y costo”).
Salida del plan:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Tamaño y costo
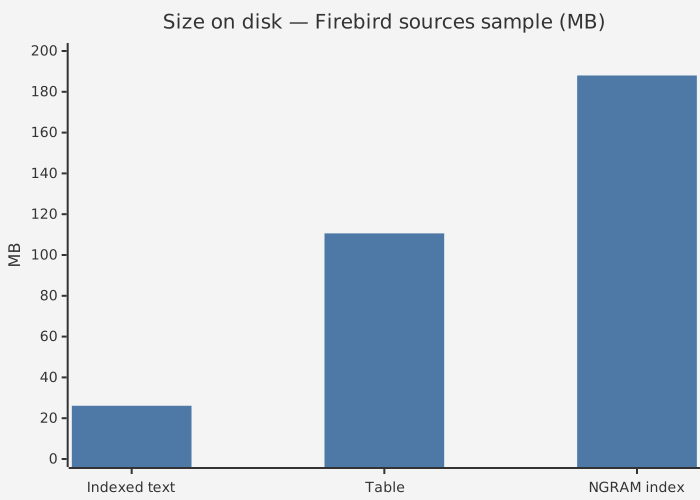
Medido en las líneas del código fuente de Firebird (953 000 filas, 27 millones de caracteres):
índice de 188 MB (7.2 x el texto, 1.7 x la tabla), creado en 16 s;
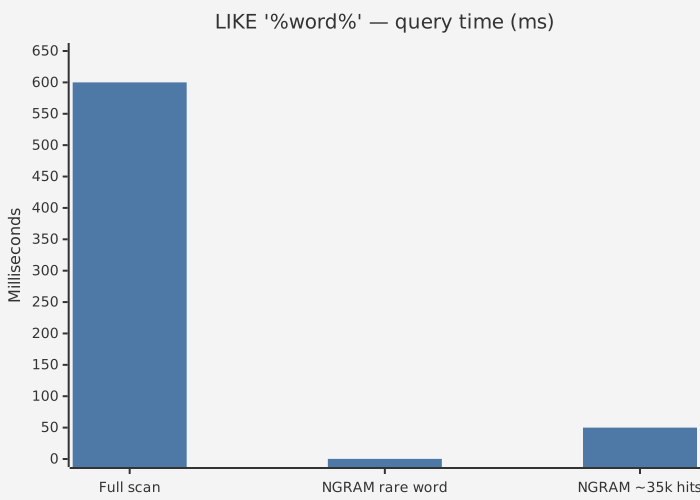
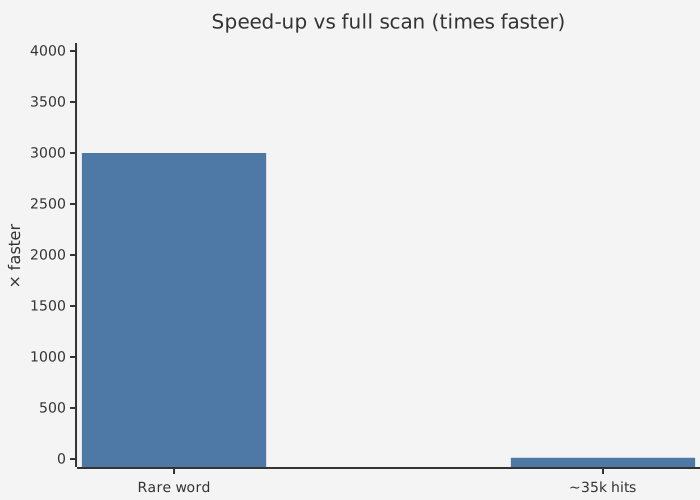
LIKE '%word%' de 12 a 4000 veces más rápido que un escaneo completo (desde 0.2 ms para palabras raras
hasta 50 ms para una palabra en 35 000 filas, frente a 600 ms para el escaneo).
Con UNICODE_CI_AI el escaneo es 6 veces más lento (3.5 s), el índice no:
LIKE y CONTAINING son de 20 a 8000 veces más rápidos.
- Aproximadamente 1.4 entradas de índice por carácter de texto (cada entrada es un hash de grama de 8 bytes y un número de registro). Espere un índice varias veces más grande que el texto.
- Cada inserción añade aproximadamente 1.4 entradas de árbol B por carácter: las inserciones en una tabla con un índice NGRAM son mucho más lentas que sin él. El objetivo son datos mayormente de adición (logs, mensajes, documentos) con actualizaciones raras.
- Las actualizaciones insertan solo los gramas nuevos. Los gramas antiguos se eliminan mediante la recolección de basura cuando ninguna versión de registro los necesita ya.
- La creación del índice deja 5% de espacio libre en cada página, como lo hace
CONCURRENTLY. Los gramas de un registro están en muchas páginas hoja; sin espacio libre las primeras actualizaciones tras la creación dividen casi todas las páginas hoja. - Un
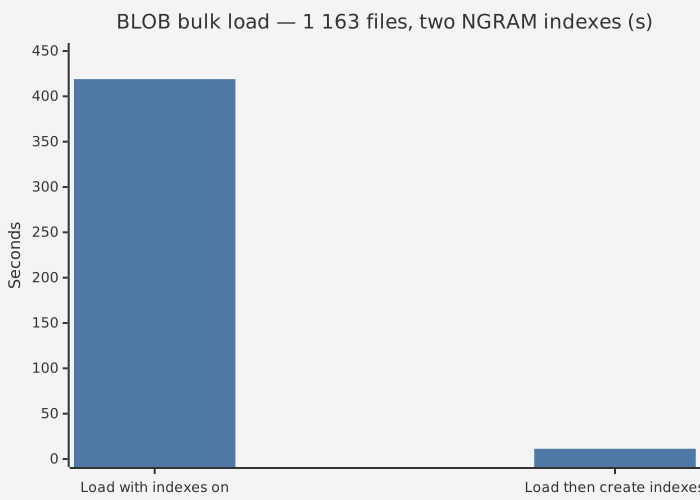
UPDATEque no cambia la columna indexada (para un índice sobre una expresión: las columnas que usa la expresión) no calcula gramas en absoluto. - Para una carga masiva, cree el índice después de la carga, o hágalo
INACTIVEdurante la carga. 1 163 archivos fuente (28 millones de caracteres) como BLOB: carga con dos índices NGRAM 419 s; carga sin índices 0.6 s, luego creación de ambos índices 10.7 s. - La creación del índice ordena todos los gramas: el espacio temporal es de aproximadamente 20 bytes por grama.
ParallelWorkersacelera la creación.
Compatibilidad con servidores sin soporte NGRAM
El índice se almacena en ODS 13.1. Su condición (RDB$CONDITION_BLR) comienza con una expresión de guarda
que falla con un error de conversión. Un servidor sin soporte NGRAM
(Firebird 5.0.x estándar, HQbird anterior):
- abre la base de datos;
SELECTda resultados correctos y no usa el índice NGRAM; - rechaza
INSERTyUPDATEen la tabla con el errorconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(así el índice nunca se corrompe); - permite
DELETEy sweep (el índice conserva entradas extra: solo un costo de tamaño);
- no puede activar el índice.
Probado con Firebird 5.0.4.1812 estándar y HQbird 5.0.4.1773.
Herramientas de terceros pueden mostrar el índice como DESCENDING con una cláusula WHERE.
gbak hace copia de seguridad y restaura índices NGRAM (la restauración debe hacerse con HQbird con soporte NGRAM).
Una restauración estándar falla en un índice NGRAM sobre una columna BLOB (attempt to index BLOB column)
y deja la base de datos fuera de línea (gfix -online la pone en línea sin ese índice).