HQbird レプリケーションクラスタのガイド
HQbird レプリケーションクラスタの管理者ガイド:hqclusternode と hqbirdrcm(RCM)。インストーラ:HQbird 2027 のダウンロード。
目次
- 0. はじめに
- 1. ノードと hqbirdrcm のインストール
- 2. クラスタの構成
- 3. マスターへのデータベースの追加
- 4. データベースをレプリカにする方法:手順とディスク上の場所
- 5. 初期化(reinit)
- 6. パブリケーションの設定
- 7. その他のレプリケーションオプション
- 8. レプリカを通常のデータベースに移す方法
0. はじめに
このガイドは、HQbird レプリケーションクラスタのインストールと使い方を説明します。対象は hqclusternode のノードと、クラスタマネージャ hqbirdrcm(RCM)です。
Firebird 管理者向けのガイドです。Firebird、gfix、nbackup を知っていることを前提とします。ノードの内部動作を知る必要はありません。
クラスタの構成要素
| 構成要素 | 数 | 動作する場所 | 役割 |
|---|---|---|---|
| Firebird(HQbird) | 1 つ以上のインスタンス | 各データベースサーバー上 | データベースを格納し、レプリケーションセグメントを書き出す |
| fbagent | Firebird インスタンスごとに 1 つ | Firebird のそば | ノードの要求に応じて Firebird を停止・起動する |
| hqclusternode(ノード) | インスタンスと役割の組み合わせごとに 1 つ | Firebird のそば | レプリケーションを構成し、セグメントを転送し、レプリカの初期化を行う |
| hqbirdrcm(RCM) | クラスタごとに 1 つ | すべてのノードから到達できる任意のホスト | Web インターフェース、コマンド、アラート、統計 |
ノードには 役割 があります。master または replica です。1 つの Firebird インスタンス上で 2 つのノードを動かせます。マスターノードとレプリカノードです。その場合、この Firebird のデータベースのうち一部はマスター、ほかはレプリカになります。
動作のしくみ
- マスター上で、Firebird はデータベースの変更を セグメント(レプリケーションログファイル)に書き出します。
- マスターノードは、保護されたチャネル(mTLS)経由でセグメントをレプリカノードへ送ります。
- レプリカノードはセグメントを受信セグメントフォルダに置きます。レプリカ側の Firebird が、それをデータベースのコピーへ適用します。
- 最初のデータベースコピーは、マスターノード自身がレプリカへ転送します。これを 初期化(reinit)と呼びます。
nbackupを経由し、この間マスターは動き続けます。 - ノードは統計を RCM へ送ります。RCM はクラスタの状態を表示し、オペレータのコマンドをノードへ送ります。

対応バージョン
- Firebird / HQbird 5.0 と 4.0 — すべての機能。
- HQbird 3.0 と 2.5 — replconf プラグインによるレプリケーション。パブリケーションはありません。テーブルの集合はフィルタで定義します。違いは「HQbird 2.5/3.0」の枠に書いてあります。
マスターとレプリカの Firebird のメジャーバージョンは一致している必要があります。一致しない場合、レプリカノードは初期化を拒否します。
ポート
| ポート | 待ち受けるもの | 接続するもの | 用途 |
|---|---|---|---|
7051 |
ノード | ほかのノードと RCM | ノード API、セグメントとデータベースコピーの転送 |
7443 |
RCM | すべてのノード | ノードからの統計の受信 |
7444 |
RCM | オペレータ | Web インターフェースとオペレータ API。RCM 経由のインストール(第 1.3 章):すべてのアドレスで HTTPS。HQCenter Admin 経由または手動のインストール:HTTP、127.0.0.1 のみ |
7450–7459 |
fbagent(リンクのウィンドウが開いている間) | RCM | ホストのリンク(第 1.3 章) |
13050 |
fbagent、127.0.0.1 のみ | 同じホスト上のノード | Firebird の管理 |
3050 |
Firebird | アプリケーション | 通常のデータベース操作 |
1 台のホストに 2 つのノード(マスターとレプリカ)がある場合、2 つ目のノードは別のポートを使います。RCM 経由でインストールすると、2 つ目のノードはポート 7061 になります。それ以外の場合は、自分でポートを指定します。例:7052。
ポート 13050 をネットワークに公開してはいけません。HTTP のポート 7444(HQCenter Admin 経由または手動のインストール)も同様です。RCM の Web インターフェースへは SSH トンネルで接続します(第 1 章)。RCM 経由でインストールした場合、ポート 7444 は HTTPS で動作し、インストーラがファイアウォールで開きます。
大原則:fbagent がなければ変更しない
ノードがレプリケーション構成を変えるのは fbagent 経由だけです。Firebird の再起動が必要だからです。fbagent が使えない場合、ノードは構成を変える操作を 拒否します。一部分だけ動くことはありません。
用語
| 用語 | 意味 |
|---|---|
| セグメント | データベースの変更を収めたレプリケーションログファイル |
| パブリケーション | 変更がセグメントに入るマスター側テーブルの一覧(Firebird 4/5) |
| 初期化(reinit) | nbackup による、マスターからレプリカへのデータベースコピーの転送 |
| データベース GUID | Firebird のデータベース識別子。RCM はこれでマスターとレプリカを結びます |
| ピア | 相手ノード。マスターにとっては、そのレプリカ |
| コンパニオン | 同じ Firebird インスタンス上のもう一方のノード(1 台のホスト上のマスターとレプリカ) |
| 登録(Enroll) | マスターのデータベースをノードに登録すること |
ガイドの読み方
| 章 | 主題 |
|---|---|
| 1. インストール | HQCenter Admin 経由、HQCenter Admin なしの RCM 経由、手動でのノードと RCM のインストール。Linux と Windows |
| 2. クラスタの構成 | マスター → レプリカのリンク、ノード設定、RCM ユーザー |
| 3. マスターへのデータベースの追加 | 登録、Firebird の再起動、確認 |
| 4. データベースをレプリカにする方法 | 段階、レプリカの準備、ディスク容量 |
| 5. 初期化 | 再初期化の手順、運用への影響、長いトランザクション、速度、エラー |
| 6. パブリケーションの設定 | Firebird 4/5 のパブリケーション、テーブル、新しいテーブル、HQbird 2.5/3.0 |
| 7. その他のレプリケーションオプション | replication.conf のパラメータ、アーカイブ、転送、アラート、一時停止、ログ |
| 8. レプリカを通常のデータベースにする | 通常化、マスターへ昇格、新しい GUID、サービス(スイッチオーバー、フェイルオーバー)、スイッチオーバーのチェックリスト |
どの章も同じ例を使います。
| 項目 | 値 |
|---|---|
node-a |
マスターノード。データベースは /databases/master |
node-b |
レプリカノード。データベースは /databases/replica |
| RCM | 別ホスト(データベースサーバーの 1 台でもよい) |
| データベース | employee.fdb |
1. ノードと hqbirdrcm のインストール
インストール方法は 3 つあります。
| 方法 | 選ぶとき | 自分で行うこと |
|---|---|---|
| HQCenter Admin 経由(1.2) | 通常の経路。HQCenter Admin の更新サーバーに届き、自動更新が必要 | fbagent のインストールスクリプトを実行し、要求を承認し、クラスタを記述する |
| RCM 経由、HQCenter Admin なし(1.3) | HQCenter Admin はないが、証明書、構成、更新を手作業なしで行いたい。データベースサーバーは最大 3 台 | 各ホストに HQbird をインストールし、RCM にログインし、設定 → ホストをリンク でホストのアドレスを指定する |
| 手動(1.4) | HQCenter Admin に届かない、閉じたネットワーク、特別な要件 | ファイルを置き、証明書を作り、node.json と rcm.json を書き、サービスを登録する |
HQCenter Admin 経由と RCM 経由では、ノードと RCM を 自分ではインストールしません。クラスタに追加したときに fbagent がインストールします(第 2 章)。証明書と構成も自動で作られます。
Linux と Windows は 1 つの章にまとめてあります。Windows の違いは「Windows の場合」の枠にあります。
1.1. 要件
各データベースサーバーで:
- Firebird / HQbird 5.0、4.0、3.0、または 2.5(2.5 は Linux のみ)。
- すべての Firebird インスタンスのそばに fbagent。fbagent がなければノードは動きません。
- すべてのサーバーと RCM ホストでの時刻同期(NTP、chrony、
w32time)。再起動ウィンドウと転送ウィンドウ、遅延の見積もり、「ノードが応答しない」判定は時計に依存します。 - セグメントアーカイブとレプリカ初期化のための空き容量(第 4 章)。
- ポート表どおりのネットワーク(第 0 章)。
Linux: root 権限、x86_64、systemd、curl。対応:Ubuntu 20–26、Debian 11–13、Astra、CentOS 7–10、AlmaLinux、Rocky、Oracle Linux 8–10、RED OS、openSUSE 15.6、Fedora 44+。
Windows: 管理者権限、x64、Windows 10 / Server 2016 以降、64 ビット Windows PowerShell 5.1。Windows 10 と Server 2016–2022 では 7-Zip が必要です。
RCM を動かす場所。 クラスタごとに RCM は 1 つ必要です。すべてのノードから到達できる任意のサーバーにインストールできます。データベースサーバーの 1 台でも構いません。
1.2. HQCenter Admin 経由のインストール
手順 1. fbagent のインストールスクリプトを実行する
スクリプトは Firebird(HQbird ビルド)と fbagent をインストールし、fbagent を HQCenter Admin サーバーに登録します。Firebird のバージョンに合うスクリプトを選びます。fb25、fb30、fb40、fb50。
Linux(root として):
sudo sh fbagent-fb50_known.sh --goafts <HQCenter-Admin-server> --enroll --clusterWindows の場合(管理者の PowerShell):
powershell -NoProfile -ExecutionPolicy Bypass -File .\fbagent-fb50_known.ps1 -EnrollWindows には -Cluster パラメータはありません。fbagent は LocalSystem として動作し、クラスタ用フォルダを自分で作ります。
主なパラメータ:
| Linux | Windows | 意味 |
|---|---|---|
--goafts <name> |
-Goafts |
ダウンロード元の HQCenter Admin サーバー。名前は供給元から渡されます |
--enroll |
-Enroll |
fbagent を HQCenter Admin に登録する(証明書要求) |
--cluster |
— | /opt/hqclusternode と /opt/hqbirdrcm のフォルダを作る(fbagent 2.55.2 以前でのみ必要。新しいバージョンでは害はありません) |
--channel |
-Channel |
fbagent の更新チャネル。既定は stable |
--token |
-Token |
ライセンストークン。HQCenter Admin が要求を自動で承認します |
--port |
-Port |
Firebird のポート |
--yes |
-Yes |
質問しない(端末がないときに必要) |
パラメータの完全な一覧は、fbagent インストールスクリプトの README を参照してください。
手順 2. fbagent の要求を承認する
--enroll パラメータを付けると、fbagent は証明書要求(CSR)を HQCenter Admin に送り、承認を最大 30 分待ちます。承認の方法は次のとおりです。
- 自動 — ライセンストークン(
--token)付きでインストールし、ライセンスに空きスロットがある場合。 - HQCenter Admin パネルで — CSR 要求の節、このホストの要求、承認して署名するボタン。
- HQCenter Admin API で —
POST /v1/admin/csr-requests/{id}/approve。
登録が成功しなかった場合(待ち時間が尽きたなど)、fbagent 自体は動きますが、スクリプトは終了コード 2 で終わります。同じパラメータでスクリプトを再実行してください。繰り返されるのは登録だけです。
登録の数分後、fbagent は HQ Monitor を自分でインストールします。
手順 3. クラスタを記述する
fbagent を HQCenter Admin のクラスタに追加すると、ノードと RCM が現れます。クラスタの記述方法は 第 2 章 にあります。
クラスタを保存したあと:
- 10 分以内に fbagent が HQCenter Admin からクラスタを受け取ります(その後は 60 秒ごとに変更を確認します)。
- RCM ホスト上の fbagent がクラスタの認証局(CA)を作り、すべてのノードの証明書に署名します。
- 各 fbagent は、自分のクラスタメンバー用に
node.jsonまたはrcm.jsonを書きます。 - 次の製品確認(3 分ごと)で、fbagent がサービスをインストールして起動します。
インストールされるものと場所:
| 対象 | Linux | Windows |
|---|---|---|
| マスターノード | /opt/hqclusternode/master/、サービス hqclusternode-master-p<port> |
<HQbird>\hqclusternode\master\、サービス HQClusterNode-master-p<port> |
| レプリカノード | /opt/hqclusternode/replica/、サービス hqclusternode-replica-p<port> |
<HQbird>\hqclusternode\replica\、サービス HQClusterNode-replica-p<port> |
| RCM | /opt/hqbirdrcm/、サービス hqbirdrcm |
<HQbird>\hqbirdrcm\、サービス hqbirdrcm |
<port> は Firebird のポートです。例:3050。1 つの fbagent がホストできるのは、マスターノード 1 つ、レプリカノード 1 つ、RCM 1 つ、ルーター 1 つまでです(hqclusternode router、HQbird 2027.2.30 以降、第 8.7 章)。
Windows の場合。 2.83.0 より前の fbagent は、ノードを
C:\hqclusternodeに、RCM をC:\hqbirdrcmにインストールしていました。これらのフォルダがある場合、fbagent は引き続きそれらを使います。
更新
- fbagent はノードと RCM の新しいバージョンを 3 分ごとに確認します。既定のチャネルは
stableです。先にレプリカノードを更新し、そのあとマスターノードを更新します。 - 更新後にサービスが起動しない、または誤ったバージョンを報告する場合、fbagent は前のバージョンへロールバックし、新しいバージョンを ブロックします。ブロックの一覧:
<fbagent folder>/update/<product>/blocked-versions.json。そのバージョンを再試行するには、このファイルから該当行を削除します。 - 製品の状態:
fbagent --product-status hqclusternode(またはhqbirdrcm)。
1.3. RCM 経由のインストール(HQCenter Admin なし)
クラスタは RCM が管理します。各ホストの fbagent は RCM からクラスタの記述を受け取り、RCM ホスト上の fbagent が証明書に署名し、ノードと RCM は RCM が保管するリリースから更新されます。
制限:
- RCM ごとにクラスタは 1 つ。
- シート は 3 まで。シートとは、マスターノードまたはレプリカノードが動くホストです。同じホスト上のマスターとレプリカは 1 シートです。RCM だけが動くホストはシートを消費しません。4 台目のホストはエラー
seats_exceededになります。 - RCM は fbagent も Firebird も更新しません。fbagent が自分で更新し、
replication.conf、node.json、rcm.json、証明書には手を付けません。
方法は 2 つあります。
- RCM でホストをリンク — 通常の方法。3 つの操作です。各ホストでインストーラを実行する(1 台で RCM、ほかはディスカバリモード)、RCM にログインする、ホストをリンク フォーム。
- コマンドラインから手動 — 参加トークンと
fbagent --cluster-join。ホスト間でポート7450が閉じている、またはペアリングウィンドウがすでに閉じているときに使います。
ライセンス。 試用ライセンスには cluster 機能が含まれます。試用期間のあと、ライセンスに cluster がない場合、fbagent はノードも RCM も インストールしません。すでにインストール済みのノードと RCM の更新を止めることはありません。HQCenter Admin がないと、フローティングライセンスは online_check_days に猶予日数を加えた期間のあと動作を止めます。そのため、各 fbagent に バインド ライセンスをインストールします。
fbagent --license-request --out license_request.json
# send the file to the vendor and receive license.json
fbagent --license-install license.json
ライセンスがないと、マスターはセグメントの送信を止めます(第 2.8 章)。
ポート:
| ポート | 場所 | 接続するもの |
|---|---|---|
7443 |
RCM ホスト | クラスタのすべてのホストの fbagent とノード |
7444 |
RCM ホスト | オペレータのブラウザ(RCM コンソール、HTTPS) |
7450(2 台目以降の fbagent ホストでは 7451…7459) |
ディスカバリモードのホスト。ペアリングウィンドウが開いている間 | RCM ホスト上の RCM |
7051(同じ fbagent の 2 つ目のノードは 7061) |
ノードのホスト | ほかのノードと RCM(1.4、手順 7) |
RCM でホストをリンク
ゼロからの例。 Linux サーバー 2 台、
.runインストーラ、リンク、登録、パブリケーション、負荷をかけた初期化と再初期化。スクリーンショットと測定値付き。ガイドhqbird2027-linux-cluster-guide.ru.mdとランブックhqbird2027-linux-cluster-runbook.ru.md(goafts リポジトリ、documentation フォルダ)。
手順 1. 各ホストに HQbird をインストールする
各データベースサーバーに、フルインストーラ で HQbird をインストールします。HQCenter Admin には登録しません(--enroll)。
既定では、インストーラはクラスタを構成しません。 ノードと RCM のプログラムを fbagent のフォルダ(update/<product>/staged/)に置きますが、RCM はインストールせず、ペアリングウィンドウも開かず、ファイアウォールでクラスタのポートも開きません。クラスタは 2 つのパラメータで有効にします。
sudo sh hqbird2027-fb50-linux-<version>.run --rcm on               # RCM host
sudo sh hqbird2027-fb50-linux-<version>.run --cluster-pairing on   # other hosts
--rcm on — クラスタの RCM を動かす 1 台のホストで指定します。インストーラは次を行います。
- このホストのクラスタを作ります(
fbagent --cluster-init)。クラスタ名はホスト名です。 - RCM をインストールして起動します。RCM コンソールはポート
7444の HTTPS で動作します。 - 最初の RCM 管理者
rcmadminを、ランダムなパスワードで作ります。 - ファイアウォールでポート
7443、7444、ノードポート7051を開きます。
--cluster-pairing on(ディスカバリモード)— ほかの各ホストで指定します。インストーラは fbagent の ペアリングウィンドウ を 24 時間開きます。ポート 7450 とノードポート 7051 です。ウィンドウが開いている間、ネットワーク上の RCM がこのホストを自分のクラスタへ招待できます。fbagent は 1 分以内にポート 7450 で待ち受けを始めます。
これらのパラメータがないと、インストーラは自分で尋ねます。テキストインターフェースでは クラスタ のページ、--no-tui では質問が 2 つです。既定の答えは「いいえ」です。クラスタ用パラメータなしの --yes も、両方の質問に「いいえ」と答えます。
最後にインストーラは RCM: と Pairing: の行を表示します。RCM ホストでは:
RCM:        https://10.0.0.7:7444 (cluster db1)
CA hash:    sha256:7cfc1d4b…032d2582
Login:      rcmadmin
Password:   in /opt/hqbird/fbagent-fb50/clusterca/db1/rcm-initial-password (read it with sudo; RCM asks for a new one at the first login)
Pairing:    not needed: this agent runs the RCM; other agents link through it
別のホストでは:
RCM:        off; turn it on in HQbird Monitor or with fbagent --cluster-init <id>
Pairing: port 7450 open until 2026-11-17T17:49:18Z (fingerprint sha256:0439e44a…91a2f9b9); an RCM may invite this host出力にパスワードはありません。Password: 行のファイルにあります。ディスカバリモードの各ホストの fingerprint を控えてください。
Linux インストーラのクラスタ用パラメータ:
| パラメータ | 動作 |
|---|---|
--rcm on|off |
このホストに RCM をインストールし、クラスタを作る。既定は off |
--cluster-pairing on|off |
ディスカバリモード。ペアリングウィンドウを 24 時間開く。既定は off |
--pairing-port N |
新しい fbagent のペアリングポート。7450–7459。既定は最初の空き |
--rcm-password-file F |
ファイル F の 1 行目を RCM 管理者パスワードにする。ランダムの代わり |
--cluster-id ID |
ホスト名の代わりにクラスタ名 ID を使う(--rcm on と併用) |
--cluster-node on|off |
ノードのプログラムをインストールする。既定は on |
--rcm-allow A,B |
このホストを招待できる RCM をこれらに限る。アドレス、CIDR ネットワーク、または名前 |
ホスト上の最初の fbagent は、ペアリングポート 7450 とノードポート 7051、7061 を使います。同じホストの 2 つ目のインスタンスは 7451、7052、7062 です。
RCM とペアリングウィンドウは、インストーラを使わずあとから有効にできます。HQ Monitor の クラスタ ページ、または fbagent ユーザーでのコマンドです。
cd <fbagent folder>                                    # /opt/hqbird/fbagent-fb50
sudo -u firebird ./fbagent --cluster-init <name>      # RCM host; open ports 7443 and 7444 yourself
sudo -u firebird ./fbagent --cluster-pairing on      # window for 24 hours
sudo -u firebird ./fbagent --cluster-pairing off
sudo -u firebird ./fbagent --cluster-pairing status古いインストーラ(fbagent 3.1.0 より前)はクラスタについて尋ねません。すべてのホストに RCM をインストールし、すべての場所でペアリングウィンドウを開きます。必要なのは 1 台のホストの RCM です。ほかのホストの RCM は、リンクのあと自分で停止します。
Windows の場合。 Windows インストーラにも同じ 2 つの選択があります。パラメータ
/RCMと/DISCOVERYです。
手順 2. RCM にログインする
RCM ホストの RCM: 行のアドレスを開きます(https://<host>:7444)。ログイン rcmadmin と、Password: 行のファイルにあるパスワードでログインします。RCM はすぐに新しいパスワードを求めます(1.5)。
手順 3. ホストをリンクする
RCM で 設定 → ホストをリンク を開きます。
- ホスト 欄に、ホストのアドレスまたは名前を 1 行に 1 つ入力します。1 行目は RCM ホストで、すでにクラスタに入っています。
- ホストを確認 をクリックします。RCM は各ホストのペアリングポート
7450–7459を調べ、プラットフォーム、Firebird のバージョン、フィンガープリント、状態を表示します。RCM ホストにペアリングウィンドウは不要です。フィンガープリントをインストーラの出力(Pairing:行)と照合します。 - マスター を選び(既定は最初のホスト)、リンク をクリックします。
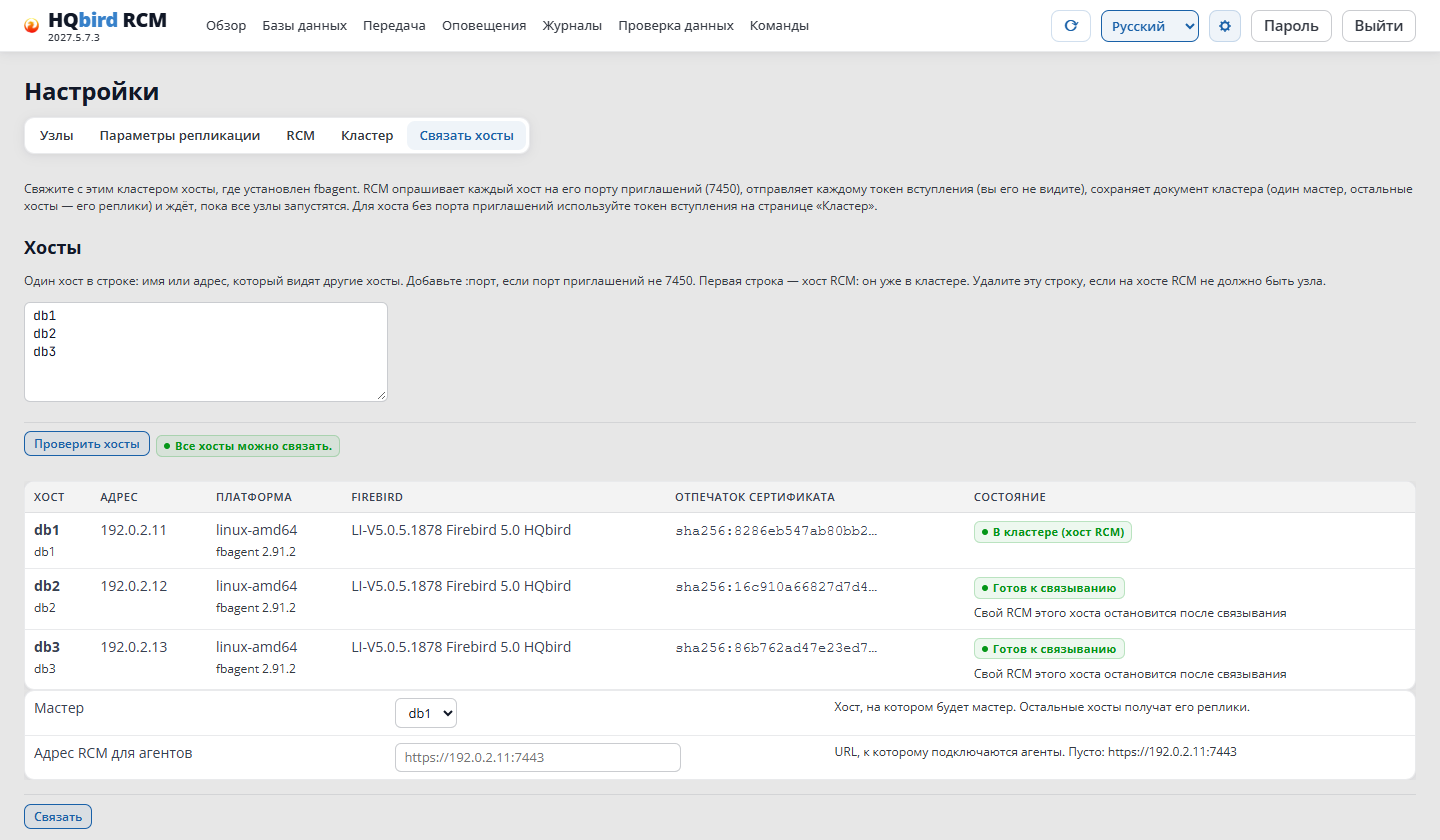
RCM は確認を求め、進行状況 の節に進捗を表示します。すべてのノードが動作すると「完了」と表示し、クラスタのリビジョン番号を示します。
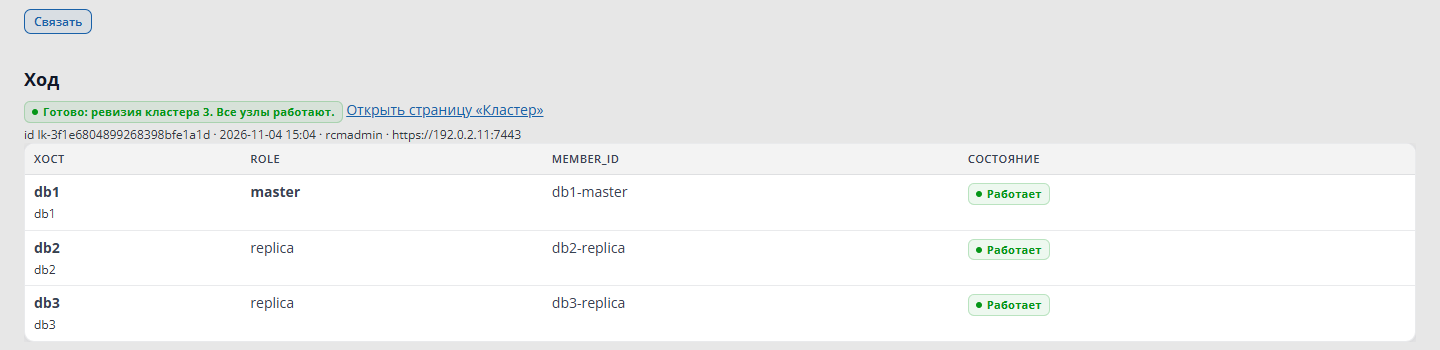
コマンドラインからも同じ操作ができます。
cd /opt/hqbirdrcm
export RCM_USER=rcmadmin RCM_PASSWORD='<password>'
./hqbirdrcm cluster link -hosts db1,db2,db3 -master db1
そのあと起きること:
- RCM は空いている各ホストへ招待を送ります。
- ホストの fbagent はクラスタに参加し、ペアリングポートを閉じます。ホストにノードのない独自の RCM がある場合、fbagent はそれを停止して無効にし、空のクラスタを fbagent フォルダの
cluster/left/へ移します。 - RCM はクラスタを保存します。マスターにはノード
<host>-master、ほかのホストには<host>-replica、ポート7051、マスター → レプリカのリンクです。 - 各ホストの fbagent がノードをインストールして起動します。RCM はすべてのノードが動作するまで待ち、各ホストに 稼働中 と表示します。
ホストを確認 のあとのホストの状態:
| 状態 | 対処 |
|---|---|
| リンク可能 | 何もしません。その下に「このホスト自身の RCM はリンク後に停止します」とあれば、それは正常です |
| クラスタ内 | ホストはすでにこのクラスタに入っています |
エラー unreachable |
ポート 7450 が閉じています。ペアリングウィンドウがオフ(既定どおり)か、24 時間が過ぎています。インストール直後は 1 分待って ホストを確認 を再度クリックします。そうでなければウィンドウを開き(--cluster-pairing on)、ファイアウォールを確認します |
エラー in_other_cluster |
ホストは別のクラスタに入っています |
エラー claimed |
別の RCM が今このホストをリンクしています |
エラー seats_exceeded |
シートが 3 を超えています |
リリース。 fbagent はノードを RCM からだけ インストールします。RCM は起動時と 5 分ごとに、rcm.json の隣の import/ フォルダから署名済みリリースを取り込みます。インストーラは RCM ホストのリリースをそこに置き、ほかのホストの fbagent は自分のプラットフォーム用リリースを自分でダウンロードします。リリースの一覧は ホストをリンク ページの下部にあります。リリースは手動でもインポートできます(下の手順 5)。
コマンドラインから手動
順序:RCM ホストで手順 1–3、ほかの各ホストで手順 4、RCM で手順 5–6。
手順 1. fbagent 付きで HQbird をインストールする
各データベースサーバーと RCM ホストに、フルインストーラ で HQbird をインストールします。RCM ホストでは最初から --rcm on を指定できます(その場合、手順 3 は不要です)。ほかのホストではクラスタ用パラメータを指定しません。既定では RCM もペアリングウィンドウもありません。HQCenter Admin には登録しません(--enroll)。
RCM ホストでは、インストーラは RCM のプログラムを fbagent フォルダ(update/hqbirdrcm/staged/)に残します。これがないと手順 3 はエラー no hqbirdrcm to install で失敗します。
手順 2. バインドライセンスをインストールする
この節の冒頭「ライセンス」と同じです。
手順 3. RCM ホストにクラスタを作る
インストーラがすでにクラスタを作っている場合(--rcm on:出力にアドレス付きの RCM: 行がある)、この手順は飛ばします。
コマンドは fbagent ユーザー(Linux では firebird)で実行します。root では実行しません。root だと CA ファイルと rcm.json の所有者が root になります。
cd <fbagent folder>
sudo -u firebird ./fbagent --cluster-init shop-prod --address 10.0.0.7
Windows の場合(管理者の PowerShell):
.\fbagent.exe --cluster-init shop-prod --address 10.0.0.7
shop-prod— クラスタ名。小文字のラテン文字、数字、-。--address— ほかのホストが接続するときの RCM ホストのアドレス。複数回指定できます。パラメータがない場合は、ホストのアドレスと名前が使われます。
このコマンドは次を行います。
- クラスタ CA とエージェント CA を作ります(fbagent フォルダの
clusterca/<name>/)。 - RCM 証明書、
rcm.json、cluster-init.jsonを RCM フォルダに書きます。 - RCM をインストールし、サービス
hqbirdrcmを登録します。Linux ではサービスは別ユーザーhqbirdrcmで動作します。 - fbagent を RCM に切り替え(
cluster.source = rcm)、再起動します。 - RCM のアドレスと CA のフィンガープリントを表示します。
Cluster:    shop-prod
RCM URL:    https://10.0.0.7:7443
CA hash:    sha256:9f86d0...
RCM URL と CA hash を控えます。ほかのホストで必要です。同じクラスタに対する再実行は安全です。CA と鍵はそのままです。
すぐに RCM へログインし、rcmadmin のパスワードを変更します(1.5)。
Linux の場合。 ユーザー
hqbirdrcmは fbagent グループに入っています。RCM はこのグループ経由でrcm.jsonを読めますが、書き込めません。そのため 設定 → RCM は変更を保存しません(エラーrcm_config_read_only)。ホスト上で fbagent ユーザーとしてrcm.jsonを編集し、RCM を再起動します。
手順 4. ほかのホストの fbagent を接続する
-
RCM ホストで、各 fbagent 用の 参加トークン を作ります。RCM の 設定 → クラスタ、参加トークンを作成 ボタンです。またはコマンドラインから:
cd /opt/hqbirdrcm
export RCM_USER=rcmadmin RCM_PASSWORD='<password>'
./hqbirdrcm cluster join-token -note db2
トークンは 24 時間有効で、1 つの fbagent だけ、1 回だけ使えます。RCM はそれを 1 回だけ、できあがったコマンドとともに表示します。
-
ノードのホストで、このコマンドを fbagent ユーザーとして実行します。
cd <fbagent folder> sudo -u firebird ./fbagent --cluster-join https://10.0.0.7:7443 \ --ca-hash sha256:9f86d0... --token-file token.txt--token-fileの代わりに--token <token>も使えます。Windows では、管理者の PowerShell で.\fbagent.exeを使って同じことをします。
fbagent はフィンガープリントで RCM の CA を検証します。フィンガープリントが一致しない場合、停止し、何も書きません。そのあと fbagent は自分の証明書(90 日、自動更新)を受け取り、再起動します。接続された fbagent は RCM の エージェント 表に表示されます。メンバーがない間は、ホストには何もインストールされません。
手順 5. リリースを RCM にインポートする
fbagent はノードと RCM を RCM からだけ 取得します。必要なリリースが ミラー内のリリース の一覧(設定 → ホストをリンク)にない場合、ホストの各プラットフォーム(linux-amd64、windows-amd64)向けに、各製品(hqclusternode、hqbirdrcm)をインポートします。リリースファイルと .sig 署名は供給元から渡されます。
cd /opt/hqbirdrcm
sudo -u hqbirdrcm ./hqbirdrcm release import -config rcm.json \
  -file hqclusternode-linux-amd64 -product hqclusternode \
  -platform linux-amd64 -version 2027.5.12
sudo -u hqbirdrcm ./hqbirdrcm release list -config rcm.json- RCM は署名を
<file>.sigから探します。-sigで指定することもできます。有効な供給元の署名がなければ、RCM はファイルを受け付けません。 - 新しいリリースは前のリリースを置き換えます。RCM の再起動は不要です。
- fbagent は新しいバージョンを 3 分ごとに確認します。更新の順序とロックは HQCenter Admin 経由と同じです(1.2、「更新」)。
手順 6. クラスタを記述する
メンバーとリンクを RCM の 設定 → クラスタ で設定します(第 2.3 章)。保存後、fbagent は HQCenter Admin 経由と同じ方法でノードをインストールします(1.2、手順 3)。証明書、node.json、rcm.json を書き、サービスをインストールして起動します。
ポートは、この節の冒頭にあります。
1.4. 手動インストール
手順 1. fbagent 付きで HQbird をインストールする
すべてのデータベースサーバーに HQbird をインストールします(同じスクリプトで --enroll なし、または HQbird のフルインストーラ)。fbagent が動作していることを確認します。
fbagent の agent_config.json から 3 つの値を控えます。node.json に必要です。
| fbagent のフィールド | node.json のフィールド |
例 |
|---|---|---|
local_api.listen |
firebird.fbagent_url |
http://127.0.0.1:13050 |
local_api.token |
firebird.fbagent_token |
— |
local_api.instance_id |
firebird.instance_id |
— |
fbagent の確認(応答は Firebird インスタンスの JSON):
curl -s -H "Authorization: Bearer <token>" http://127.0.0.1:13050/v1/instances/<instance_id>ホストに HQbird インスタンスが複数ある場合、fbagent 構成の firebird.update.services には自分のインスタンスのサービスだけを残します(3.5 を参照)。
手順 2. ファイルを配置する
Linux:
/opt/hqclusternode/
  hqclusternode        # program
  node.json            # node configuration (permissions 0600)
  certs/               # ca.crt, <node_id>.crt, <node_id>.key
  work/                # working folder
/opt/hqbirdrcm/
  hqbirdrcm            # program
  rcm.json             # cluster configuration
  certs/               # ca.crt, rcm.crt, rcm.key
rcm-data/ # state, users, audit logsudo mkdir -p /opt/hqclusternode/certs /opt/hqclusternode/work
sudo install -m 0755 hqclusternode-linux-amd64 /opt/hqclusternode/hqclusternode
# on the RCM host:
sudo mkdir -p /opt/hqbirdrcm/certs /opt/hqbirdrcm/rcm-data
sudo install -m 0755 hqbirdrcm-linux-amd64 /opt/hqbirdrcm/hqbirdrcmWindows の場合。 既定のフォルダは
C:\hqclusternodeで、配置は同じです。空白を含むパスも使えます。
1 台のホストに 2 つのノード(マスターとレプリカ)がある場合、それぞれ専用のフォルダを与えます。例:/opt/hqclusternode/master と /opt/hqclusternode/replica。
手順 3. 証明書を作る
ノードと RCM は mTLS だけで通信します。CA が 1 つと、参加者ごとの証明書が必要です。任意のマシンで 1 回だけ 実行します。
./hqclusternode gencerts -out certs \
  -nodes 'node-a:master,node-b:replica' \
  -hosts 'localhost,127.0.0.1,<ip-node-a>,<ip-node-b>,<ip-rcm>'
このコマンドは ca.crt と ca.key、node-a.crt/.key、node-b.crt/.key、rcm.crt/.key を作ります。-hosts には、参加者が接続されるときに使う名前とアドレスをすべて列挙します。
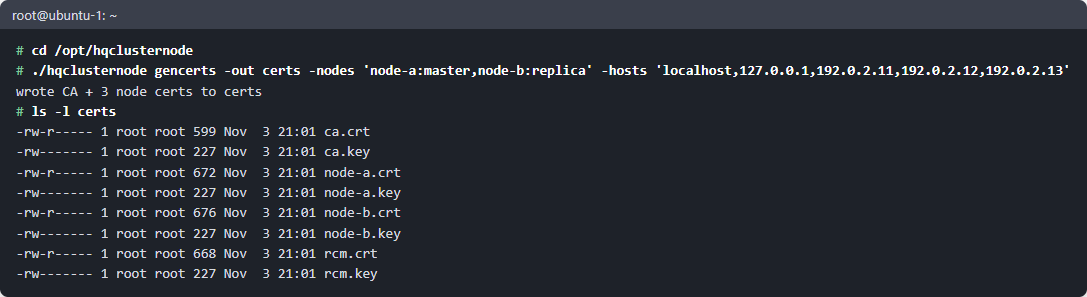
ca.key は CA の鍵です。ホストへコピーせず、別に保管します。
新しいノードは、あとから -add で追加します。同じ CA でその組に署名し、ほかのファイルは変更しません。
./hqclusternode gencerts -out certs -add -nodes 'node-c:replica' -hosts '<ip-node-c>'証明書の有効期限は 90 日です。gencerts -out certs -list で期限を表示し、gencerts -out certs -renew で同じ鍵のまま更新します。新しい .crt をそのホストへコピーします。ノードは再起動なしで取り込みます。
各ホストへコピーするのは ca.crt と、そのホスト自身の 証明書と鍵だけです。
手順 4. node.json を書く
ノードごとに 1 ファイルです。マスター(node-a)の例:
{
  "node_id": "node-a",
  "role": "master",
  "listen_addr": ":7051",
  "rcm": { "url": "https://<ip-rcm>:7443", "ca_cert": "certs/ca.crt",
           "client_cert": "certs/node-a.crt", "client_key": "certs/node-a.key" },
  "firebird": {
    "root": "/opt/firebird",
    "user": "SYSDBA",
    "password": "<SYSDBA password>",
    "port": 3050,
    "replication_conf": "/opt/firebird/replication.conf",
    "replication_log": "/opt/firebird/replication.log",
    "firebird_log": "/opt/firebird/firebird.log",
    "fbagent_url": "http://127.0.0.1:13050",
    "fbagent_token": "<local_api.token>",
    "instance_id": "<local_api.instance_id>",
    "service_name": "<Firebird service name>"
  },
  "windows": { "restart_window": "22:00-05:00", "transfer_window": "23:00-05:00" },
  "peers": [ { "node_id": "node-b", "url": "https://<ip-node-b>:7051", "compress": "zstd" } ]
}レプリカノード(node-b)も同じファイルですが、"role": "replica"、自分の証明書、peers にはマスター node-a を入れます。
主なフィールド:
| フィールド | 値 |
|---|---|
node_id |
ノード名。証明書、rcm.json、ほかのノードの peers と同じ |
role |
master または replica |
listen_addr |
ノード API のアドレス。同じホストの 2 つ目のノードは別のポート(:7052) |
rcm.url |
RCM の統計を受け取るアドレス。none は RCM なし |
firebird.* |
このインスタンスの Firebird と fbagent。fbagent の値は 完全に 一致している必要があります |
firebird.auto_restart |
レプリカノードが Firebird を自分で再起動してよいか。auto(既定)、never、always |
windows.restart_window |
Firebird の再起動ウィンドウ。マスターの既定は 22:00-05:00、レプリカは常時 |
windows.transfer_window |
初期化が全速で走るウィンドウ |
peers |
マスターにとっては自分のレプリカ、レプリカにとっては自分のマスター |
databases |
データベースのフォルダ。手で書かず、RCM で設定する方がよい(第 3 章) |
残りのフィールドには既定値があります。fbagent のフィールドが未設定だと、ノードは起動しません。
ファイルを保護します。パスワードとトークンが入っています。
chmod 600 /opt/hqclusternode/node.jsonWindows の場合。 パスは JSON 形式で書きます。
"C:\\HQbird\\replication.conf"。service_nameは Firebird の Windows サービス名です。
手順 5. rcm.json を書く
{
  "ingest_addr": "0.0.0.0:7443",
  "operator_addr": "127.0.0.1:7444",
  "users_file": "rcm-data/users.json",
  "data_dir": "./rcm-data",
  "tls": { "ca_cert": "certs/ca.crt", "cert": "certs/rcm.crt", "key": "certs/rcm.key" },
  "nodes": [
    { "node_id": "node-a", "url": "https://<ip-node-a>:7051", "role": "master",  "host": "A" },
    { "node_id": "node-b", "url": "https://<ip-node-b>:7051", "role": "replica", "host": "B" }
  ]
}url— RCM ホストから見たノードのアドレス。httpsのみ。host— Firebird インスタンスのラベル。同じラベルのマスターノードとレプリカノードは同じ Firebird 上で動きます(コンパニオン。レプリカをマスターへ昇格するために必要、第 8 章)。1 つのラベルにつき、マスターとレプリカはそれぞれ 1 つまで。- 相対パスは
rcm.jsonのフォルダから解決されます。
手順 6. サービスを登録する
起動順: 先に RCM、次にレプリカ、そのあとマスター。
RCM(Linux):
cd /opt/hqbirdrcm
sudo ./hqbirdrcm svc install -config /opt/hqbirdrcm/rcm.json
sudo ./hqbirdrcm svc start
ノード(Linux):
cd /opt/hqclusternode
sudo ./hqclusternode svc install -config /opt/hqclusternode/node.json -certs /opt/hqclusternode/certs
sudo ./hqclusternode svc start -config /opt/hqclusternode/node.json
systemctl status hqclusternode-master-p3050
svc install は、ユーザー firebird で動くサービス hqclusternode-<role>-p<port> を作ります。Firebird のフォルダの所有者が root の場合、コマンドは firebird グループにそのフォルダへの書き込み(スティッキービット付き)を与え、変更をすべて表示します。ノードは replication.conf を置き換える必要があるからです。
svc start、svc stop、svc uninstall では、同じ node.json を指定します。サービス名は役割と Firebird のポートから導出されます。
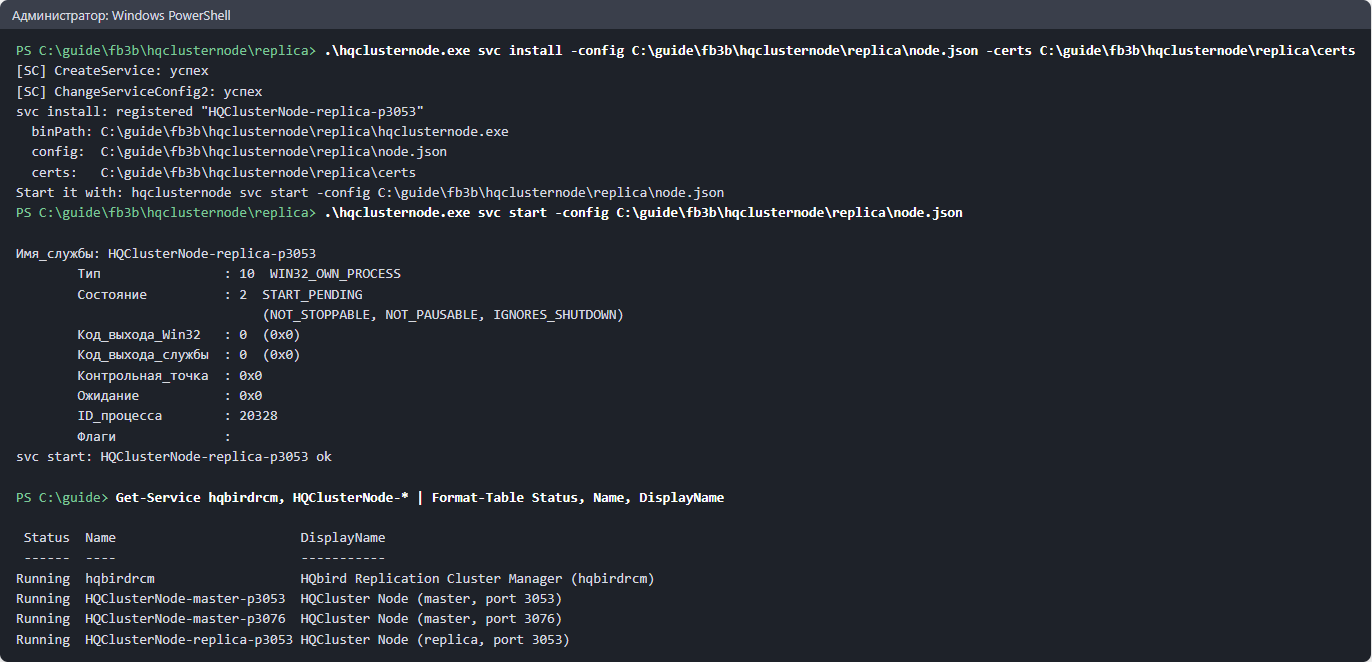
Windows の場合(管理者の PowerShell):
cd C:\hqclusternode
.\hqclusternode.exe svc install -config C:\hqclusternode\node.json -certs C:\hqclusternode\certs
サービス
HQClusterNode-<role>-p<port>は LocalSystem として動作し、自動起動し、失敗後に再起動します。ノードのサービスは Firebird のサービスに 依存しません。ノードをバージョン 2027.1.2–2027.1.9 でインストールした場合、依存関係を一度外します。.\hqclusternode.exe svc fix-deps -config C:\hqclusternode\node.json。
手順 7. ポートを開く
ノードのホストでは、ほかのノードと RCM からの 7051(listen_addr のポート)への着信を許可します。RCM ホストでは、すべてのノードからの 7443 への着信を許可します。ポート 7444 と 13050 は外部に公開しません。
ノードホストでの ufw の例:
sudo ufw allow from <ip-rcm> to any port 7051 proto tcp
sudo ufw allow from <ip-partner-node> to any port 7051 proto tcp
手動更新
サービスを止め、プログラムを置き換え、サービスを起動します。
sudo systemctl stop hqclusternode-master-p3050
sudo install -m 0755 hqclusternode-linux-amd64 /opt/hqclusternode/hqclusternode
sudo systemctl start hqclusternode-master-p3050
構成と証明書は、これでは変わりません。
1.5. RCM への最初のログイン
アドレスとパスワードは、RCM のインストール方法によります。
| RCM のインストール方法 | アドレス | ログインとパスワード |
|---|---|---|
HQbird インストーラ、または fbagent --cluster-init(1.3) |
任意のコンピュータから https://<RCM host>:7444 |
rcmadmin と、インストーラが表示したパスワード(または --rcm-password-file で指定した自分のパスワード) |
| HQCenter Admin 経由(1.2)、または手動(1.4) | http://127.0.0.1:7444。RCM ホスト上のみ |
rcmadmin、パスワード strong password(空白を含む) |
HTTPS(1.3)。 RCM の証明書はクラスタ CA が署名しており、ブラウザはそれを知らないため警告します。ログインページで RCM は CA のフィンガープリントを表示します。インストーラが表示した CA hash と照合し、CA をブラウザまたはシステムに信頼されたルートとしてインポートします。ログインページの CA 証明書をダウンロード リンク(https://<RCM host>:7444/ca.crt、ファイル hqcluster-ca.crt)です。RCM を localhost だけで待ち受けさせるには、rcm.json に "operator_addr": "127.0.0.1:7444" を設定して RCM を再起動します。
HTTP(1.2、1.4)。 別のコンピュータからは SSH トンネルで接続します。
ssh -L 7444:127.0.0.1:7444 <rcm-host>そのあとブラウザで http://127.0.0.1:7444 を開きます。
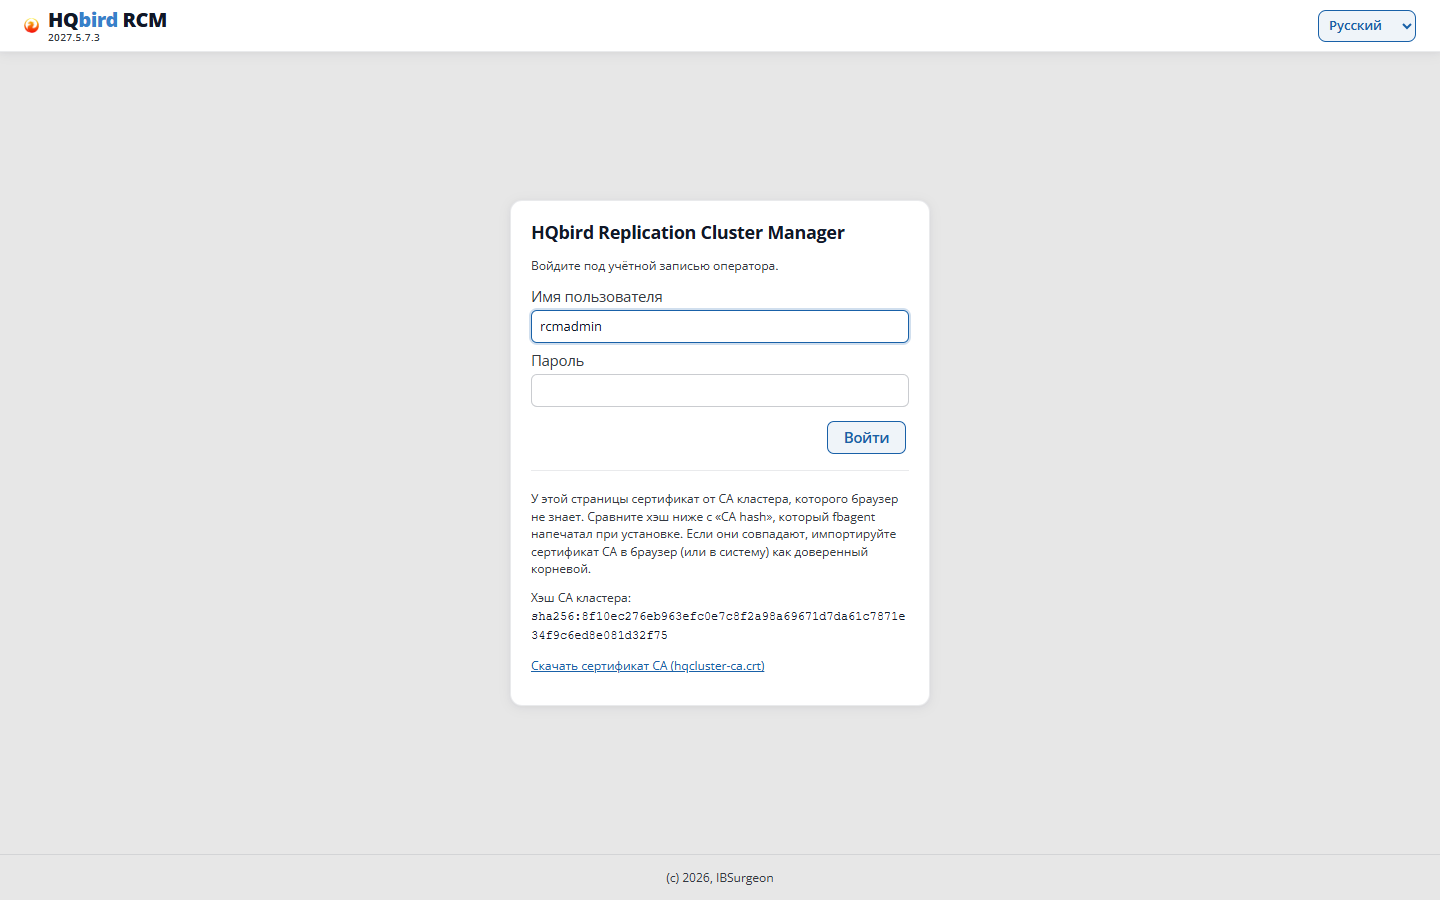
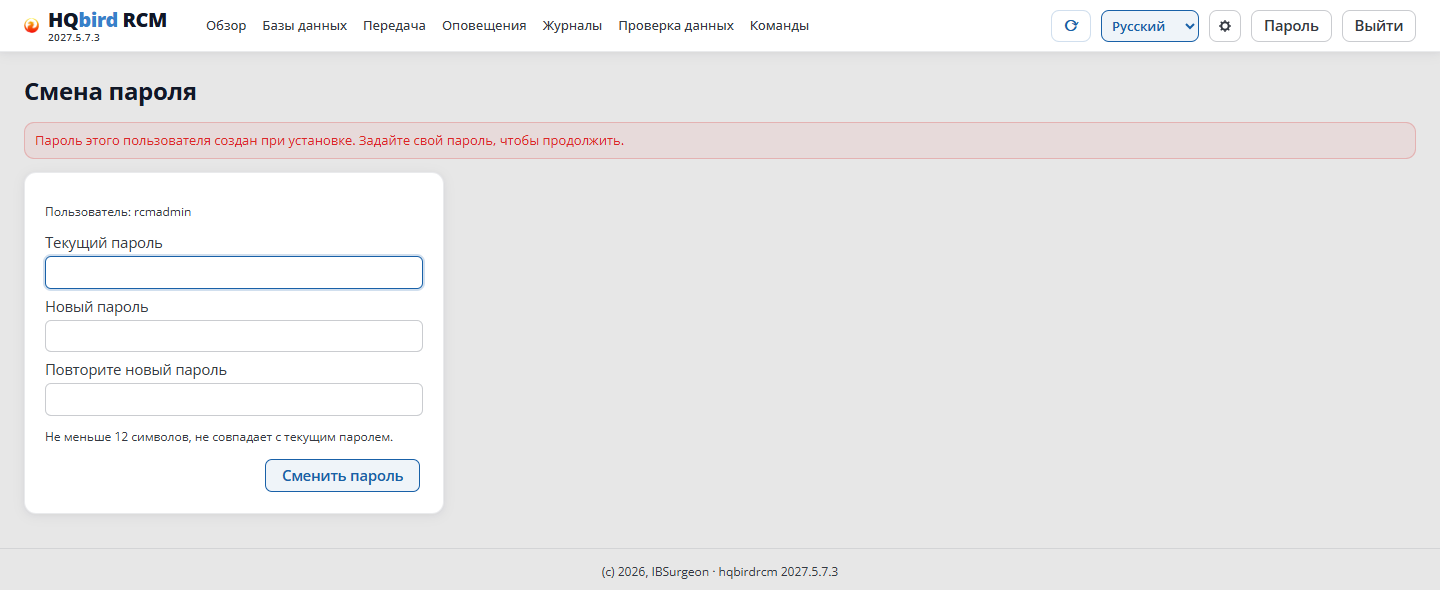
生成されたパスワード。 RCM は最初のログインで変更を求めます。変更するまでほかのページは開きません。strong password は すぐに 変更します(ヘッダーの パスワード リンク)。
言語。 ページヘッダーの言語一覧で ロシア語 を選びます(ログインページにもあります)。選ばなければ、言語はブラウザから取られます。
パスワードの変更と新しいユーザー
各ユーザーは自分のパスワードを変更します。 ページヘッダーの パスワード リンクです。現在のパスワードと、12 文字以上の新しいパスワードが必要です。変更後、そのユーザーのほかのセッションは閉じられます。
インストーラがパスワードを生成した場合、それは fbagent フォルダのファイル clusterca/<name>/rcm-initial-password に書かれます。パスワード変更後、fbagent はこのファイルを自分で削除します。RCM フォルダの initial-admin.json は 削除しないでください。入っているのはハッシュだけです。ユーザーファイルが失われ、このファイルもない場合、RCM は既定パスワードのユーザーを作ります。
新しいユーザー。 インターフェースにユーザーページはありません。ユーザーはファイル rcm-data/users.json に保存されます。パスワードは HA1 ハッシュとして保存されます。MD5("<name>:hqbirdrcm:<password>")。
- ハッシュを計算します。
printf '%s' 'rcmadmin:hqbirdrcm:<new password>' | md5sum users.jsonのそのユーザーのha1フィールドに書き込みます。ユーザーを追加するには、usersにもう 1 要素を足します。{ "username": "ivanov", "ha1": "<hash>", "algo": "MD5", "created_at": "2026-11-03T00:00:00Z" }- すぐに RCM を再起動します。ファイルを読むのは起動時だけです。インターフェースでパスワードを変えると、RCM はメモリからファイルを書き直し、まだ読んでいない編集は失われます。
chmod 600 /opt/hqbirdrcm/rcm-data/users.json
sudo systemctl restart hqbirdrcm
role フィールドがないユーザーは、すべての権限を持ちます。HQbird 2027.2.31 以降には "role": "viewer" の役割があります。閲覧のみで、変更の要求はすべて 403 になります。
1.6. インストールの確認方法
-
ノードと RCM のサービスが動作し、再起動を繰り返していないこと:
systemctl status hqclusternode-master-p3050、systemctl status hqbirdrcm。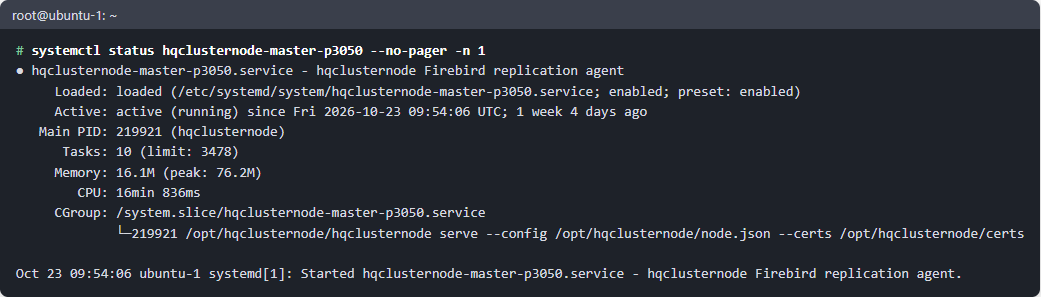
ノードの systemctl status
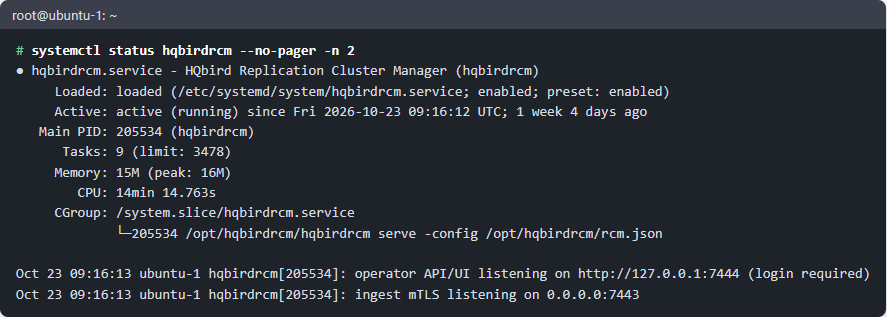
- RCM が応答すること(パスワードなし):
curl http://127.0.0.1:7444/healthz。RCM 経由でインストールした場合(1.3)、コンソールは HTTPS です。curl -k https://127.0.0.1:7444/healthz。 - RCM の 概要 ページにすべてのノードが表示され、「応答しない」の印がないこと。
- RCM ホストのコマンドラインから:
export RCM_USER=rcmadmin RCM_PASSWORD='<password>' ./hqbirdrcm nodes ./hqbirdrcm status - RCM 経由のクラスタ:設定 → クラスタ の 状態 の節。各メンバーが最新リビジョンを適用し、エラーを報告していないこと。コマンドラインでは
./hqbirdrcm cluster status。
1.7. ログ
| 対象 | 場所 |
|---|---|
| ノードのログ | <node.json folder>/logs/node-YYYYMMDD.jsonl |
| ノードサービスの出力(Linux) | journalctl -u hqclusternode-<role>-p<port> |
| RCM サービスの出力(Linux) | journalctl -u hqbirdrcm |
| Firebird のレプリケーションログ | node.json の firebird.replication_log |
| SSH なしで任意のノードのログ | RCM の ログ ページ |
1.8. よくあるエラー
| 表示 | 原因 | 対処 |
|---|---|---|
ノードが起動しない。fbagent_url、fbagent_token、または instance_id に関するエラー |
fbagent が動作していないか、値が agent_config.json と一致しない |
1.4 の手順 1 の curl コマンドで fbagent を確認する |
| インストールスクリプトが終了コード 2 で終わった | fbagent の要求が時間内に承認されなかった | 要求を承認し、スクリプトを再実行する |
| HQCenter Admin 経由でノードが現れない | fbagent がクラスタに入っていないか、クラスタをまだ取得していない | クラスタを確認する(第 2 章)。最大 10 分待つ |
| RCM 上のノードが「応答しない」 | ポート 7051 が閉じている、rcm.json の url が誤っている、アドレスが証明書に入っていない |
ポートと証明書の -hosts を確認する |
| RCM にサインインできない。「失敗したサインイン試行が多すぎます」 | 5 分以内にサインインが 10 回失敗した | 数分待つ |
| 新しいバージョンがインストールされない | そのバージョンが blocked-versions.json にある |
ファイルからそのバージョンの行を削除する |
--cluster-init:no hqbirdrcm to install |
インストーラが RCM のプログラムを残していない | フルインストーラで HQbird をインストールする(1.3、「手動」、手順 1) |
--cluster-join:token_used、token_expired、token_revoked |
トークンは使用済み、24 時間より古い、または失効している | 新しいトークンを作る(1.3、「手動」、手順 4) |
--cluster-join:hostname_conflict |
クラスタに、同じホスト名で別のアドレスの fbagent がある | ホストに別の名前を付ける |
--cluster-join:this agent is in cluster … from goafts |
fbagent はすでに HQCenter Admin のクラスタに入っている | HQCenter Admin のクラスタから外す |
| RCM 経由でノードがインストールされない | RCM にこのプラットフォームのリリースがない | hqbirdrcm release list、リリースをインポートする(1.3、「手動」、手順 5) |
2. クラスタの構成
この章では、クラスタにどのノードが入るか、どのマスターがどのレプリカへセグメントを送るかを定義します。そのあと、RCM のノードとユーザーを構成します。
関係の定義方法は 3 つです。
| ノードのインストール方法 | 関係を定義する場所 | 節 |
|---|---|---|
| HQCenter Admin 経由 | HQCenter Admin:HQ Monitor の クラスタ ページ、または HQCenter Admin API | 2.2 |
| RCM 経由、HQCenter Admin なし | RCM:設定 → クラスタ、hqbirdrcm cluster、または HQ Monitor の クラスタ ページ |
2.3 |
| 手動 | RCM:設定 → RCM と 設定 → ノード | 2.3 |
HQCenter Admin 経由または RCM 経由でインストールしたノードでは、関係の変更は クラスタの記述の中だけで 行います。fbagent はクラスタの記述に従って node.json と rcm.json を上書きします。RCM の 設定 → RCM または 設定 → ノード で関係を編集すると拒否されます(409 cluster_managed)。以前の RCM は受け付けていましたが、失われていました。
2.1. 役割と構成
各ノードの役割は 1 つです。マスター または レプリカ。1 つの Firebird インスタンス上で、マスターとレプリカの 2 ノードを動かせます。
対応する構成:
1 → 1        node-a (master) ──▶ node-b (replica)

1 → N        node-a ──▶ node-b
                    └─▶ node-c

N → 1        node-a ──┐
                      ├─▶ node-b    (one replica for several masters)
             node-x ──┘

Both nodes   host-1: node-1m (master) + node-1r (replica)  ← one Firebird
on a host    host-2: node-2m (master) + node-2r (replica)  ← one Firebird
             node-1m ──▶ node-2r,  node-2m ──▶ node-1r
リンクは常にマスターからレプリカへ向かいます。RCM はマスターのデータベースを、ノード名ではなく データベース GUID でレプリカに結びます。
コンパニオン。 同じ Firebird インスタンス上のマスターノードとレプリカノードはコンパニオンです。レプリカのマスターへの昇格(第 8 章)は、このような組でのみ動作します。rcm.json では、組は同じ host の値で示されます。
2.2. HQCenter Admin 経由のリンク
クラスタを記述する場所
- HQ Monitor のクラスタページ(管理者のみ。構成の配信が有効である必要があります)。通常の方法です。
- HQCenter Admin API:
POST /v1/admin/clustersとPUT /v1/admin/clusters/{id}。HQCenter Admin パネルにクラスタのページはありません。
``
クラスタページでの手順
- 新しいクラスタ ID(小文字のラテン文字、数字、
-)を入力し、作成 をクリックします。 - メンバーを追加します(メンバー)。それぞれに次を指定します。
- ホストの fbagent。
- 役割:
master、replica、またはrcm。 - ホストのアドレス。
- ポート:ノードは
7051(同じホストの 2 つ目のノードは例として7052)、RCM は統計の取り込みポート7443。
- マスターからレプリカへのリンクを追加します(レプリケーションリンク)。
- 検証 をクリックし、そのあと 保存 をクリックします。
別の管理者が同時にクラスタを変更した場合、ページはクラスタの再読み込みと変更のやり直しを求めます。
規則
- 1 つの fbagent が属せるクラスタは 1 つだけです。
- 1 つの fbagent 上では、マスター、レプリカ、RCM、ルーターはそれぞれ 1 つまでです。ルーター(役割
router、HQbird 2027.2.30 以降)にはリンクがなく、ライセンスのシートを消費しません(第 8.7 章)。 - クラスタの RCM はちょうど 1 つ です。RCM ホスト上の fbagent がクラスタの認証局(CA)を運用します。
- メンバー名(
member_id)はラテン文字、数字、-。メンバーの名前、fbagent、役割は変更できません。メンバーを別のホストへ移すには、新しい名前の新しいメンバーを作ります。古い名前は再利用しません。 - すべてのレプリカにはマスターへのリンクが必要です。
- HQCenter Admin はノードのアドレスを自分で組み立てます。
https://<first address>:<port>。 - HQbird 2.5/3.0: クラスタの
replconf_valid_tillの日付(YYYY-MM-DD)を設定します。replconf プラグインの構成がその日付まで有効です。
API での例
{"contract":1,"cluster_id":"shop-prod","name":"Shop","pki":"managed",
 "cert_validity_days":90,"renew_before_days":30,
 "members":[
  {"member_id":"db1-m","agent_id":"<fbagent of host 1>","role":"master","addresses":["db1.lan"],"listen_port":7051},
  {"member_id":"db1-rcm","agent_id":"<fbagent of host 1>","role":"rcm","addresses":["db1.lan"],"listen_port":7443},
  {"member_id":"db2-r","agent_id":"<fbagent of host 2>","role":"replica","addresses":["db2.lan"],"listen_port":7052}],
"links":[{"from":"db1-m","to":"db2-r"}]}- 作成:
POST /v1/admin/clusters(ドキュメントはメンバーと一緒に送れます)。ドキュメント全体の置換:PUT /v1/admin/clusters/{id}。 PUTにはヘッダーIf-Match: <revision>が必要です(リビジョンはGETとETagが返します)。ヘッダーがないと428、古いリビジョンだと409、ドキュメントに誤りがあると422とエラーの一覧です。POST /v1/admin/clusters/{id}/validateは保存せずにドキュメントを検証します。GET /v1/admin/clusters/{id}/statusはメンバーの状態と証明書の期限を表示します。
保存後に起きること
- 各メンバーの fbagent がクラスタを受け取ります。クラスタ内では 60 秒ごとに確認します(RCM ホスト上の fbagent は 30 秒ごと)。クラスタの外にいる fbagent は、次の構成の問い合わせでクラスタを知ります。その問い合わせがサーバーに届かない場合、確認は 10 分ごとに走ります。
- 各 fbagent は鍵を作り、証明書要求を送ります。RCM ホスト上の fbagent が署名します。RCM は要求なしで自分の証明書に署名します。
- fbagent は
node.jsonに、名前、役割、アドレス、peers(リンクから)、RCM のアドレス、証明書のパス、Firebird と fbagent のデータを書きます。rcm.jsonには、ノードの一覧(nodes)、ルーターの一覧(routers)、統計の取り込みアドレス、証明書のパスを書きます。fbagent はファイルのほかのフィールドには手を付けません。 - fbagent はサービスをインストールして起動します(第 1 章)。
クラスタの変更:
| 変わったもの | fbagent の動作 |
|---|---|
動作中のノードの peers だけ |
再起動せずにノードへ渡す |
| ノードのほかのフィールド | ノードを止め、ファイルを書き、ノードを起動する。ノードの windows.transfer_window の中で行う(未設定なら直ちに) |
rcm.json |
RCM を直ちに再起動する |
| 証明書または CA | サービスを再起動する |
| メンバーの削除 | サービスを停止して削除する。cluster-managed.json → cluster-removed.json、プログラム → *.removed。構成、証明書、データは残る |
ノードを削除したあと、共有の replication.conf にはその節 # BEGIN managed-by:<name> … # END … が残ります。手動で削除し、RCM 経由で Firebird を再起動します。
クラスタ証明書の承認
既定では、RCM ホスト上の fbagent が要求に自分で署名します(auto)。手動承認を有効にできます。RCM ホストでのコマンド:
fbagent --cluster-ca-approval manual     # or auto
fbagent --cluster-status                 # this fbagent's membership in the cluster (JSON)
fbagent --cluster-ca-approve <request_id>
manual モードでは、新しいメンバーまたは新しい鍵は承認を待ちます。既知の鍵での証明書更新は自動で署名されます。
2.3. RCM 経由のリンク
RCM のクラスタ(HQCenter Admin なし)
クラスタを HQbird インストーラまたは fbagent --cluster-init コマンドで作った場合(第 1.3 章)、クラスタの記述は RCM が保管します。ホストを足す最も簡単な方法は 設定 → ホストをリンク ページです(第 1.3 章、「RCM でホストをリンク」)。RCM がメンバーとリンクを自分で作ります。規則は HQCenter Admin と同じです(2.2、「規則」)。加えて:
- RCM にはクラスタが 1 つあります。
rcmメンバーは常に存在し、削除できません。 - シート は 3 まで(マスターノードまたはレプリカノードがあるホスト)。超えるとエラー
seats_exceededになります。 - メンバーを追加できるのは、RCM に接続済みの fbagent の上だけです(第 1.3 章:「ホストをリンク」、または「手動」の手順 4)。
設定 → クラスタのページでの手順:
- エージェント 表で、fbagent の行の メンバーを追加 をクリックします。
- 役割(
master、replica、またはrouter)、member_id、アドレス、ポートを指定します。ページは名前<host>-<role>とポートを提案します。最初の fbagent ノードは7051、2 つ目は7061です。ホストの別のメンバーがすでに使っているポートは RCM が拒否します。fbagent のアドレスはボタンです。クリックしてアドレスを追加します。 - リンク の節で、マスターからレプリカへの リンクを追加 をクリックします。
- 検証 をクリックします。RCM はエラーと警告を表示します。
- 保存 をクリックします。ページは変更の一覧を表示し、確認を求めます。メンバーを削除する場合、ウィンドウは赤になります。
保存前の変更はページ上にだけあります(「未保存」のラベル)。誰かが同時にクラスタを保存した場合、ページは再読み込みを提案します。変わったのが RCM のフィールドだけ(リビジョン、CA、委任)の場合、ページは変更を自分で保存します。
ページのほかの節:
| 節 | 内容 |
|---|---|
| ヘッダー | クラスタ名、リビジョン、クラスタ CA とエージェント CA。古い CA の エクスポート ボタン |
| 接続トークン | 新しい fbagent 用のトークンを作る、未使用のトークンを失効させる |
| JSON ドキュメント | テキスト欄のドキュメント全体。検証 と 保存 はこれを使います |
| 鍵と CA | 委任:新しいメンバー鍵(rekey)、新しいクラスタ CA(rotate_ca)、新しいエージェント CA(rotate_agent_ca)。未保存の変更があるときは使えません |
| 状態 | 各メンバーが適用したリビジョン、証明書の期限、サービス、最後のエラー |
RCM ホストの コマンドラインから:
export RCM_USER=rcmadmin RCM_PASSWORD='<password>'
./hqbirdrcm cluster show > c.json        # document with revision
# edit c.json
./hqbirdrcm cluster validate -f c.json   # validate without saving anything
./hqbirdrcm cluster apply -f c.json      # save (If-Match = revision from the file)
./hqbirdrcm cluster agents               # connected fbagents and their members
./hqbirdrcm cluster status               # what the fbagents reported
ドキュメント形式は 2.2 の「API での例」と同じです。古いリビジョンでの apply は 409 になります。show をやり直します。RCM は直近 20 リビジョンを rcm-data/cluster/history/ に保持します。
HQ Monitor。 クラスタ ページは RCM でも動作します。RCM ホスト上では、HQ Monitor はそのホストの fbagent 経由で、fbagent の証明書を使って RCM にアクセスします。RCM のユーザーとパスワードは不要です。RCM の監査ログでは、そのような操作は agent:<id> (<user>) として記録されます。以前の RCM バージョン向けの別の方法:HQ Monitor の構成に rcm_admin_url(http://127.0.0.1:7444)、rcm_admin_user(RCM ユーザー)、rcm_admin_password_file(そのパスワードのファイル)を設定します。
保存後の流れは HQCenter Admin 経由と同じです(2.2、「保存後に起きること」)。RCM は rcm.json の nodes を、再起動なしで自分で読み直します。
fbagent をクラスタから外す: そのメンバーを削除して保存し、エージェント 表で 失効 をクリックします(または ./hqbirdrcm cluster revoke -agent <id>)。戻すには新しいトークンが必要です。失効後、fbagent(バージョン 3.1.0 以降)は自分でクラスタを離れます。ノードを止め、クラスタのデータを削除します。ノードのホストでは fbagent --cluster-leave コマンドが同じことをします。RCM ホストでは拒否されます。
手動インストール:ノードを RCM に追加する
- 設定 → RCM、接続済みノード の表。
- ノードを追加 をクリックします。
node_id、url(https://<address>:7051)、役割、host(Firebird インスタンスのラベル)、server(画面上のグループ化専用)を入力します。 - ノードの行で 検証 をクリックします。RCM は接続と権限を確認します。
- 保存 をクリックします。RCM は
rcm.jsonを書き、古いファイルをrcm.json.<UTC time>.bakとして保存します(直近 20)。 - RCM を再起動します。 再起動までは古い構成が有効です。ページは、再起動を待っているフィールドを表示します。
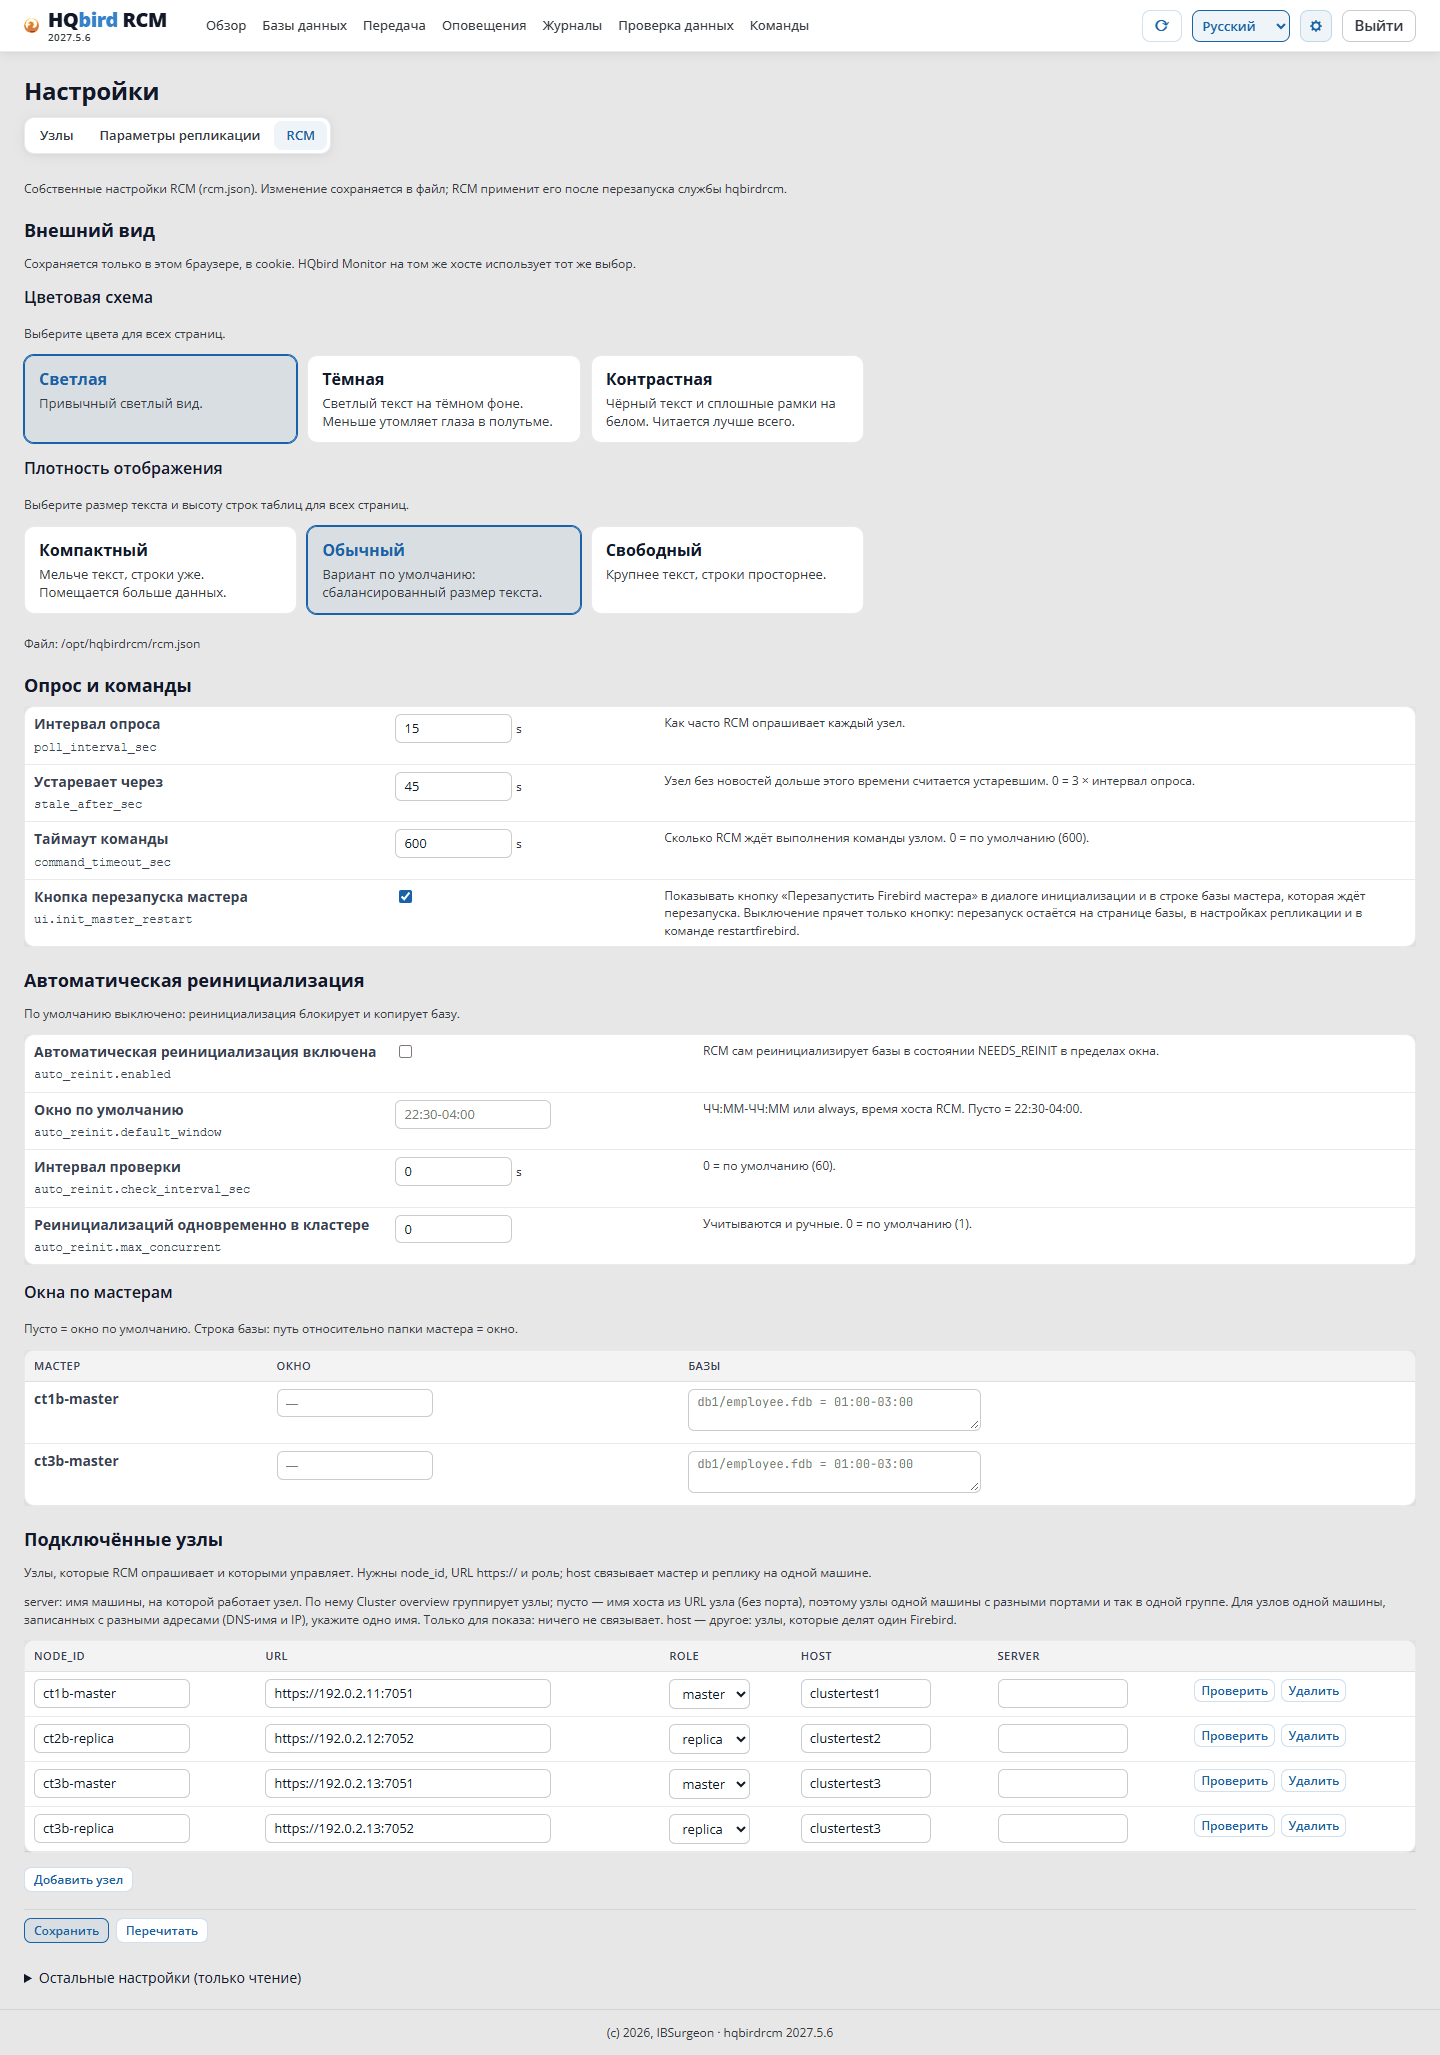
手動インストール:マスターとレプリカをリンクする
リンクは 両側に 記録する必要があります。
- 設定 → ノード でマスターノードを選びます。
- ピア の節で ピアを追加 をクリックします。レプリカの
node_id、そのurl、圧縮(zstd)。 - 保存 をクリックします。RCM は変更の一覧を表示し、確認を求めます。
peersの変更は直ちに有効になります。 - レプリカノードでも繰り返します。そのピアはマスターです。
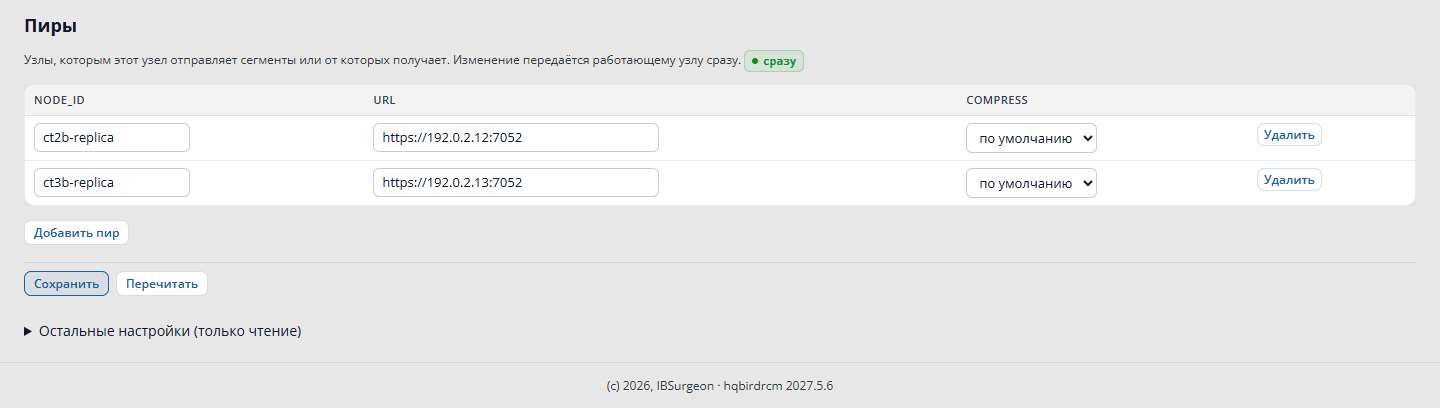
片側にピアが記録されていないと、データベースの初期化時に RCM はそのレプリカノードを提示しません。
2.4. ノードの設定
設定 → ノード は、ノードが RCM からの変更を許可している node.json の設定を表示します。変更されたフィールドだけが、変更一覧のウィンドウのあと保存されます。
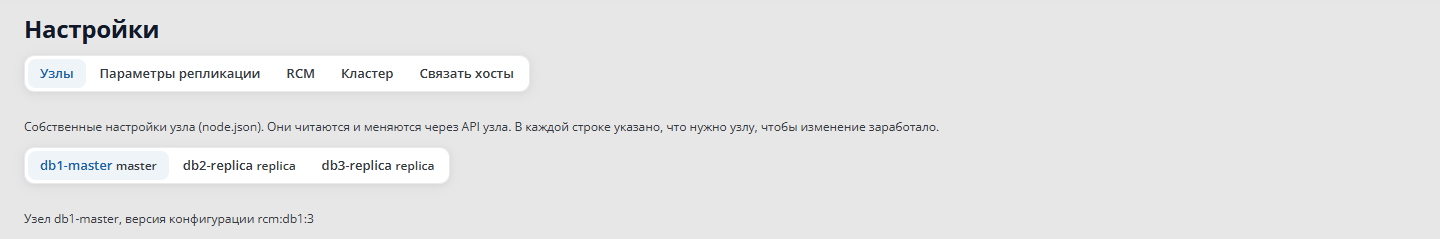
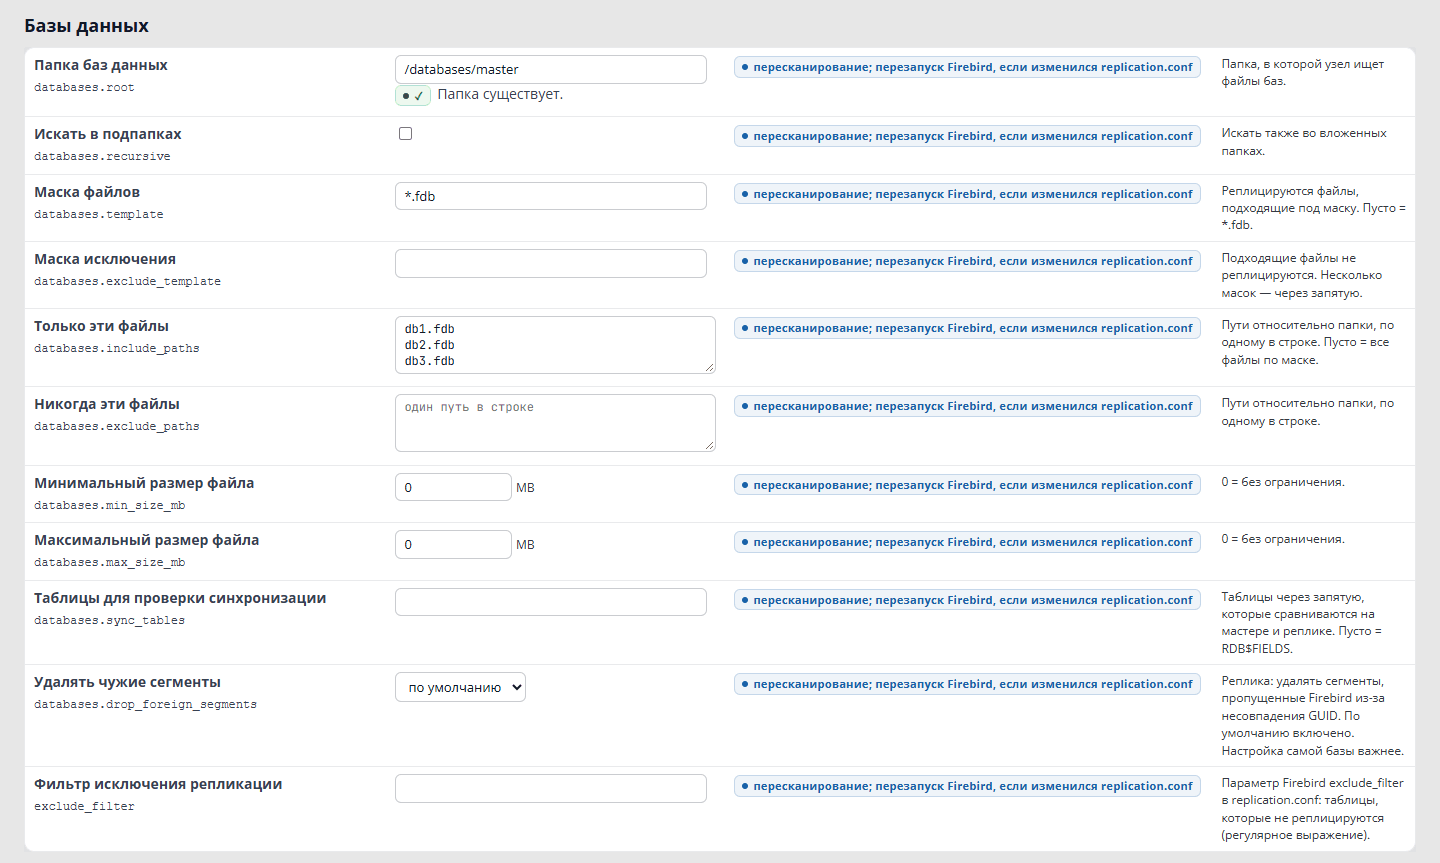
各行には、変更がいつ有効になるかが示されます。
| いつ | どの設定 |
|---|---|
| 直ちに | channel_a_mbps、channel_a_burst_mbps、windows.restart_window、peers。HQbird 2027.2.24 以降はデータ確認の設定(limits.data_check_*)。HQbird 2027.2.31 以降は advertise_addr |
| ノード再起動後 | 残りの上限、windows.transfer_window。ページはノードが再起動するまで、これらを別の行に表示します |
| スキャン後 | databases.*、exclude_filter。replication.conf が変わった場合は Firebird の再起動が必要です(第 3.5 章) |
読み取り専用(ノードホスト上の node.json で変更):firebird(パスワードと auto_restart を含む)、rcm、tls、segments、listen_addr のアドレス。
主な設定:
| 設定 | 既定 | 意味 |
|---|---|---|
windows.restart_window |
マスター 22:00-05:00、レプリカは常時 |
ノードが Firebird を再起動してよい時刻。マスターの Firebird は自分では再起動しません |
windows.transfer_window |
23:00-05:00 |
初期化が reinit_window_mbps の速度で走るウィンドウ |
limits.channel_a_mbps |
50 | セグメント転送速度、MB/s(channel_a_burst_mbps は短期のピーク、200) |
limits.reinit_window_mbps |
100 | 転送ウィンドウ内の初期化速度、MB/s |
limits.reinit_day_disk_fraction |
0.5 | ウィンドウ外の初期化に使う、測定したディスク速度の割合 |
limits.retention_days |
2 | 送信済みセグメントをマスターのアーカイブに何日残すか |
limits.free_space_floor_gb |
1 | 最小空き容量、GB。これを下回るとレプリカはセグメントを受け付けません |
limits.max_concurrent_reinits |
1 | ノードが同時に実行する初期化の数 |
速度とアーカイブの保持の詳細は、第 5 章と第 7 章を参照してください。
firebird.auto_restart(node.json のみ)は、レプリカ ノードが Firebird を自分で再起動してよいかを決めます。
| 値 | 動作 |
|---|---|
auto(既定) |
この Firebird がマスターのデータベースを提供していない場合は可 |
never |
不可 |
always |
この Firebird がマスターのデータベースをホストしていても常に可 |
HQCenter Admin 経由。 fbagent ノードの
windows.transfer_windowは、クラスタが変わったときにノードサービス自身を再起動するウィンドウとしても使われます。node.jsonにウィンドウが設定されていない場合、fbagent はサービスを直ちに再起動します。
2.5. 1 台のホスト上の複数の HQbird インスタンス
fbagent は、自分の構成の firebird.update.services に列挙されたサービスを再起動します。空の一覧は、ホスト上の すべての HQbird サービスを意味します。一覧には自分のインスタンスのサービスだけを残します。ノードはこの設定を見ません。fbagent が複数のインスタンスを知っている場合、ログに警告 fbagent_shared を書きます。
2.6. SYSDBA のパスワード
ノードは node.json の firebird.user と firebird.password のユーザーとパスワードで Firebird に接続します。fbagent はパスワードの独自のコピーを保持します。SYSDBA のパスワードを変更した場合:
- このインスタンスの すべての ノード(マスターとレプリカ)の
node.jsonでfirebird.passwordを修正します。 - fbagent の構成のパスワードを修正し、再読み込みします(fbagent のドキュメントを参照)。
- ノードのサービスを再起動します。
そうしないと、RCM のパブリケーションと確認のページにログインエラー(SQLSTATE 28000)が表示されます。
2.7. RCM のユーザーと監査
- ユーザーはファイル
rcm-data/users.jsonにあります(第 1.5 章)。役割がないユーザーはすべての権限を持ちます。viewerの役割(HQbird 2027.2.31 以降)は閲覧のみです。 - セッションは最後の操作から 12 時間続きます。
- 5 分以内にログインが 10 回失敗すると、そのユーザーとアドレスのログインが一時的にブロックされます。成功したログインはカウンタをリセットします。
- 監査ログはファイル
rcm-data/audit.jsonlです。変更、ログイン、ログアウトごとに JSON が 1 行です。インターフェースに監査ログはありません。 - コマンド ページは各コマンドの実行者を表示します。
2.8. ライセンス
マスターノードは 1 分に 1 回、自分のホストの fbagent ライセンスを読みます。ライセンスがない場合(試用期間の終了、ライセンスの期限切れまたは無効)、ノードはマスター上のすべてのデータベースについて セグメントの送出を停止します。Firebird とデータベースは動き続けますが、レプリカは変更を受け取らなくなります。
RCM で見えるもの:
- マスターが赤(
NEEDS_ATTENTION)になり、「ライセンスなし:送出停止」のバッジが付きます。 - 再開 ボタンはありません。一時停止を解くのはライセンスだけです。
- レプリカ側:「…以降受信なし:マスターにライセンスがありません」。
- ノード 表に「ライセンスなし」のバッジ。設定 → ノード に fbagent のライセンスのブロック。
- アラート
license_pausedとlicense_pause_archive_released。 - 初期化は禁止されます(
license_paused)。
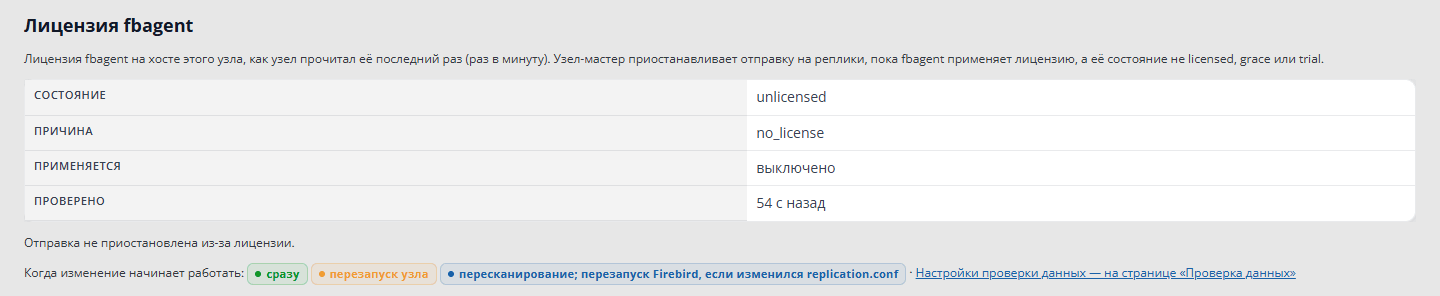
fbagent にライセンスをインストールします。ノードは 1 分以内に自分で一時停止を解除します。マスターは、一時停止の開始から limits.retention_days(既定 2 日)の間、レプリカ用のアーカイブを保持します。それよりあとでライセンスを入れると、レプリカは再度初期化する必要があります。
HQCenter Admin なしの、RCM 経由のクラスタ。 HQCenter Admin のないフローティングライセンスは、online_check_days に猶予日数を加えた期間のあと動作を止めます。クラスタの各 fbagent には バインド ライセンスが必要です(fbagent --license-request、そのあと fbagent --license-install、第 1.3 章「ライセンス」)。試用期間のあと、ライセンスに cluster 機能がなければ、fbagent は新しいノードや RCM を追加しません。更新を禁止することはありません。HQbird 2.5/3.0 では、RCM の replconf_valid_till の日付を、fbagent ノード上のライセンス終了に猶予日数を加えた日より後にはできません(エラー replconf_after_license)。
2.9. 確認方法
-
概要: すべてのノードが存在し、サーバーごとにグループ化されている。
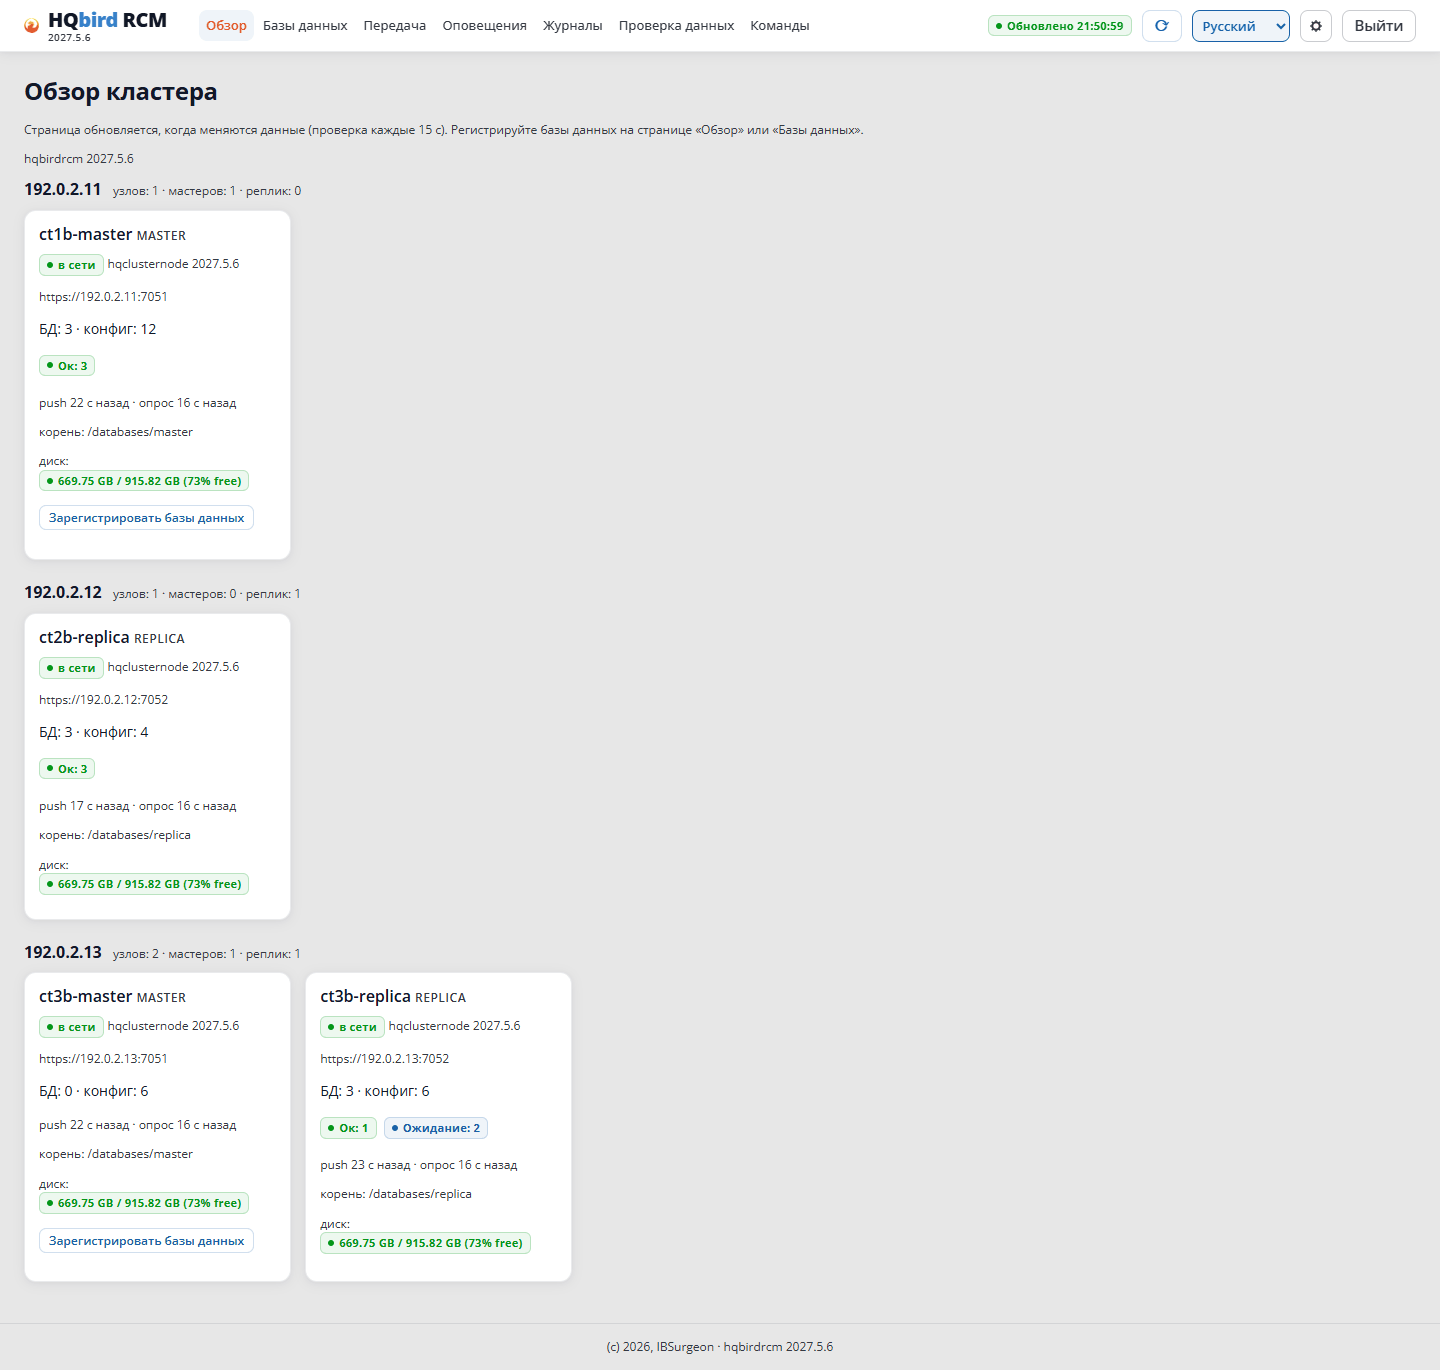
クラスタの概要
- 設定 → ノード: マスターの ピア にレプリカがあり、レプリカにはマスターがある。
- 設定 → RCM: 各ノードの行の 確認 ボタンが通る。
- クラスタレポートを 1 つのファイルとして:
./hqbirdrcm report -o report.json
2.10 よくあるエラー
| 表示 | 原因 | 対処 |
|---|---|---|
RCM でのピア編集が拒否される(409 cluster_managed)、またはノード再起動後に失われる |
ノードが HQCenter Admin 経由または RCM 経由でインストールされた | クラスタの記述でリンクを変更する(2.2、2.3) |
RCM でクラスタを保存するときの seats_exceeded |
4 台目のホストにノードがある | ノードのあるホストは 3 台まで |
設定 → RCM:rcm_config_read_only |
Linux 上の RCM 経由クラスタ:rcm.json の所有者は fbagent |
fbagent ユーザーとして rcm.json を編集し、RCM を再起動する |
失効 がエージェントに対して動作しない(agent_has_members) |
fbagent にメンバーがある | 先にメンバーを削除して保存する |
| 初期化時にレプリカノードが提示されない | 片側にピアが記録されていない | 両側にピアを追加する(2.3) |
| 設定 → RCM の変更が有効にならない | RCM が再起動されていない | RCM を再起動する |
HQCenter Admin でクラスタを保存するときの 422 |
ドキュメントに誤りがある | errors の一覧に従って直し、validate で確認する |
クラスタ保存時の 409 |
ほかの誰かがクラスタを変更した | クラスタを読み直し、再試行する |
| 新しい HQCenter Admin のクラスタメンバーが証明書を受け取らない | RCM ホストで手動承認になっている | fbagent --cluster-ca-approve <id> |
パブリケーションページのエラー SQLSTATE 28000 |
SYSDBA のパスワードが変更された | 2.6 |
3. マスターへのデータベースの追加
この章では、マスターのデータベースがノードの管理下に入ります。ノードはそれを replication.conf に記録し、セグメント用のフォルダを作ります。Firebird を再起動したあと、データベースはレプリケーションの準備ができます。
レプリカの作成は次の手順です(パブリケーション、初期化)。第 4–6 章で説明します。
ボタン名はロシア語の RCM インターフェースに合わせ、英語名を括弧に示します。
3.1. ノードがデータベースを見つける方法
マスターノードは 1 つのフォルダ、データベースのルート(databases.root)の中のデータベースを探します。何を管理下に置くかは規則で決まります。
| 規則 | フィールド | 既定 |
|---|---|---|
| データベースのフォルダ | root |
未設定 |
| サブフォルダを検索 | recursive |
はい |
| 包含マスク | template |
*.fdb |
| 除外マスク | exclude_mask |
なし |
| ファイルサイズ、MB | min_size_mb、max_size_mb |
制限なし(0) |
| データ比較用のテーブル | sync_tables |
HQbird 2027.2.24 ではデータベースのパブリケーションのテーブル。なければ RDB$FIELDS。2027.5.7 では RDB$FIELDS |
| 包含リスト | include_paths |
空(テンプレートモード) |
| 除外リスト | exclude_paths |
空 |
root のパスは ノードホスト上 のパスであり、RCM ホスト上ではありません。ノードは先に包含マスクを適用し、次に除外マスク、そのあとサイズを適用します。
規則はノード全体で共通です。sync_tables の一覧も共有です。確認(第 5.10 章)は、独自の一覧を持たないノードの各データベースで、一覧の各テーブルを探します。
比較用テーブル、HQbird 2027.2.24。 各データベースは独自の一覧を持てます(同期追跡テーブル)。ノードはそれを databases.sync_tables_by_db に保存します。確認は、設定されている最初の一覧を使います。
- そのデータベース自身の一覧。
- ノード共有の
sync_tables一覧。 - データベースのパブリケーションのテーブル。
RDB$FIELDS。
以前に保存した共有一覧はパブリケーションより優先されます。独自の一覧がないデータベースはそれを使います。マスターのデータベースページは、現在どの一覧が有効かを表示します(3.3)。
プライマリデータベースとレプリカの両方にないテーブルは、状態「データベースにない」(absent)になります。比較されず、それのために確認が「異常」になることはありません。片側にだけ欠けているテーブルは不一致です。
RCM とノード 2027.5.7。 ノード全体で一覧は 1 つです(sync_tables)。一覧がない場合、確認は RDB$FIELDS を使います。欠けているテーブルはエラーで、データベースの確認は「異常」になります。
すべての規則はノードの node.json に保存されます。ノードはスキャンのたびにそれらを適用します。
テンプレートモードとリストモード:
- テンプレートモード(包含リストが空):ノードは、除外されたものを除き、マスクに合うすべてのファイルを取ります。フォルダ内の 新しいファイル は、次のスキャンでノードが自動的に拾います。
- リストモード(包含リストが空でない):ノードは一覧のファイルだけを取ります。新しいファイルは自動では管理下に 入りません。追加が必要です。
フォルダにデータベースのコピー、テスト用データベース、レプリケーション不要のほかのファイルがある場合は、リストモードを選びます。
3.2. 始める前に:権限を確認する
Firebird とノードが動作するユーザー(Linux では firebird、Windows では LocalSystem)には、次への読み書き権限が必要です。
- データベースのルートフォルダとデータベースファイル。
replication.confとそのフォルダ(ノードは一時ファイル経由でファイルを置き換えます)。- セグメントフォルダ
<database>.ReplLogと<database>.LogArch(ノードが自分で作ります)。
RCM は登録の前に権限を確認します(事前確認)。確認に失敗すると、コマンドはエラー preflight failed on <node> とパスの一覧で終了します。
ノードホストでの確認(Linux):
sudo -u firebird /opt/hqclusternode/hqclusternode checkpermissions -config /opt/hqclusternode/node.json3.3. データベース登録ページ
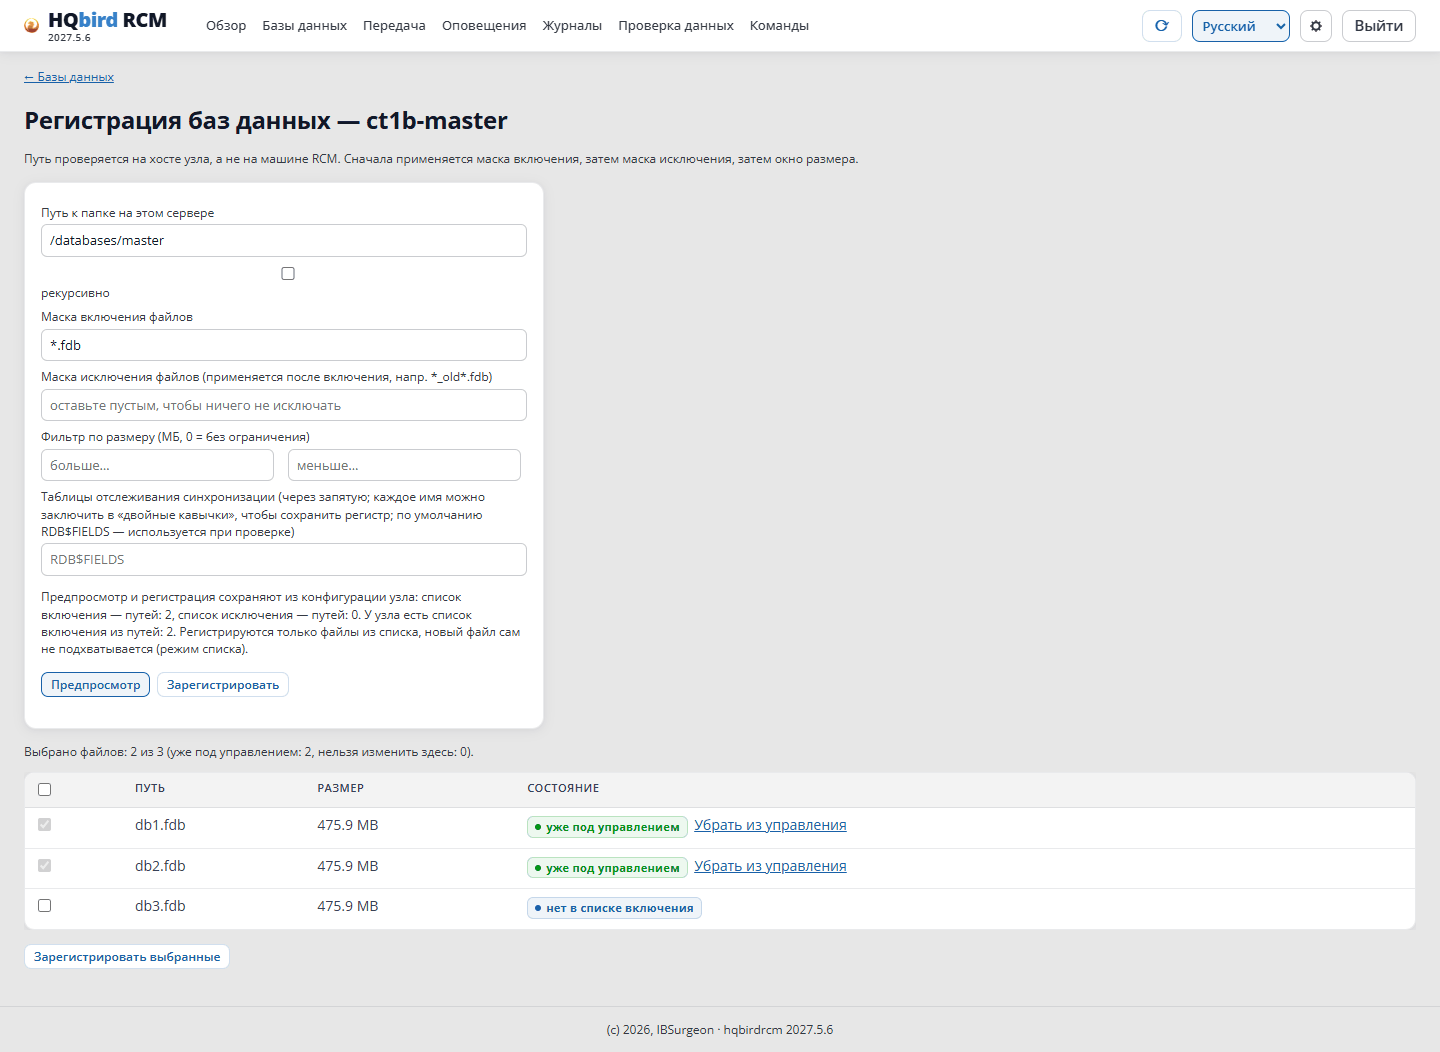
-
マスターノードの登録ページを開きます。リンクは 2 か所にあります。
- データベース → ノード 表 → 操作の列 → 登録。
- 概要 → マスターノードのカード → データベースを登録。
レプリカノードにはこのページはありません。
-
フォームはノードの 現在の 規則を表示します(ノード自身が送ったものです)。ノードが応答しない場合、プレビューと登録のボタンは無効です。現在の規則がないと、包含リストと除外リストをリセットしてしまうからです。
-
フィールドを入力または修正します。このサーバー上のフォルダのパス、再帰、マスク、サイズフィルタ、同期追跡テーブル。
同期追跡テーブル フィールド:
- HQbird 2027.2.24 以降 — 一覧は、この操作が登録する データベースごと です。空のフィールド:データベースは自分のパブリケーションのテーブルを使います。登録はノード共有の一覧(
sync_tables)を変えません。それがある場合、フォームはその旨を示します。独自の一覧がないデータベースは、パブリケーションではなくそれを使います。すでに管理下のデータベースの一覧は、そのページで設定します。データベース → マスターのデータベース → 同期追跡テーブル のブロック。ブロックは現在有効な一覧を表示します。空のフィールドはそのデータベース自身の一覧を外します。 - RCM とノード 2027.5.7 — ノードのすべてのデータベース 向けの単一の一覧(
sync_tables)。
- HQbird 2027.2.24 以降 — 一覧は、この操作が登録する データベースごと です。空のフィールド:データベースは自分のパブリケーションのテーブルを使います。登録はノード共有の一覧(
-
プレビュー をクリックします。ノードは包含マスクに合うすべてのファイルを表示します。何も変更しません。
-
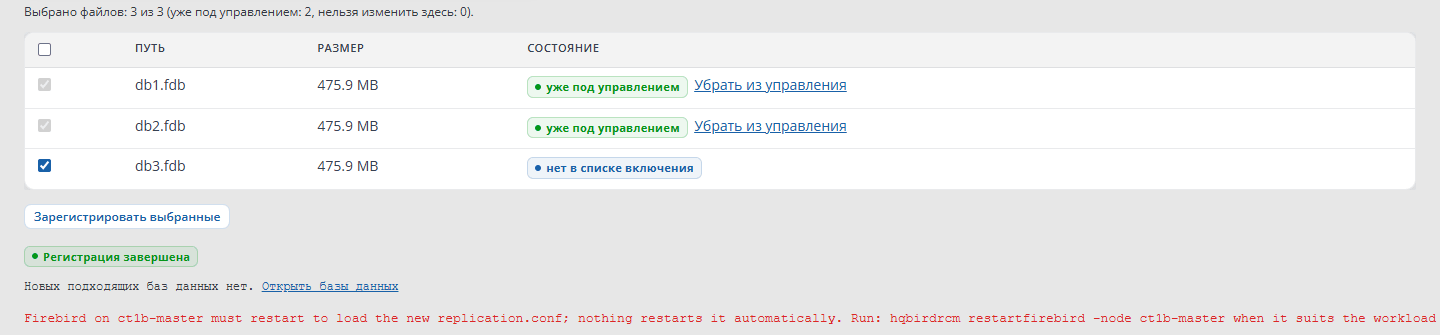
一覧を確認します。各ファイルにチェックボックスがあります。
- チェックあり — ファイルは管理されます。
- チェックあり、ロック、管理済み の印 — データベースはすでに登録されています。
- 理由付きでロック — ファイルはマスク、サイズ、または除外リストで除外されています。取り込むには規則を変えます。
-
必要なデータベースをチェックし、選択項目を登録 をクリックします。RCM は確認を求め、ファイル数を表示します。
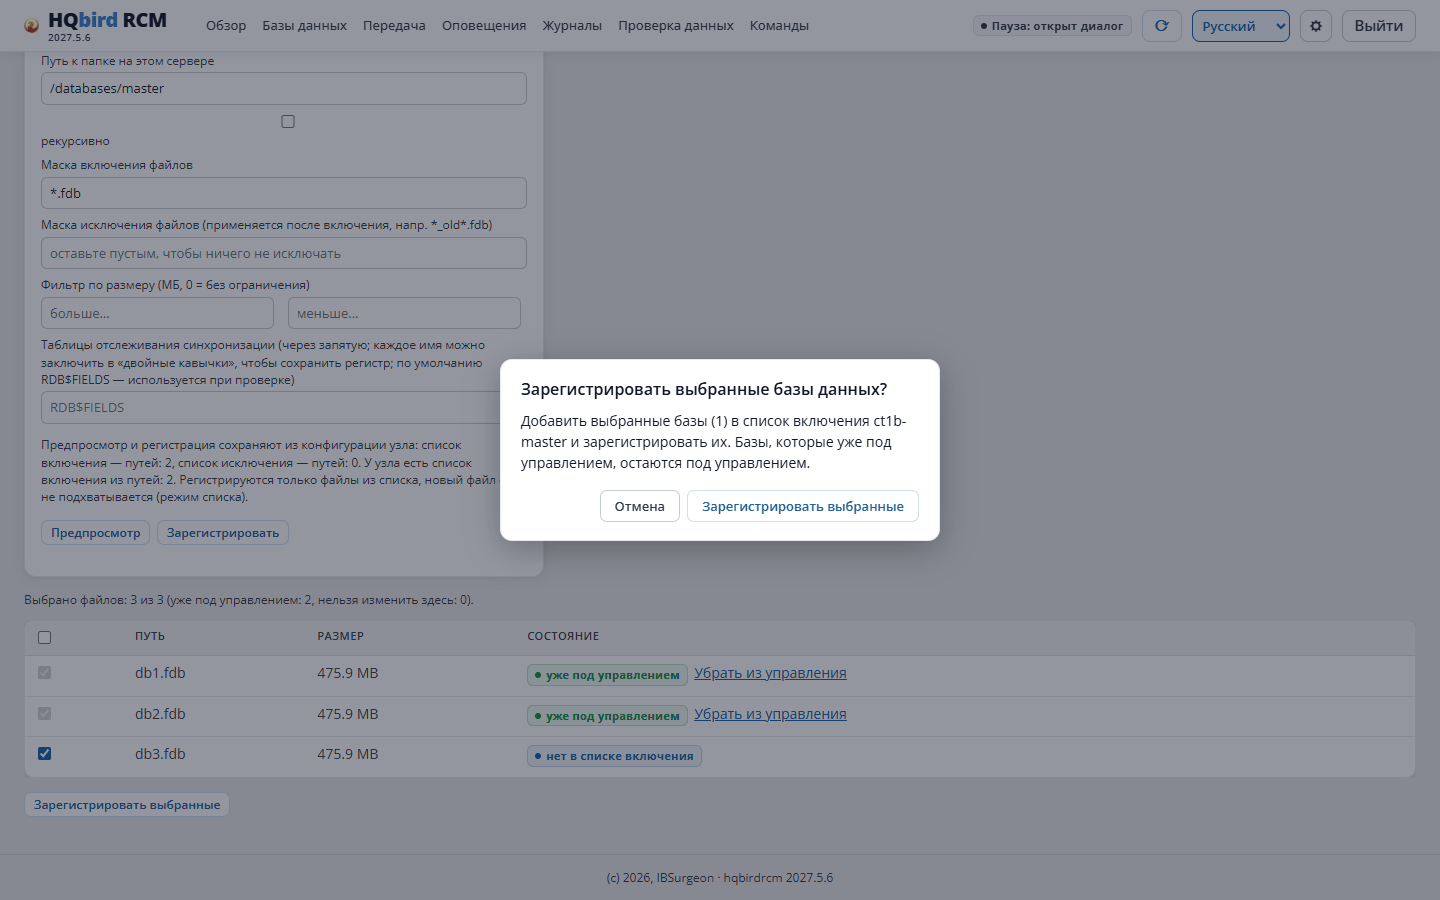
このボタンが行うこと:
- テンプレートモード — チェックのないファイルは除外リストに追加され、チェックのあるファイルはそこから外されます。
- リストモード — チェックのあるファイルは包含リストに追加されます。
このボタンは、すでに管理下のデータベースに 追加 します。ロックされた行は変えません。 7. 登録 ボタンは、リストを変えずにフォームを適用します。 8. 完了メッセージと、追加されたデータベースの数を待ちます。長い間応答がない場合は、コマンド ページで結果を確認します。
HQbird 2027.2.24 以降のメッセージは「登録:N」です。マスターの Firebird の再起動が必要な場合、RCM は押すボタンを示します(通常はデータベースの行の マスターの Firebird を再起動)し、マスターのデータベースへのリンクを出します。RCM 2027.5.7 は、データベースが追加されていても「適した新しいデータベースはありません」と言うことがあります。データベース ページを確認します。
登録後にデータベースが見つからず、ノードにすでにデータベースがあった場合、ノードは拒否し(409)、古い規則を返します。こうしてパスの誤りが、すべてのデータベースのレプリケーションを止めないようにします。
コマンドラインからも同じ操作
hqbirdrcm enroll-databases -node node-a -root /databases/master注意:このコマンドは、パラメータにあるフィールドだけを送ります。残りの規則(マスク、サイズ、包含リストと除外リスト、
sync_tables)はノードによって リセットされます。これらの規則用のパラメータはありません。コマンドを実行する前に、現在の規則を確認します(hqbirdrcm getconfig -node node-a)。設定されている場合は、登録ページを使います。
3.4. 登録後に起きること
- ノードは規則を
node.jsonに書きます。 - ノードはフォルダをスキャンします(scansync)。
- 見つかった各データベースについて、ノードは
replication.confの 自分の 領域(行# BEGIN managed-by:node-a role:masterと# END …の間)にブロックを書き、フォルダ<database>.ReplLogと<database>.LogArchを作ります。ノードは自分の領域の外のテキストを変更しません。 - 変更の前に、ノードはファイルのコピーを保存します。
replication_YYYYMMDD_hhmmss_NNN.conf。 replication.confが変わった場合、データベースはPENDING_RESTART状態に入ります。Firebird が新しいファイルを読むのは再起動のあとだけです。ノード 表では、これは 再起動待ち 列に表示されます。
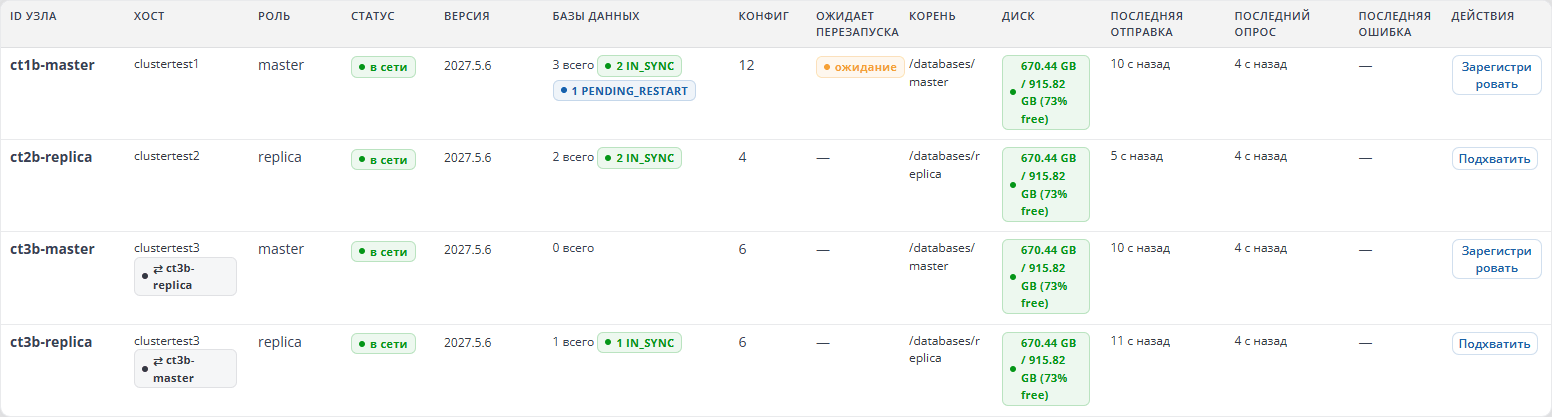
新しいデータベースの状態:
| 状態 | RCM のグループ | 意味 |
|---|---|---|
UNCONFIGURED |
保留 | データベースは見つかったが、構成はまだ書かれていない |
PENDING_RESTART |
保留 | 構成は書かれた。Firebird の再起動が必要 |
CONFIGURED |
保留 | Firebird は再起動済み。データベースはパブリケーションと初期化の準備ができている |
3.5. マスターの Firebird の再起動
マスターノードは Firebird を自分では再起動しません。RCM も同様です。 マスターの再起動はオペレータの判断です。再起動は、その Firebird インスタンスの すべての データベースへの接続を切断します。
負荷の低い時刻を選び、次のいずれかのボタンをクリックします。
- マスターの Firebird を再起動 — データベース ページで、再起動を待っているデータベースのマスターの行。
- 初期化 ウィンドウの同じボタン。第 5 章。
- Firebird を再起動 — データベースのページ。
RCM は確認を求めます。ノード名と警告を表示します。Firebird は再起動ウィンドウを待たずに直ちに再起動し、すべての接続が切断されます。
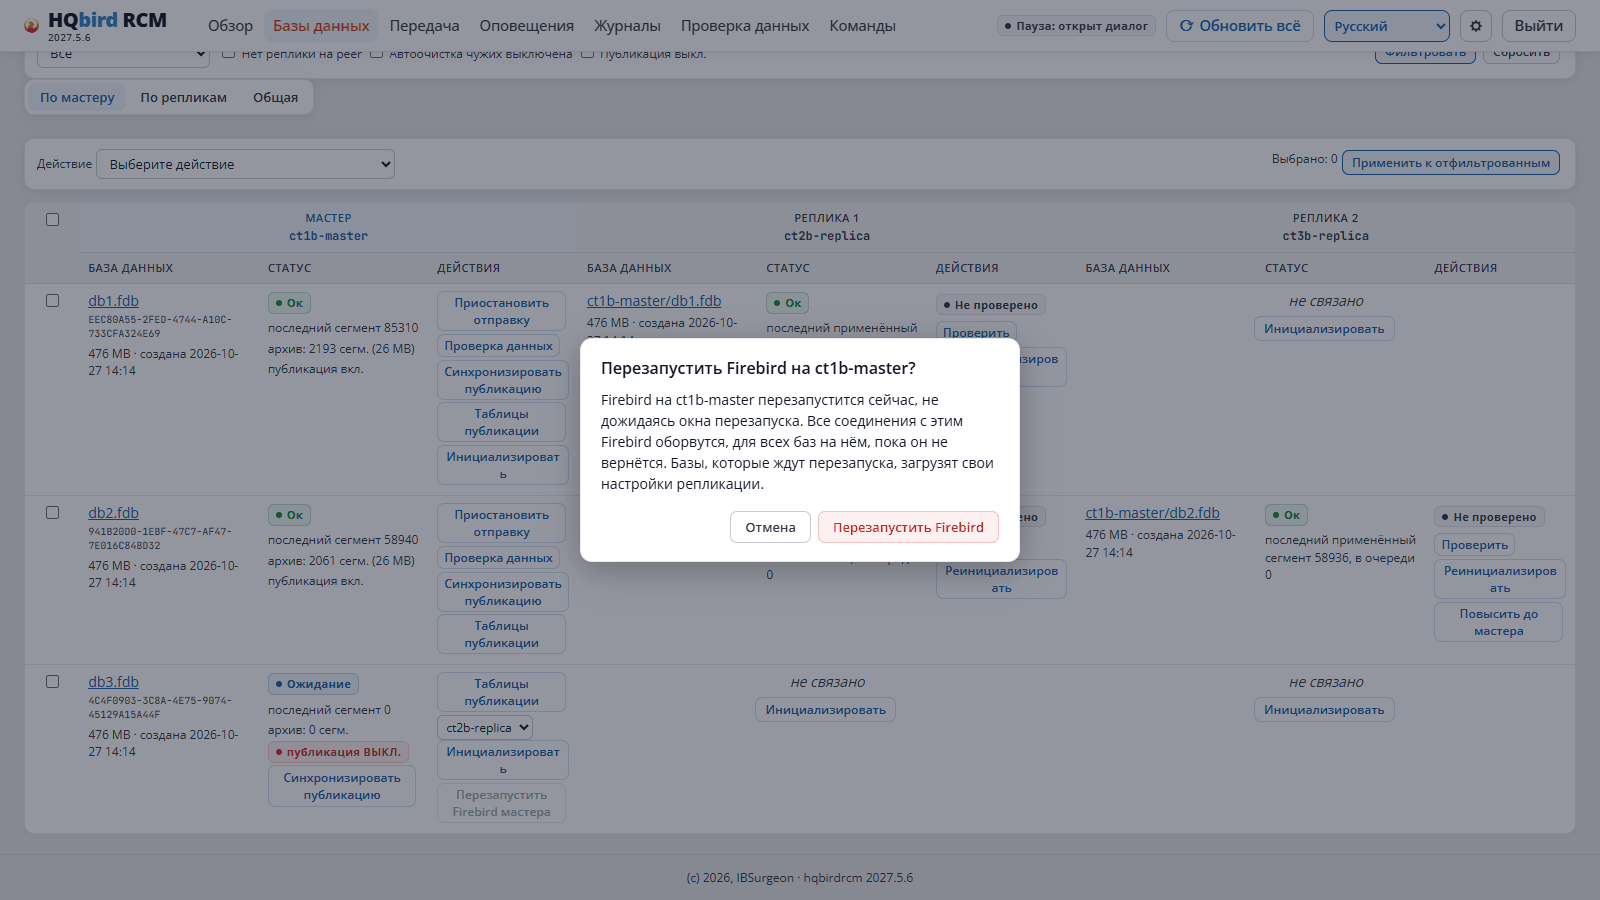
コマンドラインからも同じ操作
hqbirdrcm restartfirebird -node node-aこのコマンドも、再起動ウィンドウを待たずに直ちに再起動します。
ノードが Firebird を再起動する方法:
- fbagent が応答し、同じ インスタンスを管理していることを確認します(
node.jsonの識別子、ポート、サービス名)。いずれかが一致しなければ、ノードは拒否します。 - fbagent に Firebird の再起動を依頼します。
- Firebird が自分のポートで応答するのを待ちます。
- データベースを
PENDING_RESTARTからCONFIGUREDへ移します。
1 台のホストに複数の HQbird インスタンス。 fbagent は、自分の構成の
firebird.update.servicesに列挙されたサービスを再起動します。空の一覧は、ホスト上の すべての HQbird サービスを意味します。ホストに HQbird インスタンスが 2 つある場合、一覧には自分のインスタンスのサービスだけを残します。そうしないと、一方のノードの再起動がもう一方のインスタンスも止めます。
Windows の場合。
replication.logがlog_portion_mb以上に成長している場合、再起動は次の順です。Firebird を停止 → ログをアーカイブ → 起動。
3.6. すでに手動でレプリケーションされているデータベース
データベースのレプリケーションがすでに手動で構成されている場合(replication.conf に独自のブロック、パブリケーション有効、セグメントが流れている)、レプリカを再初期化 せずに 管理下に入れられます。そのための detect_existing モードがあります(マスターのみ)。
- プレビューを実行します。
応答の
hqbirdrcm enroll-databases -node node-a -root /databases/master -detect-existing -dry-runtaken_overは、移行されるデータベースの一覧です。-verboseを足すと、スキップされたデータベースと理由が見えます。 - 一覧が正しければ、
-dry-runなしでコマンドを実行します。
ノードがブロックを移行するのは、次の場合だけです。
- セグメントフォルダの名前が正確に
<database>.ReplLogと<database>.LogArchである。 - アーカイブにすでにセグメントがある。
- データベースでパブリケーションが有効である。
ノードはパスが異なるブロックを移行せず、「見つかったが未対応」と報告します。
移行後、データベースは PENDING_RESTART になります。レプリケーション設定は変わっていません。変わるのはファイル内のブロックの位置だけです。保守ウィンドウで Firebird を再起動します。
3.7. 確認方法
-
データベース: データベースがマスターノードの行に見え、状態は
CONFIGURED(再起動後)。 -
データベースの隣に パブリケーション無効 のアイコンがあることがあります。パブリケーションはまだ有効ではありません。これは正常で、パブリケーションは次の手順です(第 6 章)。
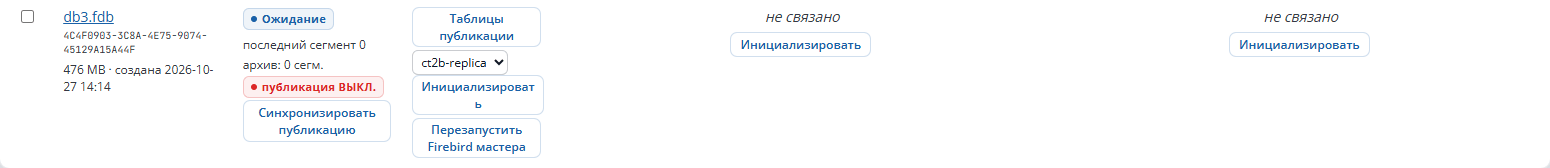
マスターの行の新しいデータベース
- ノードホスト上:
replication.confのmanaged-by:node-a領域にデータベースのブロックがあり、データベースの隣に.ReplLogと.LogArchのフォルダがある。
3.8. データベースを管理から外す
通常の方法はボタンです。 データベース ページでデータベースにチェックを入れ、一括操作 管理から外す を選び、選択項目に適用 をクリックします。RCM は次を行います。
- ファイルをノードの除外リストに追加します。
- フォルダを 1 回スキャンします。データベースのブロックが
replication.confから削除されます。 - ノード内のデータベースの記録を削除します。
データベースファイルとセグメントフォルダはディスクに残ります。Firebird は再起動されません。Firebird は次の再起動まで、そのデータベースのセグメントを書き続けます。再起動が必要なら RCM が知らせます。
生きているレプリカを持つマスターデータベースに対して、RCM は拒否します(has_replicas)。そうしないとレプリカが黙って止まるからです。先にレプリカを通常のデータベースにするか、削除します(第 8 章)。
replication.conf からデータベースのブロックを手動で削除しないでください。次のスキャンでノードが再び書きます。
データベースファイルが消えた、または規則で除外された場合。 データベースは状態 ORPHANED(孤立グループ)になります。ノードは記録とセグメントアーカイブを保持します。データベースの欠落は、決定であるより誤りのことが多いからです。ファイルが戻ればデータベースは再び動作し、アラートは消えます。そのようなデータベースを恒久的に削除するには、この順序 で 2 つの手順を実行します。
# 1. delete the segment archive (optional)
hqbirdrcm cleanuparchive -node node-a -db <db_id> -orphaned
# 2. delete the database record
hqbirdrcm forgetdatabase -node node-a -db <db_id>
forgetdatabase のあと、cleanuparchive コマンドはそのデータベースを見つけられなくなります。どちらのコマンドも ORPHANED 状態のデータベースにだけ動作し、データベースファイルには手を付けません。
注意。 レプリカをマスターへ昇格したあと(第 8 章)、古い記録に対して
cleanuparchive -orphanedを実行しないでください。新しいマスターは同じ.LogArchフォルダを使っており、コマンドはその稼働中のアーカイブを削除します。
3.9. データベースのルートの変更
別のパスでの登録は許可されています。ノードは次を行います。
- 新しいフォルダからデータベースを追加します。
- 新しいフォルダにない古いフォルダのデータベースを
ORPHANEDに移し(通知orphaned_database)、そのアーカイブを保持します。
誤ったフォルダを選んだ場合は、正しいフォルダを再度登録します。同じフルパスのデータベースは、同じ db_id のまま動作し続けます。別の パスのデータベースは新しいデータベースです(新しい db_id)。そのレプリカは再度初期化する必要があります。
3.10. よくあるエラー
| 表示 | 原因 | 対処 |
|---|---|---|
preflight failed on node-a |
フォルダの権限がない | 権限を直し、再試行する(3.2) |
409 scan_would_empty_region |
新しいフォルダにデータベースがないが、ノードにはあった | パスとマスクを確認する |
| プレビューが空 | マスクが一致しないか、フォルダが誤っている | パス、マスク、「再帰」を確認する |
| ボタンが無効、「ノード構成の読み取りに失敗しました」 | ノードが応答しない | ノードのサービスとネットワークを確認する(第 1 章) |
データベースが長い間 PENDING_RESTART のまま |
マスターは Firebird を自分では再起動しない | Firebird を再起動する(3.5) |
| fbagent を理由に再起動が拒否される | fbagent が動作していないか、そのデータが node.json と一致しない |
第 1 章、fbagent の確認 |
| 新しいファイルが現れない | ノードがリストモードである | 「選択項目を登録」でファイルを追加する |
4. データベースをレプリカにする方法:手順とディスク上の場所
この章は、データベースがプライマリから動作するレプリカになるまでの全体と、ディスク容量の計算を扱います。初期化そのものは 第 5 章 で詳しく説明します。
4.1. 大原則
レプリカ上にデータベースが現れるのは、マスターからの初期化(reinit)だけ です。マスターノード自身が nbackup 経由でコピーを転送します。
手動でコピーを作らないでください。
- gbak は新しいデータベース GUID を作り、セグメント番号をリセットします。マスターとレプリカの結び付きが切れます。
- 動作中のデータベースの ファイルコピー は一貫性がなく、RCM は同じ GUID のデータベースが 2 つあると見て(
duplicate_guid)、初期化を禁止します。
すでに動作している、手動で構成したレプリカは、新しいコピーなしで管理下に入れられます。4.6 を参照してください。
4.2. 段階
| 番号 | 段階 | 場所 | 段階後のマスターデータベースの状態 |
|---|---|---|---|
| 1 | マスターへのデータベースの登録 | 第 3.3 章 | PENDING_RESTART |
| 2 | マスターの Firebird の再起動 | 第 3.5 章 | CONFIGURED |
| 3 | パブリケーションの同期 | 第 6 章 | CONFIGURED、パブリケーション有効 |
| 4 | レプリカの準備:フォルダ、権限、Firebird のバージョン | 4.3 | — |
| 5 | マスターとレプリカの空き容量の確認 | 4.4 | — |
| 6 | 初期化 | 第 5 章 | SEEDING → IN_SYNC |
| 7 | レプリカの Firebird の再起動(必要な場合) | 第 5.6 章 | レプリカがセグメントの適用を始める |
| 8 | データの確認 | 第 5.10 章 | — |
段階 3 は Firebird 4/5 では必須です。 パブリケーションがないと、マスターの Firebird はテーブルの変更をセグメントに書かず、レプリカは黙ってマスターから遅れます。データベース ページでは、そのようなデータベースに パブリケーション無効 のアイコンが付きます。初期化の前に パブリケーションを同期(パブリケーションの同期)をクリックします。
HQbird 2027.2.24 以降、初期化 ウィンドウはこれを警告し、パブリケーションを同期して初期化 ボタンを提示します。マスターノードはエラー publication_off で初期化を拒否します(第 5.1 章)。RCM とノード 2027.5.7 はパブリケーションを確認しません。
HQbird 2.5/3.0。 パブリケーションはないため、段階 3 は飛ばします。テーブルの集合は replconf プラグインのフィルタで定義されます(第 6 章)。
データベースの状態:
| 状態 | RCM のグループ | 意味 |
|---|---|---|
CONFIGURED |
保留 | Firebird は設定を読んだ。レプリカはまだない |
PUBLISHING |
保留 | パブリケーションの同期が進行中 |
SEEDING |
保留 | 初期化が進行中 |
IN_SYNC |
正常 | レプリカはすべてのセグメントを受け取った |
LAGGING |
保留 | レプリカが遅れており、セグメントがキューにある |
NEEDS_REINIT |
エラー | レプリカを再度初期化する必要がある |
FAILED |
エラー | 最後の初期化が失敗した |
4.3. レプリカの準備
レプリカのデータベースフォルダ
レプリカノードは、各データベースを自分の databases.root フォルダ内の次のパスに置きます。
<databases.root>/<master node name>/<database path relative to the master root>例:マスター node-a のルートが /databases/master、データベースが /databases/master/sales/employee.fdb。ルートが /databases/replica のレプリカ node-b では、データベースはここになります。
/databases/replica/node-a/sales/employee.fdbこうして、異なるマスターからの同名データベースは衝突しません。
ルートフォルダを自動で作るものはありません。 インストーラも、HQCenter Admin も、起動時のノードも作りません。次のいずれかで作ります。
- 初期化 ウィンドウ:レプリカフォルダ フィールドと フォルダを作成 ボタン。ボタンはフォルダが存在しないときだけ見えます。HQbird 2027.2.24 では、レプリカノードにまだ
databases.rootがない場合、フィールドにはすでに/databases/replica/<replica node id>が入っています。Windows 上のレプリカではフィールドは空です。ドライブ文字付きのフォルダを入力します。同じホスト上の各レプリカノードには専用のフォルダが必要です。フォルダを作るのはレプリカノードです。所有者はfirebird(またはノードサービスのユーザー)、権限は2770。ノードが作れない場合、ウィンドウはレプリカホスト用のコマンドを表示します。別のフォルダを指定すると、RCM は初期化の前にそれをレプリカノードのdatabases.rootに書きます。 - レプリカホスト上で手動(Linux):
sudo mkdir -p /databases/replica sudo chown firebird:firebird /databases/replica sudo chmod 2770 /databases/replicasetgidビット(2770)は、中のすべてのファイルが Firebird グループになるために必要です。
レプリカのルートを変えられるのは、そこにデータベースがない間だけです。そうでないと、古いデータベースがスキャンの外に出ます。1 つのデータベースだけを別の場所に置くには、データベースページの 移動 を使います。
権限
レプリカノードと Firebird は、データベースのルートに書き込める必要があります。ノードは、置かれたファイルがフォルダのグループを得ることを確認します。得られない場合、ownership_unfixable と直し方の文章で拒否します(通常、ノードサービスが Group=root で動作しています)。
HQbird 2027.2.24 では、初期化 ウィンドウは、存在するがノードサービスが書き込めないフォルダも表示します。直しのコマンド付きのノードの文章と、再確認 ボタンです。この場合の RCM 2027.5.7 は「フォルダは存在します」と言います。権限は自分で確認します(hqbirdrcm checkpermissions -node <replica> -root <folder>)。
Firebird のバージョン
レプリカの Firebird のメジャーバージョンはマスターと一致している必要があります(5.0 → 5.0、4.0 → 4.0)。一致しない場合、レプリカはデータを転送する前に拒否します。incompatible_engine。
接続
レプリカノードはマスターのピアであり、マスターはレプリカのピアである必要があります(第 2 章)。そうでないと、RCM は 初期化 ウィンドウでこのノードを提示しません。
4.4. 必要な容量
要約
| 場所 | 対象 | 量 |
|---|---|---|
| マスター、データベースのボリューム | 初期化前の空き | データベースサイズの 105 % 以上 |
| レプリカ、データベースフォルダのボリューム | 初期化前の空き | データベースサイズの 105 % 以上。HQbird 2027.2.24 ではさらに free_space_floor_gb(レプリカがすでに存在する場合は古いファイルも。古いレプリカを削除 のチェックボックスを使う場合はそれを除く) |
マスター、<database>.ReplLog |
Firebird の作業セグメント | 最大 64 セグメント × セグメントサイズ(既定 16 MB)≈ データベースあたり 1 GB |
マスター、<database>.LogArch |
レプリカ向けセグメントのアーカイブ | retention_days の期間の変更(既定 2 日)+レプリカがまだ確認していない分 |
レプリカ、<database>.Incoming |
適用待ちセグメントのキュー | 最大 256 セグメント × 16 MB ≈ 最悪の場合データベースあたり 4 GB |
| レプリカ、ボリューム全体 | 余裕 | 少なくとも free_space_floor_gb(既定 1 GB) |
初期化前の容量確認
初期化は容量を 2 回 確認し、それはデータベースをロックする 前 だけです。
- RCM — コマンドを送る前に、最新のノード統計から。容量が明らかに足りなければ、RCM は直ちにエラー
507を返します。 - マスターノード — 自分のボリュームで実測し、そのあとレプリカに自分のボリュームを測るよう依頼します。少なくとも片側が足りなければ、初期化は 容量確認 の手順でエラー
insufficient disk space on masterまたは… on replicaで終わります。
両側の要件は マスターのデータベースサイズの 105 % です。
HQbird 2027.2.24 では、レプリカノードは次のように計算します。
- 必要なのはデータベースサイズの 105 % に加えて レプリカの
free_space_floor_gb(7.3)です。初期化後もボリュームにセグメント用の余裕が残ります。 - 以前の初期化の残り(
<database>.hqcluster-part、<database>.new)は空き容量として数えます。ノードは新しいコピーの前にそれらを削除します。 - エラーの文章はすべての数値を挙げます。ファイル
<database>.pre-reinit-*.fdbと<database>.failed-seed-*.fdbとそのサイズも挙げます。ノードはそれらを決して削除しません。不要なら自分で削除します。
force(強制)が飛ばすのは RCM 内の確認だけです。ノードの確認は回避できません。コピーの途中でディスクが尽きることからノードを守るためです。容量不足の理由が古いレプリカコピーだけである場合、RCM 2027.2.24 はエラー 507 で force ではなく 古いレプリカを削除 のチェックボックスを挙げます。このためには、両方のノードが HQbird 2027.2.24 以降である必要があります。そうでなければ、エラーは更新が必要なノードと force を挙げます。
なぜこれだけ必要か
マスター。 コピー中、データベースは nbackup -L でロックされます。すべての変更はデータベースの隣の <database>.delta ファイルに書かれます。.delta のサイズはコピー中の書き込み負荷によります。高負荷で転送が遅いと大きく成長することがあります。最初の初期化では容量を監視します。
レプリカ。 コピーはデータベースの場所の隣の <database>.hqcluster-part ファイルへ直接書かれます。ノードはあらかじめ全サイズを予約します。そのあとファイルは検査され、修復され(nbackup -FIXUP -SEQUENCE)、所定の場所へリネームされます。2 つ目のコピーは不要です。データベースサイズが必要なのは、データベースのボリューム上で 1 回です。
レプリカが すでに存在した 場合(再初期化)、古いファイルは最後の手順までディスクに残ります。つまり古いファイルと新しいコピーが同時にボリューム上に必要です。空き容量は古いファイルを除いて計算されます。そのため要件は同じです。データベースサイズの 105 % の空き。
古いレプリカを削除(HQbird 2027.2.24)。レプリカのボリュームに、古いコピーの隣に新しいコピーを置く容量がない場合、初期化ウィンドウでこのチェックボックスをオンにします(第 5.1 章)。レプリカノードは転送の前に古いコピーと受信セグメント(.Incoming)を削除し、ボリュームにはデータベースサイズの 105 % に free_space_floor_gb を加えた分が足ります。ノードがコピーを削除するのは、すべての条件が真のときだけです。
- 削除しなければ容量が足りず、削除すれば足りる。
- このノードの初期化が置いたコピーである。ヘッダーが読め、モードは読み取り専用レプリカ。
- データベースが通常化されていない(
<database>.hqcluster-normal.jsonファイルがない、第 8 章)。 overwrite_non_replicaが設定されていない(5.9)。
そうでなければノードは何も削除せず、理由を文章に書いて拒否します。削除のために、ノードは削除の間レプリカの Firebird を止めます(5.6)。
チェックボックスは既定でオフです。リスク: 転送の間、レプリカ上にデータベースのコピーがありません。データベースのレプリカが 1 つだけの場合、その間マスターは保護されません。新しいコピーがない間、レプリカ上のデータベースは NEEDS_REINIT 状態です(FAILED でも ORPHANED でもありません)。レプリカはアラート replica_removed_for_reinit(警告)を出します。新しいコピーが所定の位置に入ると、アラートは消えます。削除のあと初期化が失敗すると、組は NEEDS_REINIT のままです。初期化を再度開始します(または自動再初期化が開始します、5.8)。新しい初期化はデータベースを最初から転送します。
マスターのアーカイブ(.LogArch)。 ノードは送信済みセグメントを retention_days 日保持し、レプリカが再度要求できるようにします。レプリカがまだ適用していないセグメントはより長く保持されます。容量が少ない場合、ノードは段階的にアーカイブを掃除します。
- すべてのレプリカが適用し、
retention_daysより古いセグメント。 - より新しい適用済みセグメント(容量が足りないとき)。
- 未適用 のセグメント — 最後の手段だけ。そのときレプリカは必要なセグメントを失い、
NEEDS_REINITになります。
レプリカが長い間到達不能だと、アーカイブは成長します。そのボリュームは、停止期間中のデータベースの変更量です。
計算例
データベース 100 GB。負荷は 1 日あたりセグメント 5 GB。初期化は夜間に走り、コピーに 2 時間かかり、その間 .delta に約 2 GB 入ります。
| 場所 | 計算 | 合計の空き |
|---|---|---|
| マスター、データベースのボリューム | 確認用 105 GB(.delta の成長を含む)+ .ReplLog 1 GB + .LogArch 2 日 × 5 GB = 10 GB |
116 GB 以上 |
| レプリカ、新しいデータベース | 105 GB + .Incoming 最大 4 GB + 余裕 1 GB |
110 GB 以上 |
| レプリカ、再初期化 | ディスク上にすでに古いファイル 100 GB + 空き 110 GB | ボリューム 210 GB 以上 |
| レプリカ、古いレプリカを削除 チェックボックス付きの再初期化(HQbird 2027.2.24) | 転送前に古いファイルを削除:105 GB + .Incoming 最大 4 GB + 余裕 1 GB |
ボリューム 110 GB 以上 |
データベースの成長と、レプリカの停止(マスターのアーカイブは停止 1 日あたり 5 GB 成長する)のための余裕を足します。
別ボリューム上のセグメント
.ReplLog、.LogArch、.Incoming のフォルダは、既定ではデータベースの隣にあります。別のボリュームへ移せます。node.json の segments.storage パラメータです(mirror_hierarchy: true のとき、ノードはデータベースフォルダの構造を再現します)。そのときアーカイブはデータベースの容量を奪いません。105 % の確認は、引き続きデータベースのボリュームに適用されます。
容量を見る場所
-
データベース → ノード と 概要:
databases.rootのボリュームの空き容量アイコン。黄は 20 % 未満、赤は 10 % 未満。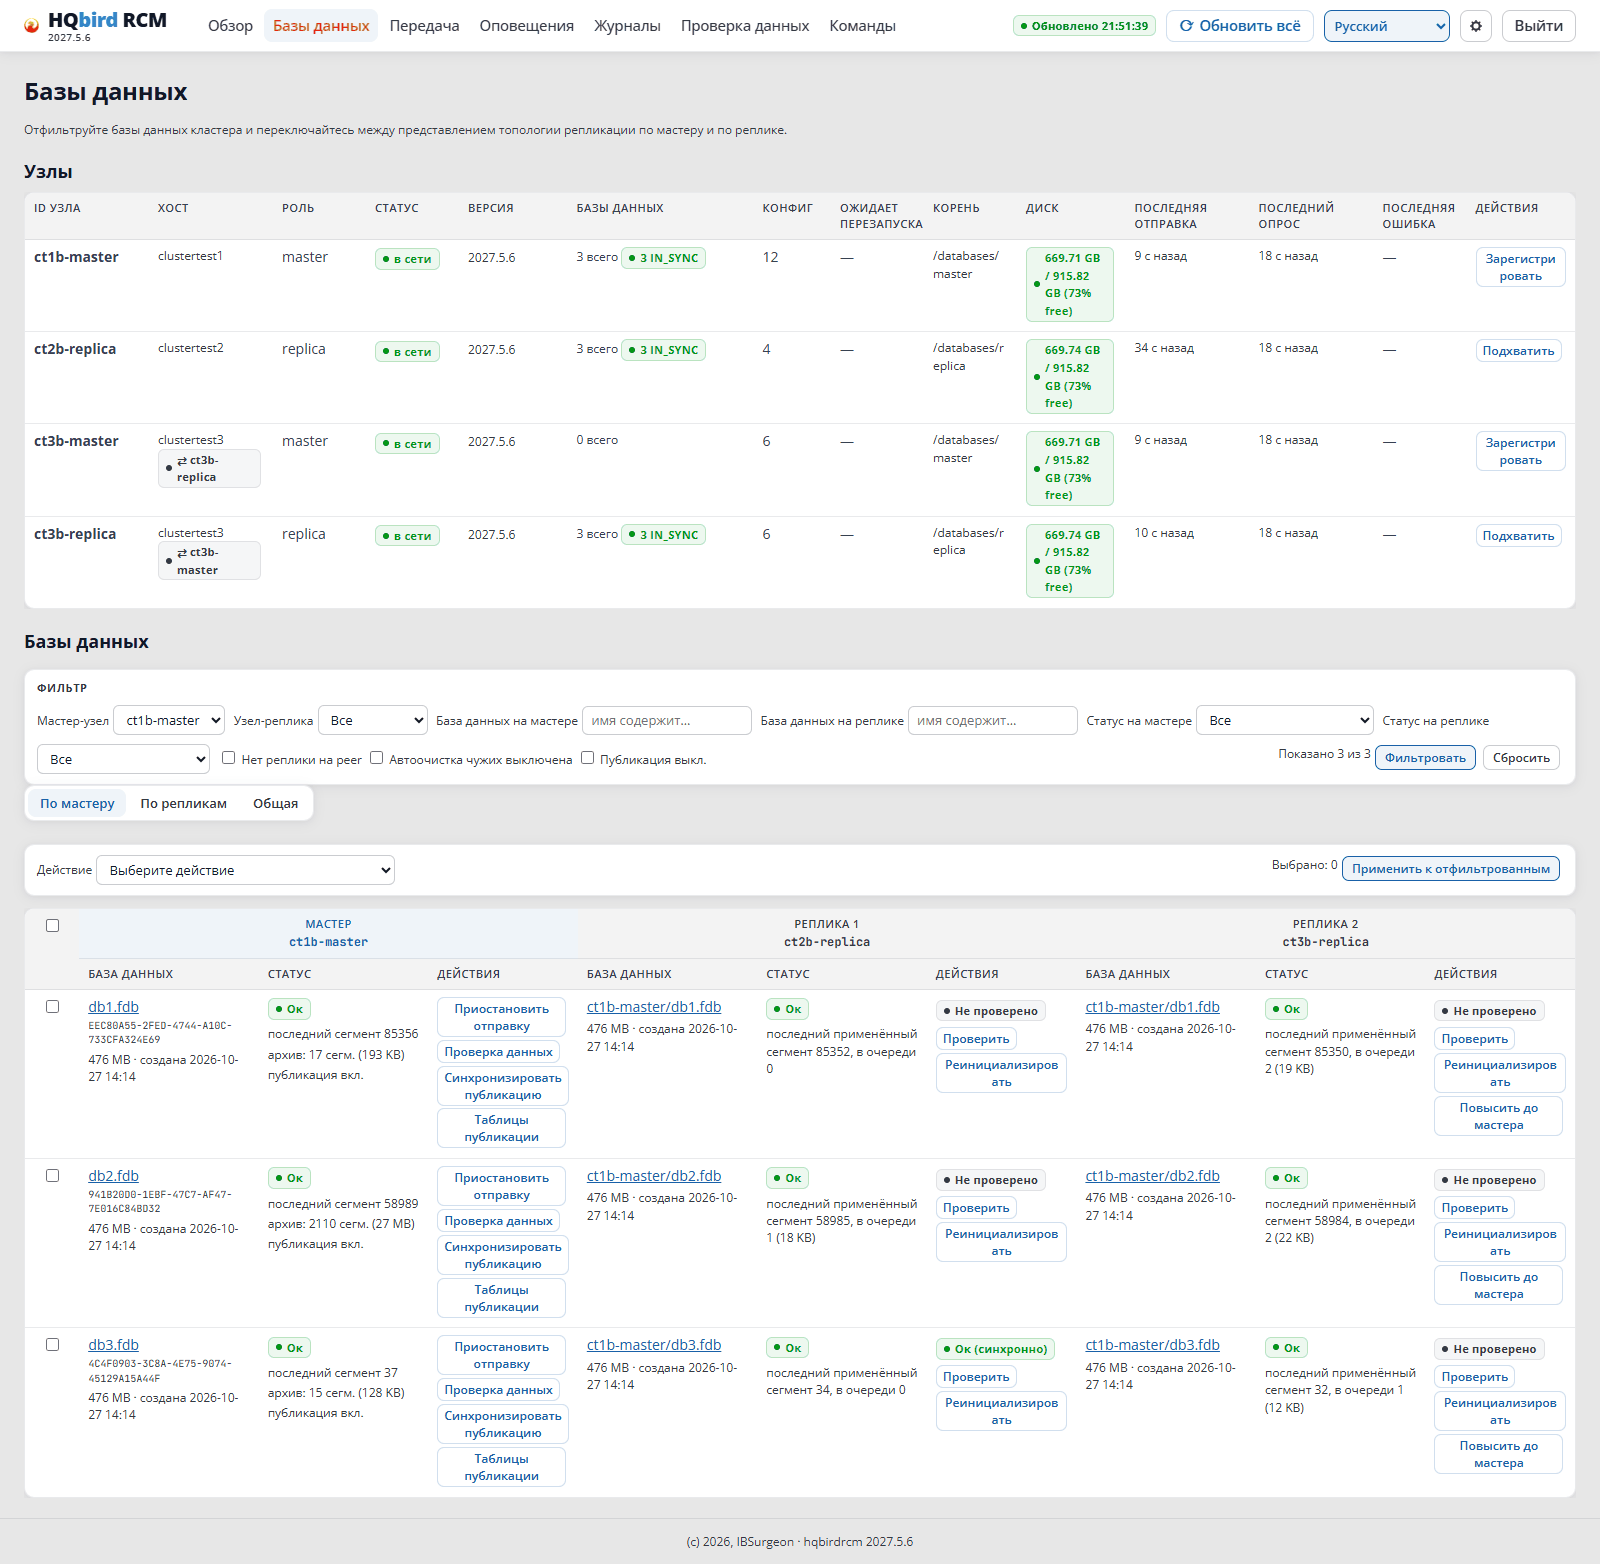
データベースページ:ノード表のディスク列
- クラスタレポート:
hqbirdrcm report。
4.5. 1 つのデータベースの複数レプリカ
2 つ目以降のレプリカも同じ方法で作ります。マスターの行で 初期化 を行い、空いているレプリカノードを選びます。
- 新しいレプリカの初期化中、マスターはこのデータベースを、すでに動作しているレプリカへも 送信しません。初期化が終わったあと、それらはマスターに追いつきます。確認ウィンドウはその旨を述べます。
- 1 つのデータベースの初期化は一度に 1 つです。異なるレプリカでも同様です。
- マスター上の容量は、初期化ごとに別々に確認されます。
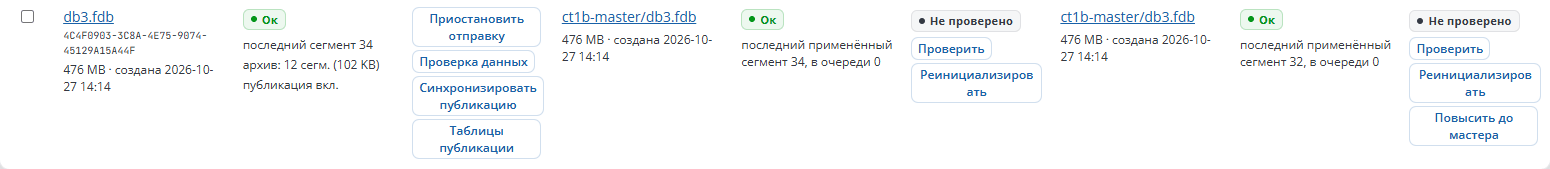
4.6. 手動で構成したレプリカ
手書きの replication.conf ですでにレプリカが動作している場合、管理下に入れ、データベースを 再度コピーしない ことができます。
- マスター:
detect_existingでデータベースを登録します(第 3.6 章)。 - レプリカ: データベース → レプリカノード → 引き継ぐ、または
hqbirdrcm takeover-replica。RCM はレプリカのブロックを見つけ、GUID でファイルをマスターのデータベースに対応付け、それぞれについてin_sync、resumable、またはneeds_reinitを表示します。 - 行を確認します。ノードはブロックを自分の
replication.conf領域へ移します。 - レプリカの Firebird を再起動し、移されたブロックを読ませます。
needs_reinitの行 だけ を初期化します。マスターのアーカイブには、これらのレプリカが必要とするセグメントがもうありません。
4.7. よくあるエラー
| 表示 | 原因 | 対処 |
|---|---|---|
insufficient disk space on master / on replica |
容量不足(4.4)。再初期化では古いコピーが最後まで容量を占める(4.4) | 容量を空けて再試行する。レプリカ側の 2 つ目の抜け道(HQbird 2027.2.24 以降)は 古いレプリカを削除 のチェックボックス(4.4、5.1) |
RCM からの即時の 507 |
容量の統計上、明らかに足りない | 同じ。古いコピーを除けば容量がある場合、RCM 2027.2.24 はチェックボックス 古いレプリカを削除 を挙げる |
incompatible_engine |
Firebird のメジャーバージョンが異なる | レプリカの Firebird をアップグレードする |
| レプリカノードにフォルダがない | ルートが作られていない | 初期化ウィンドウの フォルダを作成(4.3) |
| フォルダはあるが、ノードサービスが書き込めない(HQbird 2027.2.24 以降) | 書き込み権限がない | ウィンドウのコマンドを実行し、再確認 をクリックする(4.3) |
publication_off(HQbird 2027.2.24 以降) |
マスターのパブリケーションが無効、またはテーブルがない | パブリケーションを同期して初期化(5.1) |
ownership_unfixable |
ノードサービスが別のグループである | エラー文章の説明どおりにサービスのグループを直す |
duplicate_guid |
同じ GUID のデータベースが 2 つ(ファイルコピー) | コピーを削除するか、新しい GUID を与える(nbackup -F) |
| 初期化 一覧にレプリカノードがない | ピアに接続がない | 第 2 章 |
レプリカは IN_SYNC だがデータが食い違う |
パブリケーションが無効だった | パブリケーションを同期し、そのあと初期化をやり直す |
5. 初期化(reinit)
初期化は、マスターデータベースのコピーをレプリカへ転送することです。最初の転送を 初期化(初期化 ボタン)と呼び、繰り返しの転送を 再初期化(再初期化 ボタン)と呼びます。仕組みは同じです。
始める前に、第 4 章 の手順 1–5 を完了します。データベースは登録済み、マスターの Firebird は再起動済み、パブリケーションは有効、レプリカフォルダは存在し、容量は十分です。マスターとレプリカに必要な容量は 第 4.4 章 にあります。
5.1. 開始方法
先にパブリケーション。 データベースの登録にはパブリケーションは含まれません。パブリケーションがないと、レプリカは変更を受け取りません。初期化の前に パブリケーションを同期(第 6 章)を実行するか、
hqbirdrcm setpublication -node <master>を実行します。
- HQbird 2027.2.24 では、初期化ウィンドウがパブリケーションを確認します。無効であるか、キー付きのテーブルがない場合、ウィンドウは警告と パブリケーションを同期して初期化 ボタンを表示します。RCM はパブリケーションを同期し、コマンドの完了を待ち、ウィンドウの選択で初期化を開始します。
- 2027.2.24 のマスターノード自身も、そのような初期化(最初の初期化も含む)をエラー
publication_offで拒否し、通知master_publication_offを出します(第 6.1 章)。拒否のあと、データベースのセルには再び パブリケーションを同期して初期化 ボタンがあります。- オペレータがパブリケーションをオフにした(6.4)、またはキー付きのテーブルをすべて外した(6.3)場合、同期はその状態を保ちます。RCM は初期化を始めず、パブリケーションのテーブル ページへのリンクを出します。
- RCM とノード 2027.5.7 はパブリケーションを確認しません。初期化は成功し、RCM ではデータベースが「正常」と表示されますが、レプリカは変更を受け取りません。初期化のあとでパブリケーションをオンにした場合は、データベースを再初期化します。
- データベース を開きます。
- マスターデータベースの行で、レプリカノードの列の 初期化 をクリックします。レプリカノードは列で決まります。ウィンドウでは選びません。既存の組では、展開したマスターカードの 再初期化 です。
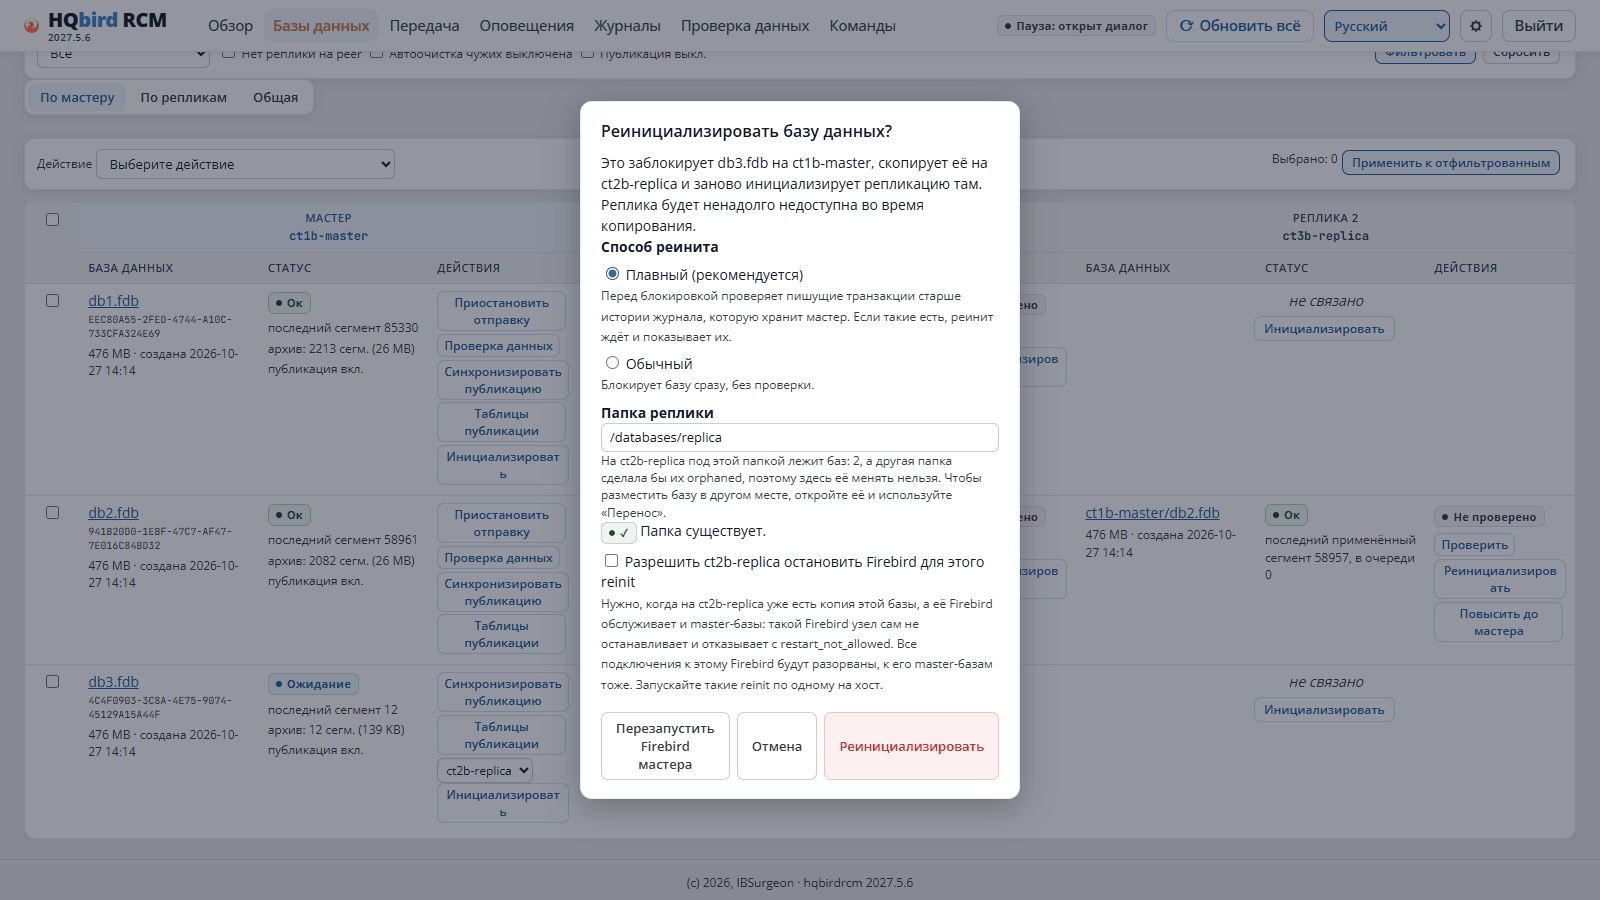
- ウィンドウ(HQbird 2027.2.24 では新しい組のタイトルは「データベースを初期化しますか?」。RCM 2027.5.7 では「データベースを再初期化しますか?」で、最初の初期化でも同じです):
- レプリカフォルダ を確認します。ウィンドウはフォルダが存在するかを表示します。存在しなければ フォルダを作成 をクリックします。レプリカノードが作ります(4.3)。ノードが作れない場合、ウィンドウはレプリカホスト用のコマンドを表示します。HQbird 2027.2.24 では、ノードサービスが書き込めないフォルダも表示します。直しのコマンドと 再確認 ボタンです。
- 再初期化の方法 を選びます。スムーズ(推奨)または 標準(5.4)。HQbird 2027.2.24 では、マスターのアーカイブにまだセグメントがない場合(通常は最初の初期化の前)、ウィンドウはヒントを表示します。忙しいデータベースでは 標準 の方が速いです。
- マスターデータベースがまだ Firebird の再起動を待っている場合、ウィンドウはその旨を述べ、マスターの Firebird を再起動 ボタンを表示します。再起動がなければデータベースはレプリケーションされません。
- 古いレプリカを削除(HQbird 2027.2.24、既定はオフ)が必要なのは、レプリカのボリュームに古いコピーの隣の新しいコピー用の容量がない再初期化のときだけです(4.4)。ウィンドウは数値をあらかじめ表示します。必要な量、空き、古いコピーが占める量。古いコピーを除けば容量がある場合、ウィンドウはチェックボックスをオンにするよう求めます。マスターまたはレプリカのノードが古いバージョンの場合、チェックボックスは無効です。ウィンドウは更新するノードを述べます。新しいコピーができるまで、レプリカにはこのデータベースのコピーがありません(4.4)。
- 確認します。RCM は、データベースがマスター上でロックされ、レプリカへコピーされることを述べます。
初期化の進捗は、データベース ページの展開したマスターカードに見えます。手順とパーセントです。HQbird 2027.2.24 では、ページを更新したあとも進捗が見えます。最初の初期化ではレプリカノードのセルに、またマスターデータベースページの 再初期化の進捗 行にもあります。マスターノードがデータベースをコピーしている間、初期化 ボタンは無効です。RCM がこの初期化を追跡していない場合(たとえばノードのコマンドラインから開始された場合)、手順はノードの状態から取られ、パーセントはありません。RCM 2027.5.7 では、ページ更新後に最初の初期化の進捗は見えません。マスターデータベースが SEEDING を離れるまで待ちます。
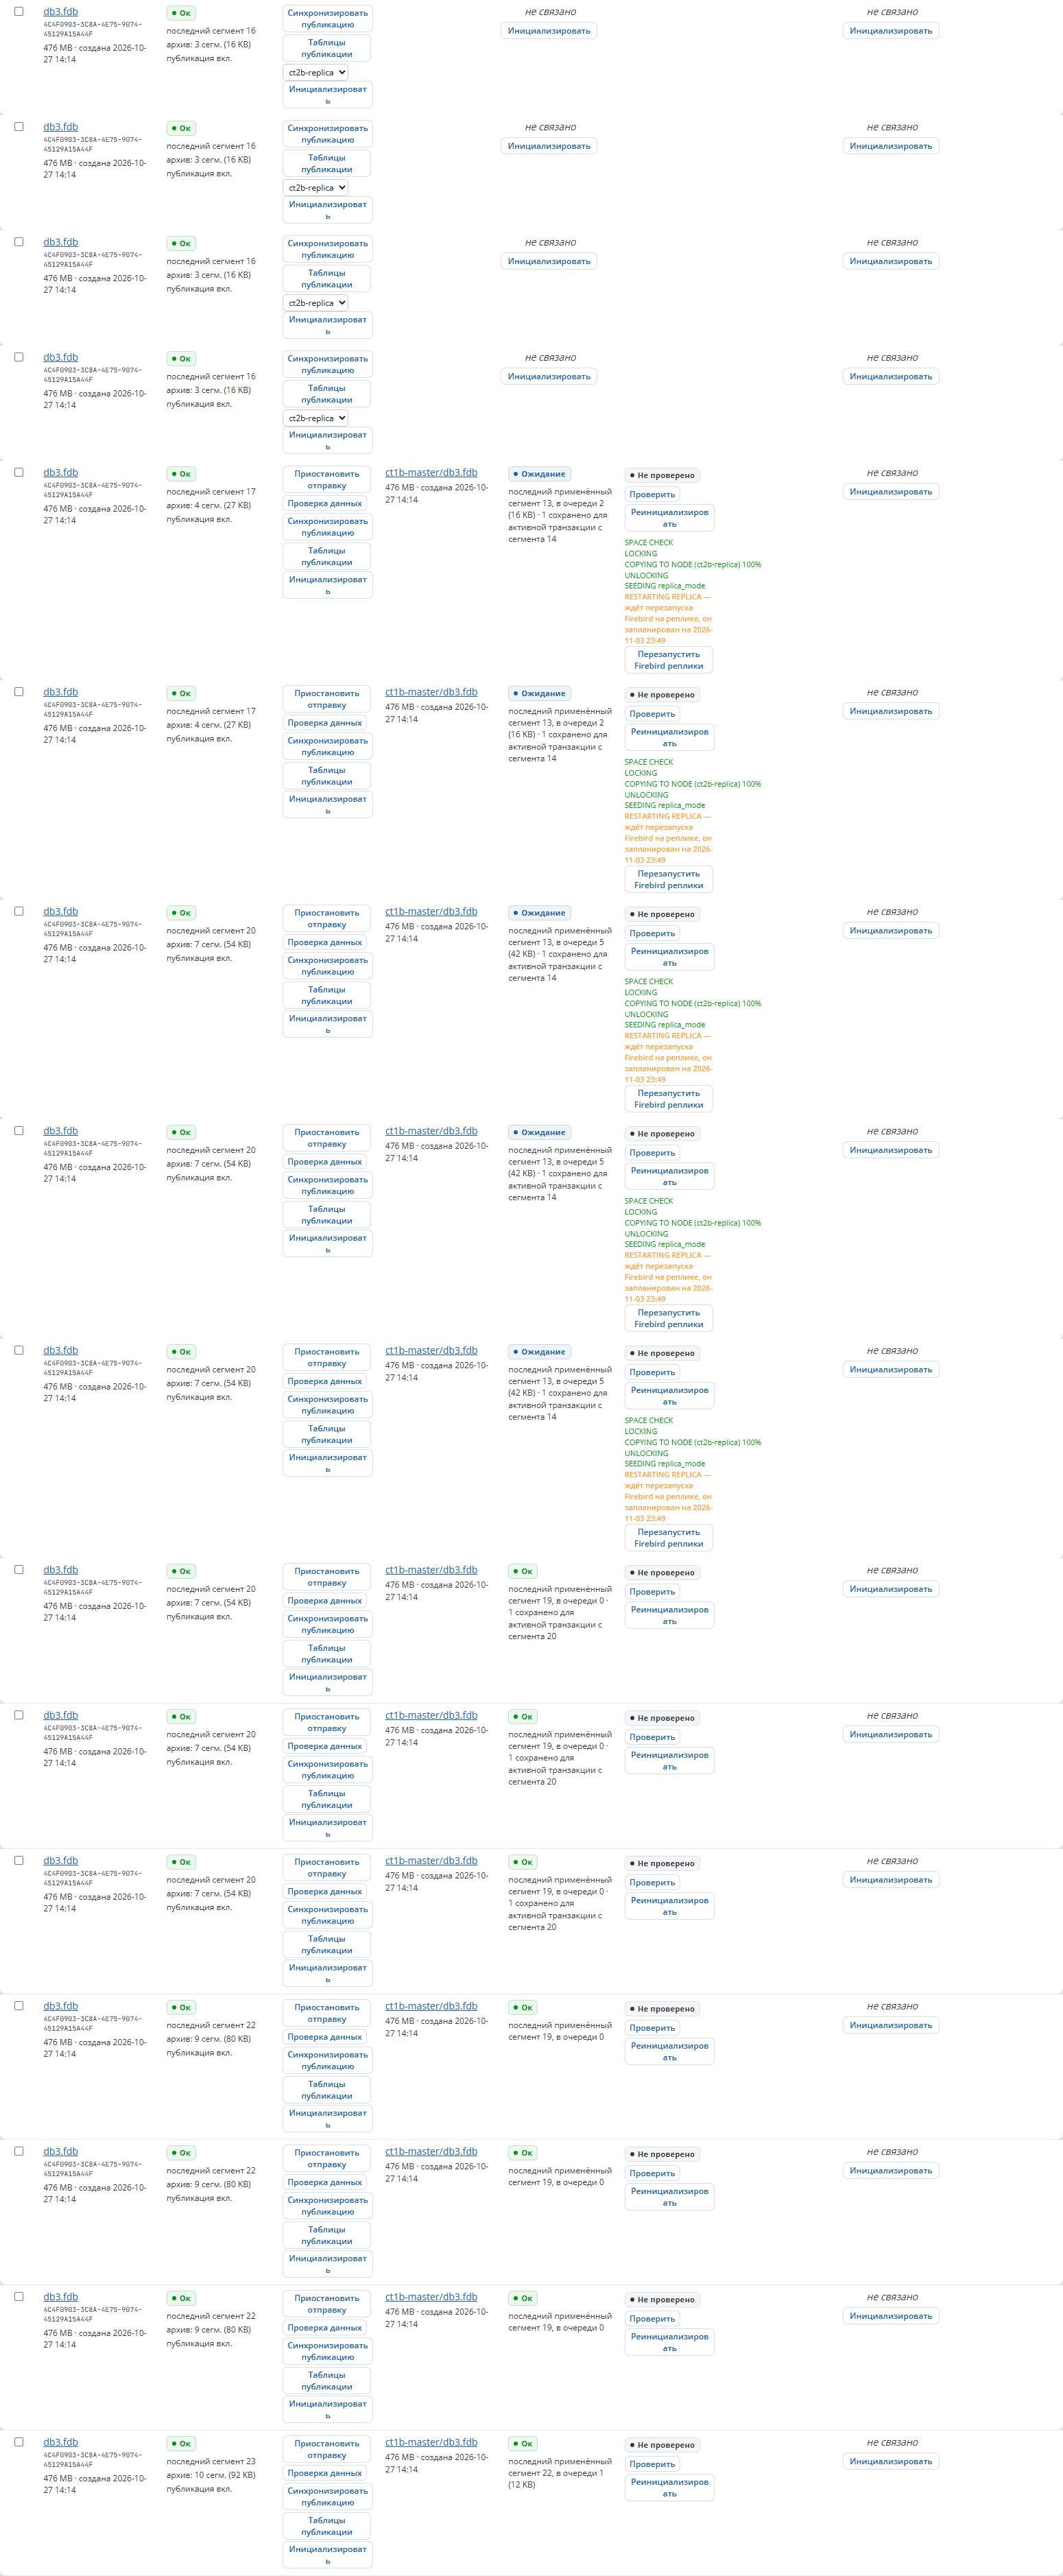
すべての RCM コマンド(初期化、Firebird の再起動、パブリケーションの同期)は、結果とともに コマンド ページに記録されます。
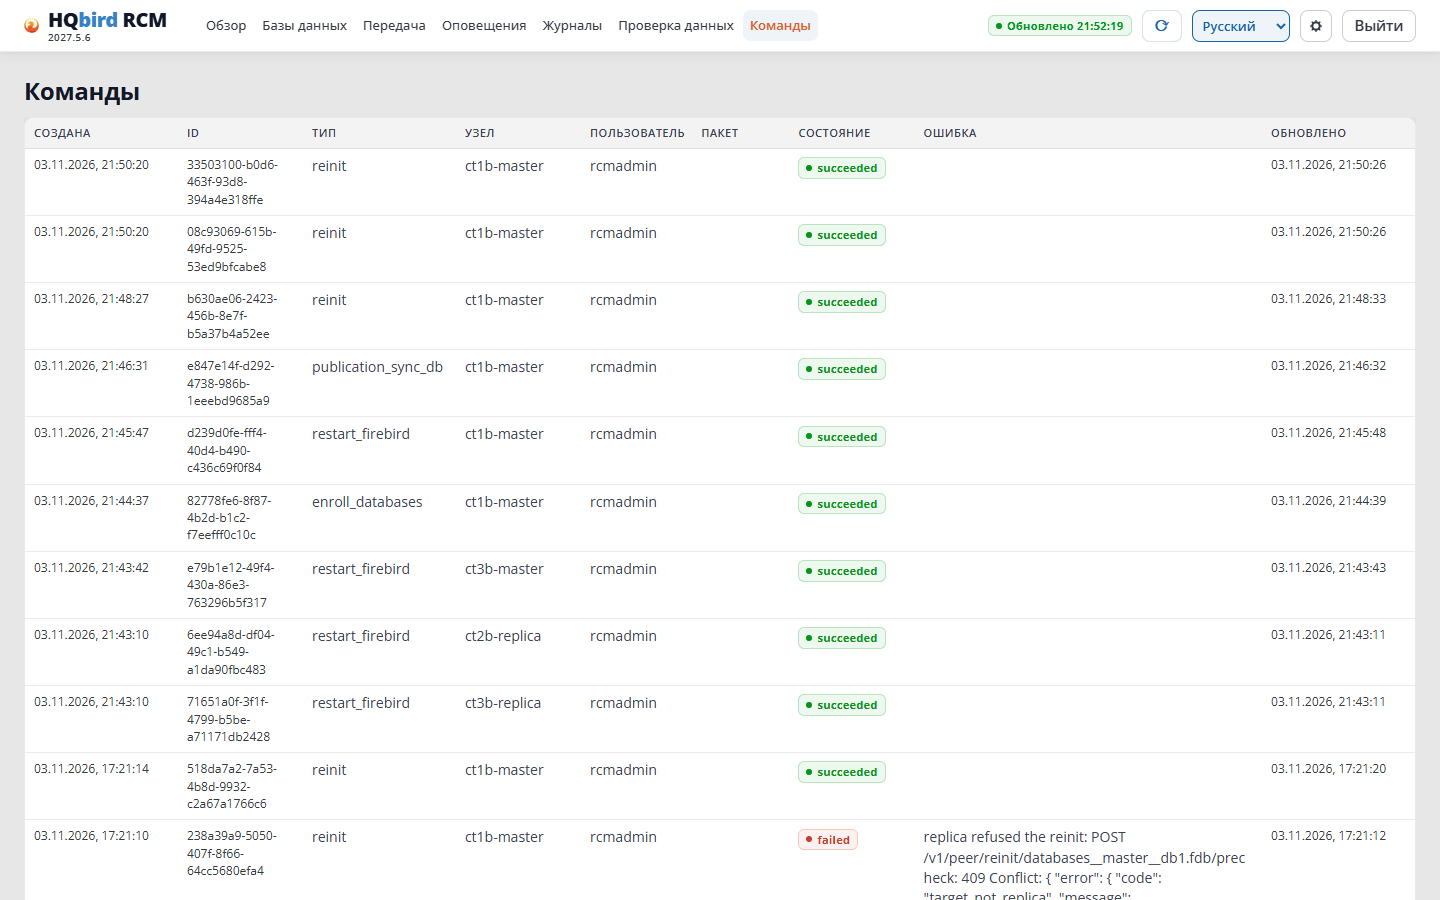
コマンドラインからも同じ操作
# one database
hqbirdrcm reinit -node node-a -db <db_id> -to node-b
# all master databases
hqbirdrcm reinit -node node-a -all -to node-b
パラメータ:
-mode smooth|standard(既定はsmooth)、-hold=false(長いトランザクションの間アーカイブを保持しない)、-allow-restart(5.6)、-force(5.9)。
-remove-old-replica(HQbird 2027.2.24)は、古いレプリカを削除 のチェックボックスと同じです。単一のデータベースだけです。-dbと-toが必要です。-allではコマンドは拒否します。マスターまたはレプリカのノードが古いバージョンの場合、RCM はnode_too_oldで拒否し、何も送りません。hqbirdrcm reinit -node node-a -db <db_id> -to node-b -remove-old-replica
-allはすべてのデータベースを試し、最初の 1 つで止まらずにエラーを集めます。
5.2. 手順
| 番号 | 手順(RCM 内) | 起きること |
|---|---|---|
| 1 | 容量確認 | マスターとレプリカの容量を確認する(第 4.4 章)。レプリカはファイルを受け取れることをあらかじめ確認する |
| 2 | ロック | nbackup -L:マスターのデータベースファイルが凍結され、変更は <database>.delta へ行く |
| 3 | ノードへコピー | ファイルが部分ごとに転送される。読み取り → チェックサム → 圧縮 → 送信 |
| 4 | ロック解除 | 転送の直後に nbackup -N。.delta の変更がデータベースへ戻る |
| 5 | シード | レプリカ上:ファイルのチェックサム検証、nbackup -FIXUP -SEQUENCE、ファイルの設置、gfix -replica、replication.conf へのブロックの書き込み |
| 6 | レプリカの再起動 | 必要な場合のレプリカの Firebird の再起動(5.6) |
手順 6 のあと、データベースは IN_SYNC 状態になります。マスターは、コピーが終わる地点からセグメントの送信を続けます。
知っておくべきこと:
- マスターは常に動作しています。 ユーザーはデータベースに書き込み、変更は
.deltaへ行きます。ロックは転送の直後に解除されます。 - ロックと重なったトランザクションは失われません。 ノードは
nbackup -Lの時点で開いていたトランザクションを見つけ、レプリカはセグメントからそれらを再生します。 - 中断後も転送は続きます。 接続またはレプリカノードが再起動した場合、マスターは最後に受け取った部分から続けます。未完了の転送はレプリカ上に 24 時間保持されます(
reinit_partial_keep_hours)。 - エラー時、ノードはロックを解除し、レプリカ上の未完了ファイルを削除し、データベースを
FAILEDにします。次の試行は既知の状態から始まります。 - 「古いレプリカを削除」チェックボックス(HQbird 2027.2.24 以降)では、レプリカは ロック の手順のあと、転送の前に古いコピーを削除します。このとき ノードへコピー の手順は「容量を空けるため古いレプリカコピーを削除しています」と表示します。削除後のエラーは、組を
FAILEDではなくNEEDS_REINITにします(第 4.4 章)。 nbackupのみ。 gbak は使いません。データベース GUID が変わるからです。
5.3. 運用への影響
| 対象 | 影響 |
|---|---|
| マスターのユーザー | 作業を続ける。コピー中に .delta が成長し、-N のあと変更がデータベースへ移される |
| このデータベースのほかのレプリカ | 初期化の間、このデータベースのセグメントを受け取らない。あとから追いつく |
| マスターのほかのデータベース | 影響なし |
| レプリカの Firebird、新しいデータベース | 停止しない。再起動は 5.6 のとおり |
| レプリカの Firebird、再初期化 | ファイルの置き換え中は 停止する。この Firebird のすべてのデータベースが数秒使えなくなる |
| レプリカの Firebird、ノードが古いコピーを削除する(「古いレプリカを削除」チェックボックス、HQbird 2027.2.24 以降) | 転送の前、削除の間、より早く 停止する。replication.conf のデータベースブロックが変わっていなければ、ノードは 2 回目の停止なしで新しいコピーを設置する。容量が足りて削除が不要なら、ノードは何も削除せず、通常の再初期化と同じに進む |
| ネットワークとディスク | 速度上限に応じた負荷(5.5) |
Windows の場合。 Firebird が開いているファイルは置き換えられません。再初期化の間、ノードは fbagent 経由でレプリカの Firebird を止め、ファイルを設置し、Firebird を再び起動します。Linux でも置き換えの前に Firebird は停止されます。そうしないと、削除された古いファイルで動作を続けるからです。
5.4. スムーズと標準
スムーズ(既定)。ロックの前に、ノードは 長いトランザクション を探します。マスターのアーカイブ内で最も古いセグメントより前に始まった、ユーザーの書き込みトランザクションです。初期化のあと、レプリカはそれらを再生できず、最初の変更で止まります(「トランザクション … が見つかりません」)。変更のないトランザクションは数えません。
そのようなトランザクションがある場合、初期化は始まりません。RCM は スムーズ再初期化は長いトランザクションを待っています と表示し、一覧を開く リンクを出します。
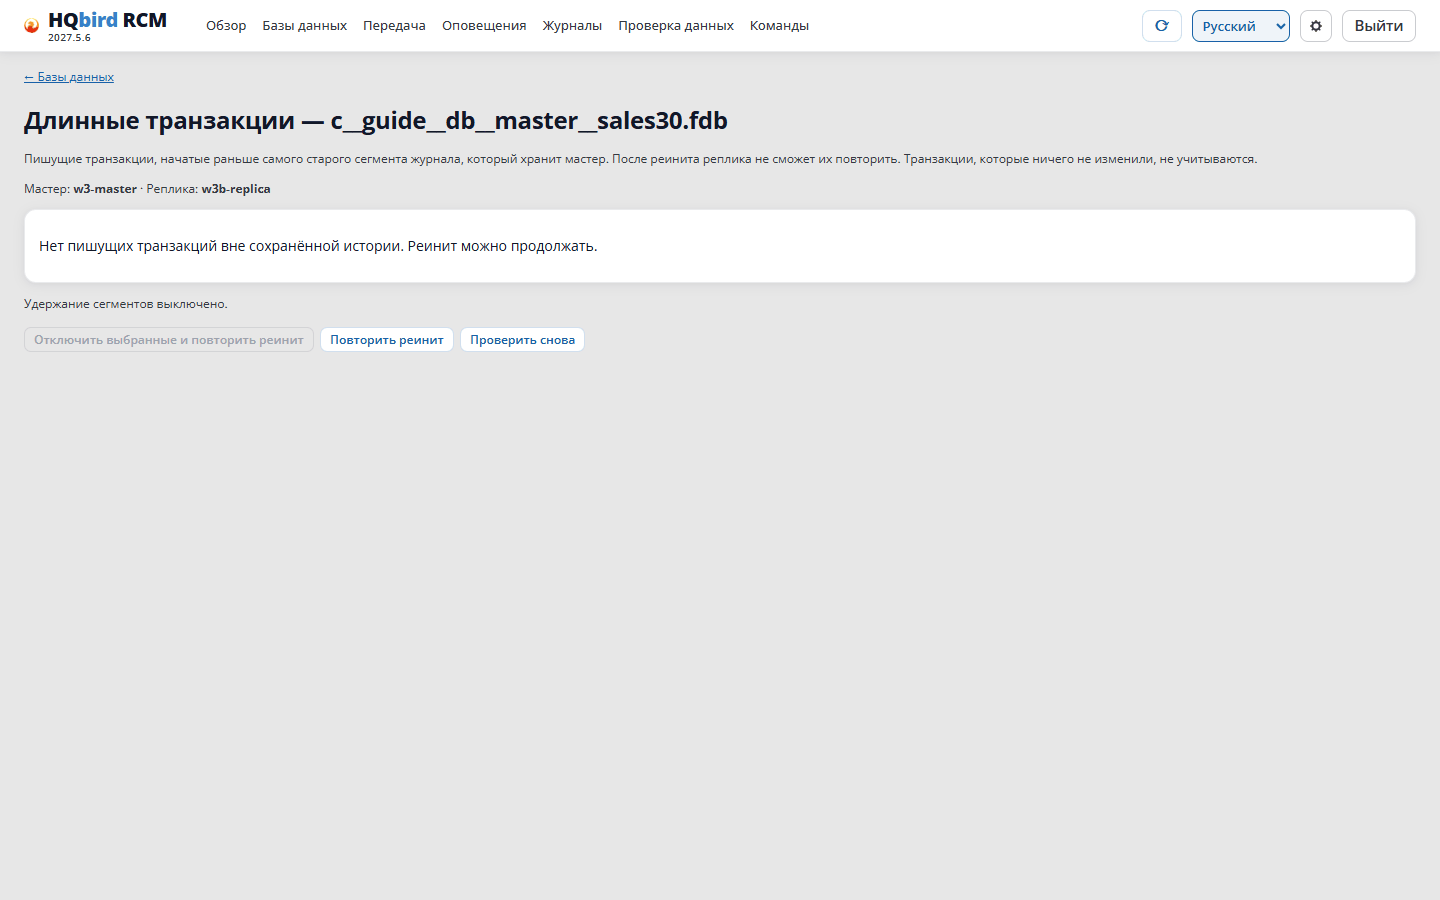
長いトランザクション ページ:
- 要約:トランザクションと接続の数、最も古いセグメント。
- 最も古いトランザクションを持つ 上位 5 接続:ユーザー、クライアント、開始、経過時間、変更、現在のクエリ。
- セグメントを保持 / 保持を解除 — 保持が有効な間、マスターのアーカイブは掃除されず、履歴は切り詰められません。
- 選択した接続を切断して再初期化を再試行 — 接続を切断し(そのトランザクションはロールバックされる)、直ちにスムーズ再初期化を開始します。
- 再初期化を再試行、再確認。
長いトランザクションを理由に再初期化が拒否されると、保持は自動で有効になります。成功した初期化のあと、手動、またはアーカイブが reinit_hold_max_segments(既定 1000 セグメント、通知 retention_hold_released)まで成長したときに解除されます。
標準 は確認なしで直ちにデータベースをロックします。長い書き込みトランザクションがないと分かっている場合だけ使います。
負荷のかかった最初の初期化。 マスターのアーカイブが空の間は、比較するセグメントがありません。
HQbird 2027.2.24 のマスターノード:ノード自身がパブリケーションを有効にし、それ以降アーカイブが変わっていない場合、履歴はパブリケーションが有効になった時点から始まります。それよりあとで始まったトランザクションは、最初の変更からジャーナルに入り、スムーズ方式を妨げません。それより前に始まったトランザクションはジャーナルに入りません。再初期化はロックの前にそれを待ち(10 秒ごとに 6 回)、locking の手順はその番号、接続、ユーザーを表示します。終わっていなければ、再初期化はエラー reinit_pre_publication_transactions で終わります。それを終わらせて再試行します。長いトランザクション ページは、そのようなトランザクションを パブリケーションが有効になる前に始まったトランザクション の表に表示します。
パブリケーションがノード経由ではなく手動で有効にされた、またはアーカイブがすでに変わっている場合、履歴の開始は不明です。その場合、書き込みトランザクションが 1 つでも開いていればスムーズ方式は拒否し、メッセージはアーカイブにまだセグメントがないと述べます。この場合 RCM 2027.2.24 は一覧を開かず、データベースのセルに対処を書きます。標準 を選ぶか、Firebird が最初のセグメントをアーカイブしてから再試行します。
2027.5.7 のマスターノードでは、現在書き込み中のデータベースの最初の初期化で、スムーズ方式は直ちに拒否します。long_transactions … segment 0 (0001-01-01T00:00:00Z)。そのようなデータベースの最初の初期化には 標準 を選びます。
その後の再初期化では、スムーズ方式は通常どおり動作します(アーカイブはすでに存在します)。
コマンドラインからも同じ操作
hqbirdrcm longtx -node node-a -db <db_id>                       # list
hqbirdrcm longtx -node node-a -db <db_id> -disconnect 12,34 -retry-to node-b
hqbirdrcm longtx -node node-a -db <db_id> -hold false           # release hold
パブリケーションより古いトランザクション。 Firebird は、パブリケーションが有効になる前に始まったトランザクションをセグメントに書きません。ノードがパブリケーションを有効にした場合、初期化はそのようなトランザクションが終わるまで待ちます(10 秒ごとに 6 回)。そうでなければエラー reinit_pre_publication_transactions で、それらを列挙して終わります。テーブルを追加したパブリケーションを同期したあと、アプリケーションを再接続し、そのあと初期化を開始します。
5.5. 速度
| いつ | 速度 | 設定 |
|---|---|---|
転送ウィンドウ windows.transfer_window の中(既定 23:00-05:00) |
一定 | limits.reinit_window_mbps、既定 100 MB/s |
| ウィンドウの外 | 測定したディスク速度の割合 | limits.reinit_day_disk_fraction、既定 0.5 |
ノードは 30 秒ごとにモードを再計算します。日中に始まった初期化は、夜になると自分で速くなります。
ノードはテストでディスク速度を測ります。マスターホストでテストを繰り返すには:
hqclusternode benchmark -config /opt/hqclusternode/master/node.json初期化時間 ≈ データベースサイズ ÷ 速度。例:100 GB を 100 MB/s で — 純粋な転送は約 17 分。実際にはネットワークまたはディスクが上限になります。
5.6. レプリカの Firebird の再起動
レプリカ上の新しいデータベース。 ファイルは Firebird を止めずに置かれます。Firebird が新しい replication.conf のブロックを読むのは再起動のあとだけです。それまでレプリカは何も適用しません。レプリカの再起動 の手順は待ちを表示します。
| 表示 | 意味 |
|---|---|
| レプリカ上の Firebird 再起動を待っている。予定は … | ほかの初期化が終わったあと、ノードは最後の初期化のあと自分で Firebird を再起動する(reinit_restart_delay_sec) |
| … 再起動ウィンドウは閉じている。次が開くのは … | レプリカの restart_window を待っている |
| … 最後の試行は失敗した。次は … | あとで再試行する |
| レプリカは Firebird を自分で再起動できない。手動で再起動する | auto_restart: never、またはこの Firebird がマスターのデータベースも提供している |
ノードは一連の初期化のあと Firebird を 1 回 再起動します。データベースごとではありません。
手動で再起動するには、レプリカの Firebird を再起動 をクリックします。待ちは、Firebird の再起動が成功したあと、またはレプリカがコピーより新しいセグメントを適用したときに終わります。
マスターのデータベースも提供している Firebird 上での再初期化。 ノードはそのような Firebird を自分では止めず、restart_not_allowed で拒否します。初期化を再度開始し、この再初期化のため -allow-restart)。この Firebird の接続を切ってよい時刻に行います。マスターのデータベースへの接続も含みます。そのような初期化はホストあたり一度に 1 つ実行します。
古いコピーの削除(古いレプリカを削除 チェックボックス、HQbird 2027.2.24)も、同じ規則でレプリカの Firebird を止めます。ノードがこの Firebird を自分で止められない場合、何も削除せず、restart_not_allowed で拒否します。同様に この再初期化のため engine_busy で拒否します。マスターはロックを解除します。あとで再試行します。
5.7. キューと同時の初期化
- 1 つのデータベースの初期化は一度に 1 つです(異なるレプリカでも同様)。このデータベースの初期化が進行中は、初期化 ボタンは無効です。
- マスターノードは、異なるデータベースの初期化を
limits.max_concurrent_reinits件同時に実行します(既定 1)。残りはキューで待ちます。応答にはキューの位置が含まれます。 - 初期化中のデータベースに対して自分で
nbackup -L(またはALTER DATABASE BEGIN BACKUP)を実行せず、そのようなバックアップの間に初期化を始めないでください。データベースのロックは 1 つだけです。初期化はこれを確認し、nbackup backup lock already activeで拒否します。
キューと現在の転送は 転送 ページで見えます。
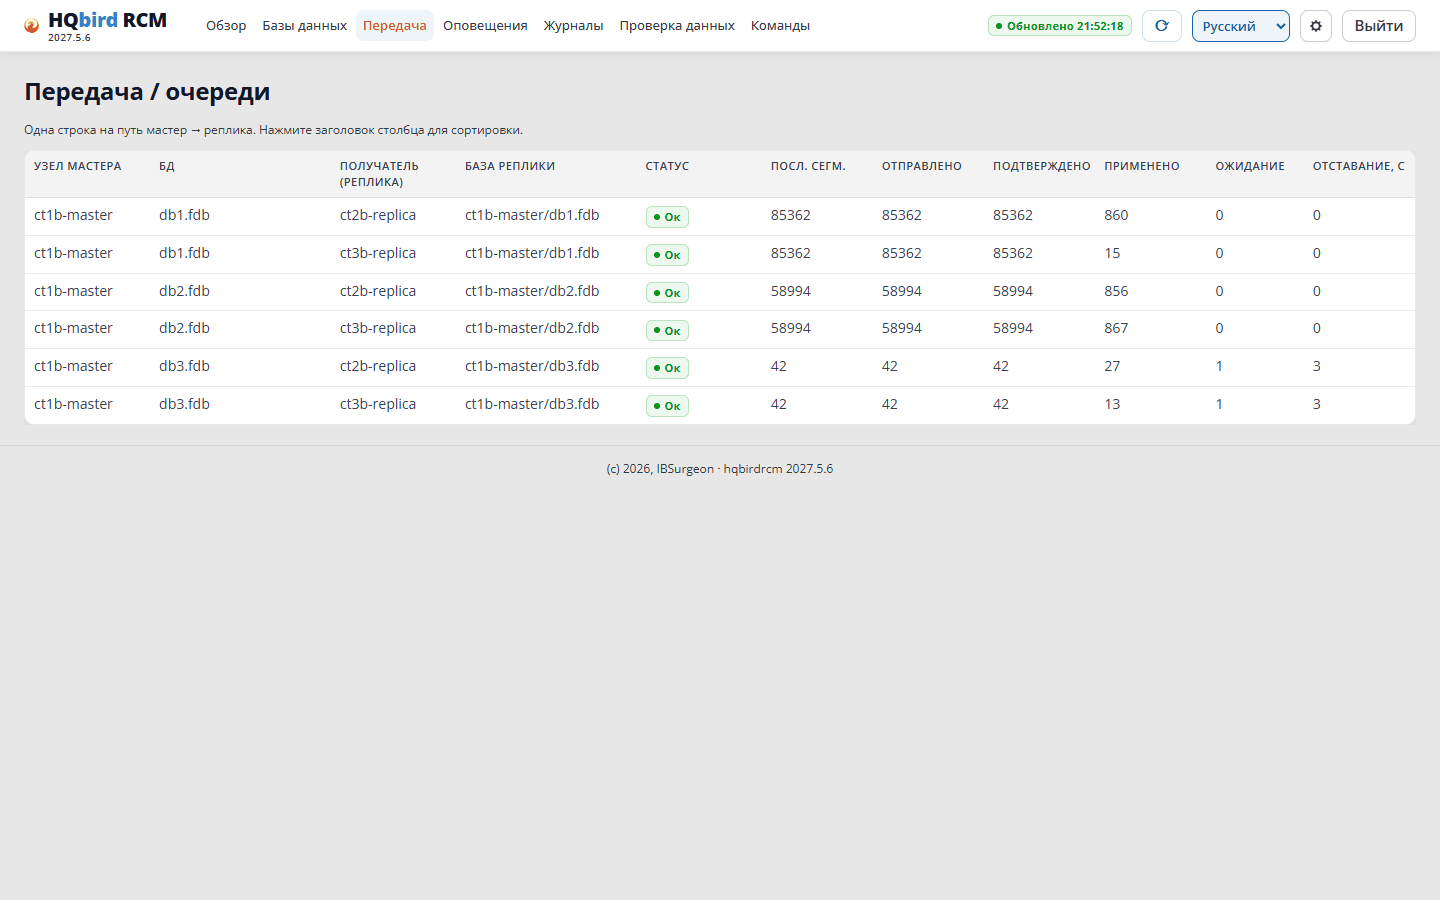
5.8. 自動再初期化
RCM は、NEEDS_REINIT 状態のデータベースを、構成されたウィンドウの中だけで自分で再初期化できます。既定では無効です。
データベースが NEEDS_REINIT に入るとき:
| 原因 | 見える場所 |
|---|---|
| 回復不能な適用エラーの繰り返し(PK、UNIQUE、FK 違反)— 3 回連続 | レプリカ、アラート replication_unrecoverable_error |
| マスターデータベースの GUID が変わった(復元、ファイルの置き換え) | レプリカ、アラート replication_guid_mismatch |
| マスターのアーカイブに、レプリカが必要とするセグメントがもうない | マスター |
| レプリカが初期化のために古いコピーを削除し、新しいコピーがまだない(HQbird 2027.2.24 以降) | レプリカ、アラート replica_removed_for_reinit。マスター |
有効にするには 設定 → RCM(または rcm.json の auto_reinit 節):
"auto_reinit": {
  "enabled": true,
  "default_window": "22:30-04:00",
  "max_concurrent": 1,
  "nodes": {
    "node-a": { "window": "23:00-05:00",
                "databases": { "sales/employee.fdb": "01:00-03:00" } }
  }
}- ウィンドウ:データベースごと → ノードごと → 全体。
"always"はいつでも。 - ウィンドウは RCM ホストの 時計で計算されます。
max_concurrent— RCM が次の自動初期化を始めるために、クラスタで動いてよい初期化(手動と自動)の数。- 自動初期化は、手動初期化と同じ容量と GUID の確認を通ります。コマンドの実行者は
system:autoreinitです。 remove_old_replica_when_short(HQbird 2027.2.24 以降、容量不足のとき古いレプリカを削除 の行)— 既定では無効。有効にすると、自動初期化は 古いレプリカを削除 フラグを送ります(4.4)。RCM が送るのは、レプリカ自身がNEEDS_REINITであるか、マスターのNEEDS_REINITの原因がそれを名指ししている場合だけです。IN_SYNCまたはLAGGINGのレプリカにはフラグは決して送られません。ノードが古いバージョンの場合、RCM はフラグなしで同じ初期化を始めます。- 変更後、RCM を再起動します。
マスターのカードの スヌーズ は、1 つのデータベースの自動初期化を 1 時間、4 時間、24 時間、または解除するまで止めます。手動の初期化は使えます。
5.9. エラー
| エラー | 原因 | 対処 |
|---|---|---|
insufficient disk space on master / on replica、507 |
容量不足。再初期化の間、古いコピーは最後まで容量を占める | 第 4.4 章。レプリカ上(HQbird 2027.2.24 以降)は 古いレプリカを削除 のチェックボックス(5.1) |
node_too_old(HQbird 2027.2.24 以降) |
古いレプリカを削除 のチェックボックスがオンだが、マスターまたはレプリカのノードが古いバージョン | エラー文章の示すとおりノードをアップグレードするか、チェックボックスなしで実行する |
engine_busy、reclaim_in_progress(HQbird 2027.2.24 以降) |
レプリカは今古いコピーを削除できない。Firebird またはこのデータベースが忙しい | あとで再試行する(5.6) |
replica_removed_for_reinit、組が NEEDS_REINIT(HQbird 2027.2.24 以降) |
レプリカは古いコピーを削除したが、初期化が終わらなかった | 初期化を再度開始する(4.4) |
publication_off(HQbird 2027.2.24 以降) |
マスターのパブリケーションが無効、またはキー付きのテーブルがない | パブリケーションを同期して初期化(5.1) |
long_transactions、「スムーズ再初期化は長いトランザクションを待っています」 |
長い書き込みトランザクションが開いている | 5.4 |
long_transactions、「マスターのアーカイブにはまだセグメントが 1 つもない」 |
負荷のかかった最初の初期化 | 標準(5.4) |
reinit_pre_publication_transactions |
パブリケーションが有効になる前に始まったトランザクション | アプリケーションを再接続し、再試行する |
duplicate_guid |
同じ GUID のマスターデータベースが 2 つ | コピーを削除する。マスターへの昇格で新しい GUID の手順が飛ばされた場合は -force(第 8.4 章) |
license_paused |
マスターの fbagent にライセンスがない | 第 2.8 章 |
409 orphaned |
データベースがマスターのスキャンの外 | 第 3.8 章 |
incompatible_engine |
Firebird のメジャーバージョンが異なる | 第 4.3 章 |
target_not_replica |
レプリカの場所に動作中のデータベースがある(通常化された) | 下記を参照 |
target_other_replica(HQbird 2027.2.24 以降) |
レプリカの場所に、このノードの別のデータベースのコピーがある | 下記を参照 |
restart_not_allowed |
レプリカの Firebird がマスターのデータベースも提供している | 5.6、「… に Firebird の停止を許可」チェックボックス |
fbagent_required |
レプリカに fbagent がインストールされていない | 第 1 章 |
nbackup backup lock already active |
nbackup のバックアップが進行中 | 5.7 |
… -L did not finish in 2m0s and was stopped |
マスター上の nbackup -L が 2 分以内に終わらなかったため、ノードが停止した |
再試行する。エラーが繰り返す場合はマスターの Firebird を確認する(firebird.log) |
reinit already in progress for this database |
このデータベースの初期化はすでに動作中 | 終わるまで待つ |
target_not_replica。 コピーの場所に動作中のデータベースがあります。通常化された(ファイル <database>.hqcluster-normal.json がある)か、レプリカモードではありません。ノードは動作中のデータベースを上書きしません。置き換える必要がある場合、ノードの API への要求で overwrite_non_replica: true(RCM にこのボタンはありません)とすると、ファイルが置き換えられ、古いファイルは <database>.pre-reinit-<UTC time>.fdb として残ります。
target_other_replica(HQbird 2027.2.24 以降)。レプリカはコピーを <databases.root>/<master id>/<database path> に置きます。マスター ID が一意なのは自分のクラスタの中だけなので、2 つのデータベースが同じパスになり得ます。レプリカノードは、自分の別のデータベースに属するコピーを上書きしません。エラーはそのデータベースとそのマスターを名指しします。ノードは、パスの記録が異なるコピー(パス内のシンボリックリンクまたはジャンクション、Windows の短いフォルダ名)も認識します。overwrite_non_replica はこのエラーを消しません。コピーの一方を別のフォルダへ移すか、そのデータベースをレプリカから外し、初期化を再度開始します。ノードが見るのは自分のデータベースだけです。同じホスト上の 2 つのレプリカノードは、異なるレプリカフォルダ(databases.root)を持つ必要があります。
5.10. 結果の確認方法
-
データベース: グループ内のマスターとレプリカの組が 正常、状態
IN_SYNC。 -
マスターのカードの 検証:ノードは、データベースのテーブル一覧(第 3.1 章)のテーブルの行数を、マスターとレプリカで数え、比較します。静かな時間に確認します。書き込みが活発だと数は異なり得ます。
HQbird 2027.2.24 では、結果ページは各側の一覧を名指しします(たとえば「このデータベース自身の一覧」または「パブリケーションのテーブル(一覧未設定)」)。RCM はマスターの一覧を使ってレプリカを数えます。両方のデータベースにないテーブルは「データベースにない」と表示され、エラーには数えません。比較されたテーブルがなければ、結果は「比較するテーブルがありません」であり、不一致ではありません。割り当て時間内に比較が終わらなければ、結果は「未比較(時間制限)」であり、これも不一致ではありません。
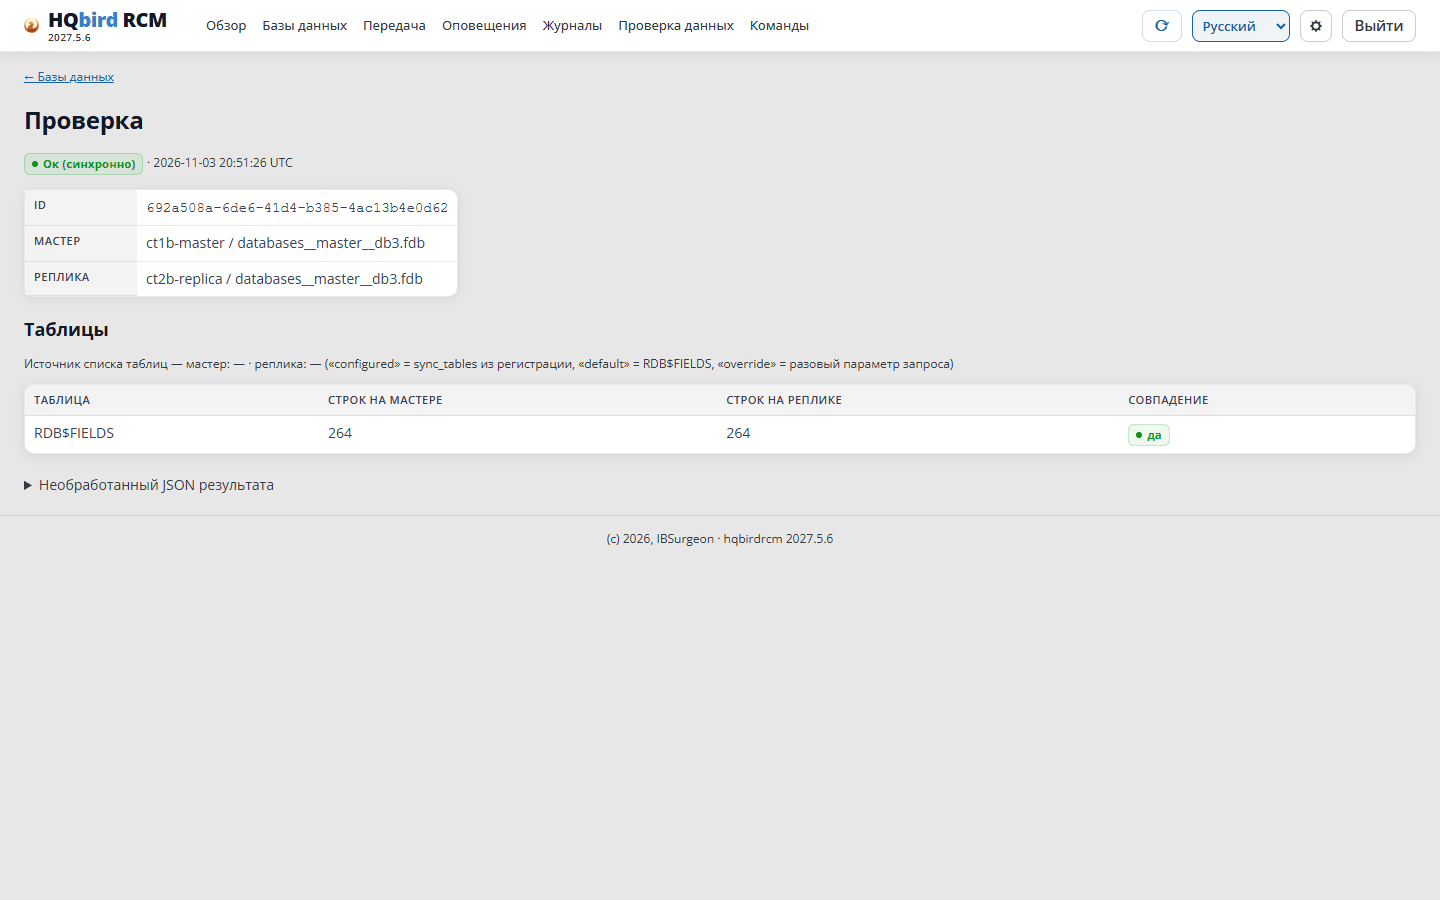
オペレータがパブリケーションから外したテーブルは、「未公開」と表示され、不一致としては表示されません。
6. パブリケーションの設定
パブリケーションは、Firebird のマスターに、どのテーブルの変更をセグメントへ書くかを伝えます。これがないと、レプリカは何も受け取りません。
6.1. パブリケーションとは
Firebird 4 と 5 では、レプリケーションするテーブルは RDB$DEFAULT パブリケーションで定義されます。
- パブリケーション有効 —
RDB$PUBLICATIONSでRDB$ACTIVE_FLAG = 1(コマンドALTER DATABASE ENABLE PUBLICATION)。 - 公開されたテーブル —
RDB$PUBLICATION_TABLESの一覧。
Firebird がセグメントへ変更を書くのは、公開されたテーブルについて、パブリケーションが有効なときだけです。データベースの登録(第 3 章)はパブリケーションを 有効にしません。有効にするのは パブリケーションを同期(6.2)です。
マスターノードはパブリケーションを 1 時間ごとに確認します(limits.publication_check_interval_sec、既定 3600)。無効の場合、ノードは 2 分ごとに確認します。
データベース ページでは、マスターデータベースにアイコンがあります。
| アイコン | 意味 |
|---|---|
| パブリケーション有効 | パブリケーションが有効 |
| パブリケーション無効 | Firebird はセグメントに何も書かず、レプリカは変更を受け取らない |
| パブリケーション不明 | ノードが状態を読めなかった |
パブリケーション無効 フィルタは、無効または不明のパブリケーションのデータベースを表示します。
無効なパブリケーションのデータベースにすでにレプリカがある場合、マスターはアラート master_publication_off を出します。
HQbird 2027.2.24 では、マスターはエラー publication_off でデータベースの初期化を拒否したときにもこのアラートを出します(第 5.1 章)。パブリケーションが無効、またはキー付きのテーブルがない場合です。アラートのレベル:
- 警告 — データベースにまだレプリカがない。初期化はパブリケーションを待っている。
- 重大 — データベースにすでにレプリカがある。
- 情報 — オペレータがパブリケーションを無効にした。
アラートは、パブリケーションが直されたとき、または別の初期化が始まったときに消えます。
6.2. パブリケーションを同期する
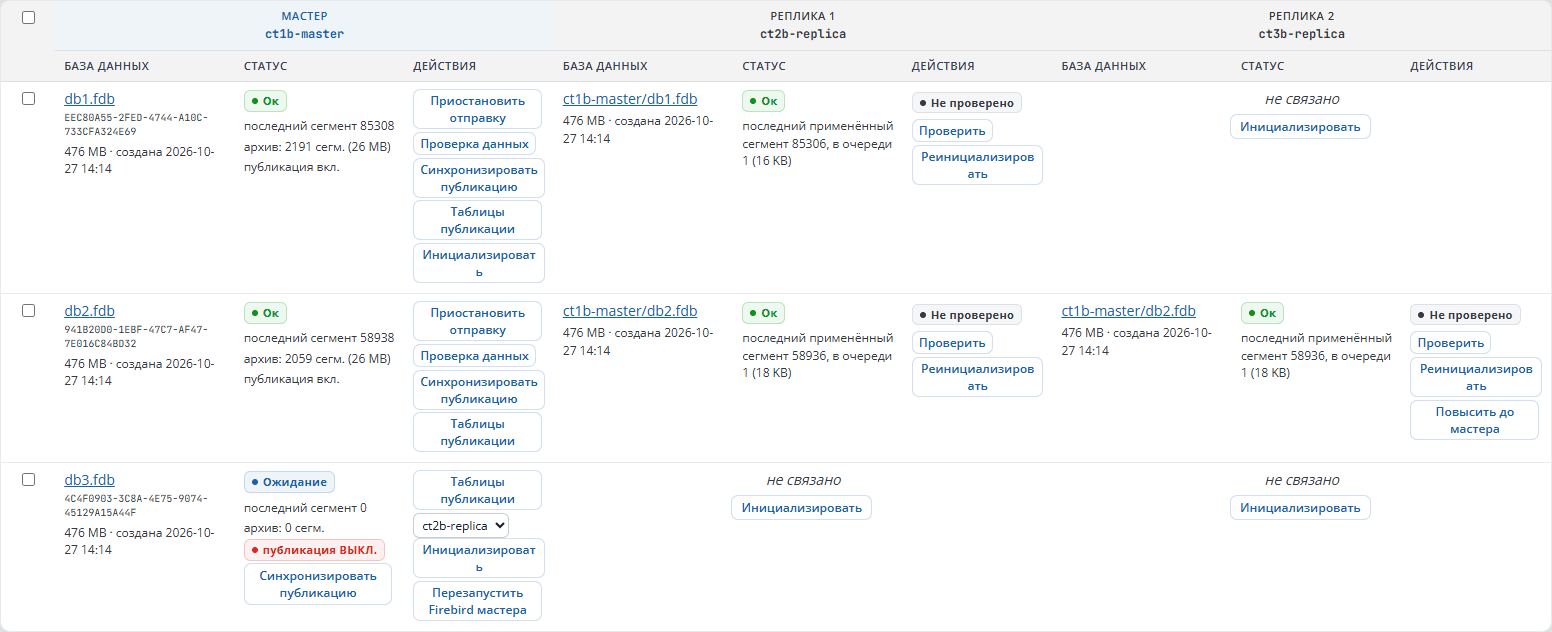
クリックする場所:
- データベース ページのマスターデータベースの行。パブリケーションが無効のとき、ボタンはアイコンの隣にあります。
- データベースのページ。
- 複数のデータベース:行にチェックを入れ、操作 一覧で パブリケーションを同期 を選びます。RCM はデータベースごとに別のコマンドを送ります。
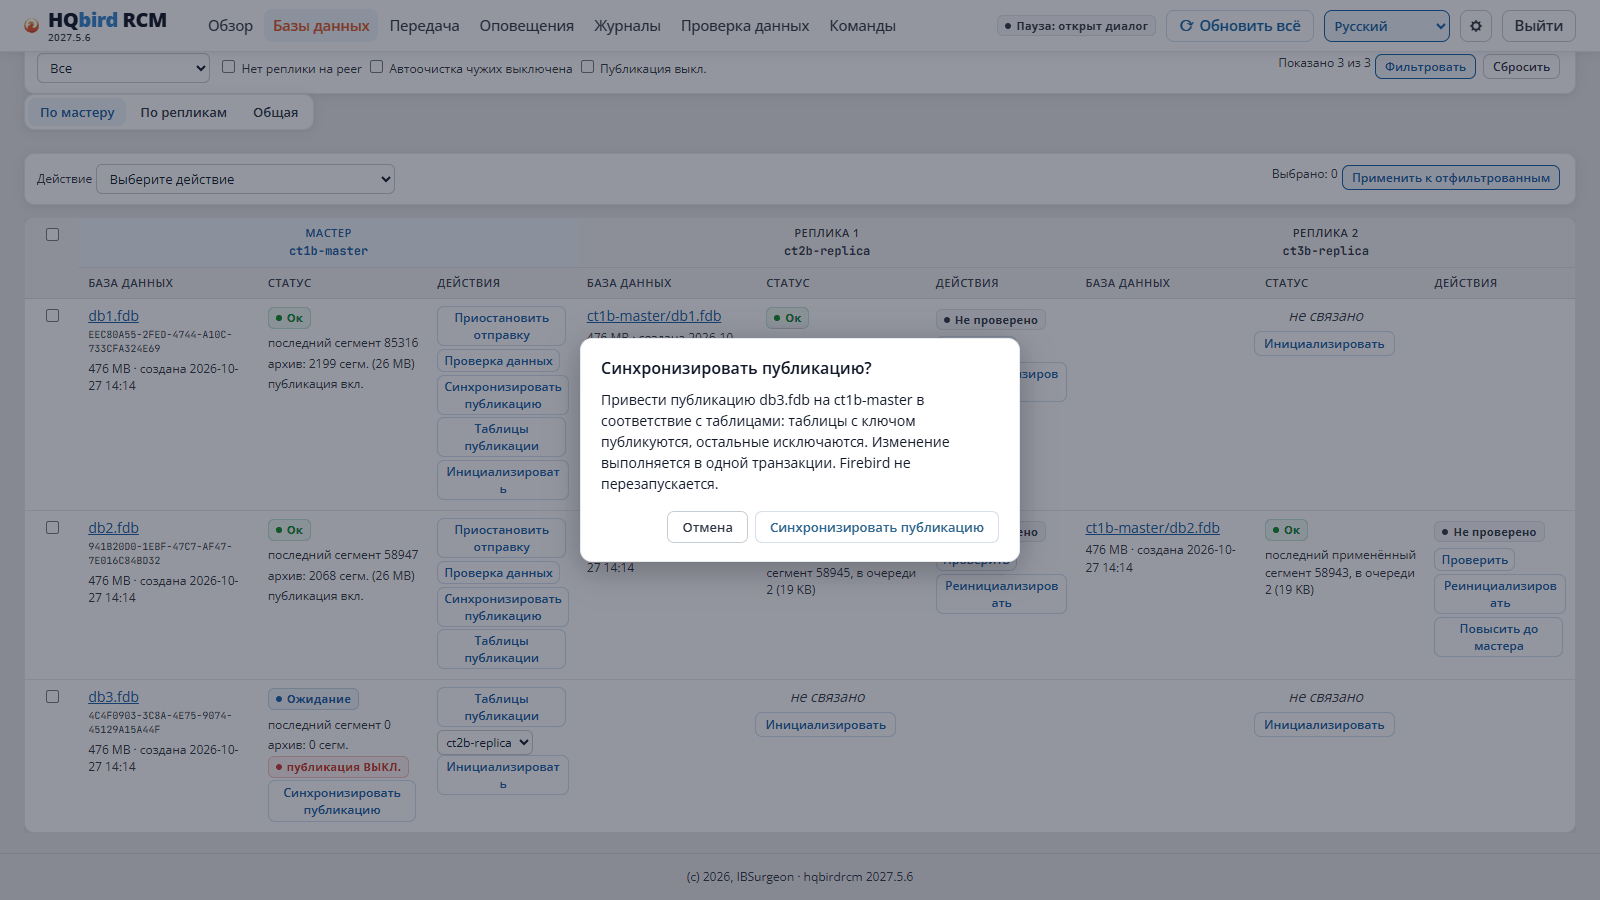
ノードが行うこと(単一のトランザクション):
- パブリケーションを有効にします。オペレータ自身が無効にした場合(6.4)は、有効にしません。
- まだ入っていない、キー付きのテーブル をすべてパブリケーションに追加します。
- キーのないテーブルと、オペレータが除外したテーブル(6.3)をパブリケーションから外します。
- 新しいテーブルの自動追加を無効にします(
EXCLUDE ALL FROM PUBLICATION、そのあと必要なテーブルを追加)。パブリケーションの構成を決めるのはノードだけです。
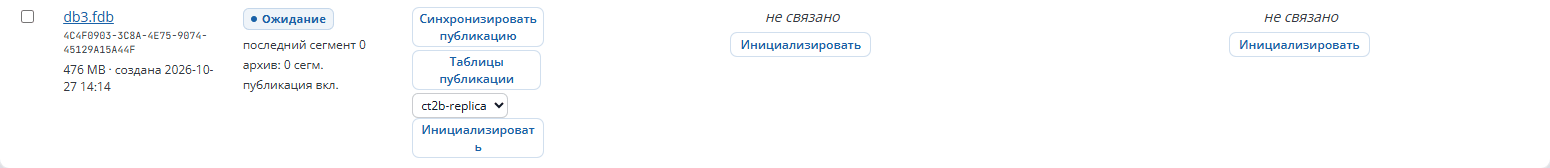
キー付きのテーブル — 主キー または 有効な一意インデックスを持つ、ユーザーの永続テーブル。システムテーブルと一時テーブルは公開されません。
同期は、DBA が手動で追加したキーのないテーブルもパブリケーションから外します。
構成がすでに正しければ、ノードは何も変えません。
ノードが拒否するとき:
| コード | 理由 |
|---|---|
no_publications |
HQbird 2.5/3.0(6.6) |
not_master |
ノードはマスターではない |
reinit_in_progress |
このデータベースの初期化が進行中 |
orphaned、database_failed、file_missing |
データベースがスキャンの外、エラー中、またはファイルがない |
ノードのすべてのデータベースを一度に — コマンドラインからだけです。コマンド ページでは、結果はデータベースごとに 完了、スキップ、または エラー と表示されます。FAILED または SEEDING 状態のデータベースと、ファイルのないデータベースはスキップされます。
コマンドラインからも同じ操作
hqbirdrcm setpublication -node node-a -db <db_id>   # one database
hqbirdrcm setpublication -node node-a               # all node databases
コマンドは最大 5 分待ち、データベースごとに 1 行を表示します。エラー時の終了コードは 1 です。
-nowait— 結果を待ちません。
6.3. パブリケーションのテーブル
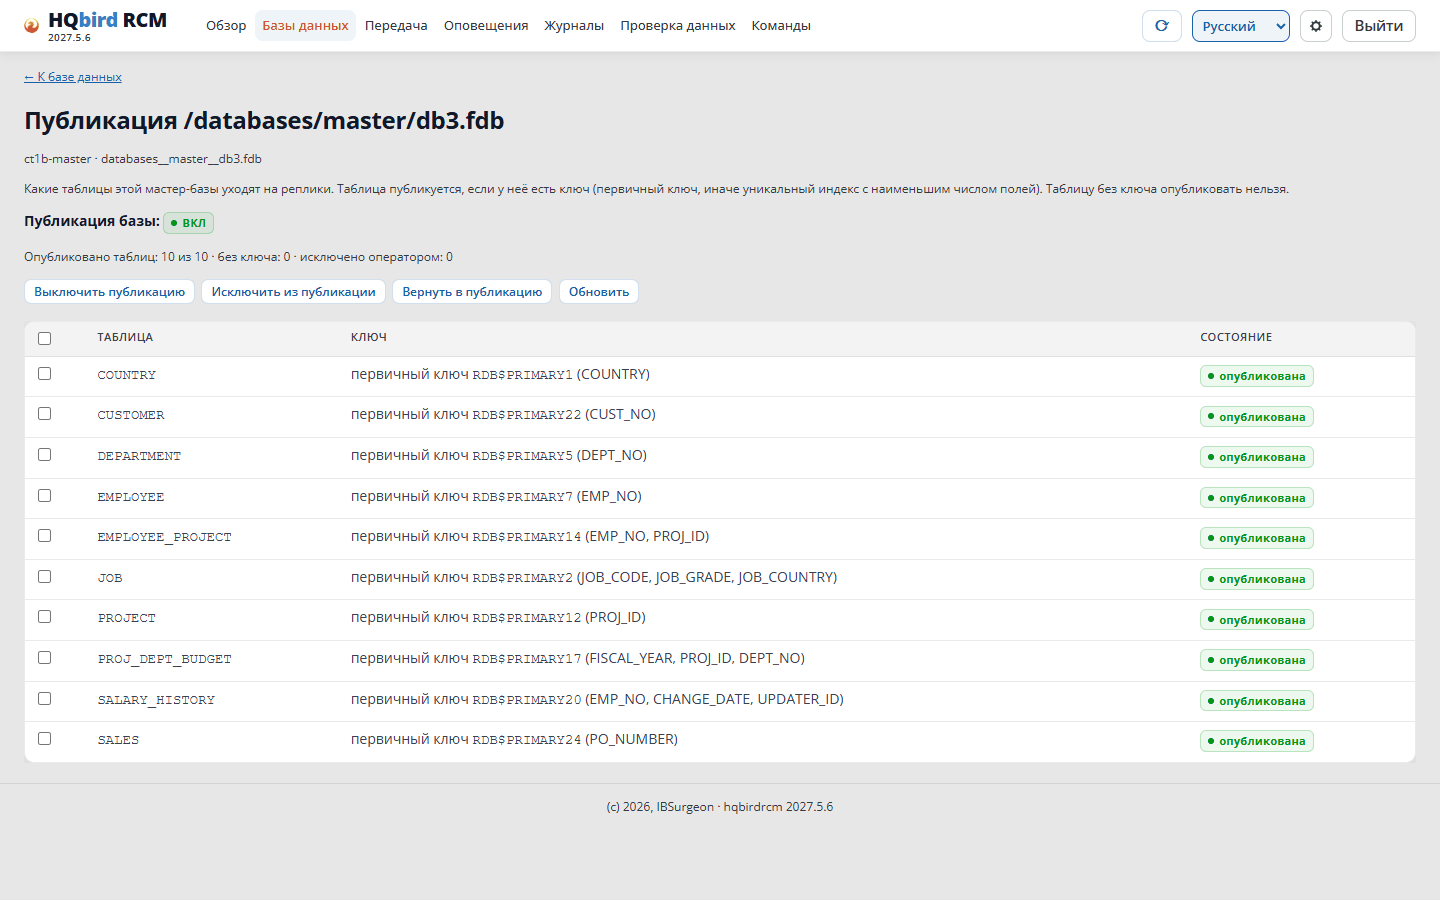
マスターデータベースの行で パブリケーションのテーブル を開きます。
ページの表示:
- パブリケーションの状態(オン/オフ、オペレータにより無効)とカウンタ。
- 各テーブル:名前、キー、状態。
| 状態 | 意味 |
|---|---|
| 公開済み | 変更がセグメントへ行く |
| 未公開 | キー付きのテーブル。同期時に追加される |
| 除外 | オペレータがパブリケーションから外した |
| キーなし | 公開できない |
キーの列には主キー、なければフィールド数が最も少ない一意インデックスが表示されます。
キーのないテーブルを公開できない理由。 レプリカは UPDATE と DELETE の行をキーで探します。キーがなければ行を見つけられません。主キーまたは一意インデックスを追加し、そのあとパブリケーションを同期します。
パブリケーションから除外 / パブリケーションに戻す:
- テーブルにチェックを入れます。
- パブリケーションから除外 または パブリケーションに戻す をクリックします。
- ノードは一覧を保存し、直ちにパブリケーションを同期します。
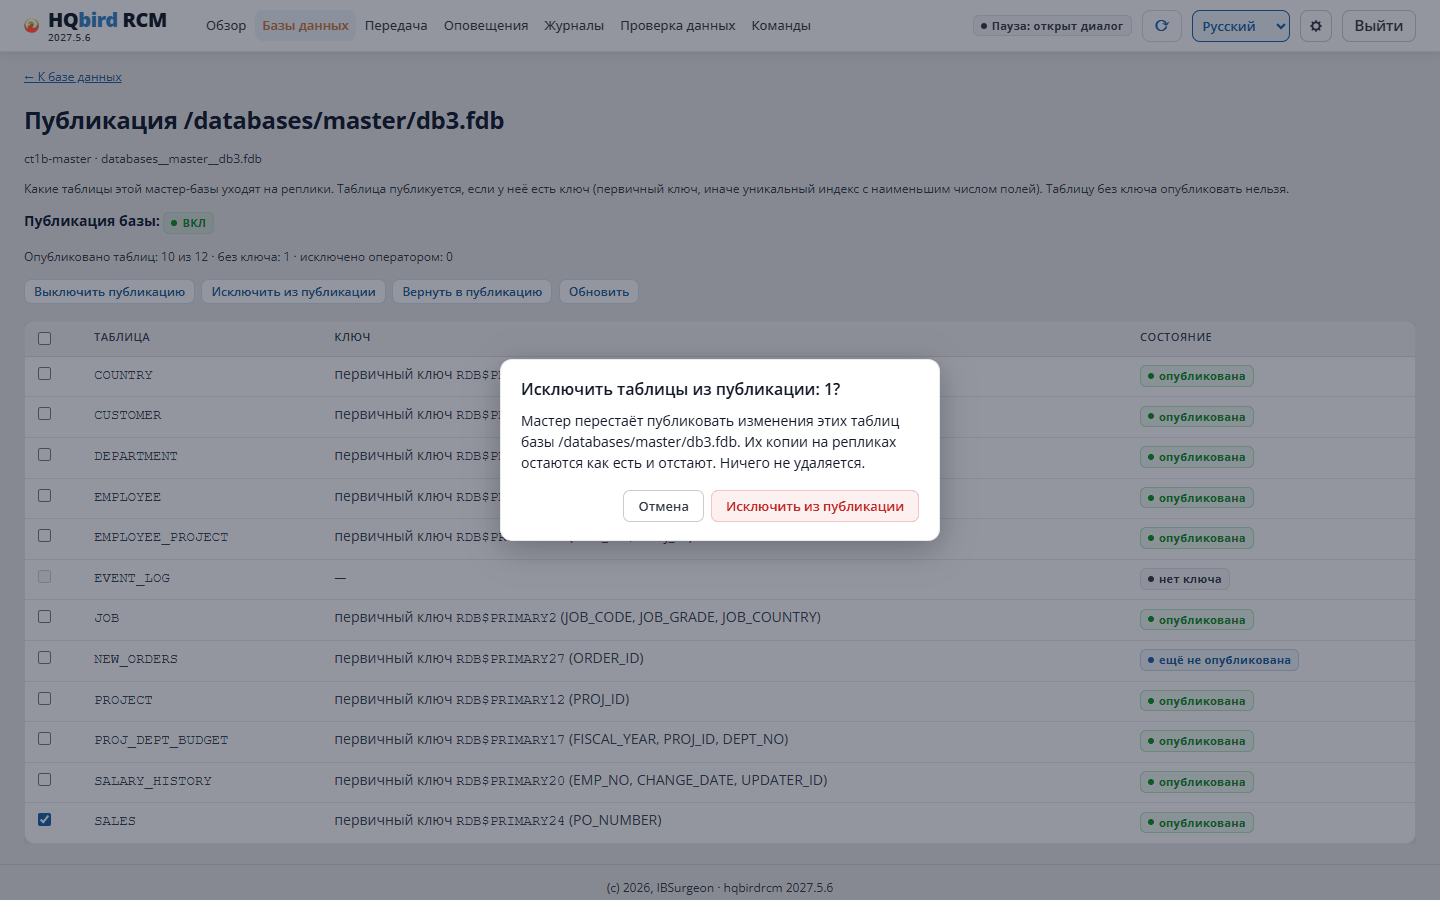
除外テーブルの一覧は マスターノード上 に保存されます。同期はそれを変えません。レプリカがマスターへ昇格すると(第 8 章)、一覧は新しいマスターへ移ります。
確認(第 5.10 章)は、除外されたテーブルを「未公開」と表示し、不一致としては表示しません。
6.4. パブリケーションの有効化と無効化
パブリケーションのテーブル ページ:パブリケーションを無効化 / パブリケーションを有効化。
- 無効化はオペレータの選択です。同期はパブリケーションを 再有効化しません。
- パブリケーションが無効の間(またはテーブルが除外されている間)に行われた変更は、有効化したあとでもレプリカへ 送られません。
- 有効化したあと、確認 をクリックします(第 5.10 章)。データが食い違う場合は、レプリカを再初期化します(第 5 章)。
6.5. 新しいテーブル
新しいテーブルは自分ではパブリケーションに 入りません。ノードが自動追加を無効にしているからです。
DDL のあと:
- テーブルに主キーまたは一意インデックスを作ります。
- パブリケーションを同期 をクリックします。
- 再初期化が必要な場合は、アプリケーションに再接続を求めます。Firebird は、パブリケーションが有効になる前に始まったトランザクションをセグメントに書きません。
COMMIT RETAININGはそのようなトランザクションを開いたままにします。初期化はそのようなトランザクションを待ち、そのあとreinit_pre_publication_transactionsで失敗します(第 5.4 章)。
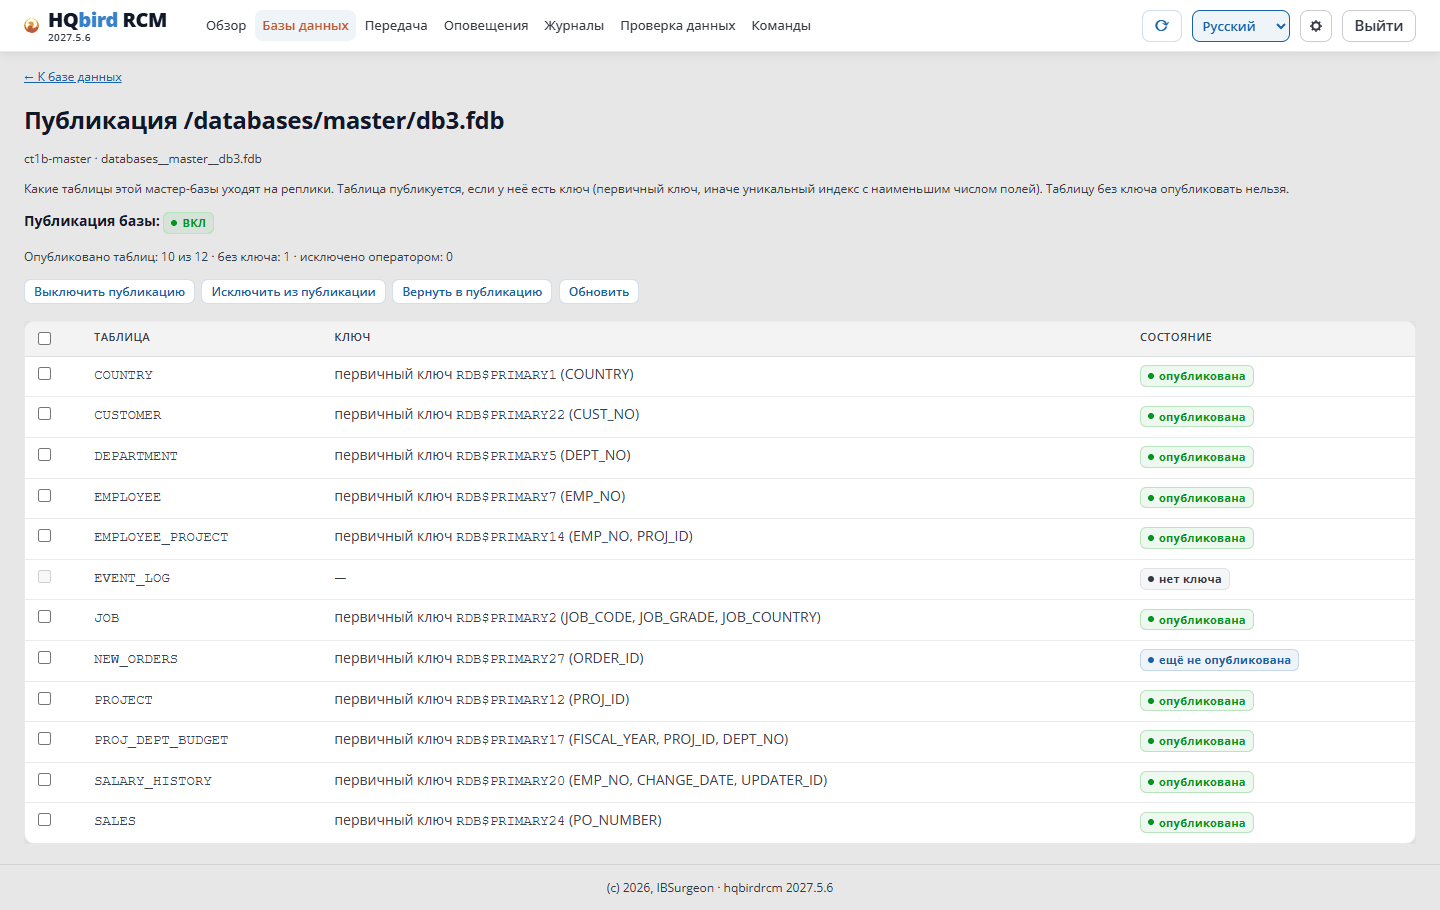
同期の前に新しいテーブルへ書かれた行は、レプリカに届きません。ある場合はデータを確認し、必要ならレプリカを再初期化します。
6.6. HQbird 2.5 と 3.0
HQbird 2.5 と 3.0 にパブリケーションはありません。replconf プラグインのファイルにマスターのブロックがあれば、Firebird はセグメントを書きます。そのようなノードではパブリケーションのボタンは隠れ、API は no_publications で応答します。
テーブルの集合 はエンジンのパラメータで定義されます。
| パラメータ | 意味 |
|---|---|
include_filter |
レプリケーションするテーブル。名前またはパターンをカンマ区切り。空はすべて |
exclude_filter |
レプリケーションしないテーブル |
パラメータは 設定 → レプリケーションパラメータ で変更します(第 7.1 章)。パブリケーションのテーブル ページはそれらを読み取り専用で表示し、エンジン設定で変更 へのリンクを出します。Firebird は再起動後に新しい値を読みます。
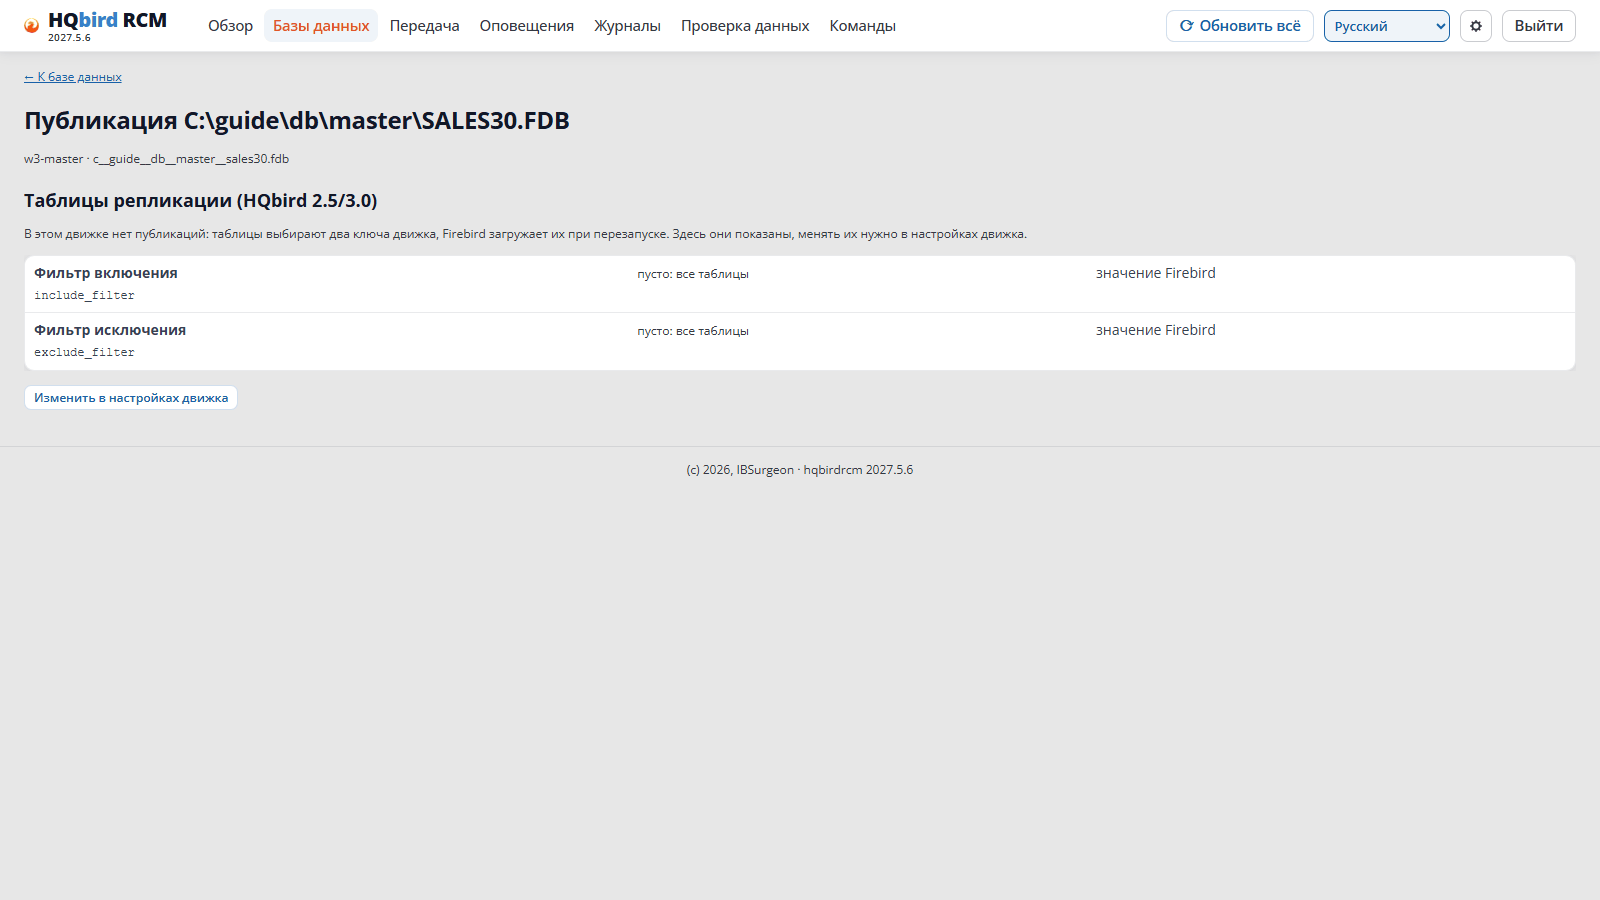
replconf プラグイン。 ノードは Firebird のフォルダに自分の replconf.hqcluster.hqbird ファイルを書きます。Firebird がそれを読むのは、replconf.properties がそれを指しているときだけです。プラグインは一度有効化する必要があります。
-
設定 → ノード、レプリケーションプラグイン(HQbird 2.5 / 3.0) のブロック。ブロックは
replconf.propertiesの指す先と、ノードが見つけた問題を表示します。
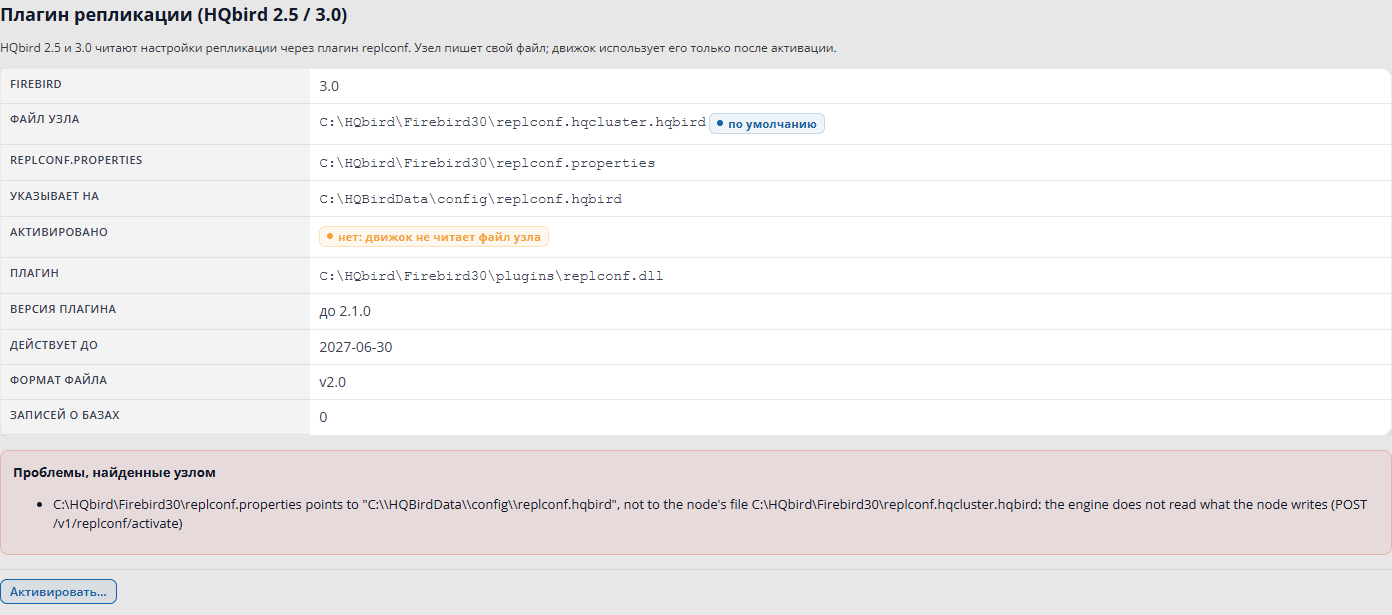
-
有効化… ウィンドウはノードが行うことを列挙します。プラグインのインストール、
replconf.propertiesをノードのファイルへ向けること、古いファイルの項目の移行。いつ行うかを選びます。ノードの再起動ウィンドウの中だけ、または 今すぐ、再起動ウィンドウを無視。
-
Firebird の再起動後、有効化済み フィールドは「はい:エンジンはノードのファイルを読んでいます」と表示します。
有効化は Firebird を再起動し、この Firebird の すべてのデータベース に影響します。静かな時間に行います。
7. その他のレプリケーションオプション
7.1. レプリケーションパラメータ
設定 → レプリケーションパラメータ ページは、選択したデータベース、またはノード全体について、replication.conf のキーを変更します。
-
マスターとレプリカを追加 — データベースを選びます。RCM は Firebird のバージョンと役割でグループ化します。マスター用とレプリカ用で別のフォームです。
-
各パラメータについて操作を選びます。
操作 行うこと 変更なし 値は変わらない 値を設定 新しい値 リセット(上位レベルへ) 自分の値を外し、上のレベルの値を取る 書き込まない(Firebird の値) キーは書かれず、Firebird の値が適用される -
適用先を選びます。選択したデータベースへ、または それらのノードの既定として。
-
プレビュー — ノードは何も変えずに値を確認します。
- 適用。RCM は各ノードへコマンドを送ります。
値の出どころ(現在 列):
| 出どころ | 値 |
|---|---|
| このデータベース | データベースに設定されている |
| ノードの値 | ノードの既定として設定されている |
| ノード組み込みの値 | コード内のノードの値 |
| Firebird の値 | キーは書かれていない |
| ファイルから(ここではまだ未設定) | replication.conf の値。RCM はまだ変えていない |
| ノードが設定 | 読み取り専用(パス、接頭辞) |
応答しないノードは、そのデータベースを選択不可として表示します。変更には fbagent が必要です(なければ fbagent_required)。
誰が Firebird を再起動するか(Firebird が replication.conf を読むのは起動時だけです):
| ノード | 誰が |
|---|---|
| マスター | あなたが再起動する。マスターは Firebird を自分では再起動しない |
firebird.auto_restart: never のレプリカ |
あなた |
| Firebird がマスターのデータベースも提供しているレプリカ | あなた |
| ほかのレプリカ | ノードが再起動する。自分の再起動ウィンドウの中で |
手動再起動のため、ページには Firebird を再起動 ボタンがあります。
7.2. 主なパラメータ
マスター、Firebird 4/5:
| パラメータ | RCM のラベル | ノードの値 | Firebird | ヒント |
|---|---|---|---|---|
journal_archive_timeout |
アーカイブのタイムアウト | 10 秒 | 60 秒 | 未完成のセグメントを閉じる前に Firebird が待つ秒数。小さくするとレプリカはマスターに近くなる。limits.data_check_quiet_sec(90)より小さくなければならない |
journal_segment_count |
セグメント数 | 64 | 8 | .ReplLog に置けるセグメント数。limits.backlog_critical(48)より大きくなければならない |
journal_segment_size |
セグメントサイズ | — | 16 MB | 1 MB から 512 MB。受信側は 512 MB を超えるものを受け付けない |
buffer_size |
— | 1 MB |
ノードは log_errors = true(変更不可)と disable_on_error = true も書きます。
レプリカ、Firebird 4/5:
| パラメータ | RCM のラベル | Firebird | 値 |
|---|---|---|---|
apply_idle_timeout |
アイドル時の休止 | 10 秒 | 新しいセグメントがないときの休止 |
apply_error_timeout |
適用エラー後の休止 | 60 秒 | エラー後、再試行前の休止 |
verbose_logging |
ノード:true |
詳細な replication.log。無効化は推奨しない |
|
skip_upddel_without_pk |
ノード:true |
キーのないテーブルでの UPDATE/DELETE をスキップする |
Firebird 5 のみ:include_filter、exclude_filter、cascade_replication。
HQbird 2.5/3.0 — 同じ意味の log_* キー:log_archive_timeout、log_segment_count、log_segment_size(buffer_size の 2 倍以上)。alert_command キーは node.json だけで設定します。
各パラメータのヒントは RCM のフォームにあります。
7.3. アーカイブの保管
マスター上の <database>.LogArch アーカイブは段階的に掃除されます。
- すべてのレプリカが 適用済み で、
retention_daysより古いセグメント。 - 空き容量が
free_space_floor_gbより少ない場合 — 保持期間より新しい適用済みセグメント。アラートdisk_serious_cleanup。 - それでも容量が少ない場合 — 最も古いものから 未適用 のセグメント。レプリカは
NEEDS_REINITを受け取り、アラートreplication_paused_reinit_scheduled。
| パラメータ(設定 → ノード、ストレージとファイル) | 既定 |
|---|---|
limits.retention_days — アーカイブの保持、日 |
2 |
limits.retention_min_kept_segments — 最後のセグメントを常に残す |
0(無効) |
limits.free_space_floor_gb — 最小空き容量 |
1 GB |
アーカイブを手動で掃除する:
hqbirdrcm cleanuparchive -node node-a              # stages for all databases on the node
hqbirdrcm cleanuparchive -node node-a -db <db_id> # a single database-orphaned(-db と一緒のときだけ)は、ORPHANED 状態のデータベースの すべての セグメントを削除します(第 3.8 章)。ほかのデータベースに対して、ノードは not_orphaned と応答します。昇格のドナーに対して -orphaned を実行しては いけません(第 8.5 章)。
7.4. 転送:圧縮、速度、ウィンドウ
圧縮 はピアごとに設定します。設定 → ノード → ピア、列 compress。
| 値 | 意味 |
|---|---|
空または none |
圧縮なし(既定) |
zstd |
zstd 圧縮 |
変更は直ちに有効になります。圧縮は遅いネットワークで有用です。
セグメント転送速度(設定 → ノード、転送と再初期化):
| パラメータ | 既定 | 有効になるとき |
|---|---|---|
limits.channel_a_mbps — セグメント転送速度 |
50 MB/s | 直ちに |
limits.channel_a_burst_mbps — セグメント転送のバースト |
200 MB | 直ちに |
単位はメビバイト(MiB)です。名前は “mbps” ですが。バーストは速度より小さくできません。
時間ウィンドウ(時間ウィンドウ):
| パラメータ | 既定 | 有効になるとき | 影響するもの |
|---|---|---|---|
windows.restart_window — Firebird 再起動ウィンドウ |
マスター 22:00-05:00、レプリカ always |
直ちに | レプリカノードが Firebird を再起動してよい時刻 |
windows.transfer_window — 転送ウィンドウ |
23:00-05:00 |
ノード再起動後 | 初期化の全速(第 5.5 章) |
各フィールドの隣のラベルは、変更がいつ有効になるかを示します。直ちに または ノード再起動。
7.5. データの検証
- 検証 — マスターとレプリカの行数の一回限りの比較(第 5.10 章)。
- データ検証 — 定期的な比較(第 5.10 章)。ノードは、マスターとレプリカが同じセグメント上にあるときに比較を行います。
- HQbird 2027.2.24 では、検証の設定は 保存 の直後に有効になります。ノードサービスの再起動は不要です。RCM は「保存済みですでに有効」と表示します。有効化のあと、最初の検証は 1 間隔のあと実行されます。無効化のあと、進行中の検証は中断され、何も書きません。新しい間隔は最後の検証の終わりから数えられます。保持、日、クエリ上限、静寂、進捗ジェネレータ は次の検証から有効になります。
- ノード 2027.5.7 はこれらの設定を起動時だけ読みます。保存 のあと、そのノードの
hqclusternodeサービスを再起動します。RCM 2027.2.24 は「保存されたがまだ有効ではない」と表示し、理由を述べます。 - 比較するテーブルは、データベースのテーブル一覧で定義されます(第 3.1 章)。HQbird 2027.2.24 では、各データベースが独自の一覧を持てます。登録時のフィールド、またはマスターのデータベースページの 同期追跡テーブル ブロック(第 3.3 章)。データ検証 ページは、使われた一覧と、「データベースにない」テーブルの数を表示します。2027.5.7 では一覧はノードごとです(
sync_tables)。 - パブリケーションから除外されたテーブルは「未公開」と表示されます(第 6.3 章)。
7.6. アラート
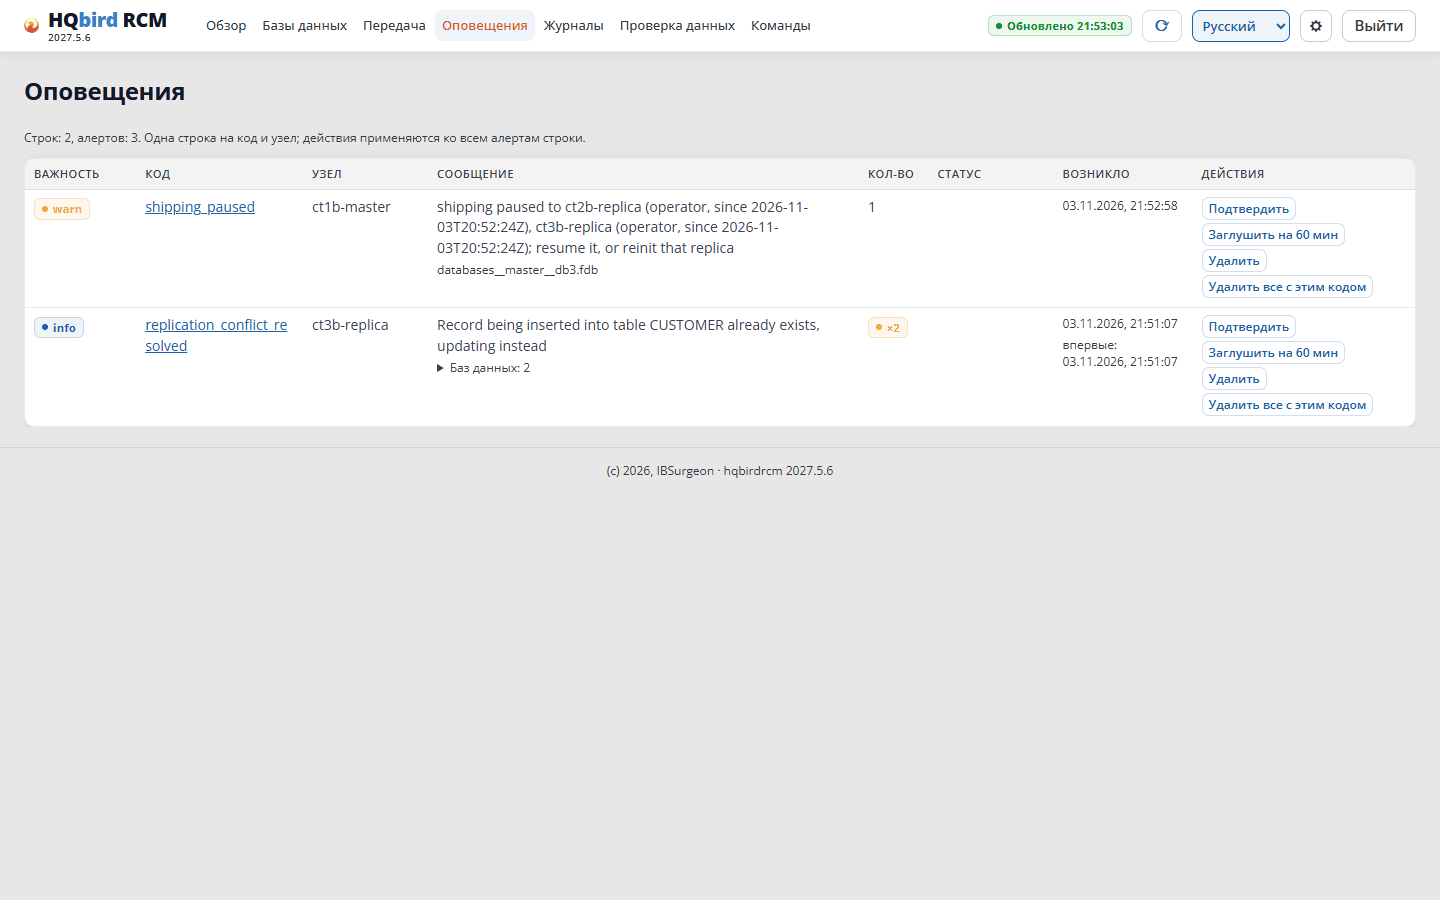
アラート ページ。操作:
- 確認 — アラートは表示されたまま、確認済み と印が付きます。
- 60 分間ミュート — 1 時間隠します。
- 削除 / このコードをすべて削除 — RCM は削除を、アラートを出したノードへ渡します。原因が残っていれば、アラートは再び現れます。
hqbirdrcm clearalerts -code backlog_warn # also -id, -acked, -allHQbird 2027.2.33 以降、RCM はアラートを Telegram、webhook(Slack、Teams、JSON)、電子メールへ送ります。チャネルは rcm.json ファイルの notify.channels 節で構成します。アラート ページの 通知チャネル ブロックはチャネルを表示し、テストメッセージを送ります。RCM はレベル warn 以上の問題を報告します。問題が現れた、より重大になった、または解消された。チャネルがなければ、RCM は何も送りません。以前のバージョンに送信はありません。アラート ページを見るか、RCM API をポーリングします。
主なコード:
| コード | 意味 |
|---|---|
backlog_warn / backlog_critical |
.ReplLog 内の未アーカイブセグメントが 32 / 48 |
disk_serious_cleanup |
アーカイブが段階 2 で掃除されている(7.3) |
replication_paused_reinit_scheduled |
未適用セグメントが削除された。初期化が必要 |
shipping_paused |
ピアへの送信が停止している(7.7) |
apply_error、replication_stopped、replication_unrecoverable_error |
レプリカがセグメントを適用できない |
replication_guid_mismatch |
マスターデータベースの GUID が変わった |
segment_missing、segment_rejected、sequence_gap |
セグメントの順序の問題 |
firebird_down、firebird_log_error |
Firebird が動作していない、またはエラーを記録している |
firebird_not_answering |
HQbird 2027.2.30 以降:Firebird が 1 分間データベース接続に応答していない(ハング)。タイムアウトで確立できなかった接続も含む。firebird_down は接続拒否だけ |
master_publication_off |
パブリケーションがオフ(第 6 章)。HQbird 2027.2.24 以降、および publication_off の失敗のあと(第 6.1 章) |
replica_removed_for_reinit |
HQbird 2027.2.24 以降:レプリカが初期化のために古いコピーを削除し、新しいコピーがまだない(第 4.4 章) |
orphaned_database |
スキャンの外のデータベース(第 3.8 章) |
restart_required_after_reinit |
レプリカの Firebird に再起動が必要(第 5.6 章) |
data_mismatch |
定期確認が不一致を見つけた |
license_paused |
fbagent にライセンスがない(第 2.8 章) |
7.7. 送信の一時停止
データベース ページのマスターの行:送信を一時停止 / 送信を再開。複数のデータベースは 操作 一覧から。
hqbirdrcm pauseshipping  -node node-a -db <db_id>
hqbirdrcm resumeshipping -node node-a -db <db_id>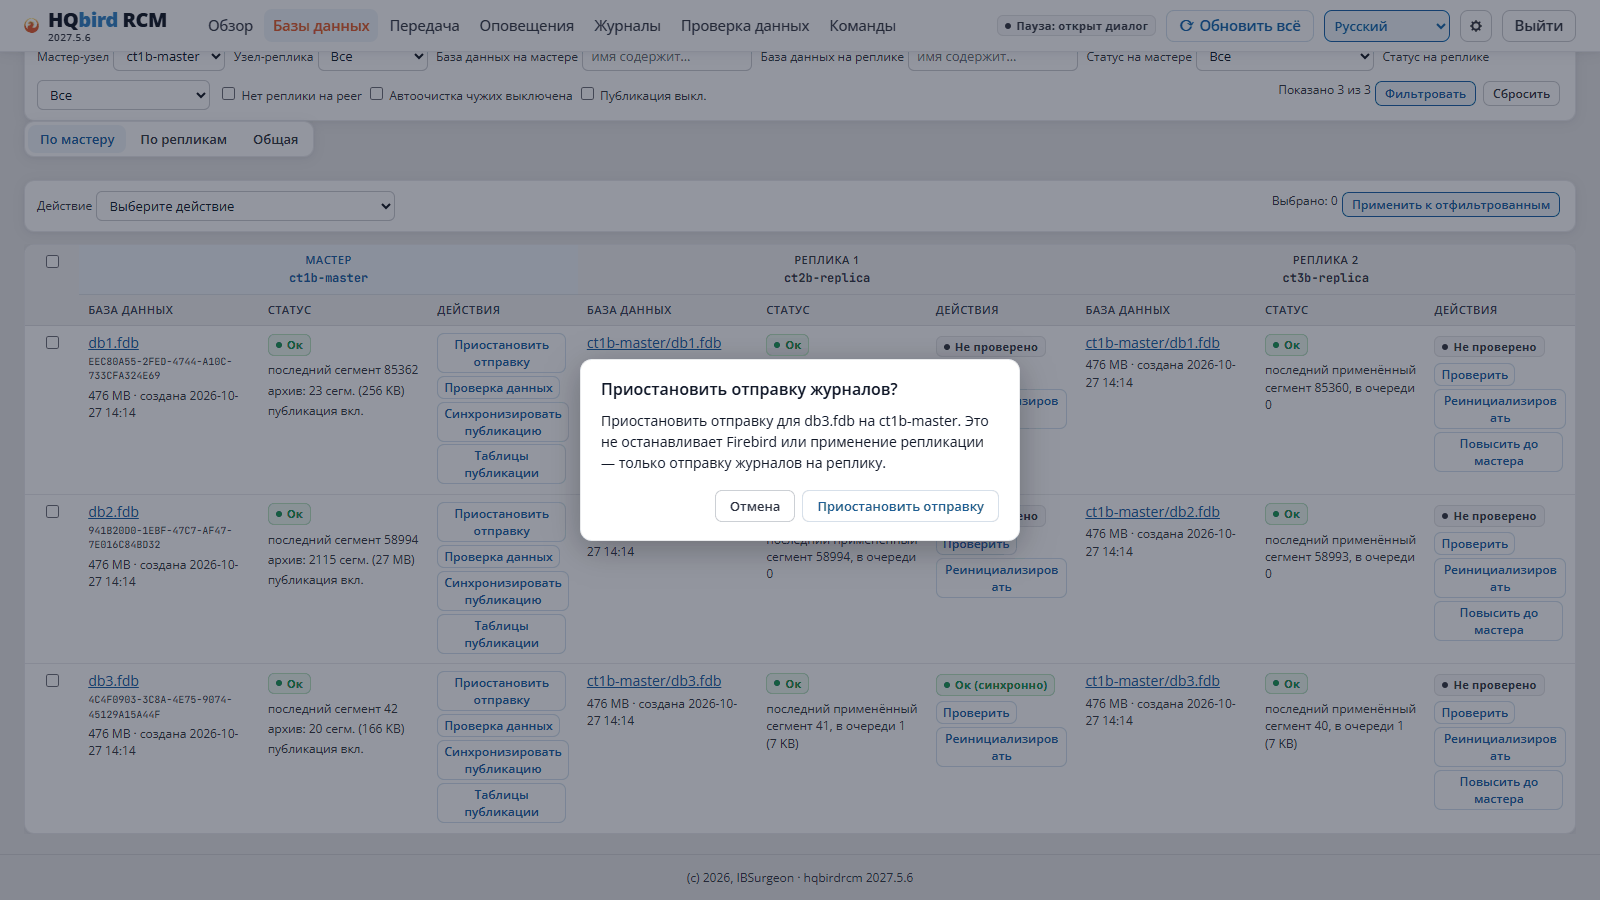
- 一時停止は 送信を再開 するか、初期化するまで有効です。
- マスターの Firebird はセグメントを書き続けます。
.LogArchアーカイブは成長します。レプリカが止まっている間、段階 1(7.3)はそのセグメントを削除しません。 - 長い一時停止は段階 3 と
NEEDS_REINITに達することがあります。容量に注意します。 - データベースにレプリカがない、またはパブリケーションが無効の場合、ボタンはありません。一時停止:ライセンスなし アイコンはライセンスに関する一時停止を意味します(第 2.8 章)。解除するのはライセンスだけです。
7.8. ログ
| ログ | 場所 |
|---|---|
| ノード | <installation folder>/logs/node-YYYYMMDD.jsonl(/opt/hqclusternode または C:\hqclusternode)、各 32 MB、20 ファイル |
Firebird の replication.log、firebird.log |
node.json のパス:firebird.replication_log、firebird.firebird_log |
| RCM | Linux:journalctl -u hqbirdrcm |
| RCM の監査 | rcm-data/audit.jsonl |
リモートのノードログ — ログ ページ:ノードとソースを選びます(replication.log、firebird.log、ノードエージェント)。
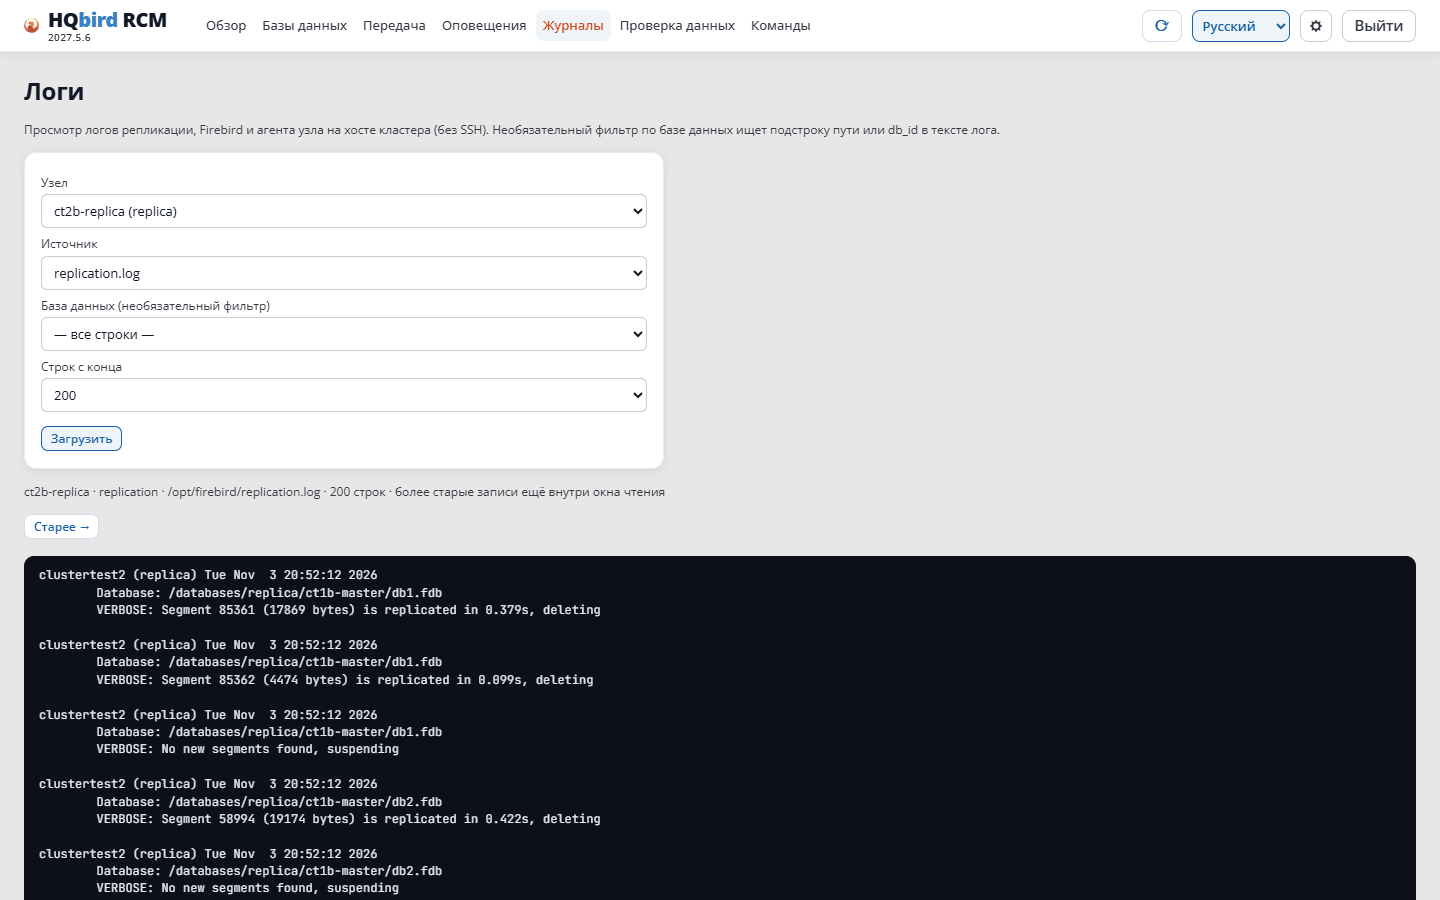
8. レプリカを通常のデータベースに移す方法
経路は 2 つあります。
| 経路 | いつ | 得られるもの |
|---|---|---|
| 通常化、8.1 | 独立した動作コピーが必要:レポート、テスト、新しいマスターを伴わない障害 | レプリケーションの外の通常のデータベース |
| マスターへ昇格、8.3 | レプリカが新しいマスターになるべきとき | マスター役割のコンパニオンノードが管理するデータベース |
どちらの経路も、インターフェースからは取り消せません。
8.1. 通常化
-
データベース、レプリカ側:レプリカの行にチェックを入れます。
-
操作 一覧で 通常化 を選び、確認します。行に専用のボタンはありません。コマンドラインのコマンドもありません。
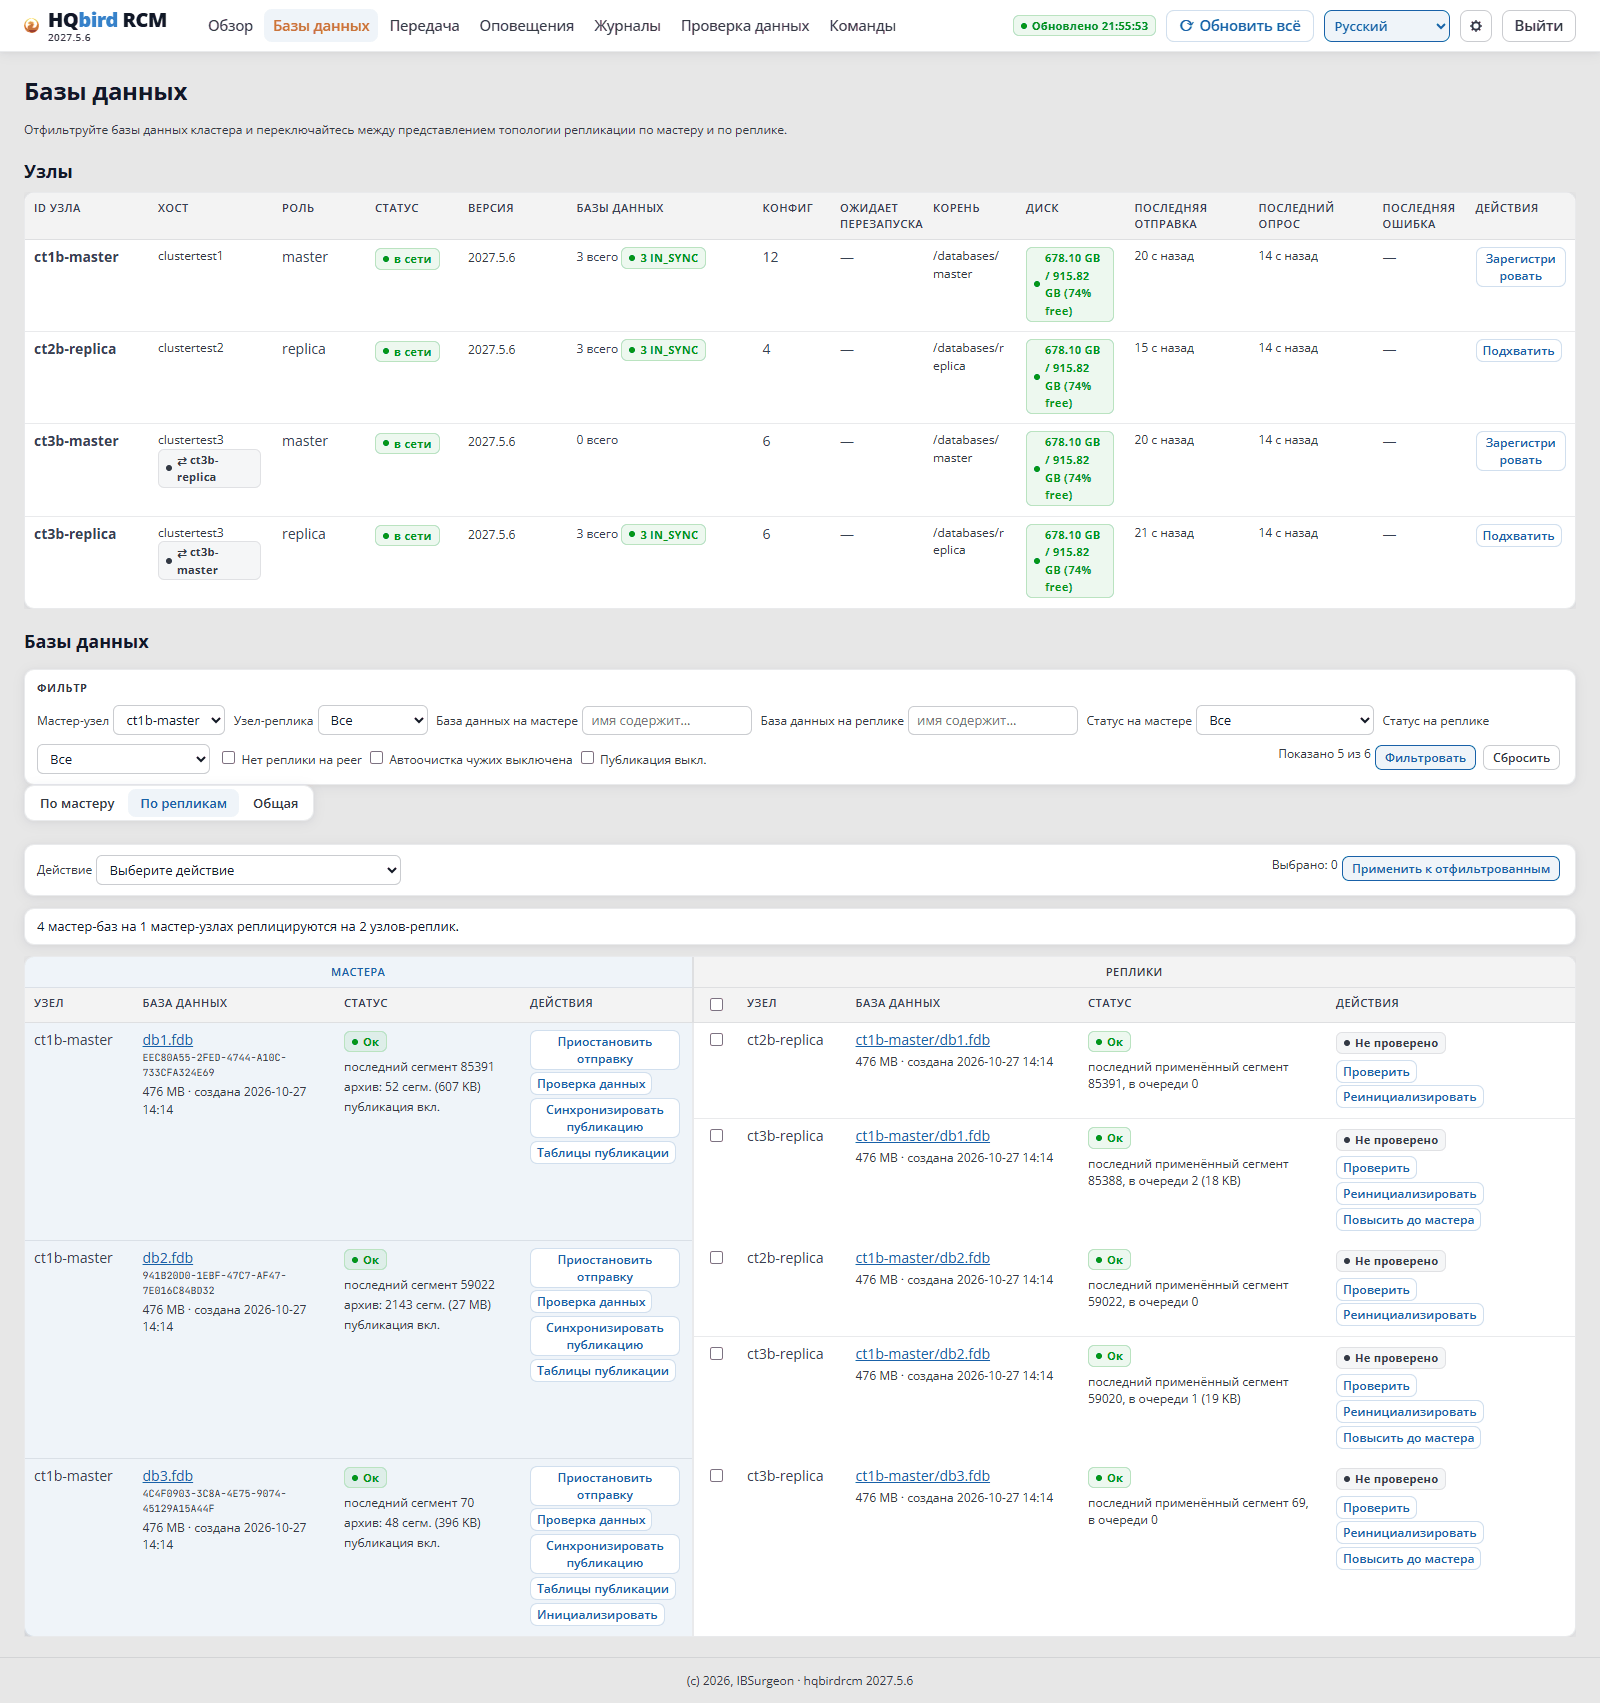
このあと、データベースは書き込みのために開きます。
replication.conf からレプリカのブロックを外します。 ノードは次のスキャンで外し、Firebird は起動時にファイルを読みます。
hqbirdrcm scansync -node node-b
hqbirdrcm restartfirebird -node node-b
それまでは、このデータベースについての「データベースはレプリカモードではない」エラーはアラートになりません。
マーカーファイルがデータベースを守ります。 初期化はそのようなデータベースを上書きしません。target_not_replica で拒否されます(第 5.9 章)。マーカーだけを削除しても不十分です。ノードはデータベースヘッダーのレプリカモードも確認します。古いレプリカを削除 チェックボックス(第 4.4 章)も、そのようなデータベースは削除しません。
HQbird 2027.2.24 では、レプリカが初期化のためにこのデータベースの古いコピーを削除している間、通常化 は reclaim_in_progress で拒否されます。あとで再試行します。
データベースを再びレプリカにする必要がある場合 — 上書き付きの新しい初期化だけが手段です。これはノード API 経由で行います(overwrite_non_replica: true)。RCM にそのようなボタンはありません。古いファイルは <database>.pre-reinit-<UTC time>.fdb として保存され、マーカーは削除されます。
8.2. セグメントがどうなるか
- ノードがデータベースをスキャンするまで、マスターはセグメントを送り続けます。レプリカノードは 30 秒ごとに古いセグメントを削除し、最後の 100 だけを残します(
keep_segments)。 - スキャンのあと、レプリカ上のデータベース記録は状態
ORPHANEDになります。レプリカノードはマスターにunknown_databaseと応答します。マスターはこのレプリカへのセグメント送信を止め、そのためのアーカイブ保持を止め、10 分ごとに再確認します。 - このデータベースのほかのレプリカは影響を受けません。
ORPHANEDの記録は削除できます(第 3.8 章):hqbirdrcm forgetdatabase。データベースファイルそのものは削除されません。
8.3. マスターへ昇格
レプリカが新しいマスターになります。ファイルはその場所に残り、制御は コンパニオンノード へ移ります。
条件:
| 条件 | 拒否 |
|---|---|
| データベースがレプリカである | bad_request |
同じホスト上でマスター役割のノード — コンパニオン — が動作している(rcm.json の同じ host ラベル、第 2.1 章) |
no_companion |
| このデータベースの昇格がすでに進行中ではない | already_running |
| このデータベースへの、またはそのマスターからの初期化がない | reinit_running |
RCM はコンパニオンノードを作りません。あらかじめインストールします(第 1 章)。
開始方法:
- レプリカの行の マスターへ昇格、または 操作 一覧。
- コマンドラインから:
hqbirdrcm promotetomaster -node node-b -db <db_id> # -timeout 10m
RCM は確認を求め、コンパニオンノードを名指しします。
手順(レプリカの行に見える。名前は英語):
| 番号 | 手順 | 行うこと |
|---|---|---|
| 1 | TURN TO NORMAL | 8.1 のとおり。データベースがすでに通常なら飛ばす |
| 2 | NEW GUID | その場で新しいデータベース GUID(8.4) |
| 3 | EXCLUDE ON DONOR | レプリカノード(ドナー)がファイルを自分のスキャンから除外する(exclude_paths) |
| 4 | ENROLL ON |
コンパニオンノードがファイルをマスターデータベースとして登録する |
| 5 | PUBLICATION SYNC | パブリケーションの同期。除外テーブルの一覧は古いマスターから引き継がれる(第 6.3 章) |
| 6 | RESTART DONOR FIREBIRD | ドナーの Firebird の再起動。ウィンドウを待たない |
| 7 | RESTART |
コンパニオンの Firebird の再起動。ウィンドウを待たない |
| 8 | FINALIZE | ドナーの行は ゴーストレプリカ になる。古いマスターは マスター劣化 になることがある(8.5) |
HQbird 2.5 と 3.0 にパブリケーションはありません。PUBLICATION SYNC の手順は「このエンジンにパブリケーションはありません」という文章で完了します。
ドナーとコンパニオンが同じ Firebird を使う場合、その Firebird は再起動されます。その すべての データベースへの接続が切断されます。
手順が失敗した場合、ジョブはエラー文章付きで failed になります。原因を直し、マスターへ昇格 を再度クリックします。完了した手順は繰り返されません。昇格中に RCM が再起動すると、ジョブも failed になります。ノードの状態を確認して再試行します。
ライセンス。 マスターのホストの fbagent にライセンスがない場合、マスターは送信を一時停止しています。昇格はそれでも可能です。RCM は警告します。一時停止が始まったあとの変更は失われます。
8.4. 新しい GUID
昇格のあと、データベースは自分の GUID を得る必要があります。そうしないと、新しいマスターは古いマスターの GUID でセグメントを書き、そのレプリカは duplicate_guid で拒否されます。
ノード上の NEW GUID の手順:
gfix -shut single -force 0— データベースへのすべての接続が切断されます。nbackup -L、そのあと-SEQUENCEなしのnbackup -F。<database>.deltaを削除します。- ヘッダーを確認します。新しい GUID、
REPLICATION_SEQUENCE= 0。 gfix -online normal。
Firebird は再起動されません。この方法はすべてのバージョン(2.5、3.0、4.0、5.0)で動作します。
手順が中断された場合、ノードはアラート newguid_interrupted を出します。データベースは single シャットダウンのままのことがあります。マスターへ昇格 を繰り返します。手順は続きます。
手順は飛ばされます(文章は skipped: で始まります)。ドナーノードが古いバージョンであるか、ファイルがすでに自分の GUID を持っている場合です。
新しい GUID のあと、古い nbackup の連鎖はもう使えません。新しいレベル 0 の nbackup コピーを作ってください。
データベースが ADD DIFFERENCE FILE で作られた場合、その .delta は別の場所にあります。手動で削除します。
8.5. 昇格のあと
ドナーの記録。 レプリカノード上でデータベースは ORPHANED のまま、パスは exclude_paths に残り、.Incoming フォルダとラベルが残ります。RCM ではこれは ゴーストレプリカ の行で、ボタンは 新しいマスターで開く と クリア です。
- 行を外すには クリア をクリックします。変わるのは RCM だけです。
- レプリカノードからドナーの記録を外すには、
forgetdatabaseを実行します。ファイルと.Incomingフォルダは残ります。HQbird 2027.2.30 以降はコマンドを拒否しません(mailbox_active)。ドナーのパスがexclude_pathsにあるからです。以前のバージョンのノードは、ファイルと.Incomingフォルダがある間は拒否します。 - ドナーに対して
cleanuparchive -orphanedを実行してはいけません。 ドナーとコンパニオンは同じ<database>.LogArchフォルダを共有します。コマンドは新しいマスターの生きているアーカイブを削除します。
古いマスター。
-
ドナーがその最後の動作中レプリカだった場合、RCM は古いマスターを マスター劣化 にし、ドナーへの送信を一時停止します(「送信一時停止:…(マスターへの昇格)」)。ドナーへの送信を再開しないでください。そこにはすでに動作中のデータベースがあります。この状態を消すには、データベースを別のレプリカへ初期化します。
古いマスター:「マスター劣化」、送信一時停止
- 古いマスターからドナーノードへの初期化は拒否されます(
target_not_replica)。そこにはすでに動作中のデータベースがあります。 - NEW GUID の手順が飛ばされた場合、古いマスターと新しいマスターは同じ GUID を持ちます。その場合、古いマスターからの初期化には
-forceが必要です(第 5.9 章)。 - 手動の昇格のあと、RCM は古いマスターを新しいマスターのレプリカにはしません。古いマスター上のアプリケーションを止め、そのデータベースを管理から外します(第 3.8 章)。サービスとして記述されたデータベースでは、これは再参加が行います(8.7)。
新しいマスター。 そのためのレプリカを用意します。レプリカノード、ピア(第 2 章)、パブリケーション(第 6 章)、初期化(第 5 章)。
8.6. 計画的スイッチオーバー:チェックリスト
これは手動スイッチオーバーの手順です。サービスとして記述されたデータベースでは、RCM が自分でマスターを切り替えます(8.7)。手動の昇格は、アプリケーションが古いマスターに書き込んでいるかを確認しません。手順:
- 事前に。 レプリカホスト上で、マスター役割のコンパニオンノードが動作し、両方のノードが同じ
hostラベルを持っている(第 2.1 章)。新しいマスターのための将来のレプリカ用ノードが準備できている。 - 古いマスターのデータベースへのアプリケーションの書き込みを止める。
- レプリカがすべてを受け取り適用するまで待つ。データベース →
IN_SYNC、キューなし。 - 確認(第 5.10 章):行数が一致する。
- マスターへ昇格(8.3)。FINALIZE の手順を待つ。
- 確認:データベースがコンパニオンのマスター一覧にあり、パブリケーション有効。
- アプリケーションを新しいマスターへ切り替える。
- 新しいデータベースの nbackup レベル 0 コピーを作る(8.4)。
- ドナーの行の ゴースト記録をクリア する(8.5)。
- レプリカを新しいマスターに接続し、初期化する(第 5 章)。
- 古いマスター:データベースを管理から外すか、アーカイブとして残す(8.5)。
8.7. サービス:RCM でのスイッチオーバーとフェイルオーバー
HQbird 2027.2.30 以降、RCM は自分でマスターを別のホストへ移します。そのために、データベースを サービス として記述します。複数ホスト上の 1 つの論理データベースです。サービスの各ホストにはマスターノードとレプリカノードがあり、データベースファイルへのパスは同じです。サービスは サービス ページ(HQbird 2027.2.31 以降)で作るか、コマンド hqbirdrcm services put -id <id> -file <file>.json で作ります。
| 操作 | 行うこと | コマンド |
|---|---|---|
| スイッチオーバー | データ損失のない、計画的なマスターの移動。そのあと古いマスターは自動的に新しいマスターのレプリカになる | hqbirdrcm switchover -service <id> -check、そのあと hqbirdrcm switchover -service <id> -to <host> |
| フェイルオーバー | マスターのホストが失われた。RCM がレプリカを昇格する。マスターの最新の変更は失われることがある | hqbirdrcm failover -service <id> -check、そのあと hqbirdrcm failover -service <id> -to <host> -accept-data-loss |
| 再参加 | フェイルオーバーのあと、古いホストを新しいマスターのレプリカとして戻す | hqbirdrcm rejoin -service <id> |
| 再開 | サービスを failed 状態から出す |
hqbirdrcm resume -service <id> -check、そのあと hqbirdrcm resume -service <id> |
同じ操作はサービスのページにあります。スイッチオーバー…、フェイルオーバー…、再参加…、再開… のボタンです。
- 自動フェイルオーバー は既定でオフです。サービスごとに有効にします。
hqbirdrcm policy -service <id> -auto-failover on -max-data-loss 30。ルーターが必要です。RCM がフェイルオーバーを始めるのは、マスターノードが沈黙し、ルーターの過半数がマスターの Firebird を見えず、レプリカの遅延がmax_data_loss_sec以下のときだけです。 - ルーター(
hqclusternode router、Linux)は、サービスの現在のマスター上に HAProxy を維持します。アプリケーションは<router host>:<router_port>に接続し、切り替えのときに接続文字列を変えません。 - フェイルオーバーのあと、古いマスターが再び応答すると、RCM はそれを隔離します(役割
fenced)。rejoinコマンドで戻します。