이 안내는 HQbird 복제 클러스터의 설치와 사용을 설명합니다. 대상은 hqclusternode 노드와 클러스터 관리자 hqbirdrcm(RCM)입니다.
Firebird 관리자를 위한 안내입니다. Firebird, gfix, nbackup 을 알고 있다고 가정합니다. 노드의 내부 동작을 알 필요는 없습니다.
클러스터의 구성 요소
구성 요소
개수
실행 위치
하는 일
Firebird(HQbird)
하나 이상의 인스턴스
각 데이터베이스 서버
데이터베이스를 저장하고 복제 세그먼트를 기록
fbagent
Firebird 인스턴스마다 하나
Firebird 옆
노드의 요청에 따라 Firebird 를 중지하고 시작
hqclusternode(노드)
인스턴스와 역할의 조합마다 하나
Firebird 옆
복제를 구성하고, 세그먼트를 전송하고, 레플리카 초기화를 수행
hqbirdrcm(RCM)
클러스터마다 하나
모든 노드가 보이는 임의의 호스트
웹 인터페이스, 명령, 경보, 통계
노드에는 역할 이 있습니다. master 또는 replica 입니다. 하나의 Firebird 인스턴스에서 노드 두 개를 실행할 수 있습니다. 마스터 노드와 레플리카 노드입니다. 이 경우 이 Firebird 의 데이터베이스 일부는 마스터이고 나머지는 레플리카입니다.
동작 방식
마스터에서 Firebird 는 데이터베이스 변경을 세그먼트(복제 로그 파일)에 기록합니다.
마스터 노드는 보호된 채널(mTLS)로 세그먼트를 레플리카 노드에 보냅니다.
레플리카 노드는 세그먼트를 수신 세그먼트 폴더에 둡니다. 레플리카의 Firebird 가 그것을 데이터베이스 복사본에 적용합니다.
데이터베이스의 첫 복사본은 마스터 노드가 직접 레플리카로 전송합니다. 이것을 초기화(reinit)라고 합니다. nbackup 을 거치며, 그동안 마스터는 계속 실행됩니다.
노드는 통계를 RCM 에 보냅니다. RCM 은 클러스터 상태를 보여주고, 운영자 명령을 노드에 보냅니다.
클러스터 동작: 세그먼트, 초기화, 통계, 운영자 명령
지원 버전
Firebird / HQbird 5.0 과 4.0 — 모든 기능.
HQbird 3.0 과 2.5 — replconf 플러그인을 통한 복제. 게시는 없습니다. 테이블 집합은 필터로 정의합니다. 차이는 “HQbird 2.5/3.0” 상자에 설명되어 있습니다.
마스터와 레플리카의 Firebird 주 버전은 일치해야 합니다. 그렇지 않으면 레플리카 노드가 초기화를 거부합니다.
포트
포트
수신 대기
접속하는 쪽
용도
7051
노드
다른 노드와 RCM
노드 API, 세그먼트와 데이터베이스 복사본 전송
7443
RCM
모든 노드
노드에서 통계 수신
7444
RCM
운영자
웹 인터페이스와 운영자 API. RCM 을 통한 설치(1.3장): 모든 주소에서 HTTPS. HQCenter Admin 을 통하거나 수동 설치: HTTP, 127.0.0.1 만
7450–7459
fbagent, 연결 창이 열려 있는 동안
RCM
호스트 연결(1.3장)
13050
fbagent, 127.0.0.1 만
같은 호스트의 노드
Firebird 관리
3050
Firebird
응용 프로그램
일반적인 데이터베이스 동작
한 호스트에 노드가 두 개(마스터와 레플리카)이면 두 번째 노드는 다른 포트를 씁니다. RCM 을 통해 설치하면 두 번째 노드는 포트 7061 을 받습니다. 그 외에는 포트를 직접 지정합니다. 예: 7052.
포트 13050 을 네트워크에 노출하면 안 됩니다. HTTP 인 포트 7444(HQCenter Admin 을 통하거나 수동 설치)도 마찬가지입니다. RCM 웹 인터페이스에는 SSH 터널로 접속합니다(1장). RCM 을 통해 설치하면 포트 7444 는 HTTPS 로 동작하고, 설치 프로그램이 방화벽에서 엽니다.
핵심 규칙: fbagent 가 없으면 변경하지 않음
노드가 복제 구성을 바꾸는 것은 fbagent 를 통해서뿐입니다. Firebird 를 다시 시작해야 하기 때문입니다. fbagent 를 쓸 수 없으면 노드는 구성을 바꾸는 동작을 거부합니다. “일부만” 동작하지 않습니다.
Windows 에는 -Cluster 매개변수가 없습니다. fbagent 는 LocalSystem 으로 실행되며 클러스터 폴더를 직접 만듭니다.
주요 매개변수:
Linux
Windows
의미
--goafts <name>
-Goafts
다운로드할 HQCenter Admin 서버. 이름은 공급자가 제공
--enroll
-Enroll
fbagent 를 HQCenter Admin 에 등록(인증서 요청)
--cluster
—
/opt/hqclusternode 와 /opt/hqbirdrcm 폴더를 만듦(fbagent 2.55.2 이하에서만 필요. 이후 버전에는 해가 없음)
--channel
-Channel
fbagent 업데이트 채널. 기본값은 stable
--token
-Token
라이선스 토큰. HQCenter Admin 이 요청을 자동으로 승인
--port
-Port
Firebird 포트
--yes
-Yes
질문하지 않음(터미널이 없을 때 필요)
전체 매개변수 목록은 fbagent 설치 스크립트의 README 를 보십시오.
2단계. fbagent 요청 승인
--enroll 매개변수가 있으면 fbagent 는 인증서 요청(CSR)을 HQCenter Admin 에 보내고 최대 30분 동안 승인을 기다립니다. 승인 방법은 다음과 같습니다.
자동 — 라이선스 토큰(--token)으로 설치했고 라이선스에 빈 슬롯이 있는 경우.
HQCenter Admin 패널에서 — CSR 요청 절, 이 호스트의 요청, 승인 후 서명 단추.
HQCenter Admin API 로 — POST /v1/admin/csr-requests/{id}/approve.
등록이 성공하지 않으면(대기 시간이 끝난 경우 등) fbagent 자체는 동작하지만 스크립트는 종료 코드 2 로 끝납니다. 같은 매개변수로 스크립트를 다시 실행하십시오. 반복되는 것은 등록뿐입니다.
등록 후 몇 분이 지나면 fbagent 가 HQ Monitor 를 직접 설치합니다.
3단계. 클러스터 기술
fbagent 를 HQCenter Admin 클러스터에 추가하면 노드와 RCM 이 나타납니다. 클러스터를 기술하는 방법은 2장 에 있습니다.
클러스터를 저장한 뒤:
10분 안에 fbagent 가 HQCenter Admin 에서 클러스터를 받습니다(그 뒤 60초마다 변경을 확인).
RCM 호스트의 fbagent 가 클러스터 인증 기관(CA)을 만들고 모든 노드의 인증서에 서명합니다.
각 fbagent 는 자신의 클러스터 구성원에 대해 node.json 또는 rcm.json 을 씁니다.
다음 제품 확인(3분마다)에서 fbagent 가 서비스를 설치하고 시작합니다.
설치되는 항목과 위치:
항목
Linux
Windows
마스터 노드
/opt/hqclusternode/master/, 서비스 hqclusternode-master-p<port>
<HQbird>\hqclusternode\master\, 서비스 HQClusterNode-master-p<port>
레플리카 노드
/opt/hqclusternode/replica/, 서비스 hqclusternode-replica-p<port>
<HQbird>\hqclusternode\replica\, 서비스 HQClusterNode-replica-p<port>
RCM
/opt/hqbirdrcm/, 서비스 hqbirdrcm
<HQbird>\hqbirdrcm\, 서비스 hqbirdrcm
<port> 는 Firebird 포트입니다. 예: 3050. 하나의 fbagent 가 둘 수 있는 것은 마스터 노드 하나, 레플리카 노드 하나, RCM 하나, 라우터 하나까지입니다(hqclusternode router, HQbird 2027.2.30 부터, 8.7장).
Windows 에서. 2.83.0 보다 앞선 fbagent 는 노드를 C:\hqclusternode 에, RCM 을 C:\hqbirdrcm 에 설치했습니다. 이 폴더가 있으면 fbagent 는 계속 그 폴더를 사용합니다.
업데이트
fbagent 는 노드와 RCM 의 새 버전을 3분마다 확인합니다. 기본 채널은 stable 입니다. 레플리카 노드를 먼저 업데이트하고, 그다음 마스터 노드를 업데이트합니다.
업데이트 뒤 서비스가 시작되지 않거나 잘못된 버전을 보고하면, fbagent 는 이전 버전으로 되돌리고 새 버전을 차단합니다. 차단 목록: <fbagent folder>/update/<product>/blocked-versions.json. 그 버전을 다시 시도하려면 이 파일에서 해당 줄을 삭제합니다.
제품 상태: fbagent --product-status hqclusternode(또는 hqbirdrcm).
1.3. RCM 을 통한 설치(HQCenter Admin 없음)
클러스터는 RCM 이 관리합니다. 각 호스트의 fbagent 는 RCM 에서 클러스터 설명을 받고, RCM 호스트의 fbagent 가 인증서에 서명하며, 노드와 RCM 은 RCM 이 보관한 릴리스에서 업데이트됩니다.
제한:
RCM 마다 클러스터는 하나.
시트 는 3개까지. 시트는 마스터 노드 또는 레플리카 노드가 실행되는 호스트입니다. 같은 호스트의 마스터와 레플리카는 시트 하나입니다. RCM 만 실행되는 호스트는 시트를 차지하지 않습니다. 네 번째 호스트는 오류 seats_exceeded 를 냅니다.
RCM 은 fbagent 나 Firebird 를 업데이트하지 않습니다. fbagent 가 직접 업데이트하며 replication.conf, node.json, rcm.json, 인증서는 건드리지 않습니다.
방법은 두 가지입니다.
RCM 에서 호스트 연결 — 일반적인 방법. 세 가지 동작입니다. 각 호스트에서 설치 프로그램(한 호스트는 RCM, 나머지는 디스커버리 모드), RCM 로그인, 호스트 연결 양식.
명령줄에서 수동 — 참여 토큰과 fbagent --cluster-join. 호스트 사이에 포트 7450 이 닫혀 있거나 페어링 창이 이미 닫힌 경우에 필요합니다.
라이선스. 평가판 라이선스에는 cluster 기능이 포함됩니다. 평가 기간이 끝난 뒤 라이선스에 cluster 가 없으면 fbagent 는 노드나 RCM 을 설치하지 않습니다. 이미 설치된 노드와 RCM 의 업데이트를 막지는 않습니다. HQCenter Admin 이 없으면 유동 라이선스는 online_check_days 에 유예 일수를 더한 기간이 지나면 동작을 멈춥니다. 따라서 각 fbagent 에 바인딩 라이선스를 설치합니다.
Command
fbagent --license-request --out license_request.json
# send the file to the vendor and receive license.jsonfbagent --license-install license.json
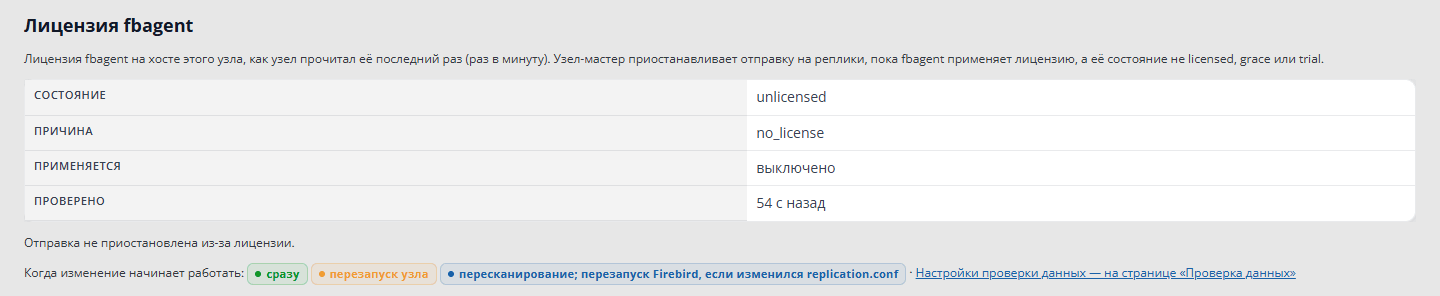
라이선스가 없으면 마스터는 세그먼트 전송을 멈춥니다(2.8장).
포트:
포트
위치
접속하는 쪽
7443
RCM 호스트
클러스터의 모든 호스트의 fbagent 와 노드
7444
RCM 호스트
운영자 브라우저(RCM 콘솔, HTTPS)
7450(두 번째 이후 fbagent 호스트는 7451…7459)
디스커버리 모드의 호스트, 페어링 창이 열려 있는 동안
RCM 호스트의 RCM
7051(같은 fbagent 의 두 번째 노드는 7061)
노드 호스트
다른 노드와 RCM(1.4, 7단계)
RCM 에서 호스트 연결
처음부터의 예. Linux 서버 두 대, .run 설치 프로그램, 연결, 등록, 게시, 부하가 있는 초기화와 재초기화. 스크린샷과 측정값 포함. 안내 hqbird2027-linux-cluster-guide.ru.md 와 런북 hqbird2027-linux-cluster-runbook.ru.md(goafts 저장소, documentation 폴더).
1단계. 각 호스트에 HQbird 설치
각 데이터베이스 서버에 전체 설치 프로그램 으로 HQbird 를 설치합니다. HQCenter Admin 에는 등록하지 않습니다(--enroll).
기본적으로 설치 프로그램은 클러스터를 구성하지 않습니다. 노드와 RCM 프로그램을 fbagent 폴더(update/<product>/staged/)에 두지만, RCM 을 설치하지 않고, 페어링 창을 열지 않으며, 방화벽에서 클러스터 포트를 열지 않습니다. 클러스터는 두 매개변수로 켭니다.
Command
sudo sh hqbird2027-fb50-linux-<version>.run --rcm on # RCM hostsudo sh hqbird2027-fb50-linux-<version>.run --cluster-pairing on # other hosts
--rcm on — 클러스터의 RCM 이 실행될 호스트 하나에서. 설치 프로그램은 다음을 합니다.
이 호스트의 클러스터를 만듭니다(fbagent --cluster-init). 클러스터 이름은 호스트 이름입니다.
RCM 을 설치하고 시작합니다. RCM 콘솔은 포트 7444 의 HTTPS 로 동작합니다.
첫 RCM 관리자 rcmadmin 을 임의의 암호로 만듭니다.
방화벽에서 포트 7443, 7444, 노드 포트 7051 을 엽니다.
--cluster-pairing on(디스커버리 모드) — 나머지 각 호스트에서. 설치 프로그램은 fbagent 의 페어링 창 을 24시간 엽니다. 포트 7450 과 노드 포트 7051 입니다. 창이 열려 있는 동안 네트워크의 RCM 이 이 호스트를 자신의 클러스터로 초대할 수 있습니다. fbagent 는 1분 안에 포트 7450 에서 수신을 시작합니다.
이 매개변수가 없으면 설치 프로그램이 스스로 묻습니다. 텍스트 인터페이스에서는 클러스터 페이지이고, --no-tui 에서는 질문이 두 개입니다. 기본 답은 “아니요"입니다. 클러스터 매개변수 없는 --yes 도 두 질문에 “아니요"로 답합니다.
마지막에 설치 프로그램은 RCM: 과 Pairing: 줄을 출력합니다. RCM 호스트에서는:
text
RCM:        https://10.0.0.7:7444 (cluster db1)
CA hash:    sha256:7cfc1d4b…032d2582
Login:      rcmadmin
Password:   in /opt/hqbird/fbagent-fb50/clusterca/db1/rcm-initial-password (read it with sudo; RCM asks for a new one at the first login)
Pairing:    not needed: this agent runs the RCM; other agents link through it
다른 호스트에서는:
text
RCM:        off; turn it on in HQbird Monitor or with fbagent --cluster-init <id>
Pairing:    port 7450 open until 2026-11-17T17:49:18Z (fingerprint sha256:0439e44a…91a2f9b9); an RCM may invite this host
출력에 암호는 없습니다. Password: 줄의 파일에 있습니다. 디스커버리 모드인 각 호스트의 fingerprint 를 적어두십시오.
Linux 설치 프로그램의 클러스터 매개변수:
매개변수
하는 일
--rcm on|off
이 호스트에 RCM 을 설치하고 클러스터를 만듦. 기본값 off
--cluster-pairing on|off
디스커버리 모드. 페어링 창을 24시간 염. 기본값 off
--pairing-port N
새 fbagent 의 페어링 포트. 7450–7459. 기본값은 첫 빈 포트
--rcm-password-file F
파일 F 의 첫 줄을 RCM 관리자 암호로 사용. 임의 암호 대신
--cluster-id ID
호스트 이름 대신 클러스터 이름 ID(--rcm on 과 함께)
--cluster-node on|off
노드 프로그램을 설치. 기본값 on
--rcm-allow A,B
이 호스트를 초대할 수 있는 RCM 을 이것으로 제한. 주소, CIDR 네트워크 또는 이름
호스트의 첫 fbagent 는 페어링 포트 7450 과 노드 포트 7051, 7061 을 받습니다. 같은 호스트의 두 번째 인스턴스는 7451, 7052, 7062 입니다.
RCM 과 페어링 창은 설치 프로그램 없이 나중에 켤 수 있습니다. HQ Monitor 의 클러스터 페이지, 또는 fbagent 사용자로 실행하는 명령입니다.
Command
cd <fbagent folder> # /opt/hqbird/fbagent-fb50sudo -u firebird ./fbagent --cluster-init <name> # RCM host; open ports 7443 and 7444 yourselfsudo -u firebird ./fbagent --cluster-pairing on # window for 24 hourssudo -u firebird ./fbagent --cluster-pairing off
sudo -u firebird ./fbagent --cluster-pairing status
오래된 설치 프로그램(fbagent 3.1.0 보다 앞)은 클러스터에 대해 묻지 않습니다. 모든 호스트에 RCM 을 설치하고 모든 곳에서 페어링 창을 엽니다. 필요한 것은 호스트 하나의 RCM 입니다. 다른 호스트의 RCM 은 연결 뒤 스스로 멈춥니다.
Windows 에서. Windows 설치 프로그램에도 같은 두 가지 선택이 있습니다. 매개변수 /RCM 과 /DISCOVERY 입니다.
2단계. RCM 에 로그인
RCM 호스트의 RCM: 줄에 있는 주소를 엽니다(https://<host>:7444). 로그인 rcmadmin 과 Password: 줄의 파일에 있는 암호로 로그인합니다. RCM 은 곧바로 새 암호를 요청합니다(1.5).
3단계. 호스트 연결
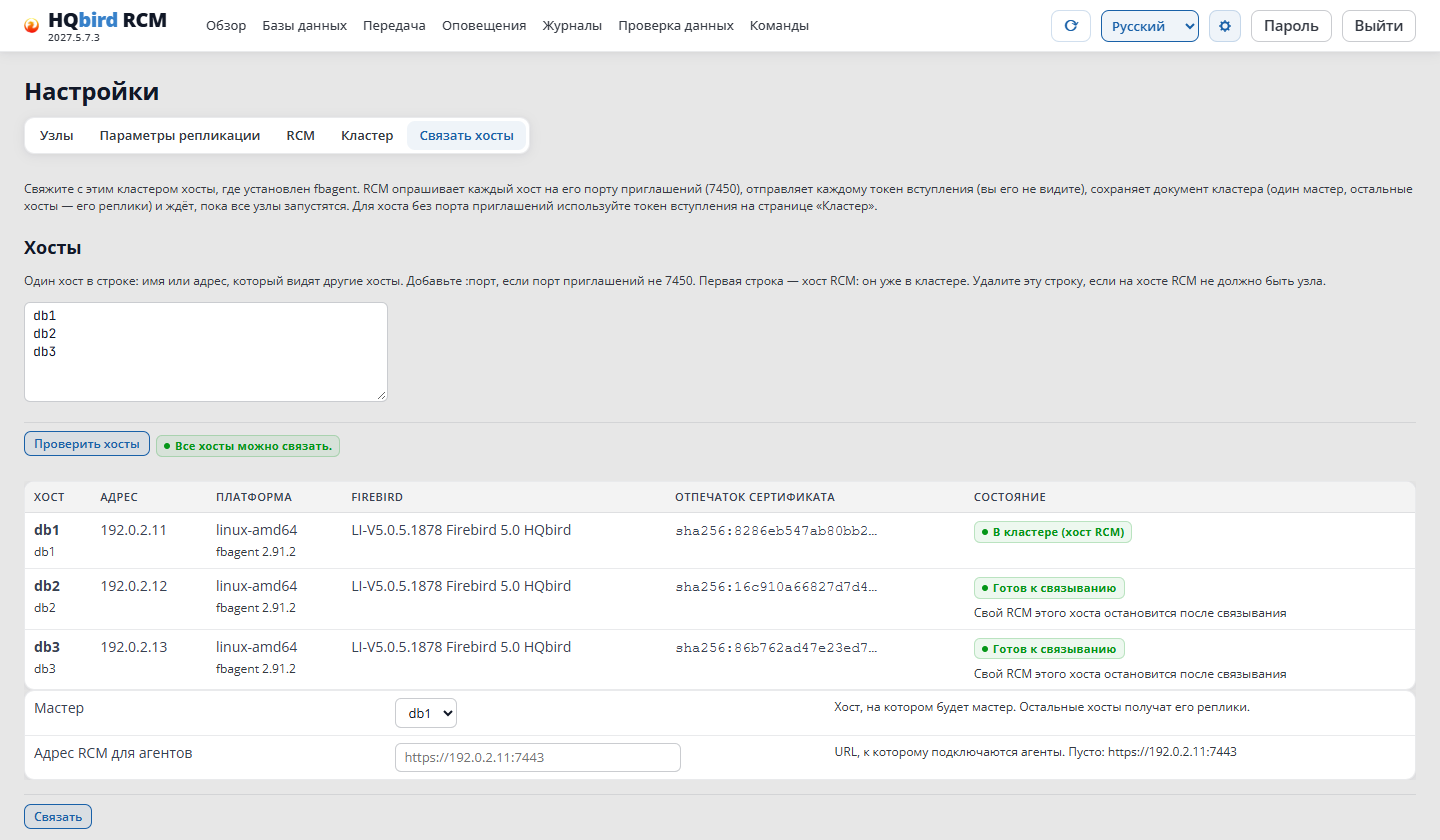
RCM 에서 설정 → 호스트 연결 을 엽니다.
호스트 칸에 호스트 주소 또는 이름을 한 줄에 하나씩 입력합니다. 첫 줄은 RCM 호스트이며 이미 클러스터에 있습니다.
호스트 확인 을 클릭합니다. RCM 은 각 호스트의 페어링 포트 7450–7459 를 조사하고 플랫폼, Firebird 버전, 지문, 상태를 보여 줍니다. RCM 호스트에는 페어링 창이 필요 없습니다. 지문을 설치 프로그램 출력(Pairing: 줄)과 비교합니다.
마스터 를 고르고(기본값은 첫 호스트) 연결 을 클릭합니다.
호스트 연결: 확인 결과
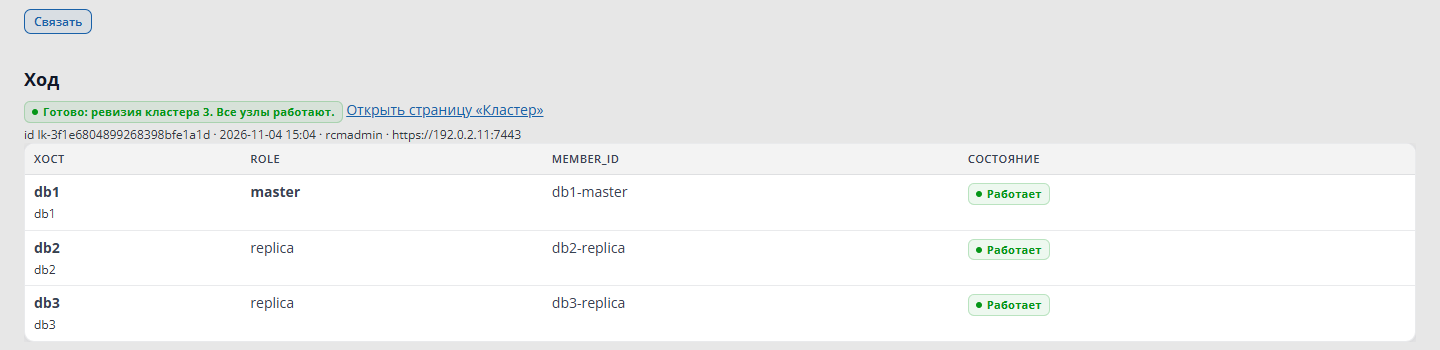
RCM 은 확인을 요청하고 진행 절에 진행 상황을 보여 줍니다. 모든 노드가 실행되면 “완료"라고 하고 클러스터 리비전 번호를 보여 줍니다.
호스트 연결: 모든 노드가 실행 중
명령줄에서도 같습니다.
Command
cd /opt/hqbirdrcm
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster link -hosts db1,db2,db3 -master db1
그다음 일어나는 일:
RCM 은 비어 있는 각 호스트에 초대를 보냅니다.
호스트의 fbagent 는 클러스터에 참여하고 페어링 포트를 닫습니다. 호스트에 노드가 없는 자체 RCM 이 있으면 fbagent 는 그것을 중지하고 비활성화한 뒤, 빈 클러스터를 fbagent 폴더의 cluster/left/ 로 옮깁니다.
RCM 은 클러스터를 저장합니다. 마스터에는 노드 <host>-master, 다른 호스트에는 <host>-replica, 포트 7051, 마스터 → 레플리카 연결입니다.
각 호스트의 fbagent 가 노드를 설치하고 시작합니다. RCM 은 모든 노드가 실행될 때까지 기다리고 각 호스트에 실행 중 을 표시합니다.
호스트 확인 뒤의 호스트 상태:
상태
할 일
연결 가능
할 일 없음. 아래에 “이 호스트 자신의 RCM 은 연결 후 멈춥니다"라고 있으면 정상입니다
클러스터 안
호스트는 이미 이 클러스터에 있습니다
오류 unreachable
포트 7450 이 닫혀 있습니다. 페어링 창이 꺼져 있거나(기본값) 24시간이 지났습니다. 설치 직후에는 1분 기다린 뒤 호스트 확인 을 다시 클릭합니다. 그렇지 않으면 창을 열고(--cluster-pairing on) 방화벽을 확인합니다
오류 in_other_cluster
호스트가 다른 클러스터에 있습니다
오류 claimed
다른 RCM 이 지금 이 호스트를 연결하고 있습니다
오류 seats_exceeded
시트가 3개를 넘습니다
릴리스. fbagent 는 노드를 RCM 에서만 설치합니다. RCM 은 시작 때와 5분마다 rcm.json 옆의 import/ 폴더에서 서명된 릴리스를 가져옵니다. 설치 프로그램은 RCM 호스트의 릴리스를 거기에 두고, 다른 호스트의 fbagent 는 자기 플랫폼용 릴리스를 직접 받습니다. 릴리스 목록은 호스트 연결 페이지 아래에 있습니다. 릴리스는 수동으로도 가져올 수 있습니다(아래 5단계).
명령줄에서 수동
순서: RCM 호스트에서 1–3단계, 다른 각 호스트에서 4단계, RCM 에서 5–6단계.
1단계. fbagent 와 함께 HQbird 설치
각 데이터베이스 서버와 RCM 호스트에 전체 설치 프로그램 으로 HQbird 를 설치합니다. RCM 호스트에서는 처음부터 --rcm on 을 지정할 수 있습니다(그러면 3단계는 필요 없습니다). 다른 호스트에서는 클러스터 매개변수를 지정하지 않습니다. 기본적으로 RCM 도 페어링 창도 없습니다. HQCenter Admin 에는 등록하지 않습니다(--enroll).
RCM 호스트에서 설치 프로그램은 RCM 프로그램을 fbagent 폴더(update/hqbirdrcm/staged/)에 남겨 둡니다. 이것이 없으면 3단계는 오류 no hqbirdrcm to install 로 실패합니다.
2단계. 바인딩 라이선스 설치
이 절 앞부분 “라이선스"와 같습니다.
3단계. RCM 호스트에 클러스터 만들기
설치 프로그램이 이미 클러스터를 만들었다면(--rcm on: 출력에 주소가 있는 RCM: 줄) 이 단계를 건너뜁니다.
명령은 fbagent 사용자(Linux 에서는 firebird)로 실행합니다. root 로 실행하지 않습니다. root 이면 CA 파일과 rcm.json 의 소유자가 root 가 됩니다.
Windows 에서(관리자 PowerShell):
.\fbagent.exe --cluster-init shop-prod --address 10.0.0.7
shop-prod — 클러스터 이름. 소문자 라틴 문자, 숫자, -.
--address — 다른 호스트가 접속할 때 쓰는 RCM 호스트 주소. 여러 번 지정할 수 있습니다. 매개변수가 없으면 호스트의 주소와 이름이 쓰입니다.
이 명령은 다음을 합니다.
클러스터 CA 와 에이전트 CA 를 만듭니다(fbagent 폴더의 clusterca/<name>/).
RCM 인증서, rcm.json, cluster-init.json 을 RCM 폴더에 씁니다.
RCM 을 설치하고 hqbirdrcm 서비스를 등록합니다. Linux 에서 서비스는 별도 사용자 hqbirdrcm 으로 실행됩니다.
fbagent 를 RCM 으로 전환하고(cluster.source = rcm) 다시 시작합니다.
RCM 주소와 CA 지문을 출력합니다.
Code
Cluster:    shop-prod
RCM URL:    https://10.0.0.7:7443
CA hash:    sha256:9f86d0...
RCM URL 과 CA hash 를 적어둡니다. 다른 호스트에서 필요합니다. 같은 클러스터에 대해 다시 실행하는 것은 안전합니다. CA 와 키는 그대로입니다.
곧바로 RCM 에 로그인하고 rcmadmin 암호를 바꿉니다(1.5).
Linux 에서. 사용자 hqbirdrcm 은 fbagent 그룹에 있습니다. RCM 은 이 그룹을 통해 rcm.json 을 읽을 수 있지만 쓸 수는 없습니다. 그래서 설정 → RCM 은 변경을 저장하지 않습니다(오류 rcm_config_read_only). 호스트에서 fbagent 사용자로 rcm.json 을 편집하고 RCM 을 다시 시작합니다.
4단계. 다른 호스트의 fbagent 연결
RCM 호스트에서 각 fbagent 용 참여 토큰 을 만듭니다. RCM 의 설정 → 클러스터, 참여 토큰 만들기 단추입니다. 또는 명령줄에서:
Command
cd /opt/hqbirdrcm
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster join-token -note db2
토큰은 24시간 동안 유효하고, fbagent 하나, 한 번만 쓸 수 있습니다. RCM 은 그것을 한 번만, 준비된 명령과 함께 보여 줍니다.
--token-file 대신 --token <token> 을 쓸 수 있습니다. Windows 에서는 관리자 PowerShell 에서 .\fbagent.exe 로 같습니다.
fbagent 는 지문으로 RCM CA 를 확인합니다. 지문이 맞지 않으면 멈추고 아무것도 쓰지 않습니다. 그다음 fbagent 는 자신의 인증서(90일, 자동 갱신)를 받고 다시 시작합니다. 연결된 fbagent 는 RCM 의 에이전트 표에 보입니다. 구성원이 없는 동안에는 호스트에 아무것도 설치되지 않습니다.
5단계. 릴리스를 RCM 에 가져오기
fbagent 는 노드와 RCM 을 RCM 에서만 가져옵니다. 필요한 릴리스가 미러의 릴리스 목록(설정 → 호스트 연결)에 없으면, 호스트의 각 플랫폼(linux-amd64, windows-amd64)에 대해 각 제품(hqclusternode, hqbirdrcm)을 가져옵니다. 릴리스 파일과 .sig 서명은 공급자가 제공합니다.
RCM 은 서명을 <file>.sig 에서 찾습니다. -sig 로 지정할 수도 있습니다. 유효한 공급자 서명이 없으면 RCM 은 파일을 받지 않습니다.
새 릴리스는 이전 릴리스를 바꿉니다. RCM 을 다시 시작할 필요는 없습니다.
fbagent 는 새 버전을 3분마다 확인합니다. 업데이트 순서와 잠금은 HQCenter Admin 을 통할 때와 같습니다(1.2, “업데이트”).
6단계. 클러스터 기술
구성원과 연결을 RCM 의 설정 → 클러스터 에서 설정합니다(2.3장). 저장 뒤 fbagent 는 HQCenter Admin 을 통할 때와 같은 방식으로 노드를 설치합니다(1.2, 3단계). 인증서, node.json, rcm.json 을 쓰고 서비스를 설치하고 시작합니다.
포트는 이 절의 앞에 있습니다.
1.4. 수동 설치
1단계. fbagent 와 함께 HQbird 설치
모든 데이터베이스 서버에 HQbird 를 설치합니다(같은 스크립트에서 --enroll 없이, 또는 HQbird 전체 설치 프로그램으로). fbagent 가 실행 중인지 확인합니다.
fbagent 의 agent_config.json 에서 값 세 개를 적어둡니다. node.json 에 필요합니다.
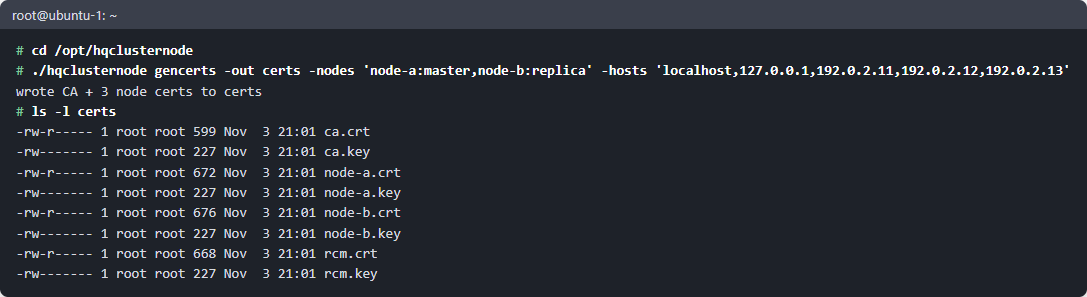
인증서 유효 기간은 90일입니다. gencerts -out certs -list 가 만료일을 보여주고, gencerts -out certs -renew 가 같은 키로 갱신합니다. 새 .crt 를 해당 호스트에 복사합니다. 노드는 다시 시작하지 않고 가져옵니다.
각 호스트에는 ca.crt 와 그 호스트 자신의 인증서와 키만 복사합니다.
4단계. node.json 작성
노드마다 파일 하나입니다. 마스터(node-a)의 예:
json
{"node_id":"node-a","role":"master","listen_addr":":7051","rcm":{"url":"https://<ip-rcm>:7443","ca_cert":"certs/ca.crt","client_cert":"certs/node-a.crt","client_key":"certs/node-a.key"},"firebird":{"root":"/opt/firebird","user":"SYSDBA","password":"<SYSDBA password>","port":3050,"replication_conf":"/opt/firebird/replication.conf","replication_log":"/opt/firebird/replication.log","firebird_log":"/opt/firebird/firebird.log","fbagent_url":"http://127.0.0.1:13050","fbagent_token":"<local_api.token>","instance_id":"<local_api.instance_id>","service_name":"<Firebird service name>"},"windows":{"restart_window":"22:00-05:00","transfer_window":"23:00-05:00"},"peers":[{"node_id":"node-b","url":"https://<ip-node-b>:7051","compress":"zstd"}]}
레플리카 노드(node-b)도 같은 파일이지만 "role": "replica", 자신의 인증서, peers 에는 마스터 node-a 가 들어갑니다.
주요 필드:
필드
값
node_id
노드 이름. 인증서, rcm.json, 다른 노드의 peers 와 같음
role
master 또는 replica
listen_addr
노드 API 주소. 같은 호스트의 두 번째 노드는 다른 포트(:7052)
rcm.url
RCM 통계를 받을 주소. none 은 RCM 없음
firebird.*
이 인스턴스의 Firebird 와 fbagent. fbagent 값은 정확히 일치해야 함
firebird.auto_restart
레플리카 노드가 Firebird 를 직접 다시 시작해도 되는지. auto(기본), never, always
windows.restart_window
Firebird 다시 시작 창. 마스터 기본값은 22:00-05:00, 레플리카는 항상
windows.transfer_window
초기화가 최고 속도로 실행되는 창
peers
마스터에게는 자신의 레플리카, 레플리카에게는 자신의 마스터
databases
데이터베이스 폴더. 손으로 쓰지 말고 RCM 에서 설정하는 편이 좋음(3장)
나머지 필드에는 기본값이 있습니다. fbagent 필드가 설정되지 않으면 노드는 시작하지 않습니다.
파일을 보호합니다. 암호와 토큰이 들어 있습니다.
Command
chmod 600 /opt/hqclusternode/node.json
Windows 에서. 경로는 JSON 형식으로 씁니다. "C:\\HQbird\\replication.conf". service_name 은 Firebird 의 Windows 서비스 이름입니다.
cd /opt/hqclusternode
sudo ./hqclusternode svc install -config /opt/hqclusternode/node.json -certs /opt/hqclusternode/certs
sudo ./hqclusternode svc start -config /opt/hqclusternode/node.json
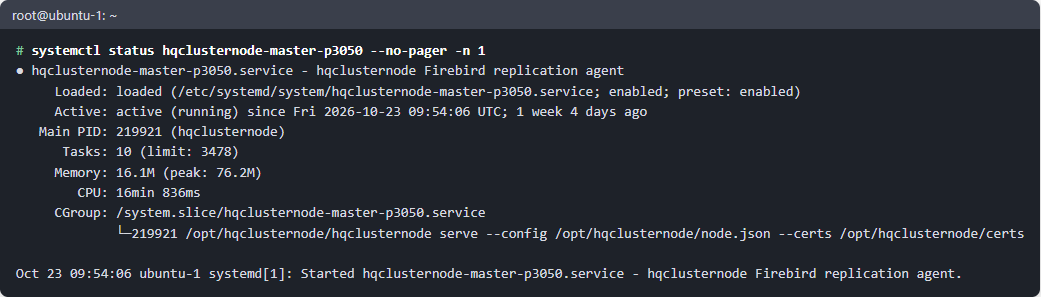
systemctl status hqclusternode-master-p3050
svc install 은 사용자 firebird 로 실행되는 서비스 hqclusternode-<role>-p<port> 를 만듭니다. Firebird 폴더의 소유자가 root 이면, 명령은 firebird 그룹에 그 폴더의 쓰기(스티키 비트 포함)를 주고 모든 변경을 출력합니다. 노드가 replication.conf 를 바꿔야 하기 때문입니다.
svc start, svc stop, svc uninstall 에는 같은 node.json 을 지정합니다. 서비스 이름은 역할과 Firebird 포트에서 나옵니다.
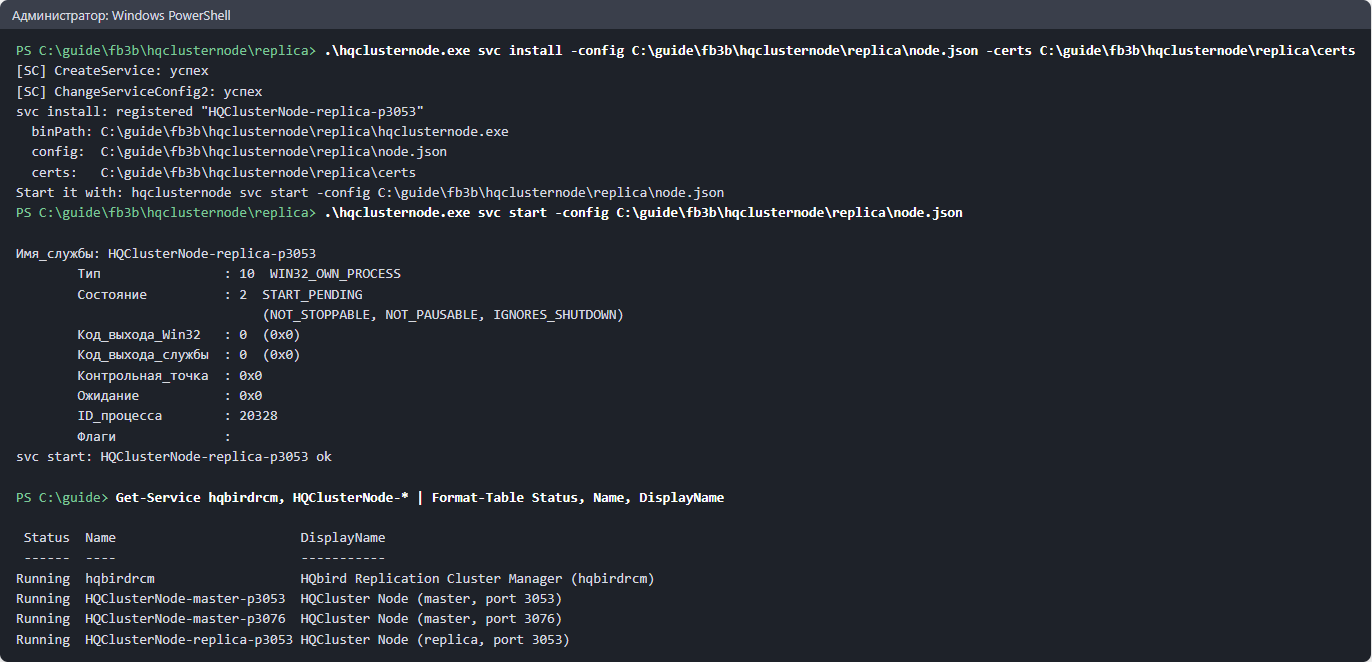
Windows 에서(관리자 PowerShell):
Command
cd C:\hqclusternode
.\hqclusternode.exe svc install -config C:\hqclusternode\node.json -certs C:\hqclusternode\certs
서비스 HQClusterNode-<role>-p<port> 는 LocalSystem 으로 실행되고, 자동으로 시작하며, 실패 뒤 다시 시작합니다. 노드 서비스는 Firebird 서비스에 의존하지 않습니다. 노드를 버전 2027.1.2–2027.1.9 로 설치했다면 의존 관계를 한 번 제거합니다. .\hqclusternode.exe svc fix-deps -config C:\hqclusternode\node.json.
Windows 에서 svc install 과 svc start
7단계. 포트 열기
노드 호스트에서는 다른 노드와 RCM 으로부터 7051(listen_addr 포트)로의 들어오는 연결을 허용합니다. RCM 호스트에서는 모든 노드로부터 7443 으로의 들어오는 연결을 허용합니다. 포트 7444 와 13050 은 외부에 노출하지 않습니다.
노드 호스트의 ufw 예:
Command
sudo ufw allow from <ip-rcm> to any port 7051 proto tcp
sudo ufw allow from <ip-partner-node> to any port 7051 proto tcp
rcmadmin 과 설치 프로그램이 출력한 암호(또는 --rcm-password-file 의 자신의 암호)
HQCenter Admin 을 통해(1.2) 또는 수동(1.4)
http://127.0.0.1:7444, RCM 호스트에서만
rcmadmin, 암호 strong password(공백 포함)
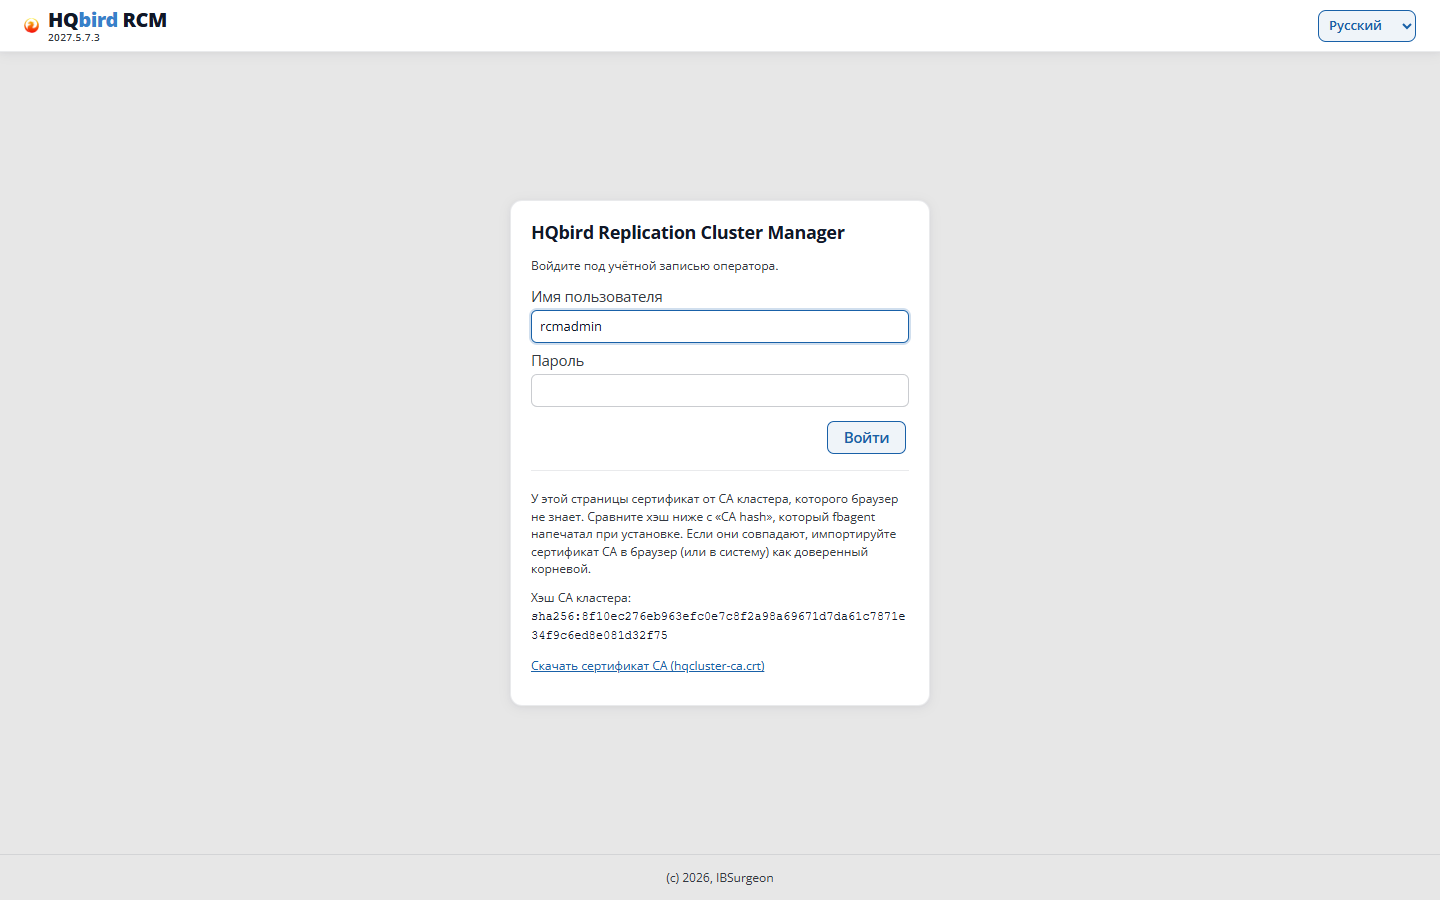
HTTPS(1.3). RCM 인증서는 클러스터 CA 가 서명했으며 브라우저는 그것을 모르므로 경고합니다. 로그인 페이지에서 RCM 은 CA 지문을 보여 줍니다. 설치 프로그램이 출력한 CA hash 와 비교하고, CA 를 브라우저나 시스템에 신뢰된 루트로 가져옵니다. 로그인 페이지의 CA 인증서 다운로드 링크입니다(https://<RCM host>:7444/ca.crt, 파일 hqcluster-ca.crt). RCM 이 localhost 에서만 수신하게 하려면 rcm.json 에 "operator_addr": "127.0.0.1:7444" 를 설정하고 RCM 을 다시 시작합니다.
HTTP(1.2, 1.4). 다른 컴퓨터에서는 SSH 터널로 접속합니다.
Command
ssh -L 7444:127.0.0.1:7444 <rcm-host>
그다음 브라우저에서 http://127.0.0.1:7444 를 엽니다.
RCM 로그인 페이지
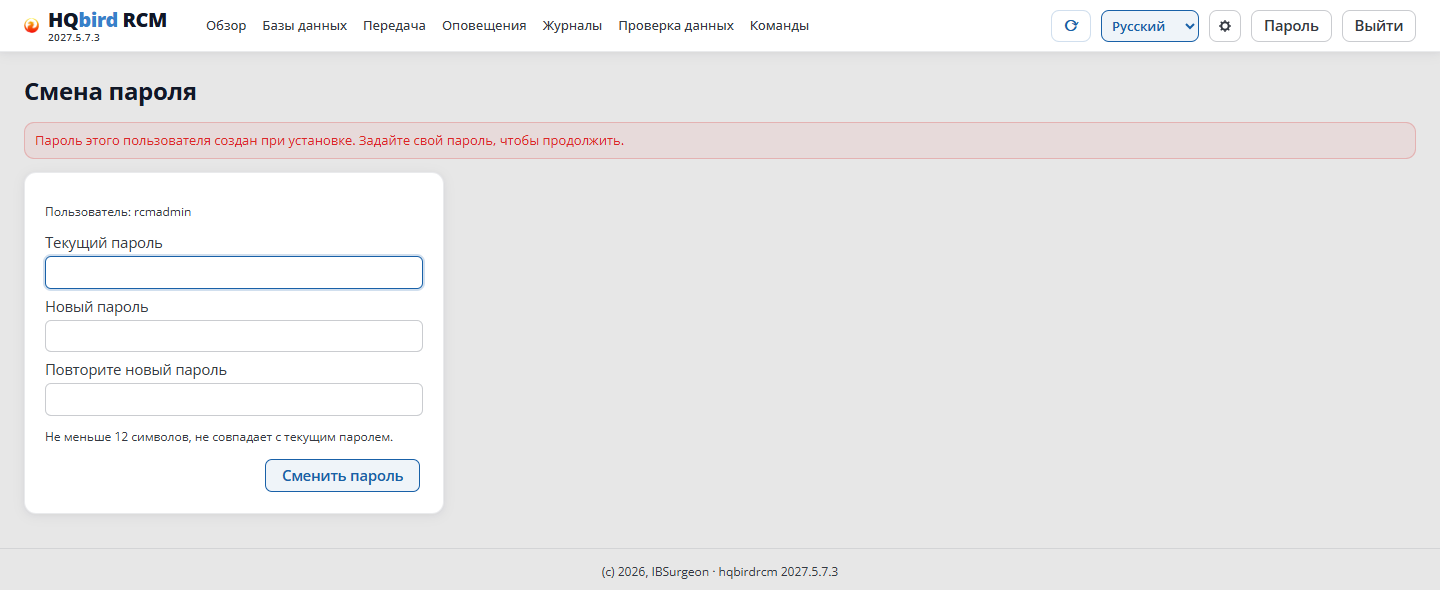
생성된 암호. RCM 은 첫 로그인에서 변경을 요청합니다. 바꿀 때까지 다른 페이지는 열리지 않습니다. strong password 는 즉시 바꿉니다(머리글의 암호 링크).
첫 로그인에서 암호 변경
언어. 페이지 머리글의 언어 목록에서 러시아어 를 고릅니다(로그인 페이지에도 있습니다). 고르지 않으면 언어는 브라우저에서 가져옵니다.
암호 변경과 새 사용자
각 사용자는 자신의 암호를 바꿉니다. 페이지 머리글의 암호 링크입니다. 현재 암호와 12자 이상의 새 암호가 필요합니다. 변경 뒤 그 사용자의 다른 세션은 닫힙니다.
설치 프로그램이 암호를 만들었으면 fbagent 폴더의 파일 clusterca/<name>/rcm-initial-password 에 기록됩니다. 암호가 바뀌면 fbagent 가 이 파일을 직접 삭제합니다. RCM 폴더의 initial-admin.json 은 삭제하지 마십시오. 들어 있는 것은 해시뿐입니다. 사용자 파일이 없어지고 이 파일도 없으면 RCM 은 기본 암호의 사용자를 만듭니다.
새 사용자. 인터페이스에 사용자 페이지는 없습니다. 사용자는 파일 rcm-data/users.json 에 저장됩니다. 암호는 HA1 해시로 저장됩니다. MD5("<name>:hqbirdrcm:<password>").
--cluster-join: this agent is in cluster … from goafts
fbagent 가 이미 HQCenter Admin 클러스터에 있음
HQCenter Admin 클러스터에서 제거
RCM 을 통해 노드가 설치되지 않음
RCM 에 이 플랫폼의 릴리스가 없음
hqbirdrcm release list, 릴리스 가져오기(1.3, “수동”, 5단계)
2. 클러스터 구성
이 장에서는 클러스터에 어떤 노드가 있는지, 어느 마스터가 어느 레플리카로 세그먼트를 보내는지 정의합니다. 그다음 RCM 의 노드와 사용자를 구성합니다.
관계는 세 가지 방법 중 하나로 정의합니다.
노드 설치 방법
관계를 정의하는 곳
절
HQCenter Admin 을 통해
HQCenter Admin: HQ Monitor 의 클러스터 페이지 또는 HQCenter Admin API
2.2
RCM 을 통해, HQCenter Admin 없이
RCM: 설정 → 클러스터, hqbirdrcm cluster, 또는 HQ Monitor 의 클러스터 페이지
2.3
수동
RCM: 설정 → RCM 과 설정 → 노드
2.3
HQCenter Admin 또는 RCM 을 통해 설치한 노드에서는 관계를 클러스터 설명 안에서만 바꿉니다. fbagent 는 클러스터 설명에 따라 node.json 과 rcm.json 을 덮어씁니다. RCM 의 설정 → RCM 또는 설정 → 노드 에서 관계를 편집하면 거부됩니다(409 cluster_managed). 이전 RCM 은 받아들였지만 사라졌습니다.
2.1. 역할과 구성
각 노드의 역할은 하나입니다. 마스터 또는 레플리카. 하나의 Firebird 인스턴스에서 마스터와 레플리카, 노드 두 개를 실행할 수 있습니다.
지원하는 구성:
Code
1 → 1        node-a (master) ──▶ node-b (replica)

1 → N        node-a ──▶ node-b
                    └─▶ node-c

N → 1        node-a ──┐
                      ├─▶ node-b    (one replica for several masters)
             node-x ──┘

Both nodes   host-1: node-1m (master) + node-1r (replica)  ← one Firebird
on a host    host-2: node-2m (master) + node-2r (replica)  ← one Firebird
             node-1m ──▶ node-2r,  node-2m ──▶ node-1r
연결은 항상 마스터에서 레플리카로 갑니다. RCM 은 마스터의 데이터베이스를 노드 이름이 아니라 데이터베이스 GUID 로 레플리카에 연결합니다.
컴패니언. 같은 Firebird 인스턴스의 마스터 노드와 레플리카 노드는 컴패니언입니다. 레플리카를 마스터로 승격(8장)하는 것은 이런 쌍에서만 동작합니다. rcm.json 에서 쌍은 같은 host 값으로 표시됩니다.
2.2. HQCenter Admin 을 통한 연결
클러스터를 기술하는 곳
HQ Monitor 의 클러스터 페이지(관리자만. 구성 전달이 켜져 있어야 함). 일반적인 방법입니다.
HQCenter Admin API:POST /v1/admin/clusters 와 PUT /v1/admin/clusters/{id}. HQCenter Admin 패널에는 클러스터 페이지가 없습니다.
``
클러스터 페이지의 단계
새 클러스터 ID(소문자 라틴 문자, 숫자, -)를 입력하고 만들기 를 클릭합니다.
구성원을 추가합니다(구성원). 각각에 다음을 지정합니다.
호스트의 fbagent.
역할: master, replica 또는 rcm.
호스트 주소.
포트: 노드는 7051(같은 호스트의 두 번째 노드는 예: 7052), RCM 은 통계 수신 포트 7443.
마스터에서 레플리카로의 연결을 추가합니다(복제 연결).
검증 을 클릭한 뒤 저장 을 클릭합니다.
다른 관리자가 동시에 클러스터를 바꾸면 페이지는 클러스터를 다시 읽고 변경을 반복하라고 요청합니다.
규칙
fbagent 하나는 클러스터 하나에만 속할 수 있습니다.
fbagent 하나에는 마스터, 레플리카, RCM, 라우터가 각각 하나까지입니다. 라우터(역할 router, HQbird 2027.2.30 부터)에는 연결이 없고 라이선스 시트를 차지하지 않습니다(8.7장).
클러스터의 RCM 은 정확히 하나입니다. RCM 호스트의 fbagent 가 클러스터 인증 기관(CA)을 운영합니다.
구성원 이름(member_id)은 라틴 문자, 숫자, -. 구성원의 이름, fbagent, 역할은 바꿀 수 없습니다. 구성원을 다른 호스트로 옮기려면 새 이름의 새 구성원을 만듭니다. 옛 이름은 다시 쓰지 않습니다.
모든 레플리카에는 마스터로의 연결이 있어야 합니다.
HQCenter Admin 은 노드 주소를 직접 만듭니다. https://<first address>:<port>.
HQbird 2.5/3.0: 클러스터의 replconf_valid_till 날짜(YYYY-MM-DD)를 설정합니다. replconf 플러그인 구성은 그 날짜까지 유효합니다.
API 예
json
{"contract":1,"cluster_id":"shop-prod","name":"Shop","pki":"managed","cert_validity_days":90,"renew_before_days":30,"members":[{"member_id":"db1-m","agent_id":"<fbagent of host 1>","role":"master","addresses":["db1.lan"],"listen_port":7051},{"member_id":"db1-rcm","agent_id":"<fbagent of host 1>","role":"rcm","addresses":["db1.lan"],"listen_port":7443},{"member_id":"db2-r","agent_id":"<fbagent of host 2>","role":"replica","addresses":["db2.lan"],"listen_port":7052}],"links":[{"from":"db1-m","to":"db2-r"}]}
만들기: POST /v1/admin/clusters(문서는 구성원과 함께 보낼 수 있음). 문서 전체 교체: PUT /v1/admin/clusters/{id}.
PUT 에는 헤더 If-Match: <revision> 이 필요합니다(리비전은 GET 과 ETag 가 줍니다). 헤더가 없으면 428, 오래된 리비전이면 409, 문서에 오류가 있으면 422 와 오류 목록입니다.
POST /v1/admin/clusters/{id}/validate 는 저장하지 않고 문서를 검증합니다.
GET /v1/admin/clusters/{id}/status 는 구성원 상태와 인증서 만료일을 보여 줍니다.
저장 뒤에 일어나는 일
각 구성원의 fbagent 가 클러스터를 받습니다. 클러스터 안에서는 60초마다 확인합니다(RCM 호스트의 fbagent 는 30초마다). 클러스터 밖의 fbagent 는 다음 구성 조회에서 클러스터를 알게 됩니다. 그 조회가 서버에 닿지 않으면 확인은 10분마다 실행됩니다.
각 fbagent 는 키를 만들고 인증서 요청을 보냅니다. RCM 호스트의 fbagent 가 서명합니다. RCM 은 요청 없이 자신의 인증서에 서명합니다.
fbagent 는 node.json 에 이름, 역할, 주소, peers(연결에서), RCM 주소, 인증서 경로, Firebird 와 fbagent 데이터를 씁니다. rcm.json 에는 노드 목록(nodes), 라우터 목록(routers), 통계 수신 주소, 인증서 경로를 씁니다. fbagent 는 파일의 다른 필드를 건드리지 않습니다.
fbagent 는 서비스를 설치하고 시작합니다(1장).
클러스터 변경:
바뀐 것
fbagent 가 하는 일
실행 중인 노드의 peers 만
다시 시작하지 않고 노드에 전달
노드의 다른 필드
노드를 중지하고, 파일을 쓰고, 노드를 시작. 노드의 windows.transfer_window 안에서(설정되지 않았으면 즉시)
rcm.json
RCM 을 즉시 다시 시작
인증서 또는 CA
서비스를 다시 시작
구성원 제거
서비스를 중지하고 제거. cluster-managed.json → cluster-removed.json, 프로그램 → *.removed. 구성, 인증서, 데이터는 남음
노드를 제거한 뒤 공유 replication.conf 에는 그 절 # BEGIN managed-by:<name> … # END … 가 남습니다. 수동으로 삭제하고 RCM 을 통해 Firebird 를 다시 시작합니다.
클러스터 인증서 승인
기본적으로 RCM 호스트의 fbagent 가 요청에 직접 서명합니다(auto). 수동 승인을 켤 수 있습니다. RCM 호스트의 명령:
Command
fbagent --cluster-ca-approval manual # or autofbagent --cluster-status # this fbagent's membership in the cluster (JSON)fbagent --cluster-ca-approve <request_id>
manual 모드에서는 새 구성원이나 새 키가 승인을 기다립니다. 알려진 키의 인증서 갱신은 자동으로 서명됩니다.
2.3. RCM 을 통한 연결
RCM 클러스터(HQCenter Admin 없음)
클러스터를 HQbird 설치 프로그램이나 fbagent --cluster-init 명령으로 만든 경우(1.3장), 클러스터 설명은 RCM 이 보관합니다. 호스트를 추가하는 가장 쉬운 방법은 설정 → 호스트 연결 페이지입니다(1.3장, “RCM 에서 호스트 연결”). RCM 이 구성원과 연결을 직접 만듭니다. 규칙은 HQCenter Admin 과 같습니다(2.2, “규칙”). 추가로:
RCM 에는 클러스터가 하나입니다. rcm 구성원은 항상 있으며 삭제할 수 없습니다.
시트 는 3개까지(마스터 또는 레플리카 노드가 있는 호스트). 넘으면 오류 seats_exceeded 가 납니다.
구성원은 RCM 에 연결된 fbagent 위에만 추가할 수 있습니다(1.3장: “호스트 연결” 또는 “수동” 4단계).
설정 → 클러스터 페이지의 단계:
에이전트 표에서 fbagent 행의 구성원 추가 를 클릭합니다.
역할(master, replica 또는 router), member_id, 주소, 포트를 지정합니다. 페이지는 이름 <host>-<role> 과 포트를 제안합니다. 첫 fbagent 노드는 7051, 두 번째는 7061 입니다. 호스트의 다른 구성원이 이미 쓰는 포트는 RCM 이 거부합니다. fbagent 주소는 단추입니다. 클릭해서 주소를 추가합니다.
연결 절에서 마스터에서 레플리카로의 연결 추가 를 클릭합니다.
검증 을 클릭합니다. RCM 이 오류와 경고를 보여 줍니다.
저장 을 클릭합니다. 페이지는 변경 목록을 보여주고 확인을 요청합니다. 구성원을 삭제하면 창은 빨간색입니다.
저장 전의 변경은 페이지에만 있습니다(“저장되지 않음” 레이블). 누군가 동시에 클러스터를 저장하면 페이지는 다시 읽기를 제안합니다. 바뀐 것이 RCM 필드뿐이면(리비전, CA, 위임) 페이지가 변경을 직접 저장합니다.
페이지의 다른 절:
절
내용
머리글
클러스터 이름, 리비전, 클러스터 CA 와 에이전트 CA. 옛 CA 의 내보내기 단추
연결 토큰
새 fbagent 용 토큰 만들기, 쓰지 않은 토큰 취소
JSON 문서
텍스트 칸의 문서 전체. 검증 과 저장 이 이것을 사용
키와 CA
위임: 새 구성원 키(rekey), 새 클러스터 CA(rotate_ca), 새 에이전트 CA(rotate_agent_ca). 저장되지 않은 변경이 있으면 사용할 수 없음
상태
각 구성원이 적용한 리비전, 인증서 만료, 서비스, 마지막 오류
RCM 호스트의 명령줄에서:
Command
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster show > c.json # document with revision# edit c.json./hqbirdrcm cluster validate -f c.json # validate without saving anything./hqbirdrcm cluster apply -f c.json # save (If-Match = revision from the file)./hqbirdrcm cluster agents # connected fbagents and their members./hqbirdrcm cluster status # what the fbagents reported
문서 형식은 2.2 “API 예"와 같습니다. 오래된 리비전의 apply 는 409 를 받습니다. show 를 다시 실행합니다. RCM 은 최근 20개 리비전을 rcm-data/cluster/history/ 에 보관합니다.
HQ Monitor.클러스터 페이지는 RCM 과도 동작합니다. RCM 호스트에서 HQ Monitor 는 그 호스트의 fbagent 를 통해, fbagent 인증서로 RCM 에 접근합니다. RCM 사용자와 암호는 필요 없습니다. RCM 감사 로그에서 그런 동작은 agent:<id> (<user>) 로 기록됩니다. 이전 RCM 버전을 위한 다른 방법: HQ Monitor 구성에 rcm_admin_url(http://127.0.0.1:7444), rcm_admin_user(RCM 사용자), rcm_admin_password_file(그 암호의 파일)을 설정합니다.
저장 뒤의 흐름은 HQCenter Admin 을 통할 때와 같습니다(2.2, “저장 뒤에 일어나는 일”). RCM 은 rcm.json 의 nodes 를 다시 시작 없이 직접 다시 읽습니다.
fbagent 를 클러스터에서 제거: 그 구성원을 삭제하고 저장한 뒤 에이전트 표에서 취소 를 클릭합니다(또는 ./hqbirdrcm cluster revoke -agent <id>). 되돌리려면 새 토큰이 필요합니다. 취소 뒤 fbagent(버전 3.1.0 부터)는 스스로 클러스터를 떠납니다. 노드를 중지하고 클러스터 데이터를 삭제합니다. 노드 호스트에서는 fbagent --cluster-leave 명령이 같은 일을 합니다. RCM 호스트에서는 거부됩니다.
수동 설치: 노드를 RCM 에 추가
설정 → RCM, 연결된 노드 표.
노드 추가 를 클릭합니다. node_id, url(https://<address>:7051), 역할, host(Firebird 인스턴스 레이블), server(화면 그룹화 전용)를 채웁니다.
노드 행에서 검증 을 클릭합니다. RCM 이 연결과 권한을 확인합니다.
저장 을 클릭합니다. RCM 이 rcm.json 을 쓰고 옛 파일을 rcm.json.<UTC time>.bak 로 저장합니다(최근 20개).
RCM 을 다시 시작합니다. 다시 시작하기 전에는 옛 구성이 유효합니다. 페이지는 다시 시작을 기다리는 필드를 보여 줍니다.
설정 → RCM
Command
sudo systemctl restart hqbirdrcm
인터페이스 없이 할 수도 있습니다. rcm.json 을 편집하고 RCM 을 다시 시작합니다.
수동 설치: 마스터와 레플리카 연결
연결은 양쪽 에 기록되어야 합니다.
설정 → 노드 에서 마스터 노드를 고릅니다.
피어 절에서 피어 추가 를 클릭합니다. 레플리카의 node_id, 그 url, 압축(zstd).
저장 을 클릭합니다. RCM 이 변경 목록을 보여주고 확인을 요청합니다. peers 변경은 즉시 적용됩니다.
레플리카 노드에서도 반복합니다. 그 피어는 마스터입니다.
마스터 노드의 피어 절
한쪽 피어가 기록되지 않으면, 데이터베이스 초기화 때 RCM 은 그 레플리카 노드를 제안하지 않습니다.
2.4. 노드 설정
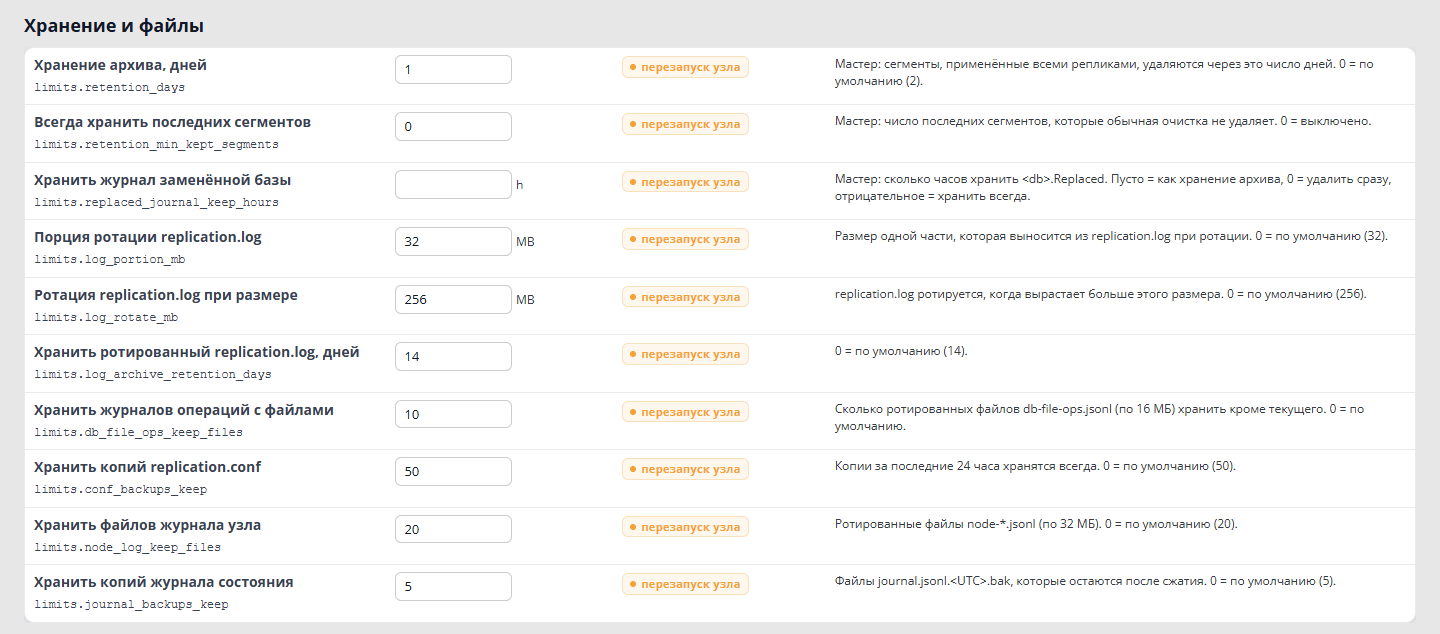
설정 → 노드 는 노드가 RCM 에서 바꾸도록 허용한 node.json 설정을 보여 줍니다. 바뀐 필드만, 변경 목록 창 뒤에 저장됩니다.
설정 → 노드: 노드 선택"스캔 후" 표시가 있는 노드 데이터베이스 설정
각 행에는 변경이 언제 적용되는지가 표시됩니다.
언제
어느 설정
즉시
channel_a_mbps, channel_a_burst_mbps, windows.restart_window, peers. HQbird 2027.2.24 부터 데이터 확인 설정(limits.data_check_*). HQbird 2027.2.31 부터 advertise_addr
노드 다시 시작 후
나머지 한도, windows.transfer_window. 페이지는 노드가 다시 시작될 때까지 이것을 별도 줄에 표시
스캔 후
databases.*, exclude_filter. replication.conf 가 바뀌면 Firebird 다시 시작이 필요(3.5장)
노드가 Firebird 를 다시 시작해도 되는 시각. 마스터 Firebird 는 스스로 다시 시작하지 않음
windows.transfer_window
23:00-05:00
초기화가 reinit_window_mbps 속도로 실행되는 창
limits.channel_a_mbps
50
세그먼트 전송 속도, MB/s(channel_a_burst_mbps 는 짧은 정점, 200)
limits.reinit_window_mbps
100
전송 창 안의 초기화 속도, MB/s
limits.reinit_day_disk_fraction
0.5
창 밖 초기화에 쓰는, 측정된 디스크 속도의 비율
limits.retention_days
2
보낸 세그먼트를 마스터 아카이브에 며칠 보관할지
limits.free_space_floor_gb
1
최소 여유 공간, GB. 이보다 낮으면 레플리카는 세그먼트를 받지 않음
limits.max_concurrent_reinits
1
노드가 동시에 실행하는 초기화 수
속도와 아카이브 보관의 자세한 내용은 5장과 7장을 보십시오.
firebird.auto_restart(node.json 만)는 레플리카 노드가 Firebird 를 직접 다시 시작해도 되는지를 정합니다.
값
동작
auto(기본)
이 Firebird 가 마스터 데이터베이스를 제공하지 않으면 가능
never
불가
always
이 Firebird 가 마스터 데이터베이스를 호스트해도 항상 가능
HQCenter Admin 을 통해. fbagent 노드의 windows.transfer_window 는 클러스터가 바뀔 때 노드 서비스 자체를 다시 시작하는 창으로도 쓰입니다. node.json 에 창이 없으면 fbagent 는 서비스를 즉시 다시 시작합니다.
2.5. 한 호스트의 여러 HQbird 인스턴스
fbagent 는 자신의 구성 firebird.update.services 에 나열된 서비스를 다시 시작합니다. 빈 목록은 호스트의 모든 HQbird 서비스를 뜻합니다. 목록에는 자신의 인스턴스 서비스만 남깁니다. 노드는 이 설정을 보지 않습니다. fbagent 가 인스턴스를 둘 이상 알면 로그에 경고 fbagent_shared 를 씁니다.
2.6. SYSDBA 암호
노드는 node.json 의 firebird.user 와 firebird.password 로 Firebird 에 접속합니다. fbagent 는 암호의 자기 복사본을 보관합니다. SYSDBA 암호를 바꿨다면:
이 인스턴스의 모든 노드(마스터와 레플리카)의 node.json 에서 firebird.password 를 고칩니다.
fbagent 구성의 암호를 고치고 다시 읽습니다(fbagent 문서 참조).
노드 서비스를 다시 시작합니다.
그렇지 않으면 RCM 의 게시와 확인 페이지에 로그인 오류(SQLSTATE 28000)가 나타납니다.
2.7. RCM 사용자와 감사
사용자는 파일 rcm-data/users.json 에 있습니다(1.5장). 역할이 없는 사용자는 모든 권한을 가집니다. viewer 역할(HQbird 2027.2.31 부터)은 보기만 가능합니다.
세션은 마지막 동작 뒤 12시간 지속됩니다.
5분 안에 로그인이 10번 실패하면 그 사용자와 주소의 로그인이 일시적으로 차단됩니다. 성공한 로그인은 카운터를 초기화합니다.
감사 로그는 파일 rcm-data/audit.jsonl 입니다. 변경, 로그인, 로그아웃마다 JSON 한 줄입니다. 인터페이스에는 감사 로그가 없습니다.
명령 페이지는 각 명령의 실행자를 보여 줍니다.
2.8. 라이선스
마스터 노드는 1분에 한 번 자기 호스트의 fbagent 라이선스를 읽습니다. 라이선스가 없으면(평가 기간 종료, 라이선스 만료 또는 무효) 노드는 마스터의 모든 데이터베이스에 대해 세그먼트 송출을 멈춥니다. Firebird 와 데이터베이스는 계속 실행되지만 레플리카는 변경을 받지 못합니다.
경보 license_paused 와 license_pause_archive_released.
초기화가 금지됩니다(license_paused).
설정 → 노드의 fbagent 라이선스 블록
fbagent 에 라이선스를 설치합니다. 노드는 1분 안에 스스로 일시 중지를 풉니다. 마스터는 일시 중지 시작부터 limits.retention_days(기본 2일) 동안 레플리카용 아카이브를 보관합니다. 그보다 늦게 라이선스를 넣으면 레플리카를 다시 초기화해야 합니다.
HQCenter Admin 없는, RCM 을 통한 클러스터. HQCenter Admin 없는 유동 라이선스는 online_check_days 에 유예 일수를 더한 기간이 지나면 동작을 멈춥니다. 클러스터의 각 fbagent 에는 바인딩 라이선스가 필요합니다(fbagent --license-request, 그다음 fbagent --license-install, 1.3장 “라이선스”). 평가 기간 뒤 라이선스에 cluster 기능이 없으면 fbagent 는 새 노드나 RCM 을 추가하지 않습니다. 업데이트를 막지는 않습니다. HQbird 2.5/3.0 에서는 RCM 의 replconf_valid_till 날짜를 fbagent 노드의 라이선스 종료에 유예 일수를 더한 날보다 뒤로 둘 수 없습니다(오류 replconf_after_license).
2.9. 확인 방법
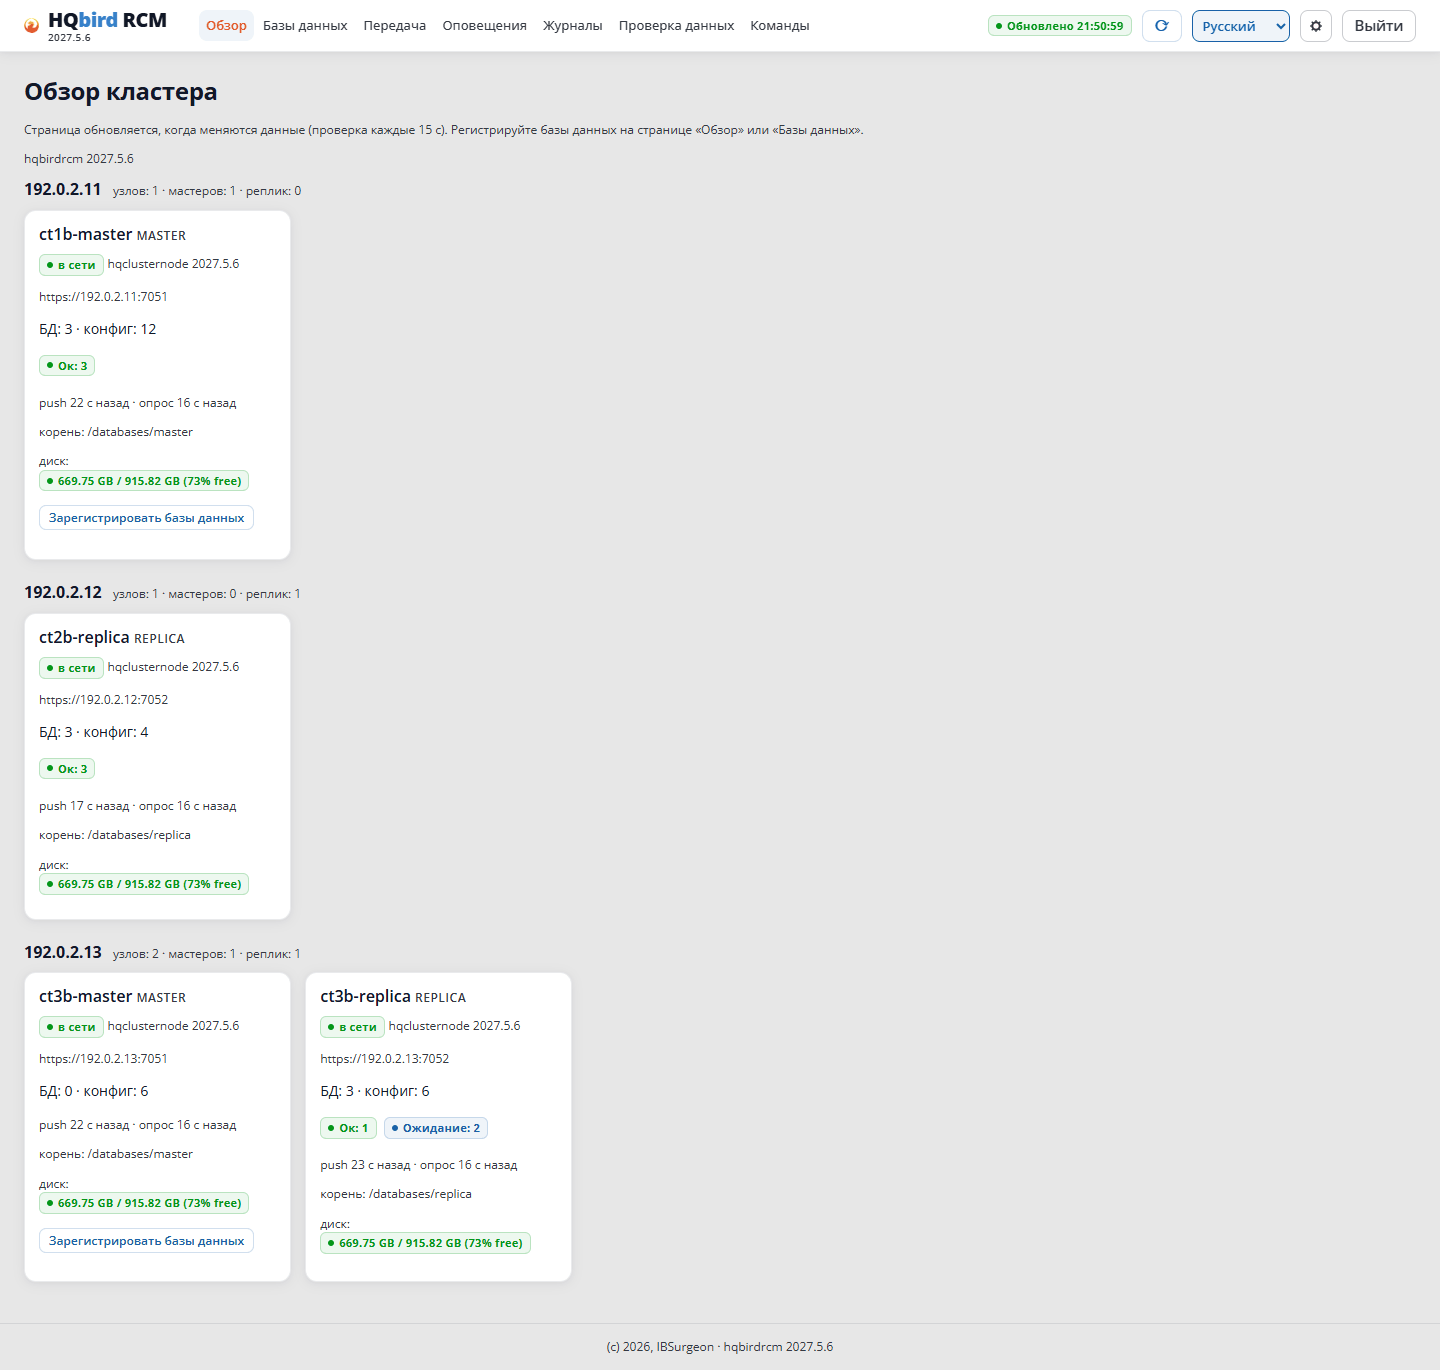
개요: 모든 노드가 있고 서버별로 묶여 있음.
클러스터 개요
설정 → 노드: 마스터의 피어 에 레플리카가 있고, 레플리카에는 마스터가 있음.
설정 → RCM: 각 노드 행의 확인 단추가 통과함.
클러스터 보고서를 파일 하나로:
Command
./hqbirdrcm report -o report.json
2.10 흔한 오류
보이는 것
원인
할 일
RCM 에서 피어 편집이 거부됨(409 cluster_managed) 또는 노드 다시 시작 뒤 사라짐
노드가 HQCenter Admin 또는 RCM 을 통해 설치됨
클러스터 설명에서 연결을 변경(2.2, 2.3)
RCM 에서 클러스터 저장 시 seats_exceeded
네 번째 호스트에 노드가 있음
노드가 있는 호스트는 3대까지
설정 → RCM: rcm_config_read_only
Linux 의 RCM 경유 클러스터: rcm.json 소유자는 fbagent
fbagent 사용자로 rcm.json 을 편집하고 RCM 을 다시 시작
취소 가 에이전트에 동작하지 않음(agent_has_members)
fbagent 에 구성원이 있음
먼저 구성원을 삭제하고 저장
초기화 때 레플리카 노드가 제안되지 않음
한쪽에 피어가 기록되지 않음
양쪽에 피어 추가(2.3)
설정 → RCM 의 변경이 적용되지 않음
RCM 이 다시 시작되지 않음
RCM 을 다시 시작
HQCenter Admin 에서 클러스터 저장 시 422
문서에 오류
errors 목록에 따라 고치고 validate 로 확인
클러스터 저장 시 409
다른 사람이 클러스터를 변경
클러스터를 다시 읽고 재시도
새 HQCenter Admin 클러스터 구성원이 인증서를 받지 못함
RCM 호스트에서 수동 승인
fbagent --cluster-ca-approve <id>
게시 페이지의 오류 SQLSTATE 28000
SYSDBA 암호가 변경됨
2.6
3. 마스터에 데이터베이스 추가
이 장에서 마스터 데이터베이스가 노드의 관리 아래로 들어갑니다. 노드는 그것을 replication.conf 에 기록하고 세그먼트용 폴더를 만듭니다. Firebird 를 다시 시작한 뒤 데이터베이스는 복제 준비가 됩니다.
레플리카를 만드는 것은 다음 단계입니다(게시, 초기화). 4–6장에 설명합니다.
단추 이름은 러시아어 RCM 인터페이스에 맞추고, 영어 이름은 괄호에 둡니다.
3.1. 노드가 데이터베이스를 찾는 방법
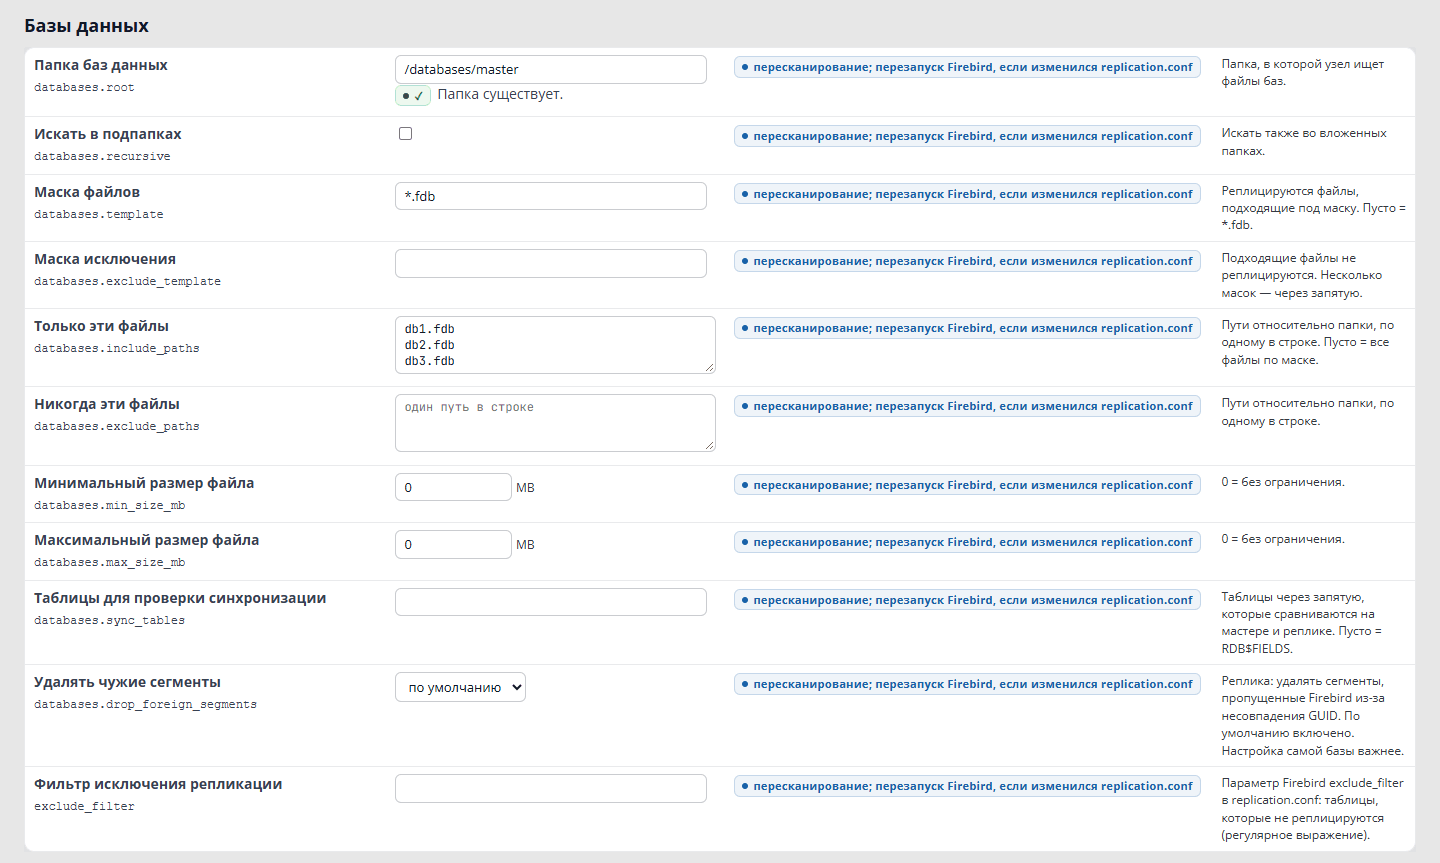
마스터 노드는 폴더 하나, 데이터베이스 루트(databases.root) 안의 데이터베이스를 찾습니다. 무엇을 관리할지는 규칙이 정합니다.
규칙
필드
기본값
데이터베이스 폴더
root
설정되지 않음
하위 폴더 검색
recursive
예
포함 마스크
template
*.fdb
제외 마스크
exclude_mask
없음
파일 크기, MB
min_size_mb, max_size_mb
제한 없음(0)
데이터 비교용 테이블
sync_tables
HQbird 2027.2.24 에서는 데이터베이스 게시의 테이블. 없으면 RDB$FIELDS. 2027.5.7 에서는 RDB$FIELDS
포함 목록
include_paths
비어 있음(템플릿 모드)
제외 목록
exclude_paths
비어 있음
root 경로는 노드 호스트 의 경로이며 RCM 호스트의 경로가 아닙니다. 노드는 포함 마스크를 먼저 적용하고, 그다음 제외 마스크, 그다음 크기를 적용합니다.
규칙은 노드 전체에 같습니다. sync_tables 목록도 공유입니다. 확인(5.10장)은 자기 목록이 없는 노드의 각 데이터베이스에서 목록의 각 테이블을 찾습니다.
비교용 테이블, HQbird 2027.2.24. 각 데이터베이스는 자기 목록을 가질 수 있습니다(동기화 추적 테이블). 노드는 그것을 databases.sync_tables_by_db 에 저장합니다. 확인은 설정된 첫 목록을 씁니다.
그 데이터베이스 자신의 목록.
노드 공유 sync_tables 목록.
데이터베이스 게시의 테이블.
RDB$FIELDS.
이전에 저장한 공유 목록은 게시보다 우선합니다. 자기 목록이 없는 데이터베이스는 그것을 씁니다. 마스터 데이터베이스 페이지는 지금 어느 목록이 유효한지 보여 줍니다(3.3).
기본 데이터베이스와 레플리카 양쪽에 없는 테이블은 상태 “데이터베이스에 없음”(absent)이 됩니다. 비교되지 않으며, 그것 때문에 확인이 “이상"이 되지는 않습니다. 한쪽에만 없는 테이블은 불일치입니다.
RCM 과 노드 2027.5.7. 노드 전체에 목록은 하나입니다(sync_tables). 목록이 없으면 확인은 RDB$FIELDS 를 씁니다. 없는 테이블은 오류이고, 데이터베이스 확인은 “이상"이 됩니다.
모든 규칙은 노드의 node.json 에 저장됩니다. 노드는 스캔할 때마다 그것을 적용합니다.
템플릿 모드와 목록 모드:
템플릿 모드(포함 목록이 비어 있음): 노드는 제외된 것을 빼고 마스크에 맞는 모든 파일을 가져갑니다. 폴더의 새 파일 은 다음 스캔에서 노드가 자동으로 집어 갑니다.
목록 모드(포함 목록이 비어 있지 않음): 노드는 목록의 파일만 가져갑니다. 새 파일은 자동으로 관리 아래에 들어가지 않습니다. 추가해야 합니다.
폴더에 데이터베이스 복사본, 테스트 데이터베이스, 복제할 필요가 없는 다른 파일이 있으면 목록 모드를 고릅니다.
3.2. 시작 전: 권한 확인
Firebird 와 노드가 실행되는 사용자(Linux 에서는 firebird, Windows 에서는 LocalSystem)는 다음에 대한 읽기·쓰기 권한이 있어야 합니다.
데이터베이스 루트 폴더와 데이터베이스 파일.
replication.conf 와 그 폴더(노드는 임시 파일을 거쳐 파일을 바꿉니다).
세그먼트 폴더 <database>.ReplLog 와 <database>.LogArch(노드가 직접 만듦).
RCM 은 등록 전에 권한을 확인합니다(사전 확인). 확인이 실패하면 명령은 오류 preflight failed on <node> 와 경로 목록으로 끝납니다.
양식은 노드의 현재 규칙을 보여 줍니다(노드가 직접 보낸 것). 노드가 응답하지 않으면 미리 보기와 등록 단추가 비활성화됩니다. 현재 규칙이 없으면 포함 목록과 제외 목록을 초기화하기 때문입니다.
필드를 채우거나 고칩니다. 이 서버의 폴더 경로, 재귀, 마스크, 크기 필터, 동기화 추적 테이블.
동기화 추적 테이블 필드:
HQbird 2027.2.24 이후 — 목록은 이 동작이 등록할 데이터베이스마다 입니다. 빈 필드: 데이터베이스는 자기 게시의 테이블을 씁니다. 등록은 노드 공유 목록(sync_tables)을 바꾸지 않습니다. 그것이 있으면 양식이 그렇게 말합니다. 자기 목록이 없는 데이터베이스는 게시가 아니라 그것을 씁니다. 이미 관리 중인 데이터베이스의 목록은 그 페이지에서 설정합니다. 데이터베이스 → 마스터 데이터베이스 → 동기화 추적 테이블 블록. 블록은 지금 유효한 목록을 보여 줍니다. 빈 필드는 그 데이터베이스 자신의 목록을 제거합니다.
RCM 과 노드 2027.5.7 — 노드의 모든 데이터베이스 를 위한 단일 목록(sync_tables).
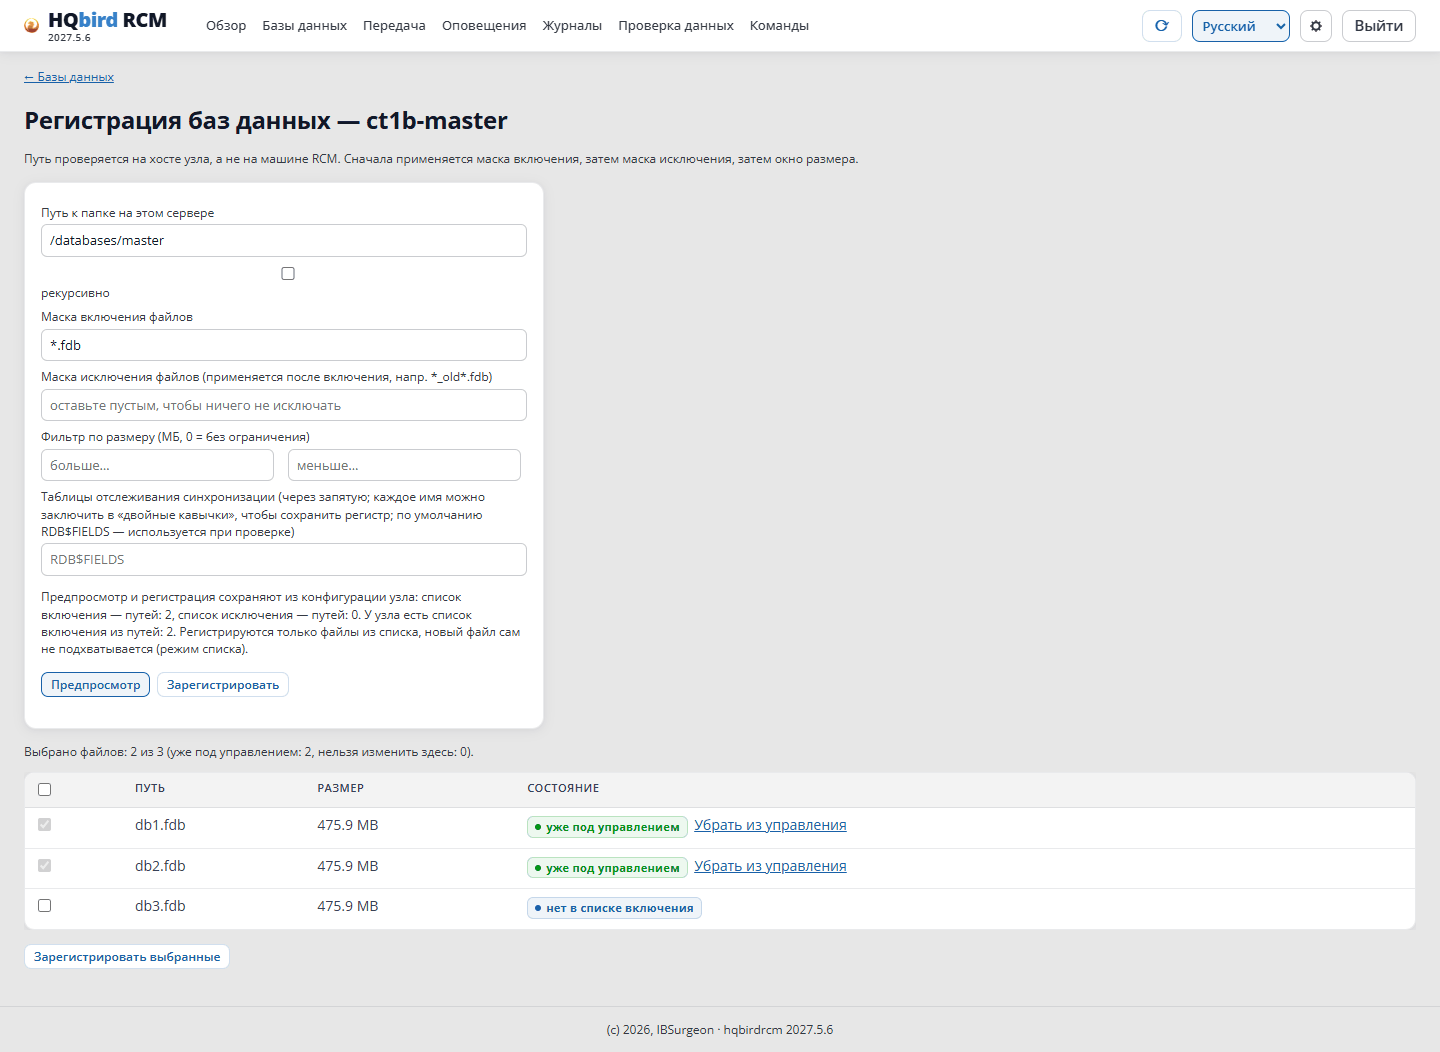
미리 보기 를 클릭합니다. 노드는 포함 마스크에 맞는 모든 파일을 보여 줍니다. 아무것도 바꾸지 않습니다.
목록을 확인합니다. 각 파일에 확인란이 있습니다.
선택됨 — 파일이 관리됩니다.
선택됨, 잠김, 이미 관리됨 표시 — 데이터베이스는 이미 등록되었습니다.
이유와 함께 잠김 — 파일이 마스크, 크기 또는 제외 목록으로 제외되었습니다. 가져가려면 규칙을 바꿉니다.
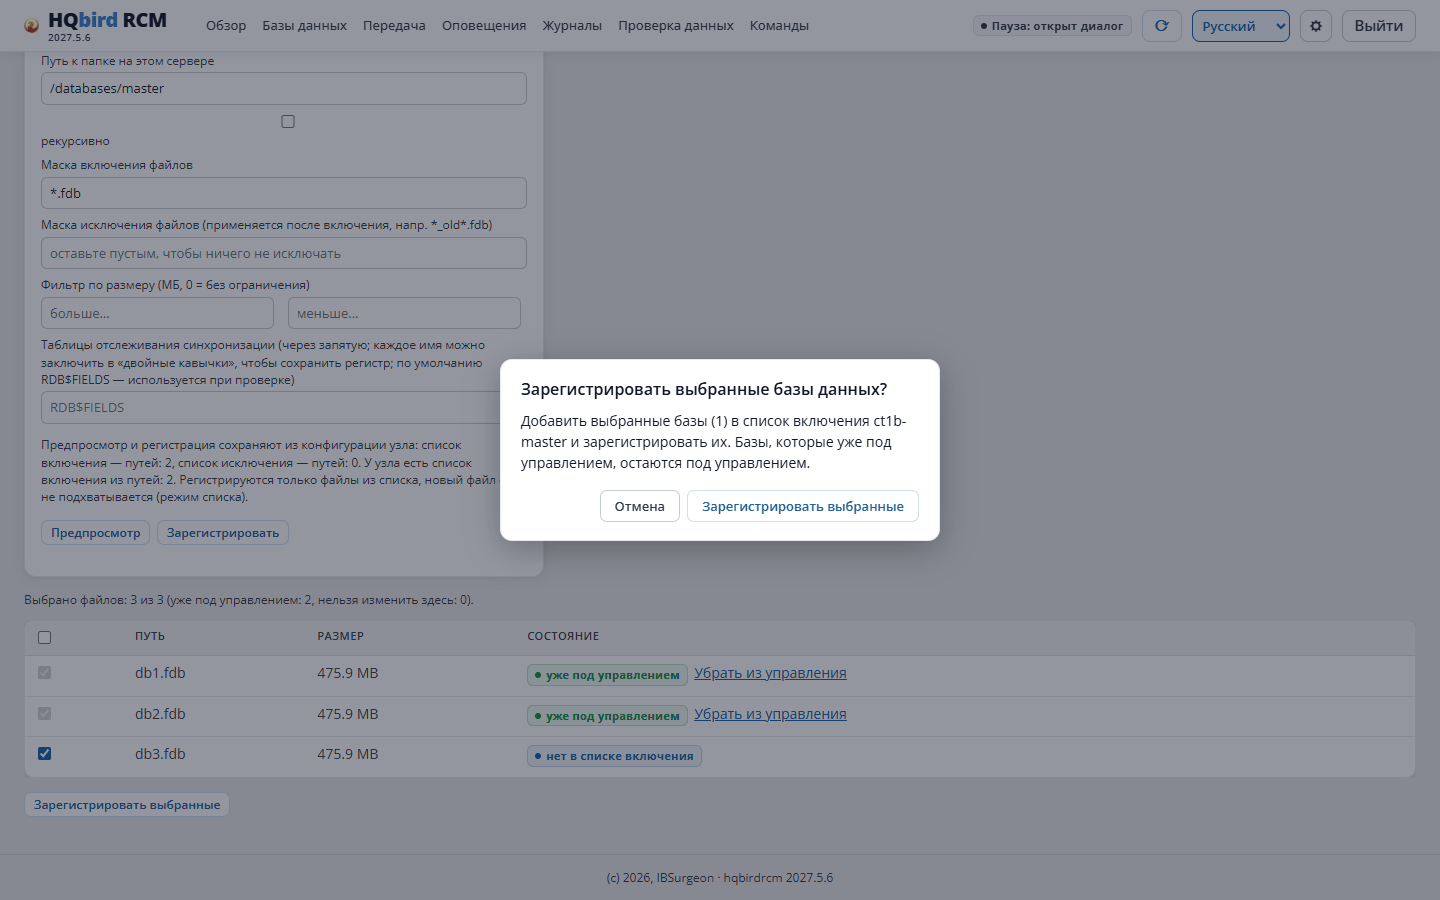
필요한 데이터베이스를 선택하고 선택 항목 등록 을 클릭합니다. RCM 이 확인을 요청하고 파일 수를 보여 줍니다.
등록 확인
이 단추가 하는 일:
템플릿 모드 — 선택되지 않은 파일은 제외 목록에 추가되고, 선택된 파일은 거기에서 빠집니다.
목록 모드 — 선택된 파일은 포함 목록에 추가됩니다.
이 단추는 이미 관리 중인 데이터베이스에 추가 합니다. 잠긴 행은 바꾸지 않습니다.
7. 등록 단추는 목록을 바꾸지 않고 양식을 적용합니다.
8. 완료 메시지와 추가된 데이터베이스 수를 기다립니다. 오래 응답이 없으면 명령 페이지에서 결과를 확인합니다.
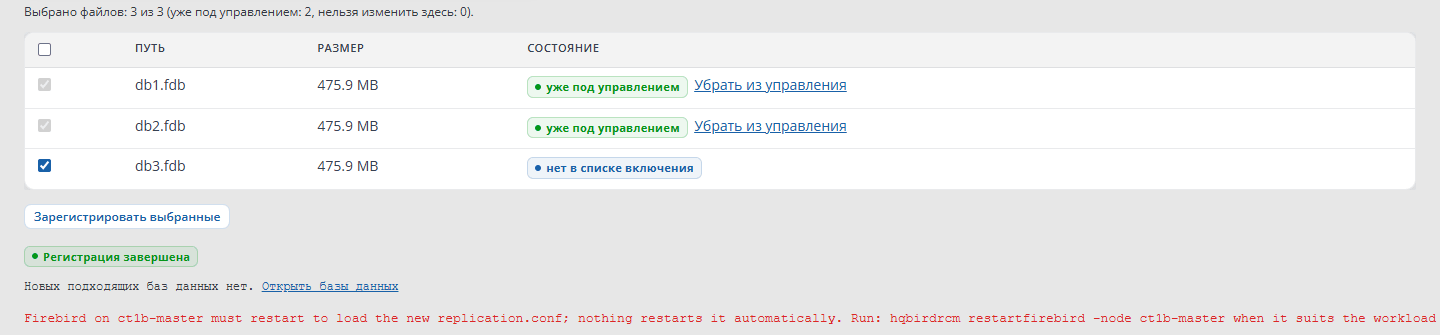
HQbird 2027.2.24 이후의 메시지는 “등록됨: N"입니다. 마스터 Firebird 를 다시 시작해야 하면 RCM 은 누를 단추를 알려 줍니다(보통 데이터베이스 행의 마스터 Firebird 다시 시작) 그리고 마스터 데이터베이스로의 링크를 줍니다. RCM 2027.5.7 은 데이터베이스가 추가되었어도 “적합한 새 데이터베이스가 없습니다"라고 할 수 있습니다. 데이터베이스 페이지를 확인합니다.
등록 결과
등록 뒤 데이터베이스가 보이지 않지만 노드에 이미 데이터베이스가 있으면, 노드는 거부하고(409) 옛 규칙을 돌려줍니다. 이렇게 경로 실수가 모든 데이터베이스의 복제를 끄지 않게 합니다.
주의: 이 명령은 매개변수의 필드만 보냅니다. 나머지 규칙(마스크, 크기, 포함·제외 목록, sync_tables)은 노드가 초기화합니다. 이 규칙용 매개변수는 없습니다. 명령을 실행하기 전에 현재 규칙을 확인합니다(hqbirdrcm getconfig -node node-a). 설정되어 있으면 등록 페이지를 씁니다.
3.4. 등록 뒤에 일어나는 일
노드는 규칙을 node.json 에 씁니다.
노드는 폴더를 스캔합니다(scansync).
찾은 각 데이터베이스에 대해 노드는 replication.conf 의 자기 영역(줄 # BEGIN managed-by:node-a role:master 와 # END … 사이)에 블록을 쓰고 폴더 <database>.ReplLog 와 <database>.LogArch 를 만듭니다. 노드는 자기 영역 밖의 텍스트를 바꾸지 않습니다.
변경 전에 노드는 파일 복사본을 저장합니다. replication_YYYYMMDD_hhmmss_NNN.conf.
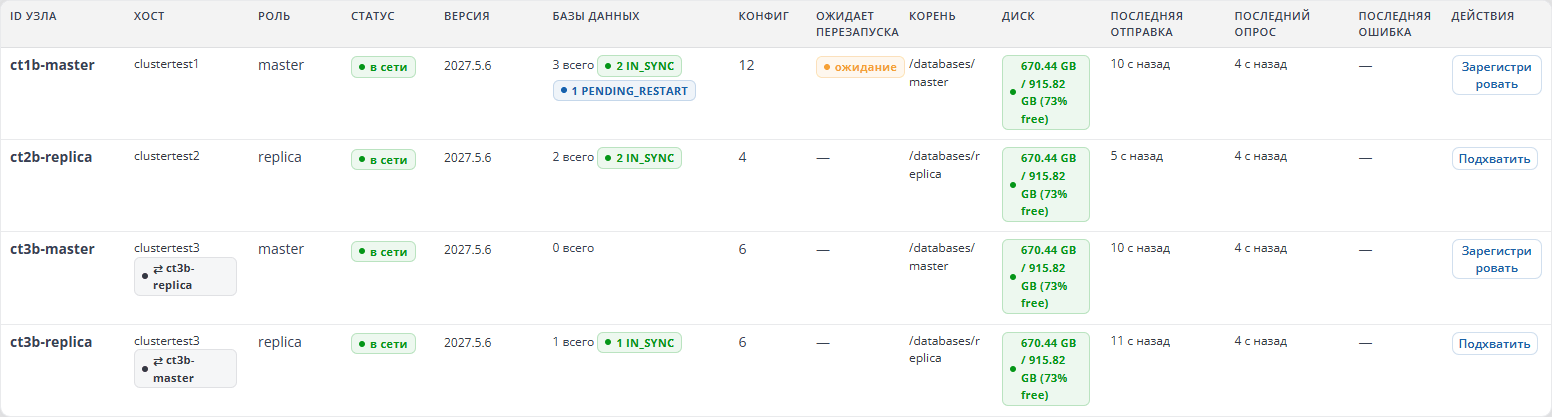
replication.conf 가 바뀌면 데이터베이스는 PENDING_RESTART 상태가 됩니다. Firebird 가 새 파일을 읽는 것은 다시 시작 뒤뿐입니다. 노드 표에서는 다시 시작 대기 열에 표시됩니다.
"노드" 표의 "다시 시작 대기" 열
새 데이터베이스의 상태:
상태
RCM 그룹
의미
UNCONFIGURED
대기
데이터베이스를 찾았으나 구성은 아직 쓰이지 않음
PENDING_RESTART
대기
구성이 쓰임. Firebird 다시 시작이 필요
CONFIGURED
대기
Firebird 가 다시 시작됨. 데이터베이스는 게시와 초기화 준비가 됨
3.5. 마스터 Firebird 다시 시작
마스터 노드는 Firebird 를 스스로 다시 시작하지 않습니다. RCM 도 마찬가지입니다. 마스터를 다시 시작하는 것은 운영자의 결정입니다. 다시 시작하면 그 Firebird 인스턴스의 모든 데이터베이스 연결이 끊어집니다.
부하가 낮은 시각을 고르고 다음 단추 중 하나를 클릭합니다.
마스터 Firebird 다시 시작 — 데이터베이스 페이지에서, 다시 시작을 기다리는 데이터베이스의 마스터 행.
초기화 창의 같은 단추. 5장.
Firebird 다시 시작 — 데이터베이스 페이지.
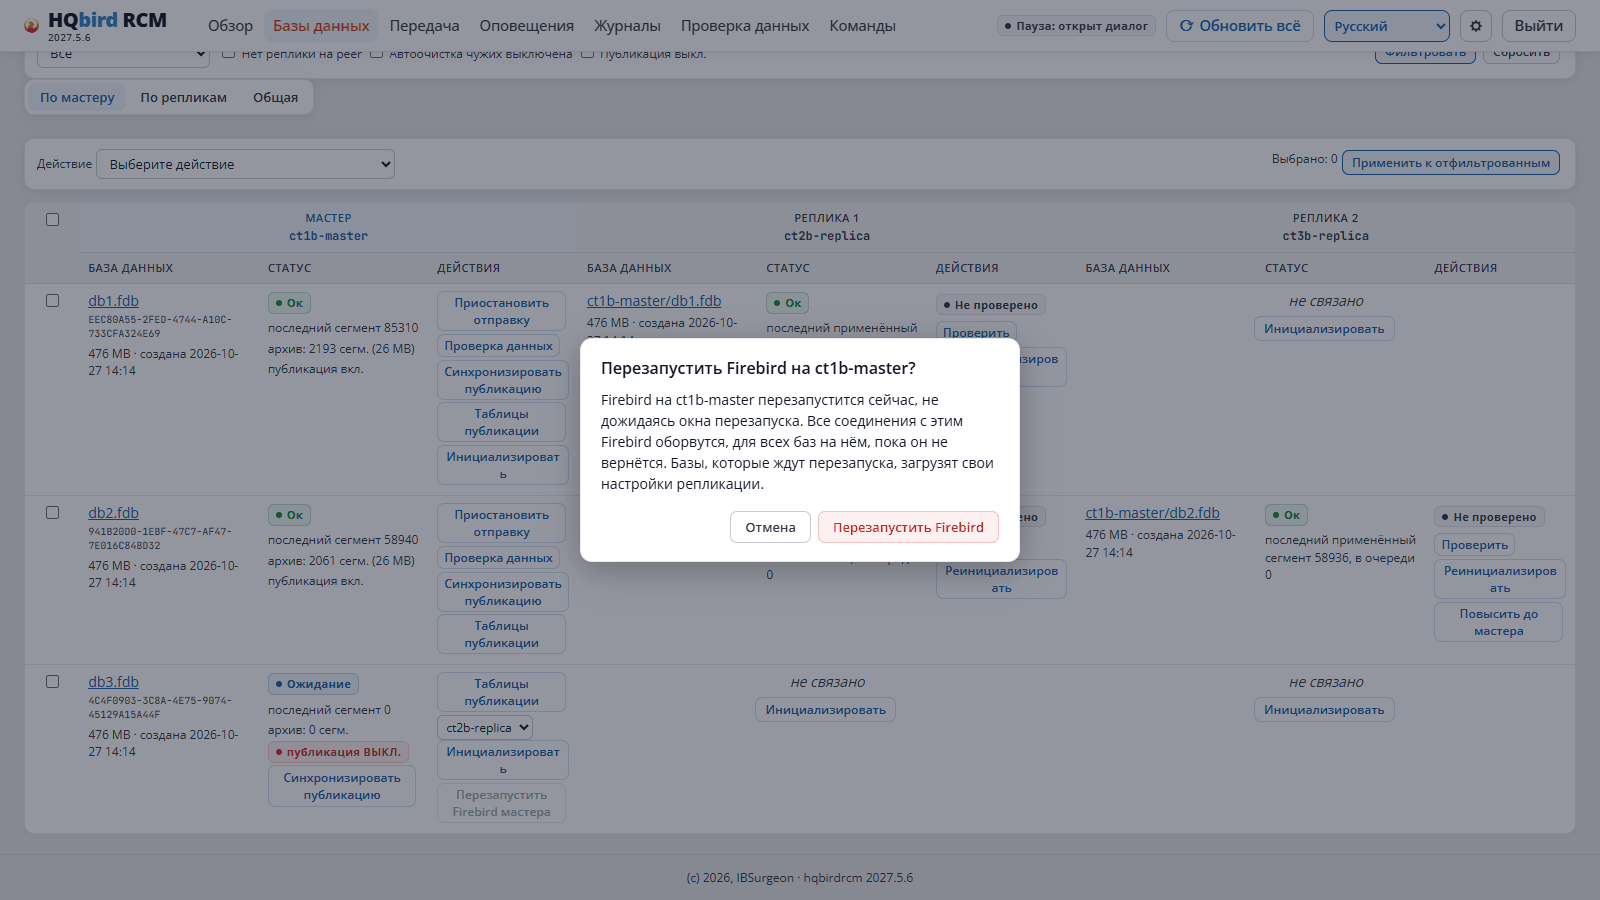
RCM 이 확인을 요청합니다. 노드 이름과 경고를 보여 줍니다. Firebird 는 다시 시작 창을 기다리지 않고 즉시 다시 시작하며 모든 연결이 끊어집니다.
마스터 Firebird 다시 시작 확인
명령줄에서도 같은 동작
Command
hqbirdrcm restartfirebird -node node-a
이 명령도 다시 시작 창 없이 즉시 다시 시작합니다.
노드가 Firebird 를 다시 시작하는 방법:
fbagent 가 응답하고 같은 인스턴스를 관리하는지 확인합니다(node.json 의 식별자, 포트, 서비스 이름). 하나라도 다르면 노드는 거부합니다.
fbagent 에 Firebird 다시 시작을 요청합니다.
Firebird 가 자기 포트에서 응답하기를 기다립니다.
데이터베이스를 PENDING_RESTART 에서 CONFIGURED 로 옮깁니다.
한 호스트에 HQbird 인스턴스가 여러 개. fbagent 는 자기 구성의 firebird.update.services 에 나열된 서비스를 다시 시작합니다. 빈 목록은 호스트의 모든 HQbird 서비스를 뜻합니다. 호스트에 HQbird 인스턴스가 둘이면 목록에는 자신의 인스턴스 서비스만 남깁니다. 그렇지 않으면 한쪽 노드를 다시 시작할 때 다른 인스턴스도 멈춥니다.
Windows 에서.replication.log 가 log_portion_mb 이상으로 자랐으면 다시 시작은 다음과 같습니다. Firebird 중지 → 로그 보관 → 시작.
3.6. 이미 수동으로 복제 중인 데이터베이스
데이터베이스 복제가 이미 수동으로 구성되어 있으면(replication.conf 에 자기 블록, 게시 켜짐, 세그먼트가 흐름) 레플리카를 다시 초기화 하지 않고 관리 아래로 들일 수 있습니다. 이를 위한 detect_existing 모드가 있습니다(마스터만).
응답의 taken_over 는 이전될 데이터베이스 목록입니다. -verbose 를 더하면 건너뛴 데이터베이스와 이유가 보입니다.
목록이 맞으면 -dry-run 없이 명령을 실행합니다.
노드가 블록을 이전하는 것은 다음일 때뿐입니다.
세그먼트 폴더 이름이 정확히 <database>.ReplLog 와 <database>.LogArch 임.
아카이브에 이미 세그먼트가 있음.
데이터베이스에서 게시가 켜져 있음.
노드는 경로가 다른 블록을 이전하지 않고 “찾았으나 지원되지 않음"으로 보고합니다.
이전 뒤 데이터베이스는 PENDING_RESTART 가 됩니다. 복제 설정은 바뀌지 않았습니다. 바뀌는 것은 파일 안의 블록 위치뿐입니다. 유지 보수 창에서 Firebird 를 다시 시작합니다.
3.7. 확인 방법
데이터베이스: 데이터베이스가 마스터 노드 행에 보이고 상태는 CONFIGURED(다시 시작 후).
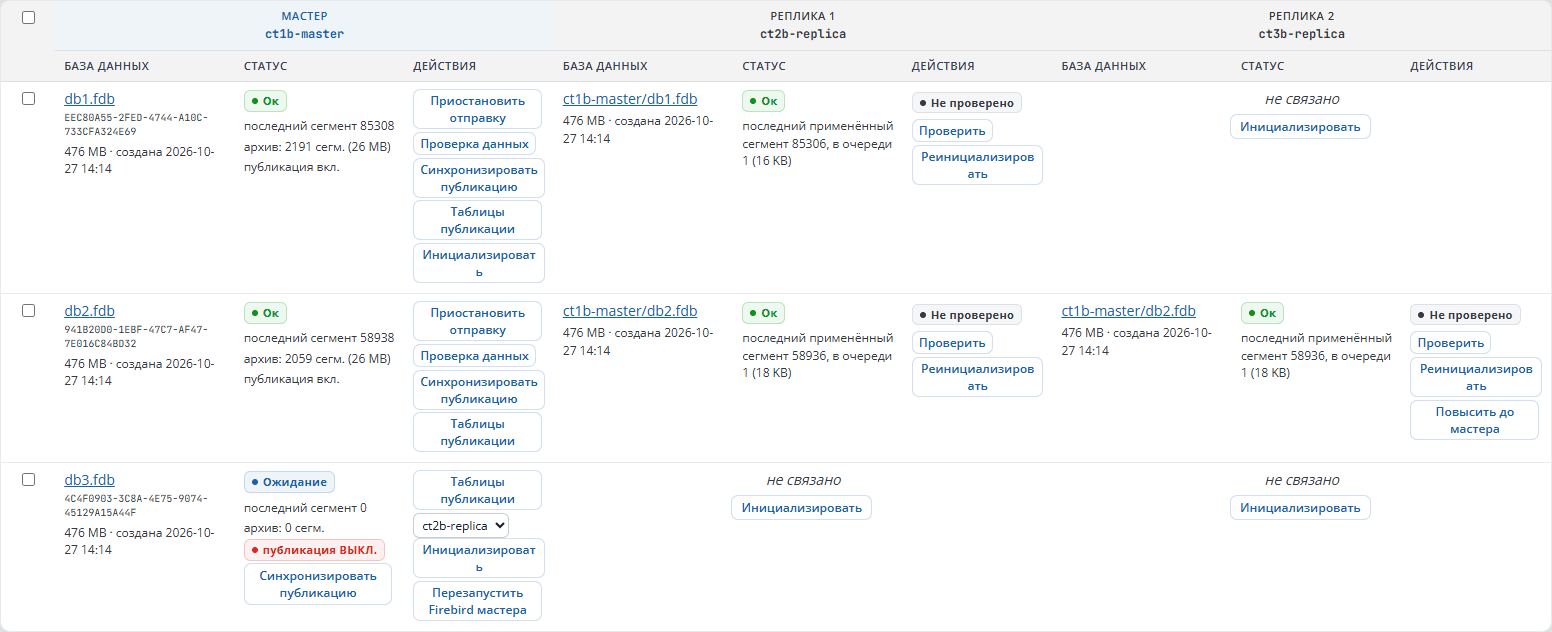
데이터베이스 옆에 게시 꺼짐 아이콘이 있을 수 있습니다. 게시는 아직 켜지지 않았습니다. 이것은 정상이며, 게시는 다음 단계입니다(6장).
마스터 행의 새 데이터베이스
노드 호스트: replication.conf 의 managed-by:node-a 영역에 데이터베이스 블록이 있고, 데이터베이스 옆에 .ReplLog 와 .LogArch 폴더가 있음.
3.8. 데이터베이스를 관리에서 제거
일반적인 방법은 단추입니다.데이터베이스 페이지에서 데이터베이스를 선택하고, 일괄 동작 관리에서 제거 를 고른 뒤 선택 항목에 적용 을 클릭합니다. RCM 은 다음을 합니다.
파일을 노드의 제외 목록에 추가합니다.
폴더를 한 번 스캔합니다. 데이터베이스 블록이 replication.conf 에서 제거됩니다.
노드의 데이터베이스 기록을 삭제합니다.
데이터베이스 파일과 세그먼트 폴더는 디스크에 남습니다. Firebird 는 다시 시작되지 않습니다. Firebird 는 다음 다시 시작까지 그 데이터베이스의 세그먼트를 계속 씁니다. 다시 시작이 필요하면 RCM 이 알립니다.
살아 있는 레플리카가 있는 마스터 데이터베이스에 대해 RCM 은 거부합니다(has_replicas). 그렇지 않으면 레플리카가 조용히 멈추기 때문입니다. 먼저 레플리카를 일반 데이터베이스로 만들거나 제거합니다(8장).
replication.conf 에서 데이터베이스 블록을 손으로 지우지 마십시오. 다음 스캔에서 노드가 다시 씁니다.
데이터베이스 파일이 사라졌거나 규칙으로 제외된 경우. 데이터베이스는 상태 ORPHANED(고아 그룹)가 됩니다. 노드는 기록과 세그먼트 아카이브를 유지합니다. 데이터베이스가 없는 것은 결정이라기보다 실수인 경우가 많습니다. 파일이 돌아오면 데이터베이스는 다시 동작하고 경보가 사라집니다. 그런 데이터베이스를 영구히 삭제하려면 이 순서 로 두 단계를 실행합니다.
forgetdatabase 뒤에는 cleanuparchive 명령이 그 데이터베이스를 찾지 못합니다. 두 명령 모두 ORPHANED 상태의 데이터베이스에만 동작하며 데이터베이스 파일은 건드리지 않습니다.
주의. 레플리카를 마스터로 승격한 뒤(8장) 옛 기록에 cleanuparchive -orphaned 를 실행하지 마십시오. 새 마스터는 같은 .LogArch 폴더를 쓰며, 명령은 그 동작 중인 아카이브를 삭제합니다.
3.9. 데이터베이스 루트 변경
다른 경로로 등록하는 것은 허용됩니다. 노드는 다음을 합니다.
새 폴더에서 데이터베이스를 추가합니다.
새 폴더에 없는 옛 폴더의 데이터베이스를 ORPHANED 로 옮기고(알림 orphaned_database) 그 아카이브를 유지합니다.
잘못된 폴더를 골랐으면 올바른 폴더를 다시 등록합니다. 같은 전체 경로의 데이터베이스는 같은 db_id 로 계속 동작합니다. 다른 경로의 데이터베이스는 새 데이터베이스입니다(새 db_id). 그 레플리카는 다시 초기화해야 합니다.
3.10. 흔한 오류
보이는 것
원인
할 일
preflight failed on node-a
폴더 권한이 없음
권한을 고치고 재시도(3.2)
409 scan_would_empty_region
새 폴더에 데이터베이스가 없지만 노드에는 있었음
경로와 마스크 확인
미리 보기가 비어 있음
마스크가 맞지 않거나 폴더가 잘못됨
경로, 마스크, “재귀” 확인
단추가 비활성화됨, “노드 구성을 읽지 못했습니다”
노드가 응답하지 않음
노드 서비스와 네트워크 확인(1장)
데이터베이스가 오래 PENDING_RESTART 에 머무름
마스터는 Firebird 를 스스로 다시 시작하지 않음
Firebird 다시 시작(3.5)
fbagent 때문에 다시 시작이 거부됨
fbagent 가 실행되지 않거나 그 데이터가 node.json 과 다름
1장, fbagent 확인
새 파일이 나타나지 않음
노드가 목록 모드임
“선택 항목 등록"으로 파일 추가
4. 데이터베이스를 레플리카로 만드는 방법: 단계와 디스크 위치
이 장은 데이터베이스가 기본에서 동작하는 레플리카가 되기까지의 전체와 디스크 공간 계산을 다룹니다. 초기화 자체는 5장 에 자세히 있습니다.
4.1. 핵심 규칙
레플리카에 데이터베이스가 나타나는 것은 마스터에서의 초기화(reinit) 뿐입니다. 마스터 노드가 nbackup 으로 복사본을 직접 전송합니다.
손으로 복사본을 만들지 마십시오.
gbak 은 새 데이터베이스 GUID 를 만들고 세그먼트 번호를 초기화합니다. 마스터와 레플리카의 연결이 끊깁니다.
실행 중인 데이터베이스의 파일 복사 는 일관되지 않으며, RCM 은 같은 GUID 의 데이터베이스가 둘이라고 보고(duplicate_guid) 초기화를 금지합니다.
이미 실행 중인, 손으로 구성한 레플리카는 새 복사본 없이 관리 아래로 들일 수 있습니다. 4.6 을 보십시오.
4.2. 단계
번호
단계
위치
단계 뒤 마스터 데이터베이스 상태
1
마스터에 데이터베이스 등록
3.3장
PENDING_RESTART
2
마스터 Firebird 다시 시작
3.5장
CONFIGURED
3
게시 동기화
6장
CONFIGURED, 게시 켜짐
4
레플리카 준비: 폴더, 권한, Firebird 버전
4.3
—
5
마스터와 레플리카의 여유 공간 확인
4.4
—
6
초기화
5장
SEEDING → IN_SYNC
7
레플리카 Firebird 다시 시작(필요하면)
5.6장
레플리카가 세그먼트 적용을 시작
8
데이터 확인
5.10장
—
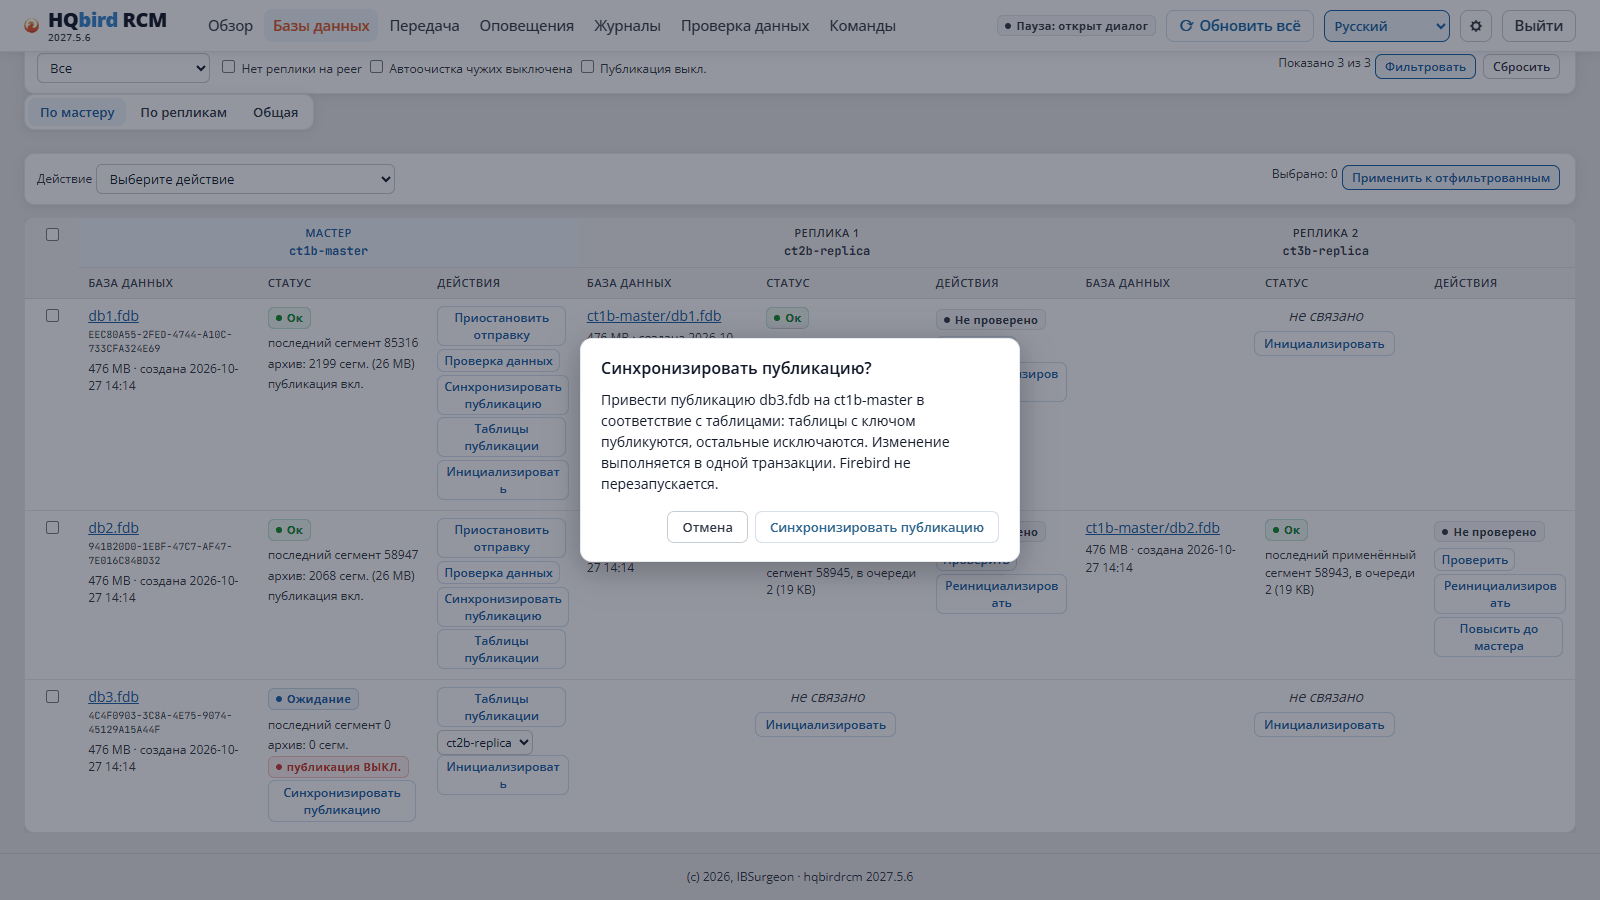
3단계는 Firebird 4/5 에서 필수입니다. 게시가 없으면 마스터 Firebird 는 테이블 변경을 세그먼트에 쓰지 않고, 레플리카는 조용히 마스터보다 뒤처집니다. 데이터베이스 페이지에서 그런 데이터베이스에는 게시 꺼짐 아이콘이 붙습니다. 초기화 전에 게시 동기화(게시 동기화)를 클릭합니다.
HQbird 2027.2.24 부터 초기화 창이 이것을 경고하고 게시를 동기화하고 초기화 단추를 제공합니다. 마스터 노드는 오류 publication_off 로 초기화를 거부합니다(5.1장). RCM 과 노드 2027.5.7 은 게시를 확인하지 않습니다.
레플리카 노드는 각 데이터베이스를 자기 databases.root 폴더 안의 다음 경로에 둡니다.
Code
<databases.root>/<master node name>/<database path relative to the master root>
예: 마스터 node-a 의 루트가 /databases/master 이고 데이터베이스가 /databases/master/sales/employee.fdb. 루트가 /databases/replica 인 레플리카 node-b 에서 데이터베이스는 여기 있습니다.
Code
/databases/replica/node-a/sales/employee.fdb
이렇게 서로 다른 마스터의 같은 이름 데이터베이스가 충돌하지 않습니다.
루트 폴더를 자동으로 만드는 것은 없습니다. 설치 프로그램도, HQCenter Admin 도, 시작 시의 노드도 만들지 않습니다. 다음 중 하나로 만듭니다.
초기화 창: 레플리카 폴더 필드와 폴더 만들기 단추. 단추는 폴더가 없을 때만 보입니다. HQbird 2027.2.24 에서 레플리카 노드에 아직 databases.root 가 없으면 필드에는 이미 /databases/replica/<replica node id> 가 들어 있습니다. Windows 의 레플리카에서는 필드가 비어 있습니다. 드라이브 문자가 있는 폴더를 입력합니다. 같은 호스트의 각 레플리카 노드에는 자기 폴더가 필요합니다. 폴더를 만드는 것은 레플리카 노드입니다. 소유자는 firebird(또는 노드 서비스 사용자), 권한은 2770. 노드가 만들지 못하면 창은 레플리카 호스트용 명령을 보여 줍니다. 다른 폴더를 지정하면 RCM 은 초기화 전에 그것을 레플리카 노드의 databases.root 에 씁니다.
setgid 비트(2770)는 안의 모든 파일이 Firebird 그룹이 되게 하는 데 필요합니다.
레플리카 루트는 거기에 데이터베이스가 없는 동안에만 바꿀 수 있습니다. 그렇지 않으면 옛 데이터베이스가 스캔 밖에 남습니다. 데이터베이스 하나만 다른 위치에 두려면 데이터베이스 페이지의 이동 을 씁니다.
권한
레플리카 노드와 Firebird 는 데이터베이스 루트에 쓸 수 있어야 합니다. 노드는 놓인 파일이 폴더의 그룹을 받는지 확인합니다. 받지 못하면 ownership_unfixable 과 고치는 방법의 글로 거부합니다(보통 노드 서비스가 Group=root 로 실행 중).
HQbird 2027.2.24 에서 초기화 창은 존재하지만 노드 서비스가 쓸 수 없는 폴더도 보여 줍니다. 고치는 명령이 있는 노드의 글과 다시 확인 단추입니다. 이 경우 RCM 2027.5.7 은 “폴더가 있습니다"라고 합니다. 권한은 직접 확인합니다(hqbirdrcm checkpermissions -node <replica> -root <folder>).
Firebird 버전
레플리카의 Firebird 주 버전은 마스터와 같아야 합니다(5.0 → 5.0, 4.0 → 4.0). 그렇지 않으면 레플리카는 데이터를 전송하기 전에 거부합니다. incompatible_engine.
연결
레플리카 노드는 마스터의 피어이고, 마스터는 레플리카의 피어여야 합니다(2장). 그렇지 않으면 RCM 은 초기화 창에서 이 노드를 제안하지 않습니다.
4.4. 필요한 공간
요약
위치
대상
양
마스터, 데이터베이스 볼륨
초기화 전 여유
데이터베이스 크기의 105% 이상
레플리카, 데이터베이스 폴더 볼륨
초기화 전 여유
데이터베이스 크기의 105% 이상. HQbird 2027.2.24 에서는 추가로 free_space_floor_gb(레플리카가 이미 있으면 옛 파일도. 옛 레플리카 제거 확인란을 쓰면 그것을 제외)
마스터, <database>.ReplLog
Firebird 작업 세그먼트
최대 64 세그먼트 × 세그먼트 크기(기본 16 MB) ≈ 데이터베이스당 1 GB
마스터, <database>.LogArch
레플리카용 세그먼트 아카이브
retention_days 기간의 변경(기본 2일) + 레플리카가 아직 확인하지 않은 분
레플리카, <database>.Incoming
적용 대기 세그먼트 큐
최대 256 세그먼트 × 16 MB ≈ 최악의 경우 데이터베이스당 4 GB
레플리카, 볼륨 전체
여유
적어도 free_space_floor_gb(기본 1 GB)
초기화 전 공간 확인
초기화는 공간을 두 번 확인하고, 그것은 데이터베이스를 잠그기 전 뿐입니다.
RCM — 명령을 보내기 전, 최신 노드 통계에서. 공간이 분명히 부족하면 RCM 은 즉시 오류 507 을 반환합니다.
마스터 노드 — 자기 볼륨에서 실측한 뒤 레플리카에 자기 볼륨을 재라고 요청합니다. 적어도 한쪽이 부족하면 초기화는 공간 확인 단계에서 오류 insufficient disk space on master 또는 … on replica 로 끝납니다.
양쪽 요구는 마스터 데이터베이스 크기의 105% 입니다.
HQbird 2027.2.24 에서 레플리카 노드는 다음과 같이 계산합니다.
필요한 것은 데이터베이스 크기의 105% 에 더해 레플리카의 free_space_floor_gb(7.3)입니다. 초기화 뒤에도 볼륨에 세그먼트용 여유가 남습니다.
이전 초기화의 잔여(<database>.hqcluster-part, <database>.new)는 여유 공간으로 셉니다. 노드는 새 복사본 전에 그것을 삭제합니다.
오류 글은 모든 숫자를 적습니다. 파일 <database>.pre-reinit-*.fdb 와 <database>.failed-seed-*.fdb 와 그 크기도 적습니다. 노드는 그것을 절대 삭제하지 않습니다. 필요 없으면 직접 삭제합니다.
force(강제)가 건너뛰는 것은 RCM 안의 확인뿐입니다. 노드 확인은 우회할 수 없습니다. 복사 도중에 디스크가 바닥나는 것을 막기 때문입니다. 공간 부족의 이유가 옛 레플리카 복사본뿐이면 RCM 2027.2.24 는 오류 507 에서 force 가 아니라 옛 레플리카 제거 확인란을 가리킵니다. 이를 위해 두 노드 모두 HQbird 2027.2.24 이상이어야 합니다. 그렇지 않으면 오류는 업데이트가 필요한 노드와 force 를 가리킵니다.
왜 이렇게 많이 필요한가
마스터. 복사 중 데이터베이스는 nbackup -L 로 잠깁니다. 모든 변경은 데이터베이스 옆의 <database>.delta 파일에 쓰입니다. .delta 크기는 복사 중 쓰기 부하에 달립니다. 부하가 크고 전송이 느리면 상당히 자랄 수 있습니다. 첫 초기화에서는 공간을 지켜봅니다.
레플리카. 복사본은 데이터베이스 위치 옆의 <database>.hqcluster-part 파일에 바로 쓰입니다. 노드는 미리 전체 크기를 예약합니다. 그다음 파일을 검사하고, 복구하고(nbackup -FIXUP -SEQUENCE), 제자리로 이름을 바꿉니다. 두 번째 복사본은 필요 없습니다. 데이터베이스 크기는 데이터베이스 볼륨에서 한 번만 필요합니다.
레플리카가 이미 있었으면(재초기화) 옛 파일은 마지막 단계까지 디스크에 남습니다. 즉 옛 파일과 새 복사본이 동시에 볼륨에 필요합니다. 여유 공간은 옛 파일을 빼고 계산됩니다. 그래서 요구는 같습니다. 데이터베이스 크기의 105% 여유.
옛 레플리카 제거(HQbird 2027.2.24). 레플리카 볼륨에 옛 복사본 옆에 새 복사본을 둘 공간이 없으면 초기화 창에서 이 확인란을 켭니다(5.1장). 레플리카 노드는 전송 전에 옛 복사본과 수신 세그먼트(.Incoming)를 삭제하고, 볼륨에는 데이터베이스 크기의 105% 에 free_space_floor_gb 를 더한 만큼이 있습니다. 노드가 복사본을 삭제하는 것은 모든 조건이 참일 때뿐입니다.
그렇지 않으면 노드는 아무것도 삭제하지 않고 이유를 글에 적어 거부합니다. 삭제하려면 노드는 삭제하는 동안 레플리카 Firebird 를 멈춥니다(5.6).
확인란은 기본적으로 꺼져 있습니다. 위험: 전송 동안 레플리카에 데이터베이스 복사본이 없습니다. 데이터베이스의 레플리카가 하나뿐이면 그동안 마스터는 보호되지 않습니다. 새 복사본이 없는 동안 레플리카의 데이터베이스는 NEEDS_REINIT 상태입니다(FAILED 도 ORPHANED 도 아님). 레플리카는 경보 replica_removed_for_reinit(경고)를 냅니다. 새 복사본이 제자리에 들어가면 경보가 사라집니다. 삭제 뒤 초기화가 실패하면 쌍은 NEEDS_REINIT 로 남습니다. 초기화를 다시 시작합니다(또는 자동 재초기화가 시작합니다, 5.8). 새 초기화는 데이터베이스를 처음부터 전송합니다.
마스터 아카이브(.LogArch). 노드는 보낸 세그먼트를 retention_days 일 동안 보관해 레플리카가 다시 요청할 수 있게 합니다. 레플리카가 아직 적용하지 않은 세그먼트는 더 오래 보관됩니다. 공간이 적으면 노드는 단계적으로 아카이브를 정리합니다.
모든 레플리카가 적용했고 retention_days 보다 오래된 세그먼트.
더 새로운 적용된 세그먼트(공간이 부족할 때).
미적용 세그먼트 — 마지막 수단만. 그때 레플리카는 필요한 세그먼트를 잃고 NEEDS_REINIT 가 됩니다.
레플리카가 오래 닿지 않으면 아카이브가 자랍니다. 그 볼륨은 중단 기간의 데이터베이스 변경량입니다.
계산 예
데이터베이스 100 GB. 부하는 하루 세그먼트 5 GB. 초기화는 밤에 실행되고 복사에 2시간이 걸리며, 그동안 .delta 에 약 2 GB 가 들어갑니다.
위치
계산
합계 여유
마스터, 데이터베이스 볼륨
확인용 105 GB(.delta 증가 포함) + .ReplLog 1 GB + .LogArch 2일 × 5 GB = 10 GB
116 GB 이상
레플리카, 새 데이터베이스
105 GB + .Incoming 최대 4 GB + 여유 1 GB
110 GB 이상
레플리카, 재초기화
디스크에 이미 옛 파일 100 GB + 여유 110 GB
볼륨 210 GB 이상
레플리카, 옛 레플리카 제거 확인란이 있는 재초기화(HQbird 2027.2.24)
전송 전에 옛 파일 삭제: 105 GB + .Incoming 최대 4 GB + 여유 1 GB
볼륨 110 GB 이상
데이터베이스 성장과 레플리카 중단(마스터 아카이브는 중단 하루당 5 GB 증가)을 위한 여유를 더합니다.
별도 볼륨의 세그먼트
.ReplLog, .LogArch, .Incoming 폴더는 기본적으로 데이터베이스 옆에 있습니다. 다른 볼륨으로 옮길 수 있습니다. node.json 의 segments.storage 매개변수입니다(mirror_hierarchy: true 이면 노드는 데이터베이스 폴더 구조를 재현합니다). 그때 아카이브는 데이터베이스의 공간을 빼앗지 않습니다. 105% 확인은 계속 데이터베이스 볼륨에 적용됩니다.
공간을 보는 곳
데이터베이스 → 노드 와 개요: databases.root 볼륨의 여유 공간 아이콘. 노랑은 20% 미만, 빨강은 10% 미만.
데이터베이스 페이지: 노드 표의 디스크 열
클러스터 보고서: hqbirdrcm report.
4.5. 한 데이터베이스의 여러 레플리카
두 번째 이후 레플리카도 같은 방법으로 만듭니다. 마스터 행에서 초기화 를 하고 비어 있는 레플리카 노드를 고릅니다.
새 레플리카를 초기화하는 동안 마스터는 이 데이터베이스를 이미 실행 중인 레플리카에도 보내지 않습니다. 초기화가 끝난 뒤 그것들은 마스터를 따라잡습니다. 확인 창이 그렇게 말합니다.
데이터베이스 하나의 초기화는 한 번에 하나입니다. 서로 다른 레플리카여도 같습니다.
마스터의 공간은 초기화마다 따로 확인됩니다.
레플리카가 둘인 마스터 데이터베이스
4.6. 손으로 구성한 레플리카
손으로 쓴 replication.conf 로 레플리카가 이미 실행 중이면 관리 아래로 들이고 데이터베이스를 다시 복사하지 않을 수 있습니다.
마스터:detect_existing 으로 데이터베이스를 등록합니다(3.6장).
레플리카:데이터베이스 → 레플리카 노드 → 인수, 또는 hqbirdrcm takeover-replica. RCM 은 레플리카 블록을 찾고 GUID 로 파일을 마스터 데이터베이스에 맞추며, 각각에 대해 in_sync, resumable 또는 needs_reinit 를 보여 줍니다.
행을 확인합니다. 노드는 블록을 자기 replication.conf 영역으로 옮깁니다.
레플리카 Firebird 를 다시 시작해 옮겨진 블록을 읽게 합니다.
needs_reinit 행 만 초기화합니다. 마스터 아카이브에는 이 레플리카가 필요한 세그먼트가 더 이상 없습니다.
4.7. 흔한 오류
보이는 것
원인
할 일
insufficient disk space on master / on replica
공간 부족(4.4). 재초기화에서는 옛 복사본이 끝까지 공간을 차지(4.4)
공간을 비우고 재시도. 레플리카 쪽의 두 번째 출구(HQbird 2027.2.24 부터)는 옛 레플리카 제거 확인란(4.4, 5.1)
RCM 의 즉시 507
공간 통계상 분명히 부족
같음. 옛 복사본을 빼면 공간이 있으면 RCM 2027.2.24 는 확인란 옛 레플리카 제거 를 가리킴
incompatible_engine
Firebird 주 버전이 다름
레플리카 Firebird 업그레이드
레플리카 노드에 폴더가 없음
루트가 만들어지지 않음
초기화 창의 폴더 만들기(4.3)
폴더는 있으나 노드 서비스가 쓸 수 없음(HQbird 2027.2.24 부터)
쓰기 권한이 없음
창의 명령을 실행하고 다시 확인 클릭(4.3)
publication_off(HQbird 2027.2.24 부터)
마스터 게시가 꺼져 있거나 테이블이 없음
게시를 동기화하고 초기화(5.1)
ownership_unfixable
노드 서비스의 그룹이 다름
오류 글대로 서비스 그룹을 고침
duplicate_guid
같은 GUID 의 데이터베이스가 둘(파일 복사)
복사본을 제거하거나 새 GUID 를 줌(nbackup -F)
초기화 목록에 레플리카 노드가 없음
피어에 연결이 없음
2장
레플리카는 IN_SYNC 인데 데이터가 어긋남
게시가 꺼져 있었음
게시를 동기화한 뒤 초기화를 반복
5. 초기화(reinit)
초기화는 마스터 데이터베이스의 복사본을 레플리카로 전송하는 것입니다. 첫 전송을 초기화(초기화 단추)라 하고, 반복 전송을 재초기화(재초기화 단추)라 합니다. 메커니즘은 같습니다.
시작 전에 4장 의 1–5단계를 마칩니다. 데이터베이스는 등록되었고, 마스터 Firebird 는 다시 시작되었고, 게시는 켜져 있고, 레플리카 폴더가 있으며, 공간이 충분합니다. 마스터와 레플리카에 필요한 공간은 4.4장 에 있습니다.
5.1. 시작하는 방법
먼저 게시. 데이터베이스 등록에는 게시가 포함되지 않습니다. 게시가 없으면 레플리카는 변경을 받지 못합니다. 초기화 전에 게시 동기화(6장)를 실행하거나 hqbirdrcm setpublication -node <master> 를 실행합니다.
HQbird 2027.2.24 에서 초기화 창은 게시를 확인합니다. 꺼져 있거나 키가 있는 테이블이 없으면 창은 경고와 게시를 동기화하고 초기화 단추를 보여 줍니다. RCM 은 게시를 동기화하고 명령이 끝나기를 기다린 뒤 창의 선택으로 초기화를 시작합니다.
2027.2.24 마스터 노드 자신도 그런 초기화(첫 초기화 포함)를 오류 publication_off 로 거부하고 알림 master_publication_off 를 냅니다(6.1장). 거부 뒤 데이터베이스 칸에는 다시 게시를 동기화하고 초기화 단추가 있습니다.
운영자가 게시를 껐거나(6.4) 키가 있는 테이블을 모두 뺐으면(6.3) 동기화는 그 상태를 유지합니다. RCM 은 초기화를 시작하지 않고 게시 테이블 페이지로의 링크를 줍니다.
RCM 과 노드 2027.5.7 은 게시를 확인하지 않습니다. 초기화는 성공하고 RCM 에서 데이터베이스는 “정상"으로 보이지만 레플리카는 변경을 받지 못합니다. 초기화 뒤에 게시를 켰다면 데이터베이스를 재초기화합니다.
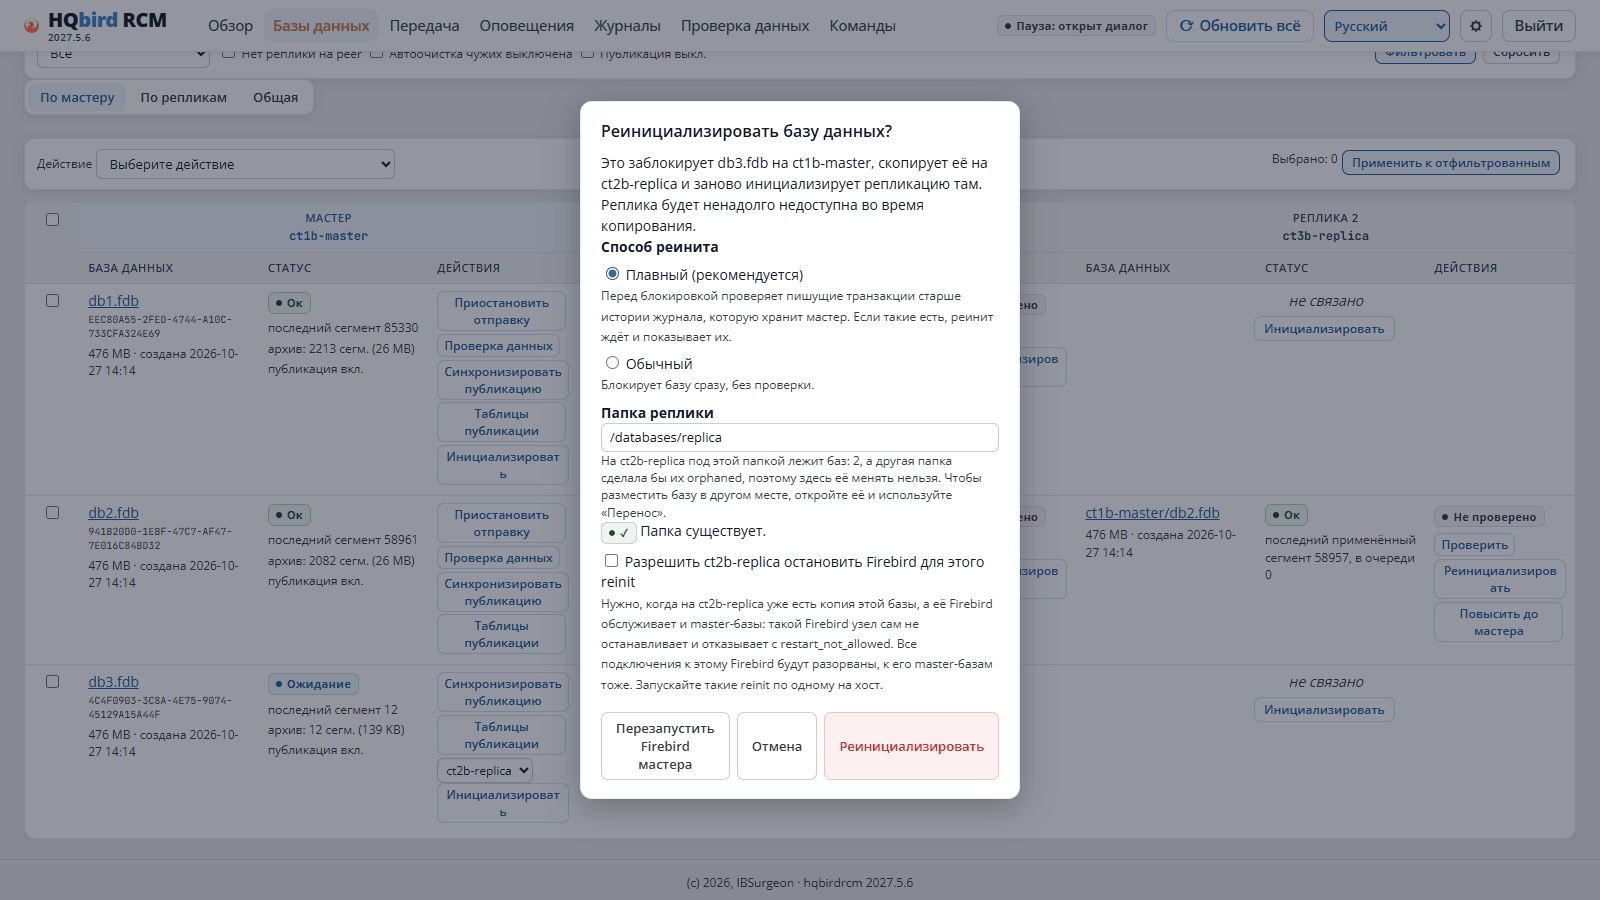
"데이터베이스를 재초기화할까요?" 창
데이터베이스 를 엽니다.
마스터 데이터베이스 행에서 레플리카 노드 열의 초기화 를 클릭합니다. 레플리카 노드는 열이 정합니다. 창에서 고르지 않습니다. 기존 쌍에서는 펼친 마스터 카드의 재초기화 입니다.
창(HQbird 2027.2.24 에서 새 쌍의 제목은 “데이터베이스를 초기화할까요?”. RCM 2027.5.7 에서는 “데이터베이스를 재초기화할까요?“이며 첫 초기화에서도 같습니다):
레플리카 폴더 를 확인합니다. 창은 폴더가 있는지 보여 줍니다. 없으면 폴더 만들기 를 클릭합니다. 레플리카 노드가 만듭니다(4.3). 노드가 만들지 못하면 창은 레플리카 호스트용 명령을 보여 줍니다. HQbird 2027.2.24 에서는 노드 서비스가 쓸 수 없는 폴더도 보여 줍니다. 고치는 명령과 다시 확인 단추입니다.
재초기화 방법 을 고릅니다. 부드럽게(권장) 또는 표준(5.4). HQbird 2027.2.24 에서 마스터 아카이브에 아직 세그먼트가 없으면(보통 첫 초기화 전) 창은 힌트를 보여 줍니다. 바쁜 데이터베이스에서는 표준 이 더 빠릅니다.
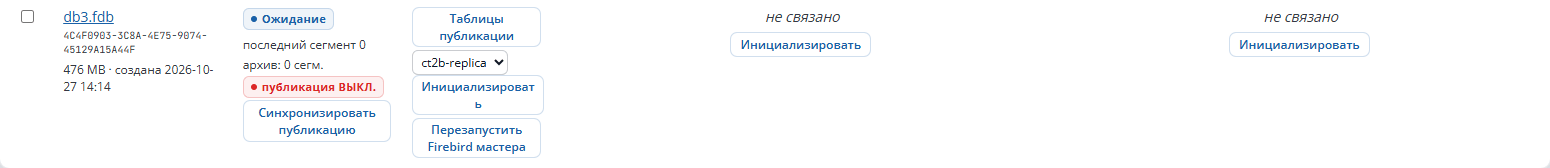
마스터 데이터베이스가 아직 Firebird 다시 시작을 기다리면 창이 그렇게 말하고 마스터 Firebird 다시 시작 단추를 보여 줍니다. 다시 시작이 없으면 데이터베이스는 복제되지 않습니다.
옛 레플리카 제거(HQbird 2027.2.24, 기본은 꺼짐)가 필요한 것은 레플리카 볼륨에 옛 복사본 옆의 새 복사본을 둘 공간이 없는 재초기화 때뿐입니다(4.4). 창은 숫자를 미리 보여 줍니다. 필요한 양, 여유, 옛 복사본이 차지하는 양. 옛 복사본을 빼면 공간이 있으면 창은 확인란을 켜라고 합니다. 마스터 또는 레플리카 노드가 옛 버전이면 확인란은 비활성입니다. 창은 업데이트할 노드를 말합니다. 새 복사본이 준비될 때까지 레플리카에는 이 데이터베이스의 복사본이 없습니다(4.4).
확인합니다. RCM 은 데이터베이스가 마스터에서 잠기고 레플리카로 복사된다고 말합니다.
초기화 진행은 데이터베이스 페이지의 펼친 마스터 카드에 보입니다. 단계와 백분율입니다. HQbird 2027.2.24 에서는 페이지를 새로 고친 뒤에도 진행이 보입니다. 첫 초기화에서는 레플리카 노드 칸에, 그리고 마스터 데이터베이스 페이지의 재초기화 진행 행에도 있습니다. 마스터 노드가 데이터베이스를 복사하는 동안 초기화 단추는 비활성입니다. RCM 이 이 초기화를 추적하지 않으면(예를 들어 노드 명령줄에서 시작) 단계는 노드 상태에서 가져오고 백분율은 없습니다. RCM 2027.5.7 에서는 페이지를 새로 고친 뒤 첫 초기화의 진행이 보이지 않습니다. 마스터 데이터베이스가 SEEDING 을 떠날 때까지 기다립니다.
마스터 행의 초기화 단계
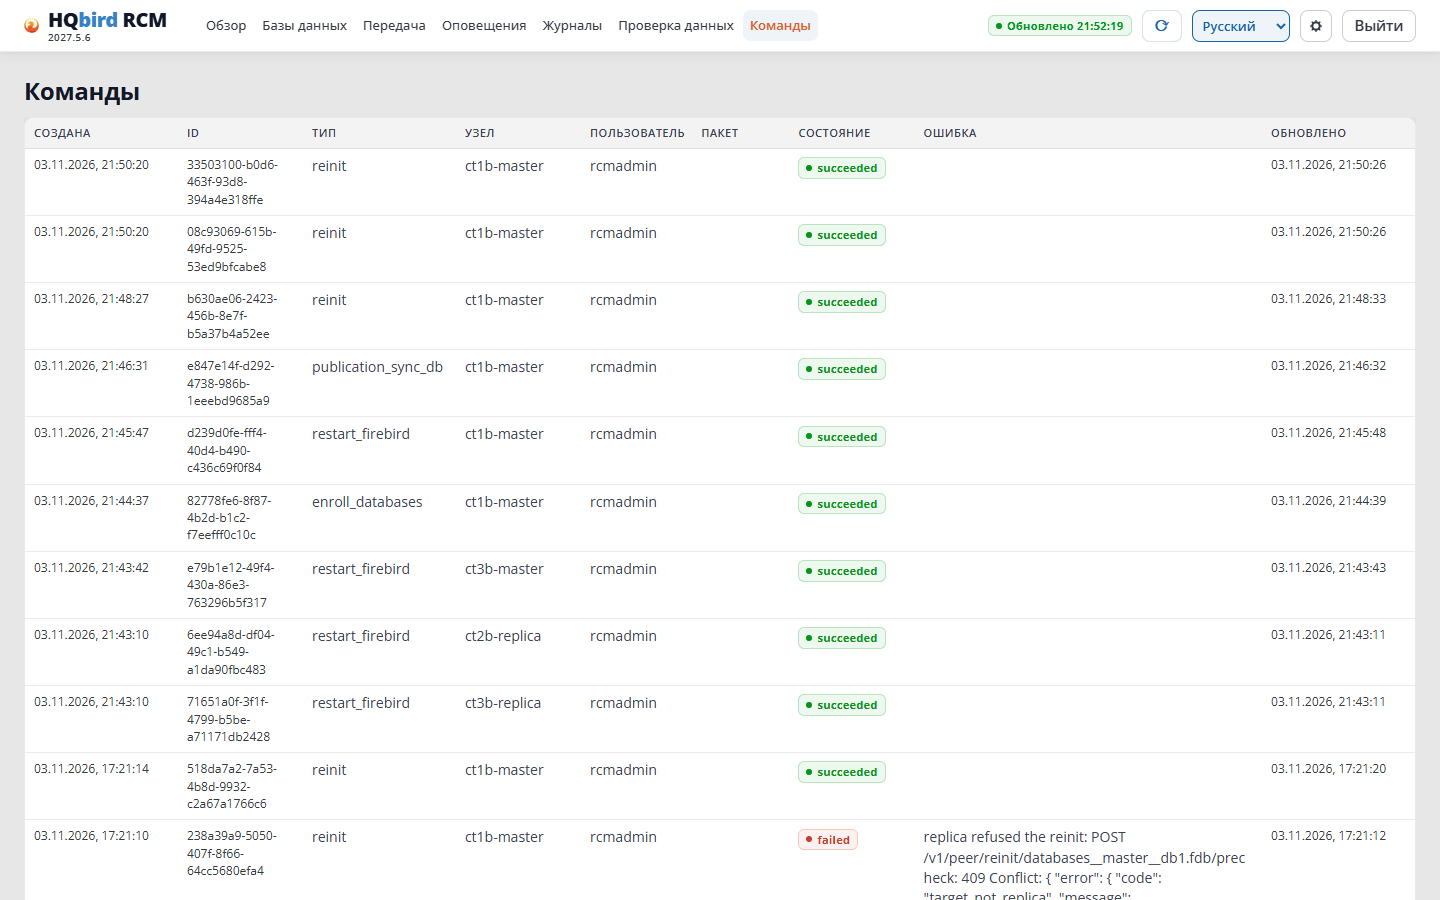
모든 RCM 명령(초기화, Firebird 다시 시작, 게시 동기화)은 결과와 함께 명령 페이지에 기록됩니다.
"명령" 페이지
명령줄에서도 같은 동작
Command
# one databasehqbirdrcm reinit -node node-a -db <db_id> -to node-b
# all master databaseshqbirdrcm reinit -node node-a -all -to node-b
-remove-old-replica(HQbird 2027.2.24)는 옛 레플리카 삭제 확인란과 같습니다. 데이터베이스 하나만입니다. -db 와 -to 가 필요합니다. -all 이면 명령은 거부합니다. 마스터 또는 레플리카 노드가 옛 버전이면 RCM 은 node_too_old 로 거부하고 아무것도 보내지 않습니다.
nbackup -L: 마스터 데이터베이스 파일이 얼고 변경은 <database>.delta 로 감
3
노드로 복사
파일이 부분으로 전송됨. 읽기 → 체크섬 → 압축 → 송신
4
잠금 해제
전송 직후 nbackup -N. .delta 의 변경이 데이터베이스로 돌아감
5
시드
레플리카에서: 파일 체크섬 검증, nbackup -FIXUP -SEQUENCE, 파일 설치, gfix -replica, replication.conf 에 블록 기록
6
레플리카 다시 시작
필요할 때 레플리카 Firebird 다시 시작(5.6)
6단계 뒤 데이터베이스는 IN_SYNC 상태가 됩니다. 마스터는 복사본이 끝나는 지점부터 세그먼트 송신을 계속합니다.
알아 둘 것:
마스터는 계속 실행됩니다. 사용자는 데이터베이스에 쓰고 변경은 .delta 로 갑니다. 잠금은 전송 직후 풀립니다.
잠금과 겹친 트랜잭션은 사라지지 않습니다. 노드는 nbackup -L 시점에 열려 있던 트랜잭션을 찾고, 레플리카는 세그먼트에서 그것을 재생합니다.
중단 뒤에도 전송은 계속됩니다. 연결이나 레플리카 노드가 다시 시작되면 마스터는 마지막으로 받은 부분부터 계속합니다. 끝나지 않은 전송은 레플리카에 24시간 보관됩니다(reinit_partial_keep_hours).
오류 시 노드는 잠금을 풀고, 레플리카의 끝나지 않은 파일을 삭제하고, 데이터베이스를 FAILED 로 둡니다. 다음 시도는 알려진 상태에서 시작합니다.
“옛 레플리카 삭제” 확인란(HQbird 2027.2.24 부터)에서는 레플리카가 잠금 단계 뒤, 전송 전에 옛 복사본을 삭제합니다. 이때 노드로 복사 단계는 “공간을 만들기 위해 옛 레플리카 복사본을 제거하는 중"을 보여 줍니다. 삭제 뒤의 오류는 쌍을 FAILED 가 아니라 NEEDS_REINIT 로 둡니다(4.4장).
nbackup 만. gbak 은 쓰지 않습니다. 데이터베이스 GUID 가 바뀌기 때문입니다.
5.3. 운영에 미치는 영향
대상
영향
마스터 사용자
계속 작업. 복사 중 .delta 가 자라고, -N 뒤 변경이 데이터베이스로 옮겨짐
이 데이터베이스의 다른 레플리카
초기화 동안 이 데이터베이스의 세그먼트를 받지 않음. 뒤에 따라잡음
마스터의 다른 데이터베이스
영향 없음
레플리카 Firebird, 새 데이터베이스
멈추지 않음. 다시 시작은 5.6 대로
레플리카 Firebird, 재초기화
파일을 바꾸는 동안 멈춤. 이 Firebird 의 모든 데이터베이스가 몇 초 동안 사용할 수 없음
전송 전, 삭제 동안 더 일찍 멈춤. replication.conf 의 데이터베이스 블록이 바뀌지 않았으면 노드는 두 번째 중지 없이 새 복사본을 설치. 공간이 충분해 삭제가 필요 없으면 노드는 아무것도 삭제하지 않고 보통의 재초기화처럼 진행
네트워크와 디스크
속도 한도에 따른 부하(5.5)
Windows 에서. Firebird 가 연 파일은 바꿀 수 없습니다. 재초기화 동안 노드는 fbagent 를 통해 레플리카 Firebird 를 멈추고, 파일을 설치하고, Firebird 를 다시 시작합니다. Linux 에서도 교체 전에 Firebird 가 멈춥니다. 그렇지 않으면 삭제된 옛 파일로 계속 동작하기 때문입니다.
5.4. 부드럽게와 표준
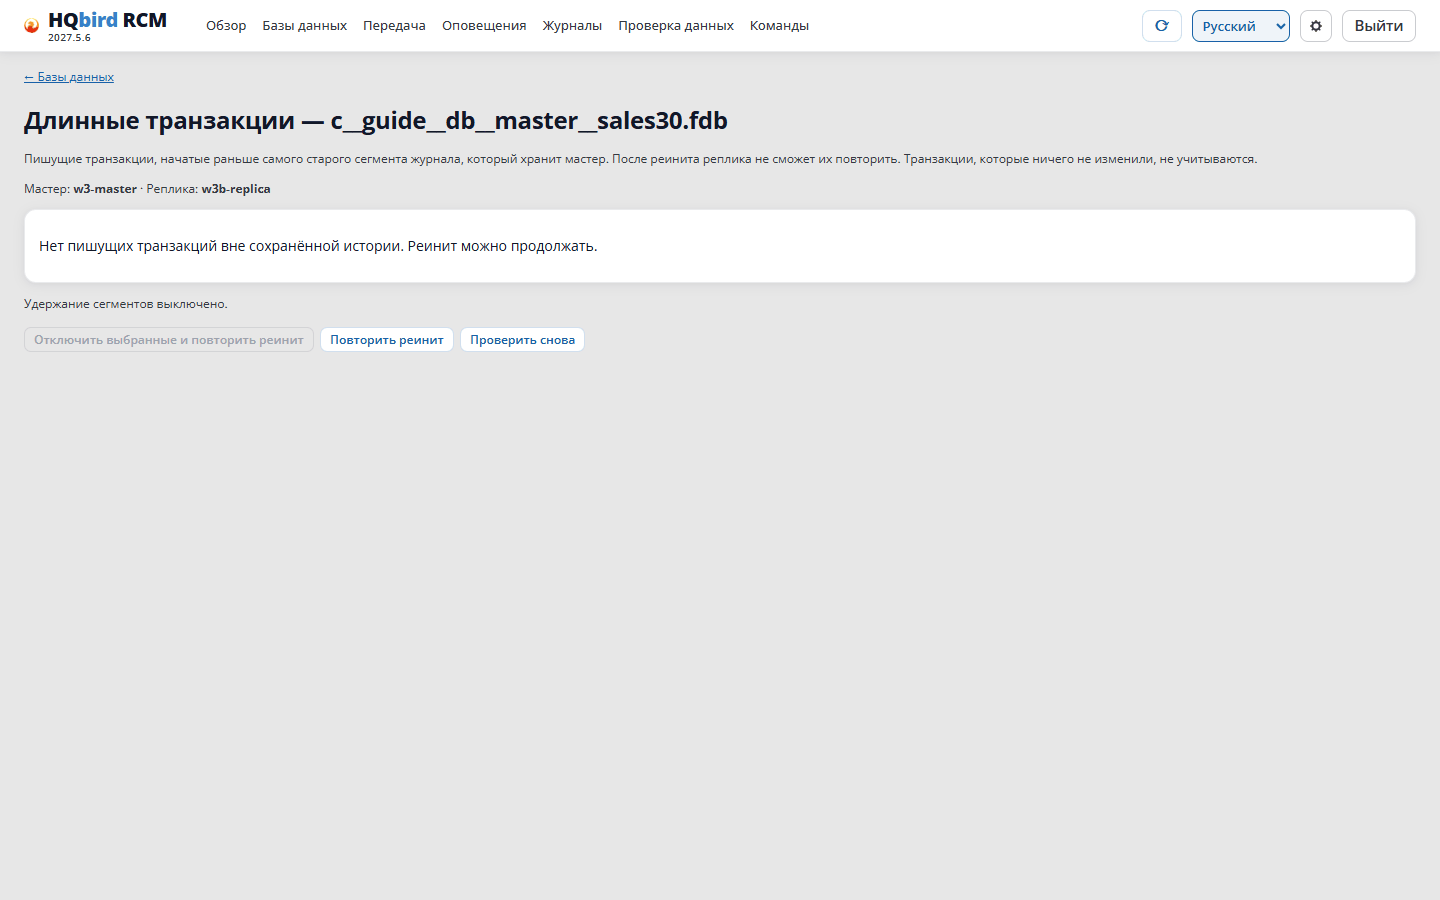
부드럽게(기본). 잠그기 전에 노드는 긴 트랜잭션 을 찾습니다. 마스터 아카이브에서 가장 오래된 세그먼트보다 먼저 시작된 사용자의 쓰기 트랜잭션입니다. 초기화 뒤 레플리카는 그것을 재생할 수 없고 첫 변경에서 멈춥니다(“트랜잭션 … 을 찾을 수 없습니다”). 변경이 없는 트랜잭션은 세지 않습니다.
그런 트랜잭션이 있으면 초기화는 시작하지 않습니다. RCM 은 부드러운 재초기화가 긴 트랜잭션을 기다리는 중 을 표시하고 목록 열기 링크를 줍니다.
긴 트랜잭션 페이지: 긴 트랜잭션 없음
긴 트랜잭션 페이지:
요약: 트랜잭션과 연결 수, 가장 오래된 세그먼트.
가장 오래된 트랜잭션을 가진 상위 5개 연결: 사용자, 클라이언트, 시작, 나이, 변경, 현재 쿼리.
세그먼트 유지 / 유지 해제 — 유지가 켜져 있는 동안 마스터 아카이브는 정리되지 않고 이력은 잘리지 않습니다.
선택한 연결을 끊고 재초기화 재시도 — 연결을 끊고(그 트랜잭션은 롤백됨) 즉시 부드러운 재초기화를 시작합니다.
재초기화 재시도, 다시 확인.
긴 트랜잭션 때문에 재초기화가 거부되면 유지는 자동으로 켜집니다. 성공한 초기화 뒤, 수동으로, 또는 아카이브가 reinit_hold_max_segments(기본 1000 세그먼트, 알림 retention_hold_released)까지 자라면 해제됩니다.
표준 은 확인 없이 즉시 데이터베이스를 잠급니다. 긴 쓰기 트랜잭션이 없다고 알 때만 씁니다.
부하가 있는 첫 초기화. 마스터 아카이브가 비어 있는 동안에는 비교할 세그먼트가 없습니다.
HQbird 2027.2.24 마스터 노드: 노드가 직접 게시를 켰고 그 뒤 아카이브가 바뀌지 않았으면 이력은 게시가 켜진 순간부터 시작합니다. 그보다 뒤에 시작된 트랜잭션은 첫 변경부터 저널에 들어가 부드러운 방법을 방해하지 않습니다. 그보다 먼저 시작된 트랜잭션은 저널에 들어가지 않습니다. 재초기화는 잠그기 전에 그것을 기다립니다(10초마다 6번). locking 단계는 그 번호, 연결, 사용자를 보여 줍니다. 끝나지 않았으면 재초기화는 오류 reinit_pre_publication_transactions 로 끝납니다. 그것을 끝내고 재시도합니다. 긴 트랜잭션 페이지는 그런 트랜잭션을 게시가 켜지기 전에 시작된 트랜잭션 표에 보여 줍니다.
게시가 노드를 통하지 않고 수동으로 켜졌거나 아카이브가 이미 바뀌었으면 이력의 시작을 알 수 없습니다. 그때 쓰기 트랜잭션이 하나라도 열려 있으면 부드러운 방법은 거부하고, 메시지는 아카이브에 아직 세그먼트가 없다고 말합니다. 이 경우 RCM 2027.2.24 는 목록을 열지 않고 데이터베이스 칸에 할 일을 씁니다. 표준 을 고르거나 Firebird 가 첫 세그먼트를 보관한 뒤 재시도합니다.
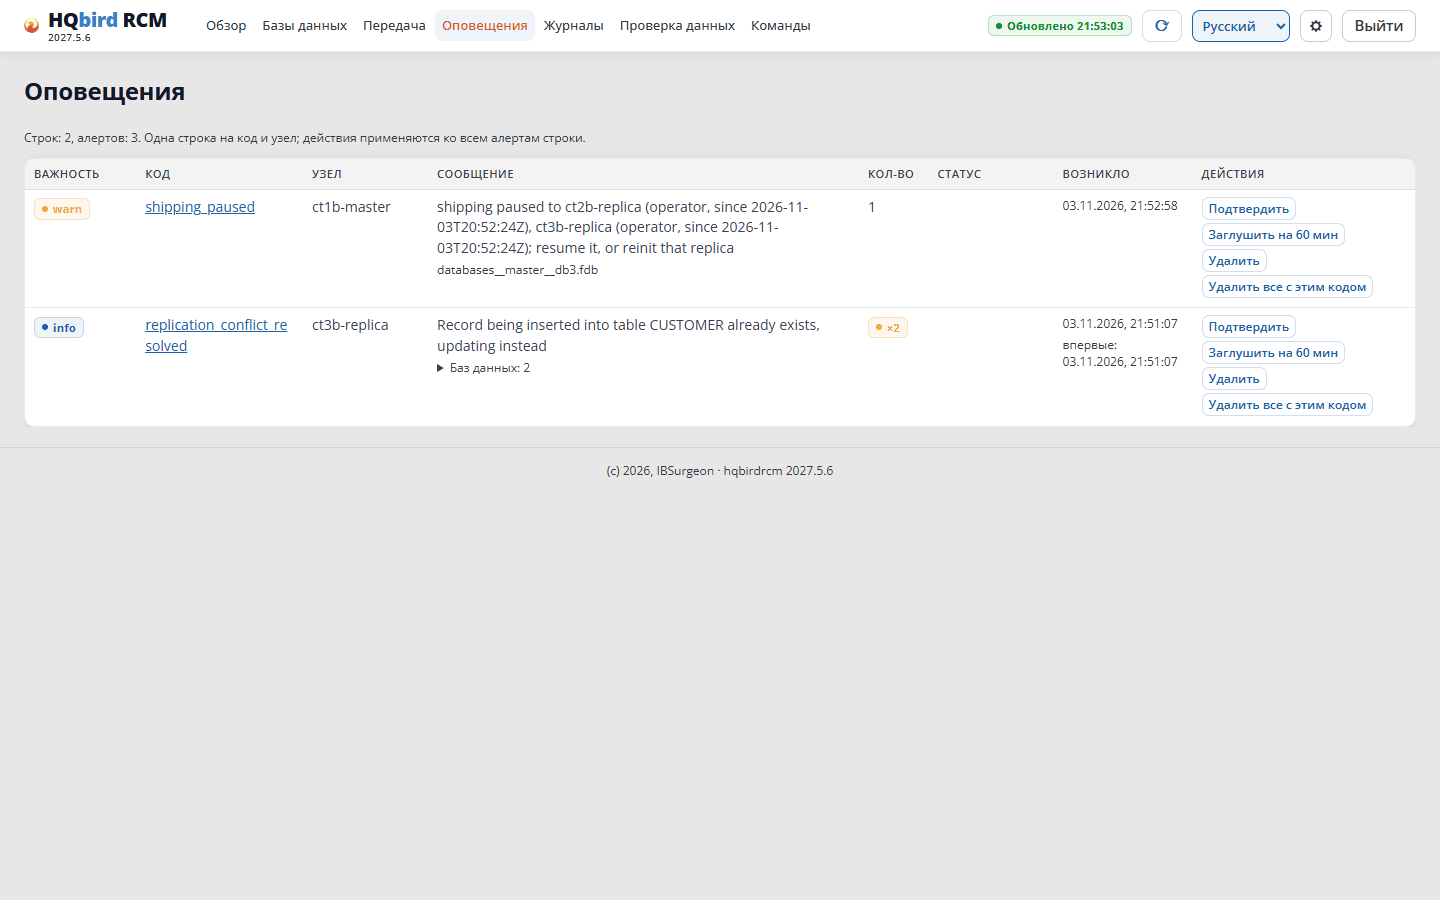
2027.5.7 마스터 노드에서는 지금 쓰기가 일어나는 데이터베이스의 첫 초기화에서 부드러운 방법이 즉시 거부합니다. long_transactions … segment 0 (0001-01-01T00:00:00Z). 그런 데이터베이스의 첫 초기화에는 표준 을 고릅니다.
게시보다 오래된 트랜잭션. Firebird 는 게시가 켜지기 전에 시작된 트랜잭션을 세그먼트에 쓰지 않습니다. 노드가 게시를 켰으면 초기화는 그런 트랜잭션이 끝날 때까지 기다립니다(10초마다 6번). 그렇지 않으면 오류 reinit_pre_publication_transactions 로 그것들을 나열하고 끝납니다. 테이블을 추가한 게시를 동기화한 뒤 응용 프로그램을 다시 연결하고, 그다음 초기화를 시작합니다.
초기화 시간 ≈ 데이터베이스 크기 ÷ 속도. 예: 100 GB 를 100 MB/s 로 — 순수 전송은 약 17분. 실제로는 네트워크나 디스크가 한계입니다.
5.6. 레플리카 Firebird 다시 시작
레플리카의 새 데이터베이스. 파일은 Firebird 를 멈추지 않고 놓입니다. Firebird 가 새 replication.conf 블록을 읽는 것은 다시 시작 뒤뿐입니다. 그때까지 레플리카는 아무것도 적용하지 않습니다. 레플리카 다시 시작 단계는 대기를 보여 줍니다.
표시
의미
레플리카의 Firebird 다시 시작을 기다리는 중. 예정은 …
다른 초기화가 끝난 뒤 노드는 마지막 초기화 뒤에 스스로 Firebird 를 다시 시작(reinit_restart_delay_sec)
… 다시 시작 창이 닫혀 있음. 다음이 열리는 시각은 …
레플리카의 restart_window 를 기다리는 중
… 마지막 시도가 실패. 다음은 …
나중에 재시도
레플리카는 Firebird 를 스스로 다시 시작할 수 없음. 수동으로 다시 시작
auto_restart: never, 또는 이 Firebird 가 마스터 데이터베이스도 제공
노드는 일련의 초기화 뒤에 Firebird 를 한 번 다시 시작합니다. 데이터베이스마다 하지 않습니다.
수동으로 다시 시작하려면 레플리카 Firebird 다시 시작 을 클릭합니다. 대기는 Firebird 다시 시작이 성공한 뒤, 또는 레플리카가 복사본보다 새로운 세그먼트를 적용하면 끝납니다.
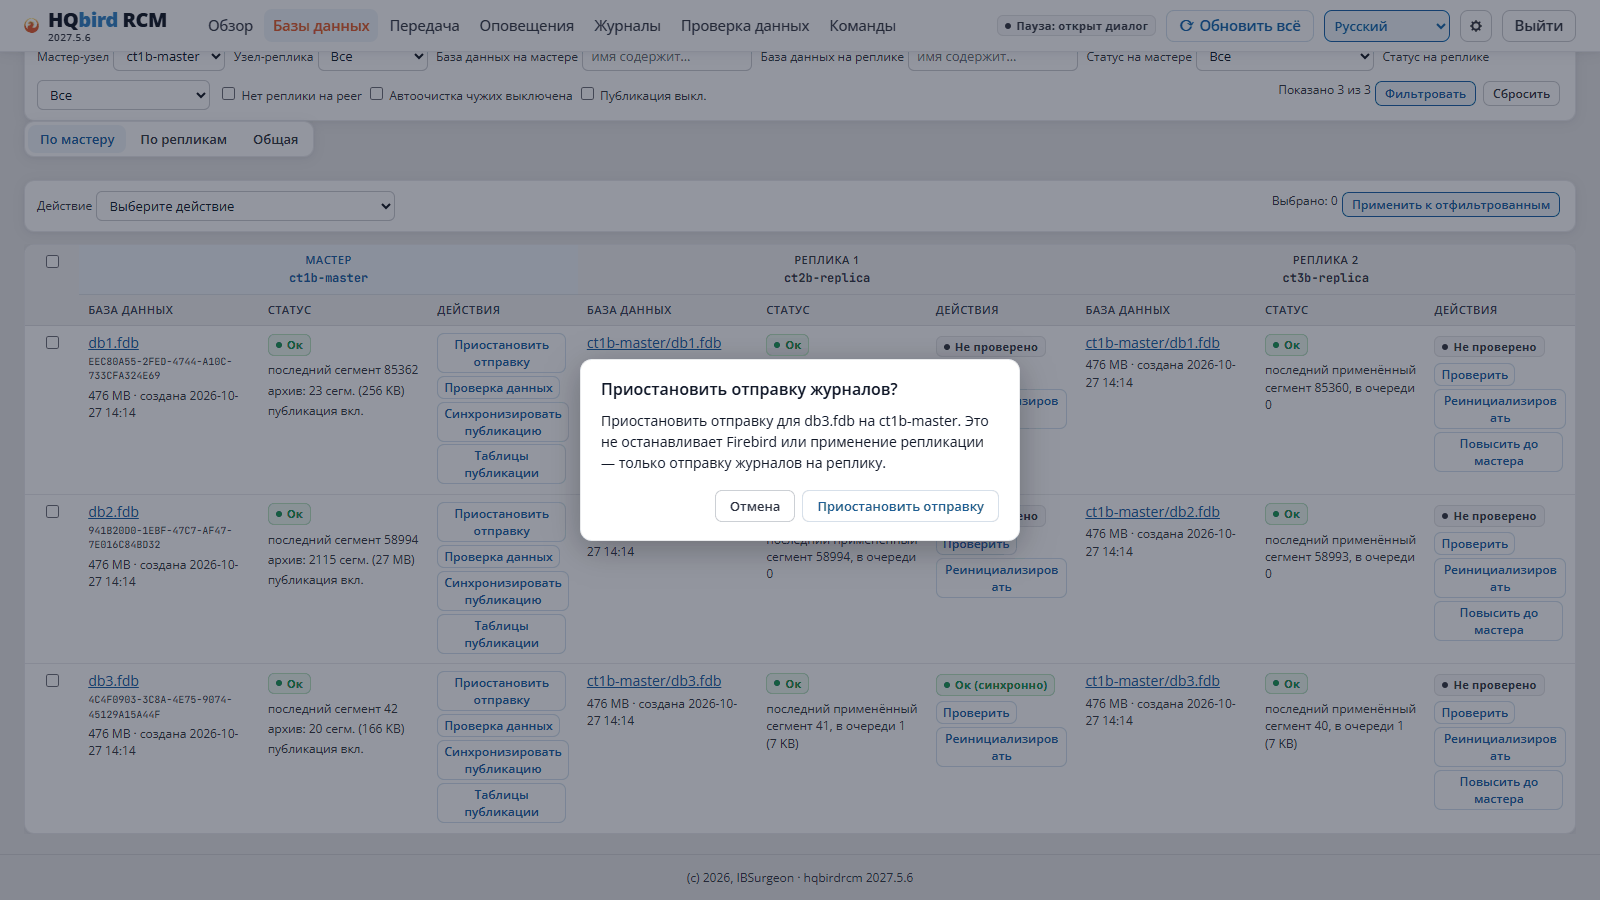
마스터 데이터베이스도 제공하는 Firebird 에서의 재초기화. 노드는 그런 Firebird 를 스스로 멈추지 않고 restart_not_allowed 로 거부합니다. 초기화를 다시 시작하고 이 재초기화를 위해 가 Firebird 를 멈추도록 허용 을 켭니다(명령줄에서는 -allow-restart). 이 Firebird 의 연결을 끊어도 되는 시각에 합니다. 마스터 데이터베이스 연결도 포함됩니다. 그런 초기화는 호스트당 한 번에 하나입니다.
옛 복사본 삭제(옛 레플리카 제거 확인란, HQbird 2027.2.24)도 같은 규칙으로 레플리카 Firebird 를 멈춥니다. 노드가 이 Firebird 를 스스로 멈추지 못하면 아무것도 삭제하지 않고 restart_not_allowed 로 거부합니다. 마찬가지로 이 재초기화를 위해 가 Firebird 를 멈추도록 허용 을 켭니다. 그때 레플리카에서 다른 초기화가 끝나거나 Firebird 가 다시 시작 중이면 노드는 아무것도 삭제하지 않고 engine_busy 로 거부합니다. 마스터는 잠금을 풉니다. 나중에 재시도합니다.
5.7. 큐와 동시 초기화
데이터베이스 하나의 초기화는 한 번에 하나입니다(서로 다른 레플리카여도). 이 데이터베이스의 초기화가 진행 중이면 초기화 단추는 비활성입니다.
마스터 노드는 서로 다른 데이터베이스의 초기화를 limits.max_concurrent_reinits 개 동시에 실행합니다(기본 1). 나머지는 큐에서 기다립니다. 응답에는 큐 위치가 들어 있습니다.
초기화 중인 데이터베이스에 직접 nbackup -L(또는 ALTER DATABASE BEGIN BACKUP)을 실행하지 말고, 그런 백업 중에 초기화를 시작하지 마십시오. 데이터베이스 잠금은 하나만 가능합니다. 초기화는 이것을 확인하고 nbackup backup lock already active 로 거부합니다.
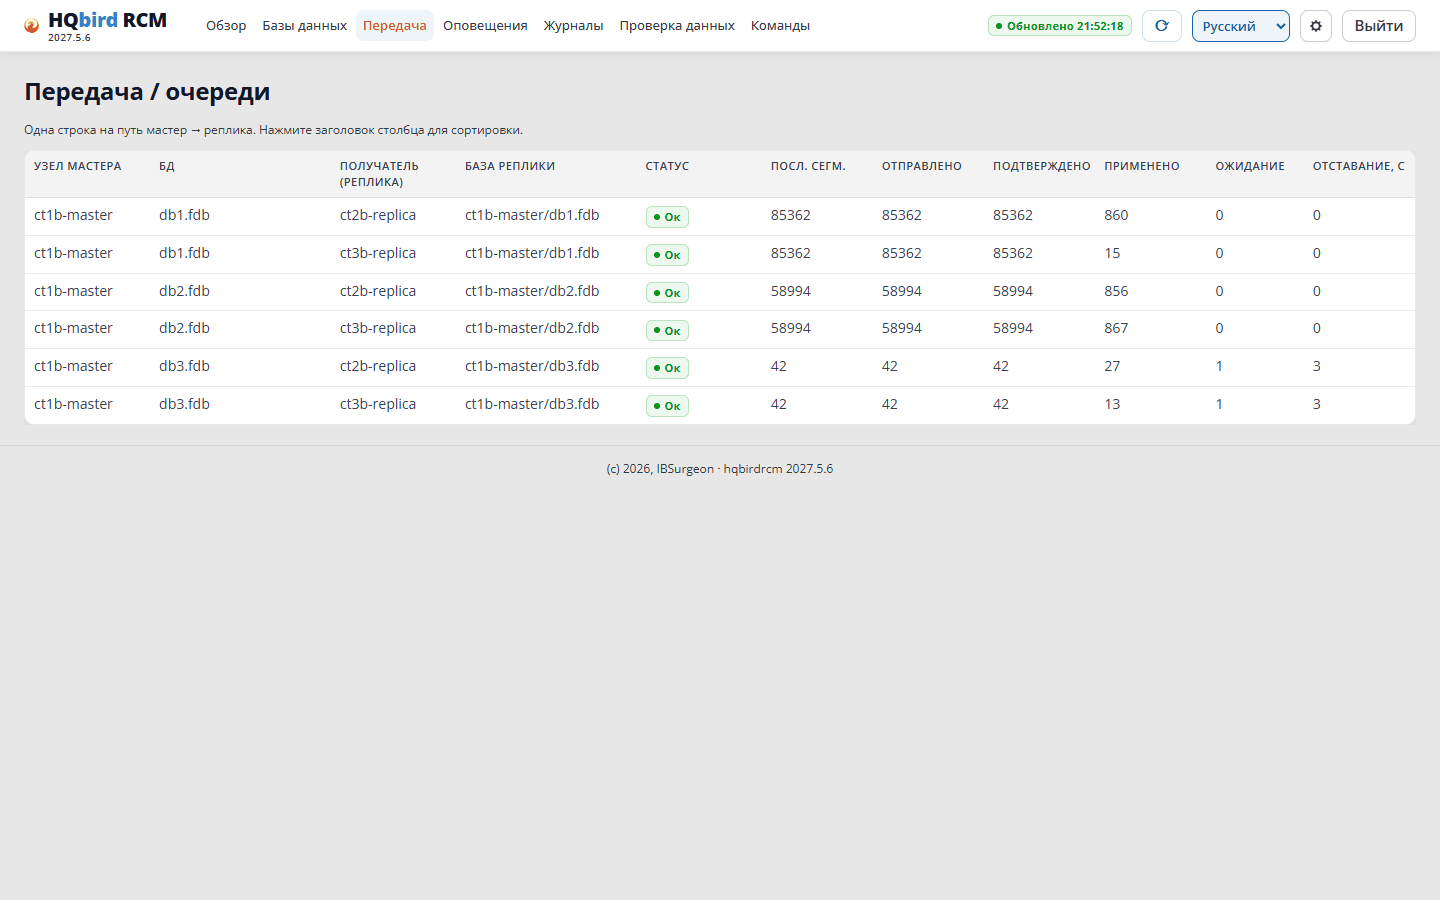
큐와 현재 전송은 전송 페이지에서 보입니다.
전송 / 큐 페이지
- 실패 뒤 `.delta` 파일이 남아 있으면 백업이 실행 중이 아닌지 확인하고 `nbackup -N ` 를 실행합니다. `.delta` 를 손으로 삭제하지 마십시오.
5.8. 자동 재초기화
RCM 은 NEEDS_REINIT 상태의 데이터베이스를 구성된 창 안에서만 스스로 재초기화할 수 있습니다. 기본적으로 꺼져 있습니다.
데이터베이스가 NEEDS_REINIT 에 들어갈 때:
원인
보이는 곳
복구할 수 없는 적용 오류가 반복(PK, UNIQUE, FK 위반) — 연속 3번
레플리카, 경보 replication_unrecoverable_error
마스터 데이터베이스 GUID 가 바뀜(복원, 파일 교체)
레플리카, 경보 replication_guid_mismatch
마스터 아카이브에 레플리카가 필요한 세그먼트가 더 이상 없음
마스터
레플리카가 초기화를 위해 옛 복사본을 삭제했고 새 복사본이 아직 없음(HQbird 2027.2.24 부터)
max_concurrent — RCM 이 다음 자동 초기화를 시작하려면 클러스터에서 실행 중이어도 되는 초기화(수동과 자동) 수.
자동 초기화는 수동 초기화와 같은 공간·GUID 확인을 거칩니다. 명령 작성자는 system:autoreinit 입니다.
remove_old_replica_when_short(HQbird 2027.2.24 부터, 공간이 부족할 때 옛 레플리카 삭제 행) — 기본적으로 꺼짐. 켜면 자동 초기화는 옛 레플리카 삭제 플래그를 보냅니다(4.4). RCM 이 보내는 것은 레플리카 자신이 NEEDS_REINIT 이거나 마스터의 NEEDS_REINIT 원인이 그것을 지목할 때뿐입니다. IN_SYNC 또는 LAGGING 레플리카에는 플래그를 절대 보내지 않습니다. 노드가 옛 버전이면 RCM 은 플래그 없이 같은 초기화를 시작합니다.
변경 뒤 RCM 을 다시 시작합니다.
마스터 카드의 일시 중지 는 데이터베이스 하나의 자동 초기화를 1시간, 4시간, 24시간, 또는 취소할 때까지 멈춥니다. 수동 초기화는 그대로 가능합니다.
5.9. 오류
오류
원인
할 일
insufficient disk space on master / on replica, 507
공간 부족. 재초기화 동안 옛 복사본이 끝까지 공간을 차지
4.4장. 레플리카(HQbird 2027.2.24 부터)는 옛 레플리카 제거 확인란(5.1)
target_not_replica. 복사본 자리에 동작 중인 데이터베이스가 있습니다. 일반으로 만들어졌거나(파일 <database>.hqcluster-normal.json 이 있음) 레플리카 모드가 아닙니다. 노드는 동작 중인 데이터베이스를 덮어쓰지 않습니다. 바꿔야 하면 노드 API 요청에 overwrite_non_replica: true(RCM 에는 이 단추가 없음)를 두면 파일이 바뀌고 옛 파일은 <database>.pre-reinit-<UTC time>.fdb 로 남습니다.
target_other_replica(HQbird 2027.2.24 부터). 레플리카는 복사본을 <databases.root>/<master id>/<database path> 에 둡니다. 마스터 ID 가 유일한 것은 자기 클러스터 안뿐이므로 데이터베이스 둘이 같은 경로가 될 수 있습니다. 레플리카 노드는 자신의 다른 데이터베이스에 속한 복사본을 덮어쓰지 않습니다. 오류는 그 데이터베이스와 그 마스터를 지목합니다. 노드는 경로 기록이 다른 복사본(경로의 심볼릭 링크나 정션, Windows 짧은 폴더 이름)도 알아봅니다. overwrite_non_replica 는 이 오류를 지우지 않습니다. 복사본 하나를 다른 폴더로 옮기거나 그 데이터베이스를 레플리카에서 제거하고 초기화를 다시 시작합니다. 노드가 보는 것은 자기 데이터베이스뿐입니다. 같은 호스트의 레플리카 노드 둘은 서로 다른 레플리카 폴더(databases.root)를 가져야 합니다.
5.10. 결과를 확인하는 방법
데이터베이스: 그룹 안의 마스터–레플리카 쌍이 정상, 상태 IN_SYNC.
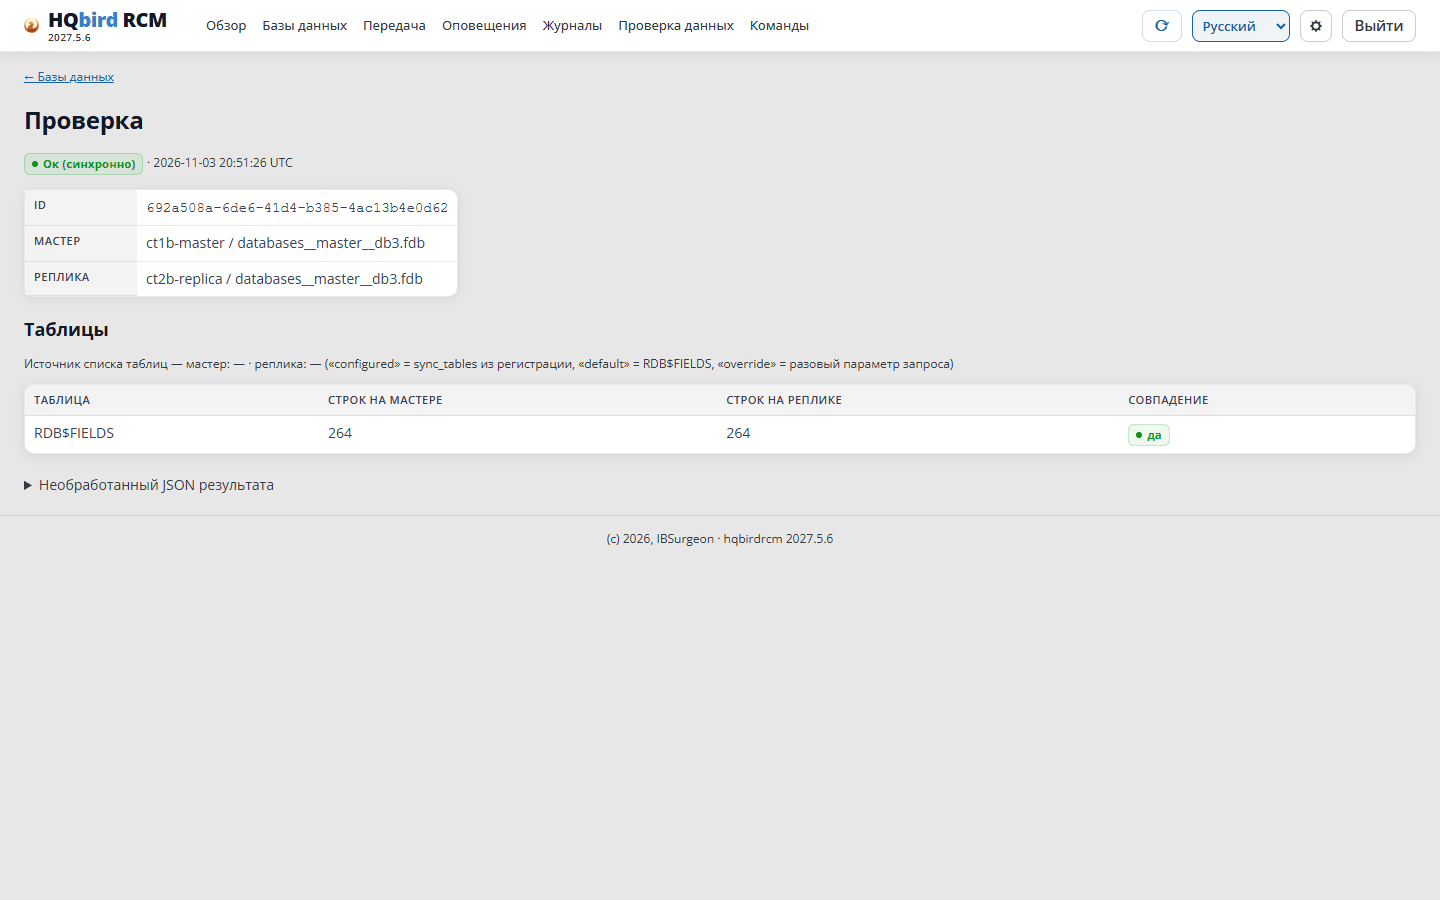
마스터 카드의 검증: 노드는 데이터베이스 테이블 목록(3.1장)의 테이블 행 수를 마스터와 레플리카에서 세어 비교합니다. 조용한 시간에 확인합니다. 쓰기가 활발하면 숫자가 다를 수 있습니다.
HQbird 2027.2.24 에서 결과 페이지는 각 쪽의 목록을 지목합니다(예를 들어 “이 데이터베이스 자신의 목록” 또는 “게시 테이블(목록 미설정)”). RCM 은 마스터 목록으로 레플리카를 셉니다. 양쪽 데이터베이스에 없는 테이블은 “데이터베이스에 없음"으로 표시되고 오류로 세지 않습니다. 비교된 테이블이 없으면 결과는 “비교할 테이블이 없습니다"이며 불일치가 아닙니다. 주어진 시간 안에 비교가 끝나지 않으면 결과는 “비교하지 않음(시간 제한)“이며 이것도 불일치가 아닙니다.
정기 확인(선택): 데이터 확인 페이지, 모든 노드에서 켜기. HQbird 2027.2.24 에서 노드는 설정을 즉시 적용하며 노드 서비스 다시 시작은 필요 없습니다. 저장 뒤 RCM 은 “저장되었고 이미 적용됨"이라고 씁니다. 노드 2027.5.7 은 hqclusternode 서비스 다시 시작이 필요하고 RCM 2027.2.24 가 그렇게 말합니다. 노드는 마스터와 레플리카가 같은 세그먼트에 있을 때 스스로 행 수를 비교합니다. 불일치는 경보 data_mismatch 를 일으킵니다. 그다음 검증 을 실행합니다.
운영자가 게시에서 뺀 테이블은 “게시되지 않음"으로 표시되고 불일치로 표시되지 않습니다.
6. 게시 구성
게시는 Firebird 마스터에 어느 테이블의 변경을 세그먼트에 쓸지 알려 줍니다. 이것이 없으면 레플리카는 아무것도 받지 못합니다.
6.1. 게시란
Firebird 4 와 5 에서 복제할 테이블은 RDB$DEFAULT 게시로 정의됩니다.
게시 켜짐 — RDB$PUBLICATIONS 에서 RDB$ACTIVE_FLAG = 1(명령 ALTER DATABASE ENABLE PUBLICATION).
게시된 테이블 — RDB$PUBLICATION_TABLES 의 목록.
Firebird 가 세그먼트에 변경을 쓰는 것은 게시된 테이블에 대해, 게시가 켜져 있을 때뿐입니다. 데이터베이스 등록(3장)은 게시를 켜지 않습니다. 켜는 것은 게시 동기화(6.2)입니다.
마스터 노드는 게시를 한 시간마다 확인합니다(limits.publication_check_interval_sec, 기본 3600). 꺼져 있으면 노드는 2분마다 확인합니다.
데이터베이스 페이지에서 마스터 데이터베이스에는 아이콘이 있습니다.
아이콘
의미
게시 켜짐
게시가 켜짐
게시 꺼짐
Firebird 는 세그먼트에 아무것도 쓰지 않고 레플리카는 변경을 받지 못함
게시 알 수 없음
노드가 상태를 읽지 못함
게시 꺼짐 필터는 꺼졌거나 알 수 없는 게시의 데이터베이스를 보여 줍니다.
꺼진 게시의 데이터베이스에 이미 레플리카가 있으면 마스터는 경보 master_publication_off 를 냅니다.
HQbird 2027.2.24 에서 마스터는 오류 publication_off 로 데이터베이스 초기화를 거부했을 때도 이 경보를 냅니다(5.1장). 게시가 꺼져 있거나 키가 있는 테이블이 없을 때입니다. 경보 수준:
경고 — 데이터베이스에 아직 레플리카가 없음. 초기화가 게시를 기다리는 중.
심각 — 데이터베이스에 이미 레플리카가 있음.
정보 — 운영자가 게시를 끔.
경보는 게시가 고쳐지거나 다른 초기화가 시작되면 사라집니다.
6.2. 게시 동기화
마스터 행: 게시 꺼짐
클릭하는 곳:
데이터베이스 페이지의 마스터 데이터베이스 행. 게시가 꺼져 있으면 단추는 아이콘 옆에 있습니다.
데이터베이스 페이지.
여러 데이터베이스: 행을 선택하고 동작 목록에서 게시 동기화 를 고릅니다. RCM 은 데이터베이스마다 별도 명령을 보냅니다.
게시 동기화 확인
노드가 하는 일(단일 트랜잭션):
게시를 켭니다. 운영자가 직접 껐으면(6.4) 켜지 않습니다.
아직 없는 키가 있는 테이블 을 모두 게시에 추가합니다.
키가 없는 테이블과 운영자가 제외한 테이블(6.3)을 게시에서 뺍니다.
새 테이블의 자동 추가를 끕니다(EXCLUDE ALL FROM PUBLICATION, 그다음 필요한 테이블을 추가). 게시 구성을 정하는 것은 노드뿐입니다.
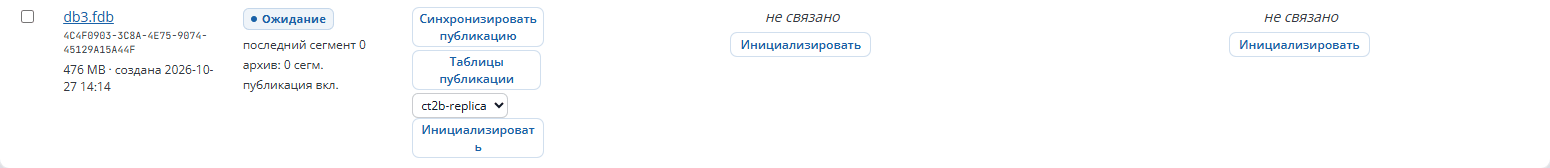
동기화 뒤 마스터 행: 게시 켜짐
키가 있는 테이블 — 기본 키 또는 활성 고유 인덱스가 있는 사용자의 영구 테이블. 시스템 테이블과 임시 테이블은 게시되지 않습니다.
동기화는 DBA 가 손으로 추가한 키가 없는 테이블도 게시에서 뺍니다.
구성이 이미 맞으면 노드는 아무것도 바꾸지 않습니다.
노드가 거부할 때:
코드
이유
no_publications
HQbird 2.5/3.0(6.6)
not_master
노드가 마스터가 아님
reinit_in_progress
이 데이터베이스의 초기화가 진행 중
orphaned, database_failed, file_missing
데이터베이스가 스캔 밖이거나, 오류 중이거나, 파일이 없음
노드의 모든 데이터베이스를 한 번에 — 명령줄에서만. 명령 페이지에서 결과는 데이터베이스마다 완료, 건너뜀 또는 오류 로 표시됩니다. FAILED 또는 SEEDING 상태의 데이터베이스와 파일이 없는 데이터베이스는 건너뜁니다.
명령줄에서도 같은 동작
Command
hqbirdrcm setpublication -node node-a -db <db_id> # one databasehqbirdrcm setpublication -node node-a # all node databases
명령은 최대 5분 기다리고 데이터베이스마다 한 줄을 출력합니다. 오류 시 종료 코드는 1입니다. -nowait — 결과를 기다리지 않습니다.
6.3. 게시 테이블
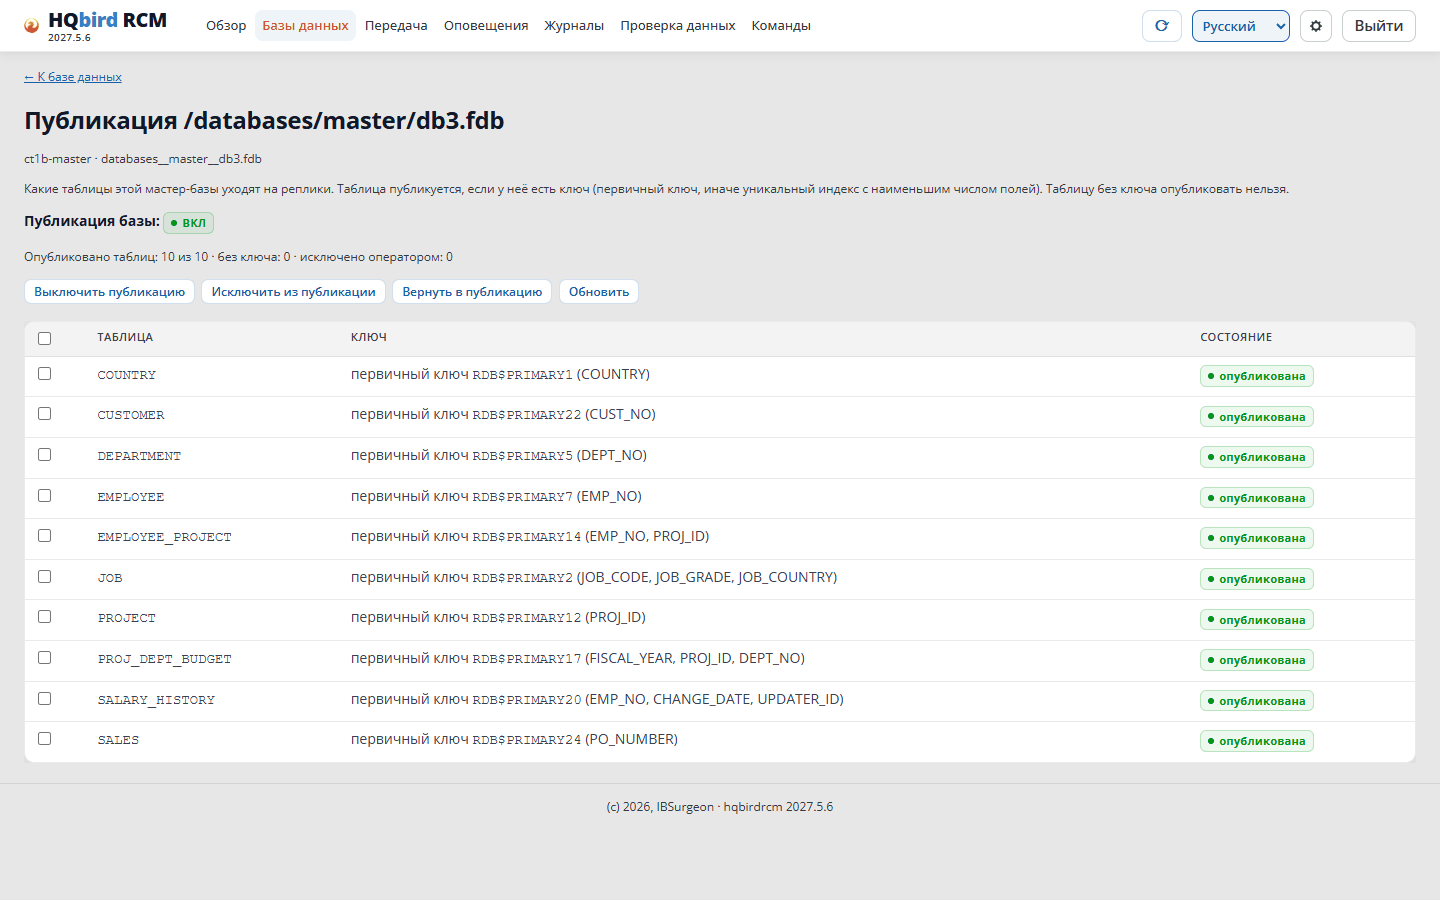
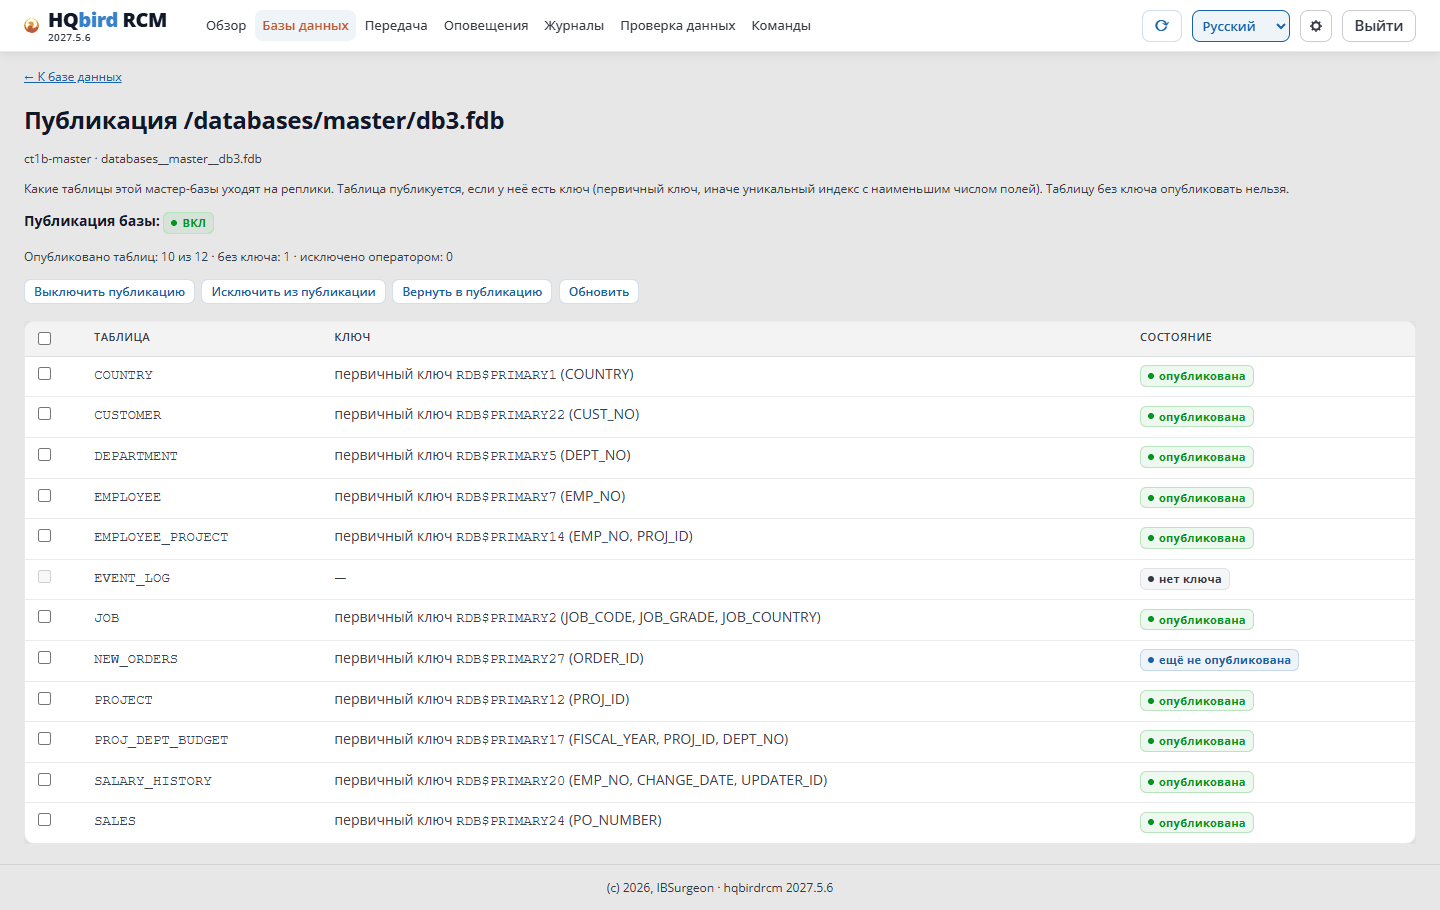
"게시 테이블" 페이지
마스터 데이터베이스 행에서 게시 테이블 을 엽니다.
페이지가 보여 주는 것:
게시 상태(켜짐/꺼짐, 운영자가 끔)와 카운터.
각 테이블: 이름, 키, 상태.
상태
의미
게시됨
변경이 세그먼트로 감
아직 게시되지 않음
키가 있는 테이블. 동기화 때 추가됨
제외
운영자가 게시에서 뺌
키 없음
게시할 수 없음
키 열에는 기본 키가, 없으면 필드 수가 가장 적은 고유 인덱스가 표시됩니다.
키가 없는 테이블을 게시할 수 없는 이유. 레플리카는 UPDATE 와 DELETE 의 행을 키로 찾습니다. 키가 없으면 행을 찾지 못합니다. 기본 키나 고유 인덱스를 추가한 뒤 게시를 동기화합니다.
게시에서 제외 / 게시로 되돌리기:
테이블을 선택합니다.
게시에서 제외 또는 게시로 되돌리기 를 클릭합니다.
노드는 목록을 저장하고 즉시 게시를 동기화합니다.
"게시에서 제외" 확인
제외 테이블 목록은 마스터 노드 에 저장됩니다. 동기화는 그것을 바꾸지 않습니다. 레플리카가 마스터로 승격하면(8장) 목록은 새 마스터로 옮겨집니다.
확인(5.10장)은 제외된 테이블을 “게시되지 않음"으로 보여 주고 불일치로는 보여 주지 않습니다.
6.4. 게시 켜기와 끄기
게시 테이블 페이지: 게시 끄기 / 게시 켜기.
끄기는 운영자의 선택입니다. 동기화는 게시를 다시 켜지 않습니다.
게시가 꺼져 있는 동안(또는 테이블이 제외된 동안) 이루어진 변경은 켠 뒤에도 레플리카로 보내지지 않습니다.
켠 뒤 확인 을 클릭합니다(5.10장). 데이터가 어긋나면 레플리카를 재초기화합니다(5장).
6.5. 새 테이블
새 테이블은 스스로 게시에 들어가지 않습니다. 노드가 자동 추가를 끄기 때문입니다.
DDL 뒤:
테이블에 기본 키나 고유 인덱스를 만듭니다.
게시 동기화 를 클릭합니다.
재초기화가 필요하면 응용 프로그램에 다시 연결하라고 합니다. Firebird 는 게시가 켜지기 전에 시작된 트랜잭션을 세그먼트에 쓰지 않습니다. COMMIT RETAINING 은 그런 트랜잭션을 열어 둡니다. 초기화는 그런 트랜잭션을 기다린 뒤 reinit_pre_publication_transactions 로 실패합니다(5.4장).
"아직 게시되지 않음" 상태의 새 테이블
동기화 전에 새 테이블에 쓴 행은 레플리카에 도달하지 않습니다. 있으면 데이터를 확인하고 필요하면 레플리카를 재초기화합니다.
6.6. HQbird 2.5 와 3.0
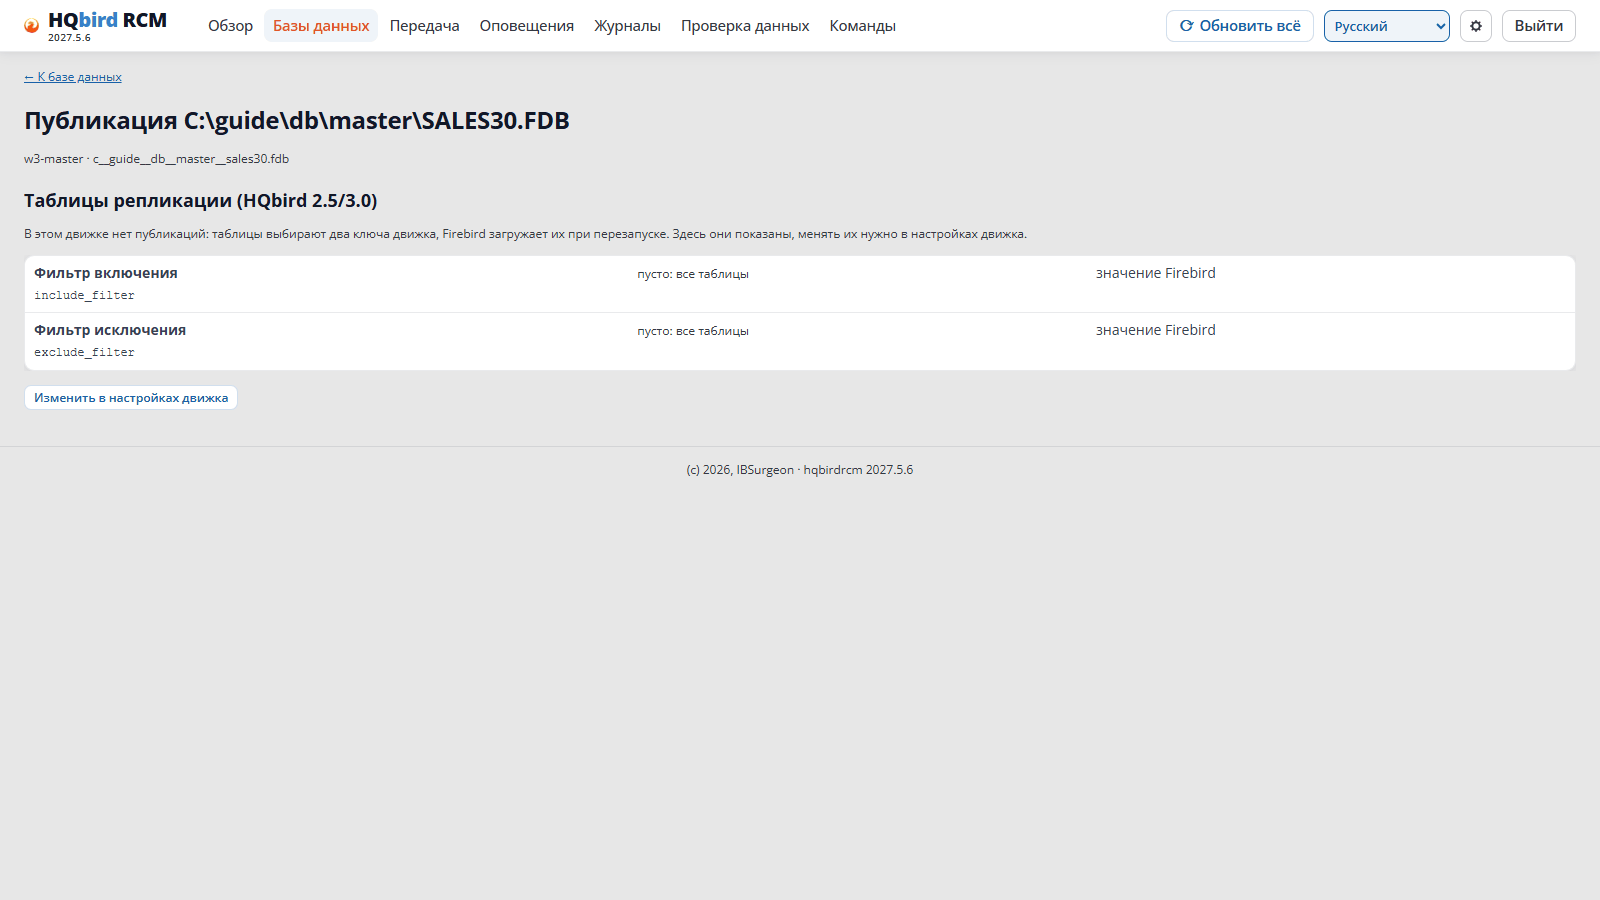
HQbird 2.5 와 3.0 에는 게시가 없습니다. replconf 플러그인 파일에 마스터 블록이 있으면 Firebird 는 세그먼트를 씁니다. 그런 노드에서는 게시 단추가 숨겨지고 API 는 no_publications 로 응답합니다.
테이블 집합 은 엔진 매개변수로 정의됩니다.
매개변수
의미
include_filter
복제할 테이블. 이름이나 패턴을 쉼표로 구분. 비어 있으면 모두
exclude_filter
복제하지 않을 테이블
매개변수는 설정 → 복제 매개변수 에서 바꿉니다(7.1장). 게시 테이블 페이지는 그것을 읽기 전용으로 보여주고 엔진 설정에서 변경 링크를 줍니다. Firebird 는 다시 시작 뒤 새 값을 읽습니다.
HQbird 3.0 의 게시 테이블: 엔진 필터
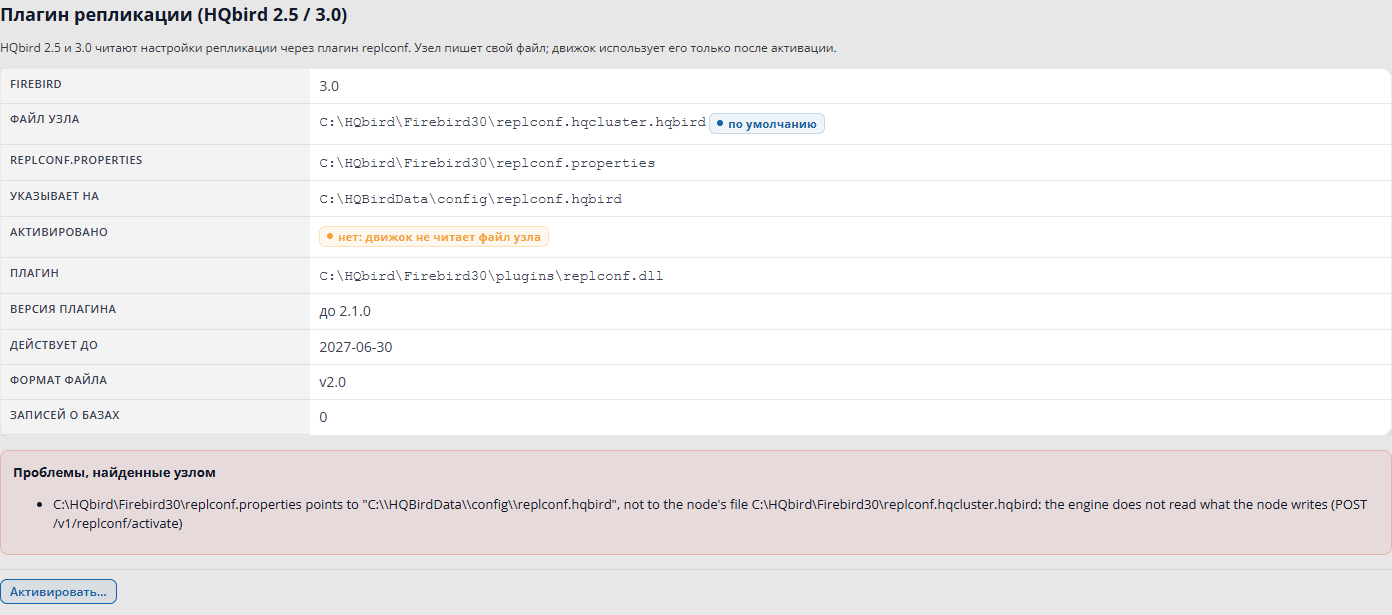
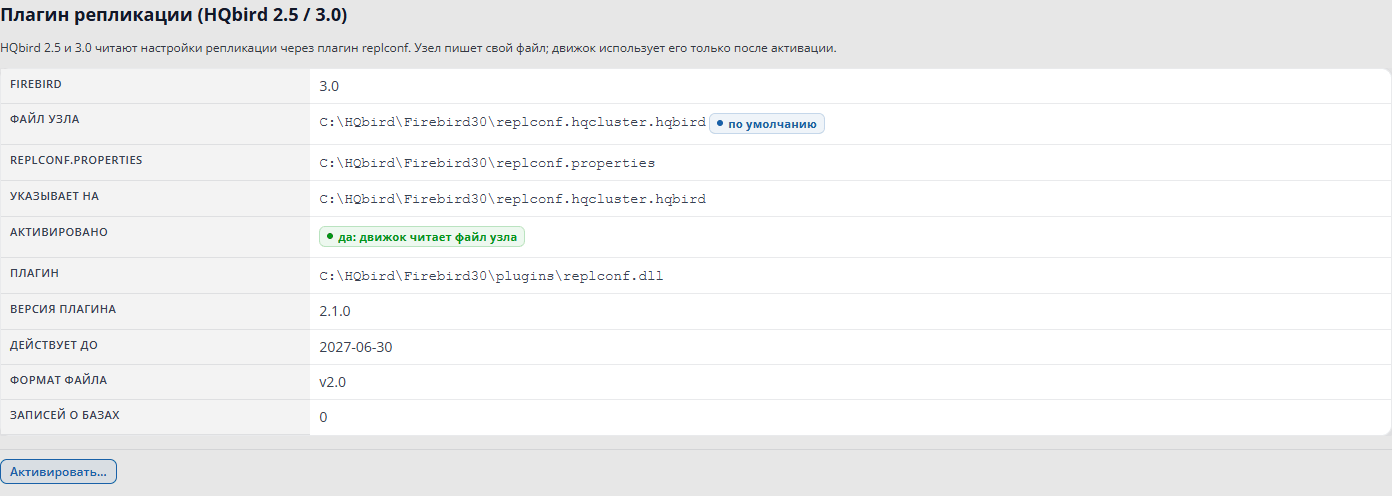
replconf 플러그인. 노드는 Firebird 폴더에 자기 replconf.hqcluster.hqbird 파일을 씁니다. Firebird 가 그것을 읽는 것은 replconf.properties 가 그것을 가리킬 때뿐입니다. 플러그인은 한 번 활성화해야 합니다.
설정 → 노드, 복제 플러그인(HQbird 2.5 / 3.0) 블록. 블록은 replconf.properties 가 가리키는 곳과 노드가 찾은 문제를 보여 줍니다.
플러그인 미활성화: replconf.properties 가 HQbird DataGuard 파일을 가리킴
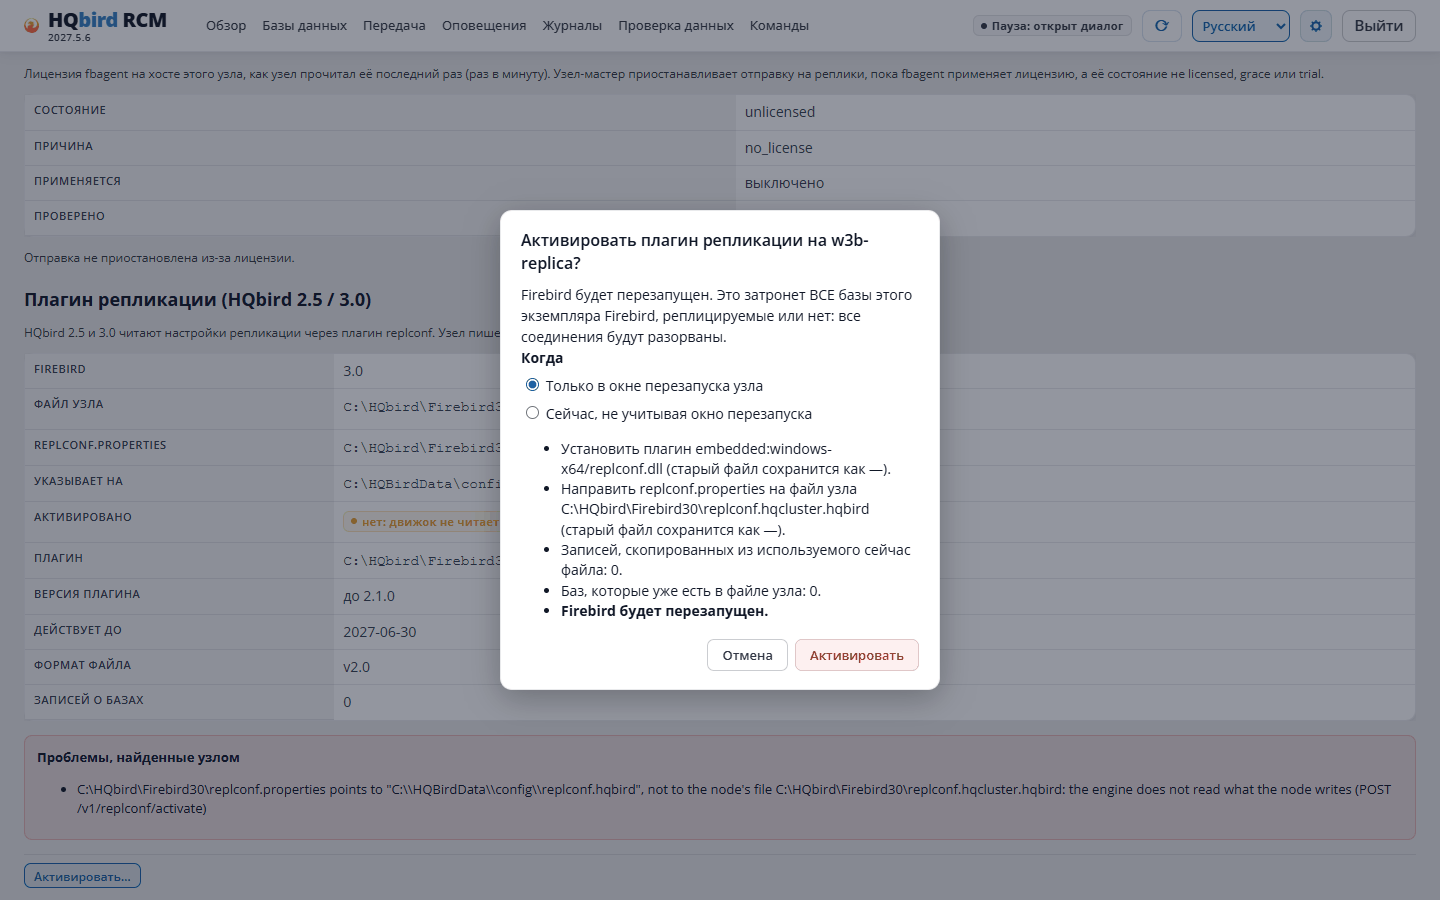
활성화… 창은 노드가 할 일을 나열합니다. 플러그인 설치, replconf.properties 를 노드 파일로 향하게 함, 옛 파일 항목 이전. 언제 할지 고릅니다. 노드 다시 시작 창 안에서만, 또는 지금, 다시 시작 창 무시.
플러그인 활성화 창
Firebird 다시 시작 뒤 활성화됨 필드는 “예: 엔진이 노드 파일을 읽습니다"를 보여 줍니다.
플러그인이 활성화됨
활성화는 Firebird 를 다시 시작하고 이 Firebird 의 모든 데이터베이스 에 영향을 줍니다. 조용한 시간에 합니다.
7. 그 밖의 복제 옵션
7.1. 복제 매개변수
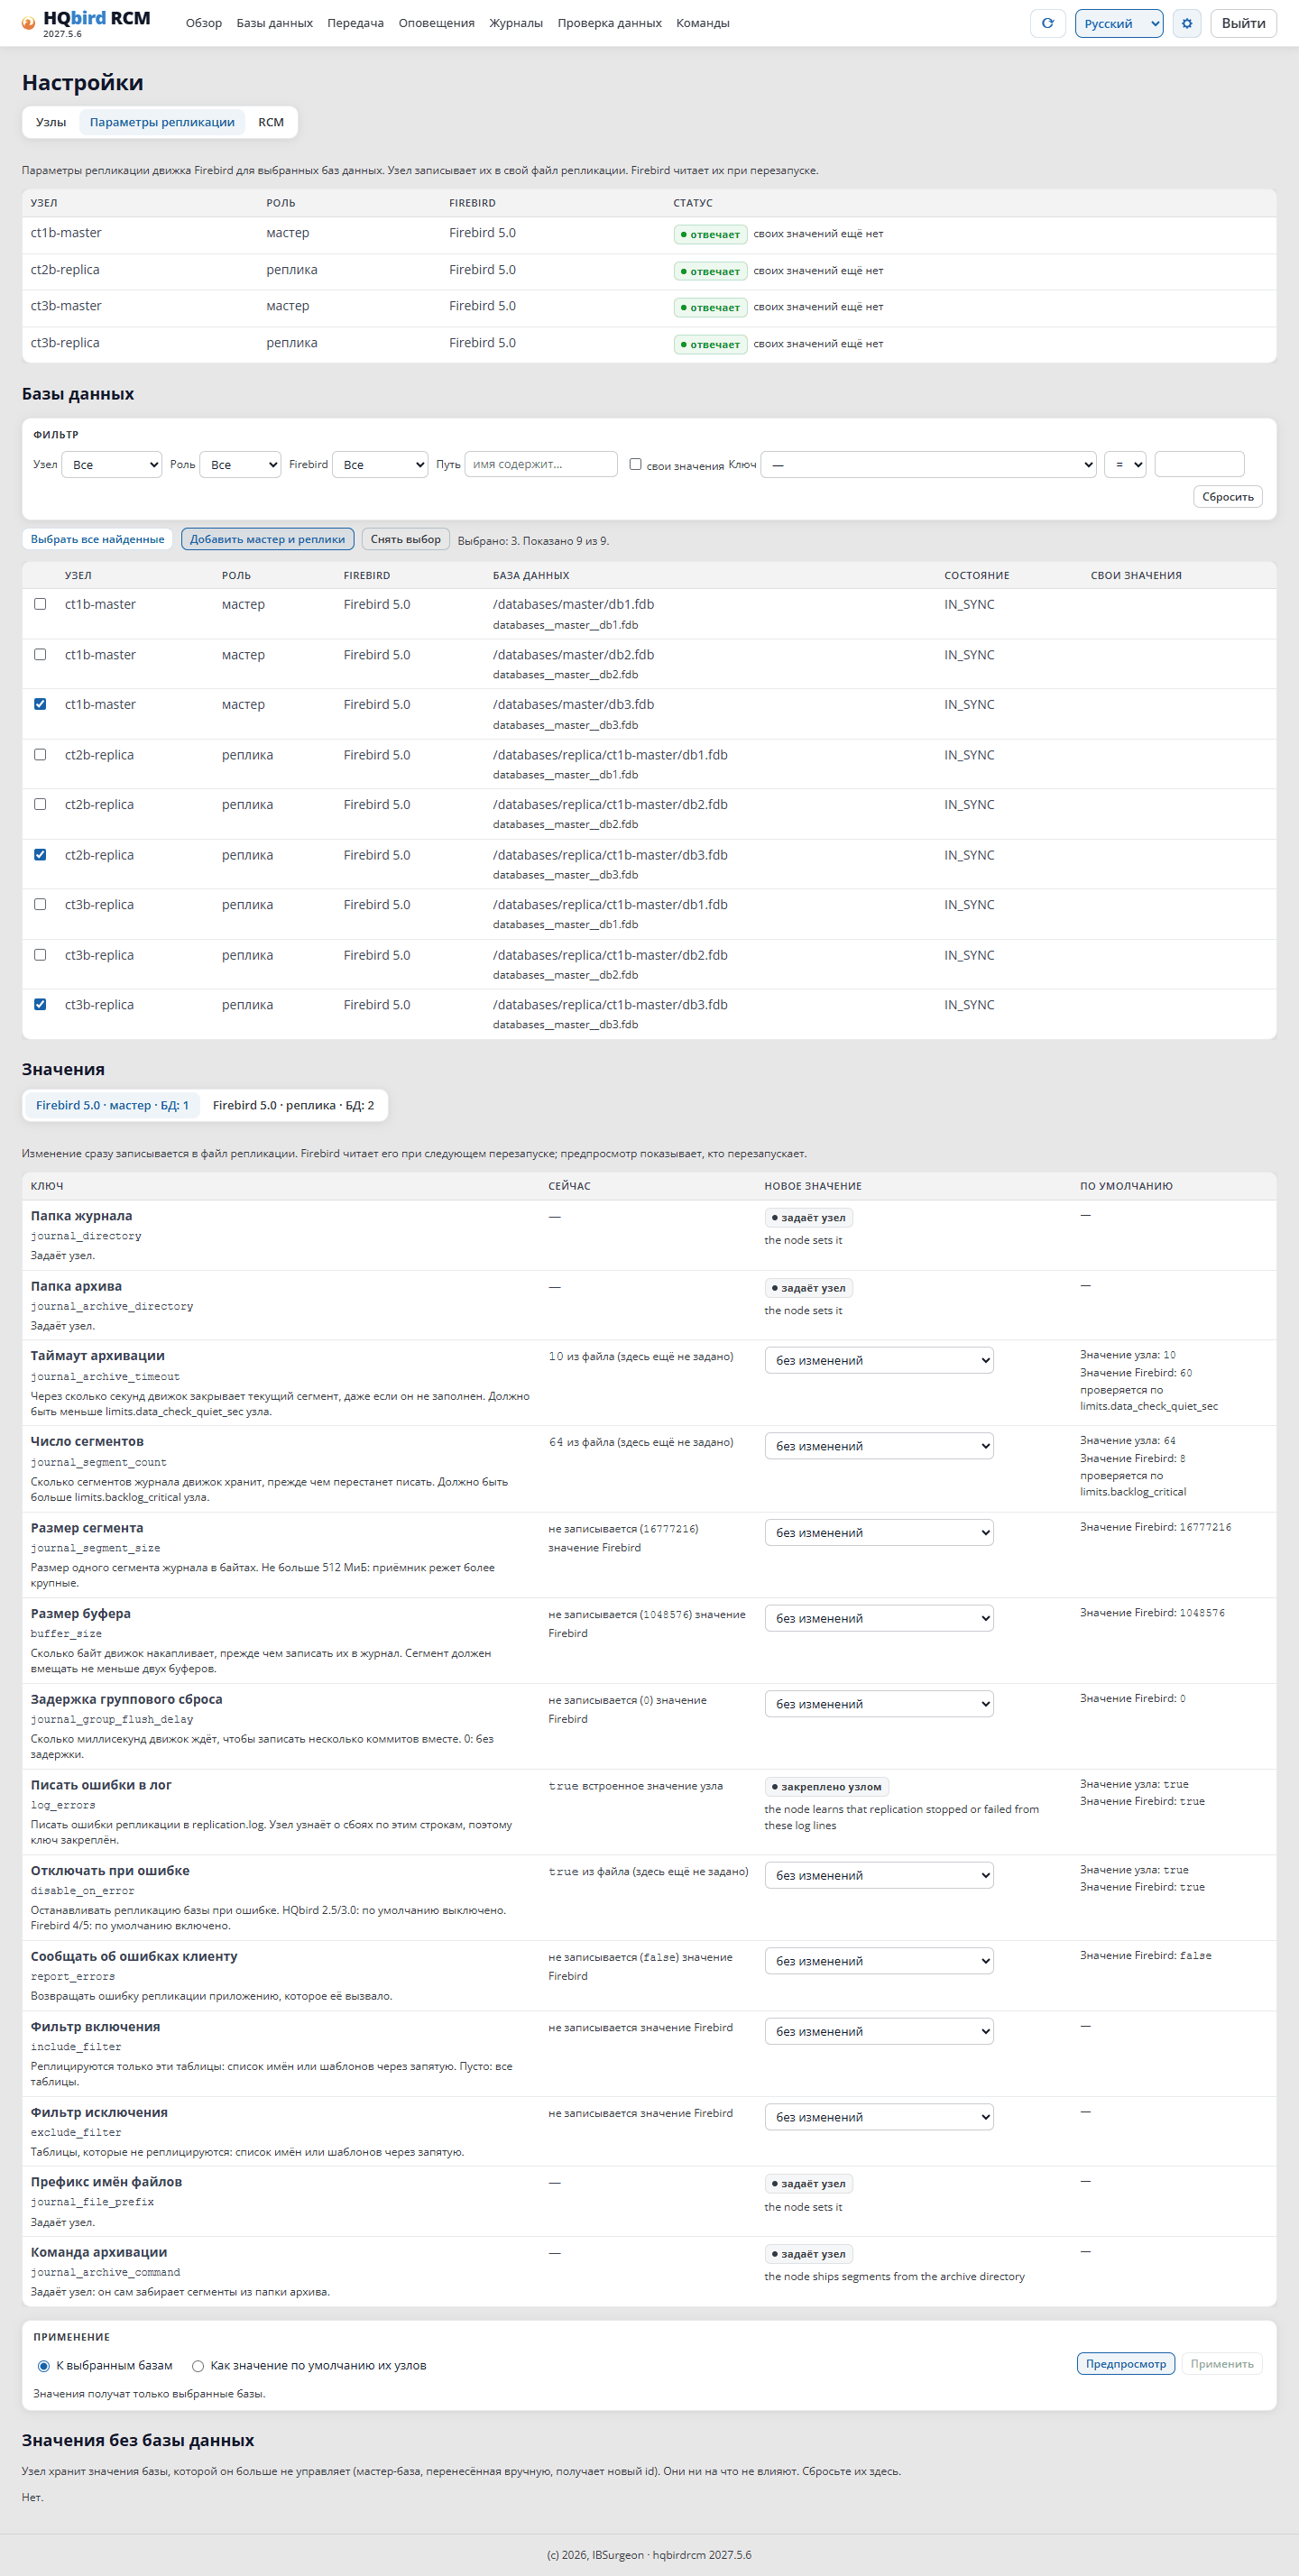
설정 → 복제 매개변수, 마법사 양식
설정 → 복제 매개변수 페이지는 선택한 데이터베이스 또는 노드 전체에 대해 replication.conf 의 키를 바꿉니다.
마스터와 레플리카 추가 — 데이터베이스를 고릅니다. RCM 은 Firebird 버전과 역할로 묶습니다. 마스터용과 레플리카용 양식이 따로입니다.
각 매개변수에 대해 동작을 고릅니다.
동작
하는 일
변경 없음
값은 바뀌지 않음
값 설정
새 값
초기화(위 수준으로)
자기 값을 제거하고 위 수준의 값을 사용
쓰지 않음(Firebird 값)
키를 쓰지 않고 Firebird 값이 적용됨
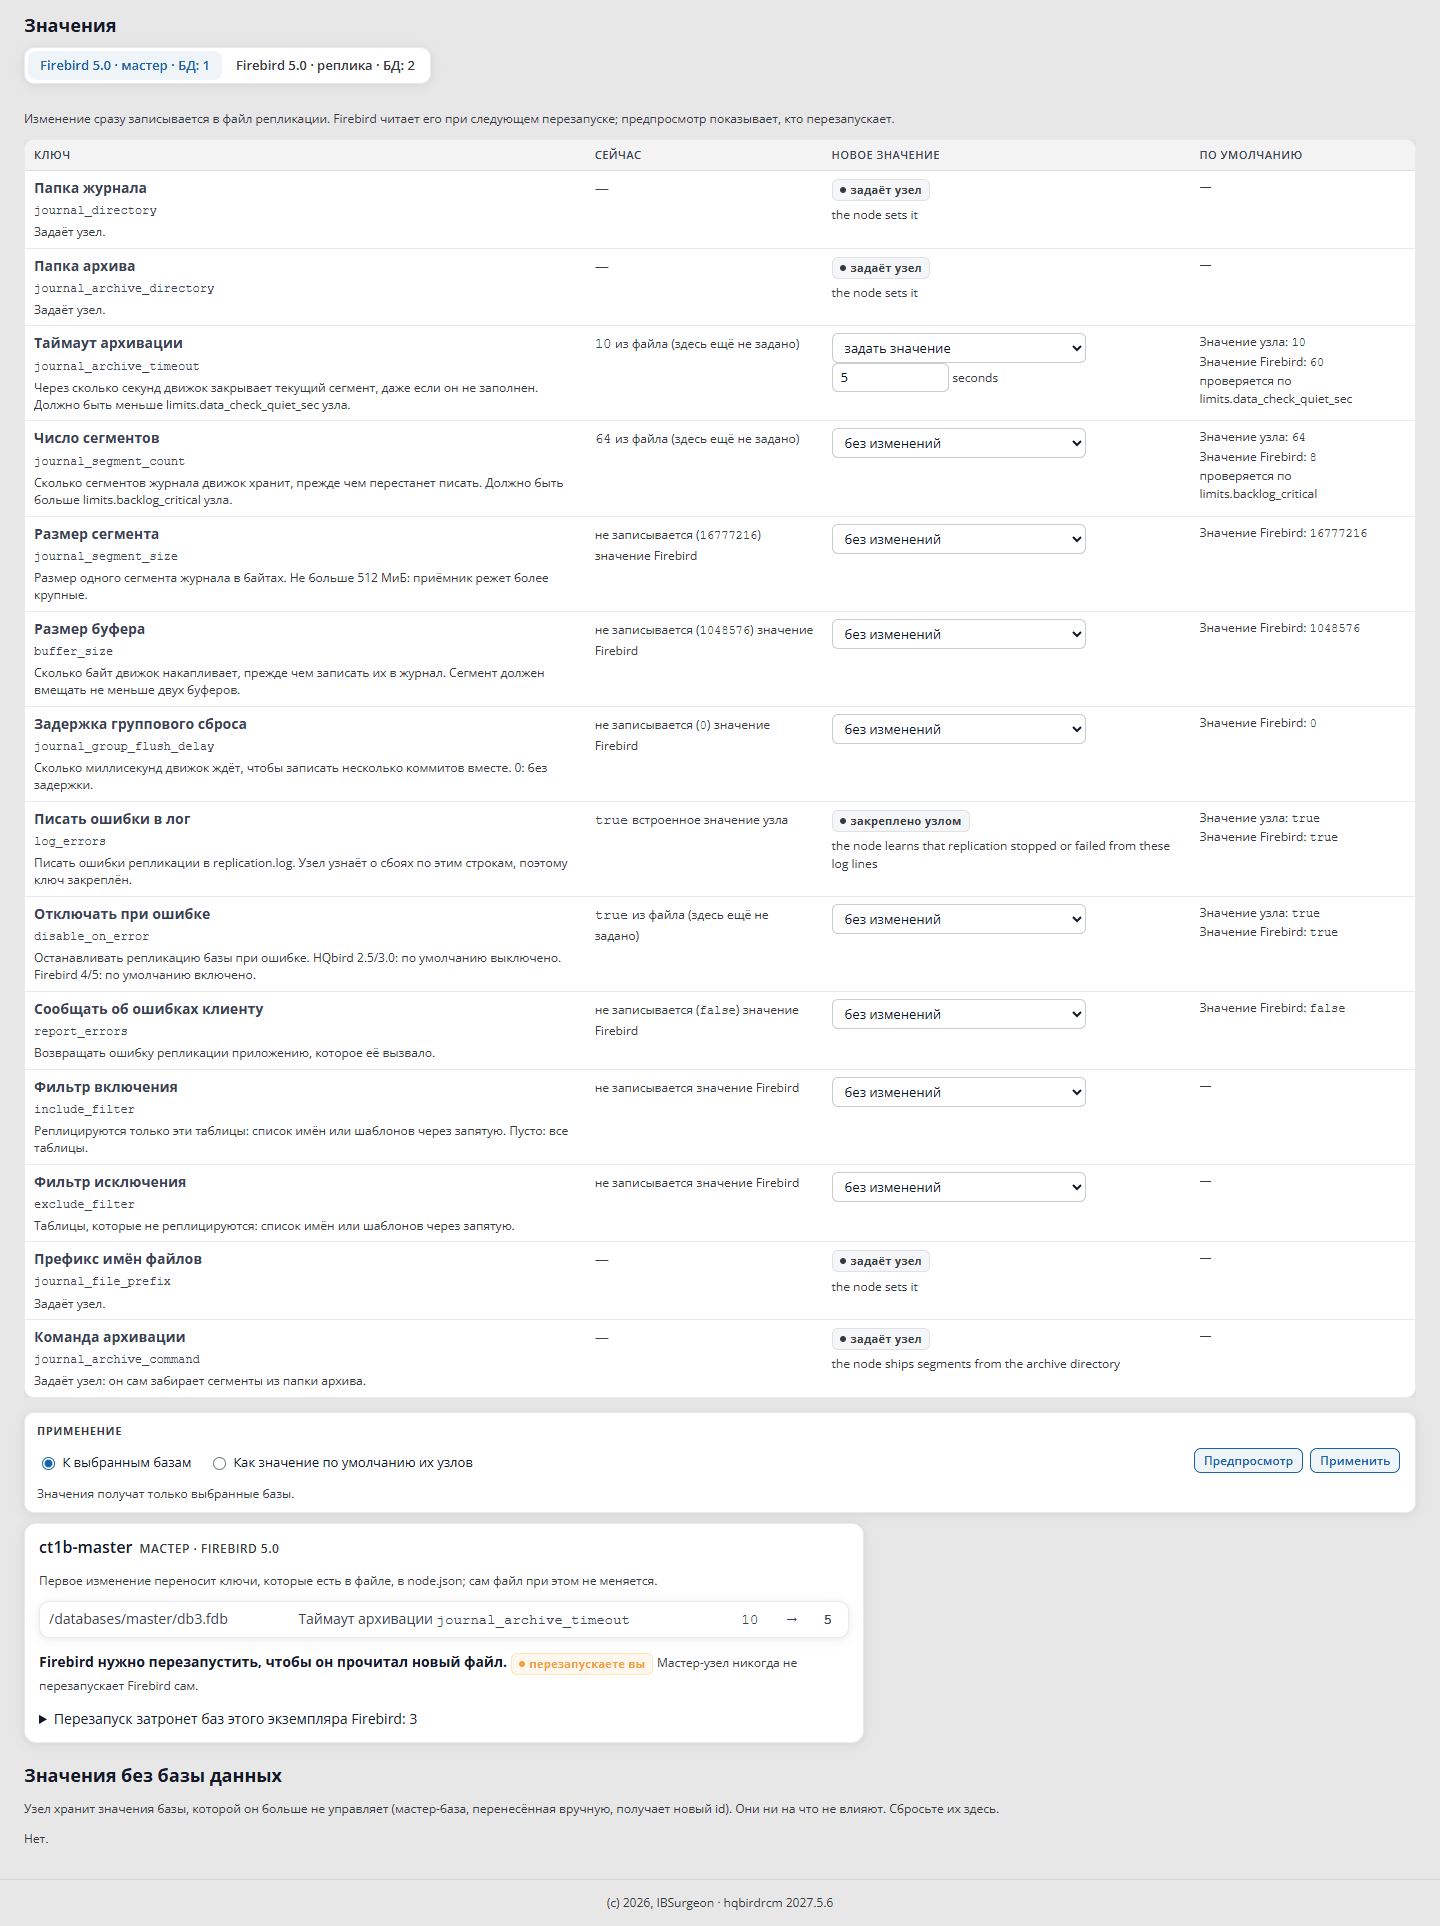
적용 대상을 고릅니다. 선택한 데이터베이스에, 또는 그 노드의 기본값으로.
미리 보기 — 노드는 아무것도 바꾸지 않고 값을 확인합니다.
변경 미리 보기
적용. RCM 이 각 노드에 명령을 보냅니다.
값의 출처(현재 열):
출처
값
이 데이터베이스
데이터베이스에 설정됨
노드 값
노드 기본값으로 설정됨
노드 내장 값
코드 안의 노드 값
Firebird 값
키가 쓰이지 않음
파일에서(여기서는 아직 설정되지 않음)
replication.conf 의 값. RCM 은 아직 바꾸지 않음
노드가 설정
읽기 전용(경로, 접두사)
응답하지 않는 노드는 그 데이터베이스를 선택할 수 없게 보여 줍니다. 변경에는 fbagent 가 필요합니다(없으면 fbagent_required).
누가 Firebird 를 다시 시작하는가(Firebird 가 replication.conf 를 읽는 것은 시작 때뿐입니다):
노드
누가
마스터
당신이 다시 시작. 마스터는 Firebird 를 스스로 다시 시작하지 않음
firebird.auto_restart: never 인 레플리카
당신
Firebird 가 마스터 데이터베이스도 제공하는 레플리카
당신
다른 레플리카
노드가 다시 시작. 자기 다시 시작 창 안에서
수동 다시 시작을 위해 페이지에는 Firebird 다시 시작 단추가 있습니다.
7.2. 주요 매개변수
마스터, Firebird 4/5:
매개변수
RCM 레이블
노드 값
Firebird
힌트
journal_archive_timeout
아카이브 시간 제한
10초
60초
완성되지 않은 세그먼트를 닫기 전에 Firebird 가 기다리는 초. 낮추면 레플리카가 마스터에 더 가까움. limits.data_check_quiet_sec(90)보다 작아야 함
journal_segment_count
세그먼트 수
64
8
.ReplLog 에 둘 수 있는 세그먼트 수. limits.backlog_critical(48)보다 커야 함
journal_segment_size
세그먼트 크기
—
16 MB
1 MB 에서 512 MB. 수신 측은 512 MB 를 넘는 것을 받지 않음
buffer_size
—
1 MB
노드는 log_errors = true(변경 불가)와 disable_on_error = true 도 씁니다.
HQbird 2.5/3.0 — 같은 의미의 log_* 키: log_archive_timeout, log_segment_count, log_segment_size(buffer_size 의 2배 이상). alert_command 키는 node.json 에서만 설정합니다.
각 매개변수의 힌트는 RCM 양식에 있습니다.
7.3. 아카이브 보관
마스터의 <database>.LogArch 아카이브는 단계적으로 정리됩니다.
모든 레플리카가 적용 했고 retention_days 보다 오래된 세그먼트.
여유 공간이 free_space_floor_gb 보다 적으면 — 보관 기간보다 새로운 적용된 세그먼트. 경보 disk_serious_cleanup.
그래도 공간이 적으면 — 가장 오래된 것부터 미적용 세그먼트. 레플리카는 NEEDS_REINIT 를 받고 경보 replication_paused_reinit_scheduled.
매개변수(설정 → 노드, 저장소와 파일)
기본값
limits.retention_days — 아카이브 보관, 일
2
limits.retention_min_kept_segments — 마지막 세그먼트를 항상 유지
0(꺼짐)
limits.free_space_floor_gb — 최소 여유 공간
1 GB
설정 → 노드, "저장소와 파일"
아카이브를 손으로 정리:
Command
hqbirdrcm cleanuparchive -node node-a # stages for all databases on the nodehqbirdrcm cleanuparchive -node node-a -db <db_id> # a single database
-orphaned(-db 와 함께일 때만)는 ORPHANED 상태 데이터베이스의 모든 세그먼트를 삭제합니다(3.8장). 다른 데이터베이스에 대해 노드는 not_orphaned 로 응답합니다. 승격 기증자에 대해 -orphaned 를 실행하면 안 됩니다(8.5장).
7.4. 전송: 압축, 속도, 창
압축 은 피어마다 설정합니다. 설정 → 노드 → 피어, 열 compress.
값
의미
비어 있거나 none
압축 없음(기본)
zstd
zstd 압축
변경은 즉시 적용됩니다. 압축은 느린 네트워크에서 유용합니다.
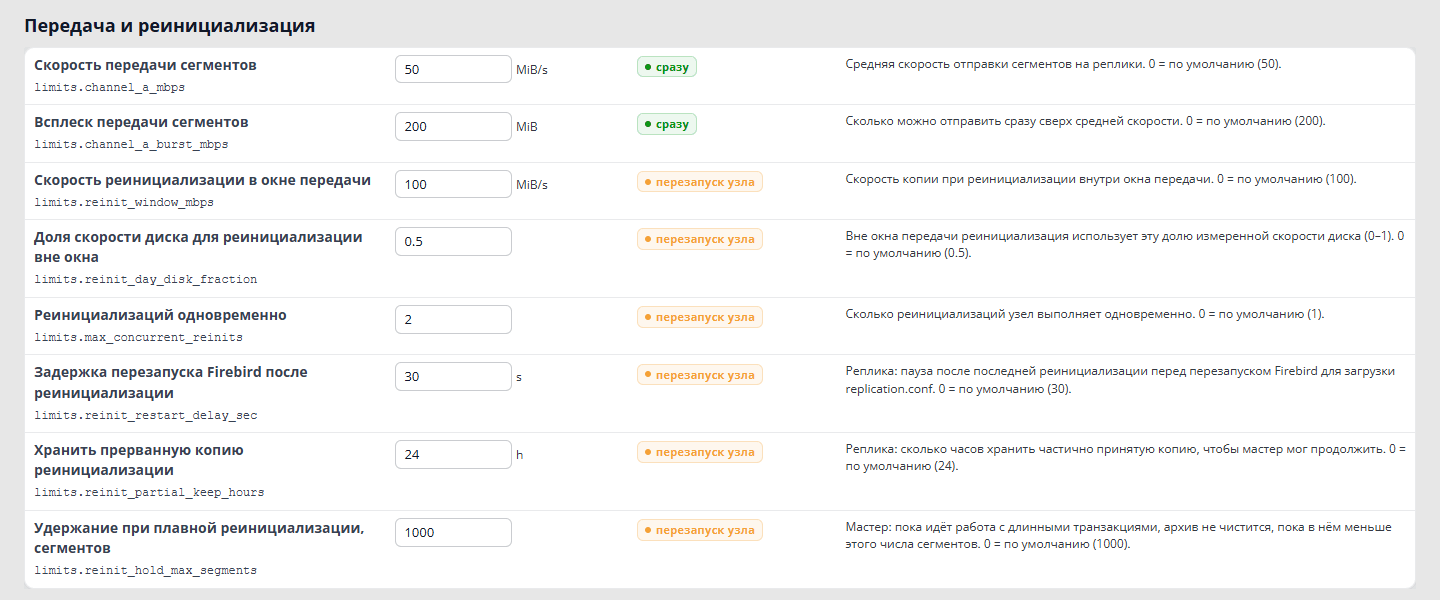
세그먼트 전송 속도(설정 → 노드, 전송과 재초기화):
매개변수
기본값
적용 시점
limits.channel_a_mbps — 세그먼트 전송 속도
50 MB/s
즉시
limits.channel_a_burst_mbps — 세그먼트 전송 버스트
200 MB
즉시
단위는 메비바이트(MiB)입니다. 이름은 “mbps"이지만. 버스트는 속도보다 작을 수 없습니다.
설정 → 노드, "전송과 재초기화"
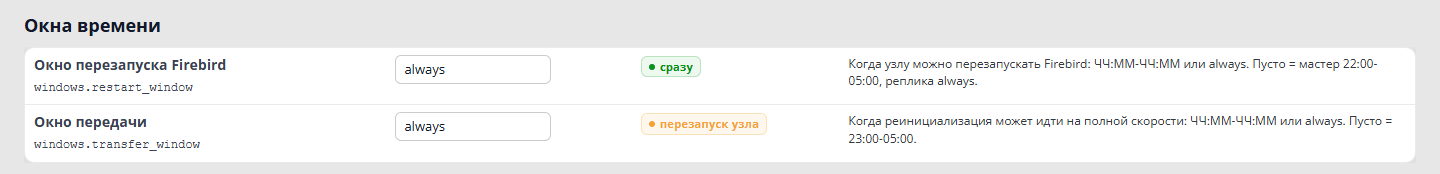
시간 창(시간 창):
매개변수
기본값
적용 시점
영향
windows.restart_window — Firebird 다시 시작 창
마스터 22:00-05:00, 레플리카 always
즉시
레플리카 노드가 Firebird 를 다시 시작해도 되는 시각
windows.transfer_window — 전송 창
23:00-05:00
노드 다시 시작 후
초기화의 최고 속도(5.5장)
각 필드 옆의 레이블은 변경이 언제 적용되는지를 보여 줍니다. 즉시 또는 노드 다시 시작.
설정 → 노드, "시간 창"
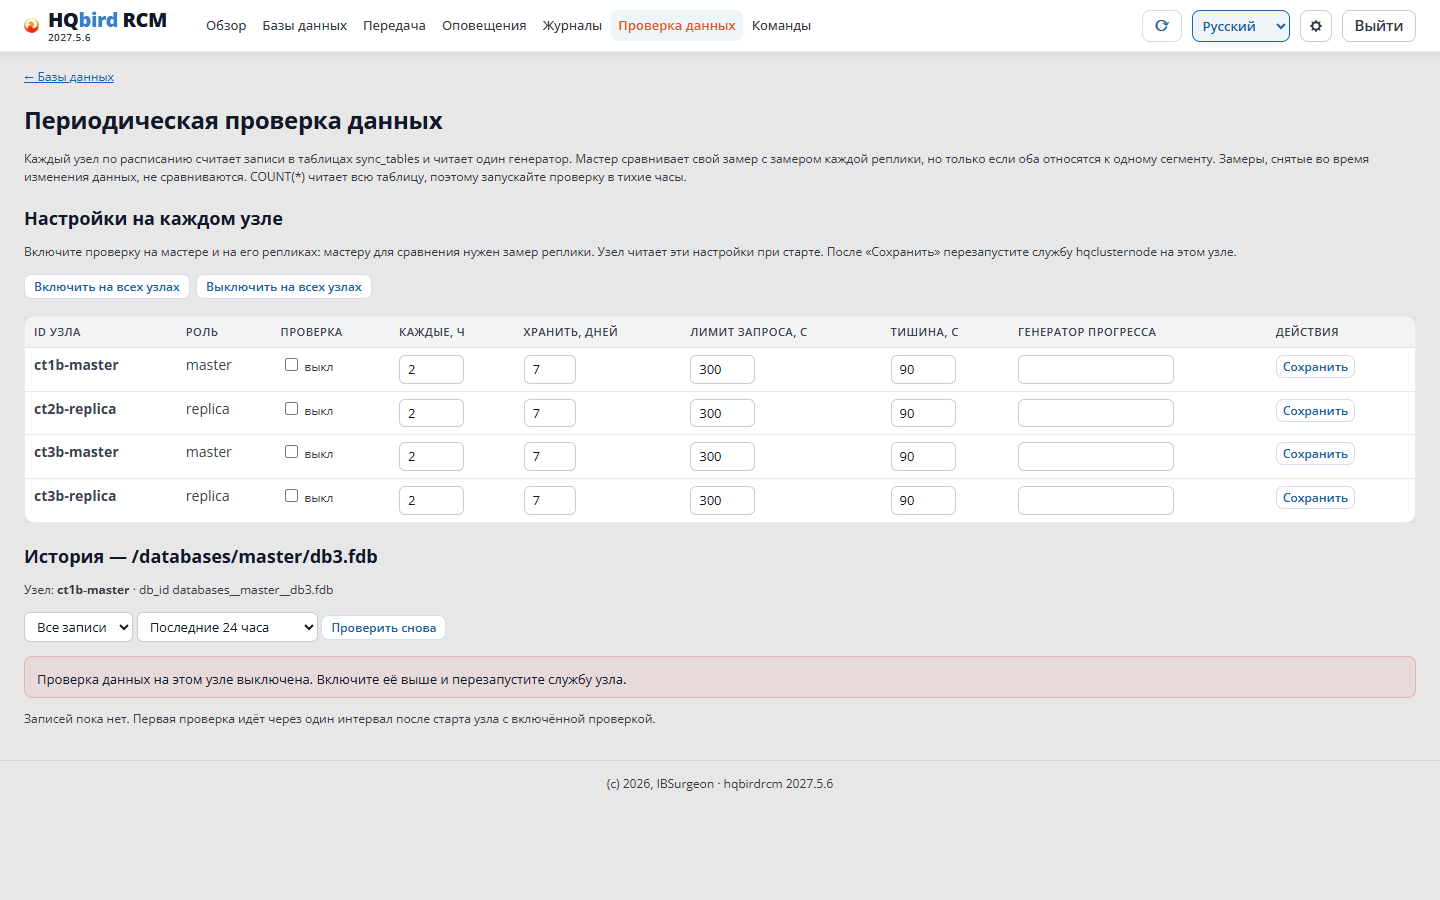
7.5. 데이터 검증
검증 — 마스터와 레플리카의 행 수를 한 번 비교(5.10장).
데이터 검증 — 정기 비교(5.10장). 노드는 마스터와 레플리카가 같은 세그먼트에 있을 때 비교합니다.
HQbird 2027.2.24 에서 검증 설정은 저장 직후 적용됩니다. 노드 서비스 다시 시작은 필요 없습니다. RCM 은 “저장되었고 이미 적용됨"을 표시합니다. 켠 뒤 첫 검증은 한 간격 뒤에 실행됩니다. 끈 뒤 진행 중인 검증은 중단되고 아무것도 쓰지 않습니다. 새 간격은 마지막 검증이 끝난 때부터 셉니다. 보관, 일, 쿼리 한도, 조용함, 진행 생성기 는 다음 검증부터 적용됩니다.
노드 2027.5.7 은 이 설정을 시작 때에만 읽습니다. 저장 뒤 그 노드의 hqclusternode 서비스를 다시 시작합니다. RCM 2027.2.24 는 “저장되었으나 아직 적용되지 않음"을 표시하고 이유를 말합니다.
비교할 테이블은 데이터베이스의 테이블 목록으로 정의됩니다(3.1장). HQbird 2027.2.24 에서는 각 데이터베이스가 자기 목록을 가질 수 있습니다. 등록 시의 필드, 또는 마스터 데이터베이스 페이지의 동기화 추적 테이블 블록(3.3장). 데이터 검증 페이지는 쓰인 목록과 “데이터베이스에 없음” 테이블 수를 보여 줍니다. 2027.5.7 에서는 목록이 노드마다입니다(sync_tables).
게시에서 제외된 테이블은 “게시되지 않음"으로 표시됩니다(6.3장).
데이터 검증 페이지
7.6. 경보
경보 페이지
경보 페이지. 동작:
확인 — 경보는 보이는 채로 확인됨 표시가 붙습니다.
60분 음소거 — 한 시간 숨깁니다.
삭제 / 이 코드를 모두 삭제 — RCM 은 삭제를 경보를 낸 노드에 전달합니다. 원인이 남아 있으면 경보가 다시 나타납니다.
Command
hqbirdrcm clearalerts -code backlog_warn # also -id, -acked, -all
HQbird 2027.2.33 부터 RCM 은 경보를 Telegram, webhook(Slack, Teams, JSON), 전자우편으로 보냅니다. 채널은 rcm.json 파일의 notify.channels 절에서 구성합니다. 경보 페이지의 알림 채널 블록은 채널을 보여주고 시험 메시지를 보냅니다. RCM 은 수준 warn 이상의 문제를 보고합니다. 문제가 나타남, 더 심각해짐, 또는 해제됨. 채널이 없으면 RCM 은 아무것도 보내지 않습니다. 이전 버전에는 송신이 없습니다. 경보 페이지를 보거나 RCM API 를 폴링합니다.
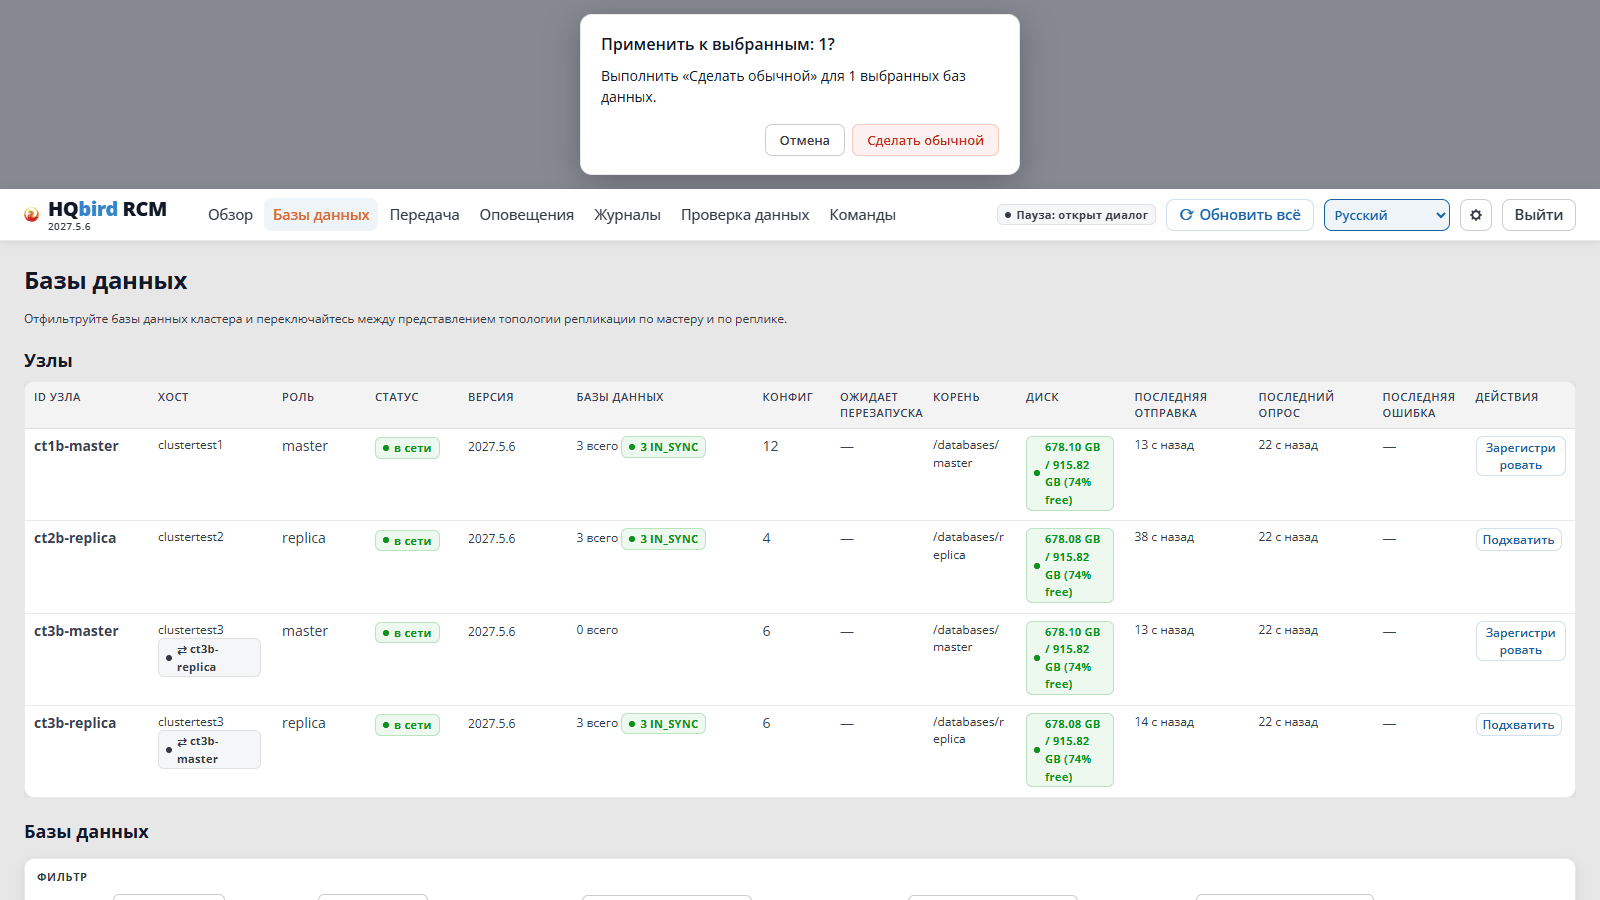
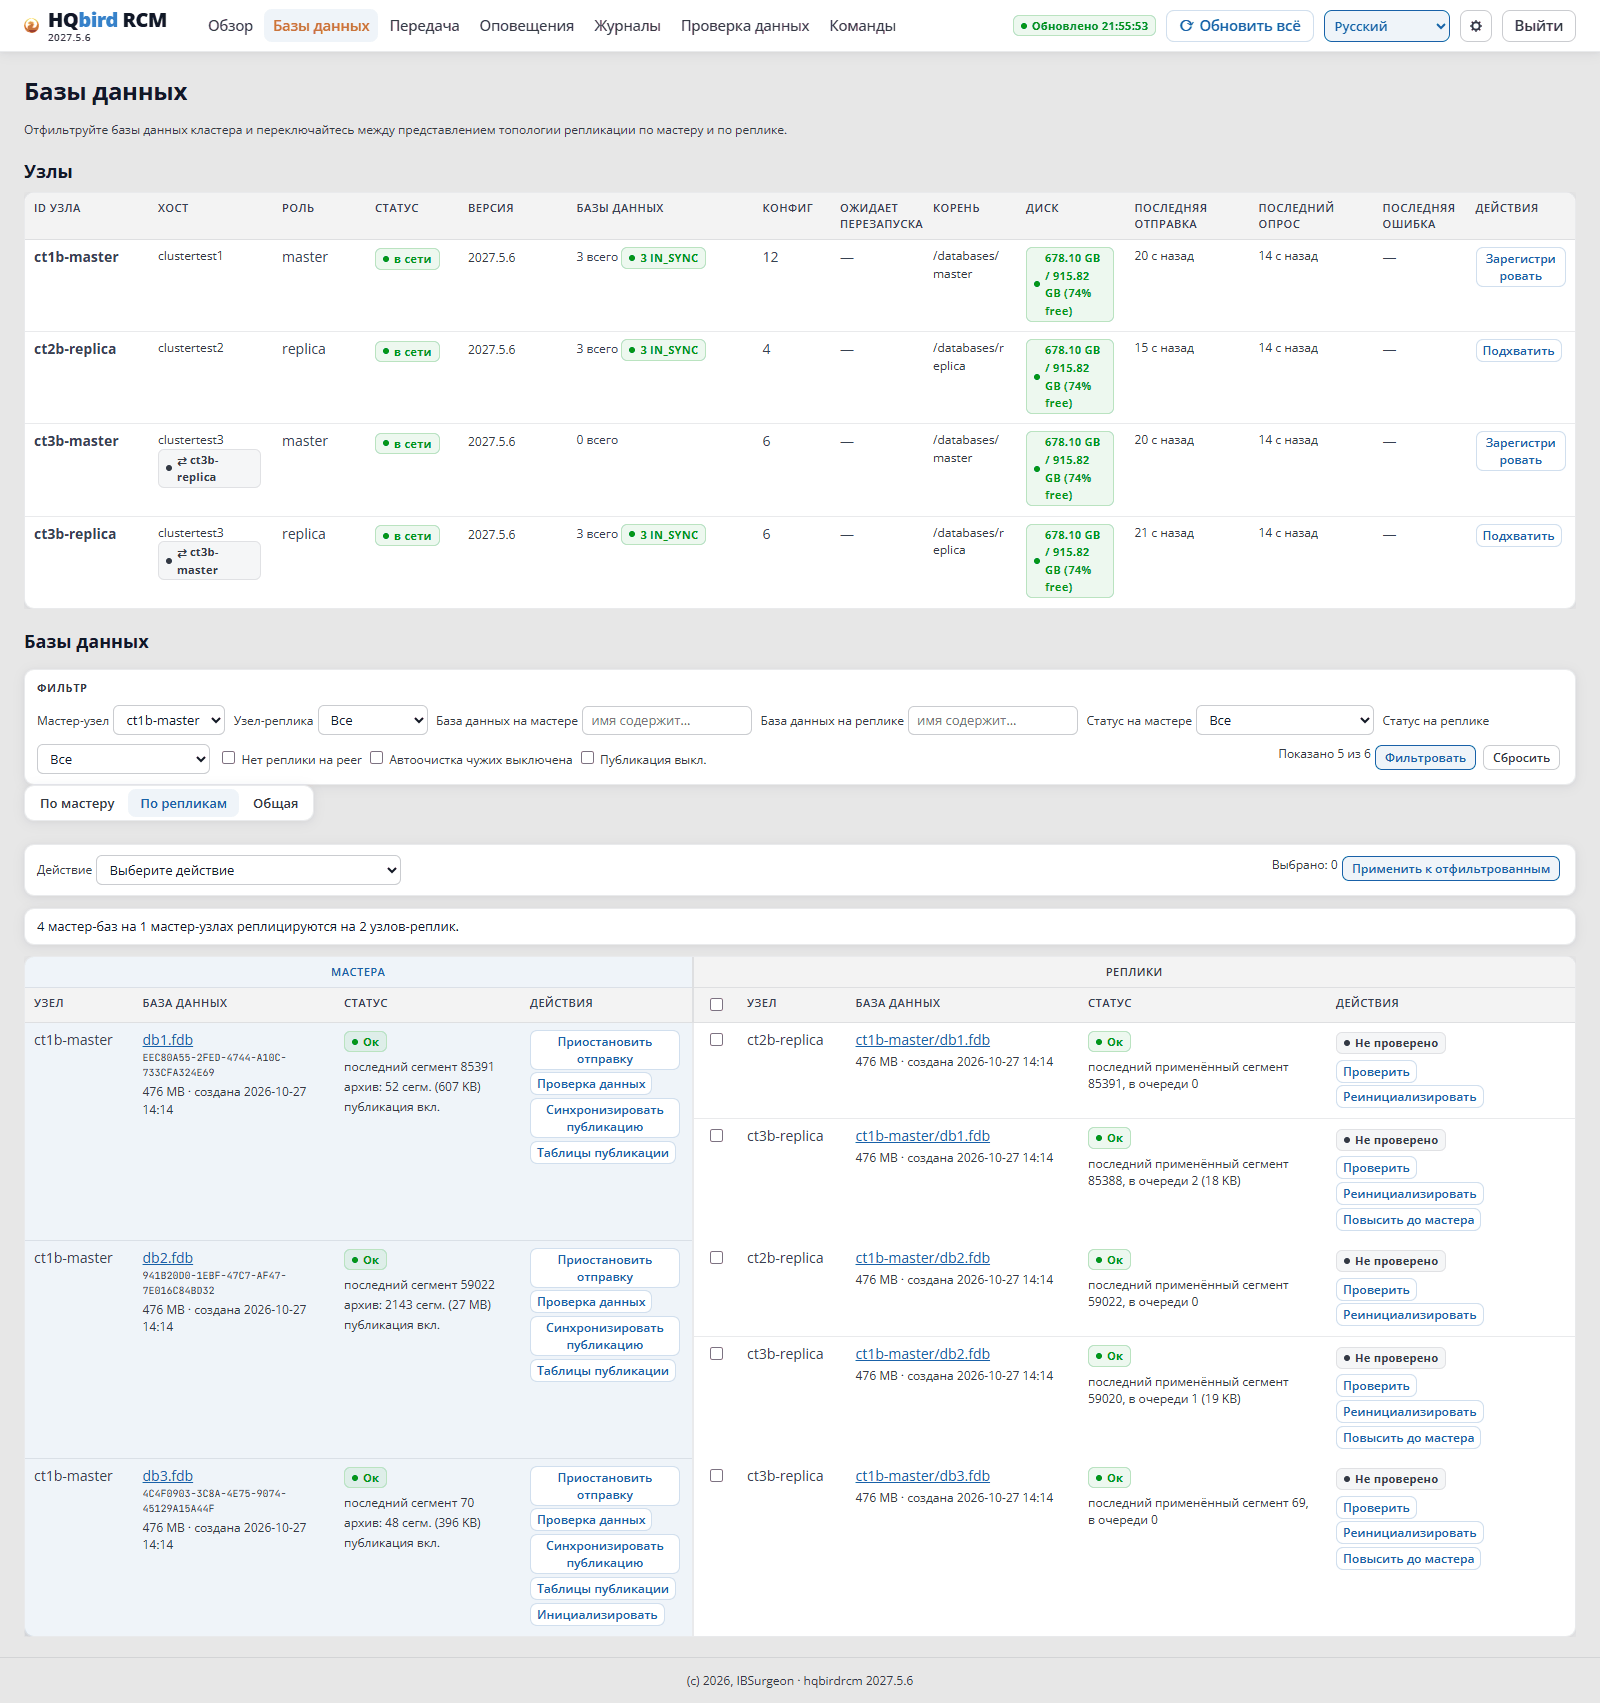
동작 목록에서 일반으로 만들기 를 고르고 확인합니다. 행에 별도 단추는 없습니다. 명령줄 명령도 없습니다.
"일반으로 만들기" 확인
3. 레플리카 노드는 다음을 합니다.
- `gfix -replica none` 을 실행합니다(HQbird 2.5/3.0: `gfix -replica {}`). 데이터베이스가 세그먼트 적용으로 바쁘면 노드는 몇 초 동안 `single` 종료로 둡니다(`gfix -shut single -force 0`), 레플리카 모드를 지우고 `gfix -online normal` 로 되돌립니다. **이 데이터베이스로의 모든 연결이 끊어집니다**.
- 표식 파일 `.hqcluster-normal.json` 을 씁니다(시각, 작성자, db_id, GUID).
- `.Incoming` 큐 정리를 시작합니다(8.2).
4. RCM 은 데이터베이스를 **레플리카가 아님(일반)** 그룹에 보여 줍니다.
"일반으로 만들기" 뒤의 "데이터베이스" 페이지
그 뒤 데이터베이스는 쓰기를 위해 열립니다.
replication.conf 에서 레플리카 블록을 제거합니다. 노드는 다음 스캔에서 제거하고, Firebird 는 시작 때 파일을 읽습니다.
그때까지 이 데이터베이스에 대한 “데이터베이스가 레플리카 모드가 아닙니다” 오류는 경보가 되지 않습니다.
표식 파일이 데이터베이스를 지킵니다. 초기화는 그런 데이터베이스를 덮어쓰지 않습니다. target_not_replica 로 거부됩니다(5.9장). 표식만 지워도 부족합니다. 노드는 데이터베이스 헤더의 레플리카 모드도 확인합니다. 옛 레플리카 삭제 확인란(4.4장)도 그런 데이터베이스는 삭제하지 않습니다.
HQbird 2027.2.24 에서 레플리카가 초기화를 위해 이 데이터베이스의 옛 복사본을 삭제하는 동안 일반으로 만들기 는 reclaim_in_progress 로 거부됩니다. 나중에 재시도합니다.
데이터베이스를 다시 레플리카로 만들어야 하면 — 덮어쓰기가 있는 새 초기화만이 방법입니다. 노드 API 로 합니다(overwrite_non_replica: true). RCM 에는 그런 단추가 없습니다. 옛 파일은 <database>.pre-reinit-<UTC time>.fdb 로 저장되고 표식은 삭제됩니다.
8.2. 세그먼트는 어떻게 되는가
노드가 데이터베이스를 스캔할 때까지 마스터는 세그먼트를 계속 보냅니다. 레플리카 노드는 30초마다 옛 세그먼트를 삭제하고 마지막 100개 만 남깁니다(keep_segments).
스캔 뒤 레플리카의 데이터베이스 기록은 상태 ORPHANED 가 됩니다. 레플리카 노드는 마스터에 unknown_database 로 응답합니다. 마스터는 이 레플리카로의 세그먼트 송신을 멈추고, 그것을 위한 아카이브 유지를 멈추고, 10분마다 다시 확인합니다.
이 데이터베이스의 다른 레플리카는 영향을 받지 않습니다.
ORPHANED 기록은 삭제할 수 있습니다(3.8장): hqbirdrcm forgetdatabase. 데이터베이스 파일 자체는 삭제되지 않습니다.
8.3. 마스터로 승격
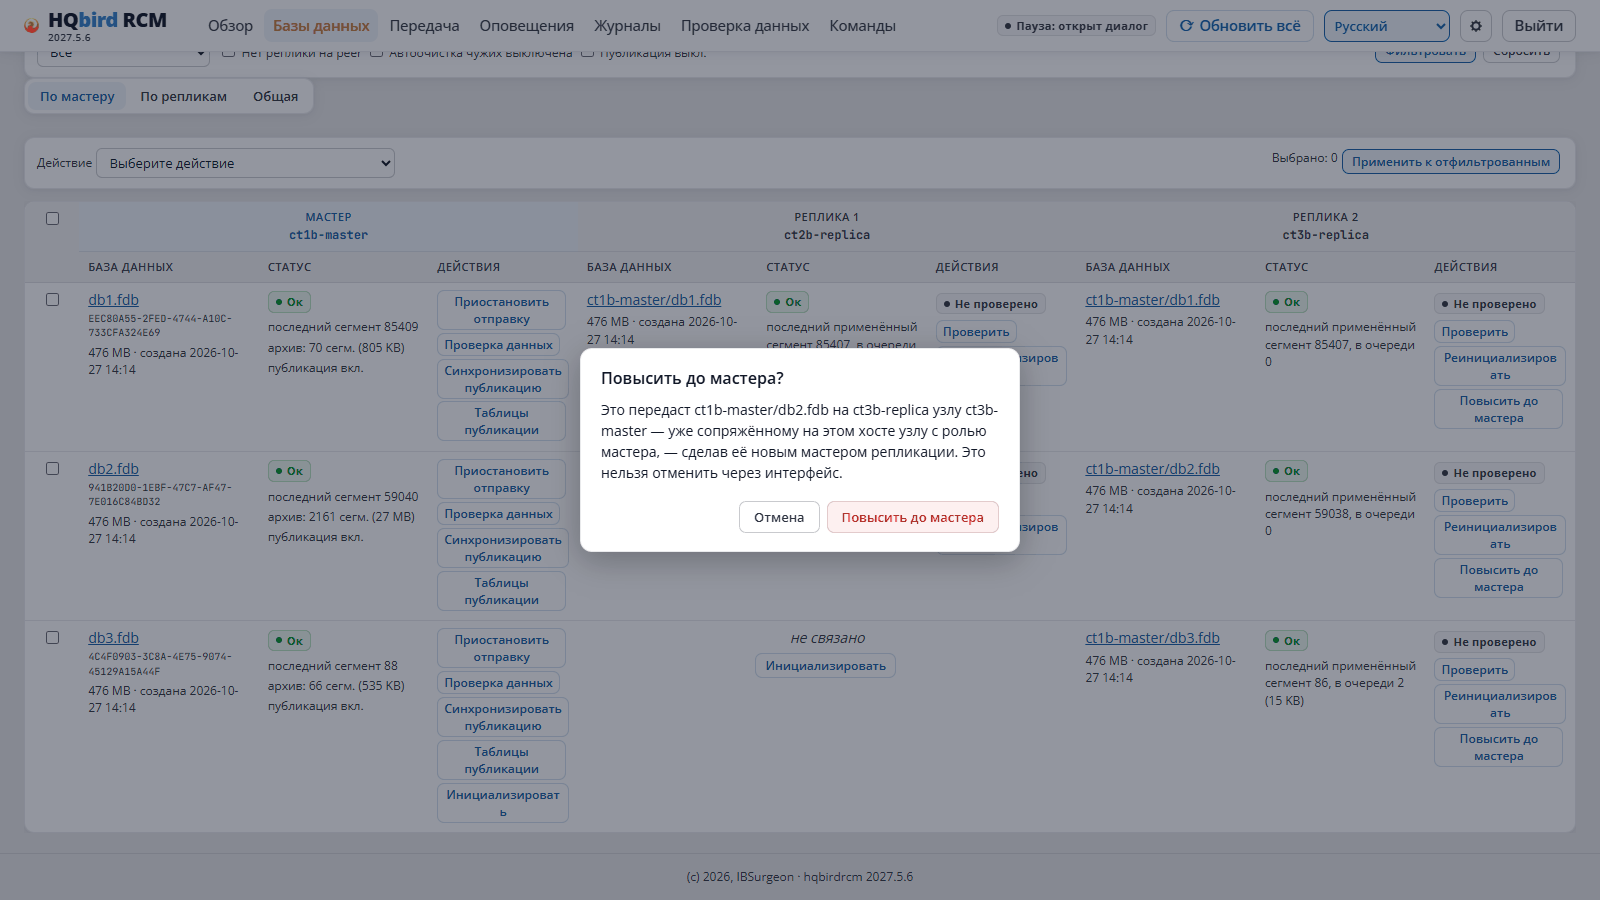
레플리카가 새 마스터가 됩니다. 파일은 그 자리에 남고 제어는 컴패니언 노드 로 넘어갑니다.
조건:
조건
거부
데이터베이스가 레플리카임
bad_request
같은 호스트에서 마스터 역할의 노드 — 컴패니언 — 가 실행 중( rcm.json 의 같은 host 레이블, 2.1장)
HQbird 2.5 와 3.0 에는 게시가 없습니다. PUBLICATION SYNC 단계는 “이 엔진에는 게시가 없습니다"라는 글로 끝납니다.
HQbird 3.0(Windows)의 승격 단계
기증자와 컴패니언이 같은 Firebird 를 쓰면 그 Firebird 는 다시 시작됩니다. 그 모든 데이터베이스로의 연결이 끊어집니다.
단계가 실패하면 작업은 오류 글과 함께 failed 가 됩니다. 원인을 고치고 마스터로 승격 을 다시 클릭합니다. 끝난 단계는 반복되지 않습니다. 승격 중 RCM 이 다시 시작되면 작업도 failed 가 됩니다. 노드 상태를 확인하고 재시도합니다.
라이선스. 마스터 호스트의 fbagent 에 라이선스가 없으면 마스터는 송신을 일시 중지한 상태입니다. 승격은 그래도 가능합니다. RCM 이 경고합니다. 일시 중지가 시작된 뒤의 변경은 사라집니다.
8.4. 새 GUID
승격 뒤 데이터베이스는 자기 GUID 를 받아야 합니다. 그렇지 않으면 새 마스터는 옛 마스터의 GUID 로 세그먼트를 쓰고, 그 레플리카는 duplicate_guid 로 거부됩니다.
노드의 NEW GUID 단계:
gfix -shut single -force 0 — 데이터베이스로의 모든 연결이 끊어집니다.
nbackup -L, 그다음 -SEQUENCE 없는 nbackup -F.
<database>.delta 를 삭제합니다.
헤더를 확인합니다. 새 GUID, REPLICATION_SEQUENCE = 0.
gfix -online normal.
Firebird 는 다시 시작되지 않습니다. 이 방법은 모든 버전(2.5, 3.0, 4.0, 5.0)에서 동작합니다.
단계가 중단되면 노드는 경보 newguid_interrupted 를 냅니다. 데이터베이스는 single 종료로 남을 수 있습니다. 마스터로 승격 을 반복합니다. 단계는 계속됩니다.
단계는 건너뜁니다(글은 skipped: 로 시작). 기증자 노드가 옛 버전이거나 파일이 이미 자기 GUID 를 가진 경우입니다.
새 GUID 뒤 옛 nbackup 체인은 더 이상 쓸 수 없습니다. 새 수준 0 nbackup 복사본을 만드십시오.
데이터베이스가 ADD DIFFERENCE FILE 로 만들어졌으면 그 .delta 는 다른 곳에 있습니다. 손으로 삭제합니다.
8.5. 승격 뒤
기증자 기록. 레플리카 노드에서 데이터베이스는 ORPHANED 로 남고, 경로는 exclude_paths 에 남으며, .Incoming 폴더와 레이블이 남습니다. RCM 에서는 이것이 유령 레플리카 행이며 단추는 새 마스터에서 열기 와 지우기 입니다.
기증자 행: «유령 레플리카»
행을 제거하려면 지우기 를 클릭합니다. 바뀌는 것은 RCM 뿐입니다.
레플리카 노드에서 기증자 기록을 제거하려면 forgetdatabase 를 실행합니다. 파일과 .Incoming 폴더는 남습니다. HQbird 2027.2.30 이상은 명령을 거부하지 않습니다(mailbox_active). 기증자 경로가 exclude_paths 에 있기 때문입니다. 이전 버전의 노드는 파일과 .Incoming 폴더가 있는 동안 거부합니다.
기증자에 대해 cleanuparchive -orphaned 를 실행하면 안 됩니다. 기증자와 컴패니언은 같은 <database>.LogArch 폴더를 공유합니다. 명령은 새 마스터의 살아 있는 아카이브를 삭제합니다.
옛 마스터.
기증자가 마지막 동작 중 레플리카였으면 RCM 은 옛 마스터를 마스터 저하 로 두고 기증자로의 송신을 일시 중지합니다(“송신 일시 중지: … (마스터로 승격)”). 기증자로의 송신을 재개하지 마십시오. 거기에는 이미 동작 중인 데이터베이스가 있습니다. 이 상태를 지우려면 데이터베이스를 다른 레플리카로 초기화합니다.
옛 마스터: «마스터 저하», 송신 일시 중지
옛 마스터에서 기증자 노드로의 초기화는 거부됩니다(target_not_replica). 거기에는 이미 동작 중인 데이터베이스가 있습니다.
NEW GUID 단계를 건너뛰었으면 옛 마스터와 새 마스터는 같은 GUID 를 가집니다. 그때 옛 마스터에서의 초기화에는 -force 가 필요합니다(5.9장).
수동 승격 뒤 RCM 은 옛 마스터를 새 마스터의 레플리카로 만들지 않습니다. 옛 마스터의 응용 프로그램을 멈추고 그 데이터베이스를 관리에서 제거합니다(3.8장). 서비스로 기술된 데이터베이스에서는 재합류가 이 일을 합니다(8.7).
새 마스터. 그것을 위한 레플리카를 준비합니다. 레플리카 노드, 피어(2장), 게시(6장), 초기화(5장).
새 마스터: 새 GUID 의 데이터베이스, 레플리카는 아직 없음
8.6. 계획된 스위치오버: 점검 목록
이것은 수동 스위치오버 절차입니다. 서비스로 기술된 데이터베이스에서는 RCM 이 스스로 마스터를 바꿉니다(8.7). 수동 승격은 응용 프로그램이 옛 마스터에 쓰고 있는지를 확인하지 않습니다. 절차:
미리. 레플리카 호스트에서 마스터 역할의 컴패니언 노드가 실행 중이고, 두 노드가 같은 host 레이블을 가짐(2.1장). 새 마스터를 위한 미래 레플리카 노드가 준비됨.
옛 마스터 데이터베이스로의 응용 프로그램 쓰기를 멈춤.
레플리카가 모든 것을 받아 적용할 때까지 기다림. 데이터베이스 → IN_SYNC, 큐 없음.
확인(5.10장): 행 수가 일치.
마스터로 승격(8.3). FINALIZE 단계를 기다림.
확인: 데이터베이스가 컴패니언의 마스터 목록에 있고 게시 켜짐.
응용 프로그램을 새 마스터로 전환.
새 데이터베이스의 nbackup 수준 0 복사본을 만듦(8.4).
기증자 행의 유령 기록을 지움(8.5).
레플리카를 새 마스터에 연결하고 초기화(5장).
옛 마스터: 데이터베이스를 관리에서 제거하거나 아카이브로 남김(8.5).
8.7. 서비스: RCM 의 스위치오버와 페일오버
HQbird 2027.2.30 부터 RCM 은 스스로 마스터를 다른 호스트로 옮깁니다. 이를 위해 데이터베이스를 서비스 로 기술합니다. 여러 호스트의 논리 데이터베이스 하나입니다. 서비스의 각 호스트에는 마스터 노드와 레플리카 노드가 있고 데이터베이스 파일 경로는 같습니다. 서비스는 서비스 페이지(HQbird 2027.2.31 부터)에서 만들거나 명령 hqbirdrcm services put -id <id> -file <file>.json 으로 만듭니다.
동작
하는 일
명령
스위치오버
데이터 손실 없는 계획된 마스터 이동. 그 뒤 옛 마스터는 자동으로 새 마스터의 레플리카가 됨
같은 동작은 서비스 페이지에 있습니다. 스위치오버…, 페일오버…, 재합류…, 재개… 단추입니다.
자동 페일오버 는 기본적으로 꺼져 있습니다. 서비스마다 켭니다. hqbirdrcm policy -service <id> -auto-failover on -max-data-loss 30. 라우터가 필요합니다. RCM 이 페일오버를 시작하는 것은 마스터 노드가 침묵하고, 라우터의 과반수가 마스터 Firebird 를 보지 못하며, 레플리카 지연이 max_data_loss_sec 이하일 때뿐입니다.
라우터(hqclusternode router, Linux)는 서비스의 현재 마스터에 HAProxy 를 유지합니다. 응용 프로그램은 <router host>:<router_port> 에 연결하고 전환 때 연결 문자열을 바꾸지 않습니다.
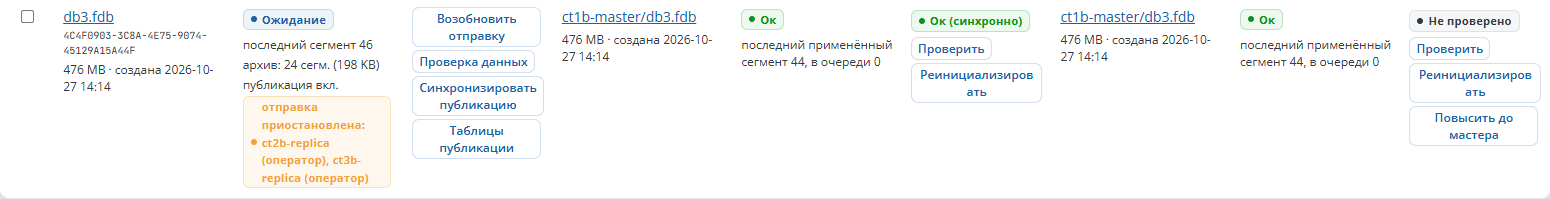
페일오버 뒤 옛 마스터가 다시 응답하면 RCM 은 그것을 격리합니다(역할 fenced). rejoin 명령으로 되돌립니다.