Ten podręcznik opisuje, jak zainstalować i używać klastra replikacji HQbird:
węzłów hqclusternode i menedżera klastra hqbirdrcm (RCM).
To podręcznik dla administratora Firebird. Zakładamy, że znasz Firebird,
gfix i nbackup. Nie musisz znać wewnętrznego działania węzła.
Z czego składa się klaster
Składnik
Ile
Gdzie działa
Co robi
Firebird (HQbird)
jedna lub więcej instancji
na każdym serwerze baz danych
przechowuje bazy danych, zapisuje segmenty replikacji
fbagent
jeden na instancję Firebird
obok Firebird
zatrzymuje i uruchamia Firebird na żądanie węzła
hqclusternode (węzeł)
jeden na instancję i rolę
obok Firebird
konfiguruje replikację, przekazuje segmenty, wykonuje inicjalizację repliki
hqbirdrcm (RCM)
jeden na klaster
na dowolnym hoście, który widzi wszystkie węzły
interfejs WWW, polecenia, alerty, statystyki
Węzeł ma rolę: master lub replica. Na jednej instancji Firebird mogą działać dwa węzły: węzeł master i węzeł replica.
W takim przypadku część baz danych tego Firebird to mastery, a część to repliki.
Jak to działa
Na masterze Firebird zapisuje zmiany bazy danych do segmentów (plików dziennika replikacji).
Węzeł master wysyła segmenty do węzła replica zabezpieczonym kanałem (mTLS).
Węzeł replica umieszcza segmenty w folderze segmentów przychodzących. Firebird repliki
stosuje je do swojej kopii bazy danych.
Sam węzeł master przekazuje pierwszą kopię bazy danych do repliki. Nazywa się to
inicjalizacją (reinit). Odbywa się to przez nbackup, a master w tym czasie
nadal działa.
Węzły wysyłają statystyki do RCM. RCM pokazuje stan klastra i
wysyła polecenia operatora do węzłów.
Jak działa klaster: segmenty, inicjalizacja, statystyki i polecenia operatora
Obsługiwane wersje
Firebird / HQbird 5.0 i 4.0 — wszystkie funkcje.
HQbird 3.0 i 2.5 — replikacja przez wtyczkę replconf. Nie ma publikacji;
zestaw tabel określają filtry. Różnice opisują ramki „HQbird 2.5/3.0”.
Główna wersja Firebird na masterze i na replice musi być taka sama. W przeciwnym razie węzeł replica
odmówi inicjalizacji.
Porty
Port
Kto nasłuchuje
Kto się łączy
Po co
7051
węzeł
inne węzły i RCM
API węzła, transfer segmentów i kopii baz danych
7443
RCM
wszystkie węzły
odbieranie statystyk od węzłów
7444
RCM
operator
interfejs WWW i API operatora. Instalacja przez RCM (rozdział 1.3): HTTPS na wszystkich adresach. Instalacja przez HQCenter Admin lub ręcznie: HTTP, tylko 127.0.0.1
7450–7459
fbagent, dopóki okno łączenia jest otwarte
RCM
łączenie hostów (rozdział 1.3)
13050
fbagent, tylko 127.0.0.1
węzeł na tym samym hoście
zarządzanie Firebird
3050
Firebird
aplikacje
zwykła praca bazy danych
Jeśli na jednym hoście są dwa węzły (master i replica), drugi węzeł ma inny port.
Przy instalacji przez RCM drugi węzeł dostaje port 7061. W pozostałych przypadkach
port ustawiasz sam, na przykład 7052.
Port 13050 nie może być wystawiony do sieci. Port 7444 z HTTP (instalacja przez
HQCenter Admin lub ręcznie) też nie: łącz się z interfejsem WWW RCM
przez tunel SSH (rozdział 1). Przy instalacji przez RCM port 7444 działa po
HTTPS, a instalator otwiera go w zaporze sieciowej.
Główna zasada: nie ma fbagent, nie ma zmian
Węzeł zmienia konfigurację replikacji tylko przez fbagent: musi
zrestartować Firebird. Jeśli fbagent jest niedostępny, węzeł odmawia każdej czynności,
która zmienia konfigurację. Nie działa „częściowo”.
Terminy
Termin
Znaczenie
Segment
plik dziennika replikacji ze zmianami bazy danych
Publikacja
lista tabel mastera, których zmiany trafiają do segmentów (Firebird 4/5)
Inicjalizacja (reinit)
przekazanie kopii bazy danych z mastera do repliki przez nbackup
GUID bazy danych
identyfikator bazy danych Firebird; RCM używa go, aby powiązać mastera z repliką
Peer
węzeł partnerski: dla mastera jego repliki
Companion
drugi węzeł na tej samej instancji Firebird (master i replica na jednym hoście)
nie ma HQCenter Admin, ale potrzebujesz certyfikatów, konfiguracji i aktualizacji bez ręcznej pracy; do 3 serwerów baz danych
instalujesz HQbird na każdym hoście, logujesz się do RCM i w Ustawienia → Połącz hosty podajesz adresy hostów
Ręcznie (1.4)
brak dostępu do HQCenter Admin, sieć zamknięta, szczególne wymagania
instalujesz pliki, tworzysz certyfikaty, zapisujesz node.json i rcm.json, rejestrujesz usługi
Przez HQCenter Admin i przez RCM nie instalujesz węzłów i RCM samodzielnie. Instaluje je
fbagent, gdy dodasz go do klastra (rozdział 2). Certyfikaty i
konfiguracja też powstają automatycznie.
Linux i Windows opisuje jeden rozdział. Różnice Windows są w
ramkach „W systemie Windows”.
1.1. Wymagania
Na każdym serwerze baz danych:
Firebird / HQbird 5.0, 4.0, 3.0 lub 2.5 (2.5 — tylko Linux).
fbagent obok każdej instancji Firebird. Bez fbagent węzeł nie działa.
Synchronizacja czasu (NTP, chrony, w32time) na wszystkich serwerach i na
hoście RCM. Okna restartu i transferu, szacunek opóźnienia oraz
kontrola „węzeł nie odpowiada” zależą od zegarów.
Wolne miejsce na archiwum segmentów i na inicjalizację repliki (rozdział 4).
Windows: uprawnienia administratora, x64, Windows 10 / Server 2016 lub nowszy,
64-bitowy Windows PowerShell 5.1. W Windows 10 i Server 2016–2022 wymagany jest 7-Zip.
Gdzie będzie działać RCM. Na klaster potrzebny jest jeden RCM. Można go zainstalować na dowolnym
serwerze, który widzi wszystkie węzły, także na jednym z serwerów baz danych.
1.2. Instalacja przez HQCenter Admin
Krok 1. Uruchom skrypt instalacyjny fbagent
Skrypt instaluje Firebird (kompilację HQbird), fbagent i rejestruje fbagent na
serwerze HQCenter Admin. Wybierz skrypt zgodny z wersją Firebird: fb25, fb30, fb40,
fb50.
Linux (jako root):
Command
sudo sh fbagent-fb50_known.sh --goafts <HQCenter-Admin-server> --enroll --cluster
W systemie Windows (PowerShell jako administrator):
nie zadawać pytań (potrzebne, gdy nie ma terminala)
Pełna lista parametrów jest w README skryptu instalacyjnego fbagent.
Krok 2. Zatwierdź żądanie fbagent
Z parametrem --enroll fbagent wysyła żądanie certyfikatu (CSR) do HQCenter Admin i
czeka do 30 minut na zatwierdzenie. Możesz je zatwierdzić tak:
automatycznie — jeśli instalacja została uruchomiona z tokenem licencji (--token) i
licencja ma wolne miejsce;
w panelu HQCenter Admin — sekcja żądań CSR, żądanie
tego hosta, przycisk zatwierdzenia i podpisu;
przez API HQCenter Admin — POST /v1/admin/csr-requests/{id}/approve.
Jeśli rejestracja się nie udała (na przykład minął czas oczekiwania), fbagent nadal
działa, ale skrypt kończy się kodem 2. Uruchom skrypt ponownie z
tymi samymi parametrami: powtórzona zostanie tylko rejestracja.
Kilka minut po rejestracji fbagent sam instaluje HQ Monitor.
Krok 3. Opisz klaster
Węzły i RCM pojawiają się, gdy dodasz fbagent do klastra HQCenter Admin. Jak opisać
klaster, opisuje rozdział 2.
Po zapisaniu klastra:
W ciągu 10 minut fbagent otrzymuje klaster z HQCenter Admin (potem sprawdza
zmiany co 60 sekund).
fbagent na hoście RCM tworzy urząd certyfikacji (CA) klastra i podpisuje
certyfikaty wszystkich węzłów.
Każdy fbagent zapisuje node.json albo rcm.json dla swoich członków klastra.
Przy następnym sprawdzeniu produktu (co 3 minuty) fbagent instaluje usługi i
je uruchamia.
<port> to port Firebird, na przykład 3050. Jeden fbagent może obsługiwać nie więcej niż
jeden węzeł master, jeden węzeł replica, jeden RCM i jeden router
(hqclusternode router, od HQbird 2027.2.30, rozdział 8.7).
W systemie Windows. Wersje fbagent przed 2.83.0 instalowały węzły w C:\hqclusternode i
RCM w C:\hqbirdrcm. Jeśli te foldery istnieją, fbagent nadal
ich używa.
Aktualizacje
fbagent sprawdza nowe wersje węzła i RCM co 3 minuty; domyślny
kanał to stable. Najpierw aktualizowany jest węzeł replica, potem węzeł master.
Jeśli po aktualizacji usługa nie startuje albo zgłasza złą wersję,
fbagent wraca do poprzedniej wersji i blokuje nową. Lista blokad:
<folder fbagent>/update/<product>/blocked-versions.json. Aby spróbować
wersji ponownie, usuń jej wiersz z tego pliku.
Stan produktu: fbagent --product-status hqclusternode (albo
hqbirdrcm).
1.3. Instalacja przez RCM (bez HQCenter Admin)
Klastrem zarządza RCM. fbagent każdego hosta otrzymuje opis klastra z RCM,
fbagent na hoście RCM podpisuje certyfikaty, a węzeł i RCM są aktualizowane z
wydań przechowywanych przez RCM.
Ograniczenia:
Jeden klaster na RCM.
Nie więcej niż 3 miejsca. Miejsce to host, na którym działa węzeł master albo replica.
Master i replica na tym samym hoście liczą się jako jedno miejsce. Host, na którym działa tylko RCM,
nie zajmuje miejsca. Czwarty host daje błąd seats_exceeded.
RCM nie aktualizuje fbagent ani Firebird. fbagent aktualizuje je sam i nie
rusza replication.conf, node.json, rcm.json ani certyfikatów.
Są dwie metody:
Połącz hosty w RCM — zwykła metoda. Trzy czynności: instalator na
każdym hoście (RCM na jednym hoście, tryb wykrywania na pozostałych), logowanie do
RCM, formularz Połącz hosty.
Ręcznie z wiersza poleceń — tokeny dołączenia i
fbagent --cluster-join. Potrzebne, gdy port 7450 jest zamknięty między hostami albo
okno parowania już się zamknęło.
Licencja. Licencja próbna zawiera funkcję cluster. Po okresie próbnym
fbagent nie instaluje węzła ani RCM, jeśli w licencji nie ma cluster.
Nigdy nie blokuje aktualizacji już zainstalowanych węzłów i RCM. Bez
HQCenter Admin licencja pływająca przestaje działać po online_check_days plus
dni karencji. Dlatego na każdym fbagent zainstaluj licencję powiązaną:
Command
fbagent --license-request --out license_request.json
# send the file to the vendor and receive license.jsonfbagent --license-install license.json
Bez licencji master przestaje wysyłać segmenty (rozdział 2.8).
Porty:
Port
Gdzie
Kto się łączy
7443
host RCM
fbagent i węzły wszystkich hostów klastra
7444
host RCM
przeglądarka operatora (konsola RCM, HTTPS)
7450 (na drugim i kolejnych hostach fbagent — 7451…7459)
host w trybie wykrywania, dopóki okno parowania jest otwarte
RCM na hoście RCM
7051 (drugi węzeł tego samego fbagent — 7061)
hosty węzłów
inne węzły i RCM (1.4, krok 7)
Połącz hosty w RCM
Przykład od zera. Dwa serwery Linux, instalator .run, łączenie,
rejestracja, publikacja, inicjalizacja i ponowna inicjalizacja pod obciążeniem — ze
zrzutami ekranu i pomiarami: podręcznik hqbird2027-linux-cluster-guide.ru.md i
runbook hqbird2027-linux-cluster-runbook.ru.md (repozytorium goafts, folder
documentation).
Krok 1. Zainstaluj HQbird na każdym hoście
Zainstaluj HQbird pełnym instalatorem na każdym serwerze baz danych. Nie rejestruj w
HQCenter Admin (--enroll).
Domyślnie instalator nie konfiguruje klastra. Umieszcza programy węzła
i RCM w folderze fbagent (update/<product>/staged/), ale nie instaluje RCM, nie otwiera okna
parowania i nie otwiera portów klastra w zaporze. Klaster
włącza się dwoma parametrami:
Command
sudo sh hqbird2027-fb50-linux-<version>.run --rcm on # RCM hostsudo sh hqbird2027-fb50-linux-<version>.run --cluster-pairing on # other hosts
--rcm on — na jednym hoście, na którym będzie działać RCM klastra. Instalator:
tworzy klaster tego hosta (fbagent --cluster-init); nazwą klastra jest
nazwa hosta;
instaluje i uruchamia RCM; konsola RCM działa po HTTPS na porcie 7444;
tworzy pierwszego administratora RCM rcmadmin z losowym hasłem;
otwiera w zaporze porty 7443, 7444 i port węzła 7051.
--cluster-pairing on (tryb wykrywania) — na każdym innym hoście.
Instalator otwiera okno parowania fbagent na 24 godziny: port 7450 i
port węzła 7051. Dopóki okno jest otwarte, RCM z sieci może zaprosić ten host do
swojego klastra. fbagent zaczyna nasłuchiwać na porcie 7450 w ciągu minuty.
Bez tych parametrów instalator pyta sam: w interfejsie tekstowym
jest to strona Cluster, z --no-tui — dwa pytania.
Domyślna odpowiedź to „nie”. --yes bez parametrów klastra też odpowiada
„nie” na oba pytania.
Na końcu instalator wypisuje wiersze RCM: i Pairing:. Na hoście RCM:
text
RCM:        https://10.0.0.7:7444 (cluster db1)
CA hash:    sha256:7cfc1d4b…032d2582
Login:      rcmadmin
Password:   in /opt/hqbird/fbagent-fb50/clusterca/db1/rcm-initial-password (read it with sudo; RCM asks for a new one at the first login)
Pairing:    not needed: this agent runs the RCM; other agents link through it
Na innym hoście:
text
RCM:        off; turn it on in HQbird Monitor or with fbagent --cluster-init <id>
Pairing:    port 7450 open until 2026-11-17T17:49:18Z (fingerprint sha256:0439e44a…91a2f9b9); an RCM may invite this host
W wyjściu nie ma hasła: jest ono w pliku z wiersza Password:. Zapisz
fingerprint każdego hosta w trybie wykrywania.
Parametry klastra w instalatorze Linux:
Parametr
Co robi
--rcm on|off
zainstalować RCM i utworzyć klaster na tym hoście; domyślnie off
--cluster-pairing on|off
tryb wykrywania: otworzyć okno parowania na 24 godziny; domyślnie off
--pairing-port N
port parowania nowego fbagent, 7450–7459; domyślnie pierwszy wolny
--rcm-password-file F
hasło administratora RCM z pierwszego wiersza pliku F, zamiast losowego
--cluster-id ID
nazwa klastra ID zamiast nazwy hosta (z --rcm on)
--cluster-node on|off
zainstalować program węzła; domyślnie on
--rcm-allow A,B
tylko te RCM mogą zaprosić ten host: adres, sieć CIDR albo nazwa
Pierwszy fbagent na hoście dostaje port parowania 7450 oraz porty węzła 7051 i
7061. Druga instancja na tym samym hoście — 7451, 7052 i 7062.
RCM i okno parowania można włączyć później, bez instalatora: w HQ Monitor,
na stronie Clusters, albo poleceniami jako użytkownik fbagent:
Command
cd <fbagent folder> # /opt/hqbird/fbagent-fb50sudo -u firebird ./fbagent --cluster-init <name> # RCM host; open ports 7443 and 7444 yourselfsudo -u firebird ./fbagent --cluster-pairing on # window for 24 hourssudo -u firebird ./fbagent --cluster-pairing off
sudo -u firebird ./fbagent --cluster-pairing status
Stare instalatory (fbagent przed 3.1.0) nie pytają o klaster:
instalują RCM na każdym hoście i wszędzie otwierają okno parowania. Potrzebujesz RCM
jednego hosta; RCM pozostałych hostów same się zatrzymują po połączeniu.
W systemie Windows. Te same dwa wybory są w instalatorze Windows: parametry
/RCM i /DISCOVERY.
Krok 2. Zaloguj się do RCM
Otwórz adres z wiersza RCM: hosta RCM (https://<host>:7444). Zaloguj się
loginem rcmadmin i hasłem z pliku we wierszu Password:. RCM od razu prosi o
nowe hasło (1.5).
Krok 3. Połącz hosty
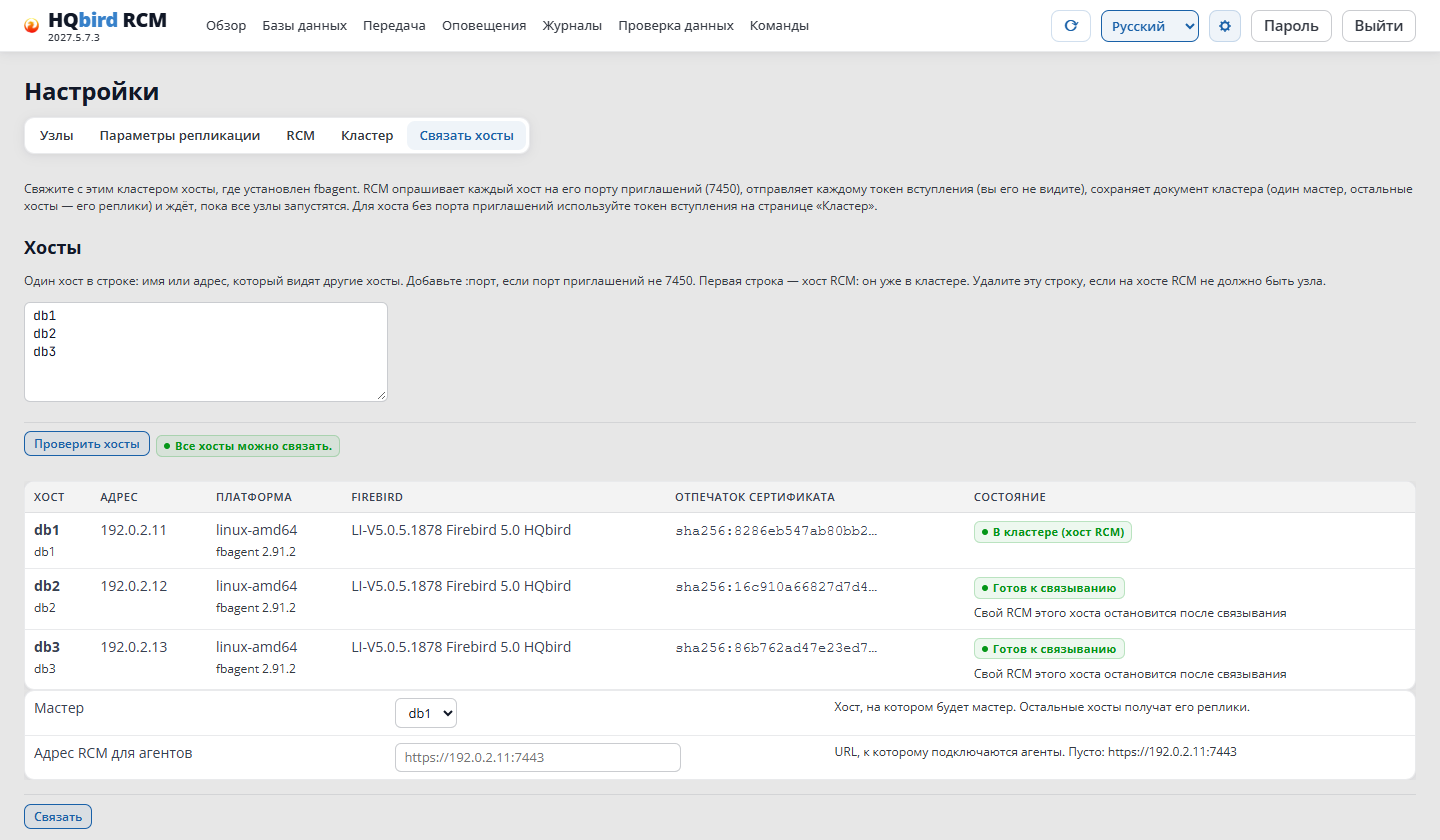
W RCM otwórz Ustawienia → Połącz hosty.
W polu Hosty wpisz adresy albo nazwy hostów, po jednym w wierszu.
Pierwszy wiersz to host RCM, on już jest w klastrze.
Kliknij Sprawdź hosty. RCM sonduje porty parowania
7450–7459 każdego hosta i pokazuje platformę, wersję Firebird,
odcisk i stan. Host RCM nie potrzebuje okna parowania. Porównaj
odciski z wyjściem instalatora (wiersz Pairing:).
Wybierz Master (domyślnie pierwszy host) i kliknij Połącz.
Połącz hosty: wynik sprawdzenia
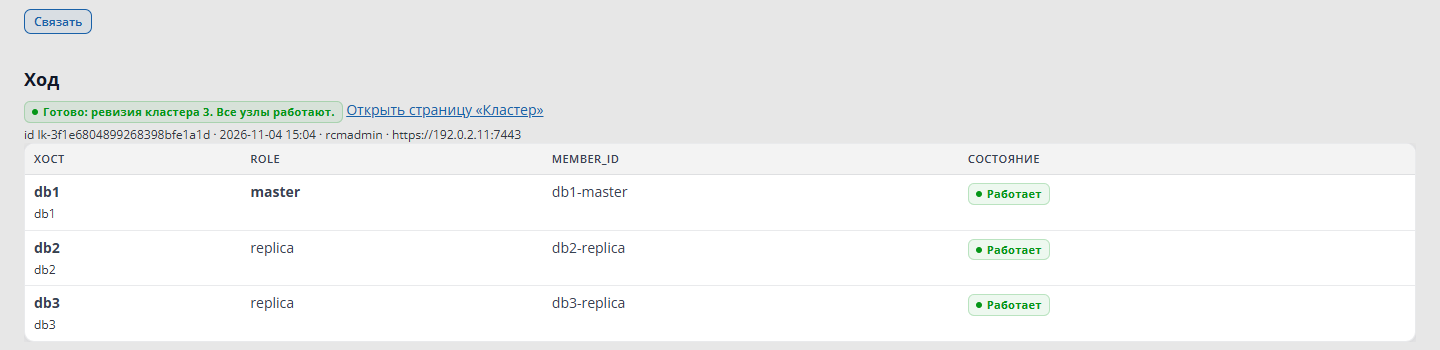
RCM prosi o potwierdzenie i pokazuje postęp w sekcji Postęp. Gdy wszystkie węzły
działają, pojawia się „Gotowe” i numer rewizji klastra:
Połącz hosty: wszystkie węzły działają
To samo z wiersza poleceń:
Command
cd /opt/hqbirdrcm
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster link -hosts db1,db2,db3 -master db1
Co dzieje się dalej:
RCM wysyła zaproszenie do każdego wolnego hosta.
fbagent hosta dołącza do klastra i zamyka port parowania. Jeśli
host ma własne RCM bez węzłów, fbagent zatrzymuje je i wyłącza, a
pusty klaster przenosi do cluster/left/ w folderze fbagent.
RCM zapisuje klaster: węzeł <host>-master na masterze, <host>-replica na
pozostałych hostach, port 7051, powiązania master → replica.
fbagent każdego hosta instaluje i uruchamia węzeł. RCM czeka, aż wszystkie węzły
działają, i pokazuje Działa przy każdym hoście.
Stany hosta po Sprawdź hosty:
Stan
Co zrobić
Gotowy do połączenia
nic. Jeśli poniżej jest „Własne RCM tego hosta zatrzyma się po połączeniu” — to normalne
W klastrze
host jest już w tym klastrze
Błąd unreachable
port 7450 jest zamknięty: okno parowania jest wyłączone (jak domyślnie) albo minęło 24 godziny. Zaraz po instalacji odczekaj minutę i kliknij Sprawdź hosty ponownie. W przeciwnym razie otwórz okno (--cluster-pairing on) i sprawdź zaporę
Błąd in_other_cluster
host jest w innym klastrze
Błąd claimed
inne RCM łączy ten host właśnie teraz
Błąd seats_exceeded
więcej niż 3 miejsca
Wydania. fbagent instaluje węzeł tylko z RCM. RCM bierze podpisane
wydania ze swojego folderu import/ (obok rcm.json) przy starcie i co
5 minut. Instalator wkłada tam wydania hosta RCM, a fbagent pozostałych hostów
same pobierają wydanie dla swojej platformy. Lista wydań jest na dole
strony Połącz hosty. Wydanie można też zaimportować ręcznie (krok 5 poniżej).
Ręcznie z wiersza poleceń
Kolejność: kroki 1–3 na hoście RCM, krok 4 na każdym innym hoście, kroki 5–6 w RCM.
Krok 1. Zainstaluj HQbird z fbagent
Zainstaluj HQbird na każdym serwerze baz danych i na hoście RCM pełnym instalatorem.
Na hoście RCM możesz od razu podać --rcm on (wtedy krok 3 nie jest potrzebny). Na innych
hostach nie podawaj parametrów klastra: domyślnie nie ma RCM ani okna
parowania. Nie rejestruj w HQCenter Admin (--enroll).
Na hoście RCM instalator zostawia program RCM w folderze fbagent
(update/hqbirdrcm/staged/). Bez niego krok 3 kończy się błędem
no hqbirdrcm to install.
Krok 2. Zainstaluj powiązaną licencję
Jak na początku sekcji, „Licencja”.
Krok 3. Utwórz klaster na hoście RCM
Jeśli instalator już utworzył klaster (--rcm on: wiersz RCM: z adresem w
wyjściu), pomiń ten krok.
Uruchom polecenie jako użytkownik fbagent (w Linux — firebird), nie jako
root: inaczej pliki CA i rcm.json będą należeć do root.
W systemie Windows (PowerShell jako administrator):
.\fbagent.exe --cluster-init shop-prod --address 10.0.0.7
shop-prod — nazwa klastra: małe litery łacińskie, cyfry i -.
--address — adres hosta RCM, pod którym inne
hosty się z nim łączą. Można powtórzyć kilka razy. Bez parametru używane są adresy i nazwa hosta.
Polecenie:
tworzy CA klastra i CA agenta (w folderze fbagent, clusterca/<name>/);
zapisuje certyfikat RCM, rcm.json i cluster-init.json do folderu RCM;
instaluje RCM i rejestruje usługę hqbirdrcm. W Linux usługa działa jako
osobny użytkownik hqbirdrcm;
przełącza fbagent na RCM (cluster.source = rcm) i uruchamia go ponownie;
wypisuje adres RCM i odcisk CA:
Code
Cluster:    shop-prod
RCM URL:    https://10.0.0.7:7443
CA hash:    sha256:9f86d0...
Zapisz RCM URL i CA hash: są potrzebne na innych hostach. Ponowne uruchomienie
dla tego samego klastra jest bezpieczne: CA i klucze pozostają te same.
Zaloguj się do RCM od razu i zmień hasło rcmadmin (1.5).
W Linux. Użytkownik hqbirdrcm jest w grupie fbagent. RCM czyta
rcm.json przez tę grupę, ale nie może go zapisać. Dlatego Ustawienia → RCM nie zapisuje zmian (błąd
rcm_config_read_only). Edytuj rcm.json na hoście jako użytkownik fbagent
i uruchom RCM ponownie.
Krok 4. Podłącz fbagent innych hostów
Na hoście RCM utwórz token dołączenia dla każdego fbagent: w RCM
Ustawienia → Klaster, przycisk Utwórz token dołączenia. Albo z
wiersza poleceń:
Command
cd /opt/hqbirdrcm
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster join-token -note db2
Token jest ważny 24 godziny, tylko dla jednego fbagent i tylko raz. RCM
pokazuje go raz, razem z gotowym poleceniem.
Na hoście węzła uruchom to polecenie jako użytkownik fbagent:
Zamiast --token-file możesz użyć --token <token>. W Windows — to samo z
.\fbagent.exe w PowerShell jako administrator.
fbagent sprawdza CA RCM po odcisku. Jeśli odcisk się nie zgadza, zatrzymuje się
i nic nie zapisuje. Potem fbagent otrzymuje swój certyfikat
(90 dni, odnawiany automatycznie) i uruchamia się ponownie. Podłączony fbagent jest widoczny w
RCM w tabeli Agenci. Dopóki nie ma członków, na hoście nic nie jest instalowane.
Krok 5. Zaimportuj wydania do RCM
fbagent bierze węzeł i RCM tylko z RCM. Jeśli wymaganego wydania nie ma na
liście Wydania w mirrorze (Ustawienia → Połącz hosty), zaimportuj każdy produkt
(hqclusternode, hqbirdrcm) dla każdej platformy swoich hostów
(linux-amd64, windows-amd64). Plik wydania i podpis .sig dostarcza
producent.
RCM szuka podpisu w <file>.sig albo podajesz go przez -sig. Bez
ważnego podpisu producenta RCM nie przyjmie pliku.
Nowe wydanie zastępuje poprzednie. Restart RCM nie jest potrzebny.
fbagent sprawdza nowe wersje co 3 minuty. Kolejność aktualizacji i
blokowanie są jak przez HQCenter Admin (1.2, „Aktualizacje”).
Krok 6. Opisz klaster
Ustaw członków i powiązania w RCM, Ustawienia → Klaster (rozdział 2.3). Po
zapisaniu fbagent instaluje węzły tak samo jak przez HQCenter Admin (1.2, krok 3): zapisuje
certyfikaty, node.json i rcm.json, instaluje usługi i je uruchamia.
Porty — na początku sekcji.
1.4. Instalacja ręczna
Krok 1. Zainstaluj HQbird z fbagent
Zainstaluj HQbird na każdym serwerze baz danych (tym samym skryptem, ale bez --enroll, albo pełnym instalatorem HQbird). Sprawdź, że fbagent działa.
Zapisz trzy wartości z agent_config.json fbagent. Są potrzebne do node.json:
Pole fbagent
Pole node.json
Przykład
local_api.listen
firebird.fbagent_url
http://127.0.0.1:13050
local_api.token
firebird.fbagent_token
—
local_api.instance_id
firebird.instance_id
—
Sprawdzenie fbagent (odpowiedź to JSON instancji Firebird):
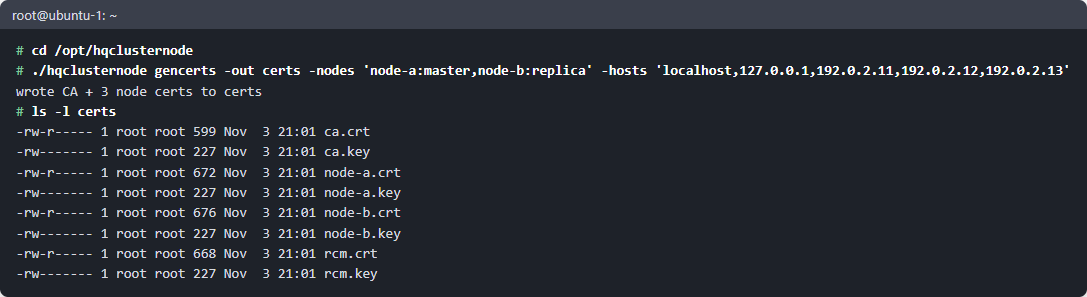
Polecenie tworzy ca.crt i ca.key, node-a.crt/.key, node-b.crt/.key oraz rcm.crt/.key. W -hosts wymień wszystkie nazwy i adresy, pod którymi uczestnicy będą osiągalni.
gencerts i pliki, które utworzył
ca.key to klucz CA. Nie kopiuj go na hosty; przechowuj osobno.
Nowy węzeł dodaje się później przez -add: podpisuje parę tą samą CA, a pozostałe pliki zostają bez zmian:
Certyfikaty są ważne 90 dni. gencerts -out certs -list pokazuje daty wygaśnięcia, a gencerts -out certs -renew odnawia je tym samym kluczem. Skopiuj nowy .crt na jego host: węzeł podejmie go bez restartu.
Skopiuj ca.crt oraz tylko własny certyfikat i klucz na każdy host.
Krok 4. Napisz node.json
Jeden plik na węzeł. Przykład dla mastera (node-a):
json
{"node_id":"node-a","role":"master","listen_addr":":7051","rcm":{"url":"https://<ip-rcm>:7443","ca_cert":"certs/ca.crt","client_cert":"certs/node-a.crt","client_key":"certs/node-a.key"},"firebird":{"root":"/opt/firebird","user":"SYSDBA","password":"<SYSDBA password>","port":3050,"replication_conf":"/opt/firebird/replication.conf","replication_log":"/opt/firebird/replication.log","firebird_log":"/opt/firebird/firebird.log","fbagent_url":"http://127.0.0.1:13050","fbagent_token":"<local_api.token>","instance_id":"<local_api.instance_id>","service_name":"<Firebird service name>"},"windows":{"restart_window":"22:00-05:00","transfer_window":"23:00-05:00"},"peers":[{"node_id":"node-b","url":"https://<ip-node-b>:7051","compress":"zstd"}]}
Węzeł replica (node-b) ma ten sam plik, ale z "role": "replica", własnymi certyfikatami i masterem node-a w peers.
Główne pola:
Pole
Wartość
node_id
nazwa węzła; ta sama w certyfikacie, w rcm.json i w peers innych węzłów
role
master albo replica
listen_addr
adres API węzła; drugi węzeł na tym samym hoście używa innego portu (:7052)
rcm.url
adres odbierania statystyk RCM; none — bez RCM
firebird.*
Firebird i fbagent tej instancji; wartości fbagent muszą zgadzać się dokładnie
firebird.auto_restart
czy węzeł replica może sam restartować Firebird: auto (domyślnie), never, always
windows.restart_window
okno restartu Firebird; dla mastera domyślnie 22:00-05:00, dla repliki zawsze
windows.transfer_window
okno, w którym inicjalizacja działa z pełną szybkością
peers
dla mastera — jego repliki, dla repliki — jej master
databases
folder baz danych; lepiej nie wpisywać go ręcznie, tylko ustawić przez RCM (rozdział 3)
Pozostałe pola mają wartości domyślne. Węzeł nie wystartuje, jeśli pola fbagent nie są ustawione.
Chroń plik: zawiera hasło i token.
Command
chmod 600 /opt/hqclusternode/node.json
W systemie Windows. Zapisuj ścieżki w formacie JSON: "C:\\HQbird\\replication.conf".
service_name to nazwa usługi Windows dla Firebird.
url — adres węzła widziany przez host RCM. Tylko https.
host — etykieta instancji Firebird. Węzeł master i węzeł replica z tą samą etykietą działają na tym samym Firebird (companion, potrzebny, aby promować replikę do mastera, rozdział 8). Jedna etykieta — nie więcej niż jeden master i jedna replica.
Ścieżki względne są rozwiązywane z folderu rcm.json.
Krok 6. Zarejestruj usługi
Kolejność startu: najpierw RCM, potem repliki, potem master.
cd /opt/hqclusternode
sudo ./hqclusternode svc install -config /opt/hqclusternode/node.json -certs /opt/hqclusternode/certs
sudo ./hqclusternode svc start -config /opt/hqclusternode/node.json
systemctl status hqclusternode-master-p3050
svc install tworzy usługę hqclusternode-<role>-p<port> działającą jako użytkownik firebird. Jeśli folder Firebird należy do root, polecenie nadaje grupie firebird prawo zapisu (z bitem sticky) i wypisuje każdą zmianę: węzeł musi podmienić replication.conf.
Dla svc start, svc stop i svc uninstall podaj ten sam node.json: nazwa usługi wynika z roli i portu Firebird.
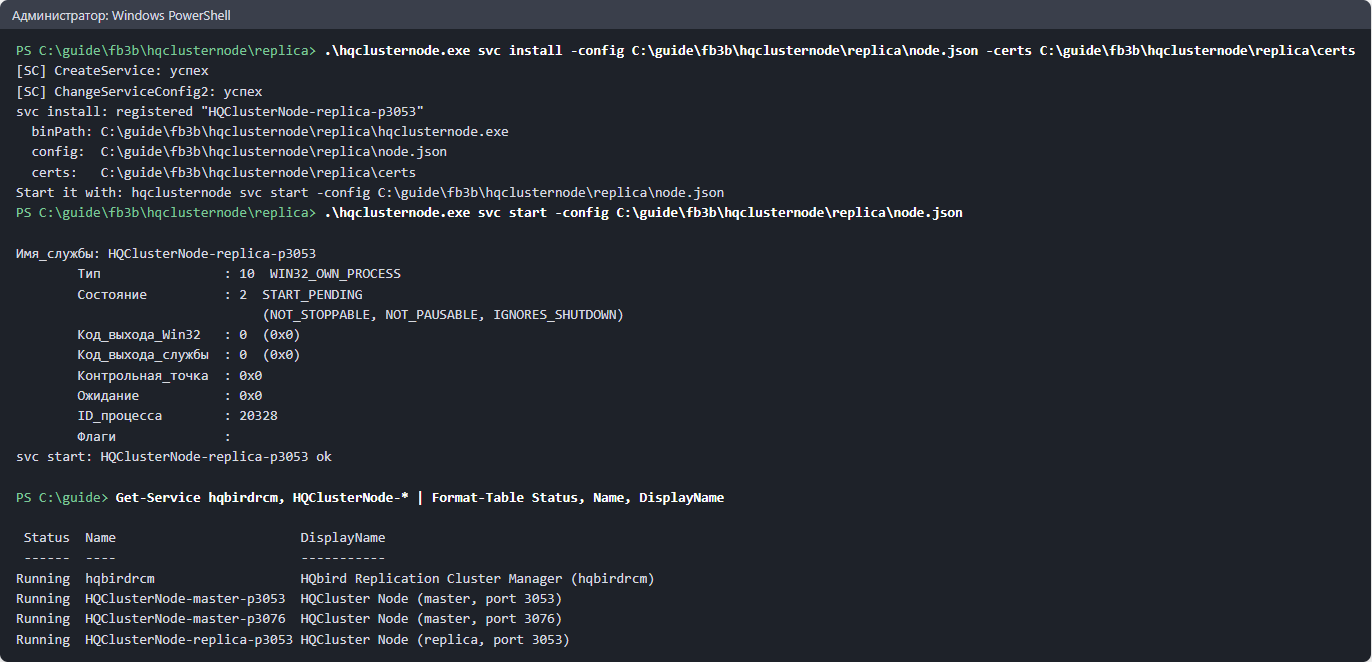
W systemie Windows (PowerShell jako administrator):
Command
cd C:\hqclusternode
.\hqclusternode.exe svc install -config C:\hqclusternode\node.json -certs C:\hqclusternode\certs
Usługa HQClusterNode-<role>-p<port> działa jako LocalSystem, startuje automatycznie i uruchamia się ponownie po awarii. Usługa węzła nie zależy od usługi Firebird. Jeśli węzeł został zainstalowany w wersji 2027.1.2–2027.1.9, usuń zależność raz:
.\hqclusternode.exe svc fix-deps -config C:\hqclusternode\node.json.
svc install i svc start w Windows
Krok 7. Otwórz porty
Na hoście węzła zezwól na połączenia przychodzące na 7051 (port listen_addr) z innych węzłów i z RCM. Na hoście RCM zezwól na połączenia przychodzące na 7443 ze wszystkich węzłów. Nie wystawiaj portów 7444 i 13050 na zewnątrz.
Przykład ufw na hoście węzła:
Command
sudo ufw allow from <ip-rcm> to any port 7051 proto tcp
sudo ufw allow from <ip-partner-node> to any port 7051 proto tcp
Konfiguracja i certyfikaty nie są przez to zmieniane.
1.5. Pierwsze logowanie do RCM
Adres i hasło zależą od sposobu instalacji RCM.
Jak zainstalowano RCM
Adres
Login i hasło
Przez instalator HQbird albo fbagent --cluster-init (1.3)
https://<host RCM>:7444 z dowolnego komputera
rcmadmin i hasło wypisane przez instalator (albo własne z --rcm-password-file)
Przez HQCenter Admin (1.2) albo ręcznie (1.4)
http://127.0.0.1:7444, tylko na hoście RCM
rcmadmin, hasło strong password (ze spacją)
HTTPS (1.3). Certyfikat RCM jest podpisany przez CA klastra, której przeglądarka nie zna, więc ostrzega. Na stronie logowania RCM pokazuje odcisk CA. Porównaj go z CA hash wypisanym przez instalator i zaimportuj CA do przeglądarki albo do systemu jako zaufany katalog główny: łącze Pobierz certyfikat CA na stronie logowania (https://<host RCM>:7444/ca.crt, plik hqcluster-ca.crt). Aby RCM nasłuchiwał tylko na localhost, ustaw "operator_addr": "127.0.0.1:7444" w rcm.json i uruchom RCM ponownie.
HTTP (1.2, 1.4). Z innego komputera połącz się przez tunel SSH:
Command
ssh -L 7444:127.0.0.1:7444 <rcm-host>
Potem otwórz http://127.0.0.1:7444 w przeglądarce.
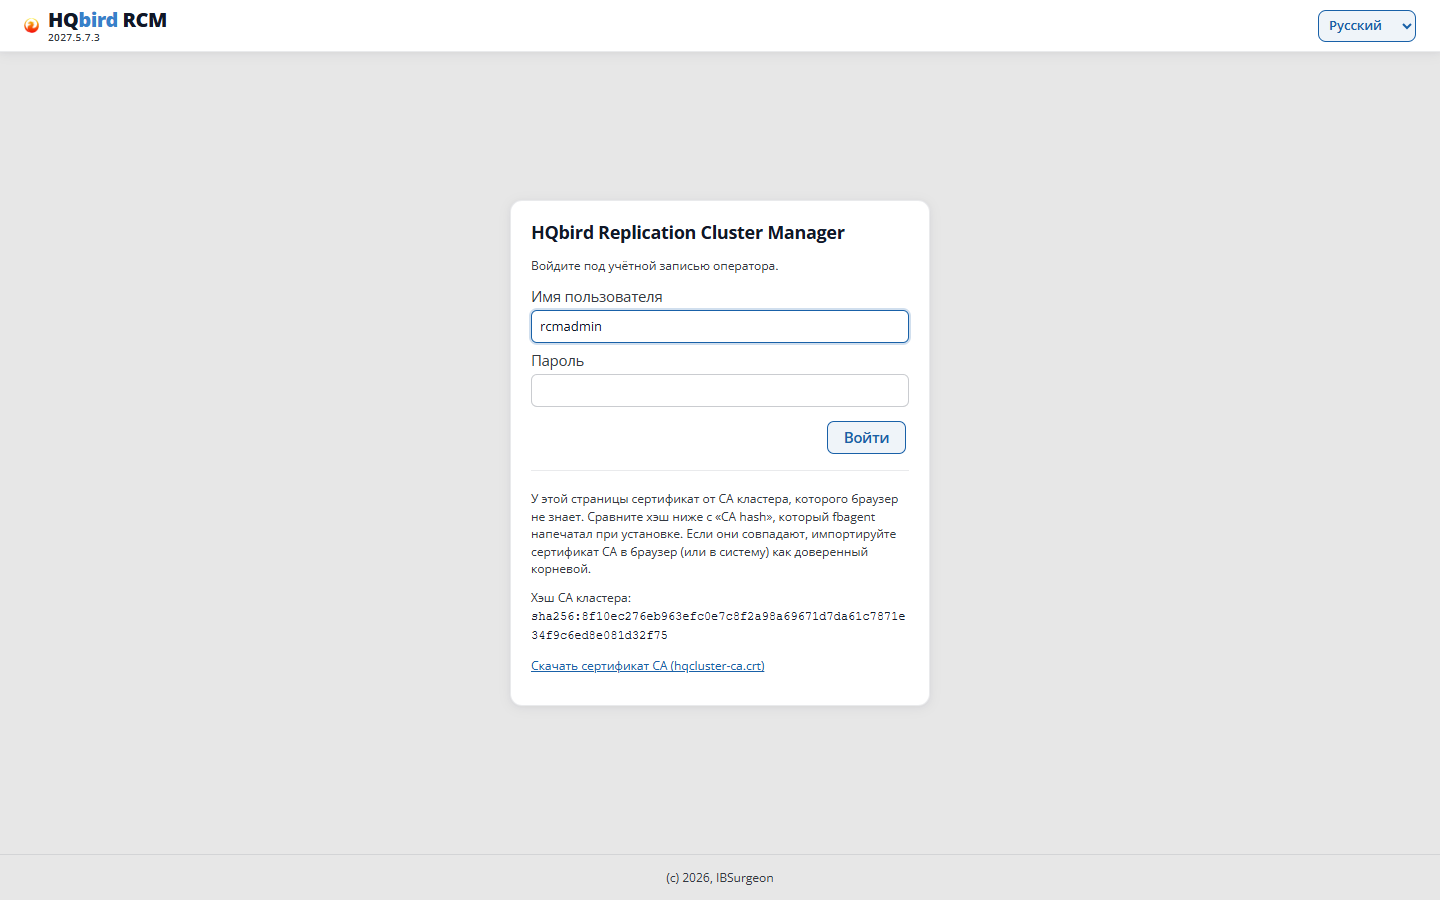
Strona logowania RCM
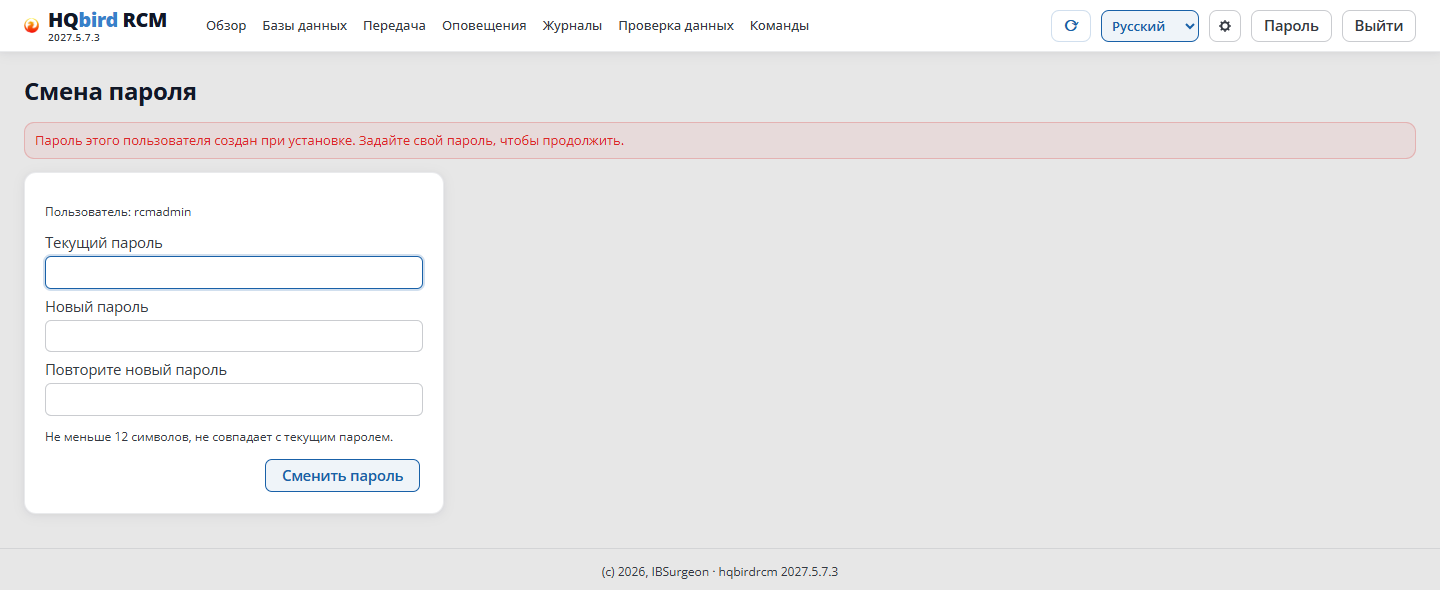
Wygenerowane hasło. RCM prosi o jego zmianę przy pierwszym logowaniu: dopóki go nie zmienisz, pozostałe strony się nie otworzą. Zmień strong passwordnatychmiast (łącze Hasło w nagłówku).
Zmiana hasła przy pierwszym logowaniu
Język. Wybierz rosyjski na liście języków w nagłówku strony (jest też na stronie logowania). Jeśli nic nie wybierzesz, język jest brany z przeglądarki.
Zmiana haseł i nowi użytkownicy
Każdy użytkownik zmienia własne hasło: łącze Hasło w nagłówku strony. Potrzebujesz obecnego hasła i nowego o długości co najmniej 12 znaków. Po zmianie pozostałe sesje tego użytkownika są zamykane.
Jeśli instalator wygenerował hasło, jest ono zapisane w pliku clusterca/<name>/rcm-initial-password w folderze fbagent. Po zmianie hasła fbagent sam usuwa ten plik. Nie usuwaj pliku initial-admin.json w folderze RCM: zawiera tylko skrót. Jeśli plik użytkowników zaginie, a tego pliku nie ma, RCM utworzy użytkownika z domyślnym hasłem.
Nowi użytkownicy. W interfejsie nie ma strony użytkowników. Użytkownicy są w pliku rcm-data/users.json. Hasło jest przechowywane jako skrót HA1: MD5("<name>:hqbirdrcm:<password>").
Uruchom RCM ponownie od razu: plik jest czytany tylko przy starcie. Gdy hasło jest zmieniane w interfejsie, RCM przepisuje plik z pamięci, a edycje, których jeszcze nie odczytał, przepadają.
Bez pola role użytkownik ma wszystkie uprawnienia. Od HQbird 2027.2.31 jest rola "role": "viewer": tylko podgląd, każde żądanie zmiany dostaje 403.
1.6. Jak sprawdzić instalację
Usługi węzła i RCM działają i nie restartują się w pętli:
systemctl status hqclusternode-master-p3050, systemctl status hqbirdrcm.
systemctl status węzła
systemctl status RCM
RCM odpowiada (bez hasła): curl http://127.0.0.1:7444/healthz. Przy
instalacji przez RCM (1.3) konsola działa po HTTPS:
curl -k https://127.0.0.1:7444/healthz.
W RCM strona Przegląd pokazuje wszystkie węzły, bez znacznika „nie
odpowiada”.
Z wiersza poleceń na hoście RCM:
Command
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm nodes
./hqbirdrcm status
Klaster przez RCM: Ustawienia → Klaster, sekcja Stan — każdy
członek zastosował najnowszą rewizję i nie zgłasza błędu. Z wiersza
poleceń: ./hqbirdrcm cluster status.
1.7. Dzienniki
Co
Gdzie
Dziennik węzła
<folder node.json>/logs/node-YYYYMMDD.jsonl
Wyjście usługi węzła (Linux)
journalctl -u hqclusternode-<role>-p<port>
Wyjście usługi RCM (Linux)
journalctl -u hqbirdrcm
Dziennik replikacji Firebird
firebird.replication_log z node.json
Dzienniki dowolnego węzła bez SSH
RCM, strona Dzienniki
1.8. Częste błędy
Co widzisz
Przyczyna
Co zrobić
Węzeł nie startuje: błąd o fbagent_url, fbagent_token albo instance_id
fbagent nie działa albo wartości nie zgadzają się z agent_config.json
sprawdź fbagent poleceniem curl z 1.4, krok 1
Skrypt instalacyjny zakończył się kodem 2
żądanie fbagent nie zostało zatwierdzone na czas
zatwierdź żądanie i uruchom skrypt ponownie
Węzły nie pojawiają się przez HQCenter Admin
fbagent nie jest w klastrze albo klaster nie został jeszcze pobrany
sprawdź klaster (rozdział 2), odczekaj do 10 minut
Węzeł w RCM jest „nie odpowiada”
port 7051 jest zamknięty, url w rcm.json jest błędny, adresu nie ma w certyfikacie
sprawdź porty i -hosts certyfikatów
Brak logowania do RCM: „Zbyt wiele nieudanych prób logowania”
token został już użyty, ma więcej niż 24 godziny albo został unieważniony
utwórz nowy token (1.3, „Ręcznie”, krok 4)
--cluster-join: hostname_conflict
w klastrze jest fbagent z tą samą nazwą hosta i innymi adresami
nadaj hostom różne nazwy
--cluster-join: this agent is in cluster … from goafts
fbagent jest już w klastrze HQCenter Admin
usuń go z klastra HQCenter Admin
Węzeł nie zainstaluje się przez RCM
RCM nie ma wydania dla tej platformy
hqbirdrcm release list, zaimportuj wydanie (1.3, „Ręcznie”, krok 5)
2. Konfiguracja klastra
W tym rozdziale określasz, które węzły są w klastrze i który master wysyła
segmenty do której repliki. Potem konfigurujesz węzły RCM i użytkowników.
Powiązania określa się na jeden z trzech sposobów:
Węzły zainstalowane
Gdzie określa się powiązania
Sekcja
przez HQCenter Admin
w HQCenter Admin: strona Clusters HQ Monitor albo API HQCenter Admin
2.2
przez RCM, bez HQCenter Admin
w RCM: Ustawienia → Klaster, hqbirdrcm cluster albo strona Clusters HQ Monitor
2.3
ręcznie
w RCM: Ustawienia → RCM i Ustawienia → Węzły
2.3
Na węzłach zainstalowanych przez HQCenter Admin albo przez RCM zmieniaj powiązania tylko w
opisie klastra. fbagent nadpisuje node.json i rcm.json według
opisu klastra. Edycja powiązań w Ustawienia → RCM albo Ustawienia → Węzły
RCM jest odrzucana (409 cluster_managed). Wcześniejsze wersje RCM to przyjmowały, ale zmiana
ginęła.
2.1. Role i schematy
Każdy węzeł ma jedną rolę: master albo replica. Dwa węzły — master i replica — mogą działać na jednej instancji Firebird.
Obsługiwane schematy:
Code
1 → 1        node-a (master) ──▶ node-b (replica)

1 → N        node-a ──▶ node-b
                    └─▶ node-c

N → 1        node-a ──┐
                      ├─▶ node-b    (one replica for several masters)
             node-x ──┘

Both nodes   host-1: node-1m (master) + node-1r (replica)  ← one Firebird
on a host    host-2: node-2m (master) + node-2r (replica)  ← one Firebird
             node-1m ──▶ node-2r,  node-2m ──▶ node-1r
Powiązanie zawsze idzie od mastera do repliki. RCM łączy bazę danych mastera z jej repliką po GUID bazy danych, a nie po nazwie węzła.
Companion. Węzeł master i węzeł replica na tej samej instancji Firebird to companiony. Promocja repliki do mastera (rozdział 8) działa tylko dla takiej pary. W rcm.json para jest oznaczona identyczną wartością host.
2.2. Powiązania przez HQCenter Admin
Gdzie opisać klaster
HQ Monitor, strona Clusters (tylko administratorzy; dostarczanie konfiguracji musi być włączone). Zwykły sposób.
API HQCenter Admin:POST /v1/admin/clusters i
PUT /v1/admin/clusters/{id}. Panel HQCenter Admin nie ma
strony klastrów.
``
Kroki na stronie Clusters
Wpisz Nowy identyfikator klastra (małe litery łacińskie, cyfry i -) i kliknij
Utwórz.
Dodaj członków (Członkowie). Dla każdego podaj:
fbagent hosta;
rolę: master, replica albo rcm;
adresy hosta;
port: dla węzła — 7051 (drugi węzeł na tym samym hoście — np. 7052),
dla RCM — port przyjmowania statystyk 7443.
Dodaj powiązania (Powiązania replikacji) od mastera do repliki.
Kliknij Sprawdź poprawność, potem Zapisz.
Jeśli inny administrator zmienił klaster w tym samym czasie, strona poprosi
o ponowne wczytanie klastra i powtórzenie zmiany.
Reguły
fbagent może należeć tylko do jednego klastra.
Na jednym fbagent — nie więcej niż jeden master, jedna replica, jeden RCM i
jeden router. Router (rola router, od HQbird 2027.2.30) nie ma powiązań i
nie zajmuje miejsca licencji (rozdział 8.7).
Klaster ma dokładnie jedno RCM. fbagent na hoście RCM prowadzi
urząd certyfikacji (CA) klastra.
Nazwa członka (member_id) — litery łacińskie, cyfry, -. Nazwy, fbagent i roli
członka nie można zmienić. Aby przenieść członka na inny host, utwórz
nowego członka z nową nazwą. Nie używaj starej nazwy ponownie.
Każda replica musi mieć powiązanie z masterem.
HQCenter Admin sam buduje adres węzła: https://<pierwszy adres>:<port>.
HQbird 2.5/3.0: ustaw datę replconf_valid_till klastra
(YYYY-MM-DD) — konfiguracja wtyczki replconf jest ważna do tej daty.
Przykład przez API
json
{"contract":1,"cluster_id":"shop-prod","name":"Shop","pki":"managed","cert_validity_days":90,"renew_before_days":30,"members":[{"member_id":"db1-m","agent_id":"<fbagent of host 1>","role":"master","addresses":["db1.lan"],"listen_port":7051},{"member_id":"db1-rcm","agent_id":"<fbagent of host 1>","role":"rcm","addresses":["db1.lan"],"listen_port":7443},{"member_id":"db2-r","agent_id":"<fbagent of host 2>","role":"replica","addresses":["db2.lan"],"listen_port":7052}],"links":[{"from":"db1-m","to":"db2-r"}]}
Utworzenie: POST /v1/admin/clusters (dokument można wysłać razem z
członkami). Zastąpienie całego dokumentu: PUT /v1/admin/clusters/{id}.
PUT wymaga nagłówka If-Match: <revision> (rewizję podają GET i ETag).
Bez nagłówka — 428, ze starą rewizją — 409, z błędem w dokumencie —
422 z listą błędów.
POST /v1/admin/clusters/{id}/validate sprawdza dokument bez zapisu.
GET /v1/admin/clusters/{id}/status pokazuje stan członków i daty
wygaśnięcia certyfikatów.
Co się dzieje po zapisaniu
fbagent każdego członka otrzymuje klaster. W klastrze — sprawdzenie co
60 sekund (fbagent na hoście RCM — co 30 sekund). Poza klastrem fbagent
dowiaduje się o klastrze przy następnym odpytaniu konfiguracji. Jeśli to odpytanie nie
dotrze do serwera, sprawdzenie odbywa się co 10 minut.
Każdy fbagent tworzy klucz i wysyła żądanie certyfikatu. fbagent na
hoście RCM je podpisuje. RCM podpisuje własny certyfikat bez żądania.
fbagent zapisuje do node.json: nazwę, rolę, adres, peers (z powiązań),
adres RCM, ścieżki certyfikatów, dane Firebird i fbagent. Do rcm.json: listę
węzłów (nodes), listę routerów (routers), adres przyjmowania statystyk i
ścieżki certyfikatów. fbagent nie rusza pozostałych pól plików.
fbagent instaluje i uruchamia usługi (rozdział 1).
zatrzymuje i usuwa usługę; cluster-managed.json → cluster-removed.json, program → *.removed; konfiguracja, certyfikaty i dane pozostają
Po usunięciu węzła jego sekcja
# BEGIN managed-by:<name> … # END … zostaje we wspólnym replication.conf. Usuń ją ręcznie i uruchom ponownie
Firebird przez RCM.
Zatwierdzanie certyfikatów klastra
Domyślnie fbagent na hoście RCM sam podpisuje żądania (auto). Można włączyć zatwierdzanie
ręczne. Polecenia na hoście RCM:
Command
fbagent --cluster-ca-approval manual # or autofbagent --cluster-status # this fbagent's membership in the cluster (JSON)fbagent --cluster-ca-approve <request_id>
W trybie manual nowy członek albo nowy klucz czeka na zatwierdzenie. Odnowienie
certyfikatu ze znanym kluczem jest podpisywane automatycznie.
2.3. Powiązania przez RCM
Klaster RCM (bez HQCenter Admin)
Jeśli klaster utworzył instalator HQbird albo polecenie fbagent --cluster-init
(rozdział 1.3), opis klastra przechowuje RCM. Najprościej dodać hosty na
stronie Ustawienia → Połącz hosty (rozdział 1.3, „Połącz hosty w RCM”):
RCM samo tworzy członków i powiązania. Reguły są takie jak w HQCenter Admin (2.2, „Reguły”), plus:
w RCM jest jeden klaster; członek rcm zawsze istnieje i nie można go usunąć;
nie więcej niż 3 miejsca (hosty z węzłami master albo replica), inaczej występuje błąd
seats_exceeded;
członka można dodać tylko na fbagent, który połączył się z RCM
(rozdział 1.3: „Połącz hosty” albo „Ręcznie”, krok 4).
Kroki na stronie Ustawienia → Klaster:
W tabeli Agenci kliknij Dodaj członka w wierszu fbagent.
Podaj rolę (master, replica albo router), member_id, adresy i port.
Strona proponuje nazwę <host>-<role> i port: 7051 dla pierwszego węzła fbagent,
7061 dla drugiego. Port zajęty już przez innego członka hosta RCM odrzuca. Adresy
fbagent to przyciski: kliknij, aby dodać adres.
W sekcji Powiązania kliknij Dodaj powiązanie od mastera do repliki.
Kliknij Sprawdź poprawność: RCM pokaże błędy i ostrzeżenia.
Kliknij Zapisz. Strona pokaże listę zmian i poprosi o
potwierdzenie. Jeśli członkowie są usuwani, okno jest czerwone.
Przed zapisem zmiany istnieją tylko na stronie (etykieta „Niezapisane”). Jeśli
ktoś zapisał klaster w tym samym czasie, strona zaproponuje ponowne wczytanie.
Jeśli zmieniły się tylko pola RCM (rewizja, CA, zlecenia), strona zapisze
twoją zmianę sama.
Inne sekcje strony:
Sekcja
Co tam jest
nagłówek
nazwa klastra, rewizja, CA klastra i CA agenta; przycisk Eksportuj dla starej CA
Tokeny połączenia
utwórz token dla nowego fbagent, unieważnij nieużyty
Dokument JSON
cały dokument w polu tekstowym; Sprawdź poprawność i Zapisz go używają
Klucze i CA
zlecenia: nowy klucz członka (rekey), nowa CA klastra (rotate_ca), nowa CA agenta (rotate_agent_ca); niedostępne, gdy są niezapisane zmiany
Stan
rewizja zastosowana przez każdego członka, wygaśnięcie certyfikatu, usługa, ostatni błąd
Z wiersza poleceń na hoście RCM:
Command
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster show > c.json # document with revision# edit c.json./hqbirdrcm cluster validate -f c.json # validate without saving anything./hqbirdrcm cluster apply -f c.json # save (If-Match = revision from the file)./hqbirdrcm cluster agents # connected fbagents and their members./hqbirdrcm cluster status # what the fbagents reported
Format dokumentu jest jak w 2.2, „Przykład przez API”. apply ze starą rewizją
dostaje 409: uruchom show ponownie. RCM trzyma ostatnie 20 rewizji w
rcm-data/cluster/history/.
HQ Monitor. Strona Clusters działa też z RCM. Na hoście RCM
HQ Monitor sięga do RCM przez fbagent tego hosta, certyfikatem fbagent:
użytkownik RCM i hasło nie są potrzebne. W dzienniku audytu RCM takie
działania są zapisywane jako agent:<id> (<user>). Inny sposób, dla wcześniejszych
wersji RCM: w konfiguracji HQ Monitor ustaw rcm_admin_url
(http://127.0.0.1:7444), rcm_admin_user (użytkownik RCM) i
rcm_admin_password_file (plik z jego hasłem).
Po zapisaniu wszystko przebiega jak przez HQCenter Admin (2.2, „Co się dzieje po
zapisaniu”). RCM sam wczytuje ponownie nodes w rcm.json, bez restartu.
Usuń fbagent z klastra: usuń jego członków i zapisz, potem
kliknij Unieważnij w tabeli Agenci (albo
./hqbirdrcm cluster revoke -agent <id>). Aby go przywrócić, potrzebny jest nowy
token. Po unieważnieniu fbagent (od wersji 3.1.0) sam opuszcza klaster:
zatrzymuje swoje węzły i usuwa dane klastra. To samo na hoście
węzła robi polecenie fbagent --cluster-leave. Na hoście RCM jest odrzucane.
Instalacja ręczna: dodaj węzeł do RCM
Ustawienia → RCM, tabela Podłączone węzły.
Kliknij Dodaj węzeł. Wypełnij node_id, url
(https://<adres>:7051), rolę, host (etykieta instancji Firebird),
server (tylko do grupowania na ekranie).
Kliknij Sprawdź poprawność w wierszu węzła: RCM sprawdzi połączenie i uprawnienia.
Kliknij Zapisz. RCM zapisze rcm.json i zachowa stary plik jako
rcm.json.<czas UTC>.bak (ostatnie 20).
Uruchom RCM ponownie. Do restartu obowiązuje stara konfiguracja;
strona pokazuje, które pola czekają na restart.
Ustawienia → RCM
Command
sudo systemctl restart hqbirdrcm
Możesz to zrobić też bez interfejsu: edytuj rcm.json i uruchom RCM ponownie.
Instalacja ręczna: powiąż mastera i replikę
Powiązanie trzeba zapisać po obu stronach:
Ustawienia → Węzły, wybierz węzeł master.
W sekcji Partnerzy kliknij Dodaj partnera: node_id repliki, jej url,
kompresja (zstd).
Kliknij Zapisz. RCM pokaże listę zmian i poprosi o
potwierdzenie. Zmiana peers wchodzi w życie natychmiast.
Powtórz dla węzła replica: jego partnerem jest master.
Sekcja Partnerzy węzła master
Jeśli partner nie jest zapisany po jednej ze stron, RCM nie zaproponuje tego węzła replica przy
inicjalizacji bazy danych.
2.4. Ustawienia węzła
Ustawienia → Węzły pokazuje ustawienia node.json, które węzeł pozwala zmieniać z RCM. Zapisywane są tylko zmienione pola, po oknie z listą zmian.
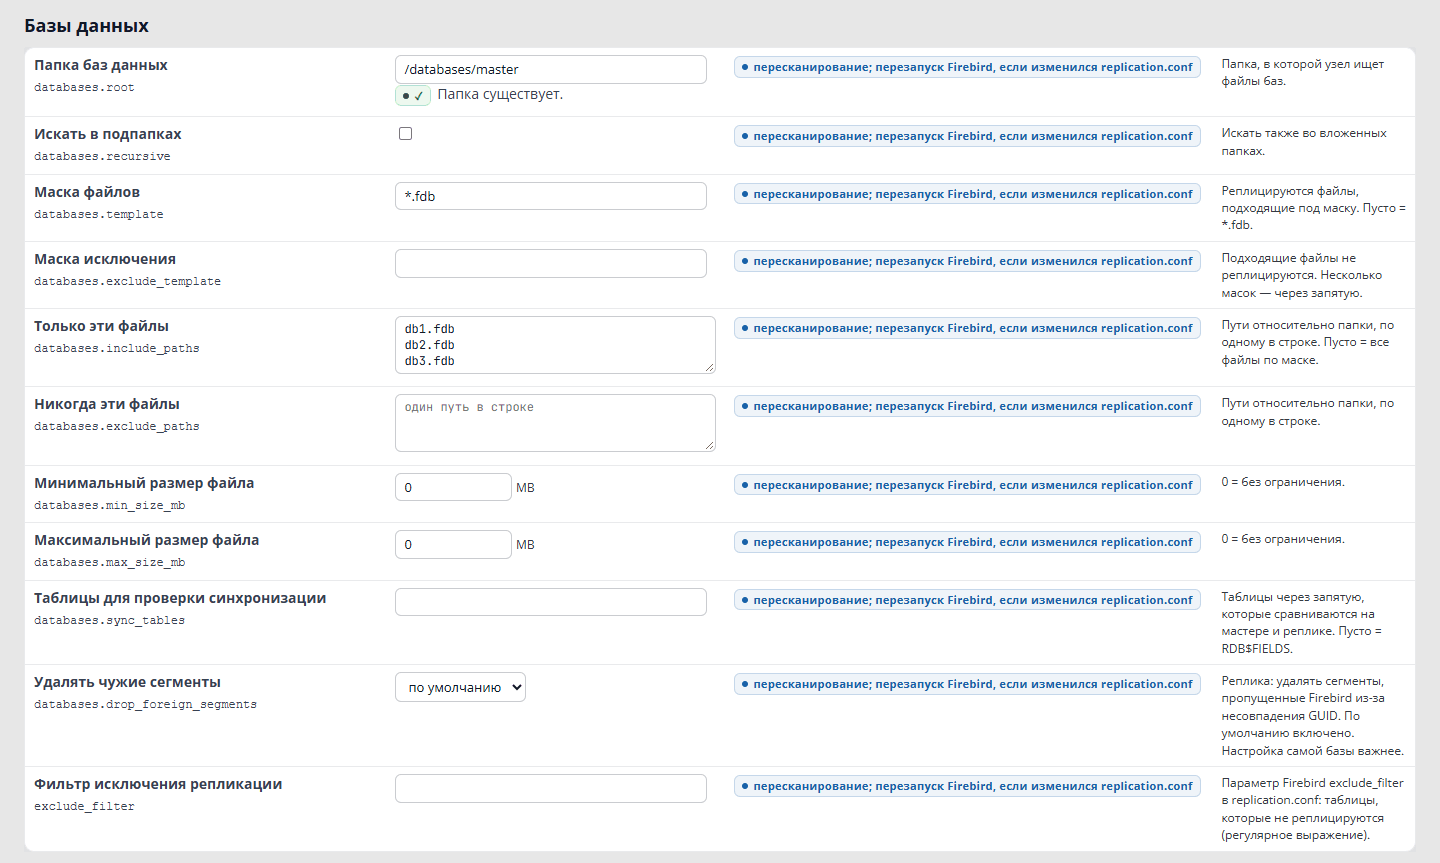
Ustawienia → Węzły: wybór węzłaUstawienia baz danych węzła ze znacznikami „po skanie”
Każdy wiersz jest oznaczony tym, kiedy zmiana wejdzie w życie:
Kiedy
Które ustawienia
Natychmiast
channel_a_mbps, channel_a_burst_mbps, windows.restart_window, peers; od HQbird 2027.2.24 — ustawienia kontroli danych (limits.data_check_*); od HQbird 2027.2.31 — advertise_addr
Po restarcie węzła
pozostałe limity, windows.transfer_window; strona pokazuje je w osobnym wierszu, dopóki węzeł nie zostanie uruchomiony ponownie
Po skanie
databases.*, exclude_filter; jeśli replication.conf się zmienił, potrzebny jest restart Firebird (rozdział 3.5)
Tylko do odczytu (zmieniane w node.json na hoście węzła): firebird (w tym hasło i auto_restart), rcm, tls, segments, adres listen_addr.
Główne ustawienia:
Ustawienie
Domyślnie
Znaczenie
windows.restart_window
master 22:00-05:00, replica — zawsze
kiedy węzeł może restartować Firebird; Firebird mastera nigdy nie restartuje się sam
windows.transfer_window
23:00-05:00
okno, w którym inicjalizacja działa z szybkością reinit_window_mbps
limits.channel_a_mbps
50
szybkość transferu segmentów, MB/s (channel_a_burst_mbps — krótki szczyt, 200)
limits.reinit_window_mbps
100
szybkość inicjalizacji w oknie transferu, MB/s
limits.reinit_day_disk_fraction
0.5
ułamek zmierzonej szybkości dysku dla inicjalizacji poza oknem
limits.retention_days
2
ile dni trzymać wysłane segmenty w archiwum mastera
limits.free_space_floor_gb
1
minimalne wolne miejsce, GB; poniżej tego replica nie przyjmuje segmentów
limits.max_concurrent_reinits
1
ile inicjalizacji węzeł wykonuje równocześnie
Szczegóły szybkości i przechowywania archiwum są w rozdziałach 5 i 7.
firebird.auto_restart (tylko w node.json) określa, czy węzeł replica może sam restartować Firebird:
Wartość
Zachowanie
auto (domyślnie)
może, jeśli ten Firebird nie obsługuje baz danych mastera
never
nigdy
always
zawsze, nawet jeśli ten Firebird ma bazy danych mastera
Przez HQCenter Admin.windows.transfer_window węzła fbagent jest też oknem restartu samej usługi węzła, gdy klaster się zmienia. Jeśli okno nie jest ustawione w node.json, fbagent restartuje usługę natychmiast.
2.5. Kilka instancji HQbird na jednym hoście
fbagent restartuje usługi wymienione w firebird.update.services swojej
konfiguracji. Pusta lista oznacza wszystkie usługi HQbird na hoście. Zostaw na liście tylko
usługę własnej instancji. Węzeł nie widzi tego ustawienia i zapisuje
ostrzeżenie fbagent_shared do dziennika, jeśli fbagent zna więcej niż jedną instancję.
2.6. Hasło SYSDBA
Węzeł łączy się z Firebird użytkownikiem i hasłem z firebird.user i
firebird.password w node.json. fbagent trzyma własną kopię hasła. Jeśli
zmieniłeś hasło SYSDBA:
Popraw firebird.password w node.jsonkażdego węzła tej
instancji (master i replica).
Popraw hasło w konfiguracji fbagent i wczytaj ją ponownie (zobacz
dokumentację fbagent).
Uruchom ponownie usługi węzłów.
Inaczej strony publikacji i weryfikacji w RCM pokażą błąd logowania
(SQLSTATE 28000).
2.7. Użytkownicy RCM i audyt
Użytkownicy są w pliku rcm-data/users.json (rozdział 1.5). Bez roli
użytkownik ma wszystkie prawa; rola viewer (od HQbird 2027.2.31) — tylko podgląd.
Sesja trwa 12 godzin po ostatniej czynności.
Po 10 nieudanych logowaniach w ciągu 5 minut logowanie tego użytkownika i adresu jest
tymczasowo blokowane. Udane logowanie zeruje licznik.
Dziennik audytu to plik rcm-data/audit.jsonl: jeden wiersz JSON na każdą
zmianę, logowanie i wylogowanie. W interfejsie nie ma dziennika audytu.
Strona Polecenia pokazuje autora każdego polecenia.
2.8. Licencja
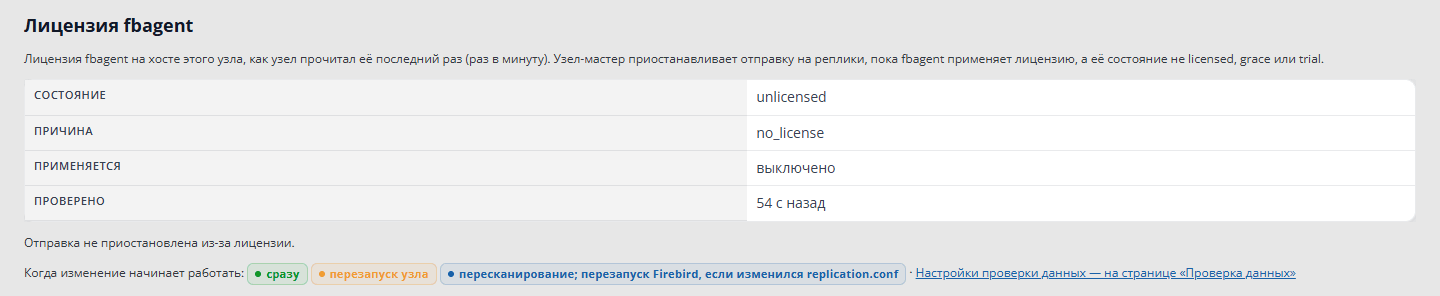
Raz na minutę węzeł master czyta licencję fbagent swojego hosta. Jeśli licencji nie ma (okres próbny się skończył, licencja wygasła albo jest nieważna), węzeł przestaje wysyłać segmenty dla wszystkich baz danych mastera. Firebird i bazy danych nadal działają, ale repliki przestają dostawać zmiany.
Co widać w RCM:
master jest czerwony (NEEDS_ATTENTION), z plakietką „brak licencji: wysyłka zatrzymana”;
nie ma przycisku Wznów: pauzę zdejmuje tylko licencja;
na replice: „nie odbiera od …: master nie ma licencji”;
w tabeli Węzły plakietka „brak licencji”; w Ustawienia → Węzły blok licencji fbagent;
alerty license_paused i license_pause_archive_released;
inicjalizacja jest zabroniona (license_paused).
Blok licencji fbagent w Ustawienia → Węzły
Zainstaluj licencję w fbagent. Węzeł sam zdejmie pauzę w ciągu minuty. Master trzyma archiwum dla replik przez limits.retention_days (domyślnie 2 dni) od początku pauzy. Jeśli zainstalujesz licencję później, repliki trzeba będzie zainicjalizować ponownie.
Klaster przez RCM, bez HQCenter Admin. Licencja pływająca bez HQCenter Admin przestaje działać po online_check_days plus dni karencji. Każdy fbagent w klastrze potrzebuje licencji powiązanej (fbagent --license-request, potem fbagent --license-install, rozdział 1.3, „Licencja”). Po okresie próbnym fbagent nie doda nowego węzła ani RCM bez funkcji cluster w licencji; aktualizacji nigdy nie zabrania. Dla HQbird 2.5/3.0 data replconf_valid_till w RCM nie może być późniejsza niż koniec licencji plus dni karencji na węzłach fbagent (błąd replconf_after_license).
2.9. Jak sprawdzić
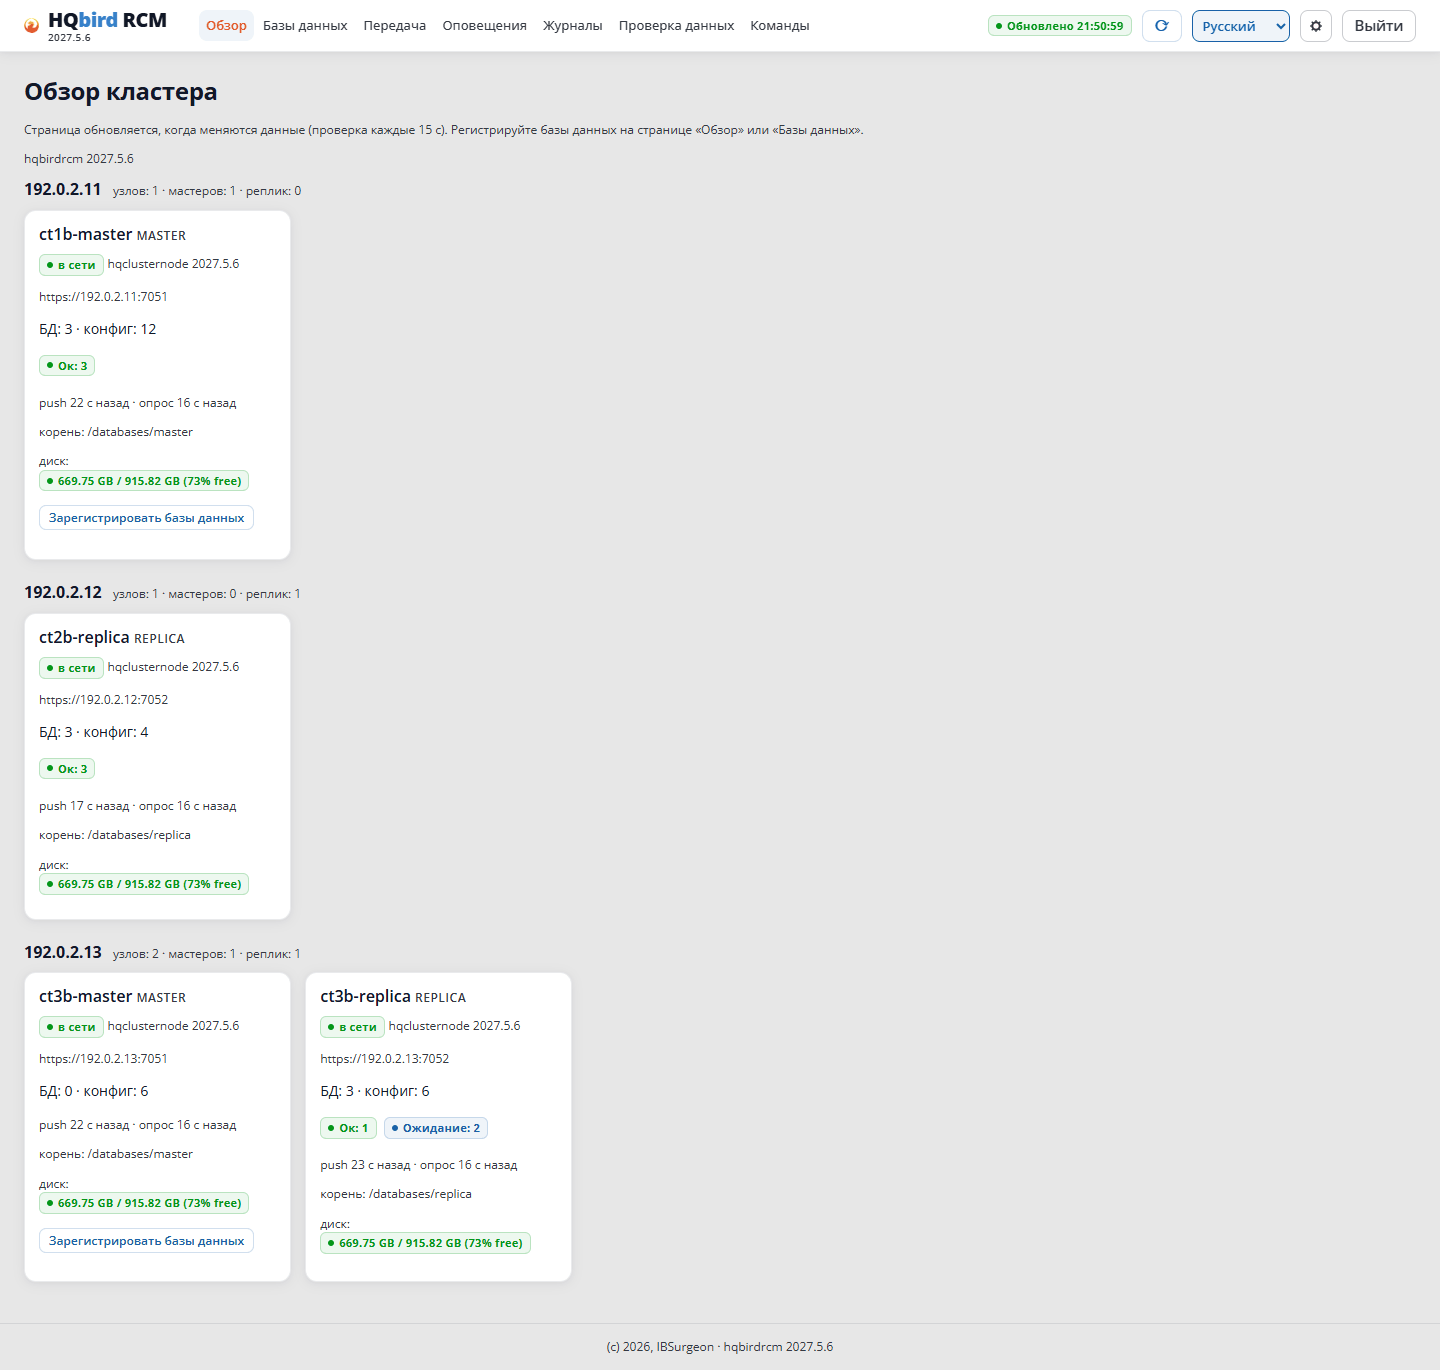
Przegląd: wszystkie węzły są obecne i pogrupowane według serwera.
Przegląd klastra
Ustawienia → Węzły: master ma replikę w Partnerzy, a replica ma mastera.
Ustawienia → RCM: przycisk Sprawdź w wierszu każdego węzła przechodzi.
Raport klastra jako jeden plik:
Command
./hqbirdrcm report -o report.json
2.10 Częste błędy
Co widzisz
Przyczyna
Co zrobić
Edycja partnerów w RCM odrzucona (409 cluster_managed) albo utracona po restarcie węzła
węzeł został zainstalowany przez HQCenter Admin albo przez RCM
zmień powiązania w opisie klastra (2.2, 2.3)
seats_exceeded przy zapisie klastra w RCM
węzły na czwartym hoście
nie więcej niż 3 hosty z węzłami
Ustawienia → RCM: rcm_config_read_only
klaster przez RCM w Linux: rcm.json należy do fbagent
edytuj rcm.json jako użytkownik fbagent i uruchom RCM ponownie
Unieważnij agenta nie działa (agent_has_members)
fbagent ma członków
najpierw usuń członków i zapisz
Węzeł replica nie jest proponowany podczas inicjalizacji
partner nie jest zapisany po jednej ze stron
dodaj partnera po obu stronach (2.3)
Zmiana w Ustawienia → RCM nie wchodzi w życie
RCM nie został uruchomiony ponownie
uruchom RCM ponownie
422 przy zapisie klastra w HQCenter Admin
błąd w dokumencie
popraw według listy errors, sprawdź przez validate
409 przy zapisie klastra
klaster zmienił ktoś inny
wczytaj klaster ponownie i spróbuj jeszcze raz
Nowy członek klastra HQCenter Admin nie dostaje certyfikatu
ręczne zatwierdzanie na hoście RCM
fbagent --cluster-ca-approve <id>
Błąd SQLSTATE 28000 na stronach publikacji
hasło SYSDBA zostało zmienione
2.6
3. Dodawanie bazy danych do mastera
W tym rozdziale baza danych mastera przechodzi pod kontrolę węzła. Węzeł zapisuje ją w
replication.conf i tworzy foldery na segmenty. Po restarcie Firebird
baza danych jest gotowa do replikacji.
Utworzenie repliki to kolejne kroki (publikacja, inicjalizacja). Są opisane w
rozdziałach 4–6.
Nazwy przycisków podano według rosyjskiego interfejsu RCM, z angielskimi w nawiasach.
3.1. Jak węzeł odkrywa bazy danych
Węzeł master szuka baz danych w jednym folderze — katalogu głównym baz (databases.root). O tym, co przechodzi pod zarząd, decydują reguły:
Reguła
Pole
Domyślnie
Folder baz danych
root
nieustawiony
Przeszukiwanie podfolderów
recursive
tak
Maska włączenia
template
*.fdb
Maska wyłączenia
exclude_mask
brak
Rozmiar pliku, MB
min_size_mb, max_size_mb
bez limitów (0)
Tabele do porównania danych
sync_tables
z HQbird 2027.2.24 — tabele z publikacji bazy danych, jeśli ich nie ma — RDB$FIELDS; w 2027.5.7 — RDB$FIELDS
Lista włączenia
include_paths
pusta (tryb szablonu)
Lista wyłączenia
exclude_paths
pusta
Ścieżka root to ścieżka na hoście węzła, nie na hoście RCM. Węzeł stosuje najpierw maskę włączenia, potem maskę wyłączenia, potem rozmiar.
Reguły są takie same dla całego węzła. Lista sync_tables też jest wspólna: kontrola (rozdział 5.10) szuka każdej tabeli z listy w każdej bazie danych węzła, która nie ma własnej listy.
Tabele do porównania, z HQbird 2027.2.24. Każda baza danych może mieć własną listę (Tabele śledzenia synchronizacji). Węzeł trzyma ją w databases.sync_tables_by_db. Kontrola bierze pierwszą ustawioną listę:
własną listę bazy danych;
wspólną listę sync_tables węzła;
tabele z publikacji bazy danych;
RDB$FIELDS.
Wspólna lista zapisana wcześniej ma pierwszeństwo przed publikacją: baza danych bez własnej listy jej używa. Strona bazy danych mastera pokazuje, która lista właśnie obowiązuje (3.3).
Tabela nieobecna zarówno w bazie podstawowej, jak i w replice dostaje stan „nie ma w bazie danych” (absent): nie jest porównywana, a kontrola nie pokaże przez nią „Nie OK”. Tabela brakująca tylko po jednej stronie to rozbieżność.
RCM i węzeł 2027.5.7. Jest jedna lista dla całego węzła (sync_tables); bez listy kontrola używa RDB$FIELDS. Brakująca tabela to błąd, a kontrola bazy danych pokaże „Nie OK”.
Wszystkie reguły są w node.json węzła. Węzeł stosuje je przy każdym skanie.
Tryb szablonu i tryb listy:
Tryb szablonu (lista włączenia pusta): węzeł bierze wszystkie pliki pasujące do maski, oprócz wyłączonych. Nowy plik w folderze węzeł podejmie automatycznie przy następnym skanie.
Tryb listy (lista włączenia niepusta): węzeł bierze tylko pliki z listy. Nowy plik nie przejdzie pod zarząd automatycznie — trzeba go dodać.
Wybierz tryb listy, jeśli folder zawiera kopie baz danych, bazy testowe albo inne pliki, których nie trzeba replikować.
3.2. Zanim zaczniesz: sprawdź uprawnienia
Użytkownik, jako który działają Firebird i węzeł (firebird w Linux,
LocalSystem w Windows), musi mieć prawo odczytu i zapisu do:
folderu głównego baz danych i plików baz danych;
replication.conf i jego folderu (węzeł podmienia plik przez plik tymczasowy);
folderów segmentów <database>.ReplLog i <database>.LogArch (węzeł tworzy je sam).
RCM sprawdza uprawnienia przed rejestracją (preflight). Jeśli kontrola się nie uda,
polecenie kończy się błędem preflight failed on <node> i listą ścieżek.
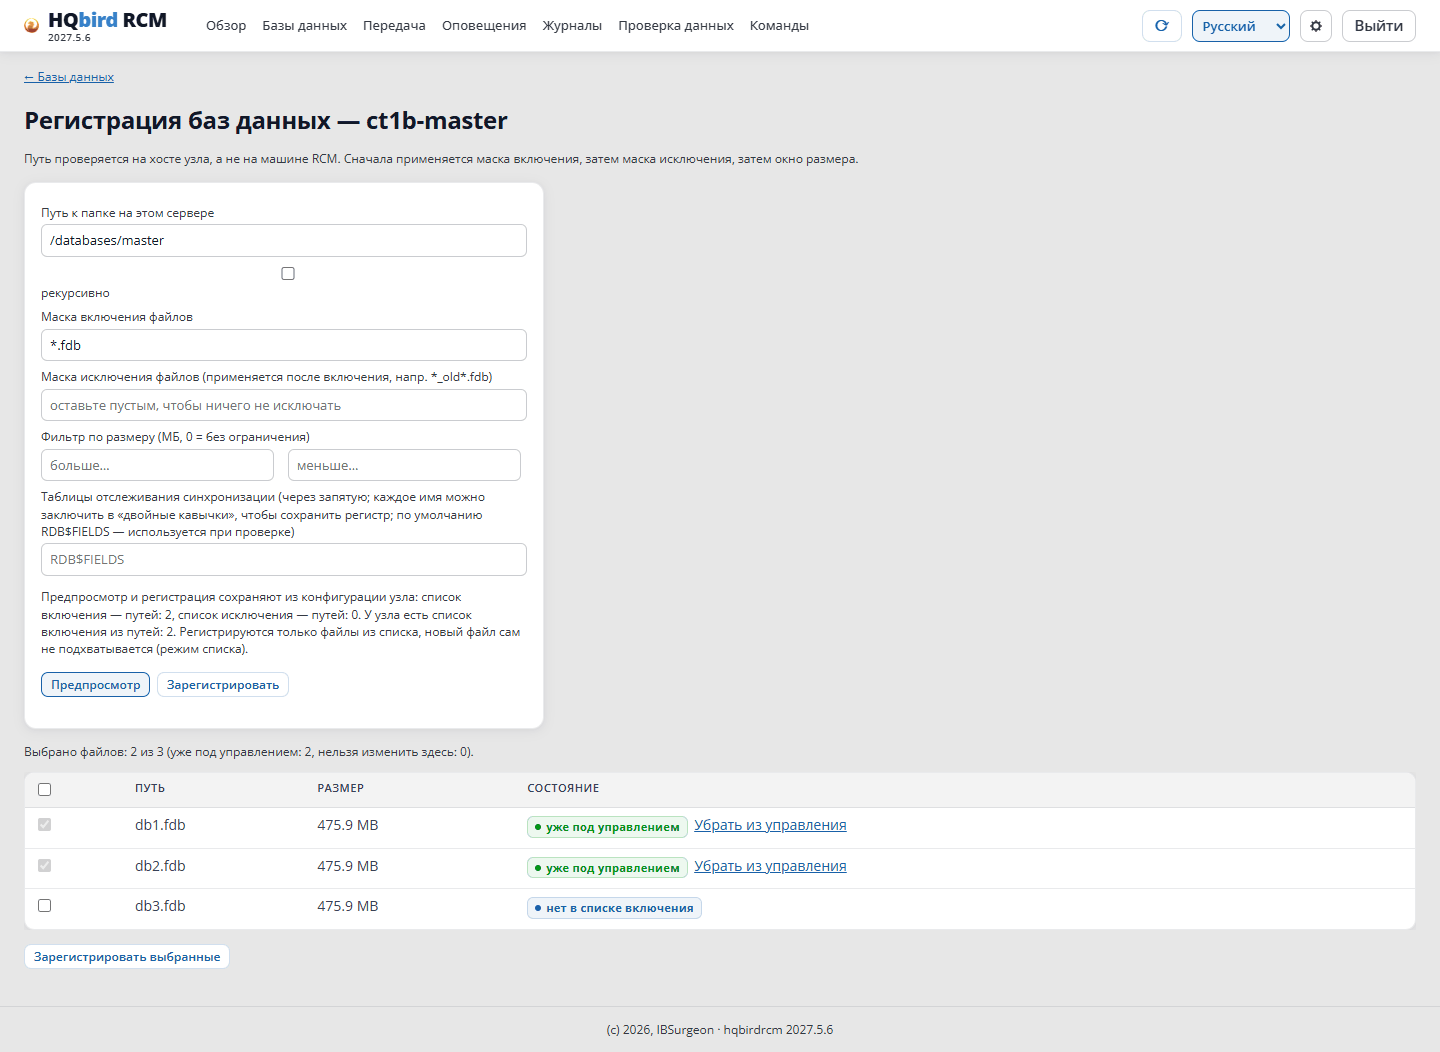
Otwórz stronę rejestracji węzła master. Łącze jest w dwóch miejscach:
Bazy danych → tabela Węzły → kolumna działań →
Zarejestruj;
Przegląd → karta węzła master → Zarejestruj bazy danych.
Węzeł replica nie ma tej strony.
Formularz pokazuje bieżące reguły węzła (węzeł sam je wysłał). Jeśli węzeł
nie odpowiada, przyciski podglądu i rejestracji są wyłączone: bez bieżących
reguł zresetowałyby listy włączenia i wyłączenia.
Wypełnij albo popraw pola: Ścieżka do folderu na tym serwerze,
recursive, maski, Filtr rozmiaru, Tabele śledzenia
synchronizacji.
Pole Tabele śledzenia synchronizacji:
z HQbird 2027.2.24 i później — lista jest na bazę danych, którą ta czynność
zarejestruje. Puste pole: baza danych używa tabel własnej publikacji. Rejestracja nie zmienia wspólnej
listy węzła (sync_tables). Jeśli ona istnieje, formularz o tym mówi: baza danych bez własnej listy używa jej
zamiast publikacji.
Listę już zarządzanej bazy danych ustawia się na jej stronie: Bazy danych →
baza danych mastera → blok Tabele śledzenia synchronizacji. Blok
pokazuje, która lista właśnie obowiązuje. Puste pole usuwa własną
listę bazy danych;
w RCM i węźle 2027.5.7 — jedna lista dla wszystkich baz danych węzła
(sync_tables).
Kliknij Podgląd. Węzeł pokaże wszystkie pliki pasujące do maski
włączenia. Nic nie zmienia.
Sprawdź listę. Każdy plik ma pole wyboru:
zaznaczone — plik będzie pod zarządem;
zaznaczone, zablokowane, oznaczone już pod zarządem — baza danych jest już
zarejestrowana;
zablokowane z powodem — plik jest wyłączony maską, rozmiarem albo listą wyłączenia.
Aby go wziąć, zmień regułę.
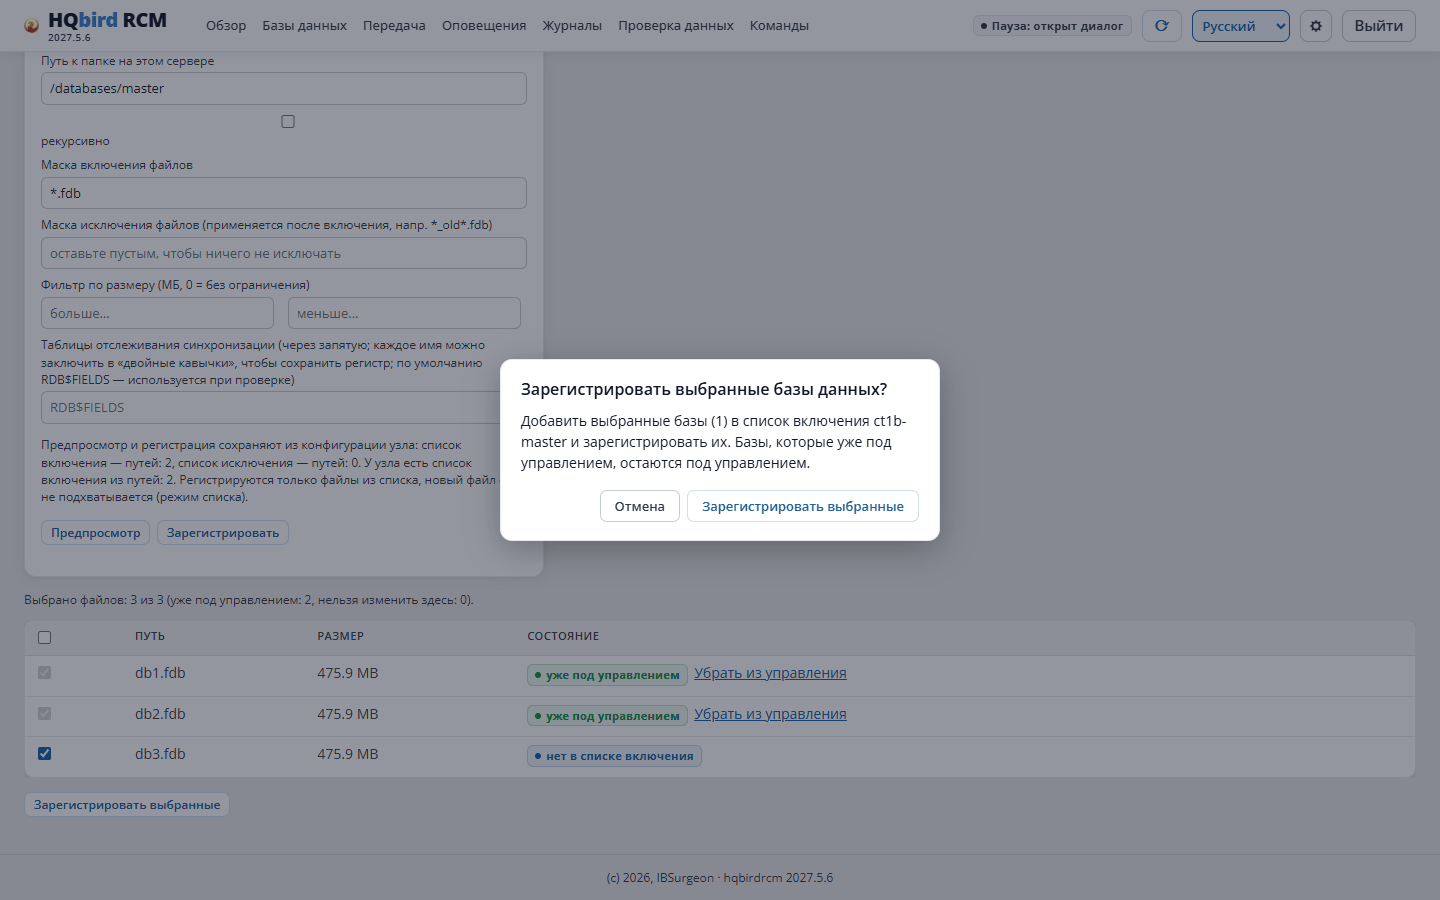
Zaznacz potrzebne bazy danych i kliknij Zarejestruj
wybrane. RCM poprosi o potwierdzenie i pokaże liczbę plików.
Potwierdzenie rejestracji
Co robi ten przycisk:
w trybie szablonu — pliki bez zaznaczenia są dodawane do listy wyłączenia, pliki z
zaznaczeniem są z niej usuwane;
w trybie listy — pliki z zaznaczeniem są dodawane do listy włączenia.
Przycisk dodaje bazy danych do tych, które już są pod zarządem. Nie zmienia
zablokowanych wierszy.
7. Przycisk Zarejestruj stosuje formularz bez zmiany
list.
8. Poczekaj na komunikat ukończenia i liczbę dodanych baz danych. Jeśli długo
nie ma odpowiedzi, sprawdź wynik na stronie Polecenia.
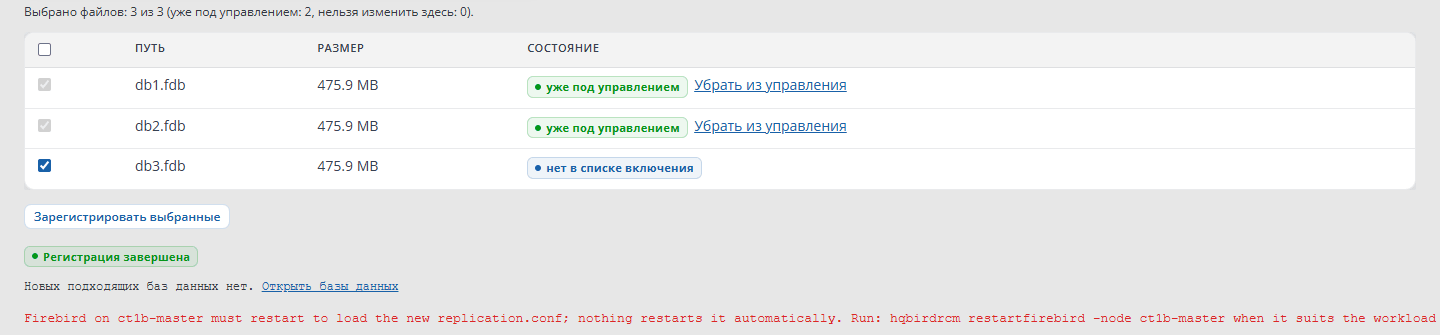
Z HQbird 2027.2.24 i później komunikat to „Zarejestrowano: N”. Jeśli Firebird mastera
trzeba zrestartować, RCM mówi, który przycisk nacisnąć (zwykle
Uruchom ponownie Firebird mastera w wierszu bazy danych) i podaje łącze do baz danych mastera.
RCM 2027.5.7 może powiedzieć „Brak nowych odpowiednich baz danych”, choć bazy danych
zostały dodane: sprawdź stronę Bazy danych.
Wynik rejestracji
Jeśli po rejestracji nie znaleziono baz danych, a węzeł już je miał, węzeł
odmawia (409) i zwraca stare reguły. W ten sposób pomyłka w ścieżce nie wyłącza
replikacji wszystkich baz danych.
Uwaga: polecenie wysyła tylko pola ze swoich parametrów. Pozostałe
reguły (maski, rozmiary, listy włączenia i wyłączenia, sync_tables) zostaną przez
węzeł zresetowane. Polecenie nie ma parametrów dla tych reguł. Przed
uruchomieniem sprawdź bieżące reguły (hqbirdrcm getconfig -node node-a). Jeśli
są ustawione, użyj strony rejestracji.
3.4. Co się dzieje po rejestracji
Węzeł zapisuje reguły do node.json.
Węzeł skanuje folder (scansync).
Dla każdej znalezionej bazy danych węzeł zapisuje blok we własnym obszarze
replication.conf (między wierszami # BEGIN managed-by:node-a role:master i
# END …) i tworzy foldery <database>.ReplLog oraz <database>.LogArch. Węzeł nie zmienia tekstu poza własnym obszarem.
Przed zmianą węzeł zapisuje kopię pliku:
replication_YYYYMMDD_hhmmss_NNN.conf.
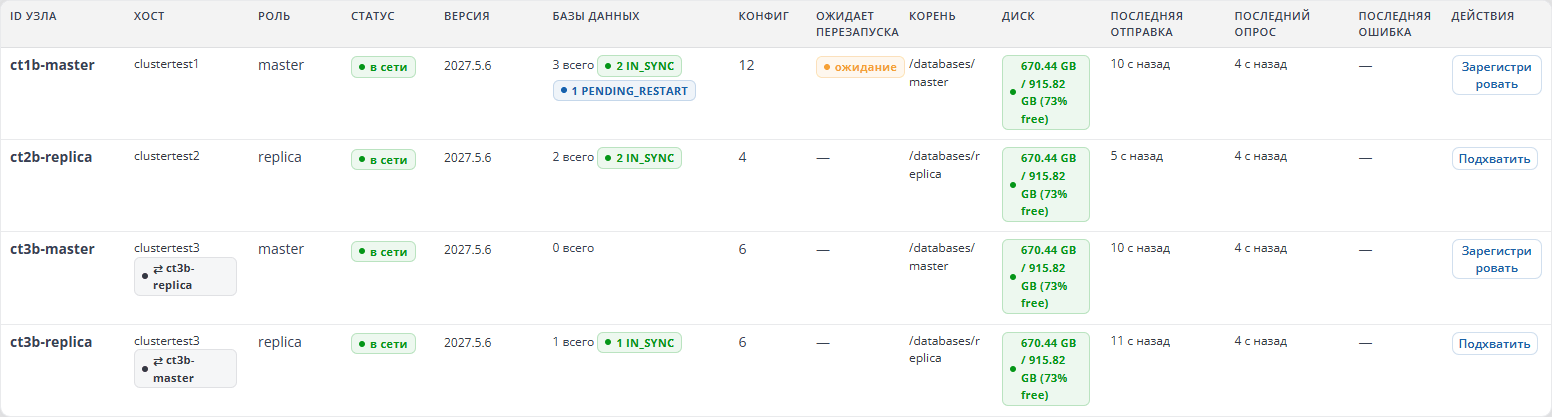
Jeśli replication.conf się zmienił, bazy danych wchodzą w
stan PENDING_RESTART: Firebird odczyta nowy plik dopiero po
restarcie. W tabeli Węzły widać to w kolumnie Oczekuje na
restart.
Kolumna „Oczekuje na restart” w tabeli „Węzły”
Stany nowej bazy danych:
Stan
Grupa w RCM
Znaczenie
UNCONFIGURED
Oczekujące
baza danych znaleziona, konfiguracja jeszcze nie zapisana
PENDING_RESTART
Oczekujące
konfiguracja zapisana, wymagany restart Firebird
CONFIGURED
Oczekujące
Firebird zrestartowany, baza danych gotowa do publikacji i inicjalizacji
3.5. Restart Firebird mastera
Węzeł master nigdy nie restartuje Firebird sam. RCM też nie. Restart
mastera to decyzja operatora: restart zrywa wszystkie połączenia do
wszystkich baz danych tej instancji Firebird.
Wybierz czas małego obciążenia i kliknij jeden z przycisków:
Uruchom ponownie Firebird mastera — na stronie Bazy danych, w wierszu
mastera bazy danych, która czeka na restart;
ten sam przycisk w oknie Inicjalizuj, rozdział 5;
Uruchom ponownie Firebird — na stronie bazy danych.
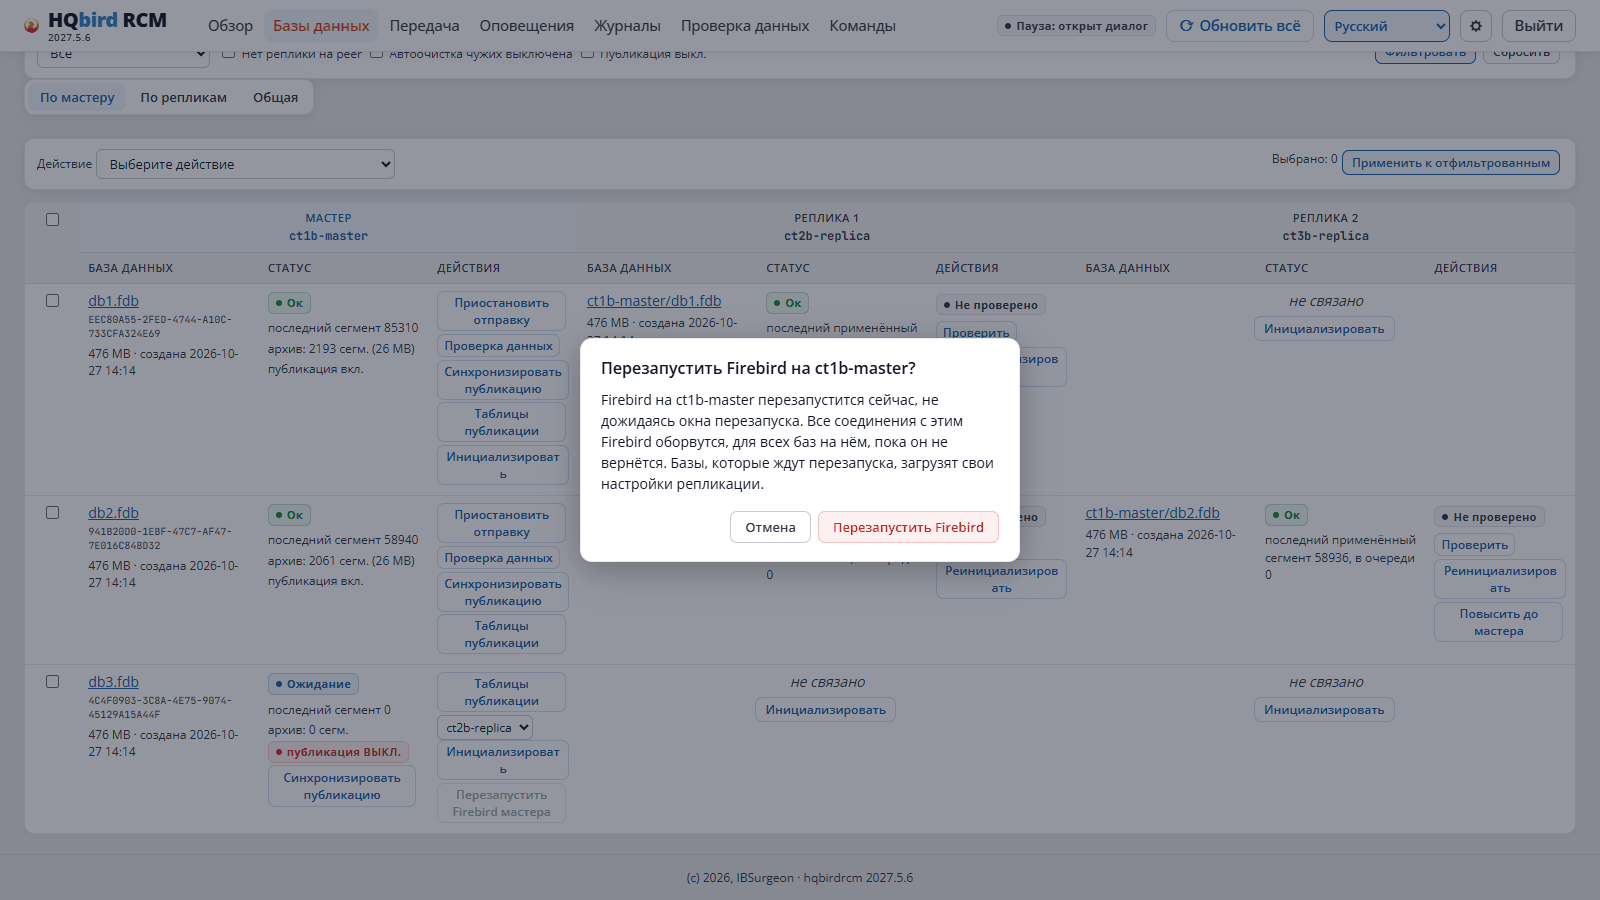
RCM poprosi o potwierdzenie. Pokazuje nazwę węzła i ostrzeżenie: Firebird
zrestartuje się natychmiast, bez okna restartu, a wszystkie połączenia zostaną zerwane.
Potwierdzenie restartu Firebird mastera
To samo z wiersza poleceń
Command
hqbirdrcm restartfirebird -node node-a
To polecenie też restartuje natychmiast, bez okna restartu.
Jak węzeł restartuje Firebird:
Sprawdza, że fbagent odpowiada i zarządza tą samą instancją
(identyfikator, port, nazwa usługi z node.json). Jeśli jakakolwiek wartość się nie
zgadza, węzeł odmawia.
Prosi fbagent o restart Firebird.
Czeka, aż Firebird odpowie na swoim porcie.
Przenosi bazy danych z PENDING_RESTART do CONFIGURED.
Kilka instancji HQbird na jednym hoście. fbagent restartuje usługi wymienione w
firebird.update.services swojej konfiguracji. Pusta lista oznacza wszystkie
usługi HQbird na hoście. Jeśli na hoście są dwie instancje HQbird, zostaw
na liście tylko usługę swojej instancji. Inaczej restart jednego węzła
zatrzyma też drugą instancję.
W systemie Windows. Jeśli replication.log urósł do log_portion_mb albo więcej,
restart przebiega tak: zatrzymaj Firebird → zarchiwizuj dziennik → uruchom.
3.6. Baza danych już replikowana ręcznie
Jeśli replikacja bazy danych jest już skonfigurowana ręcznie (własny blok w
replication.conf, publikacja włączona, segmenty płyną), można ją objąć
zarządem bez ponownej inicjalizacji repliki. Do tego jest tryb
detect_existing (tylko master).
W odpowiedzi taken_over wymienia bazy danych, które zostaną zmigrowane. Dodaj -verbose,
aby zobaczyć pominięte bazy danych z powodem.
Jeśli lista jest poprawna, uruchom polecenie bez -dry-run.
Węzeł migruje blok tylko wtedy, gdy:
foldery segmentów nazywają się dokładnie <database>.ReplLog i <database>.LogArch;
w archiwum są już segmenty;
publikacja w bazie danych jest włączona.
Węzeł nie migruje bloku z innymi ścieżkami i zgłasza go jako „znaleziony, ale
nieobsługiwany”.
Po migracji bazy danych dostają PENDING_RESTART, choć ustawienia replikacji
się nie zmieniają: zmienia się tylko pozycja bloku w pliku. Zrestartuj Firebird w
oknie serwisowym.
3.7. Jak sprawdzić
Bazy danych: baza danych jest widoczna w wierszu węzła master, stan CONFIGURED
(po restarcie).
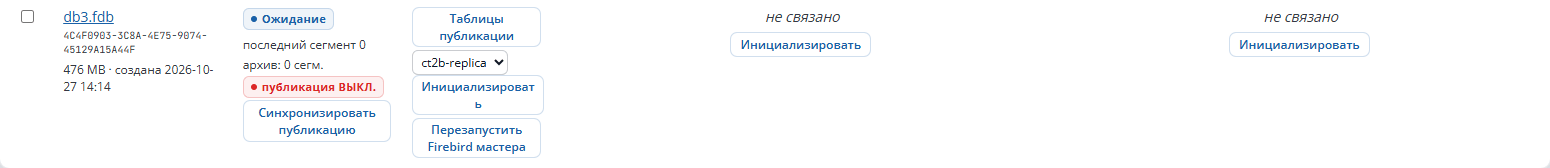
Obok bazy danych może być ikona publikacja WYŁ.: publikacja nie jest
jeszcze włączona. To normalne, publikacja to następny krok (rozdział 6).
Nowa baza danych w wierszu mastera
Na hoście węzła: blok bazy danych jest w replication.conf wewnątrz obszaru
managed-by:node-a, a obok bazy danych są foldery .ReplLog i .LogArch.
3.8. Usuń bazę danych z zarządzania
Zwykły sposób to przycisk. Na stronie Bazy danych zaznacz bazy danych,
wybierz działanie zbiorcze Usuń z zarządzania i
kliknij Zastosuj do wybranych. RCM:
dodaje pliki do listy wyłączenia węzła;
skanuje folder raz: bloki baz danych są usuwane z replication.conf;
usuwa rekordy baz danych w węźle.
Pliki baz danych i foldery segmentów zostają na dysku. Firebird nie jest restartowany.
Firebird nadal zapisuje segmenty bazy danych do następnego restartu;
RCM powie, czy restart jest potrzebny.
RCM odmówi (has_replicas) dla bazy danych mastera, która ma żywą replikę:
inaczej replica zatrzymałaby się po cichu. Najpierw zrób z repliki zwykłą bazę danych albo
ją usuń (rozdział 8).
Nie usuwaj bloku bazy danych z replication.conf ręcznie: przy następnym
skanie węzeł zapisze go ponownie.
Jeśli plik bazy danych zniknął albo został wyłączony regułą. Wtedy baza danych dostaje
stan ORPHANED (grupa Osierocone). Węzeł trzyma jej rekord i archiwum
segmentów: brakująca baza danych częściej jest pomyłką niż decyzją. Jeśli plik wróci, baza danych
znowu działa, a alert jest kasowany. Aby usunąć taką bazę danych na stałe,
wykonaj dwa kroki w tej kolejności:
Po forgetdatabase polecenie cleanuparchive nie znajdzie już bazy danych. Oba
polecenia działają tylko dla bazy danych w stanie ORPHANED i nie ruszają pliku
bazy danych.
Uwaga. Po promocji repliki do mastera (rozdział 8) nie uruchamiaj
cleanuparchive -orphaned dla starego rekordu: nowy master używa tego samego
folderu .LogArch, a polecenie usunie jego działające archiwum.
3.9. Zmiana katalogu głównego baz
Rejestracja z inną ścieżką jest dozwolona. Węzeł:
dodaje bazy danych z nowego folderu;
przenosi bazy danych ze starego folderu, których nie ma w nowym, do ORPHANED (powiadomienie
orphaned_database) i trzyma ich archiwa.
Jeśli wybrałeś zły folder, zarejestruj poprawny folder ponownie. Baza danych z tą
samą pełną ścieżką nadal działa pod tym samym db_id. Baza danych pod inną ścieżką
to nowa baza danych (nowe db_id); jej replikę trzeba zainicjalizować ponownie.
3.10. Częste błędy
Co widzisz
Przyczyna
Co zrobić
preflight failed on node-a
brak uprawnień do folderów
popraw uprawnienia, spróbuj ponownie (3.2)
409 scan_would_empty_region
nowy folder nie zawiera baz danych, a węzeł je miał
sprawdź ścieżkę i maskę
Podgląd jest pusty
maska nie pasuje albo folder jest zły
sprawdź ścieżkę, maskę, „recursive”
Przyciski są wyłączone, „Nie udało się odczytać konfiguracji węzła”
węzeł nie odpowiada
sprawdź usługę węzła i sieć (rozdział 1)
Baza danych długo zostaje w PENDING_RESTART
master nie restartuje Firebird sam
zrestartuj Firebird (3.5)
Restart odrzucony z powodu fbagent
fbagent nie działa albo jego dane nie zgadzają się z node.json
rozdział 1, sprawdzanie fbagent
Nowy plik się nie pojawił
węzeł jest w trybie listy
dodaj plik przez „Zarejestruj wybrane”
4. Jak zrobić z bazy danych replikę: kroki i lokalizacja na dysku
Ten rozdział obejmuje całą drogę bazy danych od podstawowej do działającej repliki oraz obliczenie miejsca na dysku. Sama inicjalizacja jest szczegółowo opisana w rozdziale 5.
4.1. Główna zasada
Baza danych pojawia się na replice tylko przez inicjalizację z mastera (reinit):
sam węzeł master przekazuje kopię przez nbackup.
Nie rób kopii ręcznie:
gbak tworzy nowy GUID bazy danych i zeruje numer segmentu. Powiązanie master —
replica się zrywa.
Kopia pliku działającej bazy danych nie jest spójna, a RCM zobaczy dwie bazy danych z tym samym
GUID (duplicate_guid) i zabroni inicjalizacji.
Już działającą replikę skonfigurowaną ręcznie można objąć
zarządem bez nowej kopii — zobacz 4.6.
4.2. Etapy
Nr
Etap
Gdzie
Stan bazy danych mastera po etapie
1
Rejestracja bazy danych na masterze
rozdział 3.3
PENDING_RESTART
2
Restart Firebird mastera
rozdział 3.5
CONFIGURED
3
Synchronizacja publikacji
rozdział 6
CONFIGURED, publikacja WŁ.
4
Przygotowanie repliki: folder, uprawnienia, wersja Firebird
4.3
—
5
Sprawdzenie wolnego miejsca na masterze i na replice
4.4
—
6
Inicjalizacja
rozdział 5
SEEDING → IN_SYNC
7
Restart Firebird repliki (jeśli potrzebny)
rozdział 5.6
replica zaczyna stosować segmenty
8
Weryfikacja danych
rozdział 5.10
—
Etap 3 jest obowiązkowy dla Firebird 4/5. Bez publikacji Firebird mastera nie zapisuje
zmian tabel do segmentów, a replica po cichu zostaje w tyle za masterem. Na
stronie Bazy danych taka baza danych jest oznaczona ikoną publikacja WYŁ.. Kliknij
Synchronizuj publikację przed inicjalizacją.
Od HQbird 2027.2.24 okno Inicjalizuj o tym ostrzega i
oferuje przycisk Synchronizuj publikację i inicjalizuj, a węzeł master
odmawia inicjalizacji błędem publication_off (rozdział 5.1).
RCM i węzeł 2027.5.7 nie sprawdzają publikacji.
HQbird 2.5/3.0. Nie ma publikacji, więc etap 3 jest pomijany. Zestaw tabel określają
filtry wtyczki replconf (rozdział 6).
Stany bazy danych:
Stan
Grupa w RCM
Znaczenie
CONFIGURED
Oczekujące
Firebird odczytał ustawienia, repliki jeszcze nie ma
PUBLISHING
Oczekujące
trwa synchronizacja publikacji
SEEDING
Oczekujące
trwa inicjalizacja
IN_SYNC
Ok
replica odebrała wszystkie segmenty
LAGGING
Oczekujące
replica jest w tyle, segmenty są w kolejce
NEEDS_REINIT
Błąd
replikę trzeba zainicjalizować ponownie
FAILED
Błąd
ostatnia inicjalizacja się nie udała
4.3. Przygotowanie repliki
Folder bazy danych repliki
Węzeł replica umieszcza każdą bazę danych we własnym folderze databases.root pod ścieżką:
Code
<databases.root>/<master node name>/<database path relative to the master root>
Przykład: master node-a z katalogiem głównym /databases/master i bazą danych
/databases/master/sales/employee.fdb. Na replice node-b z katalogiem głównym
/databases/replica baza danych będzie tutaj:
Code
/databases/replica/node-a/sales/employee.fdb
Dzięki temu bazy danych o tych samych nazwach z różnych masterów się nie zderzają.
Nikt nie tworzy folderu głównego automatycznie — ani instalator, ani HQCenter Admin, ani węzeł przy
starcie. Utwórz go w jeden z tych sposobów:
w oknie Inicjalizuj: pole Folder repliki, przycisk
Utwórz folder. Przycisk jest widoczny tylko wtedy, gdy folder nie istnieje. Z HQbird 2027.2.24,
jeśli węzeł replica nie ma jeszcze databases.root, pole już zawiera
/databases/replica/<id węzła replica>. Dla repliki w Windows pole jest puste:
wpisz folder z literą dysku. Każdy węzeł replica na tym samym hoście potrzebuje własnego
folderu. Folder tworzy węzeł
replica: właściciel — firebird (albo użytkownik usługi węzła), uprawnienia
2770. Jeśli węzeł nie może go utworzyć, okno pokaże polecenie dla hosta repliki.
Jeśli podasz inny folder, RCM zapisze go w databases.root węzła replica przed inicjalizacją;
Bit setgid (2770) jest potrzebny, aby wszystkie pliki wewnątrz dostały grupę Firebird.
Katalog główny repliki można zmienić tylko wtedy, gdy nie ma w nim baz danych: inaczej stare bazy danych
wypadną poza skan. Aby umieścić jedną bazę danych w innym miejscu, użyj
Przenieś na stronie bazy danych.
Uprawnienia
Węzeł replica i Firebird muszą móc pisać do katalogu głównego baz. Węzeł sprawdza, że
umieszczone pliki dostaną grupę folderu. Jeśli nie może — odmawia z
ownership_unfixable i tekstem, jak to naprawić (zwykle usługa węzła działa z
Group=root).
Z HQbird 2027.2.24 okno Inicjalizuj pokazuje też folder, który
istnieje, ale do którego usługa węzła nie może pisać: tekst węzła z poleceniem naprawy
i przycisk Sprawdź ponownie. RCM 2027.5.7 mówi wtedy
„Folder istnieje”: sprawdź uprawnienia sam (hqbirdrcm checkpermissions -node <replica> -root <folder>).
Wersja Firebird
Główna wersja Firebird na replice musi zgadzać się z masterem (5.0 → 5.0,
4.0 → 4.0). Inaczej replica odmówi przed jakimkolwiek transferem danych:
incompatible_engine.
Łączność
Węzeł replica musi być peerem mastera, a master peerem repliki (rozdział 2).
Inaczej RCM nie zaproponuje tego węzła w oknie Inicjalizuj.
4.4. Ile miejsca jest potrzebne
W skrócie
Gdzie
Co
Ile
Master, wolumen bazy danych
wolne przed inicjalizacją
≥ 105 % rozmiaru bazy danych
Replica, wolumen folderu baz
wolne przed inicjalizacją
≥ 105 % rozmiaru bazy danych, z HQbird 2027.2.24 — plus free_space_floor_gb (plus stary plik, jeśli replica już istniała; z polem Usuń starą replikę — bez niego)
Master, <database>.ReplLog
robocze segmenty Firebird
do 64 segmentów × rozmiar segmentu (domyślnie 16 MB) ≈ 1 GB na bazę danych
Master, <database>.LogArch
archiwum segmentów dla replik
zmiany przez retention_days (domyślnie 2 dni) + to, czego repliki jeszcze nie potwierdziły
Replica, <database>.Incoming
kolejka segmentów do zastosowania
do 256 segmentów × 16 MB ≈ 4 GB na bazę danych w najgorszym przypadku
Replica, cały wolumen
zapas
co najmniej free_space_floor_gb (domyślnie 1 GB)
Sprawdzanie miejsca przed inicjalizacją
Inicjalizacja sprawdza miejsce dwa razy i tylko przed zablokowaniem bazy danych:
RCM — z najnowszych statystyk węzła, przed wysłaniem polecenia. Jeśli miejsca
wyraźnie brakuje, RCM od razu zwraca błąd 507.
Węzeł master — żywy pomiar na własnym wolumenie, potem żądanie do repliki, aby
zmierzyła swój. Jeśli choć po jednej stronie jest za mało, inicjalizacja
kończy się na kroku SPRAWDZENIE MIEJSCA błędem
insufficient disk space on master albo … on replica.
Wymaganie po obu stronach to 105 % rozmiaru bazy danych mastera.
Z HQbird 2027.2.24 węzeł replica liczy tak:
potrzebuje 105 % rozmiaru bazy danych plusfree_space_floor_gb repliki (7.3):
po inicjalizacji na wolumenie zostaje zapas na segmenty;
resztki poprzednich inicjalizacji (<database>.hqcluster-part, <database>.new)
liczą się jako wolne miejsce: węzeł usuwa je przed nową kopią;
tekst błędu podaje wszystkie liczby. Podaje też pliki
<database>.pre-reinit-*.fdb i <database>.failed-seed-*.fdb z ich rozmiarem. Węzeł
nigdy ich nie usuwa: usuń je sam, jeśli nie są potrzebne.
force (wymuszone) pomija tylko kontrolę w RCM. Kontroli węzła
nie da się obejść: chroni węzeł przed końcem miejsca w trakcie kopiowania.
Jeśli miejsca brakuje tylko przez starą kopię repliki, RCM 2027.2.24 w
błędzie 507 podaje pole Usuń starą replikę, a nie force. Do tego
oba węzły muszą być HQbird 2027.2.24 albo nowsze. Inaczej błąd podaje
węzeł do aktualizacji i force.
Dlaczego tyle
Master. Podczas kopiowania baza danych jest zablokowana przez nbackup -L. Wszystkie
zmiany są zapisywane do pliku <database>.delta obok bazy danych. Rozmiar .delta zależy
od obciążenia zapisem podczas kopiowania. Przy dużym obciążeniu i wolnym
transferze może znacznie urosnąć — obserwuj miejsce przy pierwszej
inicjalizacji.
Replica. Kopia jest zapisywana wprost do pliku <database>.hqcluster-part obok
miejsca bazy danych. Węzeł rezerwuje pełny rozmiar z góry. Plik jest potem sprawdzany,
naprawiany (nbackup -FIXUP -SEQUENCE) i przemianowywany na miejsce. Druga
kopia nie jest potrzebna — rozmiar bazy danych jest potrzebny raz, na wolumenie bazy danych.
Jeśli replica już istniała (powtórna inicjalizacja), stary plik leży na
dysku do ostatniego kroku. To znaczy, że stary plik i nowa kopia są potrzebne na wolumenie
jednocześnie. Wolne miejsce jest liczone bez starego pliku — dlatego wymaganie
jest takie samo: 105 % rozmiaru bazy danych wolne.
Usuń starą replikę (z HQbird 2027.2.24). Jeśli na wolumenie repliki nie ma miejsca
na nową kopię obok starej, zaznacz to pole w oknie inicjalizacji
(rozdział 5.1). Węzeł replica usuwa wtedy starą kopię i jej
segmenty przychodzące (.Incoming) przed transferem, a wolumen wystarcza na 105 %
rozmiaru bazy danych plus free_space_floor_gb. Węzeł usuwa kopię tylko wtedy, gdy wszystkie warunki
są prawdziwe:
bez usunięcia miejsca brakuje, a z usunięciem wystarcza;
to kopia zainstalowana przez inicjalizację tego węzła: nagłówek
jest czytelny, tryb to replica tylko do odczytu;
baza danych nie została zrobiona zwykłą (nie ma pliku <database>.hqcluster-normal.json, rozdział 8);
overwrite_non_replica nie jest ustawione (5.9).
Inaczej węzeł nic nie usuwa i odmawia z powodem w tekście. Aby usunąć,
węzeł zatrzymuje Firebird repliki na czas usuwania (5.6).
Pole jest domyślnie wyłączone. Ryzyko: dopóki trwa transfer, na replice nie ma
kopii bazy danych. Jeśli baza danych ma tylko jedną replikę, master jest cały czas
bez ochrony. Dopóki nie ma nowej kopii, baza danych na replice jest w stanie NEEDS_REINIT (nie FAILED i
nie ORPHANED), a replica zgłasza alert replica_removed_for_reinit
(warn). Gdy nowa kopia jest na miejscu, alert jest kasowany. Jeśli inicjalizacja
nie uda się po usunięciu, para zostaje NEEDS_REINIT: uruchom
inicjalizację ponownie (albo uruchomi ją automatyczna ponowna inicjalizacja, 5.8).
Nowa inicjalizacja przekazuje bazę danych od początku.
Archiwum mastera (.LogArch). Węzeł trzyma wysłane segmenty przez
retention_days dni, aby replica mogła o nie poprosić ponownie. Segmenty,
których replica jeszcze nie zastosowała, są trzymane dłużej. Gdy miejsca jest mało, węzeł
czyści archiwum etapami:
segmenty zastosowane przez wszystkie repliki starsze niż retention_days;
zastosowane segmenty nowsze (gdy miejsca jest mało);
segmenty niezastosowane — tylko w ostateczności. Wtedy replica
traci potrzebne segmenty i dostaje NEEDS_REINIT.
Jeśli replica jest długo niedostępna, archiwum rośnie. Jego wolumen = zmiany bazy danych przez
okres przestoju.
Przykład obliczenia
Baza danych 100 GB. Obciążenie — 5 GB segmentów dziennie. Inicjalizacja idzie
w nocy, kopiowanie trwa 2 godziny, w tym czasie około
2 GB trafia do .delta.
Gdzie
Obliczenie
Razem wolne
Master, wolumen bazy danych
105 GB na kontrole (w tym wzrost .delta) + .ReplLog 1 GB + .LogArch 2 dni × 5 GB = 10 GB
≥ 116 GB
Replica, nowa baza danych
105 GB + .Incoming do 4 GB + 1 GB zapasu
≥ 110 GB
Replica, powtórna inicjalizacja
stary plik 100 GB już na dysku + 110 GB wolne
wolumen ≥ 210 GB
Replica, powtórna inicjalizacja z polem Usuń starą replikę (z HQbird 2027.2.24)
stary plik usunięty przed transferem: 105 GB + .Incoming do 4 GB + 1 GB zapasu
wolumen ≥ 110 GB
Dodaj zapas na wzrost bazy danych i na przestój repliki (archiwum mastera rośnie o
5 GB na dzień przestoju).
Segmenty na osobnym wolumenie
Foldery .ReplLog, .LogArch i .Incoming są domyślnie obok bazy danych.
Można je przenieść na inny wolumen: parametr segments.storage w node.json
(z mirror_hierarchy: true węzeł odtwarza strukturę folderów baz danych). Wtedy
archiwum nie zabiera miejsca bazom danych. Kontrola 105 % nadal dotyczy wolumenu bazy danych.
Gdzie patrzeć na miejsce
Bazy danych → Węzły i Przegląd: ikona wolnego miejsca dla
wolumenu databases.root. Żółty — mniej niż 20 %, czerwony — mniej niż 10 %.
Strona Bazy danych: kolumna Dysk w tabeli Węzły
Raport klastra: hqbirdrcm report.
4.5. Kilka replik jednej bazy danych
Druga i kolejne repliki powstają tak samo: Inicjalizuj w wierszu mastera, z wyborem wolnego węzła replica.
Dopóki nowa replica jest inicjalizowana, master nie przekazuje tej bazy danych także już działającym replikom. Dogonią mastera po zakończeniu inicjalizacji. Okno potwierdzenia o tym mówi.
Jedna baza danych — jedna inicjalizacja naraz, nawet dla różnych replik.
Miejsce na masterze jest sprawdzane osobno dla każdej inicjalizacji.
Baza danych mastera z dwiema replikami
4.6. Replika skonfigurowana ręcznie
Jeśli replica już działa z ręcznie napisanego replication.conf, możesz objąć ją zarządem i nie kopiować bazy danych ponownie:
Master: zarejestruj bazy danych z detect_existing (rozdział 3.6).
Replica:Bazy danych → węzeł replica → Przejmij, albo hqbirdrcm takeover-replica. RCM znajdzie bloki repliki, dopasuje pliki do baz danych mastera po GUID i pokaże dla każdej: in_sync, resumable albo needs_reinit.
Potwierdź wiersze. Węzeł przeniesie bloki do własnego obszaru replication.conf.
Zrestartuj Firebird repliki, aby odczytał przeniesione bloki.
Zainicjalizuj tylko wiersze needs_reinit: archiwum mastera nie zawiera już segmentów potrzebnych tym replikom.
4.7. Częste błędy
Co widzisz
Przyczyna
Co zrobić
insufficient disk space on master / on replica
za mało miejsca (4.4). Przy ponownej inicjalizacji stara kopia zajmuje miejsce do końca (4.4)
zwolnij miejsce, spróbuj ponownie. Drugie wyjście na replice (od HQbird 2027.2.24) to pole Usuń starą replikę (4.4, 5.1)
507 od RCM od razu
według statystyk miejsca wyraźnie brakuje
to samo. Jeśli jest miejsce bez starej kopii, RCM 2027.2.24 podaje pole Usuń starą replikę
incompatible_engine
różne główne wersje Firebird
zaktualizuj Firebird repliki
Brak folderu na węźle replica
katalog główny nieutworzony
Utwórz folder w oknie inicjalizacji (4.3)
Folder istnieje, ale usługa węzła nie może do niego pisać (od HQbird 2027.2.24)
brak prawa zapisu
uruchom polecenie z okna, kliknij Sprawdź ponownie (4.3)
publication_off (od HQbird 2027.2.24)
publikacja mastera jest wyłączona albo nie ma tabel
Synchronizuj publikację i inicjalizuj (5.1)
ownership_unfixable
usługa węzła ma obcą grupę
popraw grupę usługi według tekstu błędu
duplicate_guid
dwie bazy danych z tym samym GUID (kopia pliku)
usuń kopię albo nadaj jej nowy GUID (nbackup -F)
Węzła replica nie ma na liście Inicjalizuj
brak połączenia w peers
rozdział 2
Replica IN_SYNC, ale dane się rozjeżdżają
publikacja była wyłączona
zsynchronizuj publikację, potem powtórz inicjalizację
5. Inicjalizacja (reinit)
Inicjalizacja to przekazanie kopii bazy danych mastera do repliki. Pierwsze przekazanie
nazywa się inicjalizacją (przycisk Inicjalizuj), powtórne przekazanie to
ponowna inicjalizacja (przycisk Zainicjalizuj ponownie). Mechanizm jest ten sam.
Przed startem wykonaj kroki 1–5 z rozdziału 4:
baza danych jest zarejestrowana, Firebird mastera został zrestartowany, publikacja jest włączona,
folder repliki istnieje i jest dość miejsca. Ile miejsca potrzeba na masterze i na
replice, opisuje rozdział 4.4.
5.1. Jak zacząć
Najpierw publikacja. Rejestracja bazy danych nie obejmuje publikacji. Bez
publikacji replica nie dostaje zmian. Przed inicjalizacją uruchom
Synchronizuj publikację (rozdział 6) albo
hqbirdrcm setpublication -node <master>.
Z HQbird 2027.2.24 okno inicjalizacji sprawdza publikację. Jeśli
jest wyłączona albo nie ma tabel z kluczem, okno pokazuje
ostrzeżenie i przycisk Synchronizuj publikację i
inicjalizuj. RCM synchronizuje publikację, czeka na koniec polecenia i
rozpoczyna inicjalizację z wyborem z okna.
Węzeł master 2027.2.24 sam odmawia takiej inicjalizacji (także pierwszej)
błędem publication_off i zgłasza powiadomienie
master_publication_off (rozdział 6.1). Po odmowie komórka bazy danych znowu
ma przycisk Synchronizuj publikację i inicjalizuj.
Jeśli operator wyłączył publikację (6.4) albo usunął z niej wszystkie tabele z
kluczem (6.3), synchronizacja to zachowuje. RCM nie rozpoczyna
inicjalizacji i podaje łącze do strony Tabele publikacji.
RCM i węzeł 2027.5.7 nie sprawdzają publikacji: inicjalizacja
się udaje, baza danych pokazuje „OK” w RCM, ale replica nie dostaje zmian. Jeśli
publikację włączono po inicjalizacji — zainicjalizuj bazę danych ponownie.
Okno „Zainicjalizować bazę danych ponownie?”
Otwórz Bazy danych.
W wierszu bazy danych mastera, w kolumnie węzła replica, kliknij Inicjalizuj.
Węzeł replica jest wyznaczony przez kolumnę: nie wybiera się go w oknie. Dla
istniejącej pary — Reinit w rozwiniętej karcie mastera.
W oknie (z HQbird 2027.2.24 tytuł dla nowej pary to „Zainicjalizować
bazę danych?”; w RCM 2027.5.7 — „Zainicjalizować bazę danych ponownie?” także przy
pierwszej inicjalizacji):
sprawdź Folder repliki. Okno pokazuje, czy folder istnieje. Jeśli
nie, kliknij Utwórz folder: węzeł replica go utworzy (4.3). Jeśli węzeł
nie może go utworzyć, okno pokazuje polecenie dla hosta repliki. Z HQbird
2027.2.24 okno pokazuje też folder, do którego usługa węzła nie może
pisać: polecenie naprawy i przycisk Sprawdź ponownie;
wybierz Metodę reinit: Płynna (zalecana) albo Standardowa
(5.4). Z HQbird 2027.2.24, jeśli archiwum mastera nie ma jeszcze segmentów
(zwykle przed pierwszą inicjalizacją), okno pokazuje podpowiedź: na
obciążonej bazie danych Standardowa jest szybsza;
jeśli baza danych mastera nadal czeka na restart Firebird, okno o tym powie i
pokaże przycisk Uruchom ponownie Firebird mastera. Bez restartu baza danych
nie jest replikowana;
Usuń starą replikę (z HQbird 2027.2.24, domyślnie wyłączone)
jest potrzebne tylko przy ponownej inicjalizacji, gdy wolumen repliki nie ma
miejsca na nową kopię obok starej (4.4). Okno pokazuje
liczby z góry: ile potrzeba, ile jest wolne, ile zajmuje stara kopia.
Jeśli jest miejsce bez starej kopii, okno prosi o zaznaczenie pola. Pole
jest nieaktywne, jeśli węzeł master albo replica jest starą wersją: okno podaje,
który węzeł zaktualizować. Dopóki nowa kopia nie jest gotowa, replica nie ma kopii
tej bazy danych (4.4).
Potwierdź. RCM stwierdzi, że baza danych zostanie zablokowana na masterze i
skopiowana na replikę.
Postęp inicjalizacji widać w rozwiniętej karcie mastera na stronie Bazy danych:
kroki i procenty. Z HQbird 2027.2.24 postęp widać też po odświeżeniu
strony: przy pierwszej inicjalizacji — w komórce węzła replica, a także w
wierszu Postęp ponownej inicjalizacji na stronie bazy danych mastera. Przycisk
Inicjalizuj jest nieaktywny, dopóki węzeł master kopiuje bazę danych. Jeśli RCM nie
śledzi tej inicjalizacji (na przykład uruchomiono ją z wiersza poleceń węzła),
kroki są brane ze stanu węzła, bez procentów. W RCM 2027.5.7 po
odświeżeniu strony postęp pierwszej inicjalizacji nie jest widoczny: poczekaj, aż baza danych mastera
opuści SEEDING.
Kroki inicjalizacji w wierszu mastera
Każde polecenie RCM (inicjalizacja, restart Firebird, synchronizacja
publikacji) jest zapisywane na stronie Polecenia z wynikiem.
Strona „Polecenia”
To samo z wiersza poleceń
Command
# one databasehqbirdrcm reinit -node node-a -db <db_id> -to node-b
# all master databaseshqbirdrcm reinit -node node-a -all -to node-b
Parametry: -mode smooth|standard (domyślnie smooth), -hold=false
(nie trzymać archiwum podczas długich transakcji), -allow-restart (5.6),
-force (5.9).
-remove-old-replica (z HQbird 2027.2.24) — to samo co pole Usuń starą
replikę. Tylko dla jednej bazy danych: -db i -to są wymagane; z
-all polecenie odmawia. Jeśli węzeł master albo replica jest starą wersją, RCM
odmawia z node_too_old i nic nie wysyła.
nbackup -N zaraz po transferze: zmiany z .delta wracają do bazy danych
5
SEEDING
na replice: weryfikacja sumy kontrolnej pliku, nbackup -FIXUP -SEQUENCE, instalacja pliku, gfix -replica, zapis bloku do replication.conf
6
RESTARTING REPLICA
restart Firebird repliki, jeśli jest potrzebny (5.6)
Po kroku 6 baza danych dostaje stan IN_SYNC. Master nadal wysyła
segmenty od punktu, w którym kończy się kopia.
Co warto wiedzieć:
Master działa cały czas. Użytkownicy piszą do bazy danych, zmiany idą do
.delta. Blokada jest zdejmowana zaraz po transferze.
Transakcje, które zbiegły się z blokadą, nie giną. Węzeł znajduje
transakcje otwarte w chwili nbackup -L, a replica odtwarza je z
segmentów.
Transfer trwa po przerwaniu. Jeśli połączenie albo węzeł replica
się zrestartował, master kontynuuje od ostatniej odebranej części. Niedokończony
transfer jest trzymany na replice 24 godziny (reinit_partial_keep_hours).
Przy błędzie węzeł zdejmuje blokadę, usuwa niedokończony plik na
replice i ustawia bazę danych na FAILED. Następna próba startuje ze znanego
stanu.
Z polem „Usuń starą replikę” (od HQbird 2027.2.24) replica
usuwa starą kopię po kroku LOCKING, przed transferem. Krok COPYING TO
NODE pokazuje wtedy „usuwanie starej kopii repliki, aby zrobić miejsce”. Błąd po usunięciu daje parze NEEDS_REINIT zamiast FAILED
(rozdział 4.4).
Tylko nbackup. gbak nie jest używany: zmienia GUID bazy danych.
5.3. Wpływ na pracę
Co
Wpływ
Użytkownicy mastera
pracują dalej; podczas kopiowania .delta rośnie, po -N zmiany trafiają do bazy danych
Inne repliki tej bazy danych
nie dostają segmentów tej bazy danych, dopóki trwa inicjalizacja; potem doganiają
Inne bazy danych mastera
bez wpływu
Firebird repliki, nowa baza danych
nie jest zatrzymywany; restart według 5.6
Firebird repliki, powtórna inicjalizacja
jest zatrzymywany, gdy plik jest podmieniany: wszystkie bazy danych tego Firebird są niedostępne przez sekundy
jest zatrzymywany wcześniej, gdy trwa usuwanie, przed transferem. Węzeł instaluje nową kopię bez drugiego zatrzymania, jeśli blok bazy danych w replication.conf się nie zmienił. Jeśli miejsca wystarcza i usuwanie nie jest potrzebne, węzeł nic nie usuwa, a wszystko przebiega jak przy zwykłej powtórnej inicjalizacji
Sieć i dysk
obciążenie według limitów szybkości (5.5)
W systemie Windows. Pliku otwartego przez Firebird nie da się podmienić. Przy powtórnej
inicjalizacji węzeł zatrzymuje Firebird repliki przez fbagent, instaluje
plik i uruchamia Firebird ponownie. W Linux Firebird też jest zatrzymywany przed
podmianą: inaczej pracowałby dalej ze starym usuniętym plikiem.
5.4. Metoda płynna i standardowa
Płynna (domyślnie). Przed blokadą węzeł szuka długich transakcji: transakcji zapisu użytkownika, które zaczęły się przed najstarszym segmentem w archiwum mastera. Po inicjalizacji replica nie będzie mogła ich odtworzyć i zatrzyma się przy ich pierwszej zmianie („Nie znaleziono transakcji …”). Transakcje bez zmian nie są liczone.
Jeśli takie transakcje istnieją, inicjalizacja się nie zaczyna: RCM pokazuje Płynna ponowna inicjalizacja czeka na długie transakcje i podaje łącze Otwórz listę.
Strona Długie transakcje: brak długich transakcji
Na stronie Długie transakcje:
podsumowanie: ile transakcji i połączeń, najstarszy segment;
5 najstarszych połączeń z najstarszymi transakcjami: użytkownik, klient, start, wiek, zmiany, bieżące zapytanie;
Trzymaj segmenty / Zwolnij trzymanie — dopóki trzymanie jest włączone, archiwum mastera nie jest czyszczone i historia nie jest obcinana;
Rozłącz wybrane i ponów reinit — rozłącza połączenia (ich transakcje są wycofywane) i od razu zaczyna płynny reinit;
Ponów reinit, Sprawdź ponownie.
Trzymanie włącza się automatycznie, gdy reinit jest odrzucony z powodu długich transakcji. Jest zwalniane po udanej inicjalizacji, ręcznie albo gdy archiwum urośnie do reinit_hold_max_segments (domyślnie 1000 segmentów, powiadomienie retention_hold_released).
Standardowa blokuje bazę danych od razu, bez sprawdzania. Używaj jej tylko wtedy, gdy wiesz, że nie ma długich transakcji zapisu.
Pierwsza inicjalizacja pod obciążeniem. Dopóki archiwum mastera jest puste, nie ma segmentu do porównania.
Z węzłem master HQbird 2027.2.24: jeśli węzeł sam włączył publikację i archiwum od tego czasu się nie zmieniło, historia zaczyna się w chwili włączenia publikacji. Transakcja rozpoczęta później wchodzi do dziennika od swojej pierwszej zmiany i nie przeszkadza metodzie płynnej. Transakcja rozpoczęta wcześniej nie weszła do dziennika: reinit czeka na nią przed blokadą (6 prób co 10 s), a krok locking pokazuje jej numer, połączenie i użytkownika. Jeśli się nie skończyła, reinit kończy się błędem reinit_pre_publication_transactions: dokończ ją i spróbuj ponownie. Strona Długie transakcje pokazuje takie transakcje w tabeli Transakcje rozpoczęte przed włączeniem publikacji.
Jeśli publikację włączono ręcznie, nie przez węzeł, albo archiwum już się zmieniło, początek historii jest nieznany. Wtedy metoda płynna odmawia, jeśli jakakolwiek transakcja zapisu jest otwarta, a komunikat mówi, że archiwum nie zawiera jeszcze segmentu. W tym przypadku RCM 2027.2.24 nie otwiera listy, tylko zapisuje, co zrobić, w komórce bazy danych. Wybierz Standardowa albo spróbuj ponownie, gdy Firebird zarchiwizuje pierwszy segment.
Z węzłem master 2027.5.7 metoda płynna odmawia od razu przy pierwszej inicjalizacji bazy danych, do której trwa zapis: long_transactions … segment 0 (0001-01-01T00:00:00Z). Dla pierwszej inicjalizacji takiej bazy danych wybierz Standardowa.
Przy kolejnych ponownych inicjalizacjach metoda płynna działa jak zwykle (archiwum już istnieje).
Transakcje starsze niż publikacja. Firebird nie zapisuje do segmentów transakcji, która zaczęła się przed włączeniem publikacji. Jeśli węzeł włączył publikację, inicjalizacja czeka (6 prób co 10 sekund), aż takie transakcje się skończą; inaczej kończy się błędem reinit_pre_publication_transactions z ich listą. Po zsynchronizowaniu publikacji, która dodała tabele, połącz aplikacje ponownie, a potem rozpocznij inicjalizację.
5.5. Szybkość
Kiedy
Szybkość
Ustawienie
W oknie transferu windows.transfer_window (domyślnie 23:00-05:00)
stała
limits.reinit_window_mbps, domyślnie 100 MB/s
Poza oknem
ułamek zmierzonej szybkości dysku
limits.reinit_day_disk_fraction, domyślnie 0.5
Węzeł przelicza tryb co 30 sekund: inicjalizacja rozpoczęta w dzień sama przyspieszy w nocy.
Węzeł mierzy szybkość dysku testem. Aby powtórzyć test na hoście mastera:
Czas inicjalizacji ≈ rozmiar bazy danych ÷ szybkość. Przykład: 100 GB przy 100 MB/s — około 17 minut czystego transferu; w praktyce ogranicza to sieć albo dysk.
5.6. Restart Firebird repliki
Nowa baza danych na replice. Plik jest umieszczany bez zatrzymywania Firebird. Firebird
odczyta nowy blok replication.conf dopiero po restarcie. Do tego czasu
replica nic nie stosuje. Krok RESTARTING REPLICA pokazuje oczekiwanie:
Etykieta
Co oznacza
oczekiwanie na restart Firebird na replice, jest zaplanowany na …
węzeł sam zrestartuje Firebird po ostatniej inicjalizacji (reinit_restart_delay_sec), gdy pozostałe inicjalizacje się skończą
… okno restartu jest zamknięte, następne otworzy się o …
oczekiwanie na restart_window repliki
… ostatnia próba się nie udała, następna o …
spróbuje później
replica nie może sama zrestartować Firebird: zrestartuj ręcznie
auto_restart: never albo ten Firebird obsługuje też bazy danych mastera
Węzeł restartuje Firebird raz po serii inicjalizacji, a nie po
każdej bazie danych.
Aby zrestartować ręcznie, kliknij Uruchom ponownie Firebird repliki.
Oczekiwanie kończy się po każdym udanym restarcie Firebird albo gdy
replica zastosuje segment nowszy niż kopia.
Ponowna inicjalizacja na Firebird, który obsługuje też bazy danych mastera.
Węzeł nie zatrzymuje takiego Firebird sam i odmawia z
restart_not_allowed. Uruchom inicjalizację ponownie i zaznacz Pozwól
zatrzymać Firebird na ten reinit (-allow-restart w wierszu poleceń)
— w czasie, gdy połączenia tego Firebird można zerwać, także
do jego baz danych mastera. Takie inicjalizacje uruchamiaj po jednej na host.
Usuwanie starej kopii (pole Usuń starą replikę, z HQbird
2027.2.24) też zatrzymuje Firebird repliki, według tych samych reguł. Jeśli
węzeł nie może sam zatrzymać tego Firebird, nic nie usuwa i
odmawia z restart_not_allowed: zaznacz też Pozwól
zatrzymać Firebird na ten reinit. Jeśli w tym czasie inna inicjalizacja
kończy się na replice albo Firebird się restartuje, węzeł nic
nie usuwa i odmawia z engine_busy: master zdejmuje blokadę,
spróbuj później.
5.7. Kolejka i równoczesne inicjalizacje
Jedna baza danych — jedna inicjalizacja naraz (nawet dla różnych replik). Przycisk Inicjalizuj jest wyłączony, dopóki trwa inicjalizacja tej bazy danych.
Węzeł master wymusza limits.max_concurrent_reinits równoczesnych inicjalizacji różnych baz danych (domyślnie 1). Reszta czeka w kolejce; odpowiedź zawiera pozycję w kolejce.
Nie uruchamiaj własnego nbackup -L (ani ALTER DATABASE BEGIN BACKUP) na bazie danych podczas jej inicjalizacji i nie zaczynaj inicjalizacji podczas takiej kopii: baza danych może mieć tylko jedną blokadę. Inicjalizacja to sprawdza i odmawia z nbackup backup lock already active.
Kolejka i bieżące transfery są widoczne na stronie Transfer.
Strona Transfer / kolejki
- Jeśli po awarii zostaje plik `.delta`, upewnij się, że nie trwa kopia zapasowa, i uruchom `nbackup -N `. Nie usuwaj `.delta` ręcznie.
5.8. Automatyczna ponowna inicjalizacja
RCM może sam ponownie zainicjalizować bazę danych w stanie NEEDS_REINIT, tylko w
skonfigurowanym oknie. Domyślnie wyłączone.
Gdy baza danych wchodzi w NEEDS_REINIT:
Przyczyna
Gdzie widać
powtarzający się nieodwracalny błąd stosowania (naruszenie PK, UNIQUE, FK) — 3 razy z rzędu
replica, alert replication_unrecoverable_error
GUID bazy danych mastera się zmienił (odtworzenie, podmiana pliku)
replica, alert replication_guid_mismatch
archiwum mastera nie zawiera już segmentów potrzebnych replice
master
replica usunęła starą kopię do inicjalizacji i nie ma jeszcze nowej kopii (od HQbird 2027.2.24)
replica, alert replica_removed_for_reinit; master
Aby włączyć — Ustawienia → RCM (albo rcm.json, sekcja auto_reinit):
Okno: na bazę danych → na węzeł → globalnie. "always" — w dowolnym momencie.
Okna są liczone według zegara hosta RCM.
max_concurrent — ile inicjalizacji (ręcznych i automatycznych) może
trwać w klastrze, zanim RCM uruchomi kolejną automatyczną.
Automatyczna inicjalizacja przechodzi te same kontrole miejsca i GUID co
inicjalizacja ręczna. Autorem polecenia jest system:autoreinit.
remove_old_replica_when_short (od HQbird 2027.2.24, wiersz Usuń
starą replikę przy braku miejsca) — domyślnie wyłączone. Jeśli
włączone, automatyczna inicjalizacja wysyła flagę Usuń starą
replikę (4.4). RCM wysyła ją tylko wtedy, gdy sama replica jest w
NEEDS_REINIT albo przyczyna NEEDS_REINIT mastera ją wymienia. Dla
repliki w stanie IN_SYNC albo LAGGING flaga nigdy nie jest wysyłana. Jeśli węzeł
jest starszą wersją, RCM uruchamia tę samą inicjalizację bez flagi.
Po zmianie zrestartuj RCM.
Odłóż w karcie mastera wyłącza automatyczną
inicjalizację jednej bazy danych na 1 godzinę, 4 godziny, 24 godziny albo do odwołania. Ręczna
inicjalizacja pozostaje dostępna.
5.9. Błędy
Błąd
Przyczyna
Co zrobić
insufficient disk space on master / on replica, 507
za mało miejsca. Podczas ponownej inicjalizacji stara kopia zajmuje miejsce do końca
rozdział 4.4; na replice (od HQbird 2027.2.24) — pole Usuń starą replikę (5.1)
node_too_old (od HQbird 2027.2.24)
pole Usuń starą replikę jest zaznaczone, ale węzeł mastera albo repliki jest starą wersją
zaktualizuj węzeł tak, jak mówi tekst błędu, albo uruchom bez pola
engine_busy, reclaim_in_progress (od HQbird 2027.2.24)
replica nie może teraz usunąć starej kopii: Firebird albo ta baza danych jest zajęta
spróbuj później (5.6)
replica_removed_for_reinit, para NEEDS_REINIT (od HQbird 2027.2.24)
replica usunęła starą kopię, ale inicjalizacja się nie skończyła
uruchom inicjalizację ponownie (4.4)
publication_off (od HQbird 2027.2.24)
publikacja mastera jest wyłączona albo nie zawiera tabel z kluczem
Synchronizuj publikację i inicjalizuj (5.1)
long_transactions, „Płynny reinit czeka na długie transakcje”
otwarte są długie transakcje zapisu
5.4
long_transactions, „archiwum mastera nie zawiera jeszcze ani jednego segmentu”
pierwsza inicjalizacja pod obciążeniem
Standardowa (5.4)
reinit_pre_publication_transactions
transakcje rozpoczęte przed włączeniem publikacji
połącz aplikacje ponownie, spróbuj jeszcze raz
duplicate_guid
dwie bazy danych mastera z tym samym GUID
usuń kopię; jeśli przy promowaniu do mastera pominięto krok NEW GUID — -force (rozdział 8.4)
license_paused
fbagent mastera nie ma licencji
rozdział 2.8
409 orphaned
baza danych jest poza skanowaniem mastera
rozdział 3.8
incompatible_engine
różne główne wersje Firebird
rozdział 4.3
target_not_replica
w miejscu repliki jest działająca baza danych (została ustawiona jako zwykła)
patrz niżej
target_other_replica (od HQbird 2027.2.24)
w miejscu repliki jest kopia innej bazy danych tego węzła
patrz niżej
restart_not_allowed
Firebird repliki obsługuje też bazy danych mastera
5.6, pole „Pozwól … zatrzymać Firebird”
fbagent_required
fbagent nie jest zainstalowany na replice
rozdział 1
nbackup backup lock already active
trwa kopia nbackup
5.7
… -L did not finish in 2m0s and was stopped
nbackup -L na masterze nie skończył się w 2 minuty, więc węzeł go zatrzymał
spróbuj ponownie; jeśli błąd wraca, sprawdź Firebird mastera (firebird.log)
reinit already in progress for this database
inicjalizacja tej bazy danych już trwa
poczekaj, aż się skończy
target_not_replica. W miejscu kopii jest działająca baza danych: została
ustawiona jako zwykła (istnieje plik <database>.hqcluster-normal.json) albo nie jest w
trybie replica. Węzeł nie nadpisuje działającej bazy danych. Jeśli trzeba ją zastąpić, żądanie do API węzła z
overwrite_non_replica: true (w RCM nie ma do tego przycisku) podmieni plik i zachowa stary jako
<database>.pre-reinit-<czas UTC>.fdb.
target_other_replica (od HQbird 2027.2.24). Replica umieszcza kopię w
<databases.root>/<id mastera>/<ścieżka bazy danych>. Id mastera jest unikalne tylko w
jego własnym klastrze, więc dwie bazy danych mogą trafić na tę samą ścieżkę. Węzeł replica
nie nadpisuje kopii należącej do innej ze swoich baz danych: błąd podaje tę bazę danych i jej
mastera. Węzeł rozpoznaje też kopię, której ścieżka jest zapisana inaczej (dowiązanie symboliczne albo
junction w ścieżce, krótka nazwa folderu Windows). overwrite_non_replica nie usuwa tego błędu. Przenieś jedną z
kopii do innego folderu albo usuń tę bazę danych z repliki, a potem uruchom
inicjalizację ponownie. Węzeł widzi tylko własne bazy danych: dwa węzły replica na
tym samym hoście muszą mieć różne foldery repliki (databases.root).
5.10. Jak sprawdzić wynik
Bazy danych: para master — replica w grupie jest Ok, stan
IN_SYNC.
Sprawdź w karcie mastera: węzły liczą wiersze tabel z
listy tabel bazy danych (rozdział 3.1) na masterze i na replice i porównują je.
Sprawdzaj w spokojnym czasie: przy aktywnym zapisie liczby mogą się różnić.
W HQbird 2027.2.24 strona wyniku podaje listę każdej strony
(na przykład „własna lista tej bazy danych” albo „tabele publikacji
(lista nie ustawiona)”). RCM liczy replikę według listy mastera. Tabela,
której nie ma w obu bazach danych, jest pokazana jako „nie ma w bazie danych” i nie liczy się jako
błąd. Jeśli nie porównano żadnych tabel, wynik to „Brak tabel do
porównania”, a nie rozbieżność. Jeśli porównanie nie skończyło się w wyznaczonym czasie,
wynik to „Nie porównano (limit czasu)”, co też nie jest rozbieżnością.
Kontrola okresowa (opcjonalnie): strona Sprawdzanie danych,
Włącz dla wszystkich węzłów. W HQbird 2027.2.24 węzeł stosuje
ustawienia od razu, restart usługi węzła nie jest potrzebny: po Zapisz RCM
zapisuje „Zapisano i już obowiązuje”. Węzeł 2027.5.7 wymaga restartu
usługi hqclusternode, i RCM 2027.2.24 o tym mówi.
Węzły same porównują liczby wierszy, gdy master i replica są na tym samym
segmencie. Rozbieżność podnosi alert data_mismatch; potem uruchom
Sprawdź.
Tabela, którą operator usunął z publikacji, jest pokazana jako „nie
opublikowana”, a nie jako rozbieżność.
6. Konfigurowanie publikacji
Publikacja mówi masterowi Firebird, zmiany których tabel zapisywać do segmentów.
Bez niej replica nic nie otrzymuje.
6.1. Czym jest publikacja
W Firebird 4 i 5 tabele do replikacji określa publikacja RDB$DEFAULT:
Publikacja włączona — w RDB$PUBLICATIONS ma RDB$ACTIVE_FLAG = 1
(polecenie ALTER DATABASE ENABLE PUBLICATION).
Opublikowane tabele — lista w RDB$PUBLICATION_TABLES.
Firebird zapisuje zmiany do segmentów tylko dla opublikowanych tabel i tylko
wtedy, gdy publikacja jest włączona. Zarejestrowanie bazy danych (rozdział 3) nie
włącza publikacji. Włącza ją Synchronizuj publikację (6.2).
Węzeł master sprawdza publikację co godzinę
(limits.publication_check_interval_sec, domyślnie 3600). Jeśli jest
wyłączona, węzeł sprawdza ją co 2 minuty.
Na stronie Bazy danych baza danych mastera ma ikonę:
Ikona
Znaczenie
publikacja WŁ.
publikacja włączona
publikacja WYŁ.
Firebird nic nie zapisuje do segmentów, repliki nie dostają zmian
publikacja nieznana
węzeł nie mógł odczytać stanu
Filtr Publikacja wyłączona pokazuje bazy danych z wyłączoną albo nieznaną
publikacją.
Jeśli baza danych z wyłączoną publikacją ma już replikę, master podnosi
alert master_publication_off.
W HQbird 2027.2.24 master podnosi ten alert także wtedy, gdy odmówił
inicjalizacji bazy danych z błędem publication_off (rozdział 5.1): publikacja
jest wyłączona albo nie zawiera tabeli z kluczem. Poziom alertu:
ostrzeżenie — baza danych nie ma jeszcze repliki: inicjalizacja czeka na publikację;
poważny — baza danych ma już replikę;
info — operator wyłączył publikację.
Alert znika, gdy publikacja zostanie naprawiona albo rozpoczęła się inna
inicjalizacja.
6.2. Synchronizuj publikację
Wiersz mastera: publikacja wyłączona
Gdzie kliknąć:
w wierszu bazy danych mastera na stronie Bazy danych. Gdy publikacja
jest wyłączona, przycisk jest obok ikony;
na stronie bazy danych;
dla kilku baz danych: zaznacz wiersze, na liście Akcja wybierz
Synchronizuj publikację. RCM wyśle osobne polecenie dla każdej
bazy danych.
Potwierdzenie synchronizacji publikacji
Co robi węzeł (jedna transakcja):
Włącza publikację. Jeśli operator sam ją wyłączył (6.4), nie włącza jej.
Dodaje do publikacji wszystkie tabele z kluczem, których jeszcze nie ma.
Usuwa z publikacji tabele bez klucza i tabele, które operator
wykluczył (6.3).
Wyłącza automatyczne dodawanie nowych tabel (EXCLUDE ALL FROM PUBLICATION, potem dodaje wymagane tabele). Skład publikacji określa tylko węzeł.
Wiersz mastera po synchronizacji: publikacja włączona
Tabela z kluczem — trwała tabela użytkownika, która ma
klucz główny albo aktywny indeks unikalny. Tabele systemowe i tymczasowe
nie są publikowane.
Synchronizacja usuwa z publikacji także tabele bez klucza, które DBA dodał
ręcznie.
Jeśli skład jest już poprawny, węzeł nic nie zmienia.
Kiedy węzeł odmawia:
Kod
Powód
no_publications
HQbird 2.5/3.0 (6.6)
not_master
węzeł nie jest masterem
reinit_in_progress
trwa inicjalizacja tej bazy danych
orphaned, database_failed, file_missing
baza danych jest poza skanowaniem, w błędzie albo nie ma pliku
Wszystkie bazy danych węzła naraz — tylko z wiersza poleceń. Na stronie Polecenia
wynik jest pokazany dla każdej bazy danych: gotowe, pominięte albo błąd.
Bazy danych w stanie FAILED albo SEEDING oraz bazy danych bez pliku są pomijane.
To samo z wiersza poleceń
Command
hqbirdrcm setpublication -node node-a -db <db_id> # one databasehqbirdrcm setpublication -node node-a # all node databases
Polecenie czeka do 5 minut i wypisuje wiersz dla każdej bazy danych. Przy błędzie kod
wyjścia to 1. -nowait — nie czekaj na wynik.
6.3. Tabele publikacji
Strona „Tabele publikacji”
Otwórz Tabele publikacji w wierszu bazy danych mastera.
Strona pokazuje:
stan publikacji (wł./wył., wyłączona przez operatora) i liczniki;
każdą tabelę: nazwa, klucz i stan.
Stan
Znaczenie
opublikowana
zmiany idą do segmentów
jeszcze nie opublikowana
tabela z kluczem, zostanie dodana przy synchronizacji
wykluczona
operator usunął ją z publikacji
brak klucza
nie można jej opublikować
W kolumnie klucza — klucz główny albo, jeśli go nie ma, indeks unikalny z
najmniejszą liczbą pól.
Dlaczego tabeli bez klucza nie można opublikować. Replica szuka wiersza dla
UPDATE i DELETE po kluczu. Bez klucza wiersza nie znajdzie. Dodaj
klucz główny albo indeks unikalny, a potem zsynchronizuj publikację.
Wyklucz z publikacji / Przywróć do publikacji:
Zaznacz tabele.
Kliknij Wyklucz z publikacji albo Przywróć do publikacji.
Węzeł zapisuje listę i od razu synchronizuje publikację.
Potwierdzenie „Wyklucz z publikacji”
Lista wykluczonych tabel jest przechowywana na węźle mastera. Synchronizacja jej
nie zmienia. Gdy replica jest promowana do mastera (rozdział 8), lista przechodzi do
nowego mastera.
Sprawdź (rozdział 5.10) pokazuje wykluczoną tabelę jako „nie opublikowana”,
a nie jako rozbieżność.
6.4. Włączanie i wyłączanie publikacji
Na stronie Tabele publikacji: Wyłącz publikację /
Włącz publikację.
Wyłączenie jest wyborem operatora. Synchronizacja nie
włącza publikacji ponownie.
Zmiany wykonane, gdy publikacja była wyłączona (albo gdy tabela była
wykluczona) nie są wysyłane do repliki, także po ponownym włączeniu.
Po włączeniu kliknij Sprawdź (rozdział 5.10). Jeśli dane
się rozjechały — zainicjalizuj replikę ponownie (rozdział 5).
6.5. Nowa tabela
Nowa tabela nie trafia sama do publikacji: węzeł wyłącza
automatyczne dodawanie.
Po DDL:
Utwórz na tabeli klucz główny albo indeks unikalny.
Kliknij Synchronizuj publikację.
Poproś aplikacje o ponowne połączenie, jeśli potrzebna jest ponowna inicjalizacja. Firebird
nie zapisuje do segmentów transakcji, które zaczęły się przed włączeniem publikacji;
COMMIT RETAINING trzyma taką transakcję otwartą. Inicjalizacja czeka na
takie transakcje, a potem kończy się błędem reinit_pre_publication_transactions
(rozdział 5.4).
Nowa tabela w stanie „jeszcze nie opublikowana”
Wiersze zapisane do nowej tabeli przed synchronizacją nie dotrą do repliki.
Jeśli takie są, sprawdź dane i w razie potrzeby zainicjalizuj replikę ponownie.
6.6. HQbird 2.5 i 3.0
HQbird 2.5 i 3.0 nie mają publikacji. Firebird zapisuje segmenty, jeśli plik
wtyczki replconf zawiera blok mastera. Przyciski publikacji na takich węzłach są ukryte,
a API odpowiada no_publications.
Zestaw tabel określają parametry silnika:
Parametr
Znaczenie
include_filter
które tabele replikować: nazwy albo wzorce rozdzielone przecinkami; puste — wszystkie
exclude_filter
których tabel nie replikować
Parametry zmienia się w Ustawienia → Parametry replikacji (rozdział 7.1). Strona
Tabele publikacji pokazuje je tylko do odczytu, z łączem Zmień
w ustawieniach silnika. Firebird czyta nowe wartości po restarcie.
Tabele publikacji w HQbird 3.0: filtry silnika
Wtyczka replconf. Węzeł zapisuje własny plik replconf.hqcluster.hqbird w folderze
Firebird. Firebird czyta go tylko wtedy, gdy replconf.properties na niego
wskazuje. Wtyczkę trzeba aktywować raz:
Ustawienia → Węzły, blok Wtyczka replikacji (HQbird 2.5 / 3.0). Blok
pokazuje, dokąd wskazuje replconf.properties, i problemy, które węzeł
znalazł.
Wtyczka nieaktywna: replconf.properties wskazuje plik HQbird DataGuard
Aktywuj… Okno wymienia, co zrobi węzeł: zainstaluje wtyczkę,
skieruje replconf.properties na plik węzła, przeniesie wpisy starego pliku.
Wybierz kiedy: Tylko w oknie restartu węzła albo Teraz, ignorując
okno restartu.
Okno aktywacji wtyczki
Po restarcie Firebird pole Aktywowano pokazuje „tak: silnik
czyta plik węzła”.
Wtyczka aktywowana
Aktywacja restartuje Firebird i dotyczy wszystkich baz danych tego Firebird.
Wykonaj ją w spokojnym okresie.
Strona Ustawienia → Parametry replikacji zmienia klucze w
replication.conf dla wybranych baz danych albo dla węzła jako całości.
Dodaj master i repliki — wybierz bazy danych. RCM grupuje je według
wersji Firebird i roli: osobny formularz dla masterów i dla replik.
Dla każdego parametru wybierz działanie:
Działanie
Co robi
bez zmian
wartość nie jest zmieniana
ustaw wartość
nowa wartość
resetuj (do następnego poziomu)
usuń własną wartość, weź wartość z poziomu wyżej
nie zapisuj (wartość Firebird)
klucz nie jest zapisywany, obowiązuje wartość Firebird
Wybierz, gdzie zastosować: Do wybranych baz danych albo Jako domyślne
dla ich węzłów.
Podgląd — węzły sprawdzają wartości, nic nie zmieniając.
Podgląd zmian
Zastosuj. RCM wysyła polecenie do każdego węzła.
Skąd bierze się wartość (kolumna Bieżąca):
Źródło
Wartość
ta baza danych
ustawiona dla bazy danych
wartość węzła
ustawiona jako domyślna dla węzła
wbudowana wartość węzła
wartość węzła z kodu
wartość Firebird
klucz nie jest zapisany
z pliku (jeszcze tu nie ustawiono)
wartość z replication.conf, RCM jej jeszcze nie zmienił
ustawione przez węzeł
tylko do odczytu (ścieżki, prefiksy)
Węzeł, który nie odpowiada, pokazuje swoje bazy danych jako niedostępne do wyboru.
Zmiany wymagają fbagent (inaczej fbagent_required).
Kto restartuje Firebird (Firebird czyta replication.conf tylko przy
starcie):
Węzeł
Kto
master
restartujesz go ty: master nigdy nie restartuje Firebird sam
replica z firebird.auto_restart: never
ty
replica, której Firebird obsługuje też bazy danych mastera
ty
pozostałe repliki
węzeł go restartuje we własnym oknie restartu
Do ręcznego restartu strona ma przycisk Uruchom ponownie Firebird.
7.2. Główne parametry
Master, Firebird 4/5:
Parametr
Etykieta w RCM
Wartość węzła
Firebird
Wskazówka
journal_archive_timeout
Limit czasu archiwum
10 s
60 s
ile sekund Firebird czeka, zanim zamknie niedokończony segment. Niżej — replica jest bliżej mastera. Musi być mniejsze niż limits.data_check_quiet_sec (90)
journal_segment_count
Liczba segmentów
64
8
ile segmentów może leżeć w .ReplLog. Musi być większe niż limits.backlog_critical (48)
journal_segment_size
Rozmiar segmentu
—
16 MB
od 1 MB do 512 MB; odbiorca nie przyjmie więcej niż 512 MB
buffer_size
—
1 MB
Węzeł zapisuje też log_errors = true (nie da się zmienić) i
disable_on_error = true.
Replica, Firebird 4/5:
Parametr
Etykieta w RCM
Firebird
Wartość
apply_idle_timeout
Pauza bezczynności
10 s
pauza, gdy nie ma nowych segmentów
apply_error_timeout
Pauza po błędzie stosowania
60 s
pauza przed ponowieniem po błędzie
verbose_logging
node: true
szczegółowy replication.log; wyłączanie nie jest zalecane
skip_upddel_without_pk
node: true
pomijaj UPDATE/DELETE na tabelach bez klucza
Tylko Firebird 5: include_filter, exclude_filter, cascade_replication.
HQbird 2.5/3.0 — klucze log_* o tym samym znaczeniu: log_archive_timeout,
log_segment_count, log_segment_size (nie mniej niż 2 × buffer_size). Klucz
alert_command ustawia się tylko w node.json.
Wskazówka do każdego parametru jest w formularzu RCM.
7.3. Przechowywanie archiwum
Archiwum <database>.LogArch na masterze jest czyszczone etapami:
Segmenty zastosowane przez wszystkie repliki i starsze niż
retention_days.
Jeśli wolnego miejsca jest mniej niż free_space_floor_gb — zastosowane segmenty
młodsze niż okres przechowywania. Alert disk_serious_cleanup.
Jeśli miejsca nadal brakuje — segmenty niezastosowane, od najstarszych.
Replica dostaje NEEDS_REINIT, alert
replication_paused_reinit_scheduled.
Parametr (Ustawienia → Węzły, Pamięć i pliki)
Domyślnie
limits.retention_days — Przechowywanie archiwum, dni
2
limits.retention_min_kept_segments — Zawsze zostawiaj ostatnie segmenty
0 (wyłączone)
limits.free_space_floor_gb — Minimalne wolne miejsce
1 GB
Ustawienia → Węzły, „Pamięć i pliki”
Wyczyść archiwum ręcznie:
Command
hqbirdrcm cleanuparchive -node node-a # stages for all databases on the nodehqbirdrcm cleanuparchive -node node-a -db <db_id> # a single database
-orphaned (tylko razem z -db) usuwa wszystkie segmenty bazy danych w stanie
ORPHANED (rozdział 3.8). Dla każdej innej bazy danych węzeł odpowie not_orphaned.
Nigdy nie uruchamiaj -orphaned na donorze promocji (rozdział 8.5).
7.4. Transfer: kompresja, szybkość, okna
Kompresja jest ustawiana dla każdego partnera: Ustawienia → Węzły → Partnerzy, kolumna
compress.
Wartość
Znaczenie
puste albo none
bez kompresji (domyślnie)
zstd
kompresja zstd
Zmiana działa od razu. Kompresja przydaje się w wolnej sieci.
Szybkość transferu segmentów (Ustawienia → Węzły, Transfer i
ponowna inicjalizacja):
Jednostką jest mebibajt (MiB), choć nazwa mówi „mbps”. Impuls nie może być
mniejszy niż szybkość.
Ustawienia → Węzły, „Transfer i ponowna inicjalizacja”
Okna czasowe (Okna czasowe):
Parametr
Domyślnie
Kiedy zaczyna działać
Na co wpływa
windows.restart_window — Okno restartu Firebird
master 22:00-05:00, replica always
natychmiast
kiedy węzeł replica może zrestartować Firebird
windows.transfer_window — Okno transferu
23:00-05:00
po restarcie węzła
szybkość pełnej inicjalizacji (rozdział 5.5)
Etykieta obok każdego pola pokazuje, kiedy zmiana zaczyna działać: natychmiast albo
restart węzła.
Ustawienia → Węzły, „Okna czasowe”
7.5. Sprawdzanie danych
Sprawdź — jednorazowe porównanie liczby wierszy na masterze i na replice
(rozdział 5.10).
Sprawdzanie danych — porównanie okresowe (rozdział 5.10). Węzeł wykonuje porównanie,
gdy master i replica są na tym samym segmencie.
W HQbird 2027.2.24 ustawienia weryfikacji działają od razu po
Zapisz; restart usługi węzła nie jest wymagany. RCM pokazuje „Zapisano i już
obowiązuje”. Po włączeniu pierwsza weryfikacja rusza po jednym interwale. Po
wyłączeniu trwająca weryfikacja jest przerywana i nic nie zapisuje. Nowy
interwał liczy się od końca ostatniej weryfikacji. Przechowuj, dni, Limit
zapytania, Cisza i Generator postępu działają od następnej
weryfikacji.
Węzeł 2027.5.7 czyta te ustawienia tylko przy starcie: po
Zapisz zrestartuj usługę hqclusternode na tym węźle. RCM
2027.2.24 pokazuje „Zapisano, ale jeszcze nie obowiązuje” i podaje powód.
Które tabele porównywać, określa lista tabel bazy danych (rozdział 3.1). W HQbird
2027.2.24 każda baza danych może mieć własną listę: pole przy rejestracji albo blok
Tabele śledzenia synchronizacji na stronie bazy danych mastera
(rozdział 3.3). Strona Sprawdzanie danych pokazuje, której listy
użyto, oraz liczbę tabel „nie ma w bazie danych”. W 2027.5.7 lista jest na węzeł
(sync_tables).
Tabele wykluczone z publikacji są pokazane jako „nie opublikowana”
(rozdział 6.3).
Strona sprawdzania danych
7.6. Alerty
Strona alertów
Strona Alerty. Działania:
Potwierdź — alert pozostaje widoczny, ale jest oznaczony jako potwierdzony;
Wycisz na 60 min — ukryj na godzinę;
Usuń / Usuń wszystkie z tym kodem — RCM przekazuje usunięcie węzłowi,
który podniósł alert. Jeśli przyczyna zostaje, alert pojawi się ponownie.
Command
hqbirdrcm clearalerts -code backlog_warn # also -id, -acked, -all
Od HQbird 2027.2.33 RCM wysyła alerty do Telegrama, na webhook (Slack,
Teams, JSON) i e-mailem. Kanały konfiguruje się w sekcji notify.channels
pliku rcm.json. Blok Kanały powiadomień na stronie
Alerty pokazuje kanały i wysyła wiadomość testową. RCM zgłasza
problemy poziomu warn i wyżej: problem się pojawił, stał się poważniejszy
albo został usunięty. Bez kanałów RCM nic nie wysyła. Wcześniejsze
wersje nie wysyłają: obserwuj stronę Alerty albo odpytuj API RCM.
Firebird nie działa albo zapisuje błędy do dziennika
firebird_not_answering
od HQbird 2027.2.30: Firebird nie odpowiedział na połączenie z bazą danych przez minutę (zawieszenie). Obejmuje to też połączenie, które nie doszło do skutku przez limit czasu; firebird_down to tylko odmowa połączenia
master_publication_off
publikacja jest wyłączona (rozdział 6); od HQbird 2027.2.24 i po błędzie publication_off (rozdział 6.1)
replica_removed_for_reinit
od HQbird 2027.2.24: replica usunęła starą kopię do inicjalizacji i nie ma jeszcze nowej kopii (rozdział 4.4)
orphaned_database
baza danych poza skanowaniem (rozdział 3.8)
restart_required_after_reinit
Firebird repliki wymaga restartu (rozdział 5.6)
data_mismatch
kontrola okresowa znalazła rozbieżność
license_paused
fbagent nie ma licencji (rozdział 2.8)
7.7. Wstrzymywanie wysyłania
Na stronie Bazy danych, w wierszu mastera: Wstrzymaj wysyłanie /
Wznów wysyłanie. Dla kilku baz danych — przez listę Akcja.
Potwierdzenie wstrzymania wysyłaniaWiersz mastera podczas pauzy
Pauza obowiązuje do Wznów wysyłanie albo do inicjalizacji.
Firebird mastera nadal zapisuje segmenty. Archiwum .LogArch rośnie: dopóki
replica jest zatrzymana, etap 1 (7.3) nie usuwa jej segmentów.
Długa pauza może dojść do etapu 3 i NEEDS_REINIT. Pilnuj miejsca.
Przycisku nie ma, jeśli baza danych nie ma repliki albo publikacja jest wyłączona. Ikona
Pauza: brak licencji oznacza pauzę z powodu licencji (rozdział 2.8); znika
tylko dzięki licencji.
7.8. Dzienniki
Dziennik
Gdzie
Węzeł
<folder instalacji>/logs/node-YYYYMMDD.jsonl (/opt/hqclusternode albo C:\hqclusternode), po 32 MB, 20 plików
Firebird replication.log, firebird.log
ścieżki w node.json: firebird.replication_log, firebird.firebird_log
RCM
Linux: journalctl -u hqbirdrcm
Audyt RCM
rcm-data/audit.jsonl
Zdalny dziennik węzła — strona Dzienniki: wybierz węzeł i źródło
(replication.log, firebird.log, agent węzła).
potrzebujesz osobnej kopii roboczej: raporty, testy, awaria bez nowego mastera
zwykła baza danych poza replikacją
Promuj do mastera, 8.3
replica ma zostać nowym masterem
baza danych zarządzana przez węzeł towarzyszący z rolą master
Żadnej ze ścieżek nie da się cofnąć przez interfejs.
8.1. Ustaw jako zwykłą
Lista „Akcja” repliki: pozycja „Ustaw jako zwykłą”
Bazy danych, strona repliki: zaznacz wiersze repliki.
Na liście Akcja wybierz Ustaw jako zwykłą i potwierdź.
W wierszu nie ma osobnego przycisku. Nie ma też polecenia wiersza poleceń.
Potwierdzenie „Ustaw jako zwykłą”
3. Węzeł replica:
- uruchamia `gfix -replica none` (HQbird 2.5/3.0: `gfix -replica {}`). Jeśli
baza danych jest zajęta stosowaniem segmentów, węzeł wprowadza ją na kilka sekund w
zamknięcie `single` (`gfix -shut single -force 0`), czyści tryb replica i
przywraca ją przez `gfix -online normal`. **Wszystkie połączenia z tą bazą danych
są zrywane**;
- zapisuje plik znacznika `.hqcluster-normal.json` (czas, autor, db_id,
GUID);
- zaczyna czyścić kolejkę `.Incoming` (8.2).
4. RCM pokazuje bazę danych w grupie **Nie jest repliką (zwykła)**.
Strona „Bazy danych” po „Ustaw jako zwykłą”
Potem baza danych jest otwarta do zapisu.
Usuń blok repliki z replication.conf. Węzeł usuwa go przy następnym
skanowaniu, a Firebird czyta plik przy starcie:
Do tego czasu błędy „baza danych nie jest w trybie replica” dla tej bazy danych nie są
podnoszone jako alerty.
Plik znacznika chroni bazę danych. Inicjalizacja nie nadpisze takiej bazy danych:
zostanie odrzucona z target_not_replica (rozdział 5.9). Samo usunięcie znacznika nie wystarczy:
węzeł sprawdza też tryb replica w nagłówku bazy danych. Pole Usuń starą
replikę (rozdział 4.4) też nie usuwa takiej bazy danych.
W HQbird 2027.2.24, gdy replica usuwa starą kopię tej bazy danych do
inicjalizacji, Ustaw jako zwykłą jest odrzucane z reclaim_in_progress:
spróbuj później.
Jeśli baza danych ma znów zostać repliką — wystarczy tylko nowa inicjalizacja z
nadpisaniem. Robi się to przez API węzła (overwrite_non_replica: true); w
RCM nie ma takiego przycisku. Stary plik jest zapisywany jako
<database>.pre-reinit-<czas UTC>.fdb, a znacznik jest usuwany.
8.2. Co dzieje się z segmentami
Dopóki węzeł nie przeskanuje baz danych, master nadal wysyła segmenty. Co 30 sekund węzeł replica usuwa stare segmenty i zostawia tylko ostatnie 100 (keep_segments).
Po skanowaniu rekord bazy danych na replice dostaje stan ORPHANED. Węzeł replica odpowiada masterowi unknown_database. Master przestaje wysyłać segmenty do tej repliki, przestaje trzymać dla niej archiwum i sprawdza ją ponownie co 10 minut.
Inne repliki tej bazy danych nie są dotknięte.
Rekord ORPHANED można usunąć (rozdział 3.8): hqbirdrcm forgetdatabase. Sam plik bazy danych nie jest usuwany.
8.3. Promuj do mastera
Replica staje się nowym masterem. Jej plik zostaje na miejscu, a sterowanie
przechodzi do węzła towarzyszącego.
Warunki:
Warunek
Odrzucenie
baza danych jest repliką
bad_request
na tym samym hoście działa węzeł z rolą master — towarzyszący — (ta sama etykieta host w rcm.json, rozdział 2.1)
no_companion
promocja tej bazy danych jeszcze nie trwa
already_running
nie trwa inicjalizacja do tej bazy danych ani z jej mastera
reinit_running
RCM nie tworzy węzła towarzyszącego: zainstaluj go wcześniej (rozdział 1).
Jak zacząć:
w wierszu repliki, Promuj do mastera, albo na liście Akcja;
RCM poprosi o potwierdzenie i poda węzeł towarzyszący.
Potwierdzenie „Promować do mastera?”
Kroki (widoczne w wierszu repliki, nazwy po angielsku):
Nr
Krok
Co robi
1
TURN TO NORMAL
jak w 8.1; pomijany, jeśli baza danych jest już zwykła
2
NEW GUID
nowy GUID bazy danych na miejscu (8.4)
3
EXCLUDE ON DONOR
węzeł replica (donor) wyklucza plik ze swojego skanowania (exclude_paths)
4
ENROLL ON
węzeł towarzyszący rejestruje plik jako bazę danych mastera
5
PUBLICATION SYNC
synchronizacja publikacji; lista wykluczonych tabel przechodzi ze starego mastera (rozdział 6.3)
6
RESTART DONOR FIREBIRD
restart Firebird donora, bez czekania na okno
7
RESTART FIREBIRD
restart Firebird węzła towarzyszącego, bez czekania na okno
8
FINALIZE
wiersz donora staje się Repliką-widmem; stary master może stać się Masterem zdegradowanym (8.5)
Kroki promocji w wierszu repliki
W HQbird 2.5 i 3.0 nie ma publikacji: krok PUBLICATION SYNC
kończy się tekstem „ten silnik nie ma publikacji”.
Kroki promocji w HQbird 3.0 (Windows)
Jeśli donor i węzeł towarzyszący używają tego samego Firebird, ten Firebird jest
restartowany: połączenia ze wszystkimi jego bazami danych są zrywane.
Jeśli krok się nie uda, zadanie dostaje failed z tekstem błędu. Usuń
przyczynę i kliknij ponownie Promuj do mastera: ukończone kroki nie są
powtarzane. Jeśli RCM zrestartuje się podczas promocji, zadanie też stanie się
failed — sprawdź stan węzłów i spróbuj ponownie.
Licencja. Jeśli fbagent na hoście mastera nie ma licencji, master
wstrzymał wysyłanie. Promocja nadal jest możliwa. RCM ostrzeże:
zmiany wykonane po początku pauzy zostaną utracone.
8.4. Nowy GUID
Po promocji baza danych musi dostać własny GUID. Inaczej nowy master zapisuje
segmenty pod GUID starego mastera, a jego repliki są odrzucane z
duplicate_guid.
Krok NEW GUID na węźle:
gfix -shut single -force 0 — wszystkie połączenia z bazą danych są kończone;
nbackup -L, potem nbackup -F bez -SEQUENCE;
usuwa <database>.delta;
sprawdza nagłówek: nowy GUID, REPLICATION_SEQUENCE = 0;
gfix -online normal.
Firebird nie jest restartowany. Metoda działa we wszystkich wersjach (2.5, 3.0, 4.0,
5.0).
Jeśli krok został przerwany, węzeł podnosi alert newguid_interrupted. Baza danych może
zostać w zamknięciu single. Powtórz Promuj do mastera: krok
będzie kontynuowany.
Krok jest pomijany (tekst zaczyna się od skipped:), jeśli węzeł donora jest starą
wersją albo plik ma już własny GUID.
Po nowym GUID stary łańcuch nbackup już nie pasuje. Zrób nową kopię nbackup poziomu 0.
Jeśli baza danych została utworzona z ADD DIFFERENCE FILE, jej .delta leży w innym
miejscu: usuń ją ręcznie.
8.5. Po promocji
Rekord donora. Na węźle replica baza danych pozostaje ORPHANED, ścieżka zostaje w
exclude_paths, a folder .Incoming i etykieta zostają. W RCM jest to wiersz
Replika-widmo z przyciskami Otwórz na nowym masterze i Wyczyść.
Wiersz donora: „Replika-widmo”
Aby usunąć wiersz, kliknij Wyczyść. To zmienia tylko RCM.
Aby usunąć rekord donora z węzła replica, uruchom forgetdatabase.
Plik i folder .Incoming zostają. HQbird 2027.2.30 i nowszy nie
odrzuca polecenia (mailbox_active), bo ścieżka donora jest w
exclude_paths. Węzły wcześniejszych wersji odrzucają je, dopóki są plik i
folder .Incoming.
Nigdy nie uruchamiaj cleanuparchive -orphaned na donorze. Donor i
węzeł towarzyszący dzielą ten sam folder <database>.LogArch. Polecenie usunie żywe
archiwum nowego mastera.
Stary master.
Jeśli donor był jego ostatnią działającą repliką, RCM ustawia starego
mastera na Master zdegradowany i wstrzymuje wysyłanie do donora
(„wysyłanie wstrzymane: … (promocja do mastera)”). Nie wznawiaj
wysyłania do donora: ma już działającą bazę danych. Aby wyczyścić ten stan,
zainicjalizuj bazę danych na inną replikę.
Stary master: „Master zdegradowany”, wysyłanie wstrzymane
Inicjalizacja ze starego mastera na węzeł donora zostanie odrzucona
(target_not_replica): ma już działającą bazę danych.
Jeśli krok NEW GUID został pominięty, stary i nowy master mają ten sam GUID.
Wtedy inicjalizacja ze starego mastera wymaga -force (rozdział 5.9).
Po ręcznej promocji RCM nie zamienia starego mastera w replikę nowego
mastera. Zatrzymaj aplikacje na starym masterze i usuń jego bazę danych z
zarządzania (rozdział 3.8). Dla bazy danych opisanej jako usługa robi to Ponowne dołączenie
(8.7).
Nowy master. Przygotuj dla niego replikę: węzeł replica, partnerzy (rozdział 2),
publikacja (rozdział 6), inicjalizacja (rozdział 5).
Nowy master: baza danych z nowym GUID, jeszcze bez repliki
8.6. Planowane przełączenie: lista kontrolna
To procedura ręcznego przełączenia. Dla bazy danych opisanej jako usługa RCM sam przełącza mastera (8.7). Ręczna promocja nie sprawdza, czy aplikacje piszą do starego mastera. Procedura:
Z wyprzedzeniem. Na hoście repliki działa węzeł towarzyszący z rolą master, a oba węzły mają tę samą etykietę host (rozdział 2.1). Węzeł przyszłej repliki jest gotowy dla nowego mastera.
Zatrzymaj zapisy aplikacji do bazy danych starego mastera.
Poczekaj, aż replica odbierze i zastosuje wszystko: Bazy danych → IN_SYNC, bez kolejki.
Sprawdź (rozdział 5.10): liczby wierszy się zgadzają.
Promuj do mastera (8.3). Poczekaj na krok FINALIZE.
Sprawdź: baza danych jest na liście masterów węzła towarzyszącego, publikacja włączona.
Przełącz aplikacje na nowego mastera.
Zrób kopię nbackup poziomu 0 nowej bazy danych (8.4).
Wyczyść rekord widma dla wiersza donora (8.5).
Podłącz replikę do nowego mastera i zainicjalizuj ją (rozdział 5).
Stary master: usuń bazę danych z zarządzania albo zostaw ją jako archiwum (8.5).
8.7. Usługi: przełączenie i przejęcie awaryjne w RCM
W HQbird 2027.2.30 RCM sam przenosi mastera na inny host. W tym celu baza danych jest opisana jako usługa: jedna logiczna baza danych na kilku hostach. Na każdym hoście usługi jest węzeł master i węzeł replica, a ścieżka do pliku bazy danych jest taka sama. Usługę tworzy się na stronie Usługi (od HQbird 2027.2.31) albo poleceniem hqbirdrcm services put -id <id> -file <file>.json.
Działanie
Co robi
Polecenia
Przełączenie
planowane przeniesienie mastera bez utraty danych. Potem stary master automatycznie staje się repliką nowego mastera
po przejęciu awaryjnym przywraca stary host jako replikę nowego mastera
hqbirdrcm rejoin -service <id>
Wznów
wyprowadza usługę ze stanu failed
hqbirdrcm resume -service <id> -check, potem hqbirdrcm resume -service <id>
Te same działania są na stronie usługi: przyciski Przełączenie…, Przejęcie awaryjne…, Ponowne dołączenie… i Wznów….
Automatyczne przejęcie awaryjne jest domyślnie wyłączone. Włącza się je osobno dla każdej usługi:
hqbirdrcm policy -service <id> -auto-failover on -max-data-loss 30.
Wymaga routerów. RCM uruchamia przejęcie awaryjne tylko wtedy, gdy węzeł master milczy, większość routerów nie widzi Firebird mastera, a opóźnienie repliki nie przekracza max_data_loss_sec.
Router (hqclusternode router, Linux) trzyma HAProxy na bieżącym masterze usługi. Aplikacje łączą się z <router host>:<router_port> i nie zmieniają ciągu połączenia przy przełączeniu.
Po przejęciu awaryjnym RCM ustawia starego mastera w rolę fenced, gdy ten znów odpowie. Przywróć go poleceniem rejoin.
Ta strona używa plików cookie, aby poprawić Twoje doświadczenia i zapamiętać preferencje.