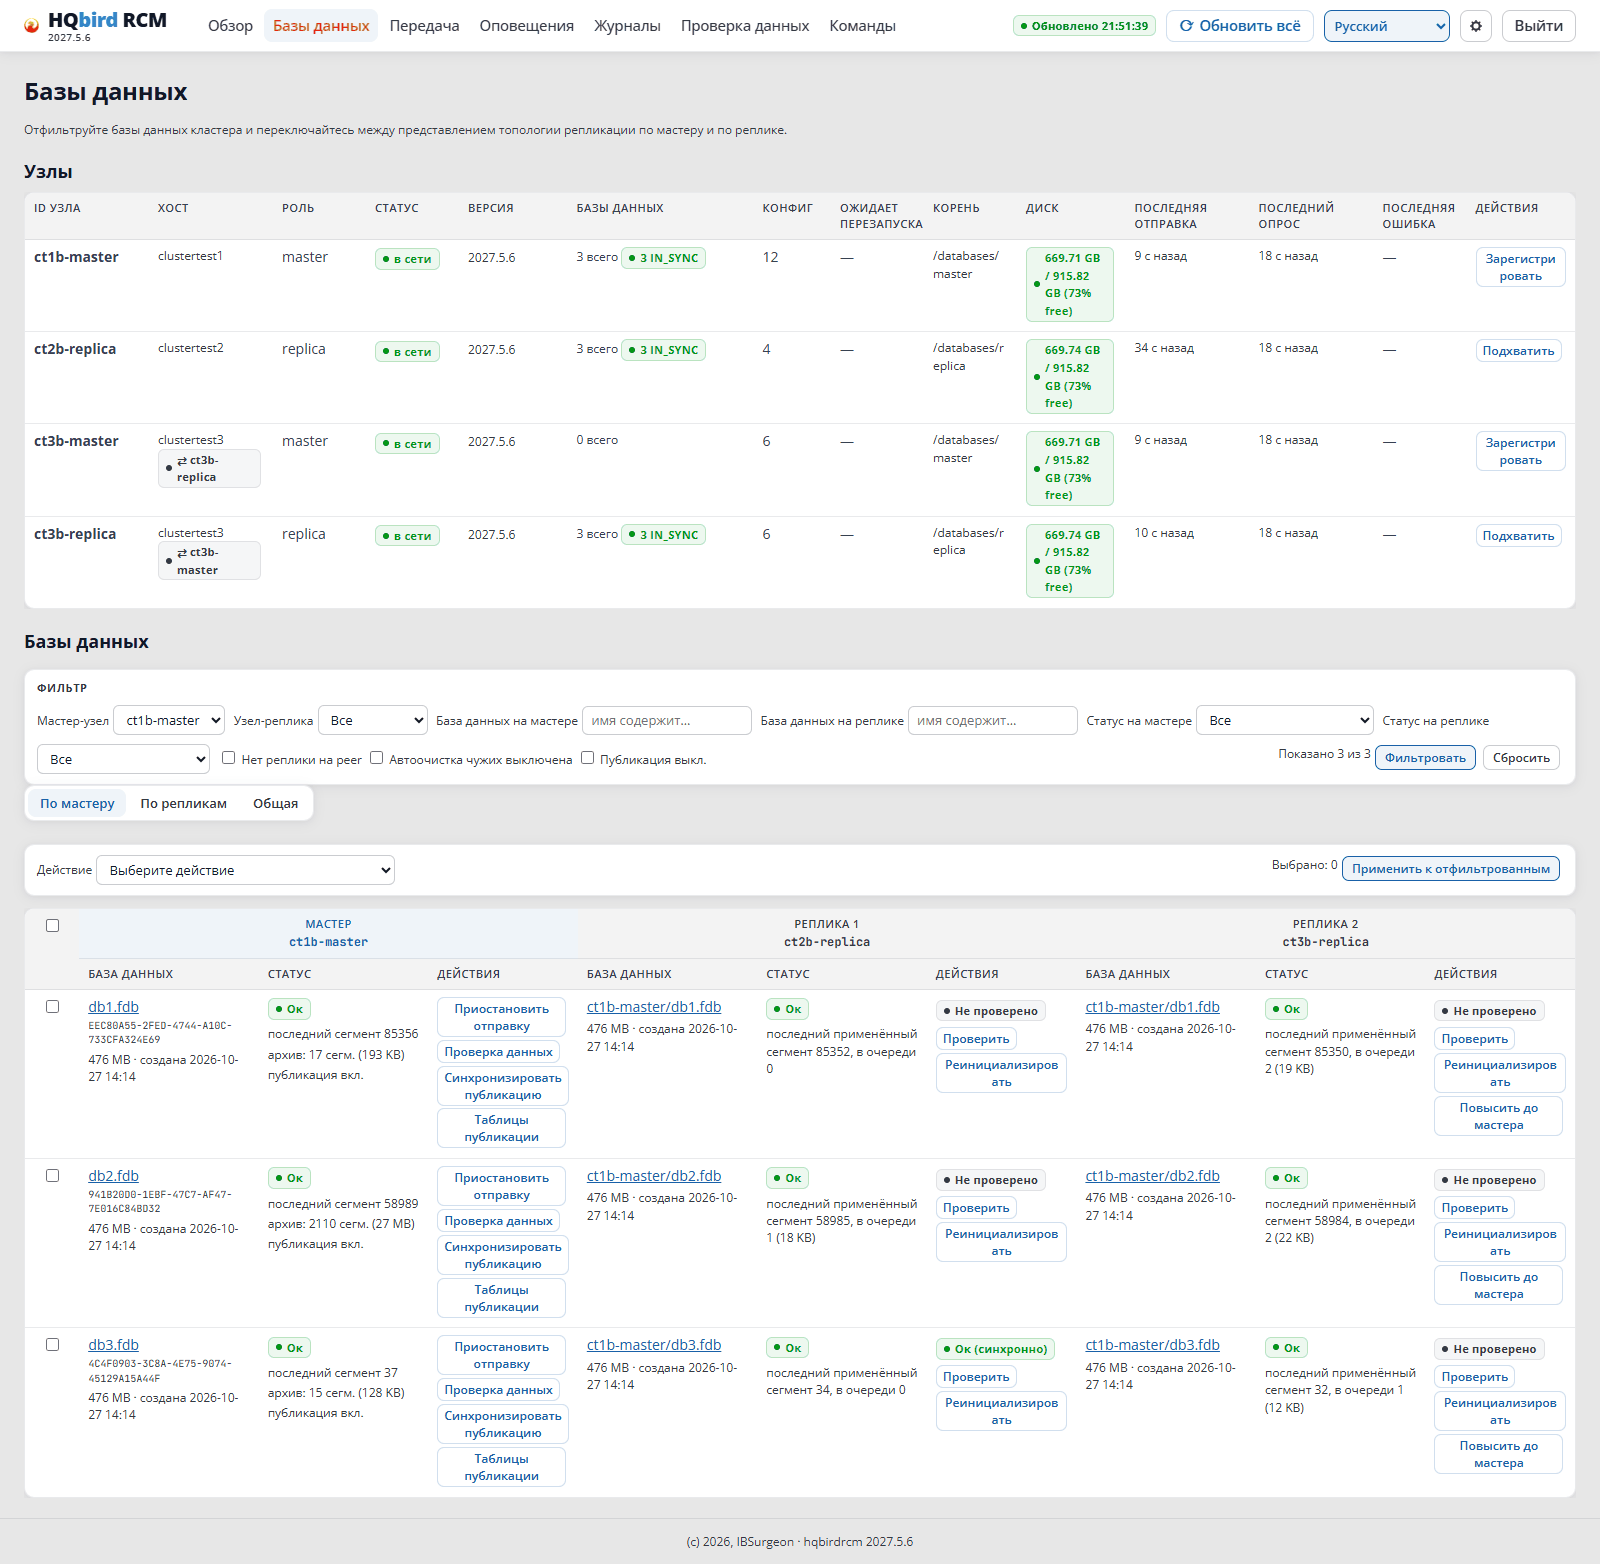
Tato příručka popisuje, jak nainstalovat a používat replikační cluster HQbird:
uzly hqclusternode a správce clusteru hqbirdrcm (RCM).
Je to příručka pro správce Firebird. Předpokládáme, že znáte Firebird,
gfix a nbackup. Vnitřní fungování uzlu znát nemusíte.
Z čeho se cluster skládá
Součást
Kolik
Kde běží
Co dělá
Firebird (HQbird)
jedna nebo více instancí
na každém databázovém serveru
ukládá databáze, zapisuje replikační segmenty
fbagent
jeden na instanci Firebird
vedle Firebird
zastavuje a spouští Firebird na žádost uzlu
hqclusternode (uzel)
jeden na instanci a roli
vedle Firebird
nastavuje replikaci, přenáší segmenty, provádí inicializaci repliky
hqbirdrcm (RCM)
jeden na cluster
na libovolném hostiteli, který vidí všechny uzly
webové rozhraní, příkazy, výstrahy, statistiky
Uzel má roli: master nebo replica. Na jedné
instanci Firebird mohou běžet dva uzly: hlavní uzel a uzel repliky.
V tom případě jsou některé databáze tohoto Firebird hlavní a jiné jsou repliky.
Jak to funguje
Na hlavním uzlu zapisuje Firebird změny databáze do segmentů (souborů
replikačního protokolu).
Hlavní uzel posílá segmenty uzlu repliky zabezpečeným kanálem (mTLS).
Uzel repliky ukládá segmenty do složky příchozích segmentů. Firebird repliky
je aplikuje na svou kopii databáze.
Hlavní uzel sám přenese první kopii databáze na repliku. Tomu se říká
inicializace (reinit). Probíhá přes nbackup a hlavní uzel po tu dobu
běží dál.
Uzly posílají statistiky do RCM. RCM ukazuje stav clusteru a
posílá operátorské příkazy uzlům.
Jak cluster funguje: segmenty, inicializace, statistiky a příkazy operátora
Podporované verze
Firebird / HQbird 5.0 a 4.0 — všechny funkce.
HQbird 3.0 a 2.5 — replikace přes plugin replconf. Publikace neexistují;
sada tabulek je určena filtry. Rozdíly jsou popsány v rámečcích „HQbird 2.5/3.0“.
Hlavní verze Firebird na hlavním uzlu a na replice se musí shodovat. Jinak uzel
repliky inicializaci odmítne.
Porty
Port
Kdo naslouchá
Kdo se připojuje
K čemu
7051
uzel
ostatní uzly a RCM
API uzlu, přenos segmentů a kopií databází
7443
RCM
všechny uzly
příjem statistik z uzlů
7444
RCM
operátor
webové rozhraní a API operátora. Instalace přes RCM (kapitola 1.3): HTTPS na všech adresách. Instalace přes HQCenter Admin nebo ručně: HTTP, pouze 127.0.0.1
7450–7459
fbagent, dokud je okno propojení otevřené
RCM
propojení hostitelů (kapitola 1.3)
13050
fbagent, pouze 127.0.0.1
uzel na stejném hostiteli
správa Firebird
3050
Firebird
aplikace
běžný provoz databáze
Jsou-li na jednom hostiteli dva uzly (hlavní a replika), má druhý uzel jiný port.
Při instalaci přes RCM dostane druhý uzel port 7061. V ostatních případech
port nastavíte sami, například 7052.
Port 13050 nesmí být vystaven do sítě. Port 7444 s HTTP (instalace přes
HQCenter Admin nebo ručně) také ne: k webovému rozhraní RCM se připojte
přes SSH tunel (kapitola 1). Při instalaci přes RCM běží port 7444 přes
HTTPS a instalátor ho otevře ve firewallu.
Hlavní pravidlo: bez fbagent žádné změny
Uzel mění konfiguraci replikace jen přes fbagent: musí
restartovat Firebird. Není-li fbagent dostupný, uzel odmítne každou akci,
která mění konfiguraci. Nefunguje „napůl“.
Pojmy
Pojem
Význam
Segment
soubor replikačního protokolu se změnami databáze
Publikace
seznam tabulek hlavního uzlu, jejichž změny jdou do segmentů (Firebird 4/5)
Inicializace (reinit)
přenos kopie databáze z hlavního uzlu na repliku přes nbackup
GUID databáze
identifikátor databáze Firebird; RCM ho používá k propojení hlavního uzlu a repliky
Partner
partnerský uzel: u hlavního uzlu jeho repliky
Společník
druhý uzel na stejné instanci Firebird (hlavní uzel a replika na jednom hostiteli)
HQCenter Admin není, ale potřebujete certifikáty, konfiguraci a aktualizace bez ruční práce; až 3 databázové servery
na každém hostiteli nainstalujete HQbird, přihlásíte se do RCM a v Nastavení → Propojit hostitele uvedete adresy hostitelů
Ručně (1.4)
bez přístupu k HQCenter Admin, uzavřená síť, zvláštní požadavky
nainstalujete soubory, vytvoříte certifikáty, napíšete node.json a rcm.json, zaregistrujete služby
Přes HQCenter Admin a přes RCM uzly a RCM neinstalujete sami. Instaluje je
fbagent, když ho přidáte do clusteru (kapitola 2). Certifikáty a
konfigurace se také vytvoří automaticky.
Linux a Windows jsou popsány v jedné kapitole. Rozdíly Windows jsou v
rámečcích „Ve Windows“.
1.1. Požadavky
Na každém databázovém serveru:
Firebird / HQbird 5.0, 4.0, 3.0 nebo 2.5 (2.5 — pouze Linux).
fbagent vedle každé instance Firebird. Bez fbagent uzel nefunguje.
Synchronizace času (NTP, chrony, w32time) na všech serverech a na
hostiteli RCM. Okna restartu a přenosu, odhad zpoždění a
kontrola „uzel neodpovídá“ závisí na hodinách.
Volné místo pro archiv segmentů a pro inicializaci repliky (kapitola 4).
Windows: oprávnění správce, x64, Windows 10 / Server 2016 nebo novější,
64bitový Windows PowerShell 5.1. Ve Windows 10 a Server 2016–2022 je nutný 7-Zip.
Kde poběží RCM. Na cluster je potřeba jedno RCM. Lze ho nainstalovat na libovolný
server, který vidí všechny uzly, včetně jednoho z databázových serverů.
1.2. Instalace přes HQCenter Admin
Krok 1. Spusťte instalační skript fbagent
Skript nainstaluje Firebird (sestavení HQbird), fbagent a zaregistruje fbagent na
serveru HQCenter Admin. Zvolte skript podle verze Firebird: fb25, fb30, fb40,
fb50.
Linux (jako root):
Command
sudo sh fbagent-fb50_known.sh --goafts <HQCenter-Admin-server> --enroll --cluster
Ve Windows parametr -Cluster není: fbagent běží jako
LocalSystem a složky clusteru vytvoří sám.
Hlavní parametry:
Linux
Windows
Význam
--goafts <name>
-Goafts
server HQCenter Admin, odkud se stahuje; název dodá váš dodavatel
--enroll
-Enroll
zaregistrovat fbagent v HQCenter Admin (žádost o certifikát)
--cluster
—
vytvořit složky /opt/hqclusternode a /opt/hqbirdrcm (nutné jen pro fbagent 2.55.2 a starší; u novějších verzí neškodí)
--channel
-Channel
kanál aktualizací fbagent, výchozí stable
--token
-Token
licenční token: HQCenter Admin žádost schválí automaticky
--port
-Port
port Firebird
--yes
-Yes
neklást otázky (nutné, když není terminál)
Úplný seznam parametrů je v README instalačního skriptu fbagent.
Krok 2. Schvalte žádost fbagent
S parametrem --enroll pošle fbagent žádost o certifikát (CSR) do HQCenter Admin a
čeká na schválení až 30 minut. Schválit ji můžete takto:
automaticky — pokud instalace běžela s licenčním tokenem (--token) a
licence má volné místo;
v panelu HQCenter Admin — sekce žádostí CSR, žádost
tohoto hostitele, tlačítko schválit a podepsat;
přes API HQCenter Admin — POST /v1/admin/csr-requests/{id}/approve.
Pokud se registrace nezdařila (například vypršel čas čekání), fbagent přesto
funguje, ale skript skončí kódem 2. Spusťte skript znovu se
stejnými parametry: zopakuje se jen registrace.
Několik minut po registraci si fbagent sám nainstaluje HQ Monitor.
Krok 3. Popište cluster
Uzly a RCM se objeví, jakmile přidáte fbagent do clusteru HQCenter Admin. Jak cluster popsat,
je v kapitole 2.
Po uložení clusteru:
Do 10 minut fbagent dostane cluster z HQCenter Admin (potom kontroluje
změny každých 60 sekund).
fbagent na hostiteli RCM vytvoří certifikační autoritu clusteru (CA) a podepíše
certifikáty všech uzlů.
Každý fbagent zapíše node.json nebo rcm.json pro členy
svého clusteru.
Při další kontrole produktu (každé 3 minuty) fbagent nainstaluje a
spustí služby.
<port> je port Firebird, například 3050. Jeden fbagent může hostit nejvýše
jeden hlavní uzel, jeden uzel repliky, jedno RCM a jeden směrovač
(hqclusternode router, od HQbird 2027.2.30, kapitola 8.7).
Ve Windows. Verze fbagent před 2.83.0 instalovaly uzly do C:\hqclusternode a
RCM do C:\hqbirdrcm. Pokud tyto složky existují, fbagent je dál
používá.
Aktualizace
fbagent kontroluje nové verze uzlu a RCM každé 3 minuty; výchozí
kanál je stable. Nejdřív se aktualizuje uzel repliky, potom hlavní uzel.
Pokud se po aktualizaci služba nespustí nebo hlásí špatnou verzi,
fbagent se vrátí k předchozí verzi a novou zablokuje. Seznam blokací:
<složka fbagent>/update/<product>/blocked-versions.json. Chcete-li verzi
zkusit znovu, smažte její řádek z tohoto souboru.
Stav produktu: fbagent --product-status hqclusternode (nebo
hqbirdrcm).
1.3. Instalace přes RCM (bez HQCenter Admin)
Cluster spravuje RCM. fbagent každého hostitele dostane popis clusteru z RCM,
fbagent na hostiteli RCM podepisuje certifikáty a uzel i RCM se aktualizují z
vydání, která RCM uchovává.
Omezení:
Jeden cluster na RCM.
Nejvýše 3 místa. Místo je hostitel, na kterém běží hlavní uzel nebo uzel repliky.
Hlavní uzel a replika na stejném hostiteli se počítají jako jedno místo. Hostitel, na kterém běží jen RCM,
místo nezabírá. Čtvrtý hostitel vyvolá chybu seats_exceeded.
RCM neaktualizuje fbagent ani Firebird. fbagent je aktualizuje sám a nesahá
na replication.conf, node.json, rcm.json ani na certifikáty.
Jsou dva způsoby:
Propojit hostitele v RCM — obvyklý způsob. Tři akce: instalátor na
každém hostiteli (RCM na jednom hostiteli, režim zjišťování na ostatních), přihlášení do
RCM, formulář Propojit hostitele.
Ručně z příkazového řádku — tokeny pro připojení a
fbagent --cluster-join. Potřebné, když je mezi hostiteli zavřený port 7450 nebo
se párovací okno už zavřelo.
Licence. Zkušební licence obsahuje funkci cluster. Po zkušební
době fbagent nenainstaluje uzel ani RCM, pokud licence nemá cluster.
Aktualizace už nainstalovaných uzlů a RCM nikdy neblokuje. Bez
HQCenter Admin plovoucí licence přestane fungovat po online_check_days plus
dny odkladu. Proto na každý fbagent nainstalujte vázanou licenci:
Command
fbagent --license-request --out license_request.json
# send the file to the vendor and receive license.jsonfbagent --license-install license.json
Bez licence hlavní uzel přestane posílat segmenty (kapitola 2.8).
Porty:
Port
Kde
Kdo se připojuje
7443
hostitel RCM
fbagent a uzly všech hostitelů clusteru
7444
hostitel RCM
prohlížeč operátora (konzole RCM, HTTPS)
7450 (na druhém a dalším fbagent — 7451…7459)
hostitel v režimu zjišťování, dokud je párovací okno otevřené
RCM na hostiteli RCM
7051 (druhý uzel téhož fbagent — 7061)
hostitelé uzlů
ostatní uzly a RCM (1.4, krok 7)
Propojení hostitelů v RCM
Příklad od nuly. Dva servery Linux, instalátor .run, propojení,
zaevidování, publikace, inicializace a reinicializace pod zátěží — se
snímky obrazovky a měřeními: příručka hqbird2027-linux-cluster-guide.ru.md a
runbook hqbird2027-linux-cluster-runbook.ru.md (repozitář goafts, složka
dokumentace).
Krok 1. Nainstalujte HQbird na každý hostitel
Nainstalujte HQbird úplným instalátorem na každý databázový server. Neregistrujte se v
HQCenter Admin (--enroll).
Ve výchozím stavu instalátor cluster nenastavuje. Programy uzlu
a RCM uloží do složky fbagent (update/<product>/staged/), ale RCM nenainstaluje, neotevře párovací
okno a neotevře porty clusteru ve firewallu. Cluster
se zapne dvěma parametry:
Command
sudo sh hqbird2027-fb50-linux-<version>.run --rcm on # RCM hostsudo sh hqbird2027-fb50-linux-<version>.run --cluster-pairing on # other hosts
--rcm on — na jednom hostiteli, kde poběží RCM clusteru. Instalátor:
vytvoří cluster tohoto hostitele (fbagent --cluster-init); název clusteru je
název hostitele;
nainstaluje a spustí RCM, konzole RCM běží přes HTTPS na portu 7444;
vytvoří prvního správce RCM rcmadmin s náhodným heslem;
otevře ve firewallu porty 7443, 7444 a port uzlu 7051.
--cluster-pairing on (režim zjišťování) — na každém dalším hostiteli.
Instalátor otevře párovací okno fbagent na 24 hodin: port 7450 a
port uzlu 7051. Dokud je okno otevřené, může RCM ze sítě pozvat tohoto hostitele do
svého clusteru. fbagent začne naslouchat na portu 7450 do jedné minuty.
Bez těchto parametrů se instalátor zeptá sám: v textovém
rozhraní je to stránka Cluster, s --no-tui — dvě otázky.
Výchozí odpověď je „ne“. --yes bez parametrů clusteru také odpoví
„ne“ na obě otázky.
Na konci instalátor vypíše řádky RCM: a Pairing:. Na hostiteli RCM:
text
RCM:        https://10.0.0.7:7444 (cluster db1)
CA hash:    sha256:7cfc1d4b…032d2582
Login:      rcmadmin
Password:   in /opt/hqbird/fbagent-fb50/clusterca/db1/rcm-initial-password (read it with sudo; RCM asks for a new one at the first login)
Pairing:    not needed: this agent runs the RCM; other agents link through it
Na jiném hostiteli:
text
RCM:        off; turn it on in HQbird Monitor or with fbagent --cluster-init <id>
Pairing:    port 7450 open until 2026-11-17T17:49:18Z (fingerprint sha256:0439e44a…91a2f9b9); an RCM may invite this host
Ve výstupu heslo není: je v souboru z řádku Password:. Zapište si
fingerprint každého hostitele v režimu zjišťování.
Parametry clusteru v instalátoru Linux:
Parametr
Co dělá
--rcm on|off
nainstaluje RCM a vytvoří cluster na tomto hostiteli; výchozí off
--cluster-pairing on|off
režim zjišťování: otevře párovací okno na 24 hodin; výchozí off
--pairing-port N
párovací port nového fbagent, 7450–7459; výchozí první volný
--rcm-password-file F
heslo správce RCM z prvního řádku souboru F, místo náhodného
--cluster-id ID
název clusteru ID místo názvu hostitele (s --rcm on)
--cluster-node on|off
nainstaluje program uzlu; výchozí on
--rcm-allow A,B
jen tato RCM smějí pozvat tohoto hostitele: adresa, síť CIDR nebo název
První fbagent na hostiteli dostane párovací port 7450 a porty uzlu 7051 a
7061. Druhá instance na stejném hostiteli — 7451, 7052 a 7062.
RCM a párovací okno lze zapnout později, bez instalátoru: v HQ Monitor,
stránka Clustery, nebo příkazy jako uživatel fbagent:
Command
cd <fbagent folder> # /opt/hqbird/fbagent-fb50sudo -u firebird ./fbagent --cluster-init <name> # RCM host; open ports 7443 and 7444 yourselfsudo -u firebird ./fbagent --cluster-pairing on # window for 24 hourssudo -u firebird ./fbagent --cluster-pairing off
sudo -u firebird ./fbagent --cluster-pairing status
Staré instalátory (fbagent před 3.1.0) se na cluster neptají:
nainstalují RCM na každý hostitel a všude otevřou párovací okno. Potřebujete RCM
jednoho hostitele; RCM ostatních hostitelů se po propojení sama zastaví.
Ve Windows. Stejné dvě volby jsou v instalátoru Windows: parametry
/RCM a /DISCOVERY.
Krok 2. Přihlaste se do RCM
Otevřete adresu z řádku RCM: hostitele RCM (https://<host>:7444). Přihlaste se
přihlašovacím jménem rcmadmin a heslem ze souboru v řádku Password:. RCM hned požádá o
nové heslo (1.5).
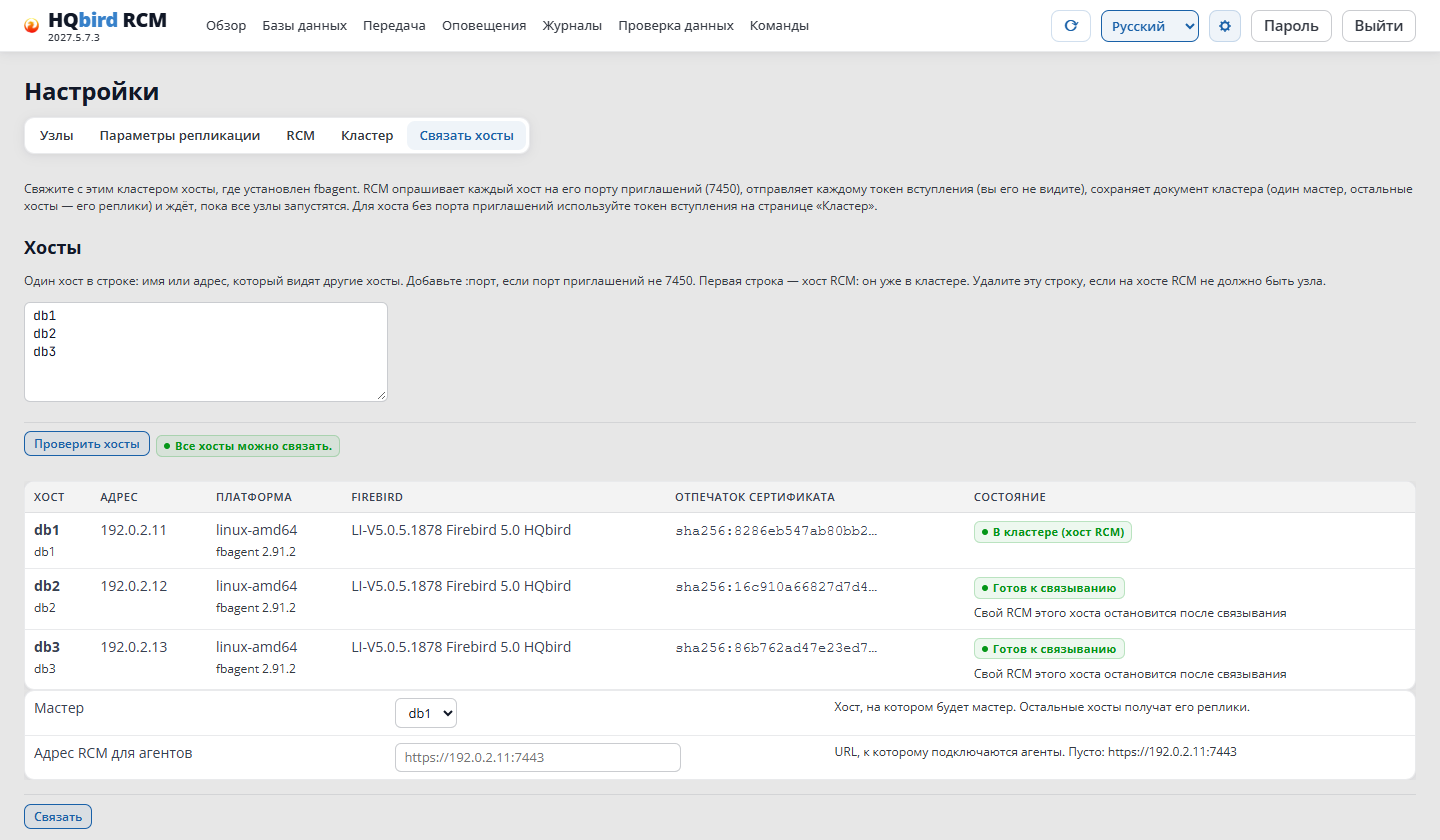
Krok 3. Propojte hostitele
V RCM otevřete Nastavení → Propojit hostitele.
Do pole Hostitelé zadejte adresy nebo názvy hostitelů, jeden na řádek.
První řádek je hostitel RCM, ten už v clusteru je.
Klikněte na Zkontrolovat hostitele. RCM vyzkouší párovací porty
7450–7459 každého hostitele a ukáže platformu, verzi Firebird,
otisk a stav. Hostitel RCM párovací okno nepotřebuje. Porovnejte
otisky s výstupem instalátoru (řádek Pairing:).
Vyberte Hlavní uzel (výchozí je první hostitel) a klikněte na Propojit.
Propojit hostitele: výsledek kontroly
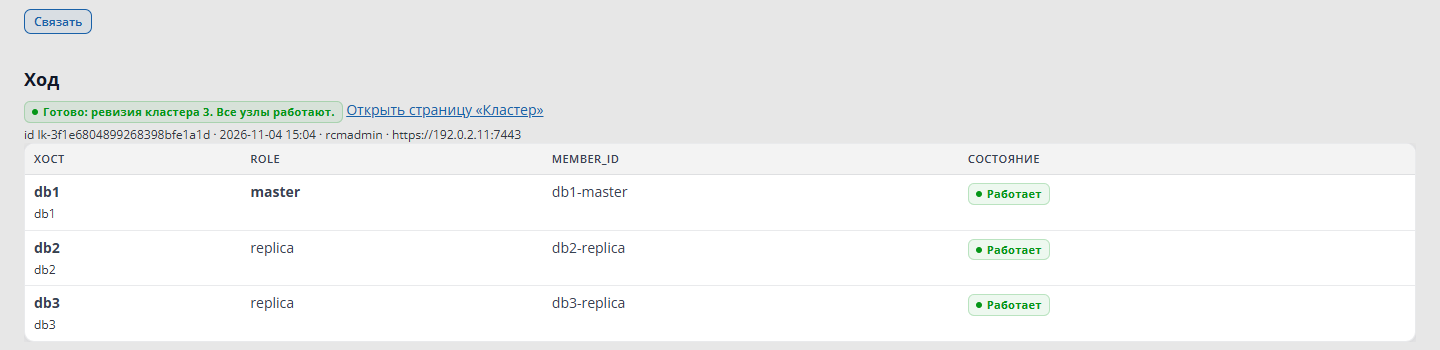
RCM požádá o potvrzení a ukazuje průběh v sekci Průběh. Když všechny uzly
běží, napíše „Hotovo“ a ukáže číslo revize clusteru:
Propojit hostitele: všechny uzly běží
Totéž z příkazového řádku:
Command
cd /opt/hqbirdrcm
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster link -hosts db1,db2,db3 -master db1
Co se stane dál:
RCM pošle pozvánku každému volnému hostiteli.
fbagent hostitele se připojí ke clusteru a zavře párovací port. Má-li
hostitel vlastní RCM bez uzlů, fbagent ho zastaví a zakáže a
prázdný cluster přesune do cluster/left/ ve složce fbagent.
RCM uloží cluster: uzel <host>-master na hlavním, <host>-replica na
ostatních hostitelích, port 7051, vazby hlavní uzel → replika.
fbagent každého hostitele nainstaluje a spustí uzel. RCM počká, až všechny uzly
běží, a u každého hostitele ukáže Běží.
Stavy hostitele po Zkontrolovat hostitele:
Stav
Co dělat
Připraven k propojení
nic. Pokud pod tím stojí „Vlastní RCM tohoto hostitele se po propojení zastaví“ — to je v pořádku
V clusteru
hostitel už je v tomto clusteru
Chyba unreachable
port 7450 je zavřený: párovací okno je vypnuté (jako ve výchozím stavu) nebo uplynulo 24 hodin. Hned po instalaci minutu počkejte a klikněte znovu na Zkontrolovat hostitele. Jinak okno otevřete (--cluster-pairing on) a zkontrolujte firewall
Chyba in_other_cluster
hostitel je v jiném clusteru
Chyba claimed
jiné RCM tohoto hostitele právě propojuje
Chyba seats_exceeded
více než 3 místa
Vydání. fbagent instaluje uzel jen z RCM. RCM bere podepsaná
vydání ze své složky import/ (vedle rcm.json) při startu a každých
5 minut. Instalátor tam uloží vydání hostitele RCM a fbagent ostatních hostitelů
si vydání pro svou platformu stáhne sám. Seznam vydání je dole na stránce
Propojit hostitele. Vydání lze také naimportovat ručně (krok 5 níže).
Ručně z příkazového řádku
Pořadí: kroky 1–3 na hostiteli RCM, krok 4 na každém dalším hostiteli, kroky 5–6 v RCM.
Krok 1. Nainstalujte HQbird s fbagent
Nainstalujte HQbird na každý databázový server a na hostitele RCM úplným instalátorem.
Na hostiteli RCM můžete rovnou uvést --rcm on (pak krok 3 není potřeba). Na ostatních
hostitelích parametry clusteru neuvádějte: ve výchozím stavu není RCM ani párovací
okno. Neregistrujte se v HQCenter Admin (--enroll).
Na hostiteli RCM instalátor nechá program RCM ve složce fbagent
(update/hqbirdrcm/staged/). Bez něj krok 3 selže chybou
no hqbirdrcm to install.
Krok 2. Nainstalujte vázanou licenci
Jako na začátku oddílu, „Licence“.
Krok 3. Vytvořte cluster na hostiteli RCM
Pokud instalátor cluster už vytvořil (--rcm on: ve výstupu řádek RCM: s adresou),
tento krok přeskočte.
Příkaz spusťte jako uživatel fbagent (v Linuxu — firebird), ne jako
root: jinak budou soubory CA a rcm.json patřit rootu.
Ve Windows (PowerShell jako správce):
.\fbagent.exe --cluster-init shop-prod --address 10.0.0.7
shop-prod — název clusteru: malá latinská písmena, číslice a -.
--address — adresa hostitele RCM, přes kterou se ostatní
hostitelé připojují. Lze ji zopakovat několikrát. Bez parametru se použijí adresy a název hostitele.
Příkaz:
vytvoří CA clusteru a CA agenta (ve složce fbagent, clusterca/<name>/);
zapíše certifikát RCM, rcm.json a cluster-init.json do složky RCM;
nainstaluje RCM a zaregistruje službu hqbirdrcm. V Linuxu služba běží jako
samostatný uživatel hqbirdrcm;
přepne fbagent na RCM (cluster.source = rcm) a restartuje ho;
vypíše adresu RCM a otisk CA:
Code
Cluster:    shop-prod
RCM URL:    https://10.0.0.7:7443
CA hash:    sha256:9f86d0...
Zapište si RCM URL a CA hash: jsou potřeba na ostatních hostitelích. Opakované spuštění
pro stejný cluster je bezpečné: CA a klíče zůstanou stejné.
Hned se přihlaste do RCM a změňte heslo rcmadmin (1.5).
V Linuxu. Uživatel hqbirdrcm je ve skupině fbagent. RCM čte
rcm.json přes tuto skupinu, ale nemůže ho zapisovat. Proto Nastavení → RCM změny neukládá (chyba
rcm_config_read_only). Upravte rcm.json na hostiteli jako uživatel fbagent
a restartujte RCM.
Krok 4. Připojte fbagent ostatních hostitelů
Na hostiteli RCM vytvořte token pro připojení pro každý fbagent: v RCM
Nastavení → Cluster, tlačítko Vytvořit token pro připojení. Nebo z
příkazového řádku:
Command
cd /opt/hqbirdrcm
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster join-token -note db2
Token platí 24 hodin, jen pro jeden fbagent a jen jednou. RCM
ho ukáže jednou, spolu s hotovým příkazem.
Na hostiteli uzlu spusťte tento příkaz jako uživatel fbagent:
Místo --token-file lze použít --token <token>. Ve Windows — totéž s
.\fbagent.exe v PowerShell jako správce.
fbagent ověří CA RCM podle otisku. Pokud se otisk neshoduje,
zastaví se a nic nezapíše. Potom fbagent dostane svůj certifikát
(90 dní, obnovuje se automaticky) a restartuje se. Připojený fbagent je vidět v
RCM v tabulce Agenti. Dokud nemá členy, na hostiteli se nic neinstaluje.
Krok 5. Naimportujte vydání do RCM
fbagent bere uzel a RCM jen z RCM. Není-li požadované vydání v
seznamu Vydání v zrcadle (Nastavení → Propojit hostitele), naimportujte každý produkt
(hqclusternode, hqbirdrcm) pro každou platformu vašich hostitelů
(linux-amd64, windows-amd64). Soubor vydání a podpis .sig dodává
dodavatel.
RCM hledá podpis v <file>.sig, nebo ho uveďte pomocí -sig. Bez
platného podpisu dodavatele RCM soubor nepřijme.
Nové vydání nahradí předchozí. Restart RCM není potřeba.
fbagent kontroluje nové verze každé 3 minuty. Pořadí aktualizace a
blokování jsou jako přes HQCenter Admin (1.2, „Aktualizace“).
Krok 6. Popište cluster
Nastavte členy a vazby v RCM, Nastavení → Cluster (kapitola 2.3). Po
uložení fbagent nainstaluje uzly stejně jako přes HQCenter Admin (1.2, krok 3): zapíše
certifikáty, node.json a rcm.json, nainstaluje a spustí služby.
Porty — na začátku oddílu.
1.4. Ruční instalace
Krok 1. Nainstalujte HQbird s fbagent
Nainstalujte HQbird na každý databázový server (stejným skriptem, ale bez --enroll, nebo úplným instalátorem HQbird). Ověřte, že fbagent běží.
Zapište si tři hodnoty z agent_config.json fbagent. Jsou potřeba pro node.json:
Pole fbagent
Pole node.json
Příklad
local_api.listen
firebird.fbagent_url
http://127.0.0.1:13050
local_api.token
firebird.fbagent_token
—
local_api.instance_id
firebird.instance_id
—
Kontrola fbagent (odpověď je JSON instance Firebird):
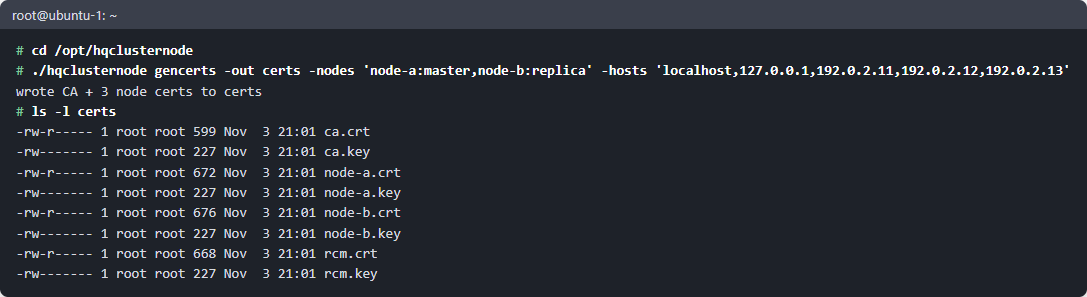
Příkaz vytvoří ca.crt a ca.key, node-a.crt/.key, node-b.crt/.key a rcm.crt/.key. V -hosts uveďte všechny názvy a adresy, přes které se k účastníkům bude přistupovat.
gencerts a soubory, které vytvořil
ca.key je klíč CA. Nekopírujte ho na hostitele; uložte ho zvlášť.
Nový uzel se později přidá pomocí -add: pár se podepíše stejnou CA a ostatní soubory zůstanou beze změny:
Certifikáty platí 90 dní. gencerts -out certs -list ukáže data konce platnosti a gencerts -out certs -renew je obnoví stejným klíčem. Nový .crt zkopírujte na jeho hostitele: uzel ho načte bez restartu.
Na každý hostitel zkopírujte ca.crt a jen jeho vlastní certifikát a klíč.
Krok 4. Napište node.json
Jeden soubor na uzel. Příklad pro hlavní uzel (node-a):
json
{"node_id":"node-a","role":"master","listen_addr":":7051","rcm":{"url":"https://<ip-rcm>:7443","ca_cert":"certs/ca.crt","client_cert":"certs/node-a.crt","client_key":"certs/node-a.key"},"firebird":{"root":"/opt/firebird","user":"SYSDBA","password":"<SYSDBA password>","port":3050,"replication_conf":"/opt/firebird/replication.conf","replication_log":"/opt/firebird/replication.log","firebird_log":"/opt/firebird/firebird.log","fbagent_url":"http://127.0.0.1:13050","fbagent_token":"<local_api.token>","instance_id":"<local_api.instance_id>","service_name":"<Firebird service name>"},"windows":{"restart_window":"22:00-05:00","transfer_window":"23:00-05:00"},"peers":[{"node_id":"node-b","url":"https://<ip-node-b>:7051","compress":"zstd"}]}
Uzel repliky (node-b) má stejný soubor, ale s "role": "replica", vlastními certifikáty a hlavním uzlem node-a v peers.
Hlavní pole:
Pole
Hodnota
node_id
název uzlu; stejný v certifikátu, v rcm.json a v peers ostatních uzlů
role
master nebo replica
listen_addr
adresa API uzlu; druhý uzel na stejném hostiteli používá jiný port (:7052)
rcm.url
adresa pro příjem statistik RCM; none — bez RCM
firebird.*
Firebird a fbagent této instance; hodnoty fbagent se musí shodovat přesně
firebird.auto_restart
zda uzel repliky smí sám restartovat Firebird: auto (výchozí), never, always
windows.restart_window
okno restartu Firebird; pro hlavní uzel je výchozí 22:00-05:00, pro repliku je vždy
windows.transfer_window
okno, ve kterém inicializace běží plnou rychlostí
peers
pro hlavní uzel — jeho repliky, pro repliku — její hlavní uzel
databases
složka databází; raději ji nepište ručně a nastavte ji přes RCM (kapitola 3)
Ostatní pole mají výchozí hodnoty. Uzel se nespustí, pokud pole fbagent nejsou nastavena.
Soubor chraňte: obsahuje heslo a token.
Command
chmod 600 /opt/hqclusternode/node.json
Ve Windows. Cesty pište ve formátu JSON: "C:\\HQbird\\replication.conf".
service_name je název služby Windows pro Firebird.
url — adresa uzlu, jak ji vidí hostitel RCM. Jen https.
host — popisek instance Firebird. Hlavní uzel a uzel repliky se stejným popiskem běží na stejném Firebird (společník, potřebný k povýšení repliky na hlavní uzel, kapitola 8). Jeden popisek — nejvýše jeden hlavní uzel a jedna replika.
Relativní cesty se řeší ze složky rcm.json.
Krok 6. Zaregistrujte služby
Pořadí startu: nejdřív RCM, potom repliky, potom hlavní uzel.
cd /opt/hqclusternode
sudo ./hqclusternode svc install -config /opt/hqclusternode/node.json -certs /opt/hqclusternode/certs
sudo ./hqclusternode svc start -config /opt/hqclusternode/node.json
systemctl status hqclusternode-master-p3050
svc install vytvoří službu hqclusternode-<role>-p<port> běžící jako uživatel firebird. Patří-li složka Firebird rootu, příkaz udělí skupině firebird právo zápisu (s sticky bitem) a vypíše každou změnu: uzel musí nahradit replication.conf.
U svc start, svc stop a svc uninstall uveďte stejný node.json: název služby se odvozuje z role a portu Firebird.
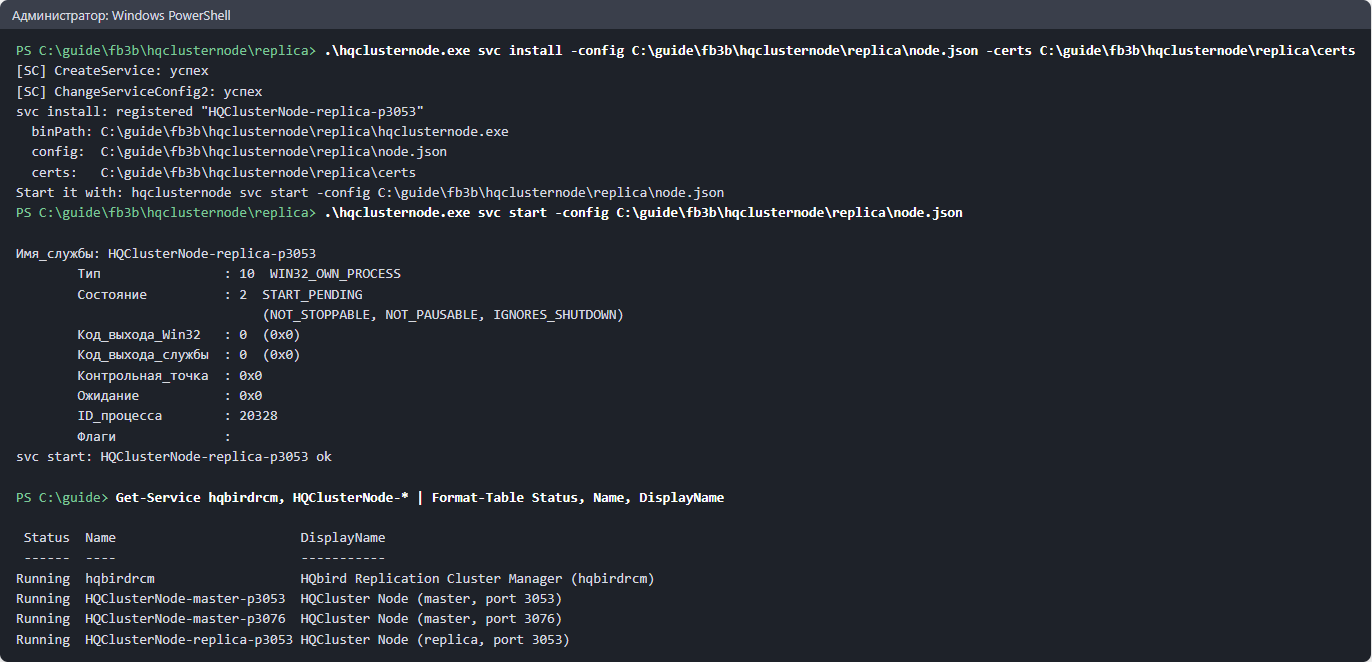
Ve Windows (PowerShell jako správce):
Command
cd C:\hqclusternode
.\hqclusternode.exe svc install -config C:\hqclusternode\node.json -certs C:\hqclusternode\certs
Služba HQClusterNode-<role>-p<port> běží jako LocalSystem, startuje automaticky a po selhání se restartuje. Služba uzlu na službě Firebird nezávisí. Byl-li uzel nainstalován ve verzi 2027.1.2–2027.1.9, závislost jednou odstraňte:
.\hqclusternode.exe svc fix-deps -config C:\hqclusternode\node.json.
svc install a svc start ve Windows
Krok 7. Otevřete porty
Na hostiteli uzlu povolte příchozí spojení na 7051 (port listen_addr) z ostatních uzlů a z RCM. Na hostiteli RCM povolte příchozí spojení na 7443 ze všech uzlů. Porty 7444 a 13050 ven nevystavujte.
Příklad ufw na hostiteli uzlu:
Command
sudo ufw allow from <ip-rcm> to any port 7051 proto tcp
sudo ufw allow from <ip-partner-node> to any port 7051 proto tcp
Adresa a heslo závisí na tom, jak bylo RCM nainstalováno.
Jak bylo RCM nainstalováno
Adresa
Přihlášení a heslo
Instalačním balíčkem HQbird nebo fbagent --cluster-init (1.3)
https://<hostitel RCM>:7444 z libovolného počítače
rcmadmin a heslo vypsané instalátorem (nebo vaše z --rcm-password-file)
Přes HQCenter Admin (1.2) nebo ručně (1.4)
http://127.0.0.1:7444, jen na hostiteli RCM
rcmadmin, heslo strong password (s mezerou)
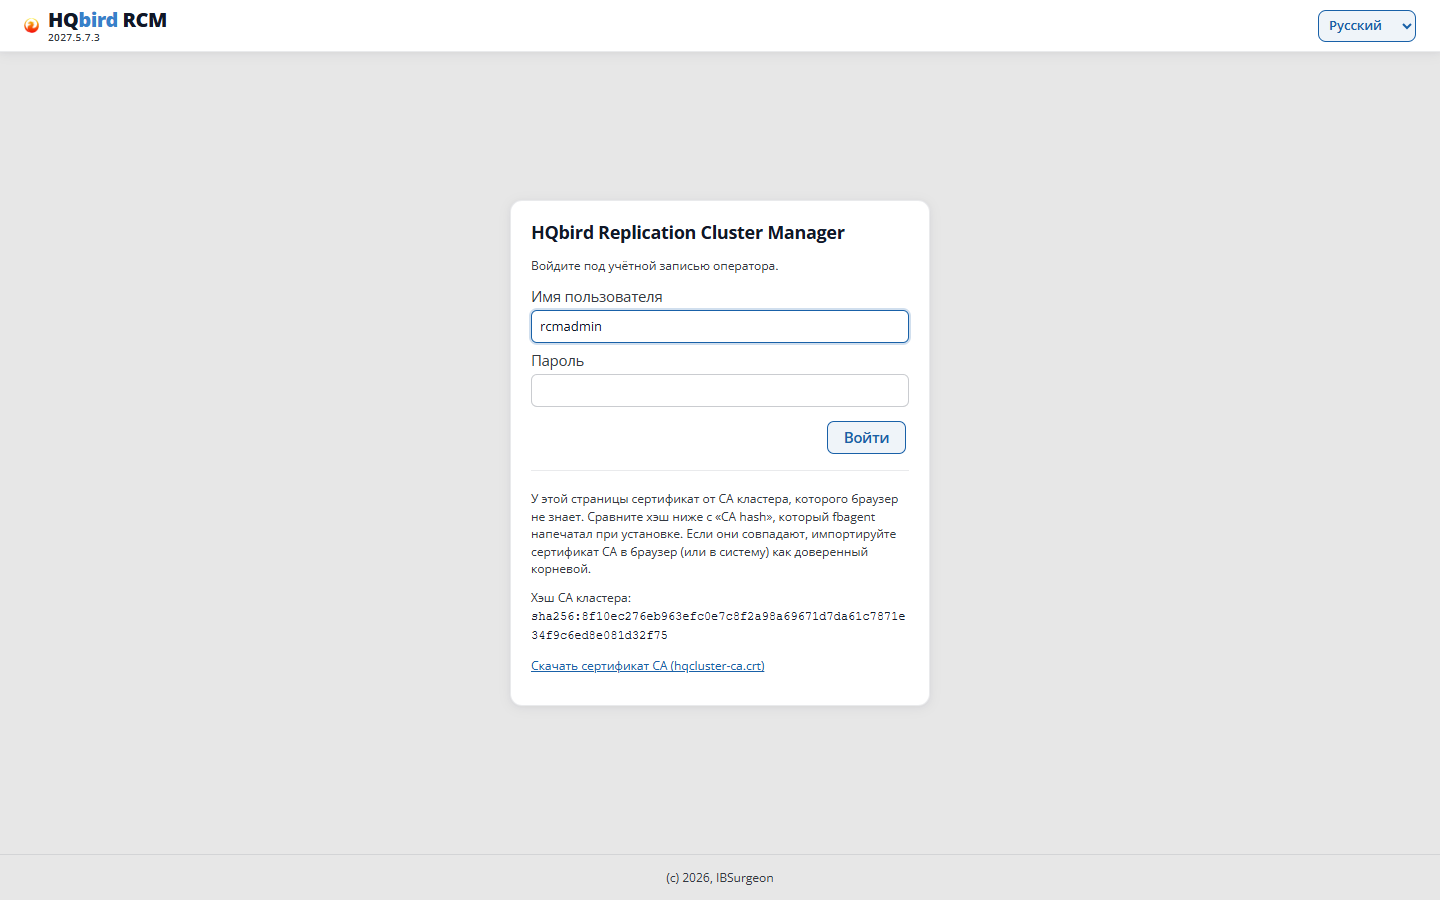
HTTPS (1.3). Certifikát RCM je podepsán CA clusteru, kterou prohlížeč nezná, proto varuje. Na přihlašovací stránce RCM ukazuje otisk CA. Porovnejte ho s CA hash vypsaným instalátorem a naimportujte CA do prohlížeče nebo do systému jako důvěryhodný kořen: odkaz Stáhnout certifikát CA na přihlašovací stránce (https://<hostitel RCM>:7444/ca.crt, soubor hqcluster-ca.crt). Aby RCM naslouchalo jen na localhost, nastavte v rcm.json"operator_addr": "127.0.0.1:7444" a restartujte RCM.
HTTP (1.2, 1.4). Z jiného počítače se připojte přes SSH tunel:
Command
ssh -L 7444:127.0.0.1:7444 <rcm-host>
Potom v prohlížeči otevřete http://127.0.0.1:7444.
Přihlašovací stránka RCM
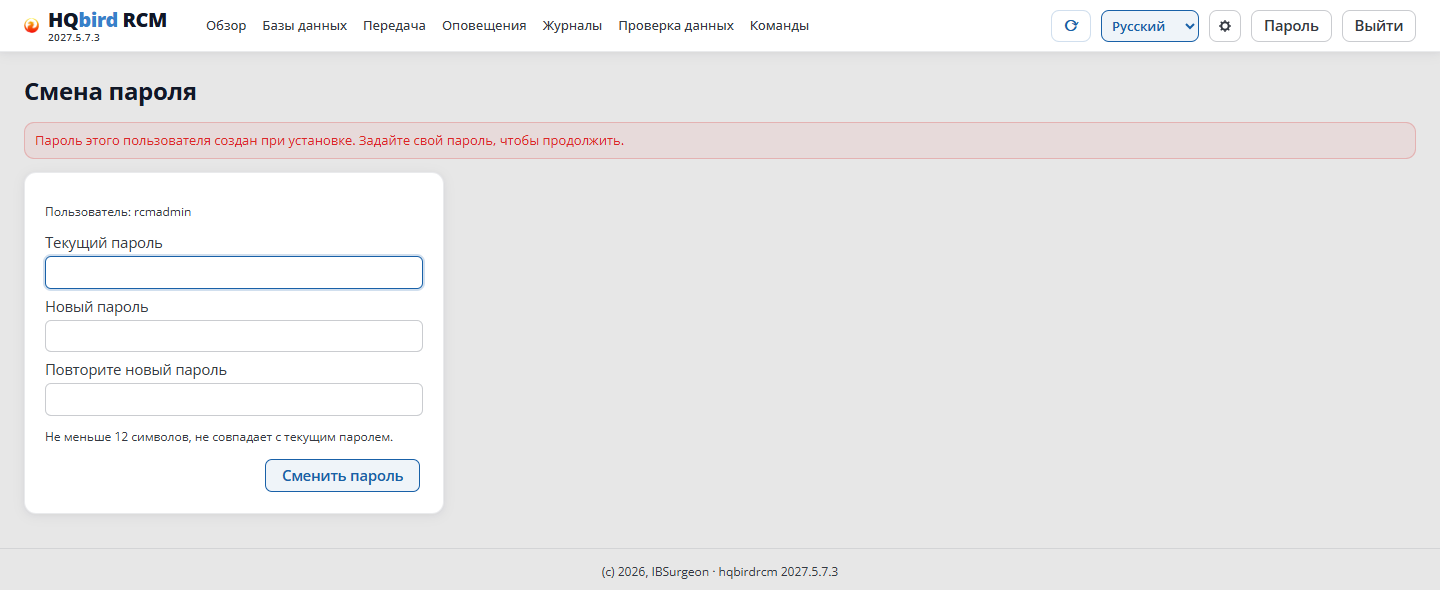
Vygenerované heslo. RCM vás při prvním přihlášení požádá o jeho změnu: dokud ho nezměníte, ostatní stránky se neotevřou. Změňte strong passwordhned (odkaz Heslo v záhlaví).
Změna hesla při prvním přihlášení
Jazyk. V seznamu jazyků v záhlaví stránky vyberte Ruštinu (je k dispozici i na přihlašovací stránce). Pokud žádný nevyberete, jazyk se vezme z prohlížeče.
Změna hesel a noví uživatelé
Každý uživatel mění své vlastní heslo: odkaz Heslo v záhlaví stránky. Potřebujete současné heslo a nové o délce alespoň 12 znaků. Po změně se ostatní relace tohoto uživatele zavřou.
Pokud heslo vygeneroval instalátor, je zapsáno do souboru clusterca/<name>/rcm-initial-password ve složce fbagent. Po změně hesla tento soubor fbagent sám smaže. Nemažte soubor initial-admin.json ve složce RCM: obsahuje jen hash. Ztratí-li se soubor uživatelů a tento soubor chybí, RCM vytvoří uživatele s výchozím heslem.
Noví uživatelé. V rozhraní stránka uživatelů není. Uživatelé jsou v souboru rcm-data/users.json. Heslo je uloženo jako hash HA1: MD5("<name>:hqbirdrcm:<password>").
Hned restartujte RCM: soubor čte jen při startu. Když se heslo změní v rozhraní, RCM soubor přepíše z paměti a úpravy, které ještě nepřečetlo, se ztratí.
Bez pole role má uživatel všechna oprávnění. Od HQbird 2027.2.31 existuje role "role": "viewer": jen prohlížení, každý požadavek na změnu dostane 403.
1.6. Jak ověřit instalaci
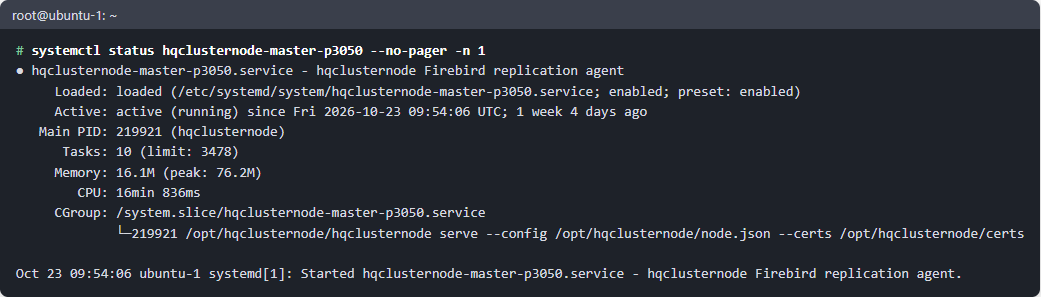
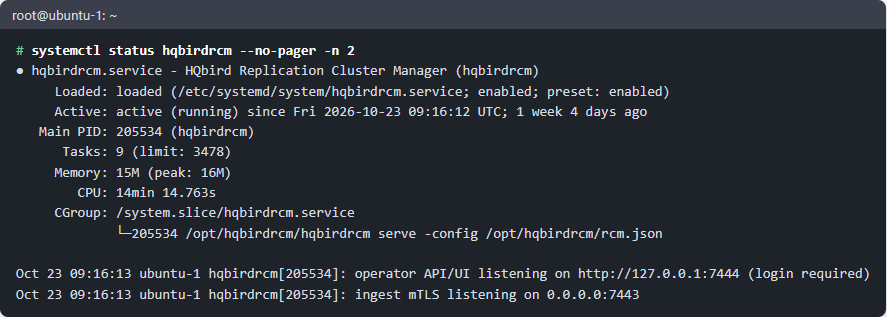
Služby uzlu a RCM běží a nerestartují se ve smyčce:
systemctl status hqclusternode-master-p3050, systemctl status hqbirdrcm.
systemctl status uzlu
systemctl status RCM
RCM odpovídá (bez hesla): curl http://127.0.0.1:7444/healthz. Při
instalaci přes RCM (1.3) konzole funguje přes HTTPS:
curl -k https://127.0.0.1:7444/healthz.
V RCM stránka Přehled ukazuje všechny uzly, bez značky „neodpovídá“.
Z příkazového řádku na hostiteli RCM:
Command
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm nodes
./hqbirdrcm status
Cluster přes RCM: Nastavení → Cluster, sekce Stav — každý
člen použil nejnovější revizi a nehlásí chybu. Z příkazového
řádku: ./hqbirdrcm cluster status.
1.7. Protokoly
Co
Kde
Protokol uzlu
<složka node.json>/logs/node-YYYYMMDD.jsonl
Výstup služby uzlu (Linux)
journalctl -u hqclusternode-<role>-p<port>
Výstup služby RCM (Linux)
journalctl -u hqbirdrcm
Replikační protokol Firebird
firebird.replication_log z node.json
Protokoly libovolného uzlu bez SSH
RCM, stránka Protokoly
1.8. Časté chyby
Co vidíte
Příčina
Co dělat
Uzel se nespustí: chyba o fbagent_url, fbagent_token nebo instance_id
fbagent neběží nebo hodnoty neodpovídají agent_config.json
zkontrolujte fbagent příkazem curl z 1.4, krok 1
Instalační skript skončil kódem 2
žádost fbagent nebyla včas schválena
schvalte žádost a spusťte skript znovu
Uzly se přes HQCenter Admin neobjeví
fbagent není v clusteru, nebo cluster ještě nebyl získán
zkontrolujte cluster (kapitola 2), počkejte až 10 minut
Uzel v RCM je „neodpovídá“
port 7051 je zavřený, url v rcm.json je nesprávné, adresa není v certifikátu
zkontrolujte porty a -hosts certifikátů
Nelze se přihlásit do RCM: „Příliš mnoho neúspěšných pokusů o přihlášení“
token už byl použit, je starší než 24 hodin, nebo byl odvolán
vytvořte nový token (1.3, „Ručně“, krok 4)
--cluster-join: hostname_conflict
cluster má fbagent se stejným názvem hostitele a jinými adresami
dejte hostitelům různé názvy
--cluster-join: this agent is in cluster … from goafts
fbagent už je v clusteru HQCenter Admin
odeberte ho z clusteru HQCenter Admin
Uzel se přes RCM nenainstaluje
RCM nemá vydání pro tuto platformu
hqbirdrcm release list, naimportujte vydání (1.3, „Ručně“, krok 5)
2. Konfigurace clusteru
V této kapitole určíte, které uzly jsou v clusteru a který hlavní uzel posílá
segmenty které replice. Potom nastavíte uzly RCM a uživatele.
Vztahy se definují jedním ze tří způsobů:
Uzly nainstalovány
Kde se vztahy definují
Oddíl
přes HQCenter Admin
v HQCenter Admin: stránka Clustery HQ Monitor nebo API HQCenter Admin
2.2
přes RCM, bez HQCenter Admin
v RCM: Nastavení → Cluster, hqbirdrcm cluster nebo stránka Clustery HQ Monitor
2.3
ručně
v RCM: Nastavení → RCM a Nastavení → Uzly
2.3
U uzlů nainstalovaných přes HQCenter Admin nebo přes RCM měňte vztahy jen v
popisu clusteru. fbagent přepisuje node.json a rcm.json podle
popisu clusteru. Úprava vztahů v Nastavení → RCM nebo Nastavení → Uzly
RCM se odmítne (409 cluster_managed). Starší verze RCM to přijímaly, ale změna
se ztratila.
2.1. Role a schémata
Každý uzel má jednu roli: hlavní uzel nebo replika. Dva uzly — hlavní a replika — mohou běžet na jedné instanci Firebird.
Podporovaná schémata:
Code
1 → 1        node-a (master) ──▶ node-b (replica)

1 → N        node-a ──▶ node-b
                    └─▶ node-c

N → 1        node-a ──┐
                      ├─▶ node-b    (one replica for several masters)
             node-x ──┘

Both nodes   host-1: node-1m (master) + node-1r (replica)  ← one Firebird
on a host    host-2: node-2m (master) + node-2r (replica)  ← one Firebird
             node-1m ──▶ node-2r,  node-2m ──▶ node-1r
Vazba jde vždy z hlavního uzlu na repliku. RCM spojuje databázi hlavního uzlu s její replikou podle GUID databáze, ne podle názvu uzlu.
Společník. Hlavní uzel a uzel repliky na stejné instanci Firebird jsou společníci. Povýšení repliky na hlavní uzel (kapitola 8) funguje jen pro takový pár. V rcm.json je pár označen shodnou hodnotou host.
2.2. Vazby přes HQCenter Admin
Kde cluster popsat
HQ Monitor, stránka Clustery (jen správci; doručování konfigurace musí být zapnuté). Obvyklý způsob.
API HQCenter Admin:POST /v1/admin/clusters a
PUT /v1/admin/clusters/{id}. Panel HQCenter Admin stránku
clusterů nemá.
``
Kroky na stránce Clustery
Zadejte Nové id clusteru (malá latinská písmena, číslice a -) a klikněte na
Vytvořit.
Přidejte členy (Členové). U každého uveďte:
fbagent hostitele;
roli: master, replica nebo rcm;
adresy hostitele;
port: pro uzel — 7051 (druhý uzel na stejném hostiteli — např. 7052),
pro RCM — port příjmu statistik 7443.
Přidejte vazby (Replikační vazby) z hlavního uzlu na repliku.
Klikněte na Ověřit a potom na Uložit.
Pokud cluster ve stejnou chvíli změnil jiný správce, stránka vás požádá,
abyste cluster znovu načetli a změnu opakovali.
Pravidla
fbagent může patřit jen do jednoho clusteru.
Na jednom fbagent — nejvýše jeden hlavní uzel, jedna replika, jedno RCM a
jeden směrovač. Směrovač (role router, od HQbird 2027.2.30) nemá vazby a
nezabírá licenční místo (kapitola 8.7).
Cluster má právě jedno RCM. fbagent na hostiteli RCM provozuje certifikační
autoritu clusteru (CA).
Název člena (member_id) — latinská písmena, číslice, -. Název, fbagent a role
člena nelze změnit. Chcete-li člena přesunout na jiného hostitele, vytvořte
nového člena s novým názvem. Starý název znovu nepoužívejte.
HQbird 2.5/3.0: nastavte datum replconf_valid_till clusteru
(YYYY-MM-DD) — konfigurace pluginu replconf platí do tohoto data.
Příklad přes API
json
{"contract":1,"cluster_id":"shop-prod","name":"Shop","pki":"managed","cert_validity_days":90,"renew_before_days":30,"members":[{"member_id":"db1-m","agent_id":"<fbagent of host 1>","role":"master","addresses":["db1.lan"],"listen_port":7051},{"member_id":"db1-rcm","agent_id":"<fbagent of host 1>","role":"rcm","addresses":["db1.lan"],"listen_port":7443},{"member_id":"db2-r","agent_id":"<fbagent of host 2>","role":"replica","addresses":["db2.lan"],"listen_port":7052}],"links":[{"from":"db1-m","to":"db2-r"}]}
Vytvoření: POST /v1/admin/clusters (dokument lze poslat spolu se
členy). Nahrazení celého dokumentu: PUT /v1/admin/clusters/{id}.
PUT vyžaduje hlavičku If-Match: <revision> (revizi dává GET a ETag).
Bez hlavičky — 428, se starou revizí — 409, s chybou v dokumentu —
422 se seznamem chyb.
POST /v1/admin/clusters/{id}/validate dokument ověří bez uložení.
GET /v1/admin/clusters/{id}/status ukáže stav členů a data
konce platnosti certifikátů.
Co se stane po uložení
fbagent každého člena dostane cluster. Uvnitř clusteru — kontrola každých
60 sekund (fbagent na hostiteli RCM — každých 30 sekund). Mimo cluster se fbagent
o clusteru dozví při dalším dotazu na konfiguraci. Pokud tento dotaz
server nedosáhne, kontrola běží každých 10 minut.
Každý fbagent vytvoří klíč a pošle žádost o certifikát. fbagent na
hostiteli RCM ji podepíše. RCM podepíše vlastní certifikát bez žádosti.
fbagent zapíše do node.json: název, roli, adresu, peers (z vazeb),
adresu RCM, cesty k certifikátům, data Firebird a fbagent. Do rcm.json: seznam
uzlů (nodes), seznam směrovačů (routers), adresu příjmu statistik a
cesty k certifikátům. Ostatních polí souborů se fbagent nedotýká.
zastaví a odebere službu; cluster-managed.json → cluster-removed.json, program → *.removed; konfigurace, certifikáty a data zůstanou
Po odebrání uzlu jeho sekce
# BEGIN managed-by:<name> … # END … zůstane ve sdíleném replication.conf. Smažte ji ručně a restartujte
Firebird přes RCM.
Schvalování certifikátů clusteru
Ve výchozím stavu fbagent na hostiteli RCM žádosti podepisuje sám (auto). Ruční schvalování
lze zapnout. Příkazy na hostiteli RCM:
Command
fbagent --cluster-ca-approval manual # or autofbagent --cluster-status # this fbagent's membership in the cluster (JSON)fbagent --cluster-ca-approve <request_id>
V režimu manual nový člen nebo nový klíč čeká na schválení. Obnova
certifikátu se známým klíčem se podepíše automaticky.
2.3. Vazby přes RCM
Cluster RCM (bez HQCenter Admin)
Pokud cluster vytvořil instalátor HQbird nebo příkaz fbagent --cluster-init
(kapitola 1.3), popis clusteru uchovává RCM. Nejsnazší způsob, jak přidat hostitele, je stránka
Nastavení → Propojit hostitele (kapitola 1.3, „Propojení hostitelů v RCM“):
RCM členy a vazby vytvoří samo. Pravidla jsou stejná jako v HQCenter Admin (2.2, „Pravidla“), a navíc:
v RCM je jeden cluster; člen rcm vždy existuje a nelze ho smazat;
nejvýše 3 místa (hostitelé s hlavním uzlem nebo uzlem repliky), jinak nastane chyba
seats_exceeded;
člena lze přidat jen na fbagent, který se připojil k RCM
(kapitola 1.3: „Propojit hostitele“ nebo „Ručně“, krok 4).
Kroky na stránce Nastavení → Cluster:
V tabulce Agenti klikněte na Přidat člena v řádku fbagent.
Uveďte roli (master, replica nebo router), member_id, adresy a port.
Stránka navrhne název <host>-<role> a port: 7051 pro první uzel fbagent,
7061 pro druhý. Port, který už zabírá jiný člen hostitele, RCM odmítne.
Adresy fbagent jsou tlačítka: kliknutím adresu přidáte.
V sekci Vazby klikněte na Přidat vazbu z hlavního uzlu na repliku.
Klikněte na Ověřit: RCM ukáže chyby a varování.
Klikněte na Uložit. Stránka ukáže seznam změn a požádá o
potvrzení. Mažou-li se členové, okno je červené.
Před uložením existují změny jen na stránce (štítek „Neuloženo“). Pokud
někdo cluster ve stejnou chvíli uložil, stránka nabídne jeho opětovné načtení.
Změnila-li se jen pole RCM (revize, CA, pověření), stránka vaši
změnu uloží sama.
Další sekce stránky:
Sekce
Co tam je
záhlaví
název clusteru, revize, CA clusteru a CA agenta; tlačítko Exportovat pro starou CA
Tokeny připojení
vytvořit token pro nový fbagent, odvolat nepoužitý
Dokument JSON
celý dokument v textovém poli; Ověřit a Uložit ho používají
Klíče a CA
pověření: nový klíč člena (rekey), nová CA clusteru (rotate_ca), nová CA agenta (rotate_agent_ca); nedostupné, jsou-li neuložené změny
Stav
revize, kterou každý člen použil, konec platnosti certifikátu, služba, poslední chyba
Z příkazového řádku na hostiteli RCM:
Command
exportRCM_USER=rcmadmin RCM_PASSWORD='<password>'./hqbirdrcm cluster show > c.json # document with revision# edit c.json./hqbirdrcm cluster validate -f c.json # validate without saving anything./hqbirdrcm cluster apply -f c.json # save (If-Match = revision from the file)./hqbirdrcm cluster agents # connected fbagents and their members./hqbirdrcm cluster status # what the fbagents reported
Formát dokumentu je jako v 2.2, „Příklad přes API“. apply se starou revizí
dostane 409: spusťte znovu show. RCM uchovává posledních 20 revizí v
rcm-data/cluster/history/.
HQ Monitor. Stránka Clustery funguje i s RCM. Na hostiteli RCM
přistupuje HQ Monitor k RCM přes fbagent tohoto hostitele, s certifikátem
fbagent: uživatel a heslo RCM nejsou potřeba. V auditním protokolu RCM se takové
akce zapisují jako agent:<id> (<user>). Jiný způsob, pro starší
verze RCM: v konfiguraci HQ Monitor nastavte rcm_admin_url
(http://127.0.0.1:7444), rcm_admin_user (uživatel RCM) a
rcm_admin_password_file (soubor s jeho heslem).
Po uložení vše probíhá jako přes HQCenter Admin (2.2, „Co se stane po
uložení“). RCM si nodes v rcm.json přečte samo, bez restartu.
Odebrat fbagent z clusteru: smažte jeho členy a uložte, potom
klikněte na Odvolat v tabulce Agenti (nebo
./hqbirdrcm cluster revoke -agent <id>). K návratu je potřeba nový
token. Po odvolání fbagent (od verze 3.1.0) cluster opustí
sám: zastaví své uzly a smaže data clusteru. Totéž na
hostiteli uzlu udělá příkaz fbagent --cluster-leave. Na hostiteli RCM se odmítne.
Ruční instalace: přidat uzel do RCM
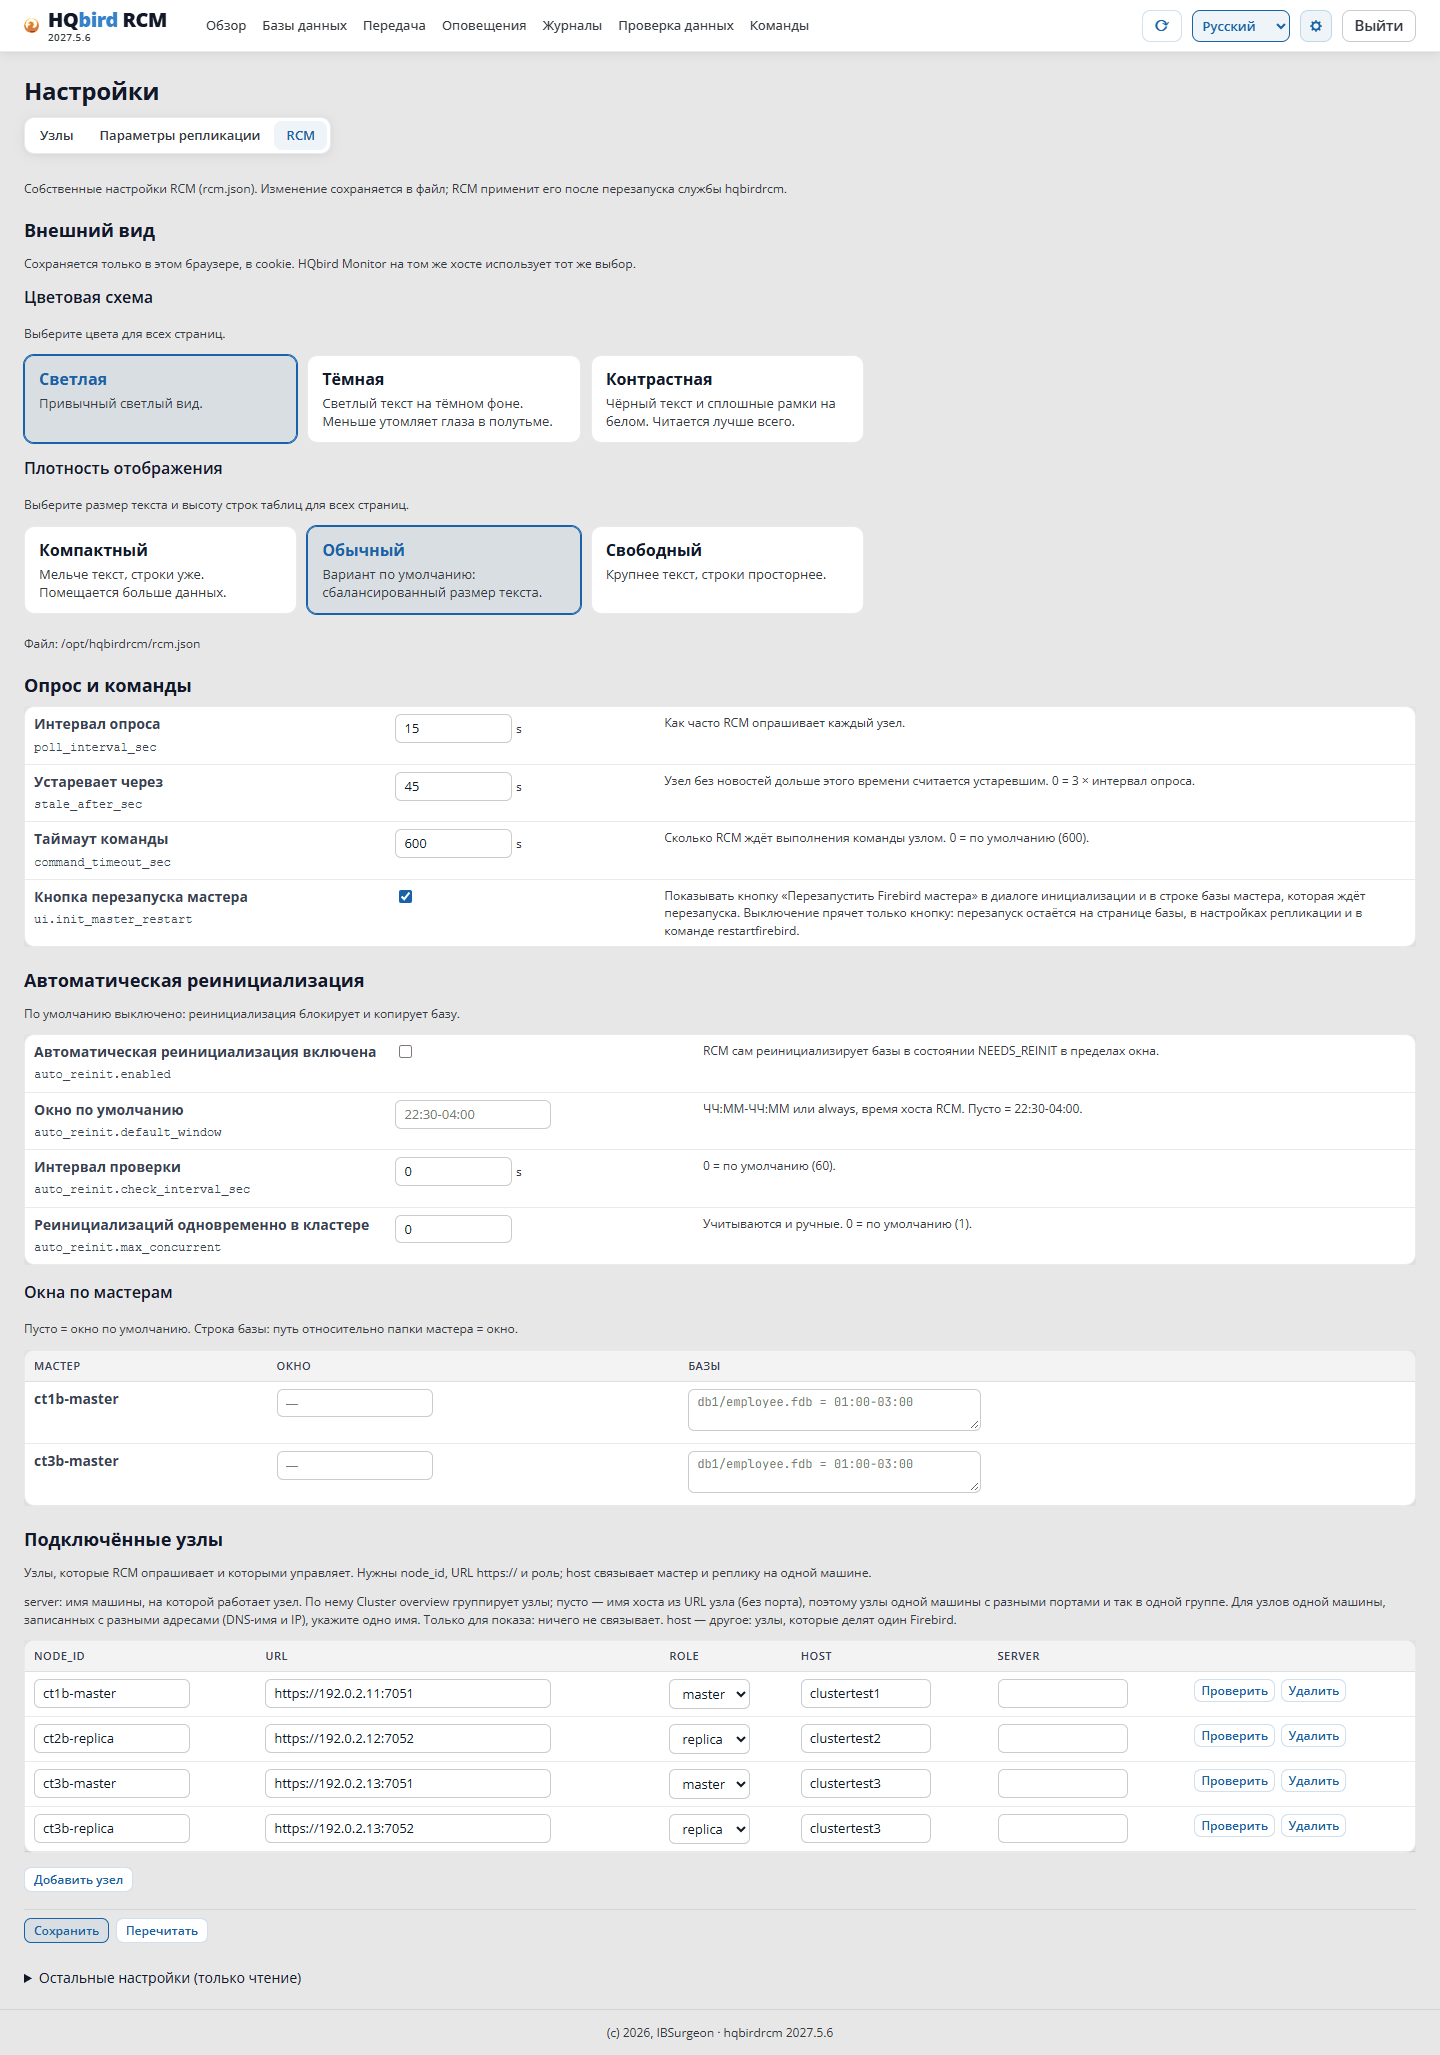
Nastavení → RCM, tabulka Připojené uzly.
Klikněte na Přidat uzel. Vyplňte node_id, url
(https://<adresa>:7051), roli, host (popisek instance Firebird),
server (jen pro seskupení na obrazovce).
Klikněte na Ověřit v řádku uzlu: RCM zkontroluje spojení a oprávnění.
Klikněte na Uložit. RCM zapíše rcm.json a starý soubor uloží jako
rcm.json.<čas UTC>.bak (posledních 20).
Restartujte RCM. Do restartu platí stará konfigurace;
stránka ukazuje, která pole čekají na restart.
Nastavení → RCM
Command
sudo systemctl restart hqbirdrcm
Lze to i bez rozhraní: upravte rcm.json a restartujte RCM.
Ruční instalace: propojit hlavní uzel a repliku
Vazbu je třeba zapsat na obou stranách:
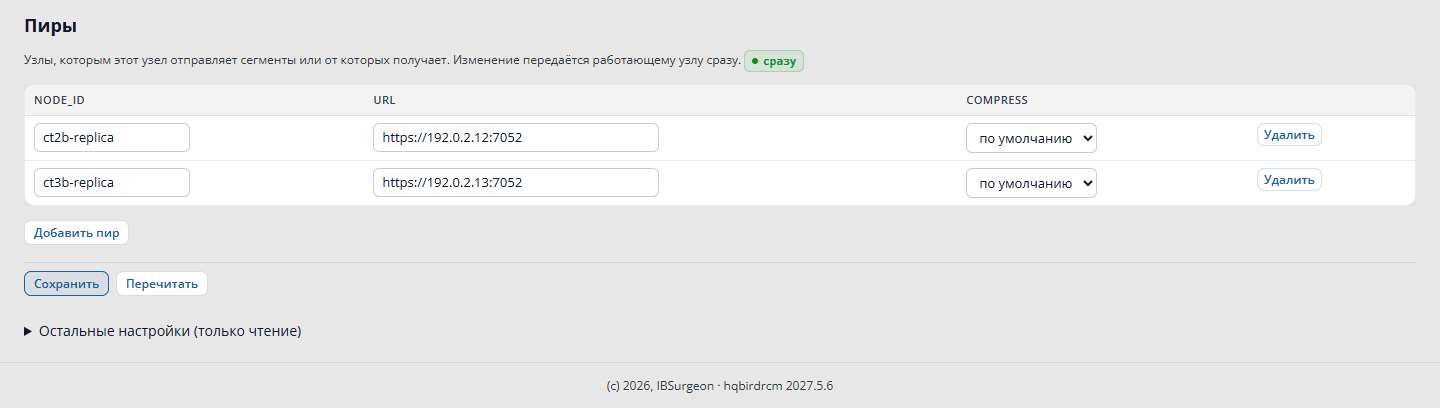
Nastavení → Uzly, vyberte hlavní uzel.
V sekci Partneři klikněte na Přidat partnera: node_id repliky, její url,
komprese (zstd).
Klikněte na Uložit. RCM ukáže seznam změn a požádá o
potvrzení. Změna peers platí hned.
Opakujte pro uzel repliky: jeho partner je hlavní uzel.
Sekce Partneři hlavního uzlu
Není-li partner zapsán na jedné ze stran, RCM tento uzel repliky při
inicializaci databáze nenabídne.
2.4. Nastavení uzlu
Nastavení → Uzly ukazuje nastavení node.json, která uzel dovoluje měnit z RCM. Uloží se jen změněná pole, po okně se seznamem změn.
Nastavení → Uzly: výběr uzluNastavení databází uzlu se značkami "po prohledání"
Každý řádek je označen tím, kdy změna začne platit:
Kdy
Která nastavení
Ihned
channel_a_mbps, channel_a_burst_mbps, windows.restart_window, peers; od HQbird 2027.2.24 — nastavení kontroly dat (limits.data_check_*); od HQbird 2027.2.31 — advertise_addr
Po restartu uzlu
ostatní limity, windows.transfer_window; stránka je ukazuje na samostatném řádku, dokud se uzel nerestartuje
Po prohledání
databases.*, exclude_filter; změnil-li se replication.conf, je nutný restart Firebird (kapitola 3.5)
Jen ke čtení (mění se v node.json na hostiteli uzlu): firebird (včetně hesla a auto_restart), rcm, tls, segments, adresa listen_addr.
Hlavní nastavení:
Nastavení
Výchozí
Význam
windows.restart_window
hlavní uzel 22:00-05:00, replika — vždy
kdy uzel smí restartovat Firebird; Firebird hlavního uzlu se sám nikdy nerestartuje
windows.transfer_window
23:00-05:00
okno, ve kterém inicializace běží rychlostí reinit_window_mbps
limits.channel_a_mbps
50
rychlost přenosu segmentů, MB/s (channel_a_burst_mbps — krátkodobý vrchol, 200)
limits.reinit_window_mbps
100
rychlost inicializace v okně přenosu, MB/s
limits.reinit_day_disk_fraction
0,5
podíl změřené rychlosti disku pro inicializaci mimo okno
limits.retention_days
2
kolik dní uchovávat odeslané segmenty v archivu hlavního uzlu
limits.free_space_floor_gb
1
minimální volné místo, GB; pod ním replika segmenty nepřijímá
limits.max_concurrent_reinits
1
kolik inicializací uzel spouští současně
Podrobnosti o rychlosti a uchování archivu jsou v kapitolách 5 a 7.
firebird.auto_restart (jen v node.json) určuje, zda uzel repliky smí sám restartovat Firebird:
Hodnota
Chování
auto (výchozí)
smí, pokud tento Firebird neobsluhuje databáze hlavního uzlu
never
nikdy
always
vždy, i když tento Firebird hostí databáze hlavního uzlu
Přes HQCenter Admin.windows.transfer_window uzlu fbagent se používá také jako okno pro restart samotné služby uzlu, když se cluster změní. Není-li okno v node.json nastaveno, fbagent službu restartuje hned.
2.5. Několik instancí HQbird na jednom hostiteli
fbagent restartuje služby uvedené v firebird.update.services své
konfigurace. Prázdný seznam znamená všechny služby HQbird na hostiteli. V seznamu nechte jen
službu vlastní instance. Uzel toto nastavení nevidí a do protokolu zapíše
varování fbagent_shared, pokud fbagent zná více než jednu instanci.
2.6. Heslo SYSDBA
Uzel se k Firebird připojuje uživatelem a heslem z firebird.user a
firebird.password v node.json. fbagent si uchovává vlastní kopii hesla. Pokud jste
změnili heslo SYSDBA:
Opravte firebird.password v node.jsonkaždého uzlu této
instance (hlavní uzel i replika).
Opravte heslo v konfiguraci fbagent a znovu ji načtěte (viz
dokumentace fbagent).
Restartujte služby uzlů.
Jinak stránky publikace a ověření v RCM ukážou chybu přihlášení
(SQLSTATE 28000).
2.7. Uživatelé RCM a audit
Uživatelé jsou v souboru rcm-data/users.json (kapitola 1.5). Bez role má
uživatel všechna práva; role viewer (od HQbird 2027.2.31) — jen prohlížení.
Relace trvá 12 hodin od poslední akce.
Po 10 neúspěšných přihlášeních během 5 minut se přihlášení tohoto uživatele a adresy
dočasně zablokuje. Úspěšné přihlášení čítač vynuluje.
Auditní protokol je soubor rcm-data/audit.jsonl: jeden řádek JSON pro každou
změnu, přihlášení a odhlášení. V rozhraní auditní protokol není.
Stránka Příkazy ukazuje autora každého příkazu.
2.8. Licence
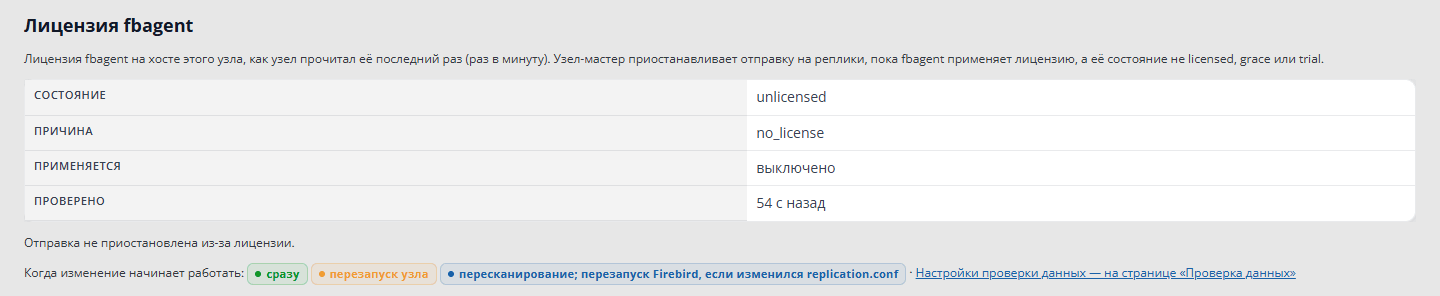
Jednou za minutu hlavní uzel čte licenci fbagent svého hostitele. Není-li licence (zkušební doba skončila, licence vypršela nebo je neplatná), uzel přestane odesílat segmenty všech databází hlavního uzlu. Firebird a databáze běží dál, ale repliky přestanou dostávat změny.
Co vidíte v RCM:
hlavní uzel je červený (NEEDS_ATTENTION), se štítkem „bez licence: odesílání zastaveno“;
tlačítko Obnovit není: pozastavení zruší jen licence;
na replice: „nepřijímá od …: hlavní uzel nemá licenci“;
v tabulce Uzly štítek „bez licence“; v Nastavení → Uzly blok licence fbagent;
výstrahy license_paused a license_pause_archive_released;
inicializace je zakázána (license_paused).
Blok licence fbagent v Nastavení → Uzly
Nainstalujte licenci do fbagent. Uzel pozastavení sám zruší do minuty. Hlavní uzel uchovává archiv pro repliky po dobu limits.retention_days (výchozí 2 dny) od začátku pozastavení. Nainstalujete-li licenci později, repliky bude třeba znovu inicializovat.
Cluster přes RCM, bez HQCenter Admin. Plovoucí licence bez HQCenter Admin přestane fungovat po online_check_days plus dnech odkladu. Každý fbagent v clusteru potřebuje vázanou licenci (fbagent --license-request, potom fbagent --license-install, kapitola 1.3, „Licence“). Po zkušební době fbagent nepřidá nový uzel ani RCM bez funkce cluster v licenci; aktualizace nikdy nezakazuje. U HQbird 2.5/3.0 datum replconf_valid_till v RCM nemůže být pozdější než konec licence plus dny odkladu na uzlech fbagent (chyba replconf_after_license).
2.9. Jak zkontrolovat
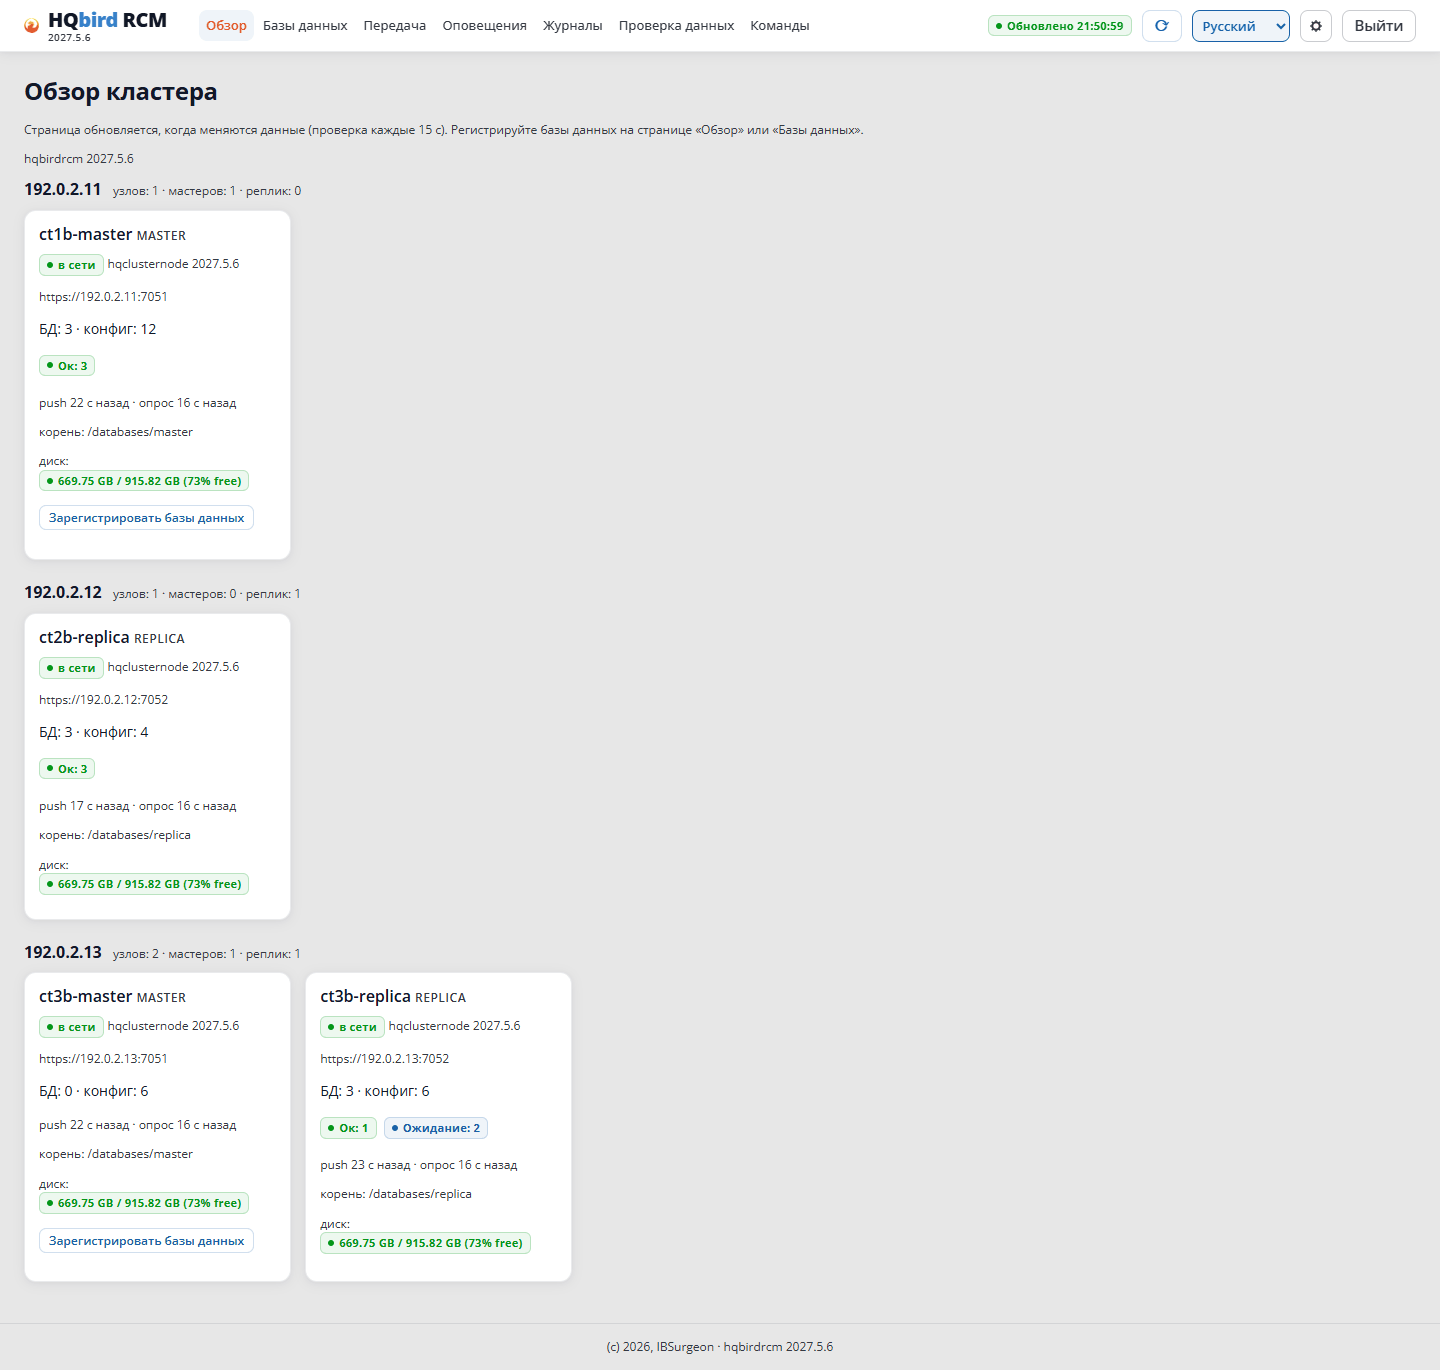
Přehled: všechny uzly jsou přítomny a seskupeny podle serveru.
Přehled clusteru
Nastavení → Uzly: hlavní uzel má repliku v Partnerech a replika má hlavní uzel.
Nastavení → RCM: tlačítko Zkontrolovat v řádku každého uzlu projde.
Hlášení clusteru jako jeden soubor:
Command
./hqbirdrcm report -o report.json
2.10 Časté chyby
Co vidíte
Příčina
Co dělat
Úprava partnerů v RCM odmítnuta (409 cluster_managed) nebo ztracena po restartu uzlu
uzel byl nainstalován přes HQCenter Admin nebo přes RCM
změňte vazby v popisu clusteru (2.2, 2.3)
seats_exceeded při ukládání clusteru v RCM
uzly na čtvrtém hostiteli
nejvýše 3 hostitelé s uzly
Nastavení → RCM: rcm_config_read_only
cluster přes RCM v Linuxu: rcm.json patří fbagent
upravte rcm.json jako uživatel fbagent a restartujte RCM
Odvolat agenta nefunguje (agent_has_members)
fbagent má členy
nejdřív smažte členy a uložte
Uzel repliky se při inicializaci nenabízí
partner není zapsán na jedné ze stran
přidejte partnera na obou stranách (2.3)
Změna v Nastavení → RCM nezačne platit
RCM nebylo restartováno
restartujte RCM
422 při ukládání clusteru v HQCenter Admin
chyba v dokumentu
opravte ji podle seznamu errors, zkontrolujte přes validate
409 při ukládání clusteru
cluster změnil někdo jiný
znovu načtěte cluster a zkuste to znovu
Nový člen clusteru HQCenter Admin nedostane certifikát
ruční schvalování na hostiteli RCM
fbagent --cluster-ca-approve <id>
Chyba SQLSTATE 28000 na stránkách publikace
heslo SYSDBA bylo změněno
2.6
3. Přidání databáze na hlavní uzel
V této kapitole se databáze hlavního uzlu dostane pod správu uzlu. Uzel ji zapíše do
replication.conf a vytvoří složky pro segmenty. Po restartu Firebird
je databáze připravena k replikaci.
Vytvoření repliky jsou další kroky (publikace, inicializace). Jsou popsány v
kapitolách 4–6.
Názvy tlačítek jsou podle ruského rozhraní RCM, s anglickými v závorkách.
3.1. Jak uzel databáze nachází
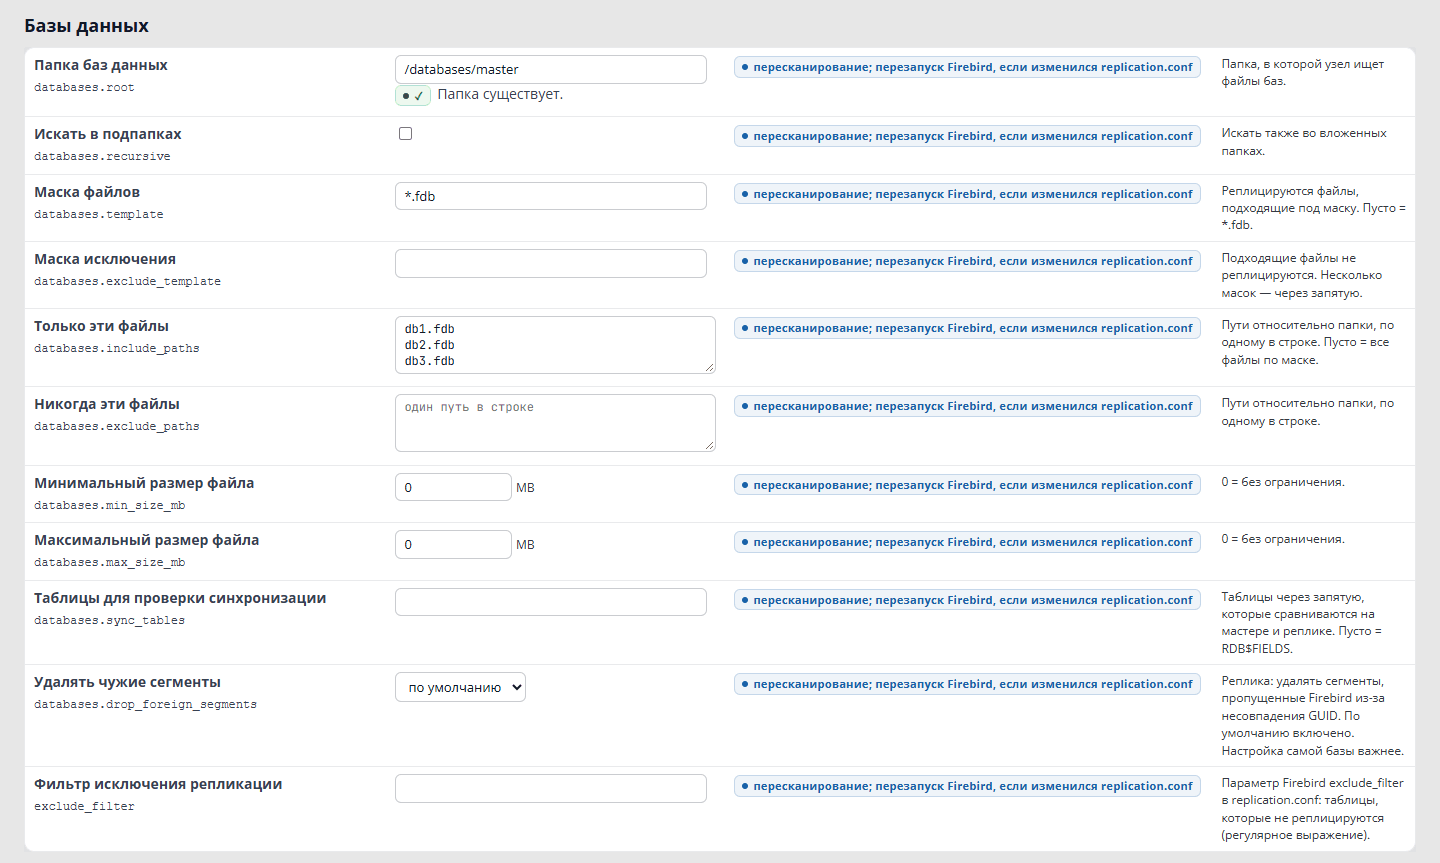
Hlavní uzel hledá databáze v jedné složce — kořeni databází (databases.root). Co se dostane pod správu, rozhodují pravidla:
Pravidlo
Pole
Výchozí
Složka databází
root
nenastaveno
Prohledávat podsložky
recursive
ano
Maska zahrnutí
template
*.fdb
Maska vyloučení
exclude_mask
žádná
Velikost souboru, MB
min_size_mb, max_size_mb
bez limitů (0)
Tabulky pro porovnání dat
sync_tables
s HQbird 2027.2.24 — tabulky z publikace databáze, nejsou-li — RDB$FIELDS; v 2027.5.7 — RDB$FIELDS
Seznam zahrnutí
include_paths
prázdný (režim masky)
Seznam vyloučení
exclude_paths
prázdný
Cesta root je cesta na hostiteli uzlu, ne na hostiteli RCM. Uzel nejdřív použije masku zahrnutí, potom masku vyloučení, potom velikost.
Pravidla jsou stejná pro celý uzel. Seznam sync_tables je také sdílený: kontrola (kapitola 5.10) hledá každou tabulku ze seznamu v každé databázi uzlu, která nemá vlastní seznam.
Tabulky pro porovnání, s HQbird 2027.2.24. Každá databáze může mít vlastní seznam (Tabulky sledování synchronizace). Uzel ho ukládá do databases.sync_tables_by_db. Kontrola vezme první nastavený seznam:
vlastní seznam databáze;
sdílený seznam sync_tables uzlu;
tabulky z publikace databáze;
RDB$FIELDS.
Sdílený seznam uložený dříve má přednost před publikací: databáze bez vlastního seznamu ho použije. Stránka databáze hlavního uzlu ukazuje, který seznam právě platí (3.3).
Tabulka, která chybí v primární databázi i v replice, dostane stav „není v databázi“ (absent): neporovnává se a kontrola kvůli ní neukáže „Není v pořádku“. Tabulka, která chybí jen na jedné straně, je nesoulad.
RCM a uzel 2027.5.7. Je jeden seznam pro celý uzel (sync_tables); bez seznamu kontrola používá RDB$FIELDS. Chybějící tabulka je chyba a kontrola databáze ukáže „Není v pořádku“.
Všechna pravidla jsou v node.json uzlu. Uzel je použije při každém prohledání.
Režim masky a režim seznamu:
Režim masky (seznam zahrnutí je prázdný): uzel vezme všechny soubory odpovídající masce, kromě vyloučených. Nový soubor ve složce uzel automaticky vezme při dalším prohledání.
Režim seznamu (seznam zahrnutí není prázdný): uzel vezme jen soubory ze seznamu. Nový soubor se pod správu nedostane automaticky — je třeba ho přidat.
Režim seznamu zvolte, pokud složka obsahuje kopie databází, testovací databáze nebo jiné soubory, které se nemají replikovat.
3.2. Než začnete: zkontrolujte oprávnění
Uživatel, pod kterým běží Firebird a uzel (firebird v Linuxu,
LocalSystem ve Windows), musí mít právo čtení a zápisu k:
kořenové složce databází a souborům databází;
replication.conf a jeho složce (uzel soubor nahrazuje přes dočasný soubor);
složkám segmentů <database>.ReplLog a <database>.LogArch (uzel je vytvoří sám).
RCM kontroluje oprávnění před zaevidováním (preflight). Selže-li kontrola,
příkaz skončí chybou preflight failed on <node> a seznamem cest.
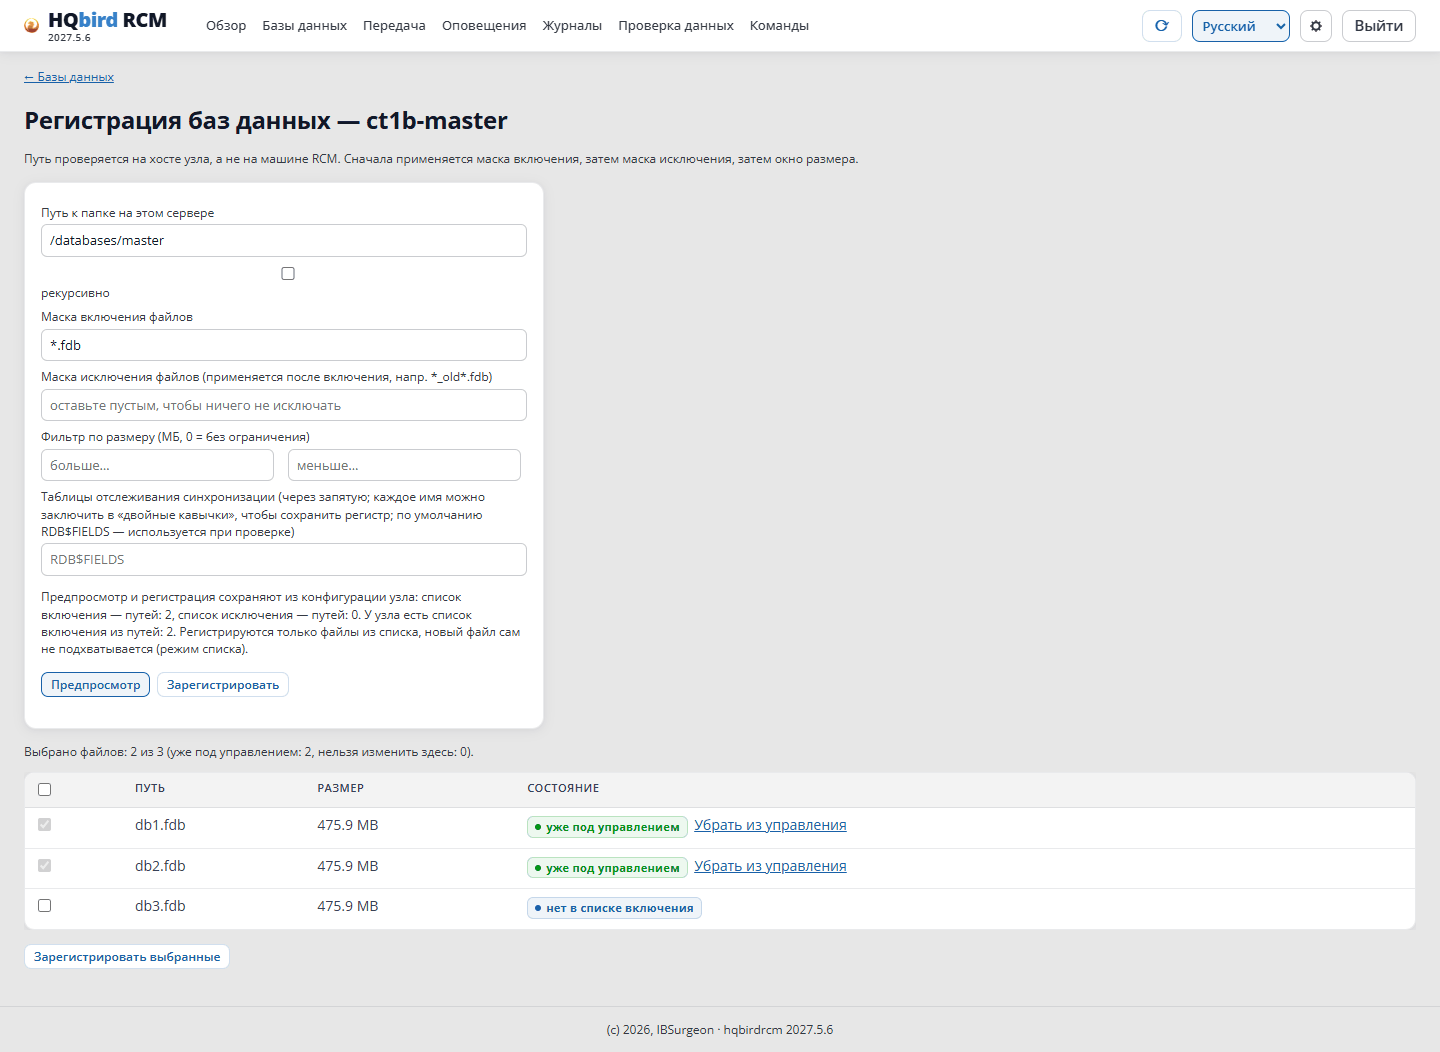
Přehled → karta hlavního uzlu → Zaevidovat databáze.
Uzel repliky tuto stránku nemá.
Formulář ukazuje aktuální pravidla uzlu (uzel je poslal sám). Pokud uzel
neodpovídá, tlačítka náhledu a zaevidování jsou vypnutá: bez aktuálních
pravidel by vynulovala seznamy zahrnutí a vyloučení.
Vyplňte nebo opravte pole: Cesta ke složce na tomto serveru,
rekurzivně, masky, Filtr velikosti, Tabulky sledování
synchronizace.
Pole Tabulky sledování synchronizace:
s HQbird 2027.2.24 a novějším — seznam je na databázi, kterou tato akce
zaeviduje. Prázdné pole: databáze použije tabulky vlastní publikace. Zaevidování nemění sdílený seznam uzlu
(sync_tables). Pokud existuje, formulář to řekne: databáze bez vlastního seznamu ho použije
místo publikace.
Seznam už spravované databáze se nastavuje na její stránce: Databáze →
databáze hlavního uzlu → blok Tabulky sledování synchronizace. Blok
ukazuje, který seznam právě platí. Prázdné pole vlastní seznam databáze odstraní;
v RCM a uzlu 2027.5.7 — jeden seznam pro všechny databáze uzlu
(sync_tables).
Klikněte na Náhled. Uzel ukáže všechny soubory odpovídající masce
zahrnutí. Nic nemění.
Zkontrolujte seznam. Každý soubor má zaškrtávací políčko:
zaškrtnuto — soubor bude spravován;
zaškrtnuto, zamčeno, označeno už spravováno — databáze je už
zaevidována;
zamčeno s důvodem — soubor je vyloučen maskou, velikostí nebo seznamem
vyloučení. Chcete-li ho vzít, změňte pravidlo.
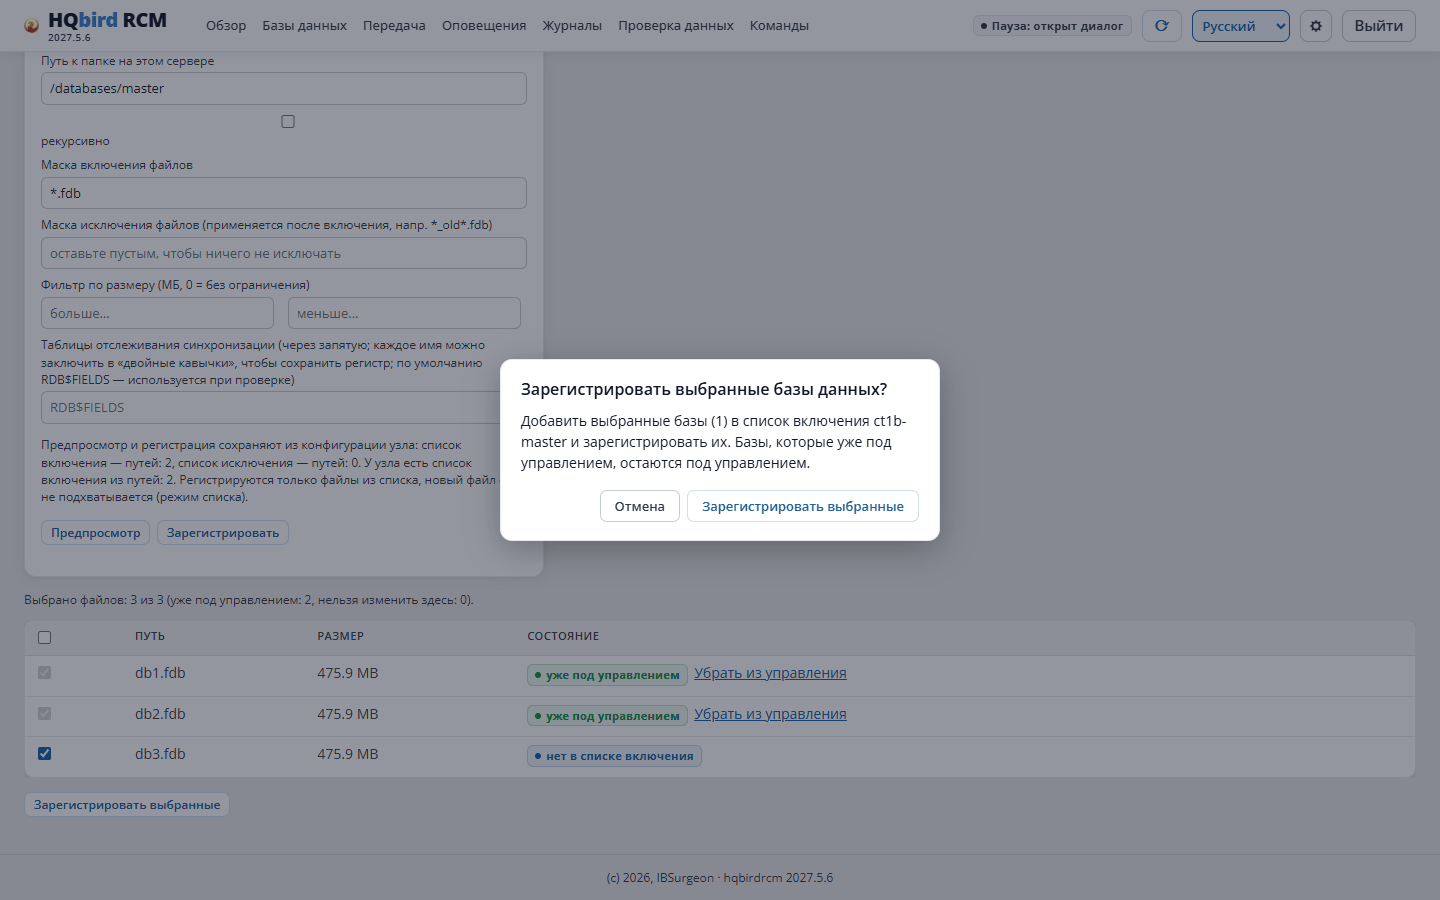
Zaškrtněte potřebné databáze a klikněte na Zaevidovat
vybrané. RCM požádá o potvrzení a ukáže počet souborů.
Potvrzení zaevidování
Co toto tlačítko dělá:
v režimu masky — soubory bez zaškrtnutí se přidají do seznamu vyloučení, soubory se
zaškrtnutím se z něj odeberou;
v režimu seznamu — soubory se zaškrtnutím se přidají do seznamu zahrnutí.
Tlačítko přidává databáze k těm, které už jsou pod správou. Zamčené
řádky nemění.
7. Tlačítko Zaevidovat použije formulář beze změny
seznamů.
8. Počkejte na zprávu o dokončení a počet přidaných databází. Pokud dlouho
nepřijde odpověď, zkontrolujte výsledek na stránce Příkazy.
S HQbird 2027.2.24 a novějším je zpráva „Zaevidováno: N“. Potřebuje-li Firebird hlavního uzlu
restart, RCM řekne, které tlačítko stisknout (obvykle
Restartovat Firebird hlavního uzlu v řádku databáze) a dá odkaz na databáze
hlavního uzlu.
RCM 2027.5.7 může říct „Žádné nové vhodné databáze“, i když databáze
byly přidány: zkontrolujte stránku Databáze.
Výsledek zaevidování
Pokud po zaevidování nebyly nalezeny žádné databáze, ale uzel už nějaké měl, uzel
odmítne (409) a vrátí stará pravidla. Chyba v cestě tak nevypne
replikaci všech databází.
Poznámka: příkaz posílá jen pole ze svých parametrů. Ostatní
pravidla (masky, velikosti, seznamy zahrnutí a vyloučení, sync_tables) uzel vynuluje.
Příkaz pro tato pravidla parametry nemá. Před
spuštěním příkazu zkontrolujte aktuální pravidla (hqbirdrcm getconfig -node node-a). Jsou-li
nastavena, použijte stránku zaevidování.
3.4. Co se stane po registraci
Uzel zapíše pravidla do node.json.
Uzel prohledá složku (scansync).
Pro každou nalezenou databázi uzel zapíše blok do vlastní oblasti
replication.conf (mezi řádky # BEGIN managed-by:node-a role:master a
# END …) a vytvoří složky <database>.ReplLog a <database>.LogArch. Text mimo vlastní oblast uzel nemění.
Před změnou uzel uloží kopii souboru:
replication_YYYYMMDD_hhmmss_NNN.conf.
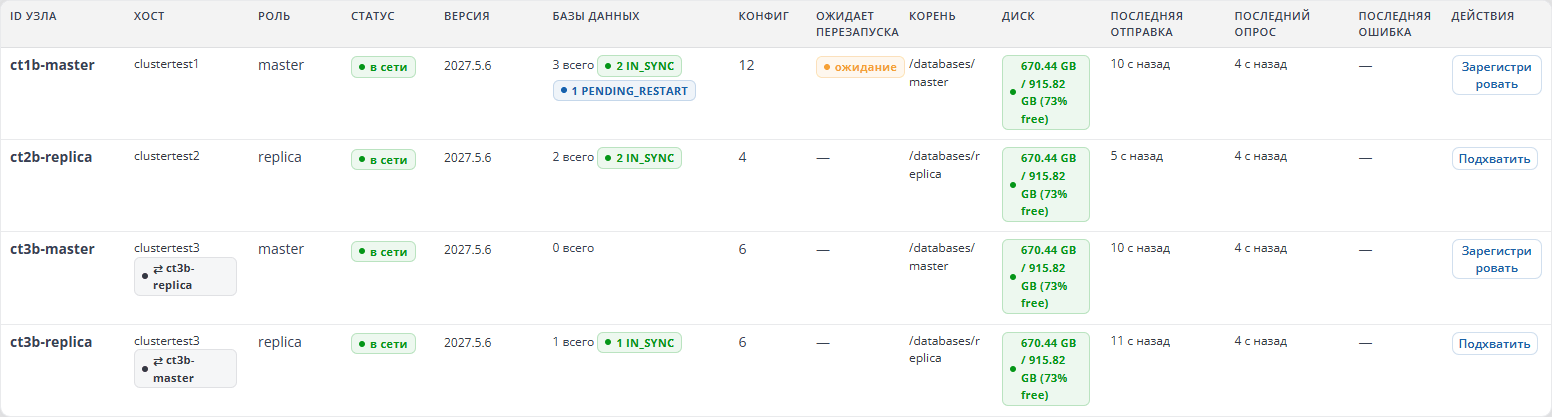
Změnil-li se replication.conf, databáze přejdou do
stavu PENDING_RESTART: Firebird nový soubor přečte až po
restartu. V tabulce Uzly je to ve sloupci Čeká na
restart.
Sloupec „Čeká na restart“ v tabulce „Uzly“
Stavy nové databáze:
Stav
Skupina v RCM
Význam
UNCONFIGURED
Čeká
databáze nalezena, konfigurace ještě není zapsána
PENDING_RESTART
Čeká
konfigurace zapsána, je nutný restart Firebird
CONFIGURED
Čeká
Firebird restartován, databáze je připravena k publikaci a inicializaci
3.5. Restart Firebird hlavního uzlu
Hlavní uzel Firebird sám nikdy nerestartuje. RCM také ne. Restart
hlavního uzlu je rozhodnutí operátora: restart shodí všechna spojení ke
všem databázím této instance Firebird.
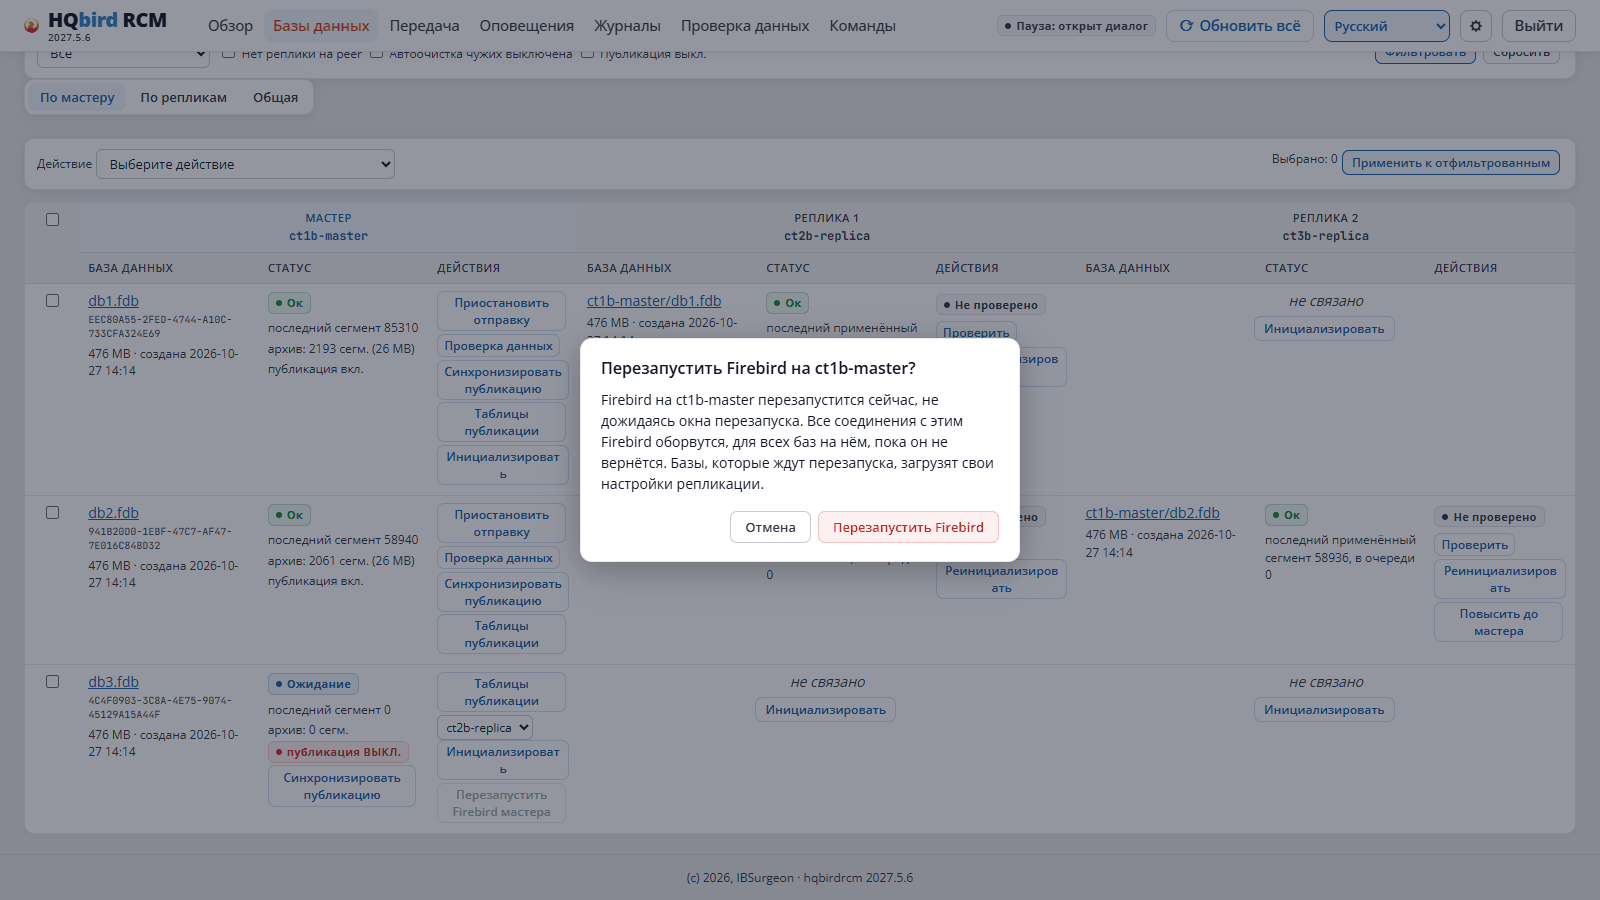
Zvolte dobu nízké zátěže a klikněte na jedno z tlačítek:
Restartovat Firebird hlavního uzlu — na stránce Databáze, v řádku
hlavního uzlu databáze, která čeká na restart;
totéž tlačítko v okně Inicializovat, kapitola 5;
Restartovat Firebird — na stránce databáze.
RCM požádá o potvrzení. Ukáže název uzlu a varování: Firebird
se restartuje hned, bez okna restartu, a všechna spojení se shodí.
Potvrzení restartu Firebird hlavního uzlu
Totéž z příkazového řádku
Command
hqbirdrcm restartfirebird -node node-a
Tento příkaz také restartuje hned, bez okna restartu.
Jak uzel restartuje Firebird:
Ověří, že fbagent odpovídá a spravuje stejnou instanci
(identifikátor, port, název služby z node.json). Pokud se nějaká hodnota
neshoduje, uzel odmítne.
Požádá fbagent o restart Firebird.
Počká, až Firebird odpoví na svém portu.
Přesune databáze z PENDING_RESTART do CONFIGURED.
Několik instancí HQbird na jednom hostiteli. fbagent restartuje služby uvedené v
firebird.update.services své konfigurace. Prázdný seznam znamená všechny
služby HQbird na hostiteli. Jsou-li na hostiteli dvě instance HQbird, nechte
v seznamu jen službu své instance. Jinak restart jednoho uzlu
zastaví i druhou instanci.
Ve Windows. Narostl-li replication.log na log_portion_mb nebo více,
restart proběhne takto: zastavit Firebird → archivovat protokol → spustit.
3.6. Databáze, která se už replikuje ručně
Je-li replikace databáze už nastavena ručně (vlastní blok v
replication.conf, publikace zapnutá, segmenty tečou), lze ji vzít pod
správu bez nové inicializace repliky. K tomu je režim
detect_existing (jen hlavní uzel).
V odpovědi taken_over uvádí databáze, které se přesunou. Přidejte -verbose,
abyste viděli přeskočené databáze s důvodem.
Je-li seznam správný, spusťte příkaz bez -dry-run.
Uzel blok přesune, jen pokud:
složky segmentů se jmenují přesně <database>.ReplLog a <database>.LogArch;
v archivu už segmenty jsou;
publikace je v databázi zapnutá.
Blok s jinými cestami uzel nepřesune a nahlásí ho jako „nalezeno, ale
nepodporováno“.
Po přesunu dostanou databáze PENDING_RESTART, i když se nastavení replikace
nemění: mění se jen poloha bloku v souboru. Restartujte Firebird v
okně údržby.
3.7. Jak ověřit
Databáze: databáze je vidět v řádku hlavního uzlu, stav CONFIGURED
(po restartu).
Vedle databáze může být ikona publikace VYPNUTA: publikace ještě
není zapnutá. To je v pořádku, publikace je další krok (kapitola 6).
Nová databáze v řádku hlavního uzlu
Na hostiteli uzlu: blok databáze je v replication.conf uvnitř
oblasti managed-by:node-a a vedle databáze jsou složky .ReplLog a .LogArch.
3.8. Odebrat databázi ze správy
Obvyklý způsob je tlačítko. Na stránce Databáze zaškrtněte databáze,
vyberte hromadnou akci Odebrat ze správy a
klikněte na Použít na vybrané. RCM:
přidá soubory do seznamu vyloučení uzlu;
jednou prohledá složku: bloky databází se odeberou z replication.conf;
smaže záznamy databází v uzlu.
Soubory databází a složky segmentů zůstanou na disku. Firebird se nerestartuje.
Firebird dál zapisuje segmenty databáze až do dalšího restartu;
RCM řekne, je-li restart potřeba.
RCM odmítne (has_replicas) databázi hlavního uzlu, která má živou repliku:
jinak by replika tiše přestala. Nejdřív z repliky udělejte běžnou databázi nebo
ji odeberte (kapitola 8).
Blok databáze z replication.conf nemažte ručně: při dalším
prohledání ho uzel zapíše znovu.
Zmizel-li soubor databáze nebo byl vyloučen pravidlem. Databáze pak dostane
stav ORPHANED (skupina Osiřelé). Uzel si ponechá záznam a archiv
segmentů: chybějící databáze je častěji omyl než rozhodnutí. Vrátí-li se soubor, databáze
zase funguje a výstraha se zruší. Chcete-li takovou databázi smazat natrvalo,
proveďte dva kroky v tomto pořadí:
Po forgetdatabase příkaz cleanuparchive databázi už nenajde. Oba
příkazy fungují jen pro databázi ve stavu ORPHANED a nesahají na soubor
databáze.
Pozor. Po povýšení repliky na hlavní uzel (kapitola 8) nespouštějte
cleanuparchive -orphaned pro starý záznam: nový hlavní uzel používá stejnou
složku .LogArch a příkaz smaže jeho pracovní archiv.
3.9. Změna kořene databází
Registrace s jinou cestou je povolena. Uzel:
přidá databáze z nové složky;
databáze ze staré složky, které v nové nejsou, přesune do ORPHANED (oznámení
orphaned_database) a jejich archivy si ponechá.
Zvolili-li jste špatnou složku, zaregistrujte znovu správnou. Databáze se
stejnou úplnou cestou bude dál fungovat pod stejným db_id. Databáze na jiné cestě
je nová databáze (nové db_id); její repliku je třeba znovu inicializovat.
3.10. Časté chyby
Co vidíte
Příčina
Co dělat
preflight failed on node-a
nejsou oprávnění ke složkám
opravte oprávnění, zkuste znovu (3.2)
409 scan_would_empty_region
nová složka neobsahuje databáze, ale uzel nějaké měl
zkontrolujte cestu a masku
Náhled je prázdný
maska neodpovídá nebo je špatná složka
zkontrolujte cestu, masku, „rekurzivně“
Tlačítka jsou vypnutá, „Nepodařilo se přečíst konfiguraci uzlu“
uzel neodpovídá
zkontrolujte službu uzlu a síť (kapitola 1)
Databáze dlouho zůstává v PENDING_RESTART
hlavní uzel Firebird sám nerestartuje
restartujte Firebird (3.5)
Restart odmítnut kvůli fbagent
fbagent neběží nebo jeho data neodpovídají node.json
kapitola 1, kontrola fbagent
Nový soubor se neobjevil
uzel je v režimu seznamu
přidejte soubor přes „Zaevidovat vybrané“
4. Jak z databáze udělat repliku: kroky a místo na disku
Tato kapitola pokrývá celou cestu databáze od primární k fungující replice a výpočet místa na disku. Samotná inicializace je podrobně popsána v kapitole 5.
4.1. Hlavní pravidlo
Databáze se na replice objeví jen inicializací z hlavního uzlu (reinit):
hlavní uzel sám přenese kopii přes nbackup.
Kopii nedělejte ručně:
gbak vytvoří nové GUID databáze a vynuluje číslo segmentu. Vazba
hlavní uzel — replika se přeruší.
Kopie souboru běžící databáze není konzistentní a RCM uvidí dvě databáze se stejným
GUID (duplicate_guid) a inicializaci zakáže.
Už běžící repliku nastavenou ručně lze vzít pod
správu bez nové kopie — viz 4.6.
4.2. Kroky
Č.
Krok
Kde
Stav databáze hlavního uzlu po kroku
1
Zaevidování databáze na hlavním uzlu
kapitola 3.3
PENDING_RESTART
2
Restart Firebird hlavního uzlu
kapitola 3.5
CONFIGURED
3
Synchronizace publikace
kapitola 6
CONFIGURED, publikace ZAPNUTA
4
Příprava repliky: složka, oprávnění, verze Firebird
4.3
—
5
Kontrola volného místa na hlavním uzlu a na replice
4.4
—
6
Inicializace
kapitola 5
SEEDING → IN_SYNC
7
Restart Firebird repliky (je-li potřeba)
kapitola 5.6
replika začne aplikovat segmenty
8
Ověření dat
kapitola 5.10
—
Krok 3 je pro Firebird 4/5 povinný. Bez publikace Firebird hlavního uzlu nezapisuje
změny tabulek do segmentů a replika tiše zaostává za hlavním uzlem. Na
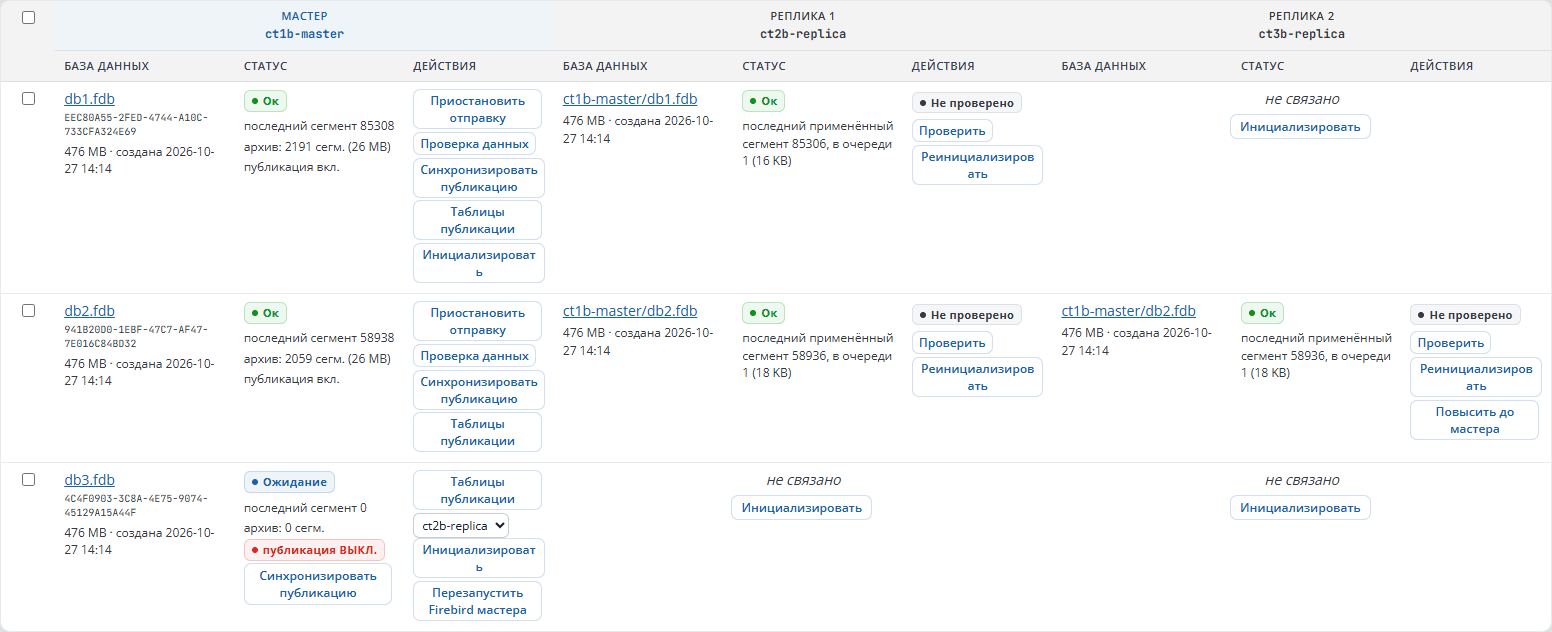
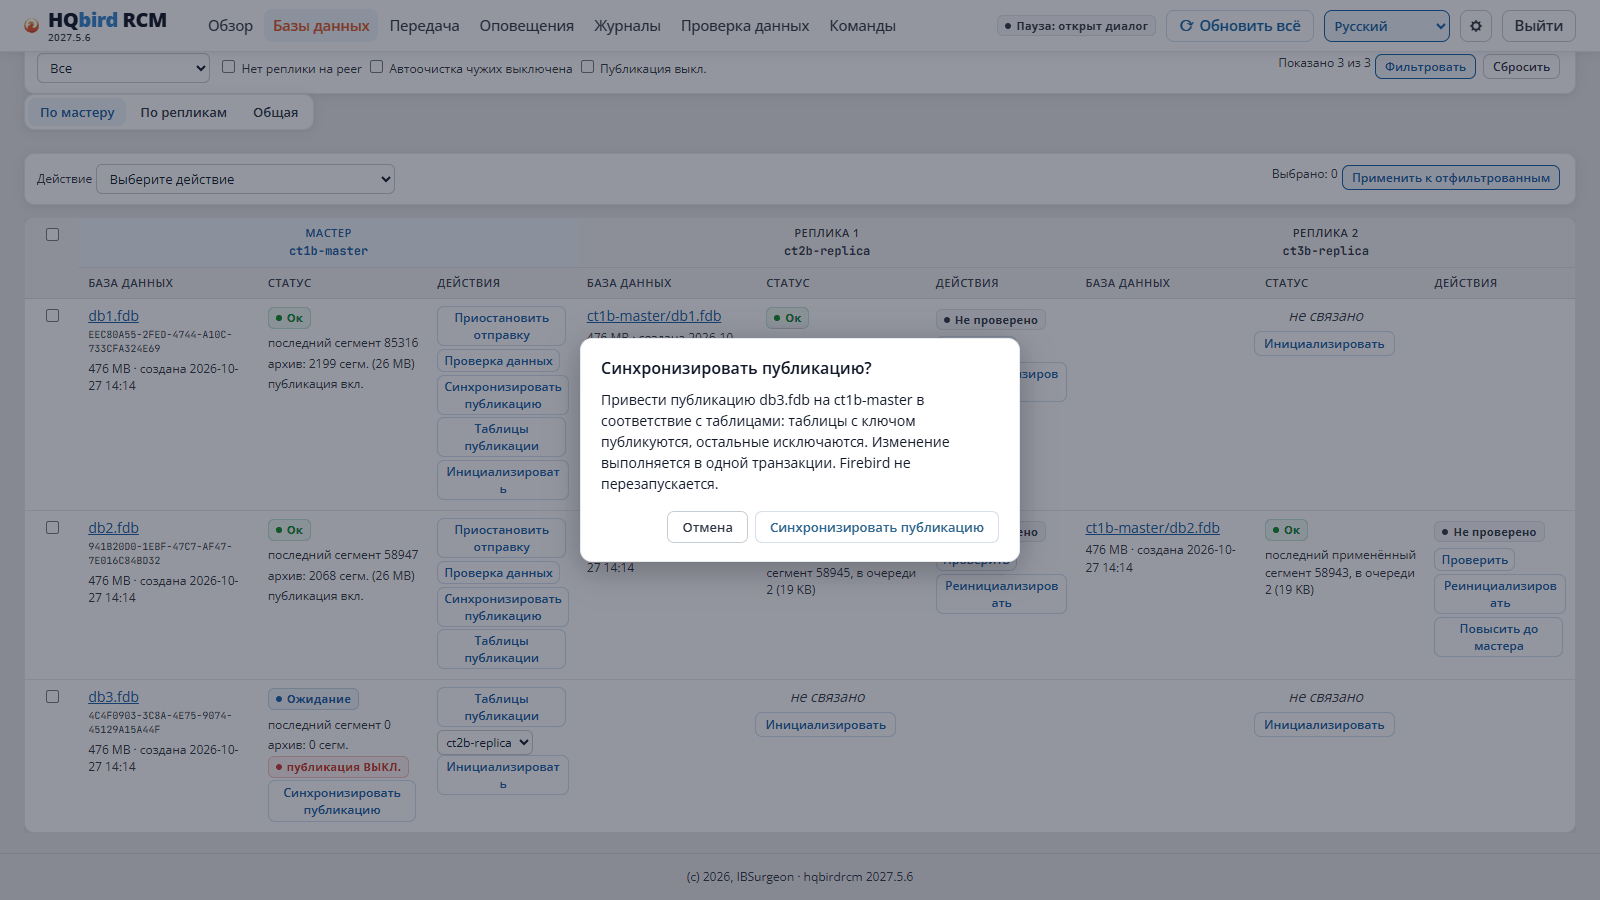
stránce Databáze je taková databáze označena ikonou publikace VYPNUTA. Před inicializací klikněte na
Synchronizovat publikaci.
Od HQbird 2027.2.24 na to okno Inicializovat upozorní a
nabídne tlačítko Synchronizovat publikaci a inicializovat, zatímco uzel
hlavního uzlu inicializaci odmítne chybou publication_off (kapitola 5.1).
RCM a uzel 2027.5.7 publikaci nekontrolují.
HQbird 2.5/3.0. Publikace neexistují, proto se krok 3 přeskočí. Sadu tabulek určují
filtry pluginu replconf (kapitola 6).
Stavy databáze:
Stav
Skupina v RCM
Význam
CONFIGURED
Čeká
Firebird přečetl nastavení, replika ještě není
PUBLISHING
Čeká
probíhá synchronizace publikace
SEEDING
Čeká
probíhá inicializace
IN_SYNC
V pořádku
replika dostala všechny segmenty
LAGGING
Čeká
replika zaostává, segmenty jsou ve frontě
NEEDS_REINIT
Chyba
repliku je třeba znovu inicializovat
FAILED
Chyba
poslední inicializace selhala
4.3. Příprava repliky
Složka databází repliky
Uzel repliky ukládá každou databázi do vlastní složky databases.root na cestě:
Code
<databases.root>/<master node name>/<database path relative to the master root>
Příklad: hlavní uzel node-a s kořenem /databases/master a databází
/databases/master/sales/employee.fdb. Na replice node-b s kořenem
/databases/replica bude databáze zde:
Code
/databases/replica/node-a/sales/employee.fdb
Databáze se stejnými názvy z různých hlavních uzlů se tak nesrazí.
Kořenovou složku nikdo nevytváří automaticky — ani instalátor, ani HQCenter Admin, ani uzel při
startu. Vytvořte ji jedním z těchto způsobů:
v okně Inicializovat: pole Složka repliky, tlačítko
Vytvořit složku. Tlačítko je vidět, jen když složka neexistuje. S HQbird 2027.2.24,
pokud uzel repliky ještě nemá databases.root, pole už obsahuje
/databases/replica/<id uzlu repliky>. Pro repliku ve Windows je pole prázdné:
zadejte složku s písmenem jednotky. Každý uzel repliky na stejném hostiteli potřebuje vlastní
složku. Složku vytvoří uzel
repliky: vlastník — firebird (nebo uživatel služby uzlu), oprávnění
2770. Nemůže-li ji uzel vytvořit, okno ukáže příkaz pro hostitele
repliky. Uvedete-li jinou složku, RCM ji před inicializací zapíše do databases.root uzlu repliky;
Bit setgid (2770) je potřeba, aby všechny soubory uvnitř dostaly skupinu Firebird.
Kořen repliky lze změnit, jen dokud nemá databáze: jinak staré databáze
skončí mimo prohledání. Chcete-li jednu databázi dát jinam, použijte
Přesunout na stránce databáze.
Oprávnění
Uzel repliky a Firebird musí umět zapisovat do kořene databází. Uzel kontroluje, že
umístěné soubory dostanou skupinu složky. Nemůže-li — odmítne s
ownership_unfixable a textem, jak to opravit (obvykle služba uzlu běží s
Group=root).
S HQbird 2027.2.24 okno Inicializovat ukáže i složku, která
existuje, ale služba uzlu do ní nemůže zapisovat: text uzlu s příkazem
opravy a tlačítko Zkontrolovat znovu. RCM 2027.5.7 v tom případě řekne
„Složka existuje“: oprávnění zkontrolujte sami (hqbirdrcm checkpermissions -node <replica> -root <folder>).
Verze Firebird
Hlavní verze Firebird na replice se musí shodovat s hlavním uzlem (5.0 → 5.0,
4.0 → 4.0). Jinak replika odmítne ještě před jakýmkoli přenosem dat:
incompatible_engine.
Konektivita
Uzel repliky musí být partnerem hlavního uzlu a hlavní uzel partnerem repliky (kapitola 2).
Jinak RCM tento uzel v okně Inicializovat nenabídne.
4.4. Kolik místa je potřeba
Stručně
Kde
Co
Kolik
Hlavní uzel, svazek databáze
volné před inicializací
≥ 105 % velikosti databáze
Replika, svazek složky databáze
volné před inicializací
≥ 105 % velikosti databáze, s HQbird 2027.2.24 — plus free_space_floor_gb (plus starý soubor, pokud replika už existovala; se zaškrtnutím Odstranit starou repliku — bez něj)
Hlavní uzel, <database>.ReplLog
pracovní segmenty Firebird
až 64 segmentů × velikost segmentu (výchozí 16 MB) ≈ 1 GB na databázi
Hlavní uzel, <database>.LogArch
archiv segmentů pro repliky
změny za retention_days (výchozí 2 dny) + to, co repliky ještě nepotvrdily
Replika, <database>.Incoming
fronta segmentů k aplikaci
až 256 segmentů × 16 MB ≈ 4 GB na databázi v nejhorším případě
Replika, celý svazek
rezerva
alespoň free_space_floor_gb (výchozí 1 GB)
Kontrola místa před inicializací
Inicializace kontroluje místo dvakrát a jen před uzamčením databáze:
RCM — z nejnovějších statistik uzlu, před odesláním příkazu. Je-li místa
zjevně málo, RCM hned vrátí chybu 507.
Hlavní uzel — živé měření na vlastním svazku, potom žádost replice, aby
změřila svůj. Nestačí-li alespoň na jedné straně, inicializace
skončí v kroku KONTROLA MÍSTA chybou
insufficient disk space on master nebo … on replica.
Požadavek na obou stranách je 105 % velikosti databáze hlavního uzlu.
S HQbird 2027.2.24 uzel repliky počítá takto:
potřebuje 105 % velikosti databáze plusfree_space_floor_gb repliky (7.3):
po inicializaci na svazku zůstane rezerva pro segmenty;
zbytky předchozích inicializací (<database>.hqcluster-part, <database>.new)
se počítají jako volné místo: uzel je před novou kopií smaže;
text chyby uvádí všechna čísla. Uvádí také soubory
<database>.pre-reinit-*.fdb a <database>.failed-seed-*.fdb s jejich velikostí. Uzel
je nikdy nemaže: smažte je sami, nejsou-li potřeba.
force (vynucení) přeskočí jen kontrolu v RCM. Kontrolu uzlu
obejít nelze: chrání uzel před tím, aby mu v polovině kopírování došlo místo.
Nestačí-li místo jen kvůli staré kopii repliky, RCM 2027.2.24 v
chybě 507 jmenuje zaškrtnutí Odstranit starou repliku, ne force. K tomu
musí být oba uzly HQbird 2027.2.24 nebo novější. Jinak chyba jmenuje
uzel, který je třeba aktualizovat, a force.
Proč tolik
Hlavní uzel. Při kopírování je databáze uzamčena pomocí nbackup -L. Všechny
změny se zapisují do souboru <database>.delta vedle databáze. Velikost .delta závisí
na zátěži zápisu během kopírování. Při velké zátěži a pomalém
přenosu může značně narůst — při první
inicializaci místo sledujte.
Replika. Kopie se zapisuje přímo do souboru <database>.hqcluster-part vedle
umístění databáze. Uzel si plnou velikost rezervuje předem. Soubor se potom zkontroluje,
opraví (nbackup -FIXUP -SEQUENCE) a přejmenuje na místo. Druhá
kopie není potřeba — velikost databáze je potřeba jednou, na svazku databáze.
Pokud replika už existovala (opakovaná inicializace), starý soubor leží na
disku až do posledního kroku. Na svazku jsou tedy současně potřeba starý soubor i nová kopie.
Volné místo se počítá bez starého souboru — požadavek
je proto stejný: 105 % velikosti databáze volných.
Odstranit starou repliku (s HQbird 2027.2.24). Není-li na svazku repliky místo
pro novou kopii vedle staré, zaškrtněte toto políčko v okně inicializace
(kapitola 5.1). Uzel repliky potom před přenosem smaže starou kopii a její
příchozí segmenty (.Incoming) a na svazku je dost pro 105 %
velikosti databáze plus free_space_floor_gb. Uzel kopii smaže, jen jsou-li všechny podmínky
pravdivé:
bez smazání místa nestačí a se smazáním stačí;
je to kopie nainstalovaná inicializací tohoto uzlu: hlavička
je čitelná, režim je replika jen pro čtení;
databáze nebyla převedena na normální (není soubor <database>.hqcluster-normal.json, kapitola 8);
overwrite_non_replica není nastaveno (5.9).
Jinak uzel nic nesmaže a odmítne s důvodem v textu. Ke smazání
uzel na dobu mazání zastaví Firebird repliky (5.6).
Políčko je ve výchozím stavu vypnuté. Riziko: dokud přenos probíhá, na replice
kopie databáze není. Má-li databáze jen jednu repliku, je hlavní uzel celou
dobu nechráněný. Dokud nová kopie není, je databáze na replice ve stavu NEEDS_REINIT (ne FAILED a
ne ORPHANED) a replika vydá výstrahu replica_removed_for_reinit
(warn). Jakmile je nová kopie na místě, výstraha se zruší. Selže-li inicializace
po smazání, pár zůstane NEEDS_REINIT: spusťte
inicializaci znovu (nebo ji spustí automatická reinicializace, 5.8).
Nová inicializace přenese databázi od začátku.
Archiv hlavního uzlu (.LogArch). Uzel uchovává odeslané segmenty po
retention_days dní, aby si je replika mohla vyžádat znovu. Segmenty,
které replika ještě neaplikovala, se uchovávají déle. Je-li místa málo, uzel
archiv čistí po etapách:
segmenty aplikované všemi replikami starší než retention_days;
aplikované segmenty, které jsou novější (když je místa málo);
neaplikované segmenty — jen jako poslední možnost. Potom replika
ztratí segmenty, které potřebuje, a dostane NEEDS_REINIT.
Je-li replika dlouho nedostupná, archiv roste. Jeho objem = změny databáze za
dobu výpadku.
Příklad výpočtu
Databáze 100 GB. Zátěž — 5 GB segmentů denně. Inicializace běží
v noci, kopírování trvá 2 hodiny a za tu dobu se do .delta dostanou asi
2 GB.
Kde
Výpočet
Celkem volné
Hlavní uzel, svazek databáze
105 GB na kontroly (zahrnuje růst .delta) + .ReplLog 1 GB + .LogArch 2 dny × 5 GB = 10 GB
≥ 116 GB
Replika, nová databáze
105 GB + .Incoming až 4 GB + 1 GB rezerva
≥ 110 GB
Replika, opakovaná inicializace
starý soubor 100 GB už na disku + 110 GB volných
svazek ≥ 210 GB
Replika, opakovaná inicializace se zaškrtnutím Odstranit starou repliku (s HQbird 2027.2.24)
starý soubor smazán před přenosem: 105 GB + .Incoming až 4 GB + 1 GB rezerva
svazek ≥ 110 GB
Přidejte rezervu na růst databáze a na výpadek repliky (archiv hlavního uzlu roste o
5 GB za den výpadku).
Segmenty na samostatném svazku
Složky .ReplLog, .LogArch a .Incoming jsou ve výchozím stavu vedle databáze.
Lze je přesunout na jiný svazek: parametr segments.storage v node.json
(s mirror_hierarchy: true uzel zopakuje strukturu složek databází). Archiv
pak nebere místo databázím. Kontrola 105 % se dál týká svazku databáze.
Kde se na místo dívat
Databáze → Uzly a Přehled: ikona volného místa svazku
databases.root. Žlutá — méně než 20 %, červená — méně než 10 %.
Stránka Databáze: sloupec Disk v tabulce Uzly
Hlášení clusteru: hqbirdrcm report.
4.5. Několik replik jedné databáze
Druhá a další repliky se vytvářejí stejně: Inicializovat v řádku hlavního uzlu, s výběrem volného uzlu repliky.
Dokud se nová replika inicializuje, hlavní uzel tuto databázi nepřenáší ani už běžícím replikám. Hlavní uzel doženou po skončení inicializace. Okno potvrzení to říká.
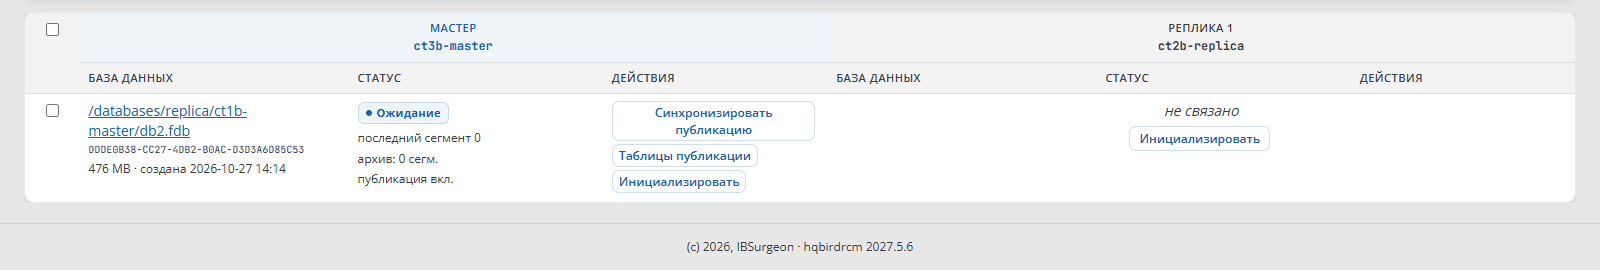
Jedna databáze — jedna inicializace najednou, i pro různé repliky.
Místo na hlavním uzlu se kontroluje zvlášť pro každou inicializaci.
Databáze hlavního uzlu se dvěma replikami
4.6. Ručně nastavená replika
Běží-li replika už z ručně napsaného replication.conf, můžete ji vzít pod správu a databázi nekopírovat znovu:
Hlavní uzel: zaevidujte databáze s detect_existing (kapitola 3.6).
Replika:Databáze → uzel repliky → Převzít, nebo hqbirdrcm takeover-replica. RCM najde bloky repliky, spáruje soubory s databázemi hlavního uzlu podle GUID a u každé ukáže: in_sync, resumable nebo needs_reinit.
Potvrďte řádky. Uzel přesune bloky do vlastní oblasti replication.conf.
Restartujte Firebird repliky, aby přečetl přesunuté bloky.
Inicializujte jen řádky needs_reinit: archiv hlavního uzlu už neobsahuje segmenty, které tyto repliky potřebují.
4.7. Časté chyby
Co vidíte
Příčina
Co dělat
insufficient disk space on master / on replica
málo místa (4.4). Při reinicializaci stará kopie zabírá místo až do konce (4.4)
uvolněte místo, zkuste znovu. Druhá cesta na replice (od HQbird 2027.2.24) je zaškrtnutí Odstranit starou repliku (4.4, 5.1)
507 z RCM hned
podle statistik místa ho zjevně není dost
totéž. Je-li místo bez staré kopie, RCM 2027.2.24 jmenuje zaškrtnutí Odstranit starou repliku
incompatible_engine
různé hlavní verze Firebird
aktualizujte Firebird repliky
Chybí složka na uzlu repliky
kořen nebyl vytvořen
Vytvořit složku v okně inicializace (4.3)
Složka existuje, ale služba uzlu do ní nemůže zapisovat (od HQbird 2027.2.24)
nejsou práva zápisu
spusťte příkaz z okna, klikněte na Zkontrolovat znovu (4.3)
publication_off (od HQbird 2027.2.24)
publikace hlavního uzlu je vypnutá nebo nemá tabulky
Synchronizovat publikaci a inicializovat (5.1)
ownership_unfixable
služba uzlu má cizí skupinu
opravte skupinu služby podle textu chyby
duplicate_guid
dvě databáze se stejným GUID (kopie souboru)
kopii odeberte nebo jí dejte nové GUID (nbackup -F)
Uzel repliky není v seznamu Inicializovat
není spojení v partnerech
kapitola 2
Replika IN_SYNC, ale data se rozcházejí
publikace byla vypnutá
synchronizujte publikaci a potom inicializaci zopakujte
5. Inicializace (reinit)
Inicializace je přenos kopie databáze hlavního uzlu na repliku. První přenos
se nazývá inicializace (tlačítko Inicializovat), opakovaný přenos je
reinicializace (tlačítko Reinicializovat). Mechanismus je stejný.
Než začnete, dokončete kroky 1–5 z kapitoly 4:
databáze je zaevidována, Firebird hlavního uzlu byl restartován, publikace je zapnutá,
složka repliky existuje a místa je dost. Kolik místa je potřeba na hlavním uzlu a na
replice, je popsáno v kapitole 4.4.
5.1. Jak začít
Nejdřív publikace. Zaevidování databáze publikaci nezapíná. Bez
publikace replika nedostává změny. Před inicializací spusťte
Synchronizovat publikaci (kapitola 6) nebo
hqbirdrcm setpublication -node <master>.
S HQbird 2027.2.24 okno inicializace publikaci kontroluje. Je-li
vypnutá nebo nemá tabulky s klíčem, okno ukáže
varování a tlačítko Synchronizovat publikaci a
inicializovat. RCM publikaci synchronizuje, počká na dokončení příkazu a
spustí inicializaci s výběrem z okna.
Hlavní uzel 2027.2.24 takovou inicializaci (i tu první)
sám odmítne chybou publication_off a vydá oznámení
master_publication_off (kapitola 6.1). Po odmítnutí má buňka databáze znovu
tlačítko Synchronizovat publikaci a inicializovat.
Vypnul-li operátor publikaci (6.4) nebo z ní odebral všechny tabulky s
klíčem (6.3), synchronizace to zachová. RCM
inicializaci nespustí a dá odkaz na stránku Tabulky publikace.
RCM a uzel 2027.5.7 publikaci nekontrolují: inicializace
uspěje, databáze v RCM ukazuje „OK“, ale replika změny nedostává. Byla-li
publikace zapnuta až po inicializaci — databázi reinicializujte.
Okno "Reinicializovat databázi?"
Otevřete Databáze.
V řádku databáze hlavního uzlu, ve sloupci uzlu repliky, klikněte na Inicializovat.
Uzel repliky určuje sloupec: v okně se nevybírá. Pro
existující pár — Reinit v rozbalené kartě hlavního uzlu.
V okně (s HQbird 2027.2.24 je titulek pro nový pár „Inicializovat
databázi?“; v RCM 2027.5.7 — „Reinicializovat databázi?“ i při
první inicializaci):
zkontrolujte Složku repliky. Okno ukazuje, zda složka existuje. Pokud
ne, klikněte na Vytvořit složku: uzel repliky ji vytvoří (4.3). Nemůže-li ji
uzel vytvořit, okno ukáže příkaz pro hostitele repliky. S HQbird
2027.2.24 okno ukáže i složku, do které služba uzlu nemůže
zapisovat: příkaz opravy a tlačítko Zkontrolovat znovu;
vyberte Metodu reinit: Plynulá (doporučeno) nebo Standardní
(5.4). S HQbird 2027.2.24, nemá-li archiv hlavního uzlu ještě segmenty
(obvykle před první inicializací), okno ukáže nápovědu: na
vytížené databázi je Standardní rychlejší;
čeká-li databáze hlavního uzlu ještě na restart Firebird, okno to řekne a
ukáže tlačítko Restartovat Firebird hlavního uzlu. Bez restartu se databáze
nereplikuje;
Odstranit starou repliku (s HQbird 2027.2.24, ve výchozím stavu vypnuto)
je potřeba jen při reinicializaci, když svazek repliky nemá
místo pro novou kopii vedle staré (4.4). Okno čísla
ukáže předem: kolik je potřeba, kolik je volné, kolik zabírá stará kopie.
Je-li místo bez staré kopie, okno vás požádá políčko zaškrtnout. Políčko
je neaktivní, je-li hlavní uzel nebo uzel repliky stará verze: okno uvede,
který uzel aktualizovat. Dokud nová kopie není hotová, replika kopii této
databáze nemá (4.4).
Potvrďte. RCM uvede, že databáze se na hlavním uzlu uzamkne a
zkopíruje na repliku.
Průběh inicializace je vidět v rozbalené kartě hlavního uzlu na stránce Databáze:
kroky a procenta. S HQbird 2027.2.24 je průběh vidět i po obnovení
stránky: při první inicializaci — v buňce uzlu repliky a také v
řádku Průběh reinicializace na stránce databáze hlavního uzlu. Tlačítko
Inicializovat je neaktivní, dokud hlavní uzel databázi kopíruje. Nesleduje-li RCM
tuto inicializaci (například byla spuštěna z příkazového řádku uzlu),
kroky se berou ze stavu uzlu, bez procent. V RCM 2027.5.7 po
obnovení stránky průběh první inicializace vidět není: počkejte, až databáze
hlavního uzlu opustí SEEDING.
Kroky inicializace v řádku hlavního uzlu
Každý příkaz RCM (inicializace, restart Firebird, synchronizace
publikace) se zapisuje na stránku Příkazy s výsledkem.
Stránka "Příkazy"
Totéž z příkazového řádku
Command
# one databasehqbirdrcm reinit -node node-a -db <db_id> -to node-b
# all master databaseshqbirdrcm reinit -node node-a -all -to node-b
-remove-old-replica (s HQbird 2027.2.24) — totéž co zaškrtnutí Smazat
starou repliku. Jen pro jednu databázi: -db a -to jsou povinné; s
-all příkaz odmítne. Je-li hlavní uzel nebo uzel repliky stará verze, RCM
odmítne s node_too_old a nic neodešle.
-all zkusí všechny databáze a chyby sbírá, místo aby se zastavil u první.
5.2. Kroky
Č.
Krok (v RCM)
Co se děje
1
KONTROLA MÍSTA
kontroluje místo na hlavním uzlu a na replice (kapitola 4.4); replika předem ověří, že soubor může přijmout
2
ZAMYKÁNÍ
nbackup -L: soubor databáze hlavního uzlu je zmrazen, změny jdou do <database>.delta
3
KOPÍROVÁNÍ NA UZEL
soubor se přenáší po částech: čtení → kontrolní součet → komprese → odeslání
4
ODMYKÁNÍ
nbackup -N hned po přenosu: změny z .delta se vrátí do databáze
5
NASAZOVÁNÍ
na replice: ověření kontrolního součtu souboru, nbackup -FIXUP -SEQUENCE, instalace souboru, gfix -replica, zápis bloku do replication.conf
6
RESTART REPLIKY
restart Firebird repliky, je-li potřeba (5.6)
Po kroku 6 dostane databáze stav IN_SYNC. Hlavní uzel dál posílá
segmenty od místa, kde kopie končí.
Co je důležité vědět:
Hlavní uzel běží pořád. Uživatelé do databáze zapisují, změny jdou do
.delta. Zámek se uvolní hned po přenosu.
Transakce, které se kryly se zámkem, se neztratí. Uzel najde
transakce otevřené v okamžiku nbackup -L a replika je přehraje ze
segmentů.
Přenos pokračuje po přerušení. Restartovalo-li se spojení nebo uzel repliky,
hlavní uzel pokračuje od poslední přijaté části. Nedokončený
přenos se na replice uchovává 24 hodin (reinit_partial_keep_hours).
Při chybě uzel zámek uvolní, nedokončený soubor na
replice smaže a databázi nastaví na FAILED. Další pokus začne ze známého
stavu.
Se zaškrtnutím „Smazat starou repliku“ (od HQbird 2027.2.24) replika
smaže starou kopii po kroku ZAMYKÁNÍ, před přenosem. Krok KOPÍROVÁNÍ NA
UZEL v tu chvíli ukazuje „odstraňování staré kopie repliky, aby se uvolnilo
místo“. Chyba po smazání dá páru NEEDS_REINIT místo FAILED
(kapitola 4.4).
Jen nbackup. gbak se nepoužívá: mění GUID databáze.
5.3. Dopad na provoz
Co
Dopad
Uživatelé hlavního uzlu
pracují dál; při kopírování .delta roste, po -N se změny přenesou do databáze
Ostatní repliky této databáze
nedostávají segmenty této databáze, dokud inicializace probíhá; potom doženou
Ostatní databáze hlavního uzlu
nejsou dotčeny
Firebird repliky, nová databáze
nezastavuje se; restart podle 5.6
Firebird repliky, opakovaná inicializace
je zastaven, dokud se soubor nahrazuje: všechny databáze tohoto Firebird jsou na sekundy nedostupné
je zastaven dříve, dokud mazání probíhá, před přenosem. Uzel nainstaluje novou kopii bez druhého zastavení, nezměnil-li se blok databáze v replication.conf. Je-li místa dost a mazání není potřeba, uzel nic nemaže a vše probíhá jako u běžné opakované inicializace
Síť a disk
zátěž podle limitů rychlosti (5.5)
Ve Windows. Soubor otevřený Firebird nelze nahradit. Při opakované
inicializaci uzel zastaví Firebird repliky přes fbagent, nainstaluje
soubor a Firebird znovu spustí. V Linuxu se Firebird před
náhradou také zastaví: jinak by dál pracoval se starým smazaným souborem.
5.4. Plynulá a standardní metoda
Plynulá (výchozí). Před zamčením uzel hledá dlouhé transakce: uživatelské zapisovací transakce, které začaly před nejstarším segmentem v archivu hlavního uzlu. Po inicializaci je replika nebude umět přehrát a zastaví se u jejich první změny („Transakce … nebyla nalezena“). Transakce beze změn se nepočítají.
Existují-li takové transakce, inicializace nezačne: RCM zobrazí Plynulý reinit čeká na dlouhé transakce a dá odkaz Otevřít seznam.
Stránka dlouhých transakcí: žádné dlouhé transakce
Na stránce Dlouhé transakce:
souhrn: kolik transakcí a spojení, nejstarší segment;
5 nejstarších spojení s nejstaršími transakcemi: uživatel, klient, začátek, stáří, změny, aktuální dotaz;
Podržet segmenty / Uvolnit podržení — dokud je podržení zapnuté, archiv hlavního uzlu se nečistí a historie se nezkracuje;
Odpojit vybrané a zopakovat reinit — odpojí spojení (jejich transakce se vrátí zpět) a hned spustí plynulý reinit;
Zopakovat reinit, Zkontrolovat znovu.
Podržení se zapne automaticky, když je reinit odmítnut kvůli dlouhým transakcím. Uvolní se po úspěšné inicializaci, ručně, nebo když archiv naroste na reinit_hold_max_segments (výchozí 1000 segmentů, oznámení retention_hold_released).
Standardní databázi zamkne hned, bez kontroly. Použijte ji, jen víte-li, že dlouhé zapisovací transakce nejsou.
První inicializace pod zátěží. Dokud je archiv hlavního uzlu prázdný, není segment, se kterým porovnávat.
S hlavním uzlem HQbird 2027.2.24: zapnul-li publikaci sám uzel a archiv se od té doby nezměnil, historie začíná v okamžiku zapnutí publikace. Transakce začatá později vstoupí do žurnálu od své první změny a plynulé metodě nepřekáží. Transakce začatá dříve do žurnálu nevstoupila: reinit na ni před zamčením čeká (6 pokusů každých 10 s) a krok locking ukáže její číslo, spojení a uživatele. Neskončila-li, reinit skončí chybou reinit_pre_publication_transactions: dokončete ji a zkuste znovu. Stránka Dlouhé transakce takové transakce ukazuje v tabulce Transakce začaté před zapnutím publikace.
Byla-li publikace zapnuta ručně, ne přes uzel, nebo se archiv už změnil, začátek historie není znám. V tom případě plynulá metoda odmítne, je-li otevřena jakákoli zapisovací transakce, a zpráva říká, že archiv ještě neobsahuje segment. RCM 2027.2.24 v tom případě seznam neotevře, ale do buňky databáze napíše, co dělat. Zvolte Standardní, nebo to zkuste znovu, až Firebird archivuje první segment.
S hlavním uzlem 2027.5.7 plynulá metoda při první inicializaci právě zapisované databáze odmítne hned: long_transactions … segment 0 (0001-01-01T00:00:00Z). Pro první inicializaci takové databáze zvolte Standardní.
U dalších reinicializací plynulá metoda funguje jako obvykle (archiv už existuje).
Transakce starší než publikace. Firebird do segmentů nezapisuje transakci, která začala před zapnutím publikace. Zapnul-li publikaci uzel, inicializace čeká (6 pokusů každých 10 sekund), až takové transakce skončí; jinak skončí chybou reinit_pre_publication_transactions a vypíše je. Po synchronizaci publikace, která přidala tabulky, znovu připojte aplikace a potom spusťte inicializaci.
5.5. Rychlost
Kdy
Rychlost
Nastavení
Uvnitř okna přenosu windows.transfer_window (výchozí 23:00-05:00)
stálá
limits.reinit_window_mbps, výchozí 100 MB/s
Mimo okno
podíl změřené rychlosti disku
limits.reinit_day_disk_fraction, výchozí 0,5
Uzel režim přepočítá každých 30 sekund: inicializace spuštěná ve dne se v noci sama zrychlí.
Uzel měří rychlost disku testem. Chcete-li test zopakovat na hostiteli hlavního uzlu:
Doba inicializace ≈ velikost databáze ÷ rychlost. Příklad: 100 GB při 100 MB/s — asi 17 minut čistého přenosu; v praxi to omezuje síť nebo disk.
5.6. Restart Firebird repliky
Nová databáze na replice. Soubor se umístí bez zastavení Firebird. Firebird
nový blok replication.conf přečte až po restartu. Do té doby
replika nic neaplikuje. Krok RESTART REPLIKY ukazuje čekání:
Popisek
Co znamená
čeká se na restart Firebird na replice, je naplánován na …
uzel Firebird restartuje sám po poslední inicializaci (reinit_restart_delay_sec), až ostatní inicializace skončí
… okno restartu je zavřené, další se otevře v …
čekání na restart_window repliky
… poslední pokus selhal, další v …
zkusí to později
replika nemůže Firebird restartovat sama: restartujte ho ručně
auto_restart: never, nebo tento Firebird obsluhuje i databáze hlavního uzlu
Uzel restartuje Firebird jednou po sérii inicializací, ne po
každé databázi.
Ruční restart: klikněte na Restartovat Firebird repliky.
Čekání skončí po jakémkoli úspěšném restartu Firebird nebo když
replika aplikovala segment novější než kopie.
Reinicializace na Firebird, který obsluhuje i databáze hlavního uzlu.
Uzel takový Firebird sám nezastaví a odmítne s
restart_not_allowed. Spusťte inicializaci znovu a zaškrtněte Povolit
uzlu zastavit Firebird pro tento reinit (-allow-restart na příkazovém
řádku) — v době, kdy lze spojení tohoto Firebird shodit, včetně
jeho databází hlavního uzlu. Takové inicializace spouštějte na hostiteli po jedné.
Mazání staré kopie (zaškrtnutí Odstranit starou repliku, s HQbird
2027.2.24) také zastaví Firebird repliky, podle stejných pravidel. Nemůže-li
uzel tento Firebird zastavit sám, nic nesmaže a
odmítne s restart_not_allowed: zaškrtněte také Povolit uzlu
zastavit Firebird pro tento reinit. Dokončuje-li se v tu chvíli na replice jiná inicializace
nebo se Firebird restartuje, uzel nic
nesmaže a odmítne s engine_busy: hlavní uzel zámek uvolní,
zkuste to později.
5.7. Fronta a souběžné inicializace
Jedna databáze — jedna inicializace najednou (i pro různé repliky). Tlačítko Inicializovat je vypnuté, dokud inicializace této databáze probíhá.
Hlavní uzel prosazuje limits.max_concurrent_reinits inicializací různých databází současně (výchozí 1). Ostatní čekají ve frontě; odpověď obsahuje pozici ve frontě.
Během inicializace databáze nespouštějte vlastní nbackup -L (ani ALTER DATABASE BEGIN BACKUP) a nespouštějte inicializaci během takové zálohy: databáze může mít jen jeden zámek. Inicializace to kontroluje a odmítne s nbackup backup lock already active.
Fronta a aktuální přenosy jsou vidět na stránce Přenos.
Stránka Přenos / fronty
- Zůstane-li po selhání soubor `.delta`, ujistěte se, že neběží záloha, a spusťte `nbackup -N `. `.delta` nemažte ručně.
5.8. Automatická reinicializace
RCM může databázi ve stavu NEEDS_REINIT reinicializovat samo, jen uvnitř
nastaveného okna. Ve výchozím stavu vypnuto.
Když databáze vstoupí do NEEDS_REINIT:
Příčina
Kde je to vidět
opakující se neopravitelná chyba aplikace (porušení PK, UNIQUE, FK) — 3× za sebou
replika, výstraha replication_unrecoverable_error
GUID databáze hlavního uzlu se změnilo (obnova, náhrada souboru)
replika, výstraha replication_guid_mismatch
archiv hlavního uzlu už neobsahuje segmenty, které replika potřebuje
hlavní uzel
replika smazala starou kopii kvůli inicializaci a nová kopie ještě není (od HQbird 2027.2.24)
replika, výstraha replica_removed_for_reinit; hlavní uzel
Zapnutí — Nastavení → RCM (nebo rcm.json, sekce auto_reinit):
Okno: na databázi → na uzel → globální. "always" — kdykoli.
Okna se počítají podle hodin hostitele RCM.
max_concurrent — kolik inicializací (ručních i automatických) smí v
clusteru běžet, aby RCM spustilo další automatickou.
Automatická inicializace prochází stejnými kontrolami místa a GUID jako
ruční. Autor příkazu je system:autoreinit.
remove_old_replica_when_short (od HQbird 2027.2.24, řádek Smazat
starou repliku při nedostatku místa) — ve výchozím stavu vypnuto. Je-li
zapnuto, automatická inicializace posílá příznak Smazat starou
repliku (4.4). RCM ho pošle, jen je-li sama replika ve
NEEDS_REINIT nebo příčina NEEDS_REINIT hlavního uzlu ji jmenuje. Pro
repliku, která je IN_SYNC nebo LAGGING, se příznak nikdy neposílá. Je-li uzel
starší verze, RCM spustí stejnou inicializaci bez příznaku.
Po změně restartujte RCM.
Odložit na kartě hlavního uzlu vypne automatickou
inicializaci jedné databáze na 1 hodinu, 4 hodiny, 24 hodin nebo do zrušení. Ruční
inicializace zůstává dostupná.
5.9. Chyby
Chyba
Příčina
Co dělat
insufficient disk space on master / on replica, 507
málo místa. Při reinicializaci stará kopie zabírá místo až do konce
kapitola 4.4; na replice (od HQbird 2027.2.24) — zaškrtnutí Odstranit starou repliku (5.1)
node_too_old (od HQbird 2027.2.24)
zaškrtnutí Odstranit starou repliku je zapnuté, ale hlavní uzel nebo uzel repliky je stará verze
aktualizujte uzel podle textu chyby nebo spusťte bez zaškrtnutí
engine_busy, reclaim_in_progress (od HQbird 2027.2.24)
replika teď starou kopii smazat nemůže: Firebird nebo tato databáze je zaneprázdněná
zkuste později (5.6)
replica_removed_for_reinit, pár NEEDS_REINIT (od HQbird 2027.2.24)
replika smazala starou kopii, ale inicializace nedoběhla
spusťte inicializaci znovu (4.4)
publication_off (od HQbird 2027.2.24)
publikace hlavního uzlu je vypnutá nebo neobsahuje tabulky s klíčem
Synchronizovat publikaci a inicializovat (5.1)
long_transactions, „Plynulý reinit čeká na dlouhé transakce“
jsou otevřené dlouhé zapisovací transakce
5.4
long_transactions, „archiv hlavního uzlu ještě neobsahuje ani jeden segment“
první inicializace pod zátěží
Standardní (5.4)
reinit_pre_publication_transactions
transakce začaté před zapnutím publikace
znovu připojte aplikace, zkuste znovu
duplicate_guid
dvě databáze hlavního uzlu se stejným GUID
kopii odeberte; byl-li při povýšení na hlavní uzel přeskočen krok NOVÉ GUID — -force (kapitola 8.4)
license_paused
fbagent hlavního uzlu nemá licenci
kapitola 2.8
409 orphaned
databáze je mimo prohledání hlavního uzlu
kapitola 3.8
incompatible_engine
různé hlavní verze Firebird
kapitola 4.3
target_not_replica
na místě repliky je pracovní databáze (byla převedena na normální)
viz níže
target_other_replica (od HQbird 2027.2.24)
na místě repliky je kopie jiné databáze tohoto uzlu
viz níže
restart_not_allowed
Firebird repliky obsluhuje i databáze hlavního uzlu
5.6, zaškrtnutí „Povolit … zastavit Firebird“
fbagent_required
na replice není nainstalován fbagent
kapitola 1
nbackup backup lock already active
probíhá záloha nbackup
5.7
… -L did not finish in 2m0s and was stopped
nbackup -L na hlavním uzlu nedoběhl do 2 minut, proto ho uzel zastavil
zkuste znovu; opakuje-li se chyba, zkontrolujte Firebird hlavního uzlu (firebird.log)
reinit already in progress for this database
inicializace této databáze už běží
počkejte, až skončí
target_not_replica. Na místě kopie je pracovní databáze: byla převedena
na normální (existuje soubor <database>.hqcluster-normal.json) nebo není v
režimu repliky. Uzel pracovní databázi nepřepíše. Má-li se nahradit, požadavek na API uzlu s
overwrite_non_replica: true (v RCM na to tlačítko není) soubor nahradí a starý ponechá jako
<database>.pre-reinit-<čas UTC>.fdb.
target_other_replica (od HQbird 2027.2.24). Replika ukládá kopii do
<databases.root>/<id hlavního uzlu>/<cesta databáze>. Id hlavního uzlu je jedinečné jen uvnitř
vlastního clusteru, takže dvě databáze mohou skončit na stejné cestě. Uzel repliky
nepřepíše kopii patřící jiné z jeho databází: chyba tuto databázi a její
hlavní uzel jmenuje. Uzel pozná i kopii, jejíž cesta je zapsána jinak (symbolický odkaz nebo
junction v cestě, krátký název složky Windows). overwrite_non_replica tuto chybu nezruší. Přesuňte jednu z
kopií do jiné složky nebo tuto databázi z repliky odeberte a potom
inicializaci spusťte znovu. Uzel vidí jen vlastní databáze: dva uzly repliky na
stejném hostiteli musí mít různé složky repliky (databases.root).
5.10. Jak zkontrolovat výsledek
Databáze: pár hlavní uzel — replika ve skupině je V pořádku, stav
IN_SYNC.
Ověřit na kartě hlavního uzlu: uzly spočítají řádky tabulek ze
seznamu tabulek databáze (kapitola 3.1) na hlavním uzlu a na replice a porovnají je.
Kontrolujte v klidné době: při aktivních zápisech se čísla mohou lišit.
S HQbird 2027.2.24 stránka výsledku jmenuje seznam každé strany
(například „vlastní seznam této databáze“ nebo „tabulky publikace
(seznam není nastaven)“). RCM počítá repliku podle seznamu hlavního uzlu. Tabulka,
která chybí v obou databázích, se ukáže jako „není v databázi“ a nepočítá se jako
chyba. Nebyly-li porovnány žádné tabulky, výsledek je „Žádné tabulky k
porovnání“, ne nesoulad. Nedokončilo-li se porovnání v daném čase,
výsledek je „Neporovnáno (časový limit)“, což také není nesoulad.
Pravidelná kontrola (volitelná): stránka Kontrola dat,
Zapnout pro všechny uzly. S HQbird 2027.2.24 uzel
nastavení použije hned, restart služby uzlu není potřeba: po Uložit RCM
napíše „Uloženo a už platí“. Uzel 2027.5.7 potřebuje restart
služby hqclusternode a RCM 2027.2.24 to řekne.
Uzly samy porovnávají počty řádků, když jsou hlavní uzel a replika na stejném
segmentu. Nesoulad vyvolá výstrahu data_mismatch; potom spusťte
Ověřit.
Tabulka, kterou operátor z publikace odebral, se ukáže jako „není
publikována“, ne jako nesoulad.
6. Nastavení publikace
Publikace říká Firebird hlavního uzlu, změny kterých tabulek zapisovat do segmentů.
Bez ní replika nedostane nic.
6.1. Co je publikace
Ve Firebird 4 a 5 tabulky k replikaci určuje publikace RDB$DEFAULT:
Publikace zapnutá — v RDB$PUBLICATIONS má RDB$ACTIVE_FLAG = 1
(příkaz ALTER DATABASE ENABLE PUBLICATION).
Publikované tabulky — seznam v RDB$PUBLICATION_TABLES.
Firebird zapisuje změny do segmentů jen u publikovaných tabulek a jen
když je publikace zapnutá. Zaevidování databáze (kapitola 3) publikaci nezapíná.
Zapíná ji Synchronizovat publikaci (6.2).
Hlavní uzel publikaci kontroluje každou hodinu
(limits.publication_check_interval_sec, výchozí 3600). Je-li
vypnutá, uzel ji kontroluje každé 2 minuty.
Na stránce Databáze má databáze hlavního uzlu ikonu:
Ikona
Význam
publikace ZAPNUTA
publikace zapnutá
publikace VYPNUTA
Firebird do segmentů nic nezapisuje, repliky nedostávají změny
publikace neznámá
uzel stav nepřečetl
Filtr Publikace vypnutá ukazuje databáze s vypnutou nebo neznámou
publikací.
Má-li databáze s vypnutou publikací už repliku, hlavní uzel vyvolá
výstrahu master_publication_off.
S HQbird 2027.2.24 hlavní uzel tuto výstrahu vyvolá i když odmítl
inicializovat databázi chybou publication_off (kapitola 5.1): publikace
je vypnutá nebo neobsahuje tabulku s klíčem. Úroveň výstrahy:
warn — databáze ještě nemá repliku: inicializace čeká na publikaci;
serious — databáze už repliku má;
info — publikaci vypnul operátor.
Výstraha se zruší, když se publikace opraví nebo začala jiná
inicializace.
6.2. Synchronizovat publikaci
Řádek hlavního uzlu: publikace vypnutá
Kam kliknout:
v řádku databáze hlavního uzlu na stránce Databáze. Je-li publikace
vypnutá, tlačítko je vedle ikony;
na stránce databáze;
pro několik databází: zaškrtněte řádky, v seznamu Akce vyberte
Synchronizovat publikaci. RCM pošle samostatný příkaz pro každou
databázi.
Potvrzení synchronizace publikace
Co uzel dělá (jedna transakce):
Zapne publikaci. Vypnul-li ji operátor sám (6.4), nezapne ji.
Do publikace přidá všechny tabulky s klíčem, které tam ještě nejsou.
Z publikace odebere tabulky bez klíče a tabulky, které operátor
vyloučil (6.3).
Vypne automatické přidávání nových tabulek (EXCLUDE ALL FROM PUBLICATION, potom přidá potřebné tabulky). Složení publikace určuje jen uzel.
Řádek hlavního uzlu po synchronizaci: publikace zapnutá
Tabulka s klíčem — trvalá uživatelská tabulka, která má
primární klíč nebo aktivní jedinečný index. Systémové a dočasné
tabulky se nepublikují.
Synchronizace z publikace odebere i tabulky bez klíče, které správce přidal
ručně.
Je-li složení už správné, uzel nic nemění.
Kdy uzel odmítne:
Kód
Důvod
no_publications
HQbird 2.5/3.0 (6.6)
not_master
uzel není hlavní
reinit_in_progress
probíhá inicializace této databáze
orphaned, database_failed, file_missing
databáze je mimo prohledání, v chybě, nebo nemá soubor
Všechny databáze uzlu najednou — jen z příkazového řádku. Na stránce Příkazy
se výsledek ukazuje po databázích: hotovo, přeskočeno nebo chyba.
Databáze ve stavu FAILED nebo SEEDING a databáze bez souboru se přeskočí.
Totéž z příkazového řádku
Command
hqbirdrcm setpublication -node node-a -db <db_id> # one databasehqbirdrcm setpublication -node node-a # all node databases
Příkaz čeká až 5 minut a pro každou databázi vypíše řádek. Při chybě je návratový
kód 1. -nowait — na výsledek nečekat.
6.3. Tabulky publikace
Stránka „Tabulky publikace“
Otevřete Tabulky publikace v řádku databáze hlavního uzlu.
Stránka ukazuje:
stav publikace (zapnuto/vypnuto, vypnuto operátorem) a čítače;
každou tabulku: název, klíč a stav.
Stav
Význam
publikována
změny jdou do segmentů
ještě nepublikována
tabulka s klíčem, přidá se při synchronizaci
vyloučena
operátor ji z publikace odebral
bez klíče
nelze publikovat
Ve sloupci klíče — primární klíč, nebo, není-li, jedinečný index s
nejmenším počtem polí.
Proč tabulku bez klíče nelze publikovat. Replika hledá řádek pro
UPDATE a DELETE podle klíče. Bez klíče řádek nenajde. Přidejte
primární klíč nebo jedinečný index a potom publikaci synchronizujte.
Vyloučit z publikace / Vrátit do publikace:
Zaškrtněte tabulky.
Klikněte na Vyloučit z publikace nebo Vrátit do publikace.
Uzel seznam uloží a publikaci hned synchronizuje.
Potvrzení „Vyloučit z publikace“
Seznam vyloučených tabulek je uložen na hlavním uzlu. Synchronizace ho
nemění. Když se replika povýší na hlavní uzel (kapitola 8), seznam přejde na
nový hlavní uzel.
Ověřit (kapitola 5.10) ukáže vyloučenou tabulku jako „není publikována“,
ne jako nesoulad.
6.4. Zapnutí a vypnutí publikace
Na stránce Tabulky publikace: Vypnout publikaci /
Zapnout publikaci.
Vypnutí je volba operátora. Synchronizace publikaci znovu
nezapne.
Změny provedené, dokud je publikace vypnutá (nebo dokud je tabulka
vyloučena), se na repliku neodešlou, ani po zapnutí.
Po zapnutí klikněte na Ověřit (kapitola 5.10). Rozcházejí-li se data —
repliku reinicializujte (kapitola 5).
6.5. Nová tabulka
Nová tabulka se do publikace sama nedostane: uzel vypíná
automatické přidávání.
Po DDL:
Na tabulce vytvořte primární klíč nebo jedinečný index.
Klikněte na Synchronizovat publikaci.
Požádejte aplikace, aby se znovu připojily, je-li potřeba reinicializace. Firebird
do segmentů nezapisuje transakce, které začaly před zapnutím publikace;
COMMIT RETAINING takovou transakci nechává otevřenou. Inicializace na
takové transakce čeká a potom selže s reinit_pre_publication_transactions
(kapitola 5.4).
Nová tabulka ve stavu „ještě nepublikována“
Řádky zapsané do nové tabulky před synchronizací se na repliku nedostanou.
Jsou-li nějaké, zkontrolujte data a v případě potřeby repliku reinicializujte.
6.6. HQbird 2.5 a 3.0
HQbird 2.5 a 3.0 publikace nemají. Firebird zapisuje segmenty, pokud
soubor pluginu replconf obsahuje blok hlavního uzlu. Tlačítka publikace na takových uzlech jsou skrytá
a API odpovídá no_publications.
Sadu tabulek určují parametry enginu:
Parametr
Význam
include_filter
které tabulky replikovat: názvy nebo vzory oddělené čárkami; prázdné — všechny
exclude_filter
které tabulky nereplikovat
Parametry se mění v Nastavení → Parametry replikace (kapitola 7.1). Stránka
Tabulky publikace je ukazuje jen ke čtení, s odkazem Změnit
v nastavení enginu. Firebird nové hodnoty přečte po restartu.
Tabulky publikace na HQbird 3.0: filtry enginu
Plugin replconf. Uzel zapisuje vlastní soubor replconf.hqcluster.hqbird do
složky Firebird. Firebird ho čte, jen když na něj ukazuje replconf.properties.
Plugin je třeba jednou aktivovat:
Nastavení → Uzly, blok Replikační plugin (HQbird 2.5 / 3.0). Blok
ukazuje, kam replconf.properties ukazuje, a problémy, které uzel
našel.
Plugin není aktivován: replconf.properties ukazuje na soubor HQbird DataGuard
Aktivovat… Okno vypíše, co uzel udělá: nainstaluje plugin,
nasměruje replconf.properties na soubor uzlu, přenese položky starého souboru.
Zvolte kdy: Jen v okně restartu uzlu nebo Teď, bez ohledu na
okno restartu.
Okno aktivace pluginu
Po restartu Firebird pole Aktivováno ukazuje „ano: engine
čte soubor uzlu“.
Plugin aktivován
Aktivace restartuje Firebird a týká se všech databází tohoto Firebird.
Proveďte ji v klidné době.
Stránka Nastavení → Parametry replikace mění klíče v
replication.conf pro vybrané databáze nebo pro uzel jako celek.
Přidat hlavní uzel a repliky — vyberte databáze. RCM je seskupí podle
verze Firebird a role: samostatný formulář pro hlavní uzly a pro repliky.
U každého parametru zvolte akci:
Akce
Co dělá
beze změn
hodnota se nemění
nastavit hodnotu
nová hodnota
resetovat (na vyšší úroveň)
odebrat vlastní hodnotu, vzít hodnotu z úrovně nad ní
nezapisovat (hodnota Firebird)
klíč se nezapíše, platí hodnota Firebird
Zvolte, kam to použít: Na vybrané databáze nebo Jako výchozí
pro jejich uzly.
Náhled — uzly hodnoty zkontrolují, aniž by něco měnily.
Náhled změn
Použít. RCM pošle příkaz každému uzlu.
Odkud hodnota pochází (sloupec Aktuální):
Zdroj
Hodnota
tato databáze
nastaveno pro databázi
hodnota uzlu
nastaveno jako výchozí uzlu
vestavěná hodnota uzlu
hodnota uzlu z kódu
hodnota Firebird
klíč není zapsán
ze souboru (zde ještě nenastaveno)
hodnota z replication.conf, RCM ji ještě nezměnilo
nastaveno uzlem
jen ke čtení (cesty, předpony)
Uzel, který neodpovídá, ukáže své databáze jako nedostupné k výběru.
Změny vyžadují fbagent (jinak fbagent_required).
Kdo restartuje Firebird (Firebird čte replication.conf jen při
startu):
Uzel
Kdo
hlavní
restartujete vy: hlavní uzel Firebird sám nikdy nerestartuje
replika s firebird.auto_restart: never
vy
replika, jejíž Firebird obsluhuje i databáze hlavního uzlu
vy
ostatní repliky
uzel ho restartuje ve vlastním okně restartu
Pro ruční restart má stránka tlačítko Restartovat Firebird.
7.2. Hlavní parametry
Hlavní uzel, Firebird 4/5:
Parametr
Popisek v RCM
Hodnota uzlu
Firebird
Nápověda
journal_archive_timeout
Časový limit archivu
10 s
60 s
kolik sekund Firebird čeká, než zavře neúplný segment. Nižší — replika je blíž hlavnímu uzlu. Musí být menší než limits.data_check_quiet_sec (90)
journal_segment_count
Počet segmentů
64
8
kolik segmentů může být v .ReplLog. Musí být větší než limits.backlog_critical (48)
journal_segment_size
Velikost segmentu
—
16 MB
od 1 MB do 512 MB; příjemce nepřijme víc než 512 MB
buffer_size
—
1 MB
Uzel také zapisuje log_errors = true (nelze změnit) a
disable_on_error = true.
Replika, Firebird 4/5:
Parametr
Popisek v RCM
Firebird
Hodnota
apply_idle_timeout
Pauza při nečinnosti
10 s
pauza, když nejsou nové segmenty
apply_error_timeout
Pauza po chybě aplikace
60 s
pauza před opakováním po chybě
verbose_logging
uzel: true
podrobný replication.log; vypínat se nedoporučuje
skip_upddel_without_pk
uzel: true
přeskočit UPDATE/DELETE na tabulkách bez klíče
Jen Firebird 5: include_filter, exclude_filter, cascade_replication.
HQbird 2.5/3.0 — klíče log_* se stejným významem: log_archive_timeout,
log_segment_count, log_segment_size (ne méně než 2 × buffer_size). Klíč
alert_command se nastavuje jen v node.json.
Nápověda ke každému parametru je ve formuláři RCM.
7.3. Ukládání archivu
Archiv <database>.LogArch na hlavním uzlu se čistí po etapách:
Segmenty, které aplikovaly všechny repliky a které jsou starší než
retention_days.
Je-li volného místa méně než free_space_floor_gb — aplikované segmenty
mladší než doba uchování. Výstraha disk_serious_cleanup.
Je-li místa pořád málo — neaplikované segmenty, od nejstarších.
Replika dostane NEEDS_REINIT, výstraha
replication_paused_reinit_scheduled.
Parametr (Nastavení → Uzly, Úložiště a soubory)
Výchozí
limits.retention_days — Uchování archivu, dny
2
limits.retention_min_kept_segments — Vždy ponechat poslední segmenty
0 (vypnuto)
limits.free_space_floor_gb — Minimální volné místo
1 GB
Nastavení → Uzly, „Úložiště a soubory“
Vyčistit archiv ručně:
Command
hqbirdrcm cleanuparchive -node node-a # stages for all databases on the nodehqbirdrcm cleanuparchive -node node-a -db <db_id> # a single database
-orphaned (jen spolu s -db) smaže všechny segmenty databáze ve
stavu ORPHANED (kapitola 3.8). U jakékoli jiné databáze uzel odpoví not_orphaned.
Nikdy nespouštějte -orphaned na dárci povýšení (kapitola 8.5).
7.4. Přenos: komprese, rychlost, okna
Komprese se nastavuje na partnera: Nastavení → Uzly → Partneři, sloupec
compress.
Hodnota
Význam
prázdné nebo none
bez komprese (výchozí)
zstd
komprese zstd
Změna platí hned. Komprese je užitečná na pomalé síti.
Rychlost přenosu segmentů (Nastavení → Uzly, Přenos a
reinicializace):
Jednotka je mebibajt (MiB), i když název říká „mbps“. Špička nemůže být
menší než rychlost.
Nastavení → Uzly, „Přenos a reinicializace“
Časová okna (Časová okna):
Parametr
Výchozí
Kdy začne platit
Co ovlivňuje
windows.restart_window — Okno restartu Firebird
hlavní uzel 22:00-05:00, replika always
hned
kdy uzel repliky smí restartovat Firebird
windows.transfer_window — Okno přenosu
23:00-05:00
po restartu uzlu
plná rychlost inicializace (kapitola 5.5)
Popisek vedle každého pole ukazuje, kdy změna začne platit: hned nebo
restart uzlu.
Nastavení → Uzly, „Časová okna“
7.5. Ověření dat
Ověřit — jednorázové porovnání počtu řádků na hlavním uzlu a na replice
(kapitola 5.10).
Ověření dat — pravidelné porovnání (kapitola 5.10). Uzel porovnání provede,
když jsou hlavní uzel a replika na stejném segmentu.
S HQbird 2027.2.24 nastavení ověření platí hned po
Uložit; restart služby uzlu není potřeba. RCM zobrazí „Uloženo a už
platí“. Po zapnutí první ověření proběhne po jednom intervalu. Po
vypnutí se probíhající ověření přeruší a nic nezapíše. Nový
interval se počítá od konce posledního ověření. Uchovat, dny, Limit
dotazu, Klid a Generátor průběhu platí od dalšího
ověření.
Uzel 2027.5.7 tato nastavení čte jen při startu: po
Uložit restartujte službu hqclusternode na tomto uzlu. RCM
2027.2.24 zobrazí „Uloženo, ale ještě neplatí“ a uvede důvod.
Které tabulky porovnávat, určuje seznam tabulek databáze (kapitola 3.1). S HQbird
2027.2.24 může mít každá databáze vlastní seznam: pole při registraci nebo
blok Tabulky sledování synchronizace na stránce databáze hlavního uzlu
(kapitola 3.3). Stránka Ověření dat ukazuje, který seznam
byl použit, a počet tabulek „není v databázi“. V 2027.5.7 je seznam na uzel
(sync_tables).
Tabulky vyloučené z publikace se ukazují jako „není publikována“
(kapitola 6.3).
Stránka ověření dat
7.6. Výstrahy
Stránka výstrah
Stránka Výstrahy. Akce:
Potvrdit — výstraha zůstane viditelná, ale je označena potvrzeno;
Ztišit na 60 min — skrýt na hodinu;
Smazat / Smazat vše s tímto kódem — RCM předá smazání uzlu,
který výstrahu vyvolal. Zůstane-li příčina, výstraha se objeví znovu.
Command
hqbirdrcm clearalerts -code backlog_warn # also -id, -acked, -all
Od HQbird 2027.2.33 RCM posílá výstrahy do Telegramu, na webhook (Slack,
Teams, JSON) a e-mailem. Kanály se nastavují v sekci notify.channels
souboru rcm.json. Blok Kanály oznámení na
stránce Výstrahy kanály ukazuje a posílá zkušební zprávu. RCM hlásí
problémy úrovně warn a vyšší: problém se objevil, stal se vážnějším,
nebo byl zrušen. Bez kanálů RCM nic neposílá. Starší
verze odesílání nemají: sledujte stránku Výstrahy nebo se ptejte API RCM.
Hlavní kódy:
Kód
Význam
backlog_warn / backlog_critical
32 / 48 nearchivovaných segmentů v .ReplLog
disk_serious_cleanup
archiv se čistí ve 2. etapě (7.3)
replication_paused_reinit_scheduled
neaplikované segmenty smazány, je nutná inicializace
od HQbird 2027.2.30: Firebird minutu neodpověděl na připojení k databázi (zaseknutí). Patří sem i spojení, které se nestihlo navázat kvůli časovému limitu; firebird_down je jen odmítnutí spojení
master_publication_off
publikace je vypnutá (kapitola 6); od HQbird 2027.2.24 a po selhání publication_off (kapitola 6.1)
replica_removed_for_reinit
od HQbird 2027.2.24: replika smazala starou kopii kvůli inicializaci a nová kopie ještě není (kapitola 4.4)
orphaned_database
databáze mimo prohledání (kapitola 3.8)
restart_required_after_reinit
Firebird repliky potřebuje restart (kapitola 5.6)
data_mismatch
pravidelná kontrola našla nesoulad
license_paused
fbagent nemá licenci (kapitola 2.8)
7.7. Pozastavení odesílání
Na stránce Databáze, v řádku hlavního uzlu: Pozastavit odesílání /
Obnovit odesílání. Pro více databází — přes seznam Akce.
Potvrzení pozastavení odesíláníŘádek hlavního uzlu během pozastavení
Pozastavení platí do Obnovit odesílání nebo do inicializace.
Firebird hlavního uzlu dál zapisuje segmenty. Archiv .LogArch roste: dokud
je replika zastavená, 1. etapa (7.3) její segmenty nemaže.
Dlouhé pozastavení může dojít do 3. etapy a k NEEDS_REINIT. Sledujte místo.
Tlačítko chybí, nemá-li databáze repliku nebo je publikace vypnutá. Ikona
Pozastavení: bez licence znamená pozastavení kvůli licenci (kapitola 2.8); zruší ho
jen licence.
7.8. Protokoly
Protokol
Kde
Uzel
<instalační složka>/logs/node-YYYYMMDD.jsonl (/opt/hqclusternode nebo C:\hqclusternode), po 32 MB, 20 souborů
replication.log a firebird.log Firebird
cesty v node.json: firebird.replication_log, firebird.firebird_log
RCM
Linux: journalctl -u hqbirdrcm
Audit RCM
rcm-data/audit.jsonl
Vzdálený protokol uzlu — stránka Protokoly: vyberte uzel a zdroj
(replication.log, firebird.log, agent uzlu).
potřebujete samostatnou pracovní kopii: sestavy, testy, výpadek bez nového hlavního uzlu
běžná databáze mimo replikaci
Povýšit na hlavní uzel, 8.3
replika se má stát novým hlavním uzlem
databáze spravovaná uzlem společníkem s rolí hlavního uzlu
Ani jednu cestu nelze přes rozhraní vrátit zpět.
8.1. Převést na normální
Seznam „Akce“ repliky: položka „Převést na normální“
Databáze, strana repliky: zaškrtněte řádky repliky.
V seznamu Akce vyberte Převést na normální a potvrďte.
V řádku samostatné tlačítko není. Příkaz příkazového řádku také není.
Potvrzení „Převést na normální“
3. Uzel repliky:
- spustí `gfix -replica none` (HQbird 2.5/3.0: `gfix -replica {}`). Je-li
databáze zaneprázdněna aplikací segmentů, uzel ji na několik sekund uvede do
vypnutí `single` (`gfix -shut single -force 0`), zruší režim repliky a
vrátí ji pomocí `gfix -online normal`. **Všechna spojení k této databázi
se shodí**;
- zapíše soubor značky `.hqcluster-normal.json` (čas, autor, db_id,
GUID);
- začne čistit frontu `.Incoming` (8.2).
4. RCM ukáže databázi ve skupině **Není replika (normální)**.
Stránka „Databáze“ po „Převést na normální“
Potom je databáze otevřená pro zápis.
Odeberte blok repliky z replication.conf. Uzel ho odebere při dalším
prohledání a Firebird soubor čte při startu:
Do té doby se chyby „databáze není v režimu repliky“ u této databáze
nevyvolávají jako výstrahy.
Soubor značky databázi chrání. Inicializace takovou databázi nepřepíše:
odmítne se s target_not_replica (kapitola 5.9). Smazat jen značku nestačí:
uzel kontroluje i režim repliky v hlavičce databáze. Zaškrtnutí Smazat starou
repliku (kapitola 4.4) takovou databázi také nesmaže.
S HQbird 2027.2.24, dokud replika maže starou kopii této databáze kvůli
inicializaci, se Převést na normální odmítne s reclaim_in_progress:
zkuste později.
Má-li se databáze znovu stát replikou — jen nová inicializace s
přepsáním. Dělá se to přes API uzlu (overwrite_non_replica: true); v
RCM takové tlačítko není. Starý soubor se uloží jako
<database>.pre-reinit-<čas UTC>.fdb a značka se smaže.
8.2. Co se stane se segmenty
Dokud uzel databáze neprohledal, hlavní uzel dál posílá segmenty. Každých 30 sekund uzel repliky maže staré segmenty a ponechá jen posledních 100 (keep_segments).
Po prohledání dostane záznam databáze na replice stav ORPHANED. Uzel repliky hlavnímu uzlu odpoví unknown_database. Hlavní uzel přestane této replice posílat segmenty, přestane pro ni držet archiv a kontroluje ji každých 10 minut.
Ostatní repliky této databáze nejsou dotčeny.
Záznam ORPHANED lze smazat (kapitola 3.8): hqbirdrcm forgetdatabase. Samotný soubor databáze se nesmaže.
8.3. Povýšit na hlavní uzel
Replika se stane novým hlavním uzlem. Její soubor zůstane na místě a správa
přejde na uzel společníka.
Podmínky:
Podmínka
Odmítnutí
databáze je replika
bad_request
na stejném hostiteli běží uzel s rolí hlavního uzlu — společník (stejný popisek host v rcm.json, kapitola 2.1)
no_companion
povýšení této databáze ještě neprobíhá
already_running
neprobíhá inicializace do této databáze ani z jejího hlavního uzlu
reinit_running
RCM uzel společníka nevytváří: nainstalujte ho předem (kapitola 1).
Jak začít:
v řádku repliky Povýšit na hlavní uzel, nebo v seznamu Akce;
Kroky (viditelné v řádku repliky, názvy v angličtině):
Č.
Krok
Co dělá
1
TURN TO NORMAL
jako v 8.1; přeskočí se, je-li databáze už normální
2
NEW GUID
nové GUID databáze na místě (8.4)
3
EXCLUDE ON DONOR
uzel repliky (dárce) vyloučí soubor ze svého prohledání (exclude_paths)
4
ENROLL ON
uzel společníka soubor zaeviduje jako databázi hlavního uzlu
5
PUBLICATION SYNC
synchronizace publikace; seznam vyloučených tabulek se přenese ze starého hlavního uzlu (kapitola 6.3)
6
RESTART DONOR FIREBIRD
restart Firebird dárce, bez čekání na okno
7
RESTART FIREBIRD
restart Firebird společníka, bez čekání na okno
8
FINALIZE
řádek dárce se stane Replika duch; starý hlavní uzel se může stát Hlavní uzel degradován (8.5)
Kroky povýšení v řádku repliky
Na HQbird 2.5 a 3.0 publikace nejsou: krok PUBLICATION SYNC
skončí textem „tento engine publikaci nemá“.
Kroky povýšení na HQbird 3.0 (Windows)
Používají-li dárce a společník stejný Firebird, tento Firebird se
restartuje: spojení ke všem jeho databázím se shodí.
Selže-li krok, úloha dostane failed s textem chyby. Opravte
příčinu a klikněte znovu na Povýšit na hlavní uzel: dokončené kroky se
neopakují. Restartuje-li se RCM během povýšení, úloha se také stane
failed — zkontrolujte stav uzlů a zkuste znovu.
Licence. Nemá-li fbagent na hostiteli hlavního uzlu licenci, hlavní uzel
pozastavil odesílání. Povýšení je přesto možné. RCM vás upozorní:
změny provedené po začátku pozastavení se ztratí.
8.4. Nové GUID
Po povýšení musí databáze dostat vlastní GUID. Jinak nový hlavní uzel zapisuje
segmenty pod GUID starého hlavního uzlu a jeho repliky se odmítnou s
duplicate_guid.
Krok NEW GUID na uzlu:
gfix -shut single -force 0 — všechna spojení k databázi se ukončí;
nbackup -L, potom nbackup -F bez -SEQUENCE;
smaže <database>.delta;
zkontroluje hlavičku: nové GUID, REPLICATION_SEQUENCE = 0;
gfix -online normal.
Firebird se nerestartuje. Metoda funguje ve všech verzích (2.5, 3.0, 4.0,
5.0).
Byl-li krok přerušen, uzel vydá výstrahu newguid_interrupted. Databáze může
zůstat ve vypnutí single. Zopakujte Povýšit na hlavní uzel: krok
bude pokračovat.
Krok se přeskočí (text začíná skipped:), je-li uzel dárce stará
verze nebo soubor už má vlastní GUID.
Po novém GUID stará řada nbackup už nevyhovuje. Udělejte novou kopii nbackup úrovně 0.
Byla-li databáze vytvořena s ADD DIFFERENCE FILE, její .delta je jinde:
smažte ho ručně.
8.5. Po povýšení
Záznam dárce. Na uzlu repliky databáze zůstane ORPHANED, cesta zůstane v
exclude_paths a složka .Incoming i popisek zůstanou. V RCM je to řádek
Replika duch s tlačítky Otevřít na novém hlavním uzlu a Vymazat.
Řádek dárce: «Replika duch»
Chcete-li řádek odebrat, klikněte na Vymazat. Tím se změní jen RCM.
Chcete-li záznam dárce odebrat z uzlu repliky, spusťte forgetdatabase.
Soubor a složka .Incoming zůstanou. HQbird 2027.2.30 a novější příkaz
neodmítne (mailbox_active), protože cesta dárce je v
exclude_paths. Uzly starších verzí ho odmítnou, dokud jsou přítomny soubor a
složka .Incoming.
Na dárci nikdy nespouštějte cleanuparchive -orphaned. Dárce a
společník sdílejí stejnou složku <database>.LogArch. Příkaz smaže živý
archiv nového hlavního uzlu.
Starý hlavní uzel.
Byl-li dárce jeho poslední fungující replikou, RCM nastaví starý
hlavní uzel na Hlavní uzel degradován a pozastaví odesílání dárci
(„odesílání pozastaveno: … (povýšení na hlavní uzel)“). Odesílání
dárci neobnovujte: už drží pracovní databázi. Tento stav zrušíte,
když databázi inicializujete na jinou repliku.
Starý hlavní uzel: «Hlavní uzel degradován», odesílání pozastaveno
Inicializace ze starého hlavního uzlu na uzel dárce se odmítne
(target_not_replica): už drží pracovní databázi.
Byl-li krok NEW GUID přeskočen, starý a nový hlavní uzel mají stejné GUID.
V tom případě inicializace ze starého hlavního uzlu vyžaduje -force (kapitola 5.9).
Po ručním povýšení RCM ze starého hlavního uzlu neudělá repliku nového
hlavního uzlu. Zastavte aplikace na starém hlavním uzlu a jeho databázi odeberte ze
správy (kapitola 3.8). U databáze popsané jako služba to udělá Znovupřipojení
(8.7).
Nový hlavní uzel. Nastavte mu repliku: uzel repliky, partnery (kapitola 2),
publikaci (kapitola 6), inicializaci (kapitola 5).
Nový hlavní uzel: databáze s novým GUID, replika ještě není
8.6. Plánované přepnutí: kontrolní seznam
Toto je postup ručního přepnutí. U databáze popsané jako služba přepne hlavní uzel samo RCM (8.7). Ruční povýšení nekontroluje, zda aplikace zapisují na starý hlavní uzel. Postup:
Předem. Na hostiteli repliky běží uzel společník s rolí hlavního uzlu a oba uzly mají stejný popisek host (kapitola 2.1). Uzel pro budoucí repliku je pro nový hlavní uzel připraven.
Zastavte zápisy aplikací do databáze starého hlavního uzlu.
Počkejte, až replika vše přijme a aplikuje: Databáze → IN_SYNC, bez fronty.
Ověřit (kapitola 5.10): počty řádků se shodují.
Povýšit na hlavní uzel (8.3). Počkejte na krok FINALIZE.
Zkontrolujte: databáze je v seznamu hlavních uzlů společníka, publikace zapnutá.
Přepněte aplikace na nový hlavní uzel.
Udělejte kopii nbackup úrovně 0 nové databáze (8.4).
Vymažte záznam ducha u řádku dárce (8.5).
Připojte repliku k novému hlavnímu uzlu a inicializujte ji (kapitola 5).
Starý hlavní uzel: odeberte databázi ze správy nebo ji nechte jako archiv (8.5).
8.7. Služby: přepnutí a failover v RCM
S HQbird 2027.2.30 RCM samo přesune hlavní uzel na jiného hostitele. K tomu se databáze popisuje jako služba: jedna logická databáze na několika hostitelích. Na každém hostiteli služby je hlavní uzel a uzel repliky a cesta k souboru databáze je stejná. Služba se vytvoří na stránce Služby (od HQbird 2027.2.31) nebo příkazem hqbirdrcm services put -id <id> -file <file>.json.
Akce
Co dělá
Příkazy
Přepnutí
plánovaný přesun hlavního uzlu bez ztráty dat. Potom se starý hlavní uzel automaticky stane replikou nového
po failoveru vrátí starého hostitele jako repliku nového hlavního uzlu
hqbirdrcm rejoin -service <id>
Obnovit
vyvede službu ze stavu failed
hqbirdrcm resume -service <id> -check, potom hqbirdrcm resume -service <id>
Stejné akce jsou na stránce služby: tlačítka Přepnutí…, Failover…, Znovupřipojení… a Obnovit….
Automatický failover je ve výchozím stavu vypnutý. Zapíná se pro každou službu zvlášť:
hqbirdrcm policy -service <id> -auto-failover on -max-data-loss 30.
Vyžaduje směrovače. RCM spustí failover, jen když hlavní uzel mlčí, většina směrovačů nevidí Firebird hlavního uzlu a zpoždění repliky není větší než max_data_loss_sec.
Směrovač (hqclusternode router, Linux) drží HAProxy na aktuálním hlavním uzlu služby. Aplikace se připojují k <hostitel směrovače>:<router_port> a při přepnutí nemění připojovací řetězec.
Po failoveru RCM starý hlavní uzel odcloní (role fenced), jakmile znovu odpoví. Vraťte ho příkazem rejoin.
Tyto webové stránky používají cookies pro zlepšení vašeho zážitku a zapamatování preferencí.