HQbird 复制群集指南
HQbird 复制群集管理员指南:hqclusternode 与 hqbirdrcm(RCM)。安装程序:HQbird 2027 下载。
目录
- 0. 引言
- 1. 安装节点与 hqbirdrcm
- 2. 群集配置
- 3. 向主节点添加数据库
- 4. 如何把数据库做成副本:步骤与磁盘位置
- 5. 初始化(reinit)
- 6. 配置发布
- 7. 其他复制选项
- 8. 如何把副本转为普通数据库
0. 引言
本指南说明如何安装和使用 HQbird 复制群集:hqclusternode 节点,以及群集管理器 hqbirdrcm(RCM)。
这是给 Firebird 管理员的指南。假定你了解 Firebird、gfix 和 nbackup。不必了解节点的内部工作方式。
群集由什么组成
| 组件 | 数量 | 运行位置 | 作用 |
|---|---|---|---|
| Firebird(HQbird) | 一个或多个实例 | 每台数据库服务器上 | 存放数据库,写入复制段 |
| fbagent | 每个 Firebird 实例一个 | 与 Firebird 并列 | 按节点请求停止和启动 Firebird |
| hqclusternode(节点) | 每个实例与角色组合一个 | 与 Firebird 并列 | 配置复制、传输段、执行副本初始化 |
| hqbirdrcm(RCM) | 每个群集一个 | 能看到所有节点的任意主机 | Web 界面、命令、警报、统计 |
节点有 角色:master 或 replica。一个 Firebird 实例上可以运行两个节点:一个主节点和一个副本节点。此时这个 Firebird 的一部分数据库是主库,其余是副本。
工作方式
- 在主库上,Firebird 把数据库变更写入 段(复制日志文件)。
- 主节点通过受保护的通道(mTLS)把段发给副本节点。
- 副本节点把段放到传入段文件夹。副本上的 Firebird 把它们应用到数据库副本。
- 数据库的第一份副本由主节点自己传到副本。这称为 初始化(reinit)。它经过
nbackup,其间主库继续运行。 - 节点把统计发给 RCM。RCM 显示群集状态,并把操作员命令发给节点。

支持的版本
- Firebird / HQbird 5.0 和 4.0 — 全部功能。
- HQbird 3.0 和 2.5 — 通过 replconf 插件复制。没有发布;表集合由过滤器定义。差别写在“HQbird 2.5/3.0”框中。
主库和副本上的 Firebird 主版本必须一致。否则副本节点会拒绝初始化。
端口
| 端口 | 谁在监听 | 谁来连接 | 用途 |
|---|---|---|---|
7051 |
节点 | 其他节点和 RCM | 节点 API,传输段和数据库副本 |
7443 |
RCM | 所有节点 | 接收节点统计 |
7444 |
RCM | 操作员 | Web 界面和操作员 API。通过 RCM 安装(第 1.3 章):所有地址上的 HTTPS。通过 HQCenter Admin 或手动安装:HTTP,仅 127.0.0.1 |
7450–7459 |
fbagent,链接窗口打开期间 | RCM | 链接主机(第 1.3 章) |
13050 |
fbagent,仅 127.0.0.1 | 同一主机上的节点 | Firebird 管理 |
3050 |
Firebird | 应用程序 | 正常的数据库操作 |
一台主机上有两个节点(主节点和副本节点)时,第二个节点使用另一个端口。通过 RCM 安装时,第二个节点得到端口 7061。其他情况下自己设置端口,例如 7052。
不得把端口 13050 暴露到网络上。使用 HTTP 的端口 7444(通过 HQCenter Admin 或手动安装)也一样:通过 SSH 隧道连接 RCM Web 界面(第 1 章)。通过 RCM 安装时,端口 7444 走 HTTPS,安装程序会在防火墙上打开它。
主要规则:没有 fbagent 就不改配置
节点只通过 fbagent 更改复制配置:它需要重启 Firebird。如果 fbagent 不可用,节点会 拒绝 任何改变配置的操作。它不会“部分”工作。
术语
| 术语 | 含义 |
|---|---|
| 段 | 含有数据库变更的复制日志文件 |
| 发布 | 其变更进入段的主库表清单(Firebird 4/5) |
| 初始化(reinit) | 通过 nbackup 把数据库副本从主库传到副本 |
| 数据库 GUID | Firebird 数据库标识符;RCM 用它把主库和副本联系起来 |
| 对等方 | 伙伴节点:对主节点而言,是它的副本 |
| 伴随节点 | 同一 Firebird 实例上的另一个节点(一台主机上的主节点和副本节点) |
| 登记(Enroll) | 把主库数据库登记到节点 |
如何阅读本指南
| 章 | 主题 |
|---|---|
| 1. 安装 | 通过 HQCenter Admin、不经过 HQCenter Admin 的 RCM,以及手动安装节点和 RCM;Linux 与 Windows |
| 2. 群集配置 | 主节点 → 副本节点链接、节点设置、RCM 用户 |
| 3. 向主节点添加数据库 | 登记、重启 Firebird、核对 |
| 4. 如何把数据库做成副本 | 阶段、准备副本、磁盘空间 |
| 5. 初始化 | 重新初始化步骤、对运行的影响、长事务、速度、错误 |
| 6. 配置发布 | Firebird 4/5 发布、表、新表、HQbird 2.5/3.0 |
| 7. 其他复制选项 | replication.conf 参数、归档、传输、警报、暂停、日志 |
| 8. 把副本转为普通数据库 | 转为普通、提升为主节点、新 GUID、服务(切换、故障转移)、切换核对清单 |
各章使用同一个例子:
| 项目 | 值 |
|---|---|
node-a |
主节点,数据库在 /databases/master |
node-b |
副本节点,数据库在 /databases/replica |
| RCM | 单独的主机(也可以是某台数据库服务器) |
| 数据库 | employee.fdb |
1. 安装节点与 hqbirdrcm
有三种安装方法:
| 方法 | 何时选用 | 你自己要做的事 |
|---|---|---|
| 通过 HQCenter Admin(1.2) | 通常路径:能到达 HQCenter Admin 更新服务器,需要自动更新 | 运行 fbagent 安装脚本,批准请求,描述群集 |
| 通过 RCM,不用 HQCenter Admin(1.3) | 没有 HQCenter Admin,但仍要证书、配置和更新,而不做手工工作;最多 3 台数据库服务器 | 在每台主机上安装 HQbird,登录 RCM,在 设置 → 链接主机 中填写主机地址 |
| 手动(1.4) | 无法访问 HQCenter Admin、封闭网络、特殊要求 | 放置文件,创建证书,编写 node.json 和 rcm.json,注册服务 |
通过 HQCenter Admin 和通过 RCM 时,你 自己不安装 节点和 RCM。把 fbagent 加入群集时由它安装(第 2 章)。证书和配置也会自动创建。
Linux 和 Windows 写在同一章里。Windows 的差别在“在 Windows 上”框中。
1.1. 要求
每台数据库服务器上:
- Firebird / HQbird 5.0、4.0、3.0 或 2.5(2.5 仅 Linux)。
- 每个 Firebird 实例旁都有 fbagent。没有 fbagent,节点不能工作。
- 所有服务器和 RCM 主机上的时间同步(NTP、chrony、
w32time)。重启窗口和传输窗口、滞后估计以及“节点无响应”检查都依赖时钟。 - 段归档和副本初始化所需的空闲空间(第 4 章)。
- 按端口表配置的网络(第 0 章)。
Linux: root 权限、x86_64、systemd、curl。支持:Ubuntu 20–26、Debian 11–13、Astra、CentOS 7–10、AlmaLinux、Rocky、Oracle Linux 8–10、RED OS、openSUSE 15.6、Fedora 44+。
Windows: 管理员权限、x64、Windows 10 / Server 2016 或更新版本、64 位 Windows PowerShell 5.1。在 Windows 10 和 Server 2016–2022 上需要 7-Zip。
RCM 的运行位置。 每个群集需要一个 RCM。它可以装在能看到所有节点的任意服务器上,包括某台数据库服务器。
1.2. 通过 HQCenter Admin 安装
步骤 1. 运行 fbagent 安装脚本
脚本安装 Firebird(HQbird 构建)和 fbagent,并把 fbagent 注册到 HQCenter Admin 服务器。选择与 Firebird 版本匹配的脚本:fb25、fb30、fb40、fb50。
Linux(以 root 身份):
sudo sh fbagent-fb50_known.sh --goafts <HQCenter-Admin-server> --enroll --cluster在 Windows 上(以管理员身份运行 PowerShell):
powershell -NoProfile -ExecutionPolicy Bypass -File .\fbagent-fb50_known.ps1 -EnrollWindows 上没有 -Cluster 参数:fbagent 以 LocalSystem 运行,并自己创建群集文件夹。
主要参数:
| Linux | Windows | 含义 |
|---|---|---|
--goafts <name> |
-Goafts |
用来下载的 HQCenter Admin 服务器;名称由供应商提供 |
--enroll |
-Enroll |
在 HQCenter Admin 中注册 fbagent(证书请求) |
--cluster |
— | 创建 /opt/hqclusternode 和 /opt/hqbirdrcm 文件夹(仅 fbagent 2.55.2 及更早需要;较新版本无害) |
--channel |
-Channel |
fbagent 更新通道,默认 stable |
--token |
-Token |
许可证令牌:HQCenter Admin 将自动批准请求 |
--port |
-Port |
Firebird 端口 |
--yes |
-Yes |
不提问(没有终端时需要) |
完整参数列表见 fbagent 安装脚本的 README。
步骤 2. 批准 fbagent 请求
带 --enroll 参数时,fbagent 向 HQCenter Admin 发送证书请求(CSR),并最多等待 30 分钟批准。可以这样批准:
- 自动 — 安装时使用了许可证令牌(
--token),并且许可证有空闲席位; - 在 HQCenter Admin 面板中 — CSR 请求一节,这台主机的请求,批准并签名按钮;
- 通过 HQCenter Admin API —
POST /v1/admin/csr-requests/{id}/approve。
如果注册没有成功(例如等待时间用尽),fbagent 仍然工作,但脚本以代码 2 退出。用相同参数再次运行脚本:只会重复注册。
注册几分钟后,fbagent 会自己安装 HQ Monitor。
步骤 3. 描述群集
把 fbagent 加入 HQCenter Admin 群集后,节点和 RCM 才会出现。如何描述群集见 第 2 章。
保存群集之后:
- 10 分钟内 fbagent 从 HQCenter Admin 收到群集(之后每 60 秒检查一次变更)。
- RCM 主机上的 fbagent 创建群集证书颁发机构(CA),并为所有节点的证书签名。
- 每个 fbagent 为自己的群集成员写入
node.json或rcm.json。 - 在下一次产品检查(每 3 分钟)时,fbagent 安装并启动服务。
安装内容和位置:
| 内容 | Linux | Windows |
|---|---|---|
| 主节点 | /opt/hqclusternode/master/,服务 hqclusternode-master-p<port> |
<HQbird>\hqclusternode\master\,服务 HQClusterNode-master-p<port> |
| 副本节点 | /opt/hqclusternode/replica/,服务 hqclusternode-replica-p<port> |
<HQbird>\hqclusternode\replica\,服务 HQClusterNode-replica-p<port> |
| RCM | /opt/hqbirdrcm/,服务 hqbirdrcm |
<HQbird>\hqbirdrcm\,服务 hqbirdrcm |
<port> 是 Firebird 端口,例如 3050。一个 fbagent 最多托管一个主节点、一个副本节点、一个 RCM 和一个路由器(hqclusternode router,自 HQbird 2027.2.30 起,第 8.7 章)。
在 Windows 上。 2.83.0 之前的 fbagent 把节点装在
C:\hqclusternode,把 RCM 装在C:\hqbirdrcm。如果这些文件夹存在,fbagent 会继续使用它们。
更新
- fbagent 每 3 分钟检查节点和 RCM 的新版本;默认通道是
stable。先更新副本节点,再更新主节点。 - 如果更新后服务无法启动或报告了错误的版本,fbagent 会回退到上一版本并 阻止 新版本。阻止列表:
<fbagent folder>/update/<product>/blocked-versions.json。要再次尝试该版本,从该文件中删除对应行。 - 产品状态:
fbagent --product-status hqclusternode(或hqbirdrcm)。
1.3. 通过 RCM 安装(不用 HQCenter Admin)
群集由 RCM 管理。每台主机的 fbagent 从 RCM 接收群集描述,RCM 主机上的 fbagent 为证书签名,节点和 RCM 从 RCM 保存的发行版更新。
限制:
- 每个 RCM 一个群集。
- 不超过 3 个席位。席位是运行主节点或副本节点的主机。同一主机上的主节点和副本节点算一个席位。只运行 RCM 的主机不占席位。第四台主机会产生错误
seats_exceeded。 - RCM 不更新 fbagent 或 Firebird。fbagent 自己更新它们,并且不触碰
replication.conf、node.json、rcm.json或证书。
有两种方法:
- 在 RCM 中链接主机 — 通常方法。三个动作:在每台主机上运行安装程序(一台主机上是 RCM,其余是发现模式),登录 RCM,填写 链接主机 表单。
- 从命令行手动进行 — 加入令牌和
fbagent --cluster-join。当主机之间的端口7450关闭,或配对窗口已经关闭时需要。
许可证。 试用许可证包含 cluster 功能。试用期结束后,如果许可证没有 cluster,fbagent 不会安装 节点或 RCM。它从不阻止已安装节点和 RCM 的更新。没有 HQCenter Admin 时,浮动许可证在 online_check_days 加上宽限天数之后停止工作。因此在每个 fbagent 上安装 绑定 许可证:
fbagent --license-request --out license_request.json
# send the file to the vendor and receive license.json
fbagent --license-install license.json
没有许可证时,主节点停止发送段(第 2.8 章)。
端口:
| 端口 | 位置 | 谁来连接 |
|---|---|---|
7443 |
RCM 主机 | 所有群集主机的 fbagent 和节点 |
7444 |
RCM 主机 | 操作员的浏览器(RCM 控制台,HTTPS) |
7450(第二台及以后的 fbagent 主机为 7451…7459) |
处于发现模式的主机,配对窗口打开期间 | RCM 主机上的 RCM |
7051(同一 fbagent 的第二个节点为 7061) |
节点主机 | 其他节点和 RCM(1.4,步骤 7) |
在 RCM 中链接主机
从零开始的例子。 两台 Linux 服务器、
.run安装程序、链接、登记、发布、负载下的初始化和重新初始化,附有截图和测量:指南hqbird2027-linux-cluster-guide.ru.md和运行手册hqbird2027-linux-cluster-runbook.ru.md(goafts 仓库,documentation 文件夹)。
步骤 1. 在每台主机上安装 HQbird
在每台数据库服务器上用 完整安装程序 安装 HQbird。不要向 HQCenter Admin 注册(--enroll)。
默认情况下安装程序不配置群集。 它把节点和 RCM 程序放到 fbagent 文件夹(update/<product>/staged/),但不安装 RCM,不打开配对窗口,也不在防火墙中打开群集端口。群集由两个参数启用:
sudo sh hqbird2027-fb50-linux-<version>.run --rcm on               # RCM host
sudo sh hqbird2027-fb50-linux-<version>.run --cluster-pairing on   # other hosts
--rcm on — 在将运行本群集 RCM 的那一台主机上。安装程序:
- 创建这台主机的群集(
fbagent --cluster-init),群集名是主机名; - 安装并启动 RCM,RCM 控制台通过 HTTPS 在端口
7444上运行; - 创建第一个 RCM 管理员
rcmadmin,密码随机; - 在防火墙中打开端口
7443、7444和节点端口7051。
--cluster-pairing on(发现模式)— 在其余每台主机上。安装程序把 fbagent 的 配对窗口 打开 24 小时:端口 7450 和节点端口 7051。窗口打开期间,网络上的 RCM 可以把这台主机邀请进自己的群集。fbagent 在一分钟内开始在端口 7450 上监听。
没有这些参数时,安装程序会自己询问:文本界面中这是 群集 页,带 --no-tui 时是两个问题。默认回答是“否”。没有群集参数的 --yes 也会对两个问题回答“否”。
最后安装程序打印 RCM: 和 Pairing: 行。在 RCM 主机上:
RCM:        https://10.0.0.7:7444 (cluster db1)
CA hash:    sha256:7cfc1d4b…032d2582
Login:      rcmadmin
Password:   in /opt/hqbird/fbagent-fb50/clusterca/db1/rcm-initial-password (read it with sudo; RCM asks for a new one at the first login)
Pairing:    not needed: this agent runs the RCM; other agents link through it
在另一台主机上:
RCM:        off; turn it on in HQbird Monitor or with fbagent --cluster-init <id>
Pairing:    port 7450 open until 2026-11-17T17:49:18Z (fingerprint sha256:0439e44a…91a2f9b9); an RCM may invite this host
输出中没有密码:它在 Password: 行所指的文件里。记下处于发现模式的每台主机的 fingerprint。
Linux 安装程序中的群集参数:
| 参数 | 作用 |
|---|---|
--rcm on|off |
在这台主机上安装 RCM 并创建群集;默认 off |
--cluster-pairing on|off |
发现模式:打开 24 小时配对窗口;默认 off |
--pairing-port N |
新 fbagent 的配对端口,7450–7459;默认第一个空闲端口 |
--rcm-password-file F |
用文件 F 的第一行作为 RCM 管理员密码,代替随机密码 |
--cluster-id ID |
用群集名 ID 代替主机名(与 --rcm on 一起) |
--cluster-node on|off |
安装节点程序;默认 on |
--rcm-allow A,B |
只有这些 RCM 可以邀请这台主机:地址、CIDR 网络或名称 |
主机上的第一个 fbagent 得到配对端口 7450 以及节点端口 7051 和 7061。同一主机上的第二个实例是 7451、7052 和 7062。
RCM 和配对窗口可以事后启用,不必重跑安装程序:在 HQ Monitor 的 群集 页,或以 fbagent 用户执行命令:
cd <fbagent folder>                                    # /opt/hqbird/fbagent-fb50
sudo -u firebird ./fbagent --cluster-init <name>      # RCM host; open ports 7443 and 7444 yourself
sudo -u firebird ./fbagent --cluster-pairing on      # window for 24 hours
sudo -u firebird ./fbagent --cluster-pairing off
sudo -u firebird ./fbagent --cluster-pairing status旧安装程序(fbagent 3.1.0 之前)不问群集:它们在每台主机上安装 RCM,并到处打开配对窗口。你只需要一台主机的 RCM;其他主机的 RCM 会在链接后自己停止。
在 Windows 上。 Windows 安装程序里也有同样的两个选择:参数
/RCM和/DISCOVERY。
步骤 2. 登录 RCM
打开 RCM 主机 RCM: 行中的地址(https://<host>:7444)。用登录名 rcmadmin 和 Password: 行所指文件中的密码登录。RCM 会立刻要求新密码(1.5)。
步骤 3. 链接主机
在 RCM 中打开 设置 → 链接主机。
- 在 主机 字段中输入主机地址或名称,每行一个。第一行是 RCM 主机,它已经在群集中。
- 单击 检查主机。RCM 探测每台主机的配对端口
7450–7459,并显示平台、Firebird 版本、指纹和状态。RCM 主机不需要配对窗口。把指纹与安装程序输出(Pairing:行)比较。 - 选择 主节点(默认第一台主机)并单击 链接。
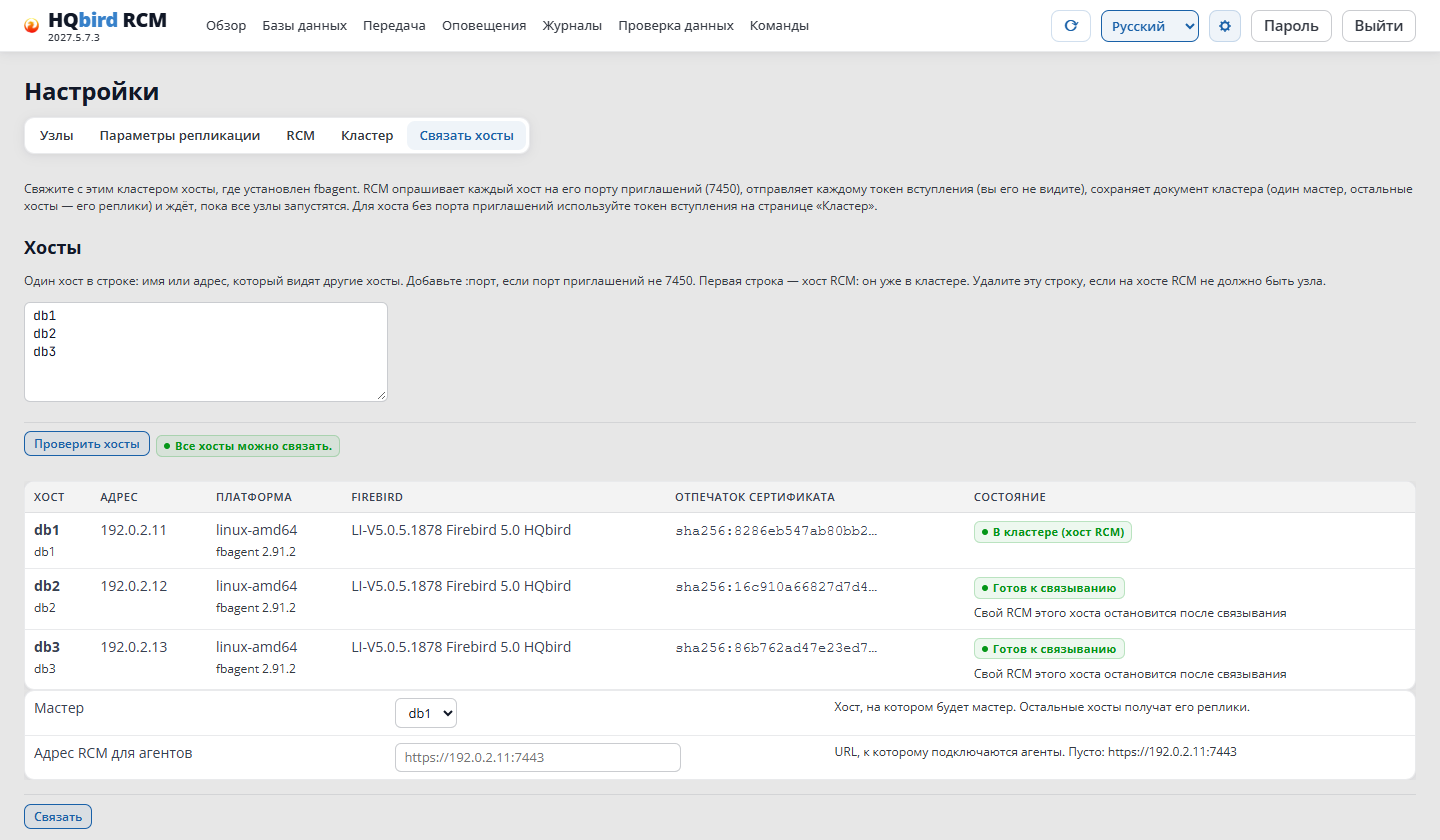
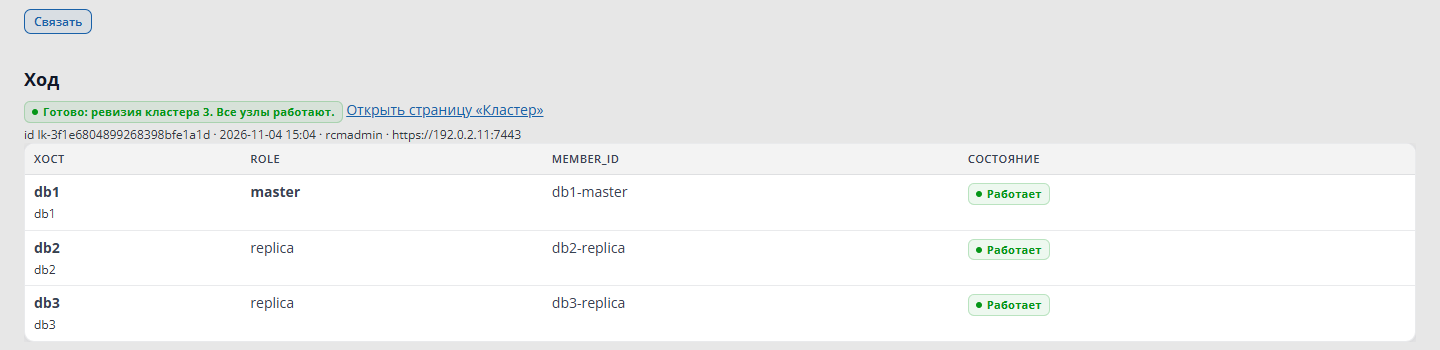
RCM 要求确认,并在 进度 一节显示进度。所有节点都在运行时,它显示“完成”,并给出群集修订号:
命令行上同样可以做:
cd /opt/hqbirdrcm
export RCM_USER=rcmadmin RCM_PASSWORD='<password>'
./hqbirdrcm cluster link -hosts db1,db2,db3 -master db1
随后发生的事:
- RCM 向每台空闲主机发送邀请。
- 主机的 fbagent 加入群集并关闭配对端口。如果主机有自己的、没有节点的 RCM,fbagent 会停止并禁用它,并把空群集移到 fbagent 文件夹的
cluster/left/。 - RCM 保存群集:主节点上是节点
<host>-master,其他主机上是<host>-replica,端口7051,主节点 → 副本节点链接。 - 每台主机的 fbagent 安装并启动节点。RCM 等到所有节点都在运行,并为每台主机显示 正在运行。
检查主机 之后的主机状态:
| 状态 | 做什么 |
|---|---|
| 可以链接 | 什么都不用做。如果下面写着“此主机自己的 RCM 将在链接后停止”——这是正常的 |
| 已在群集中 | 主机已经在这个群集里 |
错误 unreachable |
端口 7450 关闭:配对窗口是关的(默认如此)或 24 小时已过。刚安装后等一分钟再单击 检查主机。否则打开窗口(--cluster-pairing on)并检查防火墙 |
错误 in_other_cluster |
主机在另一个群集中 |
错误 claimed |
另一个 RCM 正在链接这台主机 |
错误 seats_exceeded |
超过 3 个席位 |
发行版。 fbagent 只从 RCM 安装节点。RCM 在启动时以及每 5 分钟从 rcm.json 旁边的 import/ 文件夹取出已签名的发行版。安装程序把 RCM 主机的发行版放在那里,其他主机的 fbagent 自己下载本平台的发行版。发行版列表在 链接主机 页底部。也可以手动导入发行版(下面的步骤 5)。
从命令行手动进行
顺序:在 RCM 主机上做步骤 1–3,在其他每台主机上做步骤 4,在 RCM 中做步骤 5–6。
步骤 1. 安装带 fbagent 的 HQbird
在每台数据库服务器和 RCM 主机上用 完整安装程序 安装 HQbird。在 RCM 主机上可以马上指定 --rcm on(这样就不需要步骤 3)。其他主机不要指定群集参数:默认没有 RCM,也没有配对窗口。不要向 HQCenter Admin 注册(--enroll)。
在 RCM 主机上,安装程序把 RCM 程序留在 fbagent 文件夹(update/hqbirdrcm/staged/)。没有它,步骤 3 会以错误 no hqbirdrcm to install 失败。
步骤 2. 安装绑定许可证
与本节开头“许可证”相同。
步骤 3. 在 RCM 主机上创建群集
如果安装程序已经创建了群集(--rcm on:输出中有带地址的 RCM: 行),跳过此步骤。
以 fbagent 用户运行命令(Linux 上是 firebird),不要以 root 运行:否则 CA 文件和 rcm.json 的所有者会是 root。
cd <fbagent folder>
sudo -u firebird ./fbagent --cluster-init shop-prod --address 10.0.0.7
在 Windows 上(以管理员身份运行 PowerShell):
.\fbagent.exe --cluster-init shop-prod --address 10.0.0.7
shop-prod— 群集名称:小写拉丁字母、数字和-。--address— 其他主机用来连接 RCM 主机的地址。可以重复多次。没有该参数时,使用主机的地址和名称。
该命令:
- 创建群集 CA 和代理 CA(在 fbagent 文件夹的
clusterca/<name>/); - 把 RCM 证书、
rcm.json和cluster-init.json写到 RCM 文件夹; - 安装 RCM 并注册
hqbirdrcm服务。在 Linux 上该服务以单独用户hqbirdrcm运行; - 把 fbagent 切换到 RCM(
cluster.source = rcm)并重启它; - 打印 RCM 地址和 CA 指纹:
Cluster:    shop-prod
RCM URL:    https://10.0.0.7:7443
CA hash:    sha256:9f86d0...
记下 RCM URL 和 CA hash:其他主机需要它们。对同一群集再次运行是安全的:CA 和密钥保持不变。
立即登录 RCM 并更改 rcmadmin 密码(1.5)。
在 Linux 上。 用户
hqbirdrcm在 fbagent 组中。RCM 通过这个组读取rcm.json,但不能写它。因此 设置 → RCM 不保存更改(错误rcm_config_read_only)。在主机上以 fbagent 用户编辑rcm.json并重启 RCM。
步骤 4. 连接其他主机的 fbagent
-
在 RCM 主机上为每个 fbagent 创建 加入令牌:在 RCM 的 设置 → 群集 中,单击 创建加入令牌。或从命令行:
cd /opt/hqbirdrcm
export RCM_USER=rcmadmin RCM_PASSWORD='<password>'
./hqbirdrcm cluster join-token -note db2
令牌有效 24 小时,只给一个 fbagent,并且只能用一次。RCM 只显示一次,并附上现成的命令。
-
在节点主机上以 fbagent 用户运行该命令:
cd <fbagent folder>
sudo -u firebird ./fbagent --cluster-join https://10.0.0.7:7443 \
  --ca-hash sha256:9f86d0... --token-file token.txt
可以用
--token <token>代替--token-file。在 Windows 上,以管理员身份在 PowerShell 中用.\fbagent.exe做同样的事。
fbagent 按指纹验证 RCM CA。如果指纹不匹配,它停止并且什么都不写。然后 fbagent 收到自己的证书(90 天,自动续期)并重启。已连接的 fbagent 出现在 RCM 的 代理 表中。在它还没有成员时,主机上不会安装任何东西。
步骤 5. 把发行版导入 RCM
fbagent 只从 RCM 取得节点和 RCM。如果所需发行版不在 镜像中的发行版 列表(设置 → 链接主机)中,为你的主机的每个平台(linux-amd64、windows-amd64)导入每个产品(hqclusternode、hqbirdrcm)。发行版文件和 .sig 签名由供应商提供。
cd /opt/hqbirdrcm
sudo -u hqbirdrcm ./hqbirdrcm release import -config rcm.json \
  -file hqclusternode-linux-amd64 -product hqclusternode \
  -platform linux-amd64 -version 2027.5.12
sudo -u hqbirdrcm ./hqbirdrcm release list -config rcm.json- RCM 在
<file>.sig中查找签名,也可以用-sig指定。没有有效的供应商签名,RCM 不接受文件。 - 新发行版替换上一个。不需要重启 RCM。
- fbagent 每 3 分钟检查新版本。更新顺序和锁定与通过 HQCenter Admin 时相同(1.2,“更新”)。
步骤 6. 描述群集
在 RCM 的 设置 → 群集 中设置成员和链接(第 2.3 章)。保存后,fbagent 以与通过 HQCenter Admin 相同的方式安装节点(1.2,步骤 3):写入证书、node.json 和 rcm.json,安装并启动服务。
端口见本节开头。
1.4. 手动安装
步骤 1. 安装带 fbagent 的 HQbird
在每台数据库服务器上安装 HQbird(用同一脚本,但不带 --enroll,或用完整的 HQbird 安装程序)。确认 fbagent 正在运行。
从 fbagent 的 agent_config.json 记下三个值。node.json 需要它们:
| fbagent 字段 | node.json 字段 |
示例 |
|---|---|---|
local_api.listen |
firebird.fbagent_url |
http://127.0.0.1:13050 |
local_api.token |
firebird.fbagent_token |
— |
local_api.instance_id |
firebird.instance_id |
— |
检查 fbagent(响应是 Firebird 实例的 JSON):
curl -s -H "Authorization: Bearer <token>" http://127.0.0.1:13050/v1/instances/<instance_id>如果主机上有多个 HQbird 实例,在 fbagent 配置的 firebird.update.services 中只保留你这个实例的服务(见 3.5)。
步骤 2. 放置文件
Linux:
/opt/hqclusternode/
  hqclusternode        # program
  node.json            # node configuration (permissions 0600)
  certs/               # ca.crt, <node_id>.crt, <node_id>.key
  work/                # working folder
/opt/hqbirdrcm/
  hqbirdrcm            # program
  rcm.json             # cluster configuration
  certs/               # ca.crt, rcm.crt, rcm.key
rcm-data/ # state, users, audit logsudo mkdir -p /opt/hqclusternode/certs /opt/hqclusternode/work
sudo install -m 0755 hqclusternode-linux-amd64 /opt/hqclusternode/hqclusternode
# on the RCM host:
sudo mkdir -p /opt/hqbirdrcm/certs /opt/hqbirdrcm/rcm-data
sudo install -m 0755 hqbirdrcm-linux-amd64 /opt/hqbirdrcm/hqbirdrcm在 Windows 上。 默认文件夹是
C:\hqclusternode,布局相同。 路径中可以有空格。
一台主机上有两个节点(主节点和副本节点)时,给每个节点自己的文件夹,例如 /opt/hqclusternode/master 和 /opt/hqclusternode/replica。
步骤 3. 创建证书
节点和 RCM 只通过 mTLS 通信。需要一个 CA,以及每个参与者的证书。在任意一台机器上 只运行一次:
./hqclusternode gencerts -out certs \
  -nodes 'node-a:master,node-b:replica' \
  -hosts 'localhost,127.0.0.1,<ip-node-a>,<ip-node-b>,<ip-rcm>'
该命令创建 ca.crt 和 ca.key、node-a.crt/.key、node-b.crt/.key 以及 rcm.crt/.key。在 -hosts 中列出连接各参与者时会用到的全部名称和地址。
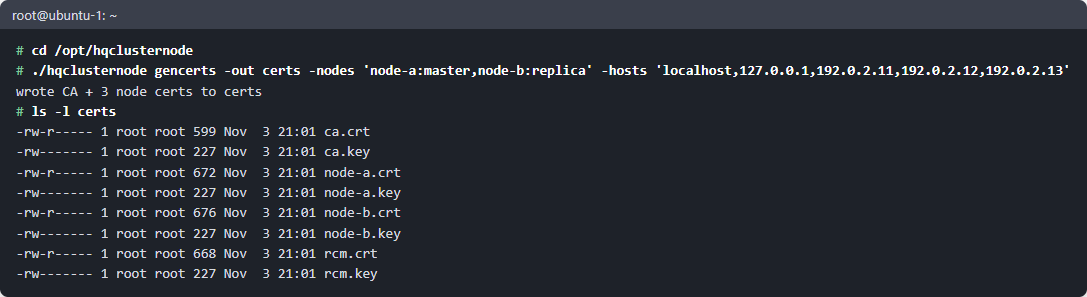
ca.key 是 CA 密钥。不要把它复制到各主机上;单独保管。
以后用 -add 添加新节点:它用同一个 CA 签发这对文件,其余文件保持不变:
./hqclusternode gencerts -out certs -add -nodes 'node-c:replica' -hosts '<ip-node-c>'证书有效期 90 天。gencerts -out certs -list 显示到期日,gencerts -out certs -renew 用同一密钥续期。把新的 .crt 复制到对应主机:节点不用重启就会采用它。
把 ca.crt 以及 仅其自己的 证书和密钥复制到每台主机。
步骤 4. 编写 node.json
每个节点一个文件。主节点(node-a)的示例:
{
  "node_id": "node-a",
  "role": "master",
  "listen_addr": ":7051",
  "rcm": { "url": "https://<ip-rcm>:7443", "ca_cert": "certs/ca.crt",
           "client_cert": "certs/node-a.crt", "client_key": "certs/node-a.key" },
  "firebird": {
    "root": "/opt/firebird",
    "user": "SYSDBA",
    "password": "<SYSDBA password>",
    "port": 3050,
    "replication_conf": "/opt/firebird/replication.conf",
    "replication_log": "/opt/firebird/replication.log",
    "firebird_log": "/opt/firebird/firebird.log",
    "fbagent_url": "http://127.0.0.1:13050",
    "fbagent_token": "<local_api.token>",
    "instance_id": "<local_api.instance_id>",
    "service_name": "<Firebird service name>"
  },
  "windows": { "restart_window": "22:00-05:00", "transfer_window": "23:00-05:00" },
  "peers": [ { "node_id": "node-b", "url": "https://<ip-node-b>:7051", "compress": "zstd" } ]
}副本节点(node-b)的文件相同,但 "role": "replica",用自己的证书,并且 peers 中是主节点 node-a。
主要字段:
| 字段 | 值 |
|---|---|
node_id |
节点名称;证书、rcm.json 以及其他节点的 peers 中必须相同 |
role |
master 或 replica |
listen_addr |
节点 API 地址;同一主机上的第二个节点使用另一个端口(:7052) |
rcm.url |
接收 RCM 统计的地址;none — 没有 RCM |
firebird.* |
本实例的 Firebird 和 fbagent;fbagent 的值必须 完全一致 |
firebird.auto_restart |
副本节点是否可以自己重启 Firebird:auto(默认)、never、always |
windows.restart_window |
Firebird 重启窗口;主节点默认 22:00-05:00,副本始终可以 |
windows.transfer_window |
初始化全速运行的窗口 |
peers |
对主节点是它的副本,对副本是它的主节点 |
databases |
数据库文件夹;最好不要手写,而通过 RCM 设置(第 3 章) |
其余字段有默认值。如果没有设置 fbagent 字段,节点不会启动。
保护该文件:它含有密码和令牌。
chmod 600 /opt/hqclusternode/node.json在 Windows 上。 用 JSON 格式写路径:
"C:\\HQbird\\replication.conf"。service_name是 Firebird 的 Windows 服务名。
步骤 5. 编写 rcm.json
{
  "ingest_addr": "0.0.0.0:7443",
  "operator_addr": "127.0.0.1:7444",
  "users_file": "rcm-data/users.json",
  "data_dir": "./rcm-data",
  "tls": { "ca_cert": "certs/ca.crt", "cert": "certs/rcm.crt", "key": "certs/rcm.key" },
  "nodes": [
    { "node_id": "node-a", "url": "https://<ip-node-a>:7051", "role": "master",  "host": "A" },
    { "node_id": "node-b", "url": "https://<ip-node-b>:7051", "role": "replica", "host": "B" }
  ]
}url— RCM 主机看到的节点地址。只能是https。host— Firebird 实例标签。标签相同的主节点和副本节点运行在同一个 Firebird 上(伴随节点,把副本提升为主节点时需要,第 8 章)。一个标签最多一个主节点和一个副本节点。- 相对路径从
rcm.json所在文件夹解析。
步骤 6. 注册服务
启动顺序: 先 RCM,再副本,再主节点。
RCM(Linux):
cd /opt/hqbirdrcm
sudo ./hqbirdrcm svc install -config /opt/hqbirdrcm/rcm.json
sudo ./hqbirdrcm svc start
节点(Linux):
cd /opt/hqclusternode
sudo ./hqclusternode svc install -config /opt/hqclusternode/node.json -certs /opt/hqclusternode/certs
sudo ./hqclusternode svc start -config /opt/hqclusternode/node.json
systemctl status hqclusternode-master-p3050
svc install 创建以用户 firebird 运行的服务 hqclusternode-<role>-p<port>。如果 Firebird 文件夹属于 root,该命令会授予 firebird 组对该文件夹的写权限(带粘滞位),并打印每一处更改:节点需要替换 replication.conf。
对于 svc start、svc stop 和 svc uninstall,指定同一个 node.json:服务名由角色和 Firebird 端口得出。
在 Windows 上(以管理员身份运行 PowerShell):
cd C:\hqclusternode
.\hqclusternode.exe svc install -config C:\hqclusternode\node.json -certs C:\hqclusternode\certs
服务
HQClusterNode-<role>-p<port>以 LocalSystem 运行,自动启动,失败后会重启。节点服务 不依赖 Firebird 服务。如果节点是用 2027.1.2–2027.1.9 安装的,一次性去掉依赖:.\hqclusternode.exe svc fix-deps -config C:\hqclusternode\node.json。
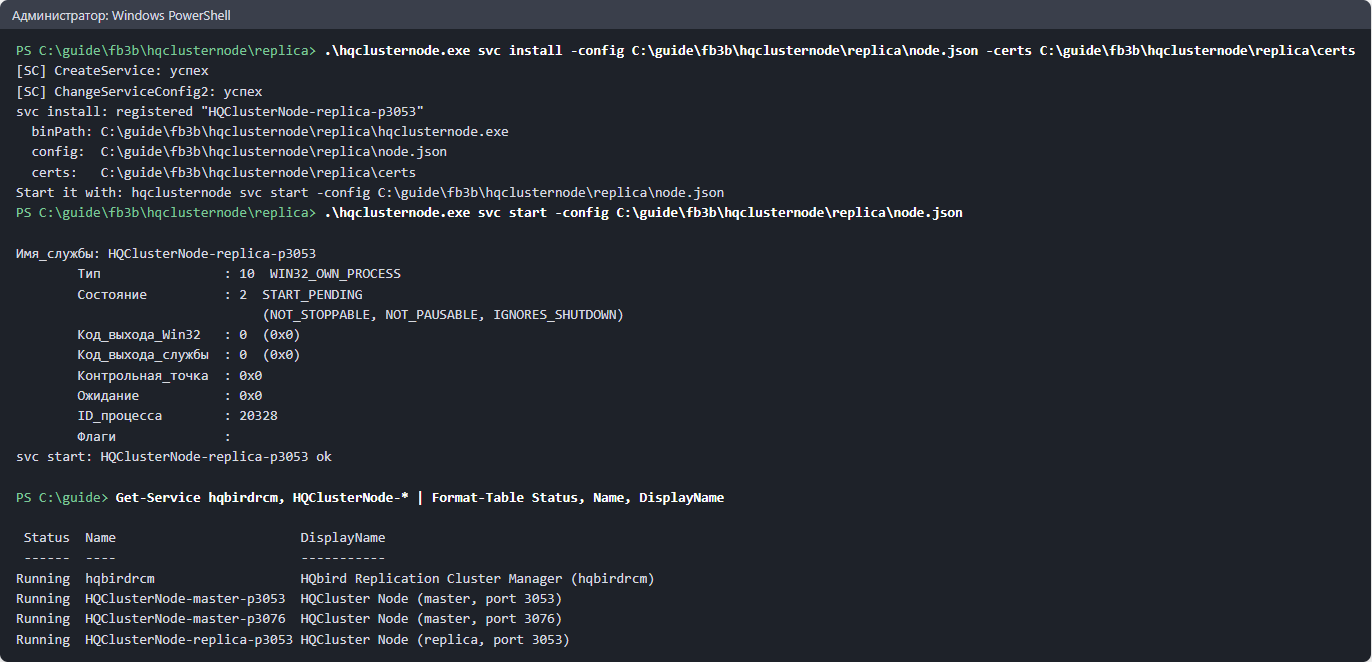
步骤 7. 打开端口
在节点主机上,允许其他节点和 RCM 入站连接 7051(listen_addr 端口)。在 RCM 主机上,允许所有节点入站连接 7443。不要把端口 7444 和 13050 暴露到外部。
节点主机上的 ufw 示例:
sudo ufw allow from <ip-rcm> to any port 7051 proto tcp
sudo ufw allow from <ip-partner-node> to any port 7051 proto tcp
手动更新
停止服务,替换程序,启动服务:
sudo systemctl stop hqclusternode-master-p3050
sudo install -m 0755 hqclusternode-linux-amd64 /opt/hqclusternode/hqclusternode
sudo systemctl start hqclusternode-master-p3050
这样做不会更改配置和证书。
1.5. 首次登录 RCM
地址和密码取决于 RCM 的安装方式。
| RCM 的安装方式 | 地址 | 登录名和密码 |
|---|---|---|
由 HQbird 安装程序或 fbagent --cluster-init(1.3) |
任意计算机上的 https://<RCM host>:7444 |
rcmadmin 以及安装程序打印的密码(或 --rcm-password-file 中你自己的密码) |
| 通过 HQCenter Admin(1.2)或手动(1.4) | http://127.0.0.1:7444,仅在 RCM 主机上 |
rcmadmin,密码 strong password(含空格) |
HTTPS(1.3)。 RCM 证书由群集 CA 签名,浏览器不认识它,因此会警告。在登录页上 RCM 显示 CA 指纹。把它与安装程序打印的 CA hash 比较,并把 CA 作为受信任根导入浏览器或系统:登录页上的 下载 CA 证书 链接(https://<RCM host>:7444/ca.crt,文件 hqcluster-ca.crt)。要让 RCM 只在 localhost 上监听,在 rcm.json 中设置 "operator_addr": "127.0.0.1:7444" 并重启 RCM。
HTTP(1.2、1.4)。 从另一台计算机通过 SSH 隧道连接:
ssh -L 7444:127.0.0.1:7444 <rcm-host>然后在浏览器中打开 http://127.0.0.1:7444。
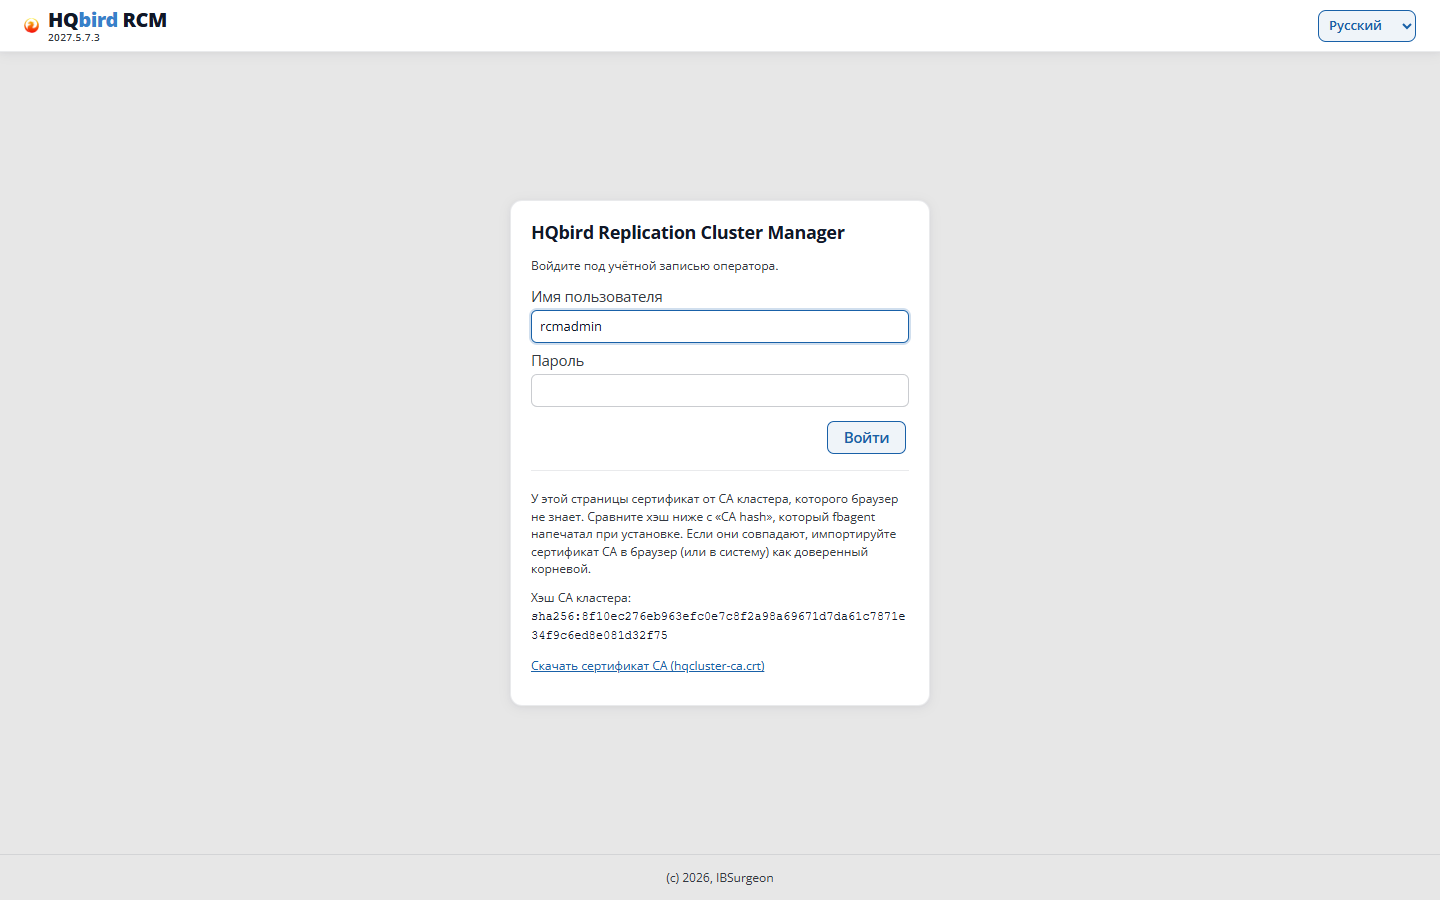
生成的密码。 RCM 在首次登录时要求更改它:在更改之前,其他页面不会打开。立即 更改 strong password(页眉中的 密码 链接)。
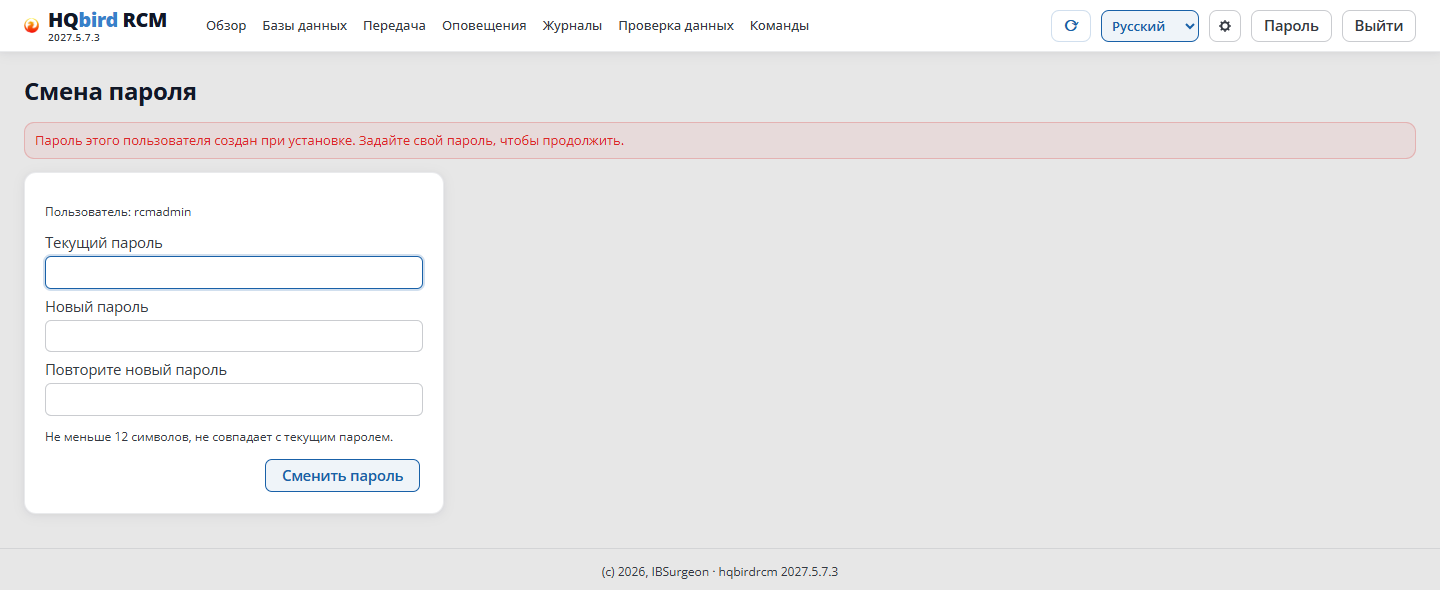
语言。 在页面页眉的语言列表中选择 俄语(登录页上也有)。如果不选,语言取自浏览器。
更改密码和新用户
每个用户更改自己的密码:页面页眉中的 密码 链接。需要当前密码,以及至少 12 个字符的新密码。更改之后,该用户的其他会话会被关闭。
如果安装程序生成了密码,它写在 fbagent 文件夹的文件 clusterca/<name>/rcm-initial-password 中。密码更改后,fbagent 会自己删除该文件。不要 删除 RCM 文件夹中的 initial-admin.json:它只含哈希。如果用户文件丢失且该文件也不在,RCM 会创建使用默认密码的用户。
新用户。 界面中没有用户页。用户保存在文件 rcm-data/users.json 中。密码以 HA1 哈希存储:MD5("<name>:hqbirdrcm:<password>")。
-
计算哈希:
printf '%s' 'rcmadmin:hqbirdrcm:<new password>' | md5sum -
把它写入
users.json中该用户的ha1字段。要添加用户,在users中再加一个元素:{ "username": "ivanov", "ha1": "<hash>", "algo": "MD5", "created_at": "2026-11-03T00:00:00Z" } -
立即重启 RCM:它只在启动时读取该文件。在界面中更改密码时,RCM 会用内存中的内容重写该文件,尚未读入的编辑会丢失。
chmod 600 /opt/hqbirdrcm/rcm-data/users.json
sudo systemctl restart hqbirdrcm
没有 role 字段时,用户拥有全部权限。自 HQbird 2027.2.31 起有角色 "role": "viewer":只能查看,任何修改请求得到 403。
1.6. 如何验证安装
-
节点和 RCM 服务正在运行,并且没有循环重启:
systemctl status hqclusternode-master-p3050、systemctl status hqbirdrcm。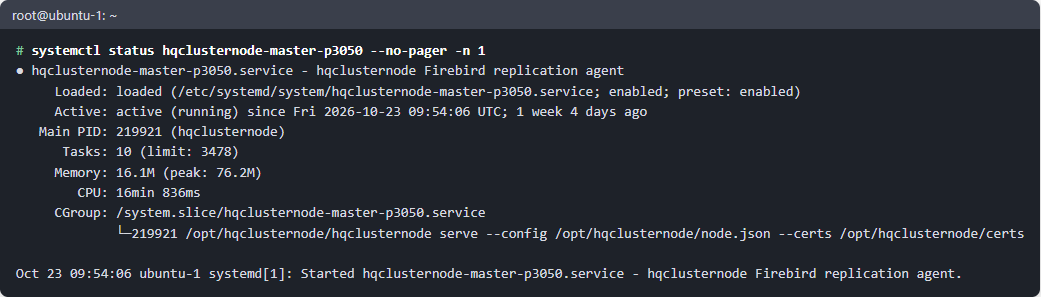
节点的 systemctl status
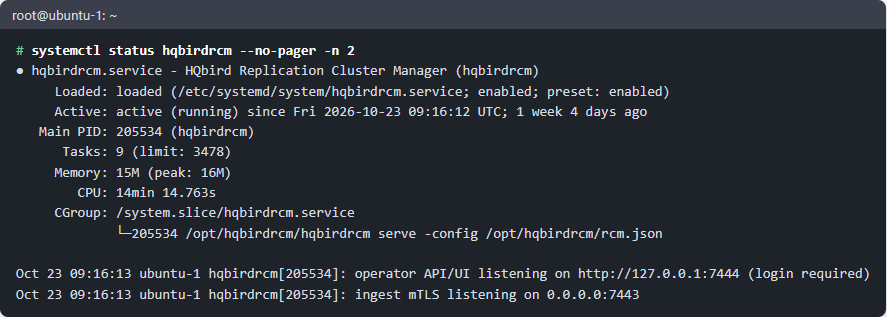
-
RCM 有响应(不需要密码):
curl http://127.0.0.1:7444/healthz。通过 RCM 安装(1.3)时,控制台走 HTTPS:curl -k https://127.0.0.1:7444/healthz。 -
在 RCM 中,概览 页显示所有节点,没有“无响应”标记。
-
在 RCM 主机的命令行上:
export RCM_USER=rcmadmin RCM_PASSWORD='<password>' ./hqbirdrcm nodes ./hqbirdrcm status -
通过 RCM 的群集:设置 → 群集,状态 一节 — 每个成员都已应用最新修订,并且没有报告错误。命令行:
./hqbirdrcm cluster status。
1.7. 日志
| 内容 | 位置 |
|---|---|
| 节点日志 | <node.json 文件夹>/logs/node-YYYYMMDD.jsonl |
| 节点服务输出(Linux) | journalctl -u hqclusternode-<role>-p<port> |
| RCM 服务输出(Linux) | journalctl -u hqbirdrcm |
| Firebird 复制日志 | node.json 中的 firebird.replication_log |
| 不通过 SSH 查看任意节点的日志 | RCM 的 日志 页 |
1.8. 常见错误
| 你看到的 | 原因 | 怎么办 |
|---|---|---|
节点不启动:关于 fbagent_url、fbagent_token 或 instance_id 的错误 |
fbagent 没有运行,或值与 agent_config.json 不符 |
用 1.4 步骤 1 中的 curl 命令检查 fbagent |
| 安装脚本以代码 2 退出 | fbagent 请求没有及时批准 | 批准请求并再次运行脚本 |
| 通过 HQCenter Admin 看不到节点 | fbagent 不在群集中,或尚未取得群集 | 检查群集(第 2 章),最多等待 10 分钟 |
| RCM 中的节点“无响应” | 端口 7051 关闭,rcm.json 中的 url 不正确,地址不在证书中 |
检查端口和证书的 -hosts |
| 无法登录 RCM:“登录失败次数过多” | 5 分钟内 10 次登录失败 | 等几分钟 |
| 新版本装不上 | 该版本在 blocked-versions.json 中 |
从文件中删除该版本行 |
--cluster-init:no hqbirdrcm to install |
安装程序没有留下 RCM 程序 | 用完整安装程序安装 HQbird(1.3,“手动”,步骤 1) |
--cluster-join:token_used、token_expired、token_revoked |
令牌已用过、超过 24 小时,或已被撤销 | 创建新令牌(1.3,“手动”,步骤 4) |
--cluster-join:hostname_conflict |
群集中已有主机名相同、地址不同的 fbagent | 给主机不同的名称 |
--cluster-join:this agent is in cluster … from goafts |
fbagent 已在 HQCenter Admin 群集中 | 把它从 HQCenter Admin 群集中移除 |
| 节点无法通过 RCM 安装 | RCM 没有该平台的发行版 | hqbirdrcm release list,导入发行版(1.3,“手动”,步骤 5) |
2. 群集配置
本章定义群集中有哪些节点,以及哪个主节点把段发给哪个副本。然后配置 RCM 的节点和用户。
关系用三种方式之一定义:
| 节点的安装方式 | 关系定义在何处 | 节 |
|---|---|---|
| 通过 HQCenter Admin | 在 HQCenter Admin 中:HQ Monitor 的 群集 页,或 HQCenter Admin API | 2.2 |
| 通过 RCM,不用 HQCenter Admin | 在 RCM 中:设置 → 群集、hqbirdrcm cluster,或 HQ Monitor 的 群集 页 |
2.3 |
| 手动 | 在 RCM 中:设置 → RCM 和 设置 → 节点 | 2.3 |
在通过 HQCenter Admin 或通过 RCM 安装的节点上,只在群集描述中 更改关系。fbagent 按群集描述覆盖 node.json 和 rcm.json。在 RCM 的 设置 → RCM 或 设置 → 节点 中编辑关系会被拒绝(409 cluster_managed)。更早的 RCM 版本会接受,但更改会丢失。
2.1. 角色与方案
每个节点有一个角色:主节点 或 副本节点。一个 Firebird 实例上可以运行两个节点:一个主节点和一个副本节点。
支持的方案:
1 → 1        node-a (master) ──▶ node-b (replica)

1 → N        node-a ──▶ node-b
                    └─▶ node-c

N → 1        node-a ──┐
                      ├─▶ node-b    (one replica for several masters)
             node-x ──┘

Both nodes   host-1: node-1m (master) + node-1r (replica)  ← one Firebird
on a host    host-2: node-2m (master) + node-2r (replica)  ← one Firebird
             node-1m ──▶ node-2r,  node-2m ──▶ node-1r
链接始终从主节点指向副本。RCM 按 数据库 GUID 把主库数据库与其副本联系起来,而不是按节点名。
伴随节点。 同一 Firebird 实例上的主节点和副本节点是伴随节点。把副本提升为主节点(第 8 章)只对这样的一对有效。在 rcm.json 中,这一对用相同的 host 值标记。
2.2. 通过 HQCenter Admin 的链接
在何处描述群集
- HQ Monitor 的群集页(仅管理员;必须启用配置下发)。通常的方式。
- HQCenter Admin API:
POST /v1/admin/clusters和PUT /v1/admin/clusters/{id}。HQCenter Admin 面板没有 群集页。
``
群集页上的步骤
- 输入 新群集 id(小写拉丁字母、数字和
-)并单击 创建。 - 添加成员(成员)。为每一个指定:
- 主机的 fbagent;
- 角色:
master、replica或rcm; - 主机地址;
- 端口:节点为
7051(同一主机上的第二个节点例如7052), RCM 为统计接收端口7443。
- 添加从主节点到副本的链接(复制链接)。
- 单击 验证,然后 保存。
如果另一位管理员同时更改了群集,页面会要求重新加载群集并重复更改。
规则
- 一个 fbagent 只能属于一个群集。
- 单个 fbagent 上最多一个主节点、一个副本节点、一个 RCM 和
一个路由器。路由器(角色
router,自 HQbird 2027.2.30 起)没有链接, 也不占用许可证席位(第 8.7 章)。 - 一个群集恰好有 一个 RCM。RCM 主机上的 fbagent 运行群集的 证书颁发机构(CA)。
- 成员名(
member_id)— 拉丁字母、数字、-。成员的名称、fbagent 和角色 不能更改。要把成员移到另一台主机,用新名称创建 新成员。不要再次使用旧名称。 - 每个副本都必须有到主节点的链接。
- HQCenter Admin 自己构造节点地址:
https://<第一个地址>:<端口>。 - HQbird 2.5/3.0: 设置群集的
replconf_valid_till日期 (YYYY-MM-DD)— replconf 插件配置在该日期之前有效。
通过 API 的示例
{"contract":1,"cluster_id":"shop-prod","name":"Shop","pki":"managed",
 "cert_validity_days":90,"renew_before_days":30,
 "members":[
  {"member_id":"db1-m","agent_id":"<fbagent of host 1>","role":"master","addresses":["db1.lan"],"listen_port":7051},
  {"member_id":"db1-rcm","agent_id":"<fbagent of host 1>","role":"rcm","addresses":["db1.lan"],"listen_port":7443},
  {"member_id":"db2-r","agent_id":"<fbagent of host 2>","role":"replica","addresses":["db2.lan"],"listen_port":7052}],
"links":[{"from":"db1-m","to":"db2-r"}]}- 创建:
POST /v1/admin/clusters(文档可以和 成员一起发送)。替换整个文档:PUT /v1/admin/clusters/{id}。 PUT需要头If-Match: <revision>(修订号由GET和ETag提供)。 没有该头 —428,修订号过旧 —409,文档有错误 —422并附错误列表。POST /v1/admin/clusters/{id}/validate验证文档而不保存。GET /v1/admin/clusters/{id}/status显示成员状态和证书 到期日。
保存之后发生什么
- 每个成员的 fbagent 收到群集。在群集内 — 每 60 秒检查一次(RCM 主机上的 fbagent — 每 30 秒)。在群集外,fbagent 在下一次配置轮询时得知群集。如果那次轮询没有 到达服务器,则每 10 分钟检查一次。
- 每个 fbagent 创建密钥并发送证书请求。RCM 主机上的 fbagent 为它签名。RCM 不经请求为自己的证书签名。
- fbagent 写入
node.json:名称、角色、地址、peers(来自链接)、 RCM 地址、证书路径、Firebird 和 fbagent 数据。写入rcm.json:节点 列表(nodes)、路由器列表(routers)、统计接收地址和 证书路径。fbagent 不触碰文件的其他字段。 - fbagent 安装并启动服务(第 1 章)。
更改群集:
| 更改了什么 | fbagent 做什么 |
|---|---|
仅运行中节点的 peers |
不重启就把它们传给节点 |
| 节点的其他字段 | 停止节点、写入文件、启动节点 — 在节点的 windows.transfer_window 内(未设置则立即) |
rcm.json |
立即重启 RCM |
| 证书或 CA | 重启服务 |
| 删除了成员 | 停止并删除服务;cluster-managed.json → cluster-removed.json,程序 → *.removed;配置、证书和数据保留 |
节点被删除后,共享的 replication.conf 中仍留下它的一节
# BEGIN managed-by:<name> … # END …。手动删除它,并通过 RCM 重启
Firebird。
批准群集证书
默认情况下,RCM 主机上的 fbagent 自己为请求签名(auto)。可以启用手动批准。在 RCM 主机上的命令:
fbagent --cluster-ca-approval manual     # or auto
fbagent --cluster-status                 # this fbagent's membership in the cluster (JSON)
fbagent --cluster-ca-approve <request_id>
在 manual 模式下,新成员或新密钥等待批准。用已知密钥续期
证书会自动签名。
2.3. 通过 RCM 的链接
RCM 群集(不用 HQCenter Admin)
如果群集是由 HQbird 安装程序或 fbagent --cluster-init 命令创建的
(第 1.3 章),群集描述由 RCM 保存。添加主机最简单的方式是
设置 → 链接主机 页(第 1.3 章,“在 RCM 中链接主机”):
RCM 自己创建成员和链接。规则与 HQCenter Admin 相同(2.2,“规则”),另外:
- 在 RCM 中只有一个群集;
rcm成员始终存在,不能删除; - 不超过 3 个席位(运行主节点或副本节点的主机),否则出现错误
seats_exceeded; - 成员只能加在已连接到 RCM 的 fbagent 上 (第 1.3 章:“链接主机”或“手动”,步骤 4)。
设置 → 群集页上的步骤:
- 在 代理 表中,单击该 fbagent 行的 添加成员。
- 指定角色(
master、replica或router)、member_id、地址和端口。 页面建议名称<host>-<role>和端口:该 fbagent 的第一个节点为7051, 第二个为7061。已被该主机另一个成员占用的端口会被 RCM 拒绝。 fbagent 地址是按钮:单击即可添加地址。 - 在 链接 一节,单击从主节点到副本的 添加链接。
- 单击 验证:RCM 会显示错误和警告。
- 单击 保存。页面会显示更改列表并要求 确认。如果正在删除成员,窗口是红色的。
保存之前,更改只存在于页面上(“未保存”标签)。如果 有人同时保存了群集,页面会提议重新加载。 如果只改了 RCM 字段(修订号、CA、委托),页面会自己 保存你的更改。
页面的其他部分:
| 部分 | 内容 |
|---|---|
| 页眉 | 群集名、修订号、群集 CA 和代理 CA;旧 CA 的 导出 按钮 |
| 连接令牌 | 为新 fbagent 创建令牌,撤销未使用的令牌 |
| JSON 文档 | 文本字段中的整个文档;验证 和 保存 使用它 |
| 密钥和 CA | 委托:新成员密钥(rekey)、新群集 CA(rotate_ca)、新代理 CA(rotate_agent_ca);有未保存更改时不可用 |
| 状态 | 每个成员已应用的修订、证书到期、服务、最近的错误 |
在 RCM 主机的命令行上:
export RCM_USER=rcmadmin RCM_PASSWORD='<password>'
./hqbirdrcm cluster show > c.json        # document with revision
# edit c.json
./hqbirdrcm cluster validate -f c.json   # validate without saving anything
./hqbirdrcm cluster apply -f c.json      # save (If-Match = revision from the file)
./hqbirdrcm cluster agents               # connected fbagents and their members
./hqbirdrcm cluster status               # what the fbagents reported
文档格式与 2.2“通过 API 的示例”相同。用旧修订号 apply
得到 409:再次运行 show。RCM 在
rcm-data/cluster/history/ 中保留最近 20 个修订。
HQ Monitor。 群集 页也适用于 RCM。在 RCM 主机上,
HQ Monitor 通过该主机的 fbagent 访问 RCM,使用 fbagent
证书:不需要 RCM 用户和密码。在 RCM 审计日志中,这类
操作记为 agent:<id> (<user>)。另一种方式,用于更早的
RCM 版本:在 HQ Monitor 配置中设置 rcm_admin_url
(http://127.0.0.1:7444)、rcm_admin_user(RCM 用户)和
rcm_admin_password_file(含其密码的文件)。
保存之后,过程与通过 HQCenter Admin 相同(2.2,“保存之后发生什么”)。RCM 自己重新读取 rcm.json 中的 nodes,不必重启。
把 fbagent 移出群集: 删除它的成员并保存,然后
在 代理 表中单击 撤销(或
./hqbirdrcm cluster revoke -agent <id>)。要把它加回来,需要新的
令牌。撤销之后,fbagent(自 3.1.0 起)自己离开群集:
它停止自己的节点并删除群集数据。在节点主机上,
fbagent --cluster-leave 命令做同样的事。在 RCM 主机上该命令被拒绝。
手动安装:把节点加入 RCM
- 设置 → RCM,已连接的节点 表。
- 单击 添加节点。填写
node_id、url(https://<地址>:7051)、角色、host(Firebird 实例标签)、server(仅用于屏幕上的分组)。 - 单击该节点行中的 验证:RCM 会检查连接和权限。
- 单击 保存。RCM 会写入
rcm.json,并把旧文件保存为rcm.json.<UTC 时间>.bak(最近 20 个)。 - 重启 RCM。 重启之前旧配置仍然有效; 页面会显示哪些字段在等待重启。
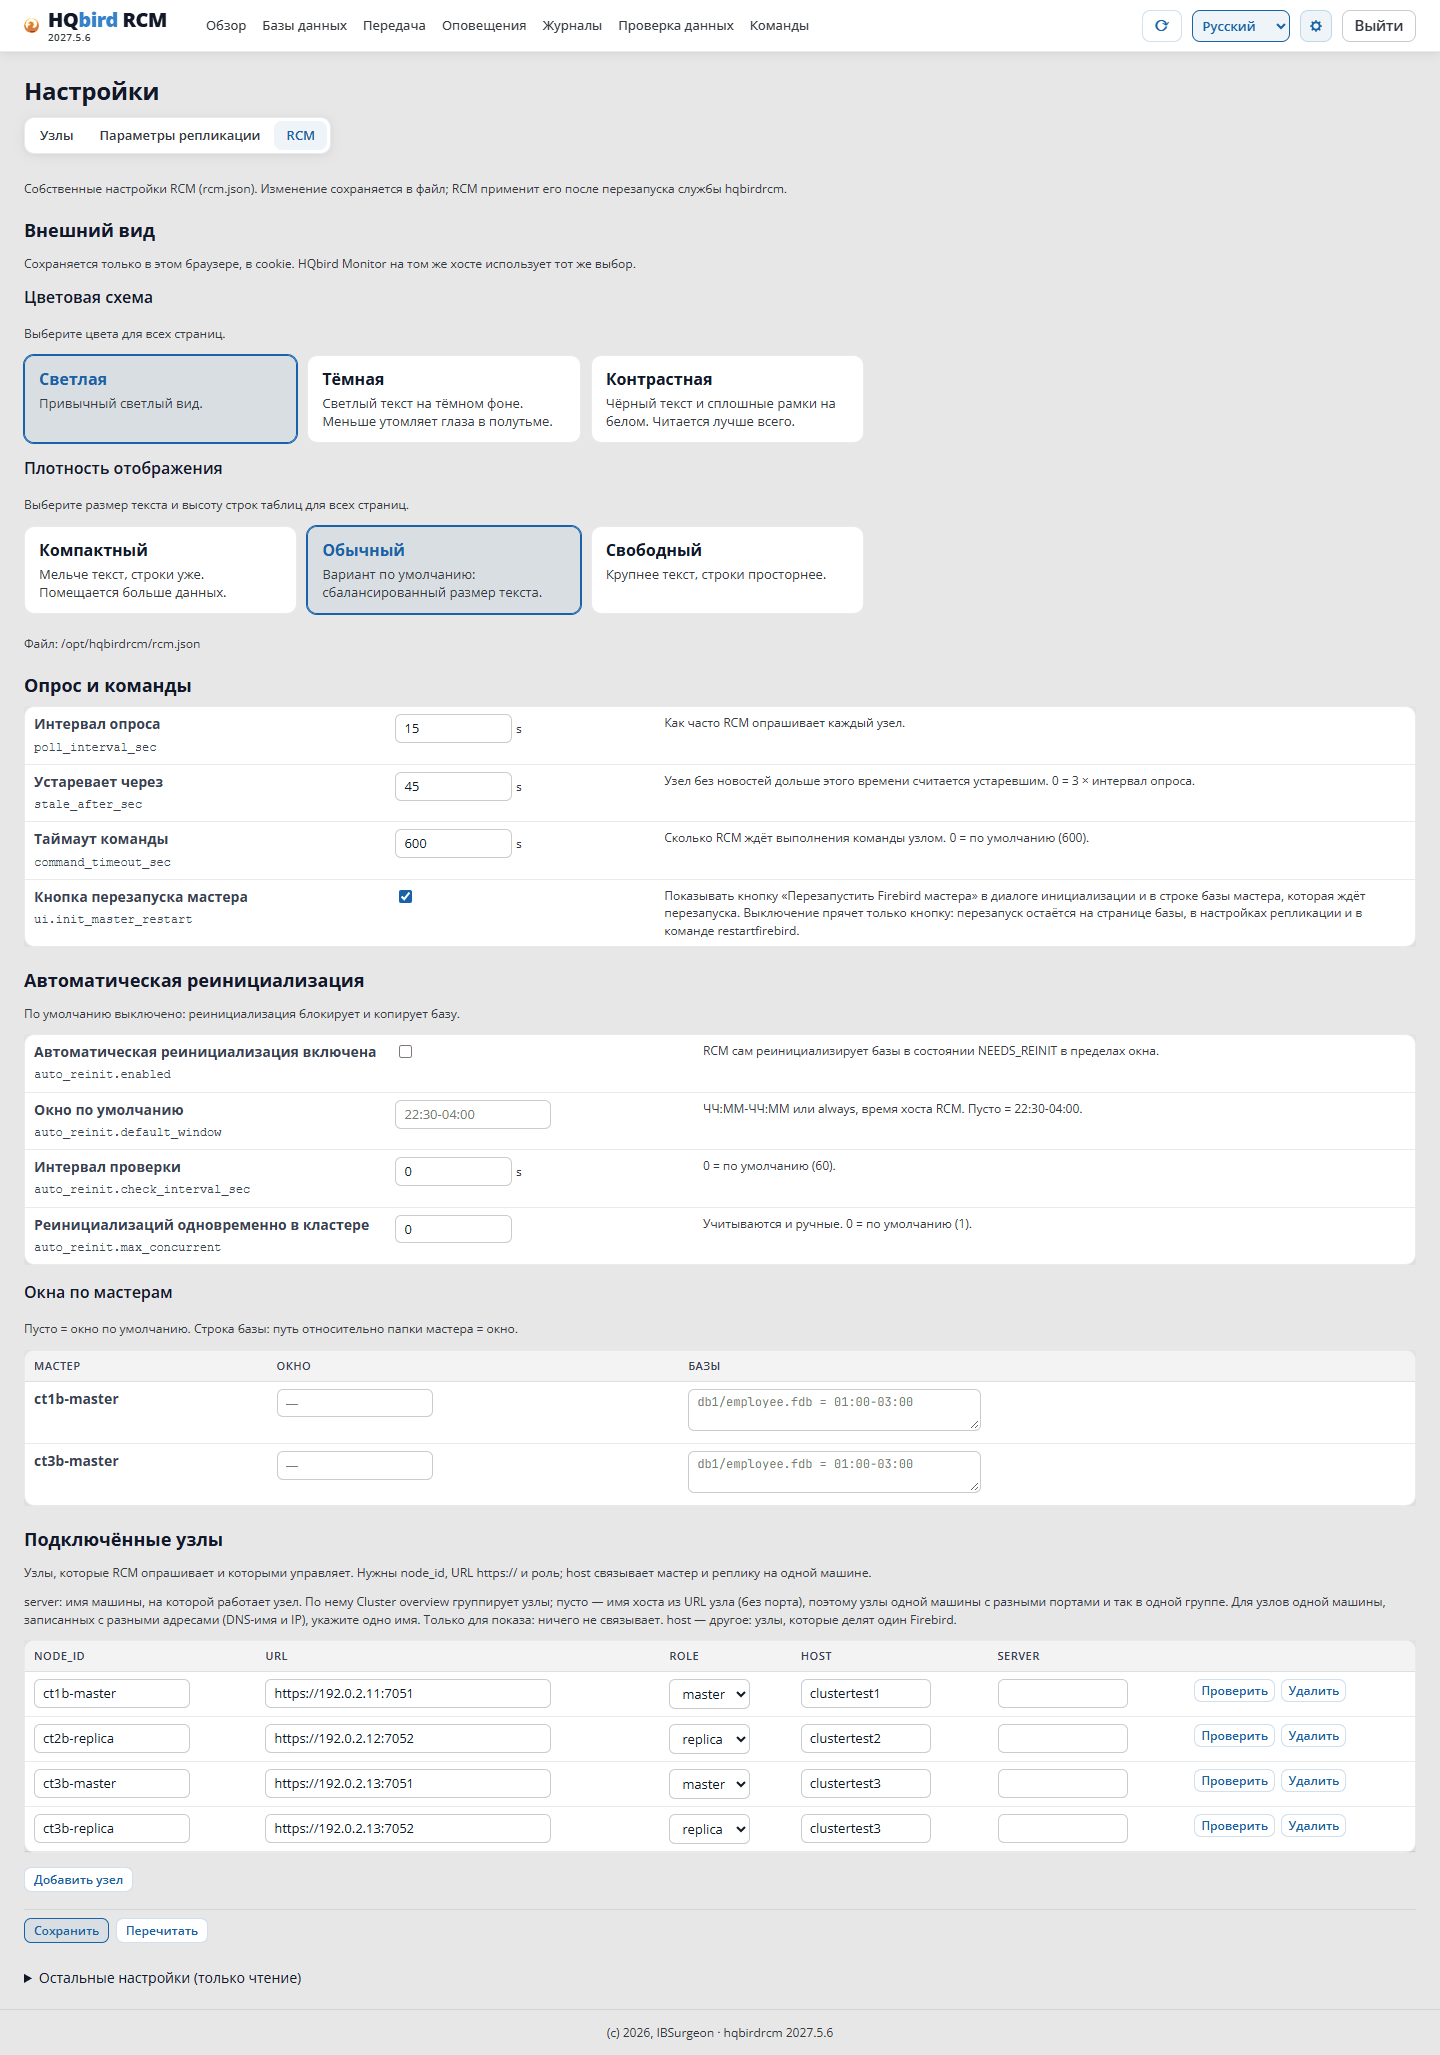
sudo systemctl restart hqbirdrcm也可以不通过界面:编辑 rcm.json 并重启 RCM。
手动安装:链接主节点和副本
链接必须 在两侧 都记下:
- 设置 → 节点,选择主节点。
- 在 对等方 一节,单击 添加对等方:副本的
node_id、它的url、 压缩(zstd)。 - 单击 保存。RCM 会显示更改列表并要求
确认。
peers的更改立即生效。 - 对副本节点重复:它的对等方是主节点。
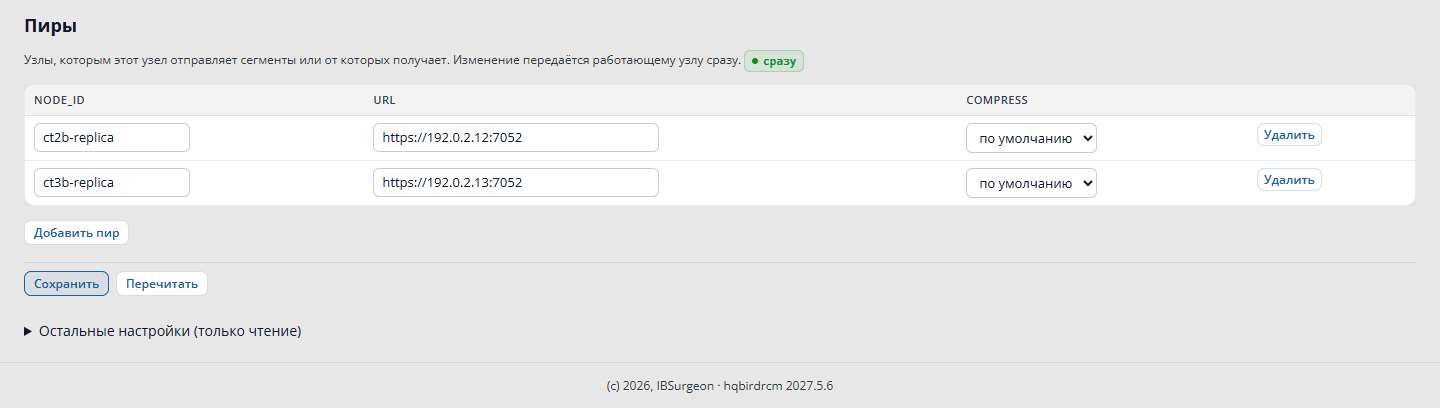
如果某一侧没有记下对等方,初始化数据库时 RCM 不会提供该副本节点。
2.4. 节点设置
设置 → 节点 显示节点允许从 RCM 更改的 node.json 设置。只保存已更改的字段,并先弹出列出更改的窗口。
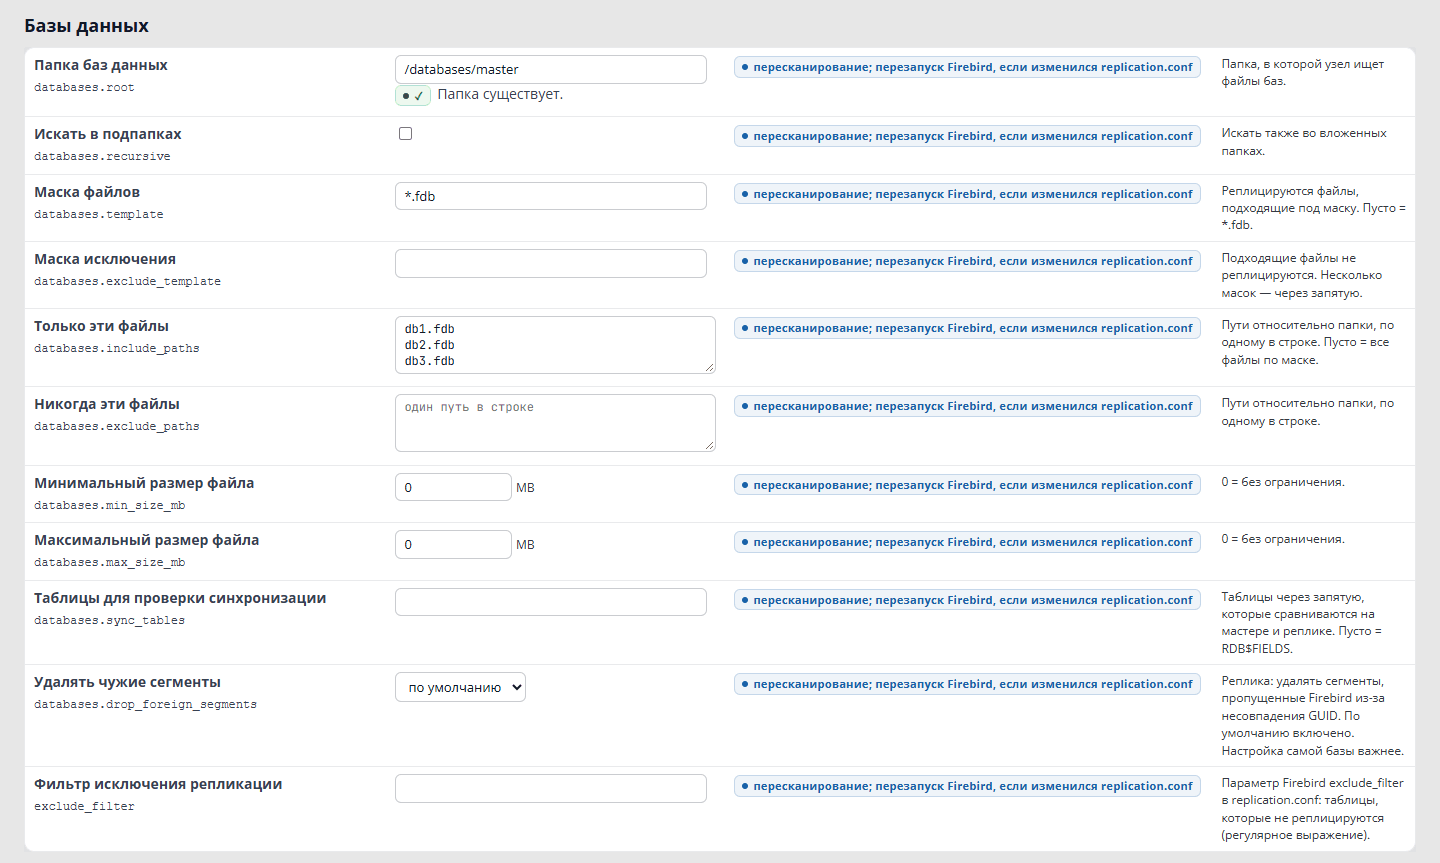
每一行都标出更改何时生效:
| 何时 | 哪些设置 |
|---|---|
| 立即 | channel_a_mbps、channel_a_burst_mbps、windows.restart_window、peers;自 HQbird 2027.2.24 起 — 数据检查设置(limits.data_check_*);自 HQbird 2027.2.31 起 — advertise_addr |
| 节点重启后 | 其余限制、windows.transfer_window;在节点重启之前,页面把它们显示在单独一行 |
| 扫描后 | databases.*、exclude_filter;如果 replication.conf 已更改,需要重启 Firebird(第 3.5 章) |
只读(在节点主机的 node.json 中更改):firebird(包括密码和 auto_restart)、rcm、tls、segments、listen_addr 地址。
主要设置:
| 设置 | 默认 | 含义 |
|---|---|---|
windows.restart_window |
主节点 22:00-05:00,副本 — 始终 |
节点何时可以重启 Firebird;主库上的 Firebird 从不自己重启 |
windows.transfer_window |
23:00-05:00 |
初始化以 reinit_window_mbps 速率运行的窗口 |
limits.channel_a_mbps |
50 | 段传输速率,MB/s(channel_a_burst_mbps — 短时峰值,200) |
limits.reinit_window_mbps |
100 | 传输窗口内的初始化速率,MB/s |
limits.reinit_day_disk_fraction |
0.5 | 窗口外初始化所用的实测磁盘速度比例 |
limits.retention_days |
2 | 主节点归档中已发送的段保留多少天 |
limits.free_space_floor_gb |
1 | 最小空闲空间,GB;低于此值副本不接收段 |
limits.max_concurrent_reinits |
1 | 节点同时运行多少个初始化 |
速度和归档保留的细节见第 5 章和第 7 章。
firebird.auto_restart(仅在 node.json 中)决定 副本 节点是否可以自己重启 Firebird:
| 值 | 行为 |
|---|---|
auto(默认) |
可以,如果这个 Firebird 不服务于主库数据库 |
never |
从不 |
always |
始终,即使这个 Firebird 上有主库数据库 |
通过 HQCenter Admin。 fbagent 节点的
windows.transfer_window也用作群集更改时重启节点服务本身的窗口。如果node.json中没有设置该窗口,fbagent 会立即重启服务。
2.5. 一台主机上的多个 HQbird 实例
fbagent 重启其配置中 firebird.update.services 列出的服务。空列表表示主机上的 全部 HQbird 服务。列表中只保留你自己实例的服务。节点看不到这项设置;如果 fbagent 知道不止一个实例,节点会在日志中写入警告 fbagent_shared。
2.6. SYSDBA 密码
节点用 node.json 中 firebird.user 和
firebird.password 的用户和密码连接 Firebird。fbagent 保存自己的一份密码副本。如果
更改了 SYSDBA 密码:
- 在该实例的 每一个 节点(主节点和副本)的
node.json中改正firebird.password。 - 在 fbagent 配置中改正密码并重新加载(见 fbagent 文档)。
- 重启节点服务。
否则 RCM 中的发布页和验证页会显示登录错误
(SQLSTATE 28000)。
2.7. RCM 用户与审计
- 用户在文件
rcm-data/users.json中(第 1.5 章)。没有角色时, 用户拥有全部权限;角色viewer(自 HQbird 2027.2.31 起)— 只能查看。 - 会话在最后一次操作之后持续 12 小时。
- 5 分钟内 10 次登录失败后,该用户和该地址的登录会被 暂时阻止。成功登录会重置计数器。
- 审计日志是文件
rcm-data/audit.jsonl:每次 更改、登录和登出一行 JSON。界面中没有审计日志。 - 命令 页显示每条命令的作者。
2.8. 许可证
主节点每分钟读取其主机的 fbagent 许可证。如果没有许可证(试用期已结束、许可证已过期或无效),节点会 停止发送段,针对主库上的所有数据库。Firebird 和数据库继续运行,但副本不再收到变更。
在 RCM 中看到的:
- 主节点是红色(
NEEDS_ATTENTION),带有“无许可证:发送已停止”标记; - 没有 恢复 按钮:只有许可证能解除暂停;
- 在副本上:“自 …… 起未接收:主节点没有许可证”;
- 在 节点 表中有“无许可证”标记;在 设置 → 节点 中有 fbagent 许可证块;
- 警报
license_paused和license_pause_archive_released; - 禁止初始化(
license_paused)。
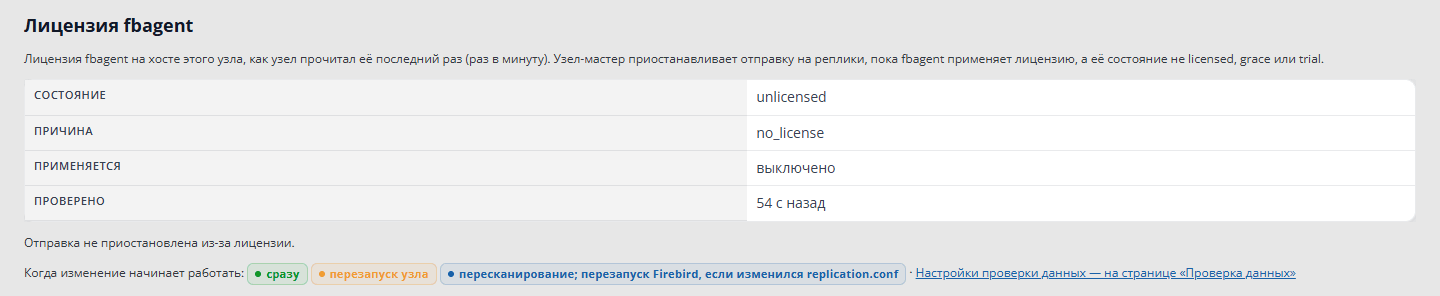
在 fbagent 中安装许可证。节点会在一分钟内自己解除暂停。主节点从暂停开始为副本保留归档 limits.retention_days(默认 2 天)。如果更晚才安装许可证,副本必须重新初始化。
通过 RCM 的群集,不用 HQCenter Admin。 没有 HQCenter Admin 的浮动许可证在 online_check_days 加上宽限天数之后停止工作。群集中的每个 fbagent 都需要 绑定 许可证(fbagent --license-request,然后 fbagent --license-install,第 1.3 章,“许可证”)。试用期之后,如果许可证中没有 cluster 功能,fbagent 不会添加新节点或 RCM;它从不禁止更新。对于 HQbird 2.5/3.0,RCM 中的 replconf_valid_till 日期不能晚于 fbagent 节点上许可证结束加上宽限天数(错误 replconf_after_license)。
2.9. 如何检查
-
概览: 所有节点都在,并按服务器分组。
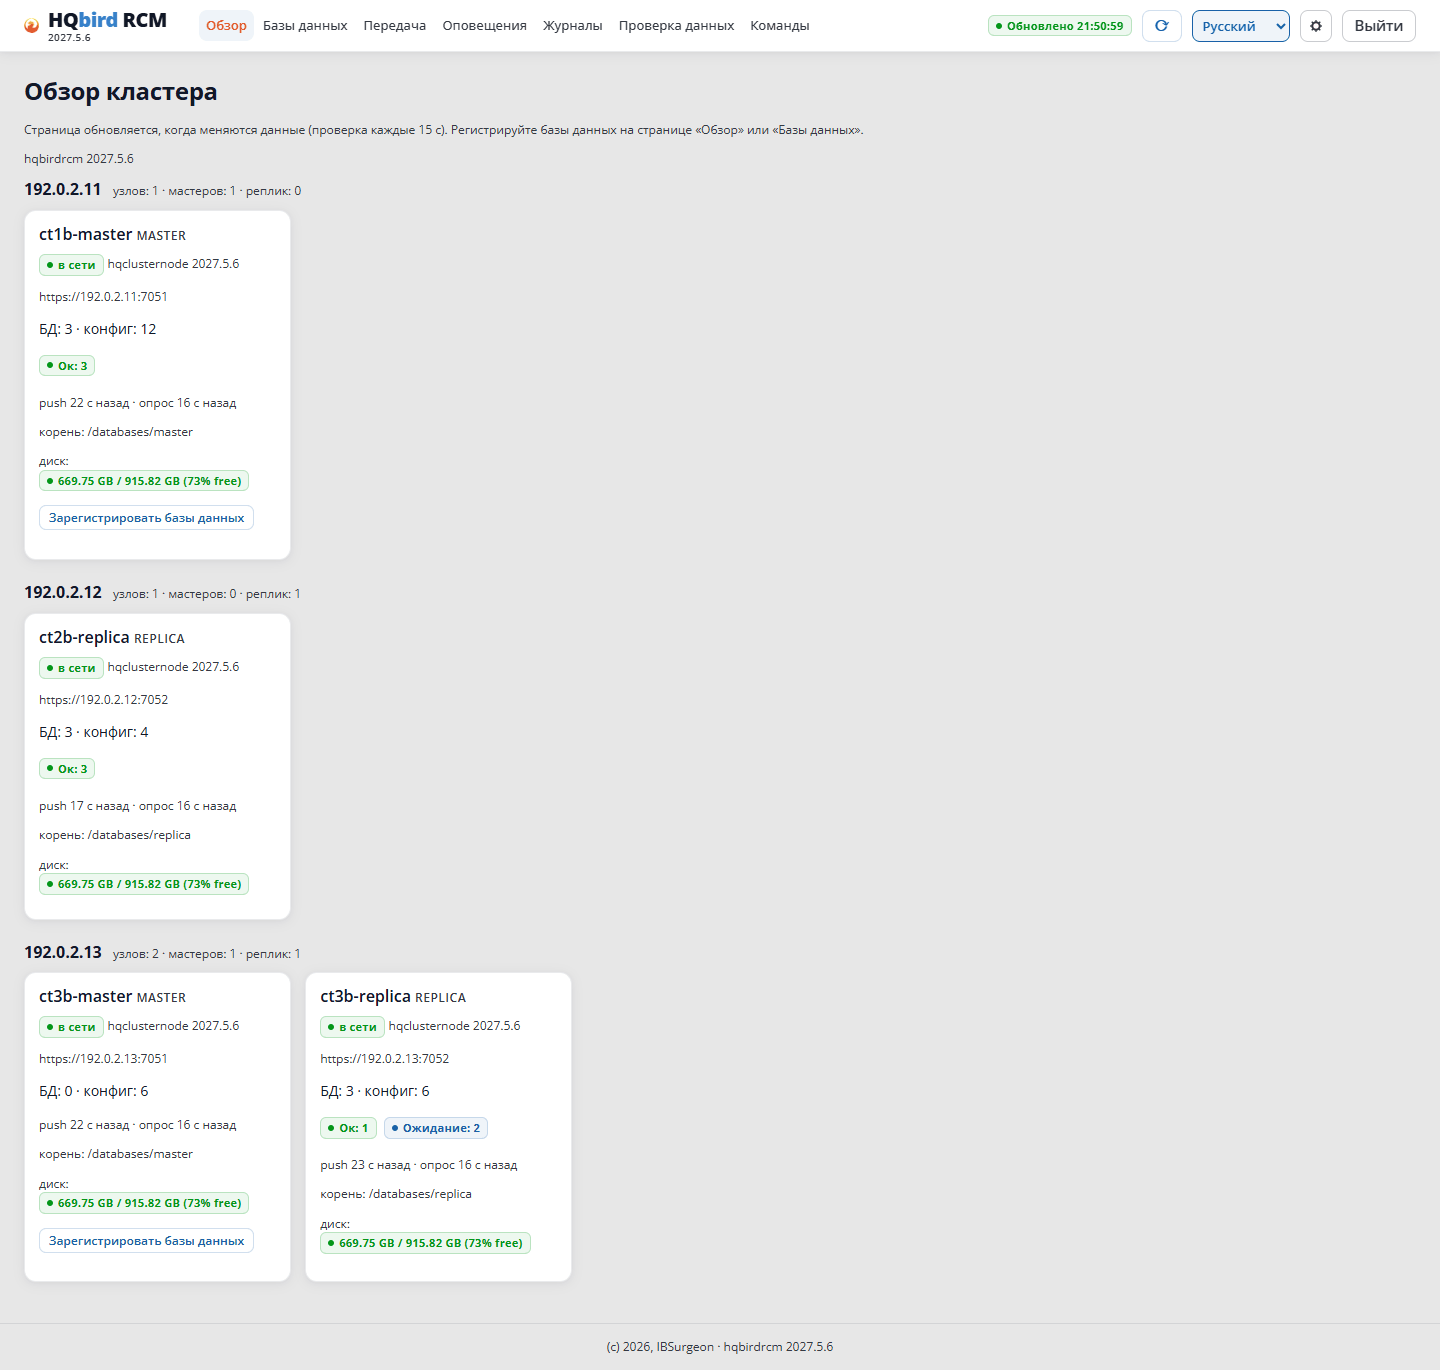
群集概览
-
设置 → 节点: 主节点的 对等方 中有副本,副本中有主节点。
-
设置 → RCM: 每个节点行中的 检查 按钮通过。
-
把群集报告做成一个文件:
./hqbirdrcm report -o report.json
2.10 常见错误
| 你看到的 | 原因 | 怎么办 |
|---|---|---|
在 RCM 中编辑对等方被拒绝(409 cluster_managed),或在节点重启后丢失 |
节点是通过 HQCenter Admin 或通过 RCM 安装的 | 在群集描述中更改链接(2.2、2.3) |
在 RCM 中保存群集时 seats_exceeded |
第四台主机上有节点 | 有节点的主机不超过 3 台 |
设置 → RCM:rcm_config_read_only |
Linux 上通过 RCM 的群集:rcm.json 属于 fbagent |
以 fbagent 用户编辑 rcm.json 并重启 RCM |
撤销 代理不起作用(agent_has_members) |
fbagent 还有成员 | 先删除成员并保存 |
| 初始化时不提供副本节点 | 某一侧没有记下对等方 | 在两侧都添加对等方(2.3) |
| 设置 → RCM 中的更改不生效 | RCM 没有重启 | 重启 RCM |
在 HQCenter Admin 中保存群集时 422 |
文档有错误 | 按 errors 列表修正,通过 validate 检查 |
保存群集时 409 |
群集已被别人更改 | 重新读取群集并重试 |
| HQCenter Admin 的新群集成员收不到证书 | RCM 主机上是手动批准 | fbagent --cluster-ca-approve <id> |
发布页上的 SQLSTATE 28000 错误 |
SYSDBA 密码已更改 | 2.6 |
3. 向主节点添加数据库
本章中,主库数据库进入节点的管理。节点把它写入
replication.conf,并为段创建文件夹。重启 Firebird 之后,
数据库就可以复制。
创建副本是后续步骤(发布、初始化)。它们在 第 4–6 章说明。
按钮名称按俄语 RCM 界面给出,括号中是英语名称。
3.1. 节点如何发现数据库
主节点在一个文件夹中查找数据库 — 数据库根(databases.root)。哪些进入管理由规则决定:
| 规则 | 字段 | 默认 |
|---|---|---|
| 数据库文件夹 | root |
未设置 |
| 搜索子文件夹 | recursive |
是 |
| 包含掩码 | template |
*.fdb |
| 排除掩码 | exclude_mask |
无 |
| 文件大小,MB | min_size_mb、max_size_mb |
无限制(0) |
| 用于数据比较的表 | sync_tables |
HQbird 2027.2.24 — 来自数据库发布的表,如果没有则 RDB$FIELDS;在 2027.5.7 中 — RDB$FIELDS |
| 包含列表 | include_paths |
空(模板模式) |
| 排除列表 | exclude_paths |
空 |
root 路径是 节点主机上 的路径,不是 RCM 主机上的。节点先应用包含掩码,再应用排除掩码,然后是大小。
规则对整个节点相同。sync_tables 列表也是共享的:检查(第 5.10 章)在该节点上没有自己列表的每个数据库中查找列表里的每张表。
用于比较的表,HQbird 2027.2.24。 每个数据库可以有自己的列表(同步跟踪表)。节点把它存在 databases.sync_tables_by_db 中。检查采用第一个已设置的列表:
- 数据库自己的列表;
- 节点共享的
sync_tables列表; - 来自数据库发布的表;
RDB$FIELDS。
先前保存的共享列表优先于发布:没有自己列表的数据库使用它。主库数据库页显示当前生效的是哪个列表(3.3)。
在主库和副本上都不存在的表得到状态“不在数据库中”(absent):它不被比较,检查也不会因此显示“不正常”。只在一侧缺失的表是差异。
RCM 和节点 2027.5.7。 整个节点只有一个列表(sync_tables);没有列表时检查使用 RDB$FIELDS。缺失的表是错误,数据库检查会显示“不正常”。
所有规则都存在节点的 node.json 中。节点在每次扫描时应用它们。
模板模式和列表模式:
- 模板模式(包含列表为空):节点取所有匹配掩码的文件,排除被排除的。文件夹中的 新文件 会在下次扫描时被节点自动纳入。
- 列表模式(包含列表非空):节点只取列表中的文件。新文件 不会 自动进入管理 — 必须添加。
如果文件夹中有数据库副本、测试数据库或其他不需要复制的文件,选择列表模式。
3.2. 开始之前:检查权限
Firebird 和节点运行所用的用户(Linux 上是 firebird,
Windows 上是 LocalSystem)必须对以下位置有读写权限:
- 数据库根文件夹和数据库文件;
replication.conf及其文件夹(节点通过临时文件替换该文件);- 段文件夹
<database>.ReplLog和<database>.LogArch(节点自己创建它们)。
RCM 在登记之前检查权限(预检)。如果检查失败,
命令以错误 preflight failed on <node> 结束,并列出路径。
在节点主机上检查(Linux):
sudo -u firebird /opt/hqclusternode/hqclusternode checkpermissions -config /opt/hqclusternode/node.json3.3. 数据库登记页
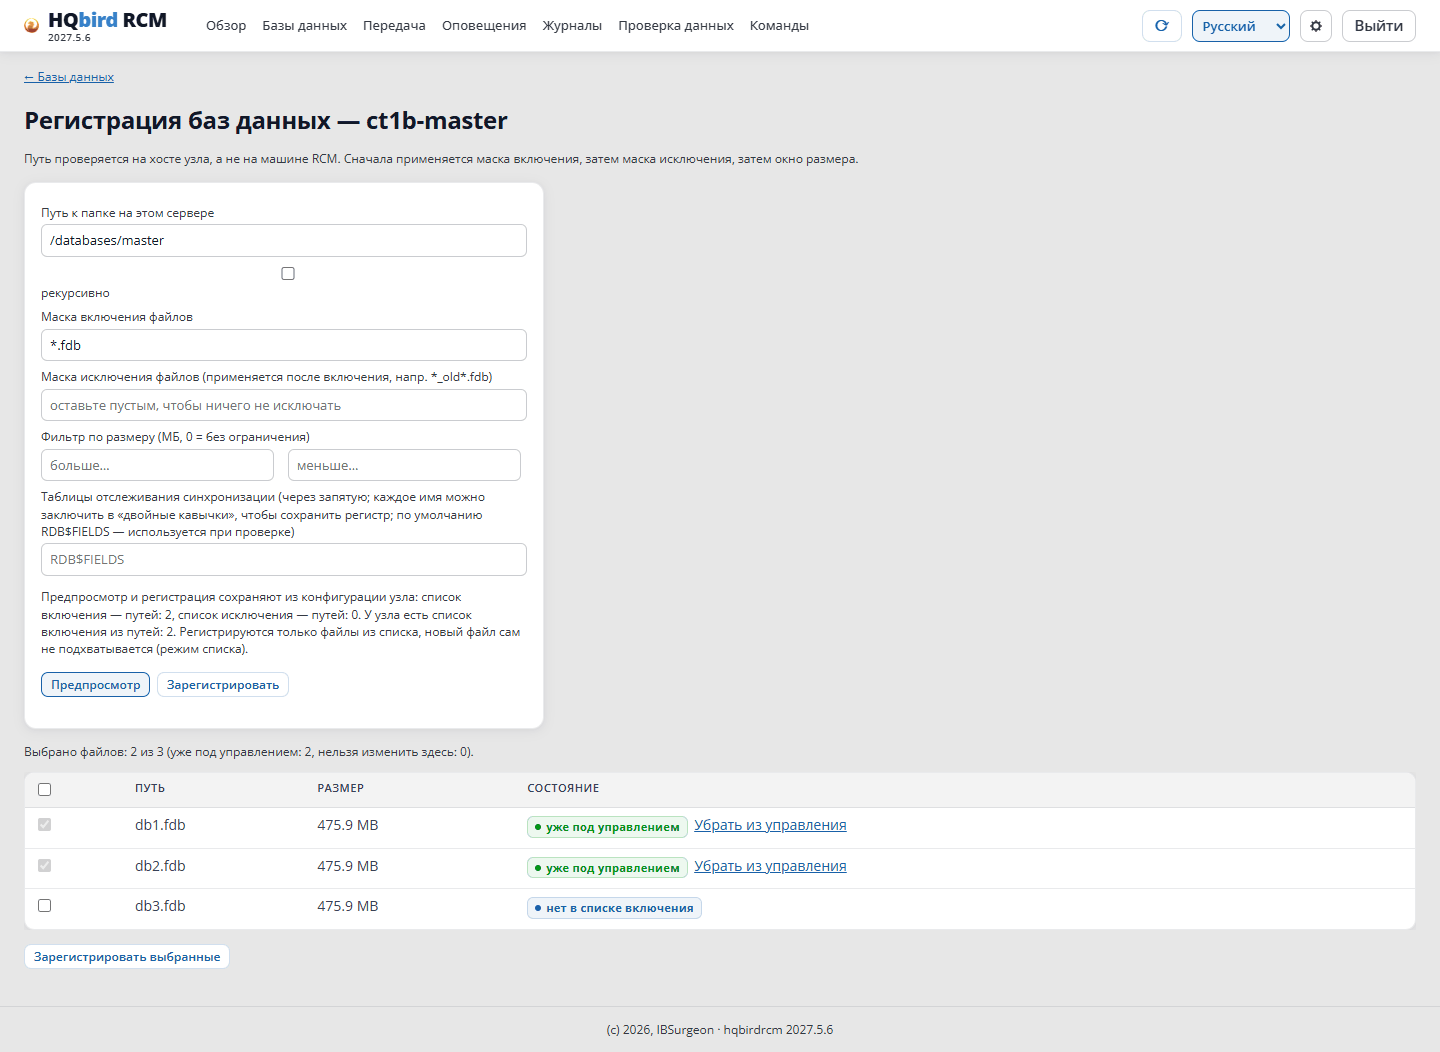
-
打开主节点登记页。链接在两个地方:
- 数据库 → 节点 表 → 操作列 → 登记;
- 概览 → 主节点卡片 → 登记数据库。
副本节点没有此页。
-
表单显示节点的 当前 规则(节点自己发送的)。如果节点 没有响应,预览和登记按钮被禁用:没有当前 规则时,它们会重置包含和排除列表。
-
填写或改正字段:此服务器上的文件夹路径、 递归、掩码、大小过滤器、同步跟踪 表。
同步跟踪表 字段:
- HQbird 2027.2.24 及以后 — 列表是 按此操作将登记的每个数据库。空字段:数据库使用自己发布中的表。登记不更改节点的共享
列表(
sync_tables)。如果它存在,表单会说明:没有自己列表的数据库使用它, 而不是发布。 已受管理的数据库的列表在其页面上设置:数据库 → 主库数据库 → 同步跟踪表 块。该块 显示当前生效的是哪个列表。空字段会去掉数据库自己的 列表; - 在 RCM 和节点 2027.5.7 中 — 该节点所有数据库 共用一个列表
(
sync_tables)。
- HQbird 2027.2.24 及以后 — 列表是 按此操作将登记的每个数据库。空字段:数据库使用自己发布中的表。登记不更改节点的共享
列表(
-
单击 预览。节点会显示所有匹配包含 掩码的文件。它不更改任何东西。
-
检查列表。每个文件有一个复选框:
- 已勾选 — 该文件将受管理;
- 已勾选、锁定、标记为 已受管理 — 数据库已经 登记;
- 锁定并附原因 — 文件被掩码、大小或排除 列表排除。要纳入它,更改规则。
-
勾选所需数据库并单击 登记 所选。RCM 会要求确认并显示文件数。
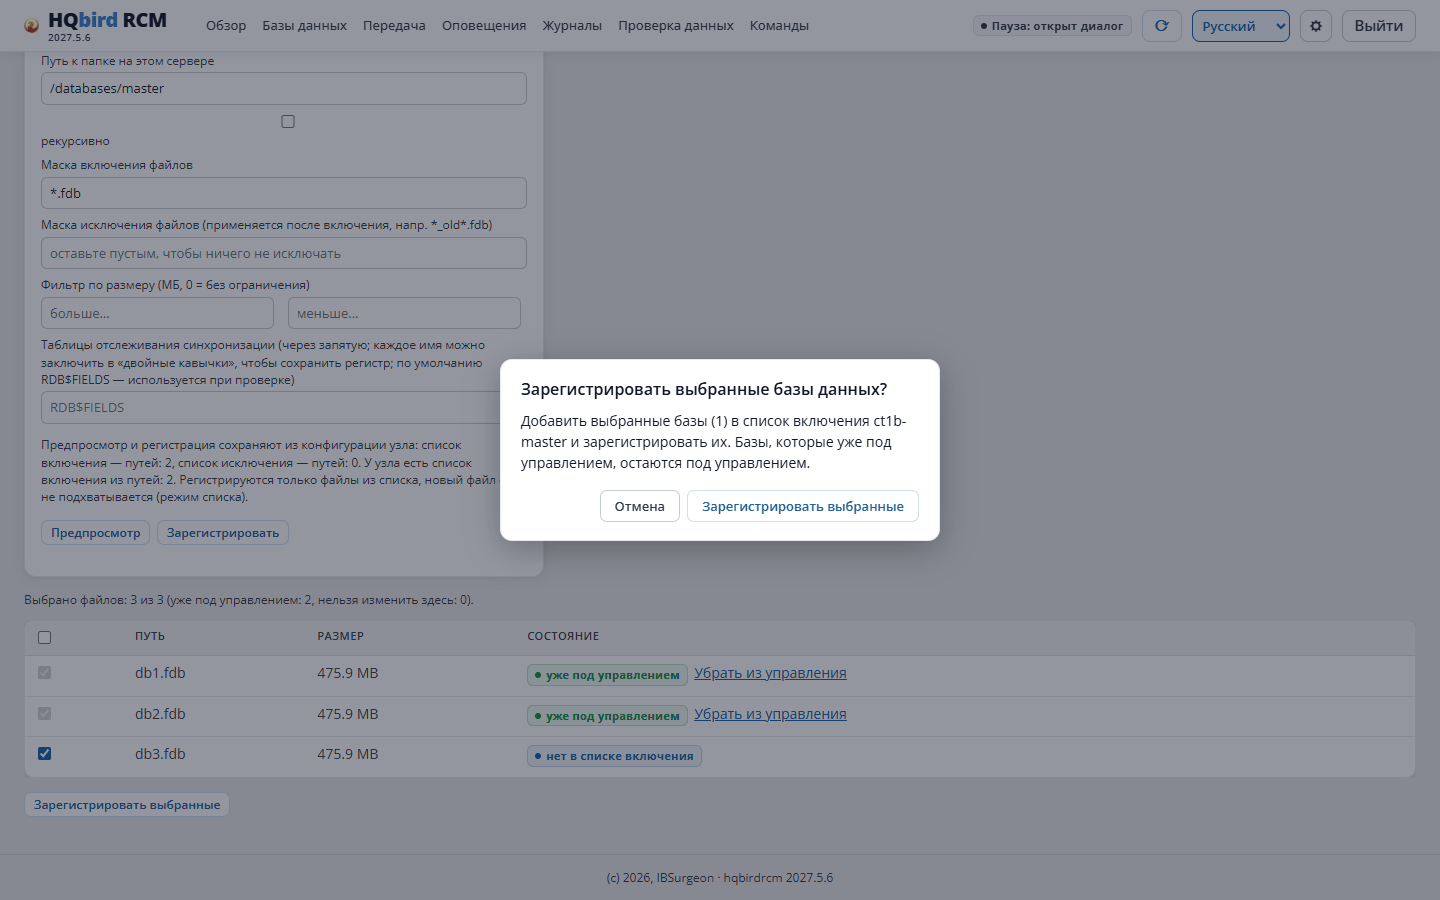
这个按钮做什么:
- 在模板模式中 — 没有复选框的文件被加入排除列表,有 复选框的文件从中移除;
- 在列表模式中 — 有复选框的文件被加入包含列表。
该按钮把数据库 添加 到已经受管理的那些。它不更改 锁定的行。 7. 登记 按钮应用表单,而不更改 列表。 8. 等待完成消息和添加的数据库数量。如果长时间 没有响应,在 命令 页上检查结果。
HQbird 2027.2.24 及以后,消息是“已登记:N”。如果主库的 Firebird 需要重启,RCM 会说明按哪个按钮(通常是 数据库行中的 重启主库 Firebird)并提供到主库 数据库的链接。 RCM 2027.5.7 可能会说“没有新的合适数据库”,即使数据库 已经添加:检查 数据库 页。
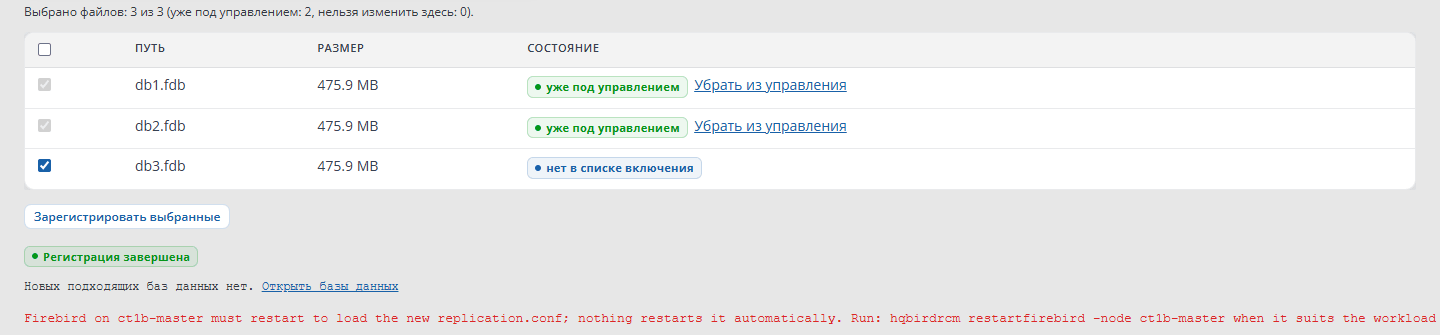
如果登记之后没有找到数据库,但节点上已经有数据库,节点
会拒绝(409)并返回旧规则。这样,路径错误不会停用
所有数据库的复制。
命令行上同样可以做
hqbirdrcm enroll-databases -node node-a -root /databases/master注意:该命令只发送其参数中的字段。其余 规则(掩码、大小、包含和排除列表、
sync_tables)会被节点 重置。 该命令没有这些规则的参数。在 运行命令之前,检查当前规则(hqbirdrcm getconfig -node node-a)。如果 它们已设置,使用登记页。
3.4. 登记之后发生什么
- 节点把规则写入
node.json。 - 节点扫描文件夹(scansync)。
- 对找到的每个数据库,节点在
replication.conf的 自己的 区域中写入一块 (在行# BEGIN managed-by:node-a role:master和# END …之间),并创建文件夹<database>.ReplLog和<database>.LogArch。节点不修改自己区域之外的文本。 - 在更改之前,节点保存文件副本:
replication_YYYYMMDD_hhmmss_NNN.conf。 - 如果
replication.conf已更改,数据库进入PENDING_RESTART状态:Firebird 只有在 重启之后才会读取新文件。在 节点 表中,这显示在 等待 重启 列。
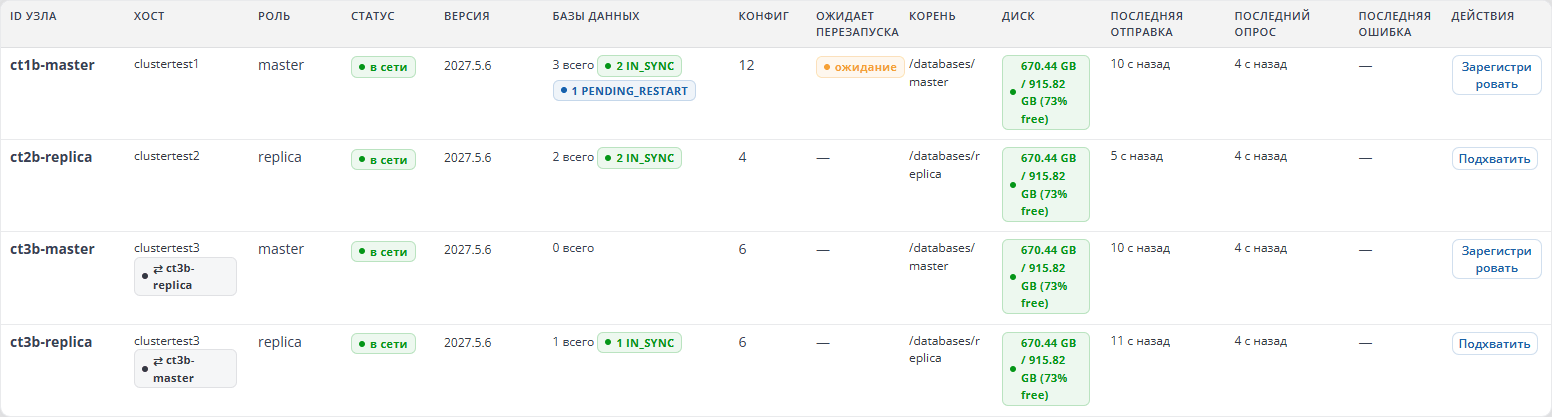
新数据库的状态:
| 状态 | RCM 中的组 | 含义 |
|---|---|---|
UNCONFIGURED |
待处理 | 已找到数据库,配置尚未写入 |
PENDING_RESTART |
待处理 | 配置已写入,需要重启 Firebird |
CONFIGURED |
待处理 | Firebird 已重启,数据库可以发布和初始化 |
3.5. 重启主库的 Firebird
主节点从不自己重启 Firebird。RCM 也不。 重启 主库是操作员的决定:重启会断开该 Firebird 实例 所有 数据库的全部连接。
选择低负载时间,并单击其中一个按钮:
- 重启主库 Firebird — 在 数据库 页上,等待重启的 数据库的主库所在行;
- 初始化 窗口中的同一按钮,第 5 章;
- 重启 Firebird — 在数据库页上。
RCM 会要求确认。它显示节点名和警告:Firebird 将立即重启,没有重启窗口,所有连接都会断开。
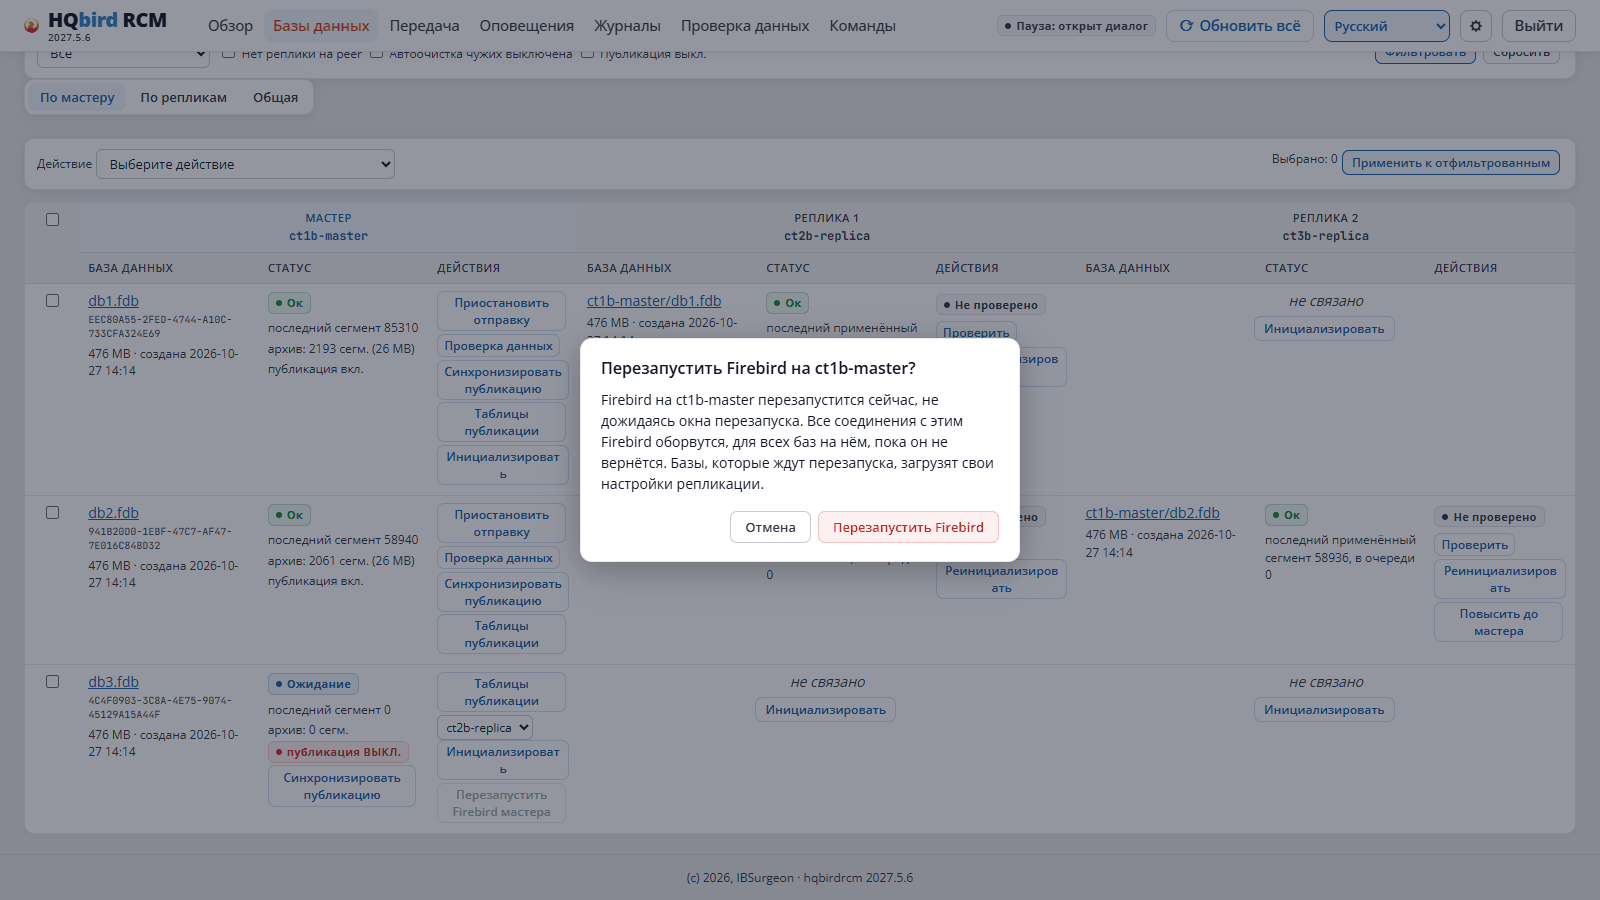
命令行上同样可以做
hqbirdrcm restartfirebird -node node-a该命令也是立即重启,没有重启窗口。
节点如何重启 Firebird:
- 检查 fbagent 是否响应,并且管理的是 同一个 实例
(
node.json中的标识符、端口、服务名)。如果任何值不 匹配,节点拒绝。 - 请求 fbagent 重启 Firebird。
- 等待 Firebird 在其端口上响应。
- 把数据库从
PENDING_RESTART移到CONFIGURED。
一台主机上的多个 HQbird 实例。 fbagent 重启其配置中
firebird.update.services列出的服务。空列表表示主机上的 全部 HQbird 服务。如果主机上有两个 HQbird 实例,列表中只 保留你这个实例的服务。否则,重启一个节点 也会停止另一个实例。
在 Windows 上。 如果
replication.log已增长到log_portion_mb或更大, 重启按以下进行:停止 Firebird → 归档日志 → 启动。
3.6. 已经手动复制的数据库
如果数据库的复制已经手动配置(replication.conf 中有自己的块、
发布已启用、段在流动),可以 不 重新初始化副本就把它纳入
管理。为此有
detect_existing 模式(仅主节点)。
-
运行预览:
hqbirdrcm enroll-databases -node node-a -root /databases/master -detect-existing -dry-run响应中,
taken_over列出将要迁移的数据库。加上-verbose可看到被跳过的数据库及原因。 -
如果列表正确,不带
-dry-run运行该命令。
节点只在以下条件都满足时迁移一块:
- 段文件夹的名称恰好是
<database>.ReplLog和<database>.LogArch; - 归档中已经有段;
- 数据库中已启用发布。
节点不迁移路径不同的块,并把它报告为“已找到但 不受支持”。
迁移之后数据库得到 PENDING_RESTART,尽管复制设置
没有更改:只是块在文件中的位置变了。在
维护窗口中重启 Firebird。
3.7. 如何验证
-
数据库: 数据库出现在主节点行中,状态
CONFIGURED(重启之后)。 -
数据库旁边可能有 发布关闭 图标:发布尚未 启用。这是正常的,发布是下一步(第 6 章)。
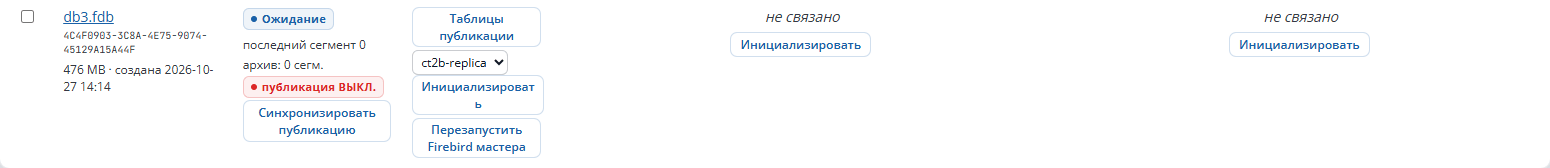
主库行中的新数据库
- 在节点主机上:
replication.conf的managed-by:node-a区域内有该数据库块,数据库旁边有.ReplLog和.LogArch文件夹。
3.8. 把数据库移出管理
通常的方式是按钮。 在 数据库 页上勾选数据库, 选择批量操作 移出管理 并 单击 应用到所选。RCM:
- 把文件加入节点的排除列表;
- 扫描文件夹一次:数据库块从
replication.conf中删除; - 删除节点中的数据库记录。
数据库文件和段文件夹留在磁盘上。Firebird 不重启。 Firebird 会继续写该数据库的段,直到下次重启; 如果需要重启,RCM 会说明。
对于有活动副本的主库数据库,RCM 会拒绝(has_replicas):
否则副本会悄悄停止。先把副本变成普通数据库或
删除它(第 8 章)。
不要手动从 replication.conf 中删除数据库块:下次
扫描时节点会再次写入它。
如果数据库文件消失了,或被规则排除了。 这时数据库得到
状态 ORPHANED(孤立组)。节点保留其记录和段
归档:数据库缺失更常见的是失误,而不是决定。如果文件回来,数据库
再次工作,警报清除。要永久删除这样的数据库,
按 这个顺序 做两步:
# 1. delete the segment archive (optional)
hqbirdrcm cleanuparchive -node node-a -db <db_id> -orphaned
# 2. delete the database record
hqbirdrcm forgetdatabase -node node-a -db <db_id>
forgetdatabase 之后,cleanuparchive 命令将不再找到该数据库。两条
命令只对处于 ORPHANED 状态的数据库有效,并且 不触碰数据库
文件。
注意。 把副本提升为主节点之后(第 8 章),不要对旧记录运行
cleanuparchive -orphaned:新主节点使用同一个.LogArch文件夹,该命令会删除它的工作归档。
3.9. 更改数据库根
允许用不同路径登记。节点:
- 添加新文件夹中的数据库;
- 把旧文件夹中、新文件夹里没有的数据库移到
ORPHANED(通知orphaned_database)并保留它们的归档。
如果选错了文件夹,再次登记正确的文件夹。完整路径
相同的数据库会继续在同一个 db_id 下运行。路径 不同 的数据库
是新数据库(新的 db_id);它的副本必须重新初始化。
3.10. 常见错误
| 你看到的 | 原因 | 怎么办 |
|---|---|---|
preflight failed on node-a |
文件夹没有权限 | 修正权限,重试(3.2) |
409 scan_would_empty_region |
新文件夹中没有数据库,但节点上原来有 | 检查路径和掩码 |
| 预览为空 | 掩码不匹配或文件夹不对 | 检查路径、掩码、“递归” |
| 按钮被禁用,“未能读取节点配置” | 节点没有响应 | 检查节点服务和网络(第 1 章) |
数据库长时间停留在 PENDING_RESTART |
主节点不自己重启 Firebird | 重启 Firebird(3.5) |
| 因 fbagent 而拒绝重启 | fbagent 没有运行,或其数据与 node.json 不符 |
第 1 章,检查 fbagent |
| 新文件没有出现 | 节点处于列表模式 | 通过“登记所选”添加该文件 |
4. 如何把数据库做成副本:步骤与磁盘位置
本章覆盖数据库从主库到可用副本的全过程,以及磁盘空间计算。初始化本身在 第 5 章 详细说明。
4.1. 主要规则
数据库出现在副本上 只能 通过来自主节点的初始化(reinit):
主节点自己通过 nbackup 传输副本。
不要手动制作副本:
- gbak 会创建新的数据库 GUID 并重置段号。主库 — 副本链接会断开。
- 正在运行的数据库的 文件复制 不一致,RCM 会看到两个 GUID 相同的数据库
(
duplicate_guid)并禁止初始化。
已经在运行、手动配置的副本可以纳入 管理而不做新副本 — 见 4.6。
4.2. 阶段
| 序号 | 阶段 | 何处 | 该阶段之后的主库数据库状态 |
|---|---|---|---|
| 1 | 在主节点上登记数据库 | 第 3.3 章 | PENDING_RESTART |
| 2 | 重启主库的 Firebird | 第 3.5 章 | CONFIGURED |
| 3 | 同步发布 | 第 6 章 | CONFIGURED,发布开启 |
| 4 | 准备副本:文件夹、权限、Firebird 版本 | 4.3 | — |
| 5 | 检查主节点和副本上的空闲空间 | 4.4 | — |
| 6 | 初始化 | 第 5 章 | SEEDING → IN_SYNC |
| 7 | 重启副本的 Firebird(如需要) | 第 5.6 章 | 副本开始应用段 |
| 8 | 验证数据 | 第 5.10 章 | — |
阶段 3 对 Firebird 4/5 是必须的。 没有发布时,主库的 Firebird 不把 表变更写入段,副本会悄悄落后于主库。在 数据库 页上,这样的数据库标有 发布关闭 图标。在初始化之前单击 同步发布(Sync publication)。
自 HQbird 2027.2.24 起,初始化 窗口会对此警告,并
提供 同步发布并初始化 按钮,而主
节点会以错误 publication_off 拒绝初始化(第 5.1 章)。
RCM 和节点 2027.5.7 不检查发布。
HQbird 2.5/3.0。 没有发布,因此跳过阶段 3。表集合由 replconf 插件过滤器定义(第 6 章)。
数据库状态:
| 状态 | RCM 中的组 | 含义 |
|---|---|---|
CONFIGURED |
待处理 | Firebird 已读取设置,还没有副本 |
PUBLISHING |
待处理 | 正在同步发布 |
SEEDING |
待处理 | 正在初始化 |
IN_SYNC |
正常 | 副本已收到全部段 |
LAGGING |
待处理 | 副本滞后,段在排队 |
NEEDS_REINIT |
错误 | 副本必须重新初始化 |
FAILED |
错误 | 上次初始化失败 |
4.3. 准备副本
副本数据库文件夹
副本节点把每个数据库放在自己的 databases.root 文件夹中,路径为:
<databases.root>/<master node name>/<database path relative to the master root>示例:主节点 node-a 的根是 /databases/master,数据库是
/databases/master/sales/employee.fdb。在根为
/databases/replica 的副本 node-b 上,数据库将在这里:
/databases/replica/node-a/sales/employee.fdb这样,来自不同主节点、名称相同的数据库不会冲突。
没有人自动创建根文件夹 — 安装程序不会,HQCenter Admin 不会,节点在 启动时也不会。用下列方式之一创建:
-
在 初始化 窗口中:副本文件夹 字段, 创建文件夹 按钮。按钮只在文件夹不存在时可见。HQbird 2027.2.24 起, 如果副本节点还没有
databases.root,字段中已经是/databases/replica/<副本节点 id>。Windows 上的副本该字段为空: 输入带盘符的文件夹。同一主机上的每个副本节点需要自己的 文件夹。文件夹由副本 节点创建:所有者 —firebird(或节点服务用户),权限2770。如果节点无法创建,窗口会显示副本 主机上的命令。如果指定了不同的文件夹,RCM 会在初始化之前把它写入副本节点的databases.root; -
在副本主机上手动(Linux):
sudo mkdir -p /databases/replica sudo chown firebird:firebird /databases/replica sudo chmod 2770 /databases/replicasetgid位(2770)是为了让里面的所有文件得到 Firebird 组。
只有在副本根中还没有数据库时才能更改它:否则旧数据库 会落在扫描之外。要把单个数据库放到不同位置,在 数据库页上使用 移动。
权限
副本节点和 Firebird 必须能写入数据库根。节点检查
放置的文件会得到该文件夹的组。如果不能 — 它以
ownership_unfixable 拒绝,并给出如何修正的文字(通常是节点服务以
Group=root 运行)。
自 HQbird 2027.2.24 起,初始化 窗口也会显示已存在、
但节点服务无法写入的文件夹:节点的文字、修正
命令和 再次检查 按钮。这种情况下 RCM 2027.5.7 会说
“文件夹已存在”:自己检查权限(hqbirdrcm checkpermissions -node <replica> -root <folder>)。
Firebird 版本
副本上的 Firebird 主版本必须与主库一致(5.0 → 5.0,
4.0 → 4.0)。否则副本会在任何数据传输之前拒绝:
incompatible_engine。
连通性
副本节点必须是主节点的对等方,主节点也必须是副本的对等方(第 2 章)。 否则 RCM 不会在 初始化 窗口中提供该节点。
4.4. 需要多少空间
简要
| 何处 | 什么 | 多少 |
|---|---|---|
| 主节点,数据库卷 | 初始化前的空闲 | ≥ 数据库大小的 105% |
| 副本,数据库文件夹卷 | 初始化前的空闲 | ≥ 数据库大小的 105%,HQbird 2027.2.24 起 — 再加上 free_space_floor_gb(如果副本已经存在,还要加上旧文件;勾选 删除旧副本 则不加) |
主节点,<database>.ReplLog |
Firebird 工作段 | 最多 64 个段 × 段大小(默认 16 MB)≈ 每个数据库 1 GB |
主节点,<database>.LogArch |
供副本使用的段归档 | retention_days 期间的变更(默认 2 天)+ 副本尚未确认的部分 |
副本,<database>.Incoming |
待应用的段队列 | 最坏情况下最多 256 个段 × 16 MB ≈ 每个数据库 4 GB |
| 副本,整个卷 | 余量 | 至少 free_space_floor_gb(默认 1 GB) |
初始化前检查空间
初始化 两次 检查空间,并且只在锁定数据库 之前:
- RCM — 根据最新的节点统计,在发送命令之前。如果空间
明显不足,RCM 立即返回错误
507。 - 主节点 — 在自己的卷上实时测量,然后请求副本
测量自己的。如果至少一侧不够,初始化
在 SPACE CHECK 步骤以错误
insufficient disk space on master或… on replica结束。
两侧的要求都是 主库数据库大小的 105%。
HQbird 2027.2.24 起,副本节点这样计算:
- 它需要数据库大小的 105% 加上 副本的
free_space_floor_gb(7.3): 初始化之后卷上仍为段留有储备; - 先前初始化的残留(
<database>.hqcluster-part、<database>.new) 算作空闲空间:节点在新副本之前删除它们; - 错误文本列出所有数字。它也列出文件
<database>.pre-reinit-*.fdb和<database>.failed-seed-*.fdb及其大小。节点 从不删除它们:如果不需要,自己删除。
force(强制)只跳过 RCM 中的检查。节点检查
不能绕过:它保护节点,避免在复制中途磁盘耗尽。
如果空间不足只是因为旧副本,RCM 2027.2.24 在
错误 507 中指出 删除旧副本 复选框,而不是 force。为此,
两个节点都必须是 HQbird 2027.2.24 或更新。否则错误会指出
需要更新的节点,以及 force。
为什么需要这么多
主节点。 复制期间数据库被 nbackup -L 锁定。所有
变更写入数据库旁边的 <database>.delta 文件。.delta 的大小取决于
复制期间的写入负载。负载重、传输慢时
它会增长很多 — 在第一次
初始化期间留意空间。
副本。 副本直接写到数据库位置旁边的 <database>.hqcluster-part 文件。节点预先保留全部大小。然后检查该文件,
修复(nbackup -FIXUP -SEQUENCE)并重命名到位。不需要第二份
副本 — 数据库大小在数据库卷上只需要一次。
如果副本 已经存在(重复初始化),旧文件会留在 磁盘上直到最后一步。这意味着卷上同时需要旧文件和新副本。空闲空间的计算不含旧文件 — 因此要求 相同:空闲为数据库大小的 105%。
删除旧副本(HQbird 2027.2.24 起)。如果副本卷上没有空间
让新副本放在旧副本旁边,在初始化
窗口中勾选此复选框(第 5.1 章)。然后副本节点在传输之前删除旧副本及其
传入段(.Incoming),卷上就够数据库大小的 105%
加上 free_space_floor_gb。节点只在以下条件全部为真时删除副本:
- 不删除则空间不够,删除则够;
- 它是本节点初始化安装的副本:文件头 可读,模式是只读副本;
- 数据库还没有被做成普通库(没有文件
<database>.hqcluster-normal.json,第 8 章); - 没有设置
overwrite_non_replica(5.9)。
否则节点什么都不删除,并在文本中给出原因后拒绝。要删除, 节点会在删除期间停止副本的 Firebird(5.6)。
该复选框默认关闭。风险: 传输进行期间,副本上没有
数据库副本。如果数据库只有一个副本,主库在
整个期间不受保护。在没有新副本时,副本上的数据库处于 NEEDS_REINIT 状态(不是 FAILED,也
不是 ORPHANED),副本发出警报 replica_removed_for_reinit
(warn)。新副本就位后,警报清除。如果删除之后初始化
失败,这一对保持 NEEDS_REINIT:再次
启动初始化(或自动重新初始化会启动它,5.8)。
新的初始化从头传输数据库。
主节点归档(.LogArch)。 节点把已发送的段保留
retention_days 天,以便副本可以再次请求它们。副本
尚未应用的段会保留更久。如果空间紧张,节点
分阶段清理归档:
- 所有副本都已应用、且早于
retention_days的段; - 较新的已应用段(空间紧张时);
- 未应用 的段 — 只作为最后手段。然后副本
会丢失它需要的段并得到
NEEDS_REINIT。
如果副本长时间不可用,归档会增长。它的体积 = 停机期间的数据库变更。
计算示例
数据库 100 GB。负载 — 每天 5 GB 段。初始化在
夜间运行,复制需要 2 小时,其间大约
2 GB 进入 .delta。
| 何处 | 计算 | 空闲合计 |
|---|---|---|
| 主节点,数据库卷 | 检查用 105 GB(含 .delta 增长)+ .ReplLog 1 GB + .LogArch 2 天 × 5 GB = 10 GB |
≥ 116 GB |
| 副本,新数据库 | 105 GB + .Incoming 最多 4 GB + 1 GB 储备 |
≥ 110 GB |
| 副本,重复初始化 | 旧文件 100 GB 已在磁盘上 + 110 GB 空闲 | 卷 ≥ 210 GB |
| 副本,勾选 删除旧副本 的重复初始化(HQbird 2027.2.24 起) | 传输前删除旧文件:105 GB + .Incoming 最多 4 GB + 1 GB 储备 |
卷 ≥ 110 GB |
为数据库增长和副本停机留出储备(主节点归档按 停机每天 5 GB 增长)。
单独卷上的段
.ReplLog、.LogArch 和 .Incoming 文件夹默认位于数据库旁边。
可以把它们移到另一个卷:node.json 中的参数 segments.storage
(mirror_hierarchy: true 时节点复制数据库文件夹的结构)。然后
归档不会占用数据库的空间。105% 检查仍然针对数据库卷。
在何处查看空间
-
数据库 → 节点 和 概览:
databases.root卷的空闲空间图标。黄色 — 少于 20%,红色 — 少于 10%。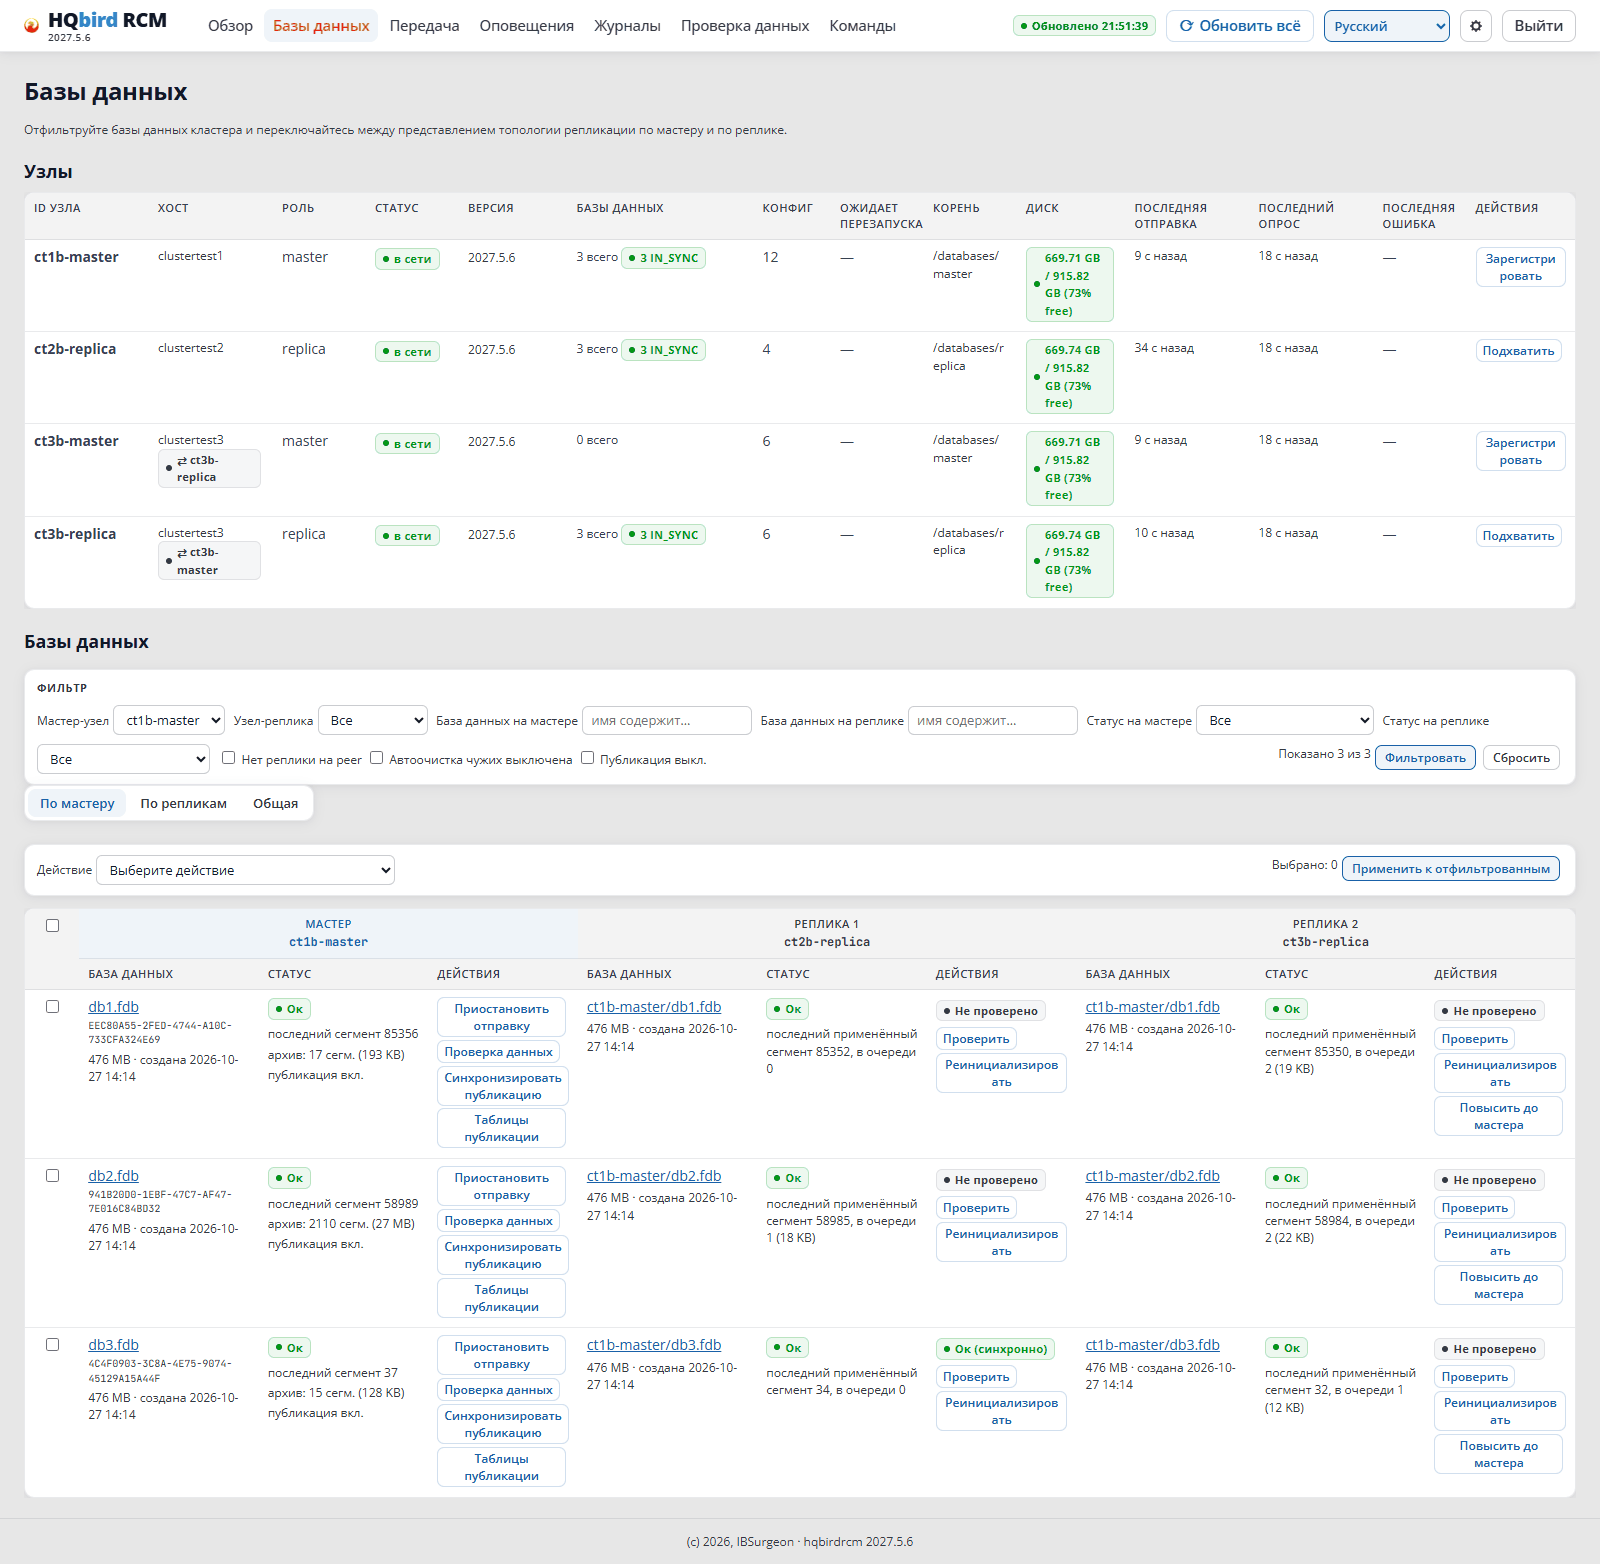
数据库页:节点表中的磁盘列
- 群集报告:
hqbirdrcm report。
4.5. 一个数据库的多个副本
第二个及以后的副本以同样方式创建:在主库行中 初始化,选择空闲的副本节点。
- 新副本正在初始化时,主节点也 不向 已经在运行的副本传输该数据库。它们会在初始化结束后追上主库。确认窗口会说明这一点。
- 一个数据库同一时间只有一个初始化,即使是不同的副本。
- 主节点上的空间对每次初始化单独检查。
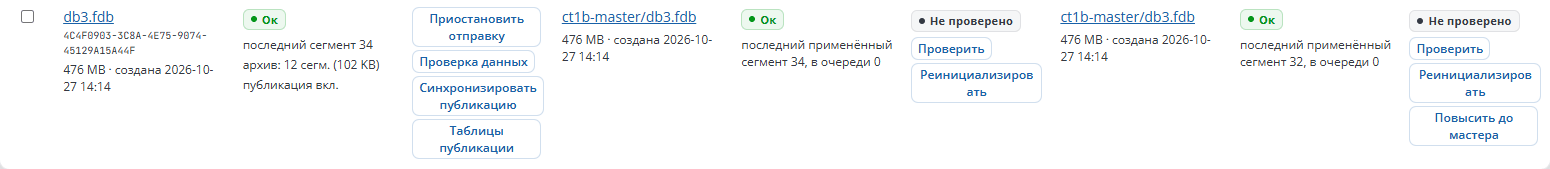
4.6. 手动配置的副本
如果副本已经从手写的 replication.conf 运行,可以把它纳入管理并且 不再复制 数据库:
- 主节点: 用
detect_existing登记数据库(第 3.6 章)。 - 副本: 数据库 → 副本节点 → 接管,或
hqbirdrcm takeover-replica。RCM 会找到副本块,按 GUID 把文件与主库数据库匹配,并为每一个显示:in_sync、resumable或needs_reinit。 - 确认这些行。节点会把块移到自己的
replication.conf区域。 - 重启副本的 Firebird,以便它读取移过去的块。
- 只 初始化
needs_reinit行:主节点归档中已不再有这些副本所需的段。
4.7. 常见错误
| 你看到的 | 原因 | 怎么办 |
|---|---|---|
insufficient disk space on master / on replica |
空间不够(4.4)。重新初始化时旧副本一直占用空间直到结束(4.4) | 腾出空间,重试。副本上的第二种出路(自 HQbird 2027.2.24 起)是 删除旧副本 复选框(4.4、5.1) |
RCM 立即返回 507 |
按空间统计明显不够 | 同样。如果去掉旧副本就有空间,RCM 2027.2.24 会指出复选框 删除旧副本 |
incompatible_engine |
Firebird 主版本不同 | 升级副本的 Firebird |
| 副本节点上缺少文件夹 | 根未创建 | 在初始化窗口中 创建文件夹(4.3) |
| 文件夹存在,但节点服务无法写入(自 HQbird 2027.2.24 起) | 没有写权限 | 运行窗口中的命令,单击 再次检查(4.3) |
publication_off(自 HQbird 2027.2.24 起) |
主库的发布已禁用或没有表 | 同步发布并初始化(5.1) |
ownership_unfixable |
节点服务的组不对 | 按错误文本修正服务组 |
duplicate_guid |
两个数据库 GUID 相同(文件复制) | 删除副本或给它新 GUID(nbackup -F) |
| 副本节点不在 初始化 列表中 | 对等方中没有连接 | 第 2 章 |
副本 IN_SYNC,但数据不一致 |
发布曾被禁用 | 同步发布,然后重复初始化 |
5. 初始化(reinit)
初始化是把主库数据库的副本传到副本。第一次传输 称为 初始化(初始化 按钮),重复传输是 重新初始化(重新初始化 按钮)。机制相同。
开始之前,完成 第 4 章 的步骤 1–5: 数据库已登记,主库的 Firebird 已重启,发布已启用, 副本文件夹存在,并且空间足够。主节点和 副本上需要多少空间在 第 4.4 章 说明。
5.1. 如何开始
先做发布。 登记数据库并不包含发布。没有 发布时,副本收不到变更。初始化之前,运行 同步发布(第 6 章)或
hqbirdrcm setpublication -node <master>。
- HQbird 2027.2.24 起,初始化窗口检查发布。如果 它关闭或没有带键的表,窗口显示 警告和 同步发布并 初始化 按钮。RCM 同步发布,等待命令结束,并 用窗口中的选择启动初始化。
- 2027.2.24 的主节点自己拒绝这样的初始化(第一次 也一样),错误是
publication_off,并发出通知master_publication_off(第 6.1 章)。拒绝之后,数据库单元格再次 有 同步发布并初始化 按钮。- 如果操作员关闭了发布(6.4)或从中移除了所有带 键的表(6.3),同步会保留这一点。RCM 不启动 初始化,并提供到 发布表 页的链接。
- RCM 和节点 2027.5.7 不检查发布:初始化 成功,数据库在 RCM 中显示“正常”,但副本收不到变更。如果 发布是在初始化之后打开的 — 重新初始化该数据库。
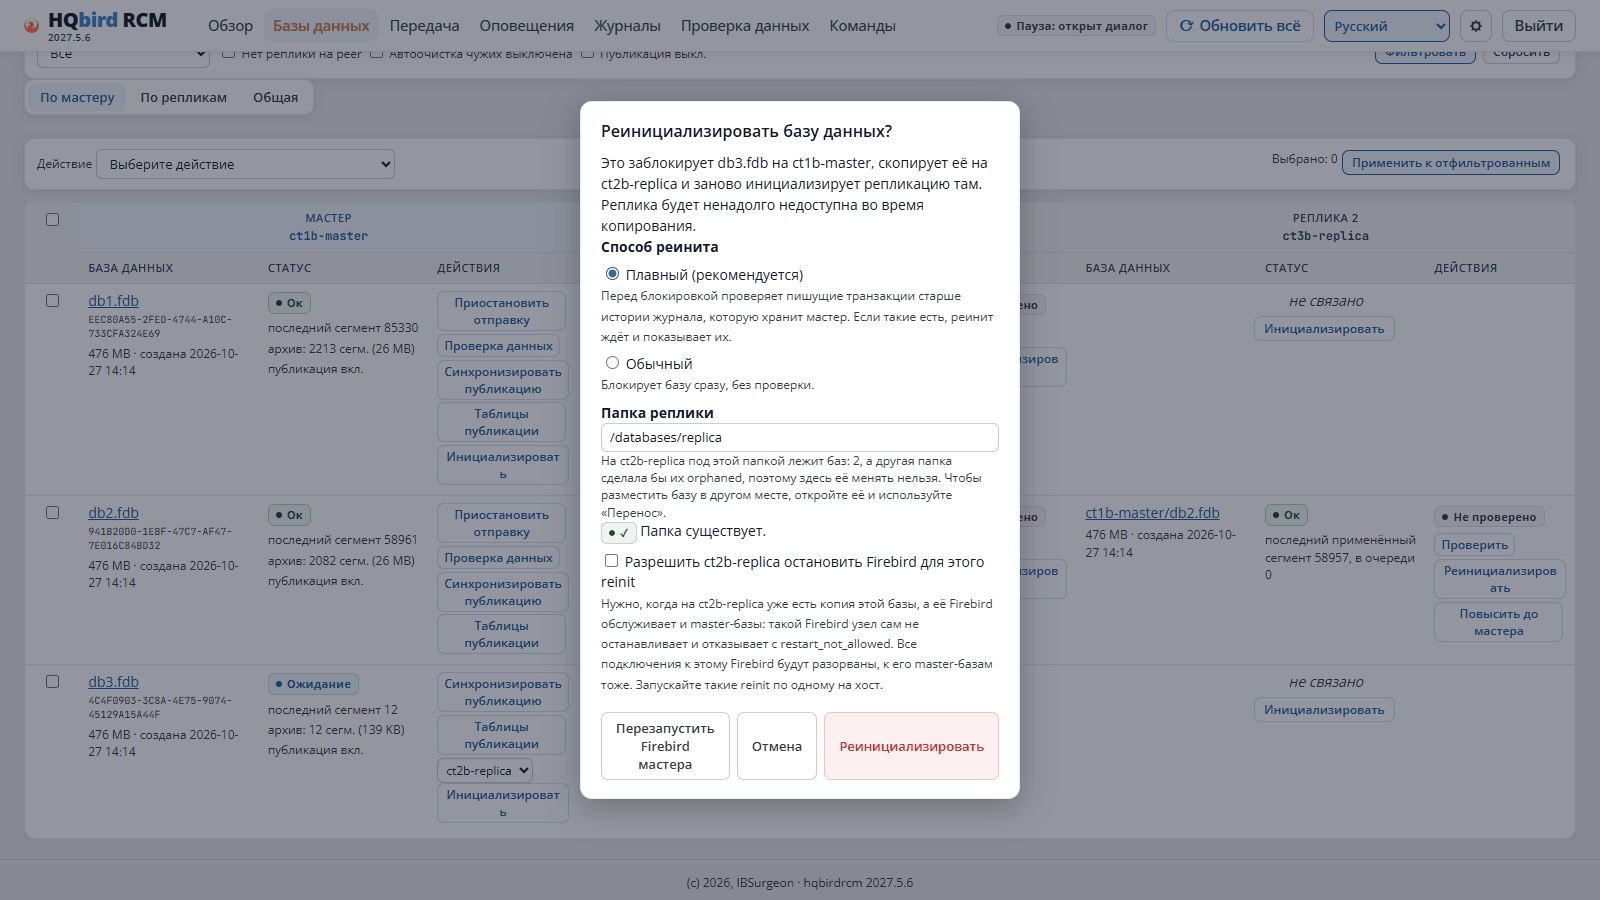
- 打开 数据库。
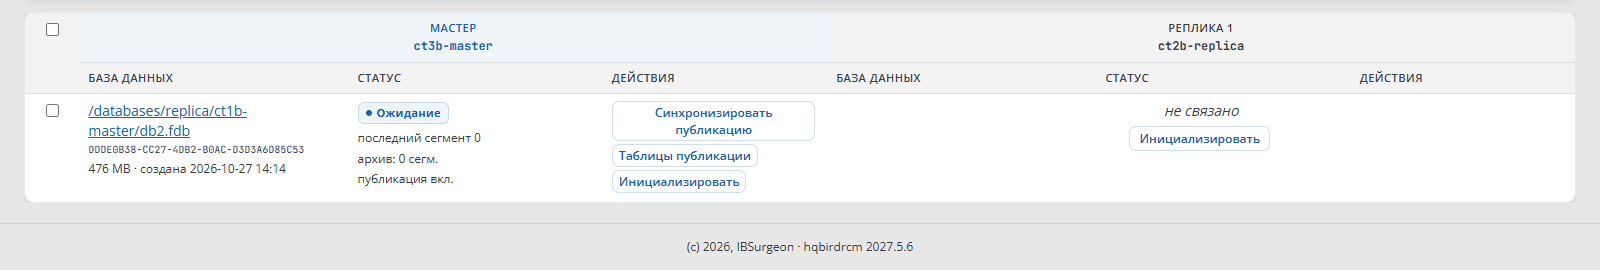
- 在主库数据库行中,在副本节点列单击 初始化 (Initialize)。副本节点由列决定:不在窗口中选择。对于 已有的一对 — 在展开的主库卡片中 重新初始化。
- 在窗口中(HQbird 2027.2.24 起,新一对的标题是“初始化
数据库?”;在 RCM 2027.5.7 中是“重新初始化数据库?”,第一次
初始化也是):
- 检查 副本文件夹。窗口显示文件夹是否存在。如果 不存在,单击 创建文件夹:副本节点会创建它(4.3)。如果节点 无法创建,窗口显示副本主机上的命令。HQbird 2027.2.24 起,窗口也会显示节点服务无法 写入的文件夹:修正命令和 再次检查 按钮;
- 选择 重新初始化方法:平滑(推荐)或 标准 (5.4)。HQbird 2027.2.24 起,如果主节点归档中还没有段 (通常在第一次初始化之前),窗口显示提示:在 繁忙的数据库上 标准 更快;
- 如果主库数据库仍在等待 Firebird 重启,窗口会说明并 显示 重启主库 Firebird 按钮。没有重启,数据库 不会被复制;
- 删除旧副本(HQbird 2027.2.24 起,默认关闭) 只在重新初始化、且副本卷没有 空间让新副本放在旧副本旁边时需要(4.4)。窗口事先显示 数字:需要多少、空闲多少、旧副本占多少。 如果去掉旧副本就有空间,窗口会请你勾选该复选框。如果主节点或副本节点是旧版本,复选框 不可用:窗口说明 要更新哪个节点。在新副本就绪之前,副本上没有 该数据库的副本(4.4)。
- 确认。RCM 会说明数据库将在主库上被锁定并 复制到副本。
初始化进度在 数据库
页上展开的主库卡片中可见:步骤和百分比。HQbird 2027.2.24 起,刷新
页面后进度仍然可见:第一次初始化 — 在副本节点单元格中,也在
主库数据库页的 重新初始化进度 行中。
主节点正在复制数据库时,初始化 按钮不可用。如果 RCM 没有
跟踪这次初始化(例如它是从节点命令行启动的),
步骤取自节点状态,没有百分比。在 RCM 2027.5.7 中,刷新
页面后第一次初始化的进度不可见:等到主库
数据库离开 SEEDING。
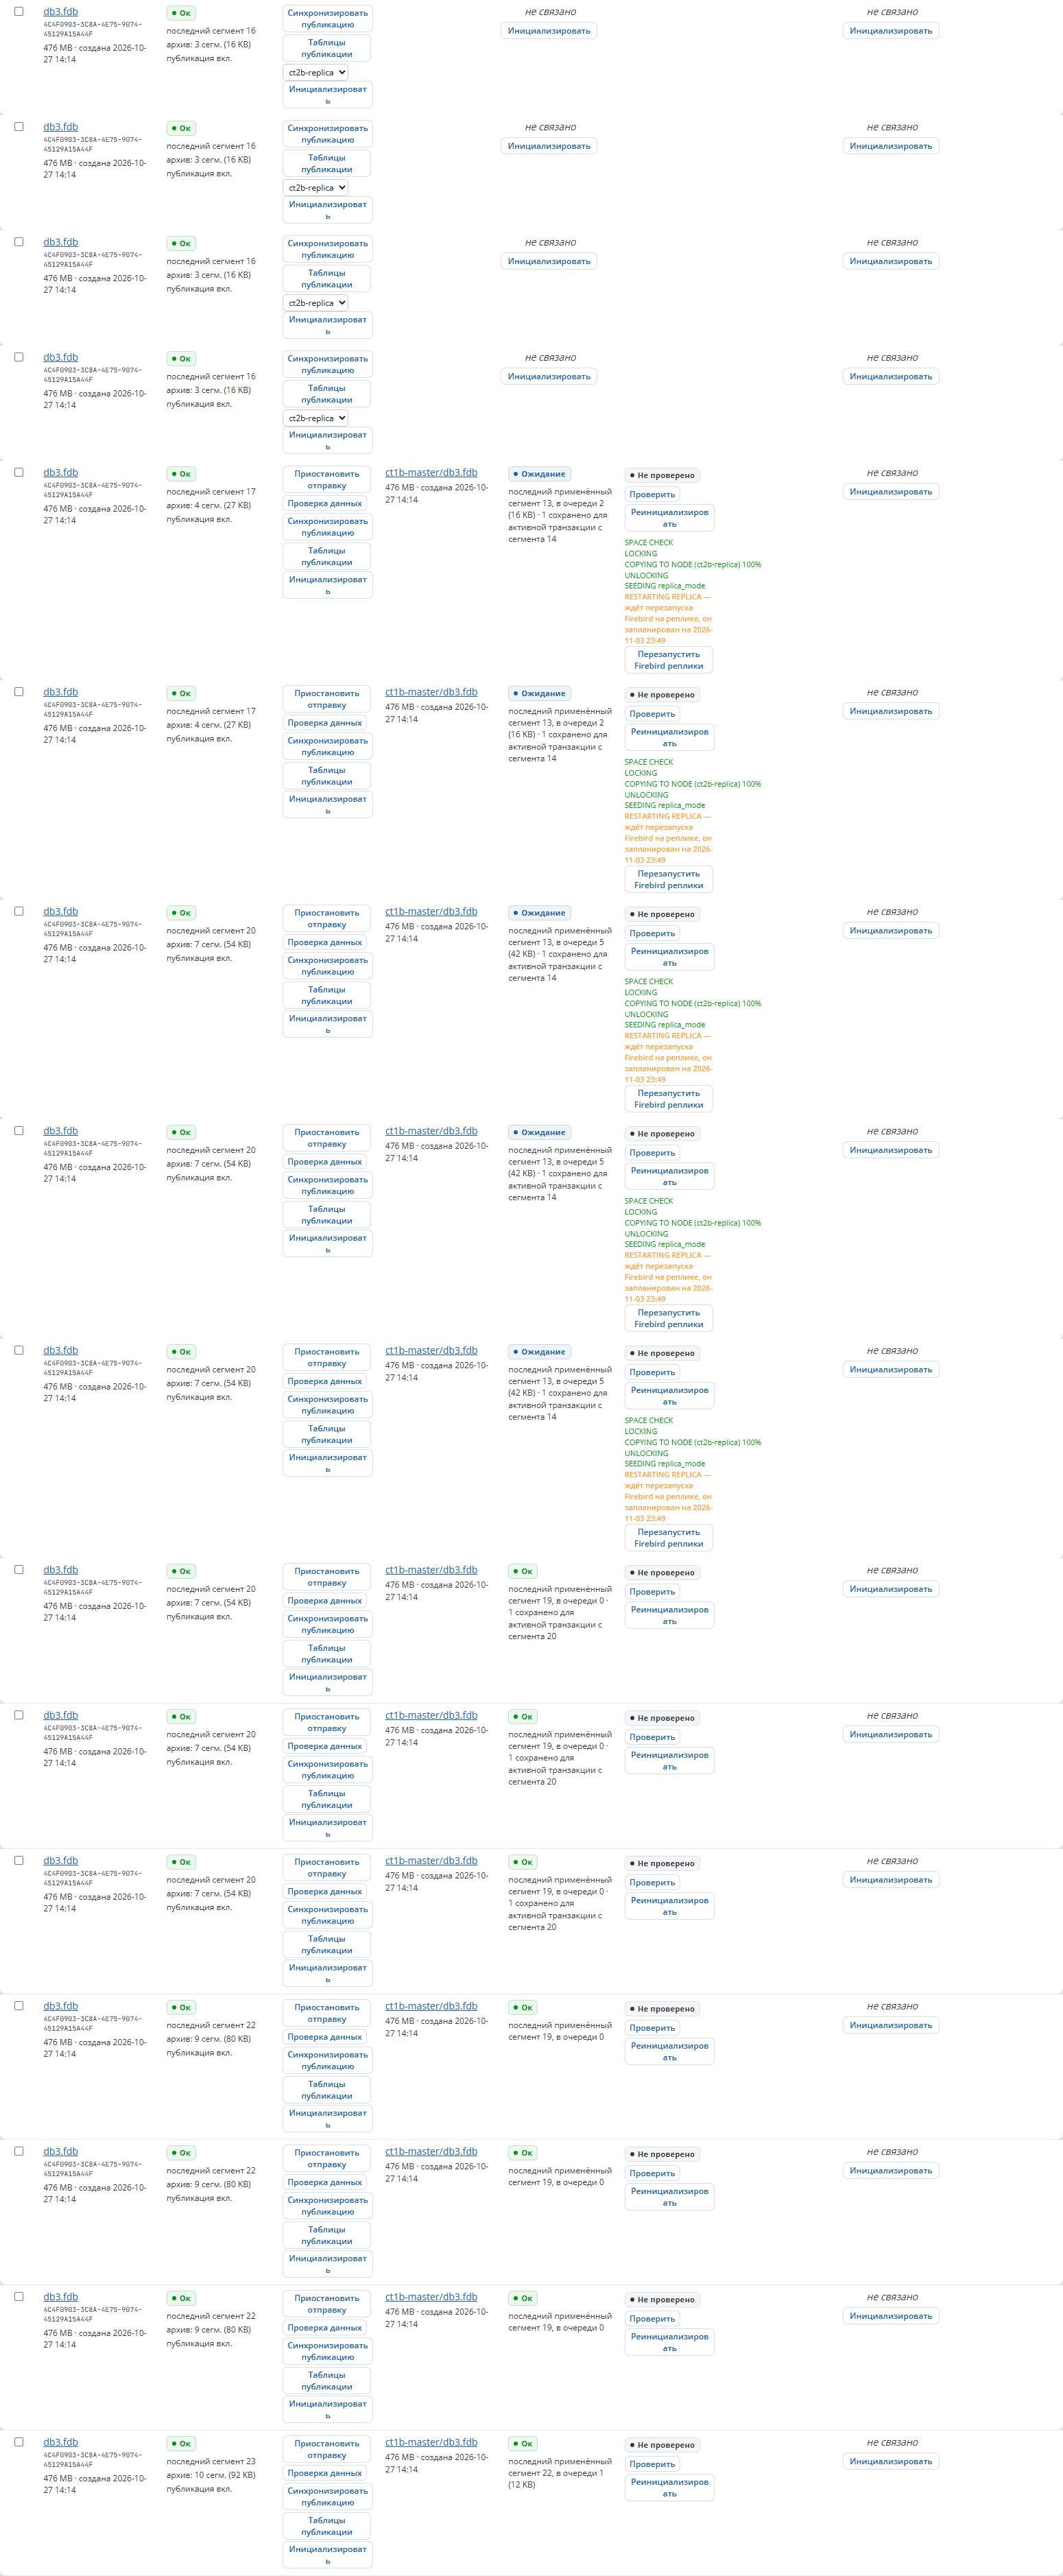
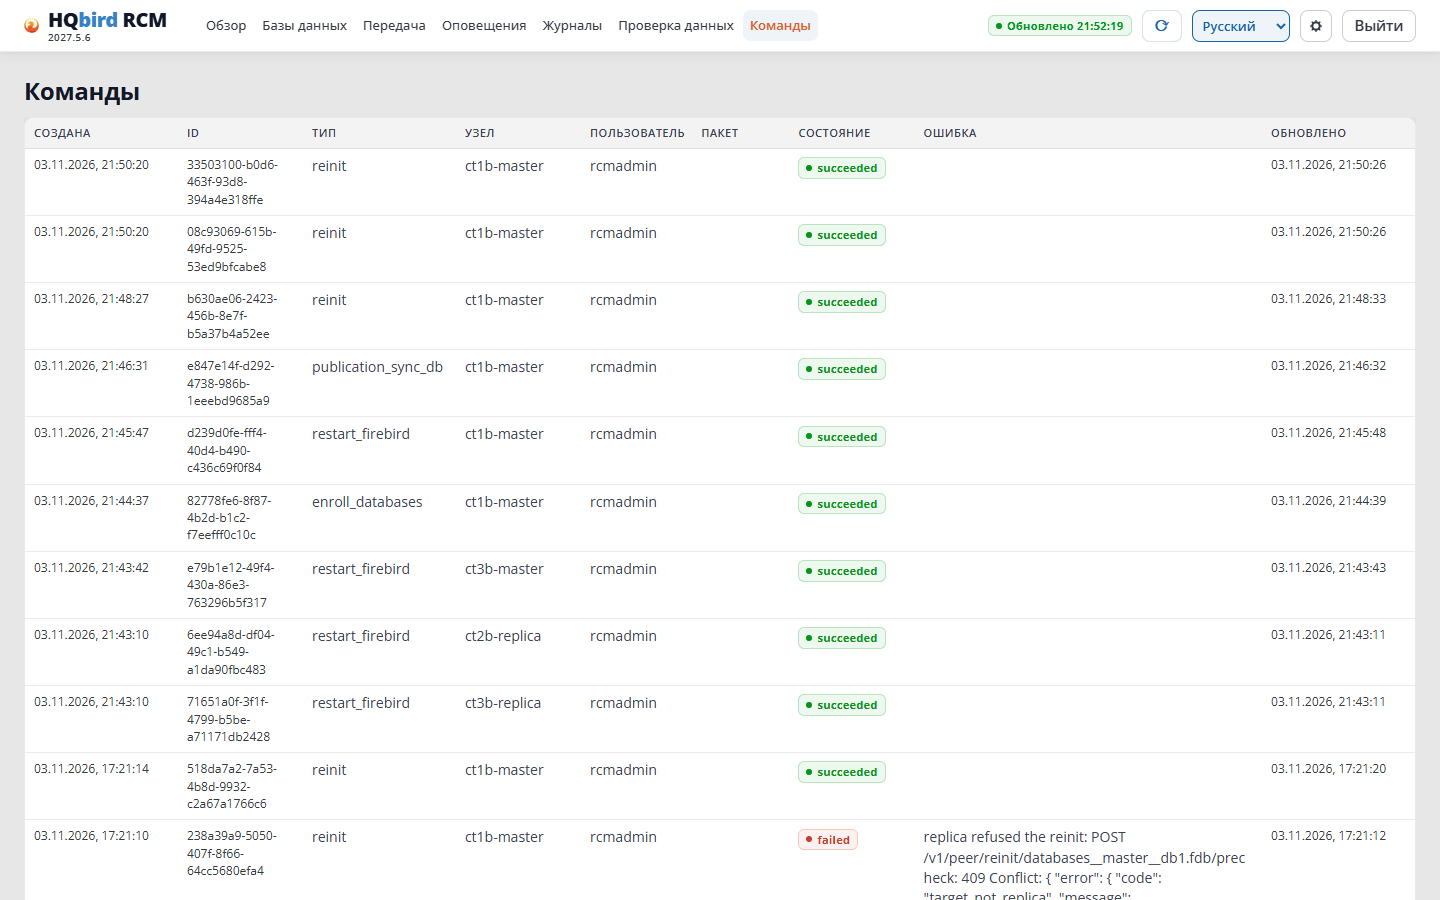
每条 RCM 命令(初始化、Firebird 重启、发布 同步)都连同结果记录在 命令 页上。
命令行上同样可以做
# one database
hqbirdrcm reinit -node node-a -db <db_id> -to node-b
# all master databases
hqbirdrcm reinit -node node-a -all -to node-b
参数:
-mode smooth|standard(默认smooth)、-hold=false(长事务期间不保留归档)、-allow-restart(5.6)、-force(5.9)。
-remove-old-replica(HQbird 2027.2.24 起)— 与 删除 旧副本 复选框相同。仅用于单个数据库:必须有-db和-to;带-all时命令拒绝。如果主节点或副本节点是旧版本,RCM 以node_too_old拒绝并且什么都不发送。hqbirdrcm reinit -node node-a -db <db_id> -to node-b -remove-old-replica
-all尝试所有数据库并收集错误,而不是在第一个错误处停止。
5.2. 步骤
| 序号 | 步骤(在 RCM 中) | 发生什么 |
|---|---|---|
| 1 | SPACE CHECK | 检查主节点和副本上的空间(第 4.4 章);副本事先检查自己能否接受该文件 |
| 2 | LOCKING | nbackup -L:主库数据库文件被冻结,变更进入 <database>.delta |
| 3 | COPYING TO NODE | 文件分块传输:读取 → 校验和 → 压缩 → 发送 |
| 4 | UNLOCKING | 传输之后立即 nbackup -N:.delta 中的变更回到数据库 |
| 5 | SEEDING | 在副本上:验证文件校验和、nbackup -FIXUP -SEQUENCE、安装文件、gfix -replica、把块写入 replication.conf |
| 6 | RESTARTING REPLICA | 重启副本的 Firebird,如果需要(5.6) |
步骤 6 之后数据库得到 IN_SYNC 状态。主节点继续从
副本结束的位置发送
段。
需要知道的:
- 主库一直在运行。 用户写入数据库,变更进入
.delta。锁在传输之后立即释放。 - 与锁定同时发生的事务不会丢失。 节点找出
nbackup -L时刻打开的事务,副本从 段中重放它们。 - 中断之后传输继续。 如果连接或副本节点
重启了,主节点会从最后收到的部分继续。未完成的
传输在副本上保留 24 小时(
reinit_partial_keep_hours)。 - 出错时 节点释放锁,删除副本上未完成的文件,
并把数据库设为
FAILED。下一次尝试从已知 状态开始。 - 勾选“删除旧副本”时(自 HQbird 2027.2.24 起)副本
在 LOCKING 步骤之后、传输之前删除旧副本。此时 COPYING TO
NODE 步骤显示“正在删除旧副本以腾出
空间”。删除之后的错误使这一对得到
NEEDS_REINIT而不是FAILED(第 4.4 章)。 - 只用
nbackup。 不使用 gbak:它会改变数据库 GUID。
5.3. 对运行的影响
| 什么 | 影响 |
|---|---|
| 主库的用户 | 继续工作;复制期间 .delta 增长,-N 之后变更转入数据库 |
| 该数据库的其他副本 | 初始化进行期间收不到该数据库的段;之后会追上 |
| 主库的其他数据库 | 不受影响 |
| 副本的 Firebird,新数据库 | 不停止;按 5.6 重启 |
| 副本的 Firebird,重复初始化 | 替换文件期间 会停止:这个 Firebird 的所有数据库有几秒钟不可用 |
| 副本的 Firebird,节点删除旧副本(“删除旧副本”复选框,自 HQbird 2027.2.24 起) | 更早 停止,在删除进行期间、传输之前。如果 replication.conf 中的数据库块没有更改,节点安装新副本时不再第二次停止。如果空间足够、不需要删除,节点什么都不删除,过程与普通的重复初始化相同 |
| 网络和磁盘 | 按速度限制加载(5.5) |
在 Windows 上。 Firebird 打开的文件不能替换。重复 初始化期间,节点通过 fbagent 停止副本的 Firebird,安装 文件,再启动 Firebird。在 Linux 上,替换之前也会停止 Firebird: 否则它会继续使用已删除的旧文件。
5.4. 平滑与标准
平滑(默认)。锁定之前,节点查找 长事务:在主节点归档中最旧的段之前开始的用户写事务。初始化之后,副本无法重放它们,并会在它们的第一次变更处停止(“找不到事务 …”)。没有变更的事务不计算。
如果存在这样的事务,初始化不会开始:RCM 显示 平滑重新初始化正在等待长事务,并提供 打开列表 链接。
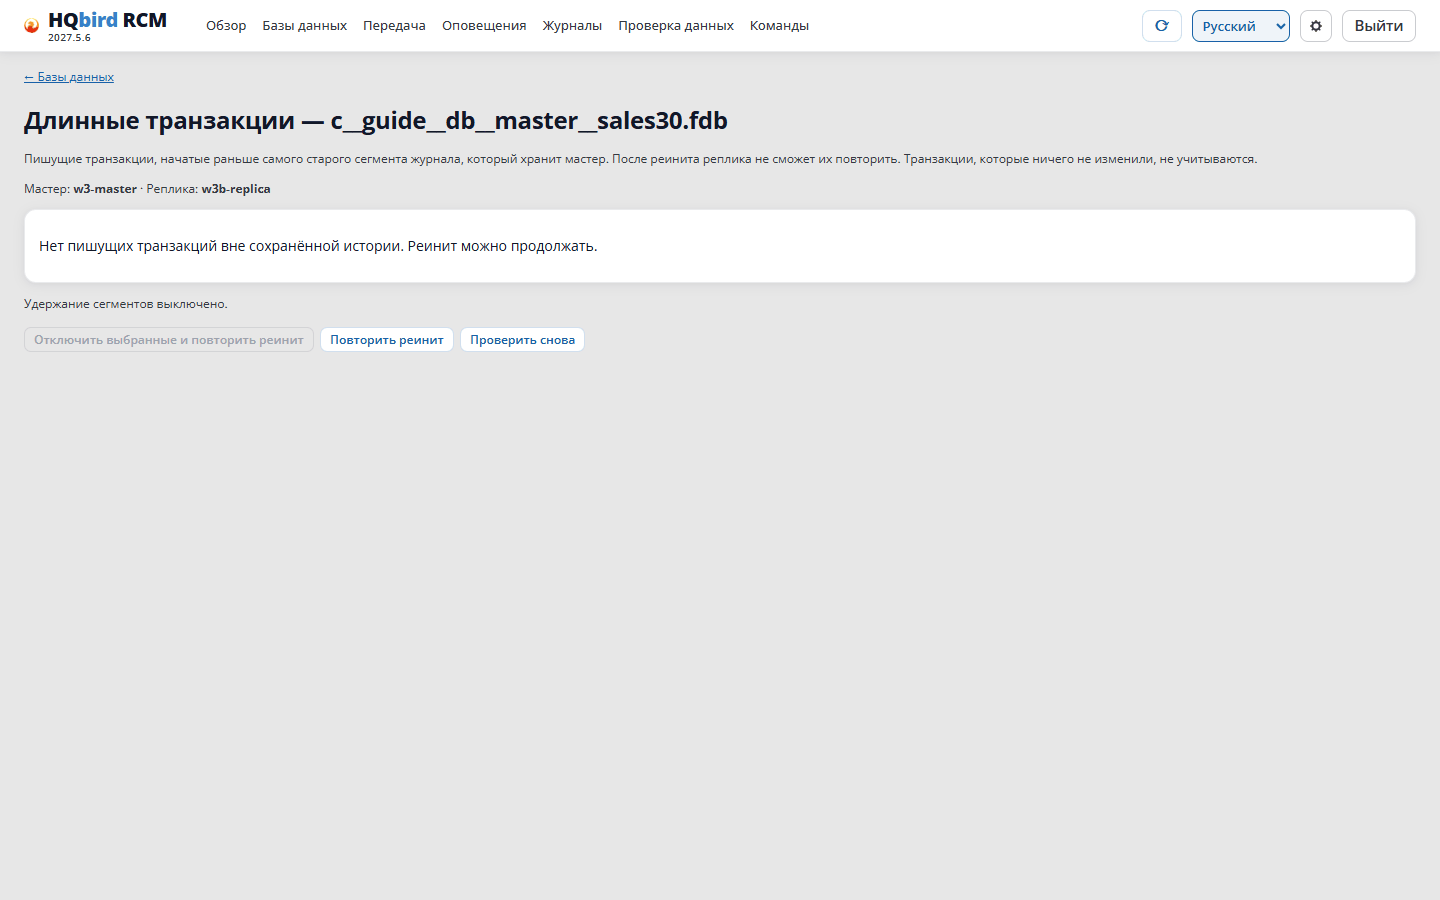
在 长事务 页上:
- 摘要:多少事务和连接、最旧的段;
- 前 5 个连接 及其最旧的事务:用户、客户端、开始、时长、变更、当前查询;
- 保留段 / 释放保留 — 保留启用时,主节点归档不被清除,历史不被截断;
- 断开所选并重试重新初始化 — 断开连接(其事务回滚)并立即启动平滑重新初始化;
- 重试重新初始化、再次检查。
因长事务而拒绝重新初始化时,保留会自动启用。成功初始化之后、手动、或归档增长到 reinit_hold_max_segments(默认 1000 个段,通知 retention_hold_released)时释放。
标准 立即锁定数据库,不做检查。只在你知道没有长写事务时使用。
负载下的第一次初始化。 主节点归档为空时,没有段可以比较。
对于 HQbird 2027.2.24 的主节点:如果节点自己启用了发布,并且此后归档没有变化,历史从启用发布的时刻开始。更晚开始的事务从其第一次变更进入日志,不妨碍平滑方法。更早开始的事务没有进入日志:重新初始化在锁定之前等待它(每 10 秒 6 次),locking 步骤显示它的编号、连接和用户。如果它没有结束,重新初始化以错误 reinit_pre_publication_transactions 结束:结束它并重试。长事务 页在 发布启用之前开始的事务 表中显示这样的事务。
如果发布是手动启用的,不是通过节点,或者归档已经变化,历史的起点未知。这时如果有任何写事务打开,平滑方法会拒绝,消息说明归档中还没有段。这种情况下 RCM 2027.2.24 不打开列表,而是在数据库单元格中写明该做什么。选择 标准,或等到 Firebird 归档第一个段后再试。
对于 2027.5.7 的主节点,平滑方法在正在被写入的数据库的第一次初始化上立即拒绝:long_transactions … segment 0 (0001-01-01T00:00:00Z)。对这样的数据库的第一次初始化,选择 标准。
随后的重新初始化中,平滑方法照常工作(归档已经存在)。
命令行上同样可以做
hqbirdrcm longtx -node node-a -db <db_id>                       # list
hqbirdrcm longtx -node node-a -db <db_id> -disconnect 12,34 -retry-to node-b
hqbirdrcm longtx -node node-a -db <db_id> -hold false           # release hold
早于发布的事务。 Firebird 不把发布启用之前开始的事务写入段。如果节点启用了发布,初始化会等待(每 10 秒 6 次)直到这样的事务结束;否则以错误 reinit_pre_publication_transactions 结束并列出它们。同步了添加了表的发布之后,重新连接应用程序,然后开始初始化。
5.5. 速度
| 何时 | 速度 | 设置 |
|---|---|---|
在传输窗口 windows.transfer_window 内(默认 23:00-05:00) |
恒定 | limits.reinit_window_mbps,默认 100 MB/s |
| 窗口之外 | 实测磁盘速度的一部分 | limits.reinit_day_disk_fraction,默认 0.5 |
节点每 30 秒重新计算模式:白天开始的初始化会在夜间自己加速。
节点用测试测量磁盘速度。要在主节点主机上重复测试:
hqclusternode benchmark -config /opt/hqclusternode/master/node.json初始化时间 ≈ 数据库大小 ÷ 速度。示例:100 GB、100 MB/s — 大约 17 分钟的纯传输;实际中受网络或磁盘限制。
5.6. 重启副本的 Firebird
副本上的新数据库。 文件在不停止 Firebird 的情况下放置。Firebird
只有重启之后才会读取新的 replication.conf 块。在此之前
副本什么都不应用。RESTARTING REPLICA 步骤显示等待:
| 标签 | 含义 |
|---|---|
| 等待副本上的 Firebird 重启,已安排在 …… | 节点会在最后一次初始化之后自己重启 Firebird(reinit_restart_delay_sec),等其他初始化结束 |
| …… 重启窗口关闭,下一个将在 …… 打开 | 等待副本的 restart_window |
| …… 上次尝试失败,下一次在 …… | 稍后重试 |
| 副本不能自己重启 Firebird:请手动重启 | auto_restart: never,或这个 Firebird 也服务于主库数据库 |
节点在一系列初始化之后 一次 重启 Firebird,而不是每 个数据库之后。
要手动重启,单击 重启副本 Firebird。 任何一次成功的 Firebird 重启之后,或当 副本已应用比该副本更新的段时,等待结束。
在也服务于主库数据库的 Firebird 上重新初始化。
节点不自己停止这样的 Firebird,并以
restart_not_allowed 拒绝。再次启动初始化并勾选 允许
-allow-restart)
— 在可以断开这个 Firebird 的连接时,包括
到它的主库数据库。每台主机一次只运行这样的初始化。
删除旧副本(删除旧副本 复选框,HQbird
2027.2.24 起)也按同样规则停止副本的 Firebird。如果
节点不能自己停止这个 Firebird,它什么都不删除,并以
restart_not_allowed 拒绝:同样勾选 允许 engine_busy 拒绝:主节点释放锁,
稍后重试。
5.7. 队列与同时进行的初始化
- 一个数据库同一时间只有一个初始化(即使是不同的副本)。该数据库的初始化进行期间,初始化 按钮被禁用。
- 主节点同时执行
limits.max_concurrent_reinits个不同数据库的初始化(默认 1)。其余在队列中等待;响应中含有队列位置。 - 初始化期间不要对该数据库运行自己的
nbackup -L(或ALTER DATABASE BEGIN BACKUP),也不要在这样的备份期间启动初始化:一个数据库只能有一把锁。初始化会检查这一点并以nbackup backup lock already active拒绝。
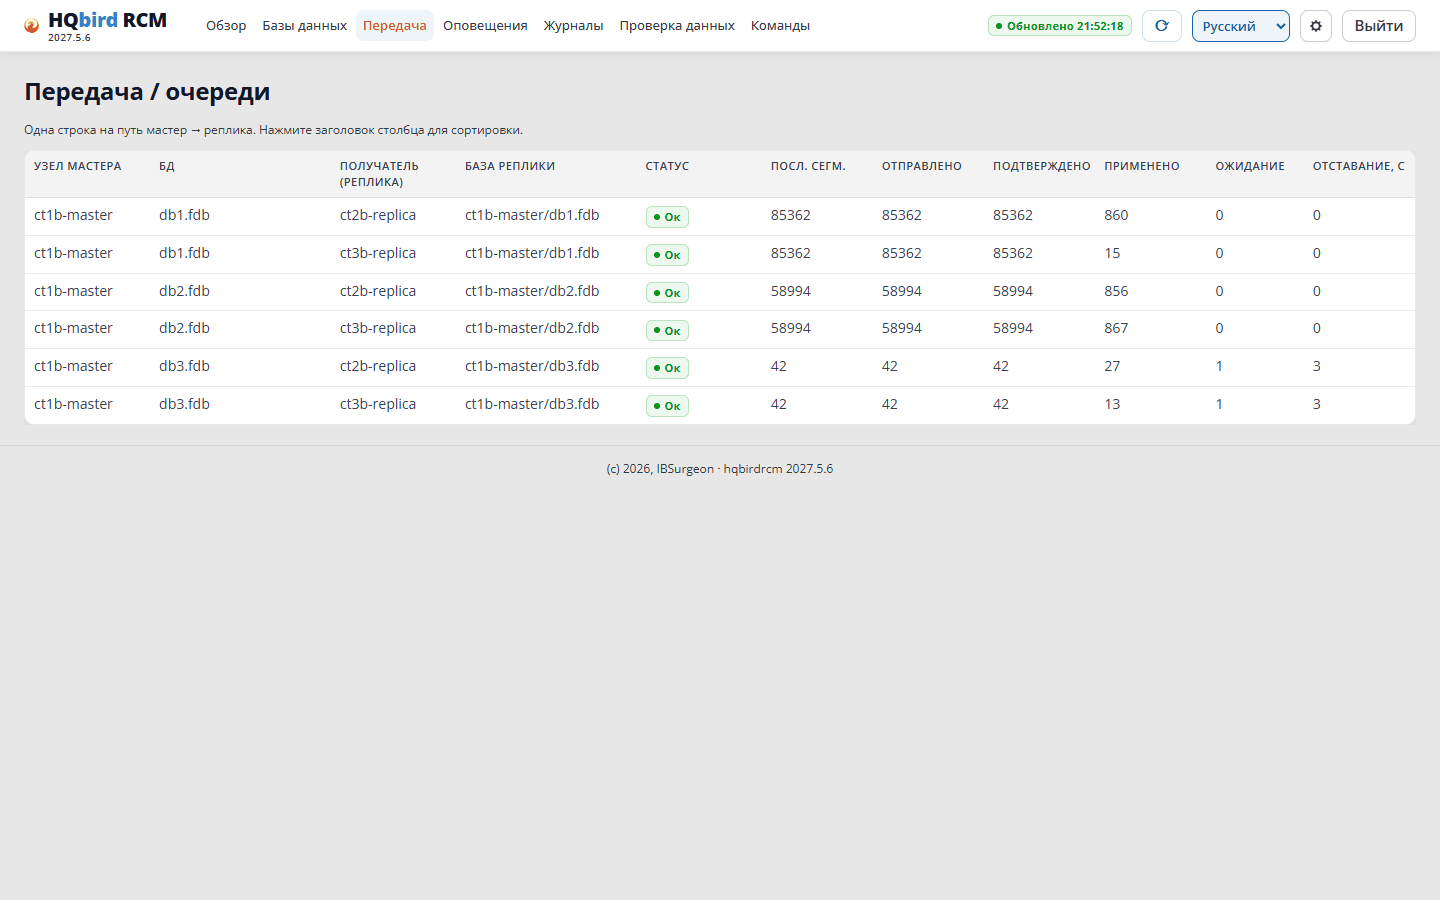
队列和当前传输在 传输 页上可见。
5.8. 自动重新初始化
RCM 可以自己重新初始化处于 NEEDS_REINIT 状态的数据库,但只在
已配置的窗口内。默认禁用。
数据库进入 NEEDS_REINIT 时:
| 原因 | 在何处可见 |
|---|---|
| 反复出现的不可恢复应用错误(PK、UNIQUE、FK 违反)— 连续 3 次 | 副本,警报 replication_unrecoverable_error |
| 主库数据库 GUID 已更改(恢复、文件替换) | 副本,警报 replication_guid_mismatch |
| 主节点归档中已不再有副本需要的段 | 主节点 |
| 副本为初始化删除了旧副本,新副本尚未就位(自 HQbird 2027.2.24 起) | 副本,警报 replica_removed_for_reinit;主节点 |
要启用 — 设置 → RCM(或 rcm.json 的 auto_reinit 节):
"auto_reinit": {
  "enabled": true,
  "default_window": "22:30-04:00",
  "max_concurrent": 1,
  "nodes": {
    "node-a": { "window": "23:00-05:00",
                "databases": { "sales/employee.fdb": "01:00-03:00" } }
  }
}- 窗口:按数据库 → 按节点 → 全局。
"always"— 任何时间。 - 窗口按 RCM 主机 的时钟计算。
max_concurrent— 群集中可以有多少个初始化(手动和自动) 在运行,RCM 才会再启动一个自动的。- 自动初始化经过与
手动初始化相同的空间和 GUID 检查。命令作者是
system:autoreinit。 remove_old_replica_when_short(自 HQbird 2027.2.24 起,空间不足时删除 旧副本 行)— 默认禁用。如果 启用,自动初始化会发送 删除旧 副本 标志(4.4)。RCM 只在副本自己处于NEEDS_REINIT,或主节点的NEEDS_REINIT原因点名它时发送。对于 处于IN_SYNC或LAGGING的副本,从不发送该标志。如果节点 是更旧的版本,RCM 启动同一次初始化但不带该标志。- 更改之后,重启 RCM。
主库卡片中的 暂停 会禁用单个数据库的自动 初始化 1 小时、4 小时、24 小时,或直到取消。手动 初始化仍然可用。
5.9. 错误
| 错误 | 原因 | 怎么办 |
|---|---|---|
insufficient disk space on master / on replica、507 |
空间不够。重新初始化期间旧副本一直占用空间直到结束 | 第 4.4 章;在副本上(自 HQbird 2027.2.24 起)— 删除旧副本 复选框(5.1) |
node_too_old(自 HQbird 2027.2.24 起) |
已勾选 删除旧副本,但主节点或副本节点是旧版本 | 按错误文本升级节点,或不勾选该复选框运行 |
engine_busy、reclaim_in_progress(自 HQbird 2027.2.24 起) |
副本现在无法删除旧副本:Firebird 或该数据库正忙 | 稍后重试(5.6) |
replica_removed_for_reinit、一对 NEEDS_REINIT(自 HQbird 2027.2.24 起) |
副本删除了旧副本,但初始化没有完成 | 再次启动初始化(4.4) |
publication_off(自 HQbird 2027.2.24 起) |
主库的发布已禁用,或不含带键的表 | 同步发布并初始化(5.1) |
long_transactions,“平滑重新初始化正在等待长事务” |
有打开的长写事务 | 5.4 |
long_transactions,“主节点归档中还没有一个段” |
负载下的第一次初始化 | 标准(5.4) |
reinit_pre_publication_transactions |
事务在发布启用之前开始 | 重新连接应用程序,重试 |
duplicate_guid |
两个主库数据库 GUID 相同 | 删除副本;如果提升为主节点时跳过了 NEW GUID 步骤 — -force(第 8.4 章) |
license_paused |
主节点的 fbagent 没有许可证 | 第 2.8 章 |
409 orphaned |
数据库在主节点扫描之外 | 第 3.8 章 |
incompatible_engine |
Firebird 主版本不同 | 第 4.3 章 |
target_not_replica |
副本的位置上是一个正在工作的数据库(它已被做成普通库) | 见下文 |
target_other_replica(自 HQbird 2027.2.24 起) |
副本的位置上是本节点另一个数据库的副本 | 见下文 |
restart_not_allowed |
副本的 Firebird 也服务于主库数据库 | 5.6,“允许 …… 停止 Firebird”复选框 |
fbagent_required |
副本上没有安装 fbagent | 第 1 章 |
nbackup backup lock already active |
nbackup 备份正在进行 | 5.7 |
… -L did not finish in 2m0s and was stopped |
主节点上的 nbackup -L 在 2 分钟内没有完成,于是节点停止了它 |
重试;如果错误反复出现,检查主库的 Firebird(firebird.log) |
reinit already in progress for this database |
该数据库的初始化已在运行 | 等它结束 |
target_not_replica。 副本的位置上是一个正在工作的数据库:它已被做成
普通库(存在文件 <database>.hqcluster-normal.json),或者它不在
副本模式。节点不覆盖正在工作的数据库。如果需要替换,向节点 API 发出带
overwrite_non_replica: true 的请求(RCM 中没有这个按钮)会替换文件,并把旧文件保留为
<database>.pre-reinit-<UTC 时间>.fdb。
target_other_replica(自 HQbird 2027.2.24 起)。副本把副本放在
<databases.root>/<主节点 id>/<数据库路径>。主节点 id 只在
自己的群集内唯一,因此两个数据库可能落到同一路径。副本节点
不覆盖属于它另一个数据库的副本:错误会指出那个数据库及其
主节点。节点也能认出路径记录方式不同的副本(路径中的符号链接或
联接、Windows 短文件夹名)。overwrite_non_replica 不能消除这个错误。把其中一个
副本移到另一个文件夹,或从副本上移除该数据库,然后再次
启动初始化。节点只看到自己的数据库:同一主机上的两个副本节点
必须有不同的副本文件夹(databases.root)。
5.10. 如何检查结果
-
数据库: 组中的主库 — 副本对是 正常,状态
IN_SYNC。 -
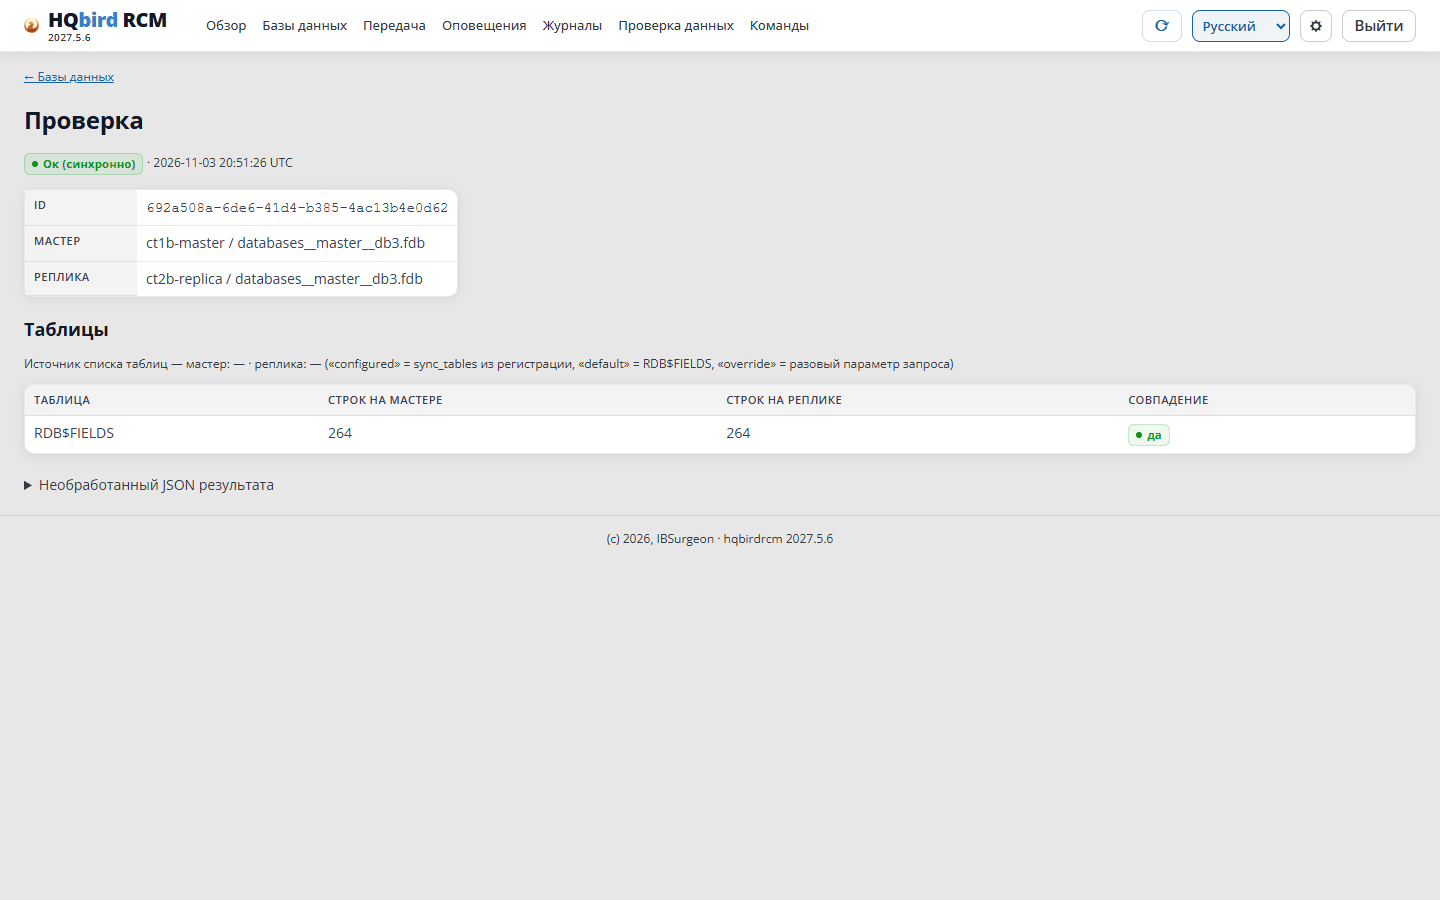
主库卡片中的 验证:节点统计表列表中的表的行数 (第 3.1 章),在主库和副本上比较。 在安静时检查:有活跃写入时数字可能不同。
HQbird 2027.2.24 起,结果页指出每一侧的列表 (例如“该数据库自己的列表”或“发布表 (未设置列表)”)。RCM 用主库的列表统计副本。在两个数据库中都不存在的表显示为“不在数据库中”,不 算作错误。如果没有比较任何表,结果是“没有可 比较的表”,不是不匹配。如果比较没有在给定时间内完成, 结果是“未比较(时间限制)”,这也不是不匹配。
hqbirdrcm verifydata -master node-a -master-db <db_id> -replica node-b -replica-db <db_id>- 定期检查(可选):数据检查 页,
为所有节点打开。HQbird 2027.2.24 起,节点立即应用
设置,不需要重启节点服务:保存 之后 RCM
写入“已保存并且已经生效”。节点 2027.5.7 需要重启
hqclusternode服务,RCM 2027.2.24 会说明。 当主库和副本处于同一个 段时,节点自己比较行数。不匹配会发出data_mismatch警报;然后运行 验证。
操作员已从发布中移除的表显示为“未 发布”,而不是不匹配。
6. 配置发布
发布告诉 Firebird 主库把哪些表的变更写入段。 没有它,副本什么都收不到。
6.1. 发布是什么
在 Firebird 4 和 5 中,要复制的表由发布 RDB$DEFAULT 定义:
- 发布已启用 — 在
RDB$PUBLICATIONS中它有RDB$ACTIVE_FLAG = 1(命令ALTER DATABASE ENABLE PUBLICATION)。 - 已发布的表 —
RDB$PUBLICATION_TABLES中的列表。
Firebird 只对已发布的表、并且只在 发布启用时把变更写入段。登记数据库(第 3 章)不会 启用发布。它由 同步发布 启用(6.2)。
主节点每小时检查发布
(limits.publication_check_interval_sec,默认 3600)。如果它被
禁用,节点每 2 分钟检查一次。
在 数据库 页上,主库数据库有一个图标:
| 图标 | 含义 |
|---|---|
| 发布开启 | 发布已启用 |
| 发布关闭 | Firebird 不向段写入任何内容,副本收不到变更 |
| 发布未知 | 节点无法读取状态 |
发布关闭 过滤器显示发布被禁用或未知的数据库。
如果发布被禁用的数据库已经有副本,主节点发出
警报 master_publication_off。
HQbird 2027.2.24 起,主节点在以错误 publication_off 拒绝
初始化数据库时也会发出此警报(第 5.1 章):发布
被禁用,或不含带键的表。警报级别:
- 警告 — 数据库还没有副本:初始化在等待发布;
- 严重 — 数据库已经有副本;
- 信息 — 操作员禁用了发布。
发布修好或另一次 初始化已开始时,警报清除。
6.2. 同步发布
在何处单击:
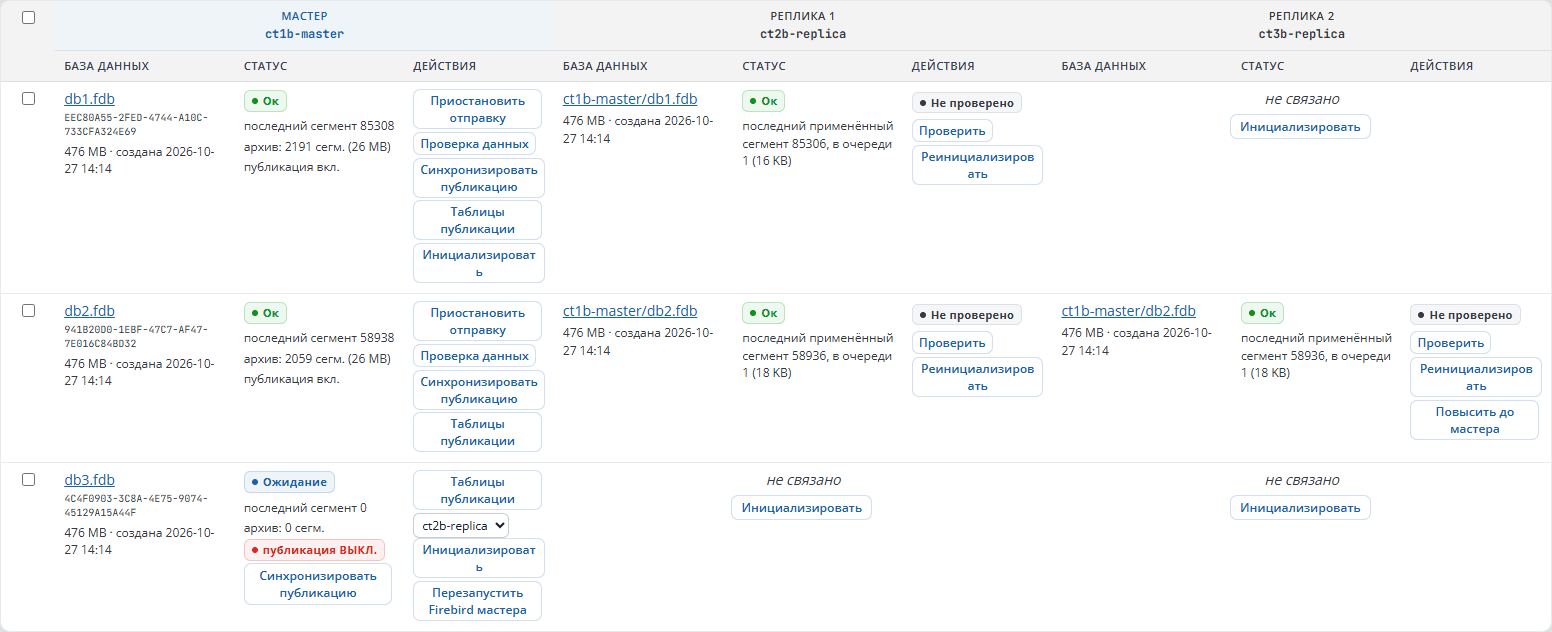
- 在 数据库 页的主库数据库行中。发布 被禁用时,按钮在图标旁边;
- 在数据库页上;
- 对多个数据库:勾选行,在 操作 列表中选择 同步发布。RCM 会为每个 数据库发送单独的命令。
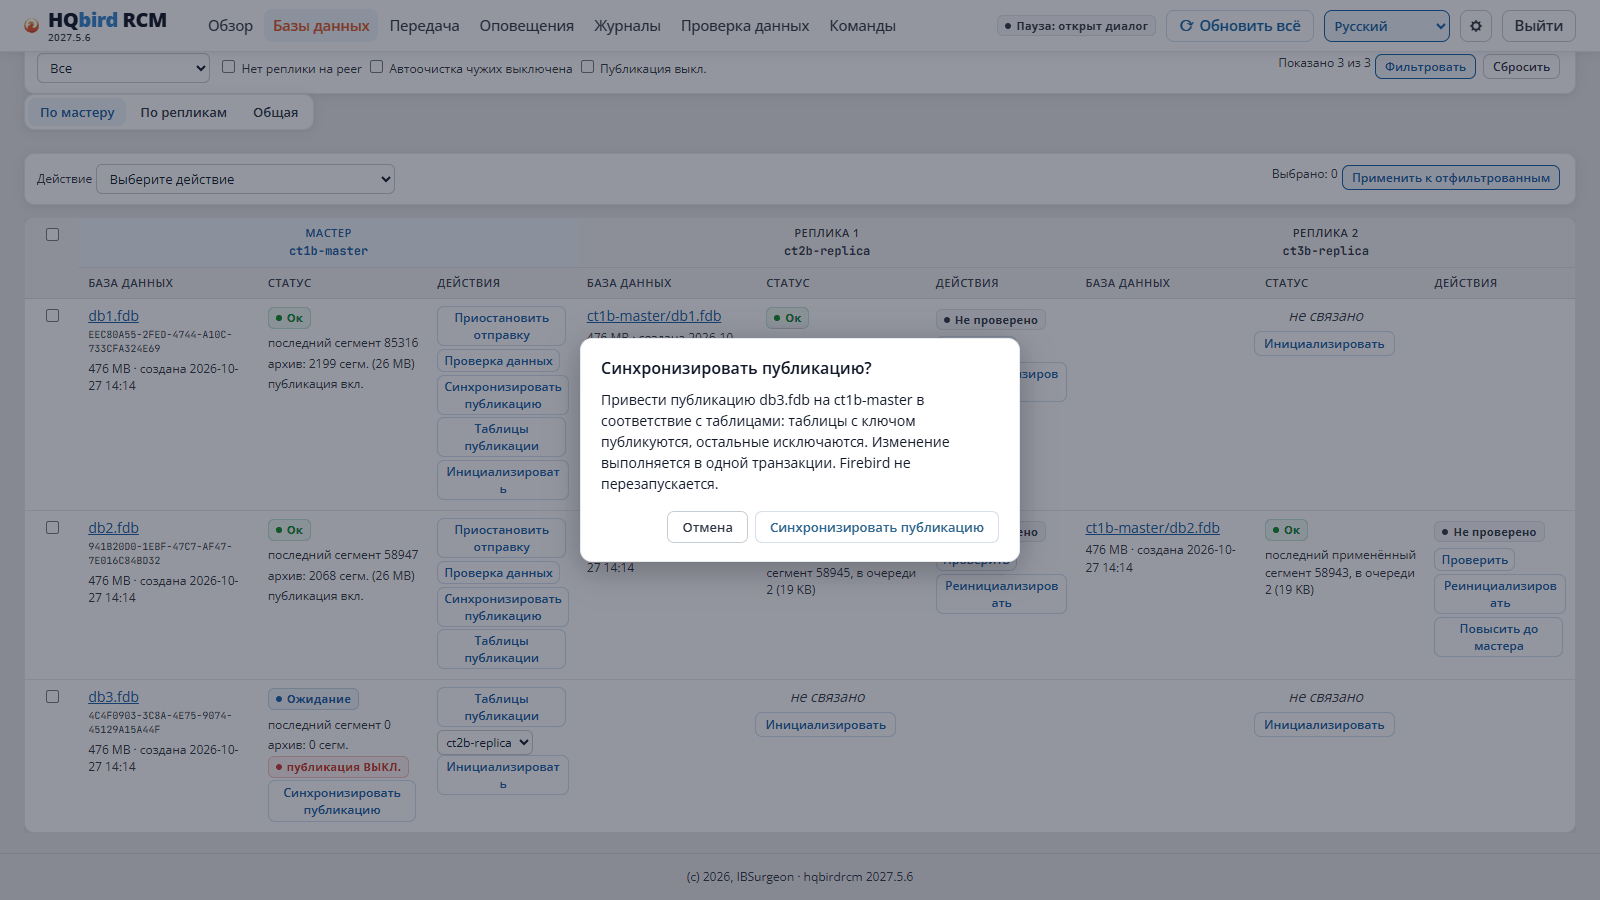
节点做什么(一个事务):
- 启用发布。如果操作员自己禁用了它(6.4),则不启用。
- 把尚未在发布中的所有 带键的表 加入发布。
- 从发布中移除没有键的表,以及操作员 排除的表(6.3)。
- 禁用自动添加新表(
EXCLUDE ALL FROM PUBLICATION,然后添加所需的表)。只有节点定义 发布的组成。
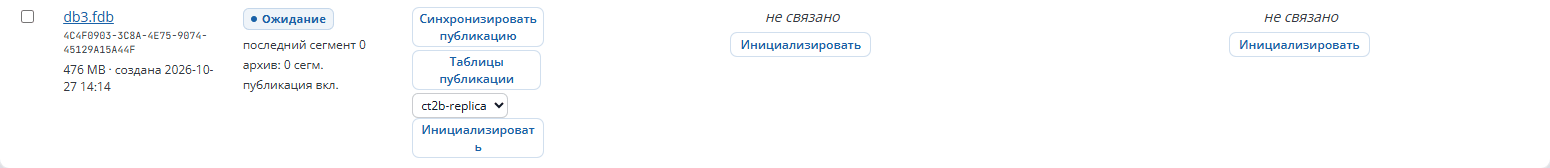
带键的表 — 有 主键 或 活动唯一索引的用户永久表。系统和临时 表不发布。
同步也会从发布中移除 DBA 手动添加的、没有键的表。
如果组成已经正确,节点什么都不更改。
节点何时拒绝:
| 代码 | 原因 |
|---|---|
no_publications |
HQbird 2.5/3.0(6.6) |
not_master |
节点不是主节点 |
reinit_in_progress |
该数据库的初始化正在进行 |
orphaned、database_failed、file_missing |
数据库在扫描之外、处于错误,或没有文件 |
一次处理节点的所有数据库 — 只能从命令行。在 命令
页上,结果按数据库显示:完成、已跳过 或 错误。
处于 FAILED 或 SEEDING 状态的数据库以及没有文件的数据库会被跳过。
命令行上同样可以做
hqbirdrcm setpublication -node node-a -db <db_id>   # one database
hqbirdrcm setpublication -node node-a               # all node databases
该命令最多等待 5 分钟,并为每个数据库打印一行。出错时退出 代码为 1。
-nowait— 不等待结果。
6.3. 发布表
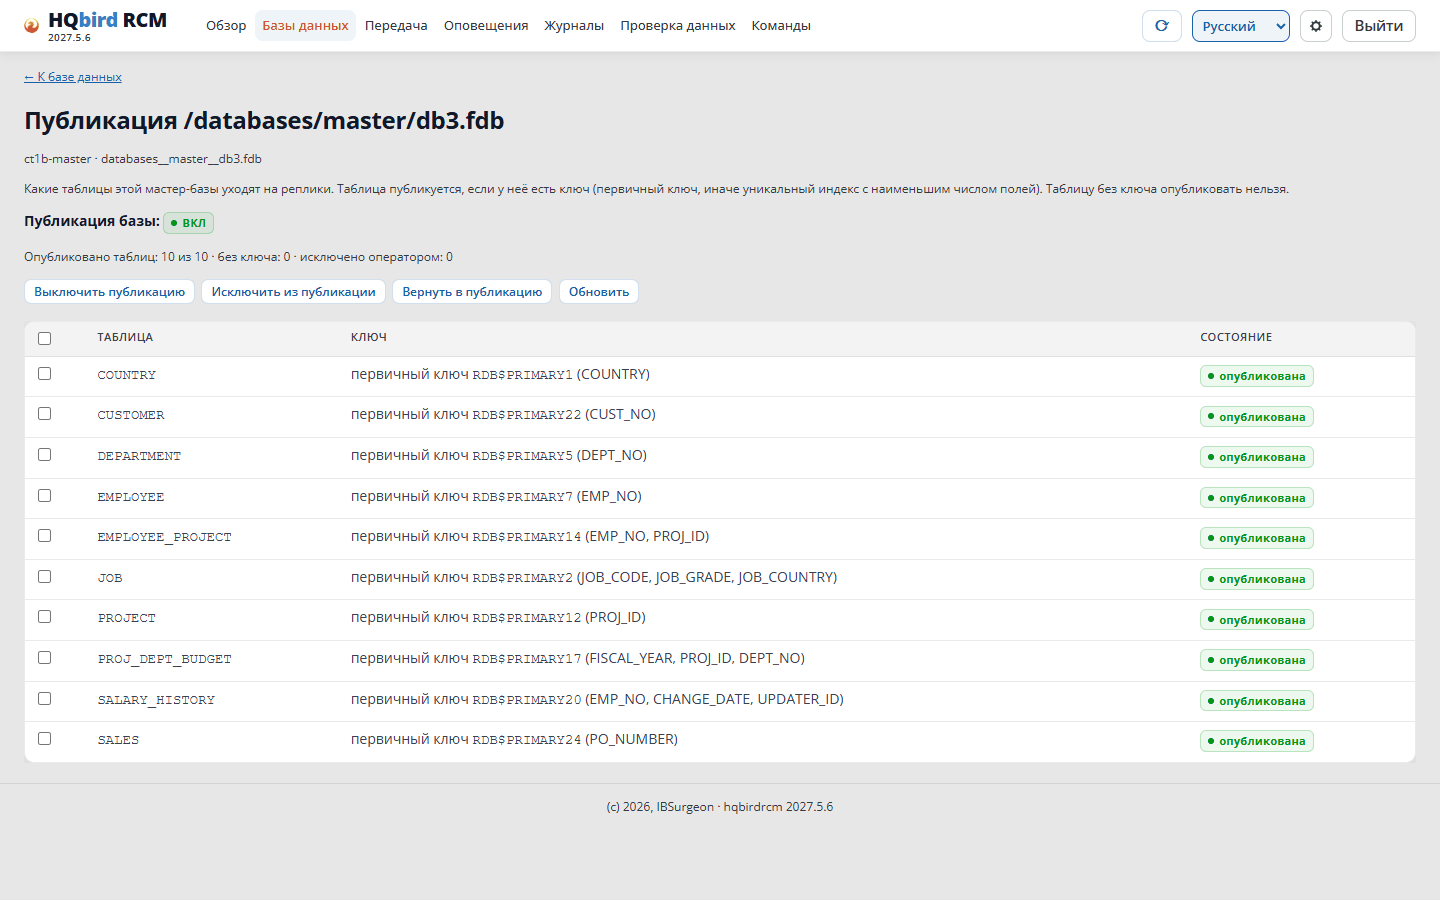
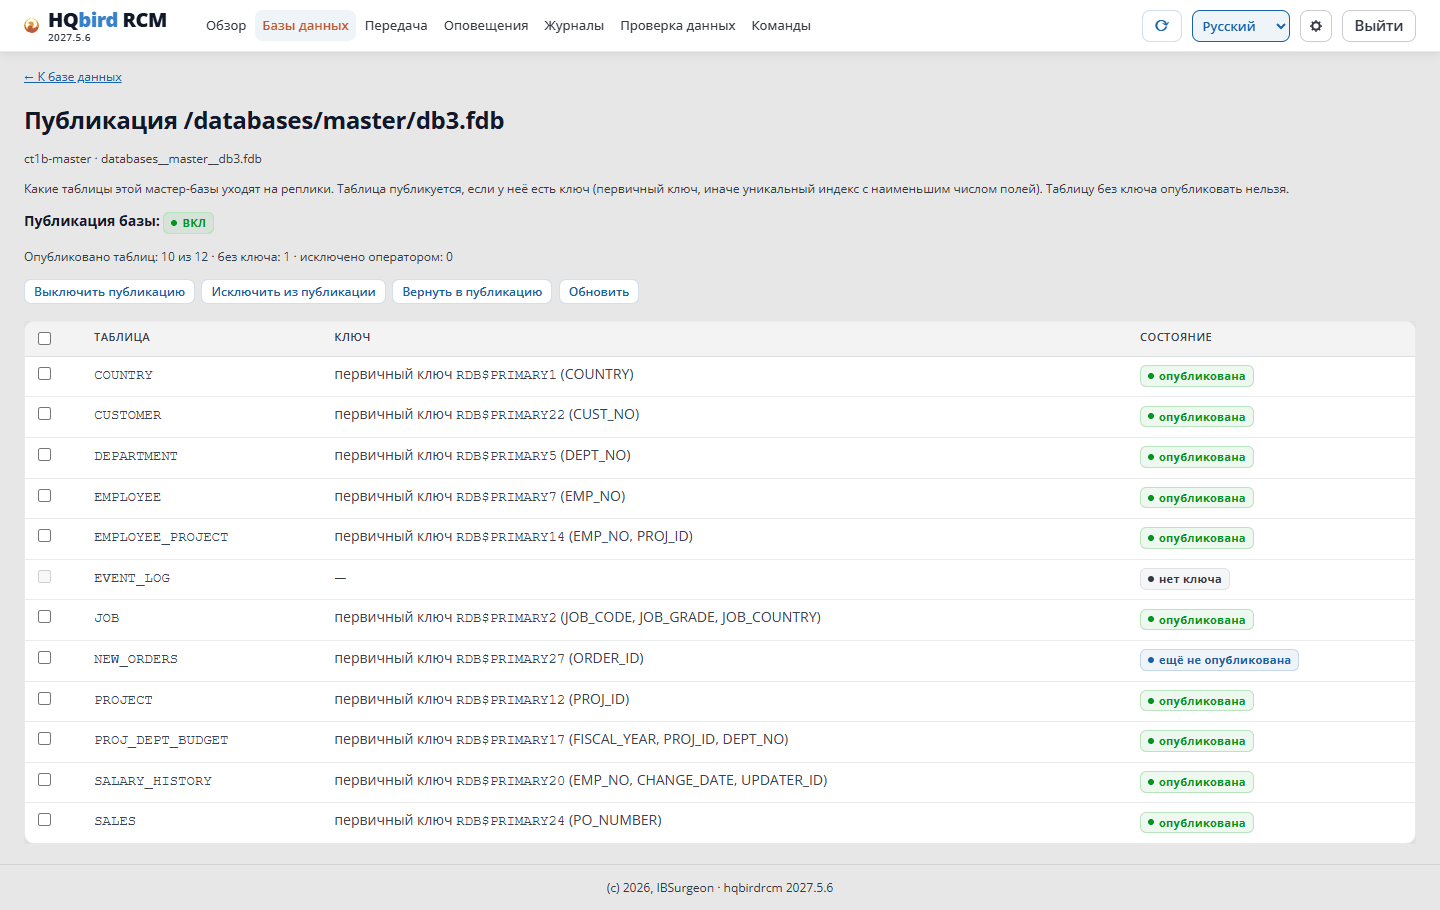
在主库数据库行中打开 发布表。
页面显示:
- 发布状态(开/关、由操作员禁用)和计数器;
- 每张表:名称、键和状态。
| 状态 | 含义 |
|---|---|
| 已发布 | 变更进入段 |
| 尚未发布 | 带键的表,同步时会添加 |
| 已排除 | 操作员把它从发布中移除 |
| 无键 | 不能发布 |
键列中 — 主键,如果没有,则是字段数 最少的唯一索引。
为什么没有键的表不能发布。 副本按键查找
UPDATE 和 DELETE 的行。没有键它找不到行。添加
主键或唯一索引,然后同步发布。
从发布中排除 / 返回发布:
- 勾选表。
- 单击 从发布中排除 或 返回发布。
- 节点保存列表并立即同步发布。
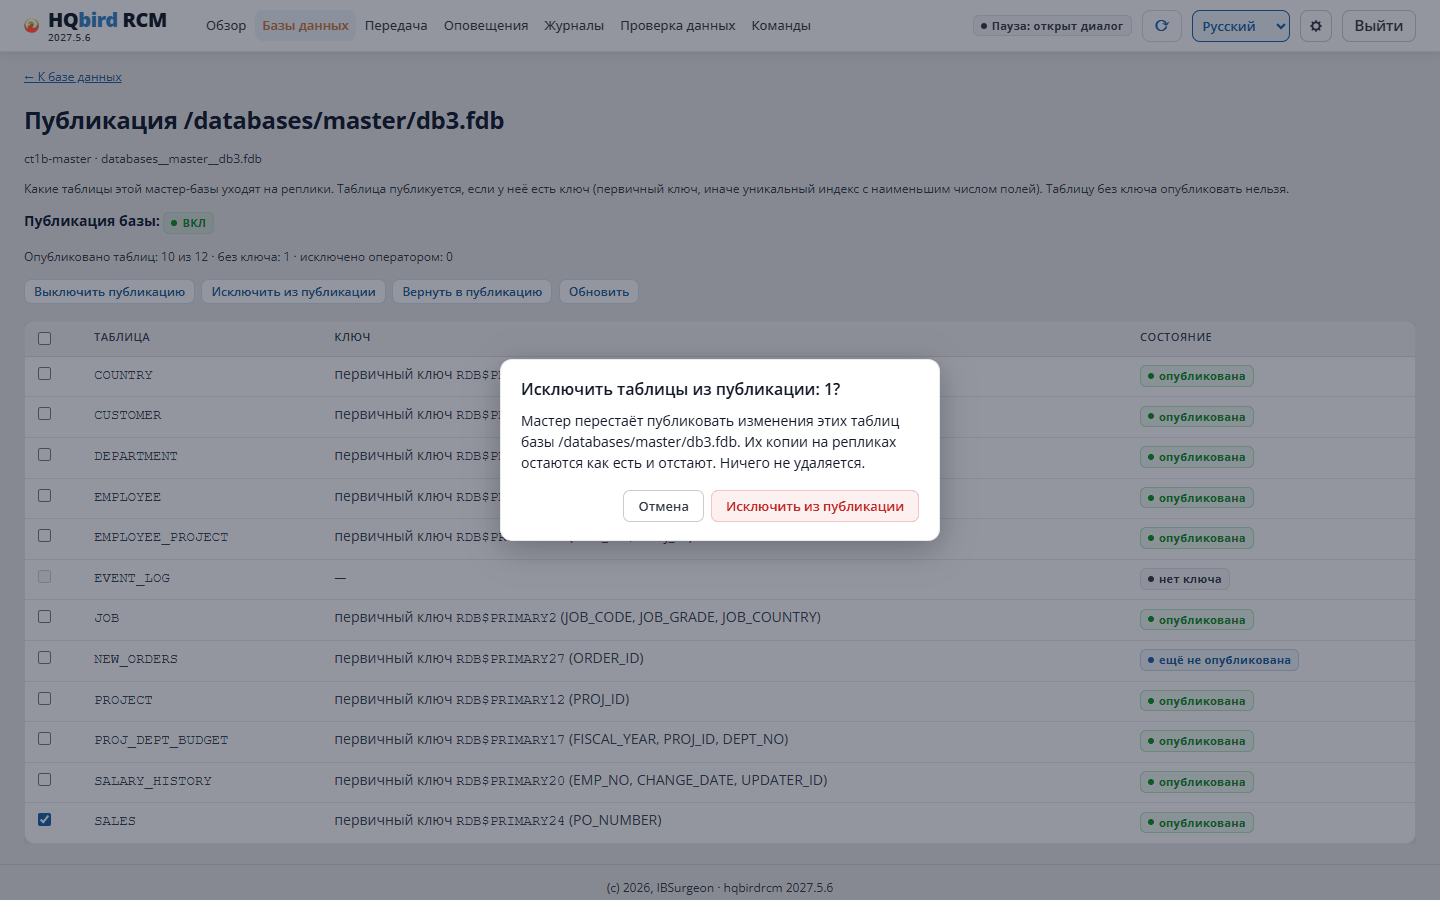
被排除表的列表存在 主节点上。同步 不更改它。副本被提升为主节点时(第 8 章),列表移到 新主节点。
检查(第 5.10 章)把被排除的表显示为“未发布”, 而不是差异。
6.4. 启用和禁用发布
在 发布表 页上:禁用发布 / 启用发布。
- 禁用是操作员的选择。同步 不会 重新启用发布。
- 发布被禁用期间(或表被 排除期间)所做的变更不会发给 副本,即使之后启用了。
- 启用之后,单击 检查(第 5.10 章)。如果数据 不一致 — 重新初始化副本(第 5 章)。
6.5. 新表
新表 不会自己进入 发布:节点禁用了 自动添加。
DDL 之后:
- 在表上创建主键或唯一索引。
- 单击 同步发布。
- 如果需要重新初始化,请应用程序重新连接。Firebird
不把发布启用之前开始的事务写入段;
COMMIT RETAINING会使这样的事务保持打开。初始化等待 这样的事务,然后以reinit_pre_publication_transactions失败 (第 5.4 章)。
同步之前写入新表的行不会到达副本。 如果有,检查数据,必要时重新初始化副本。
6.6. HQbird 2.5 和 3.0
HQbird 2.5 和 3.0 没有发布。如果
replconf 插件文件含有主库块,Firebird 就写段。这样的节点上发布按钮被隐藏,
API 以 no_publications 响应。
表集合 由引擎参数定义:
| 参数 | 含义 |
|---|---|
include_filter |
复制哪些表:名称或模式,逗号分隔;空 — 全部 |
exclude_filter |
不复制哪些表 |
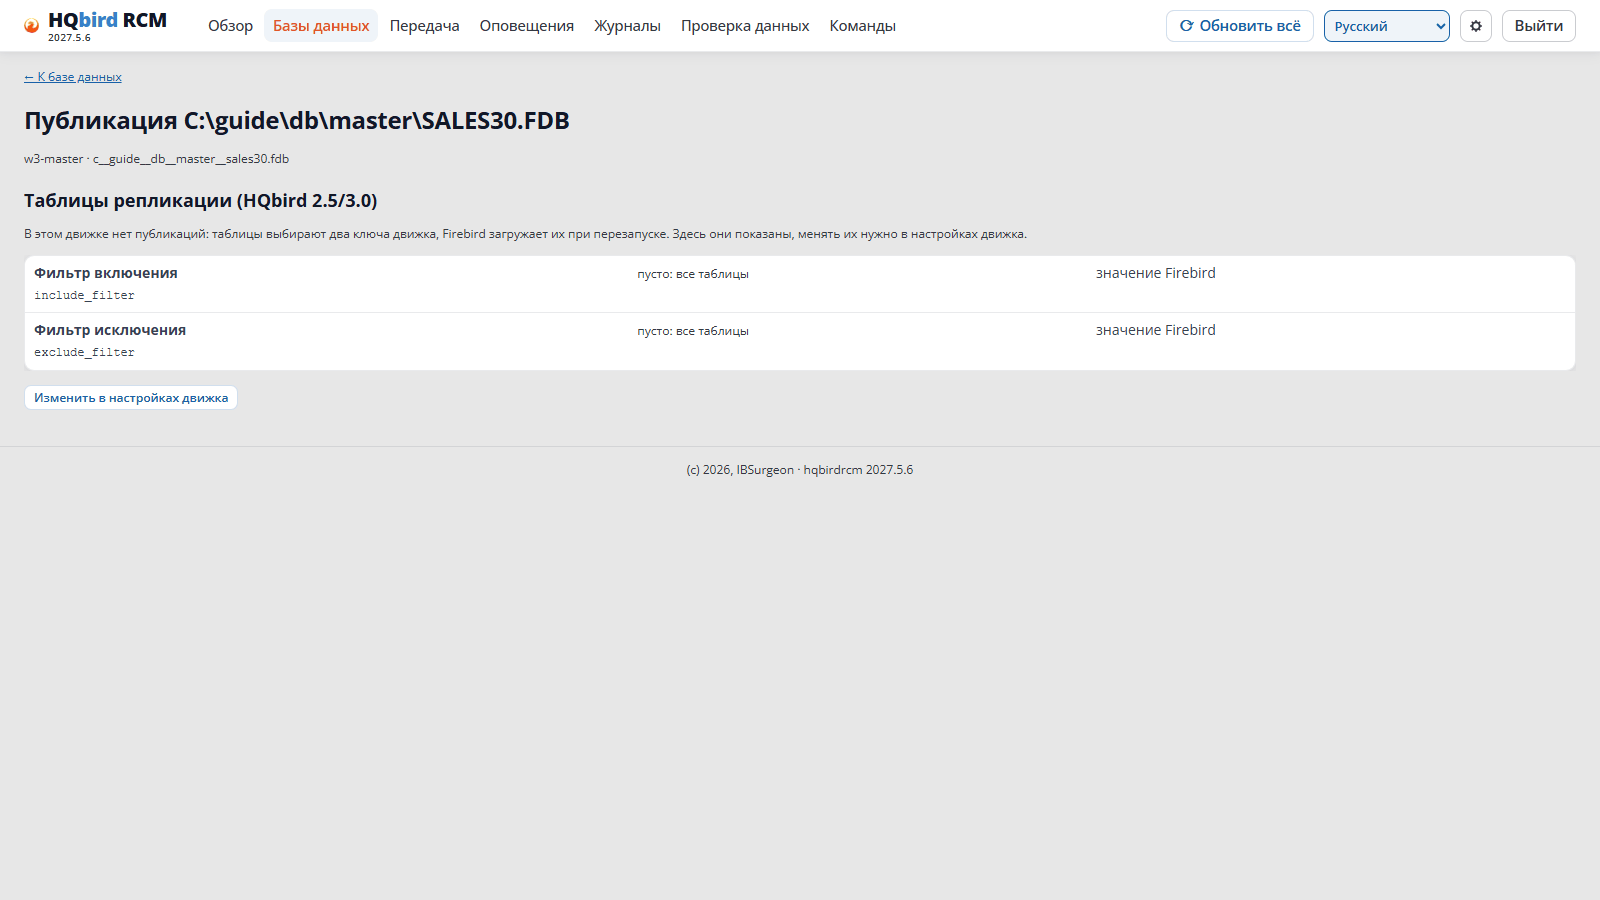
参数在 设置 → 复制参数 中更改(第 7.1 章)。 发布表 页以只读方式显示它们,并带链接 在 引擎设置中更改。Firebird 在重启之后读取新值。
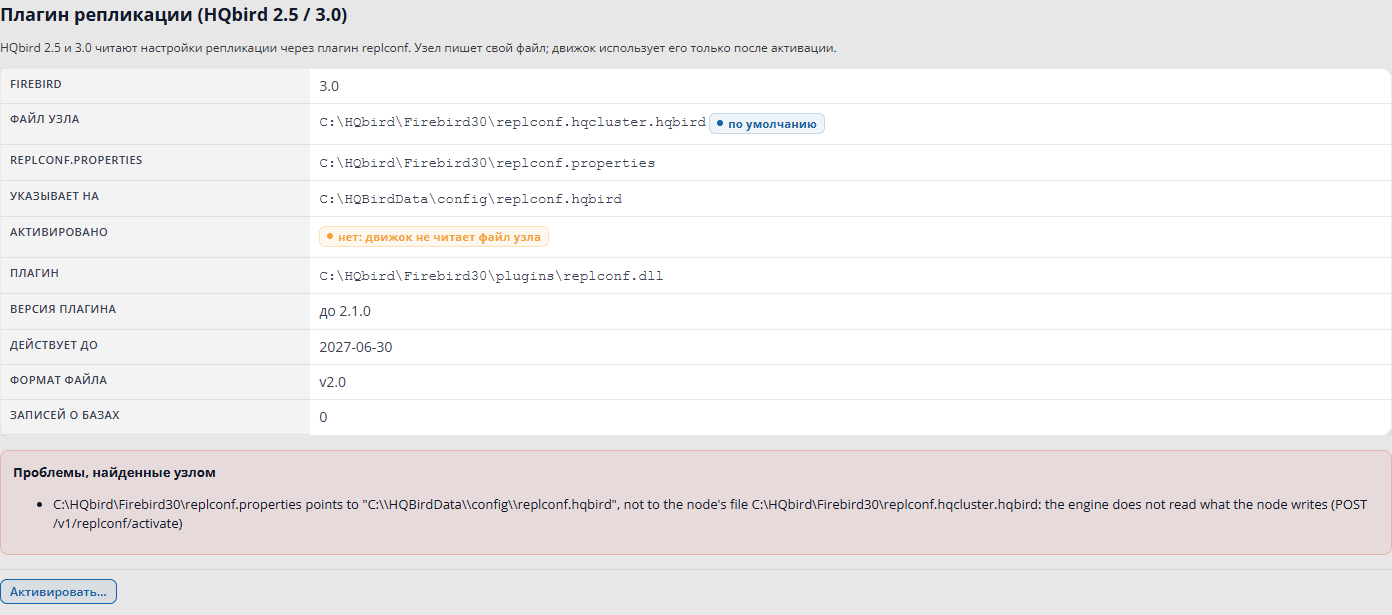
replconf 插件。 节点在
Firebird 文件夹中写入自己的文件 replconf.hqcluster.hqbird。只有当 replconf.properties 指向
它时,Firebird 才读取它。插件必须激活一次:
-
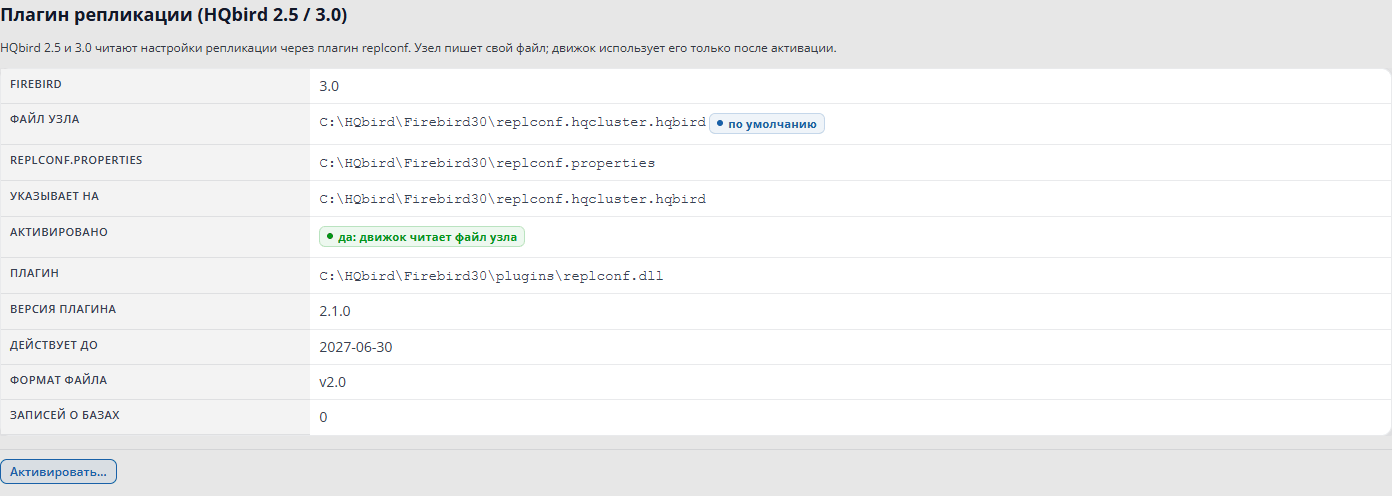
设置 → 节点,复制插件(HQbird 2.5 / 3.0) 块。该块 显示
replconf.properties指向何处,以及节点 发现的问题。
-
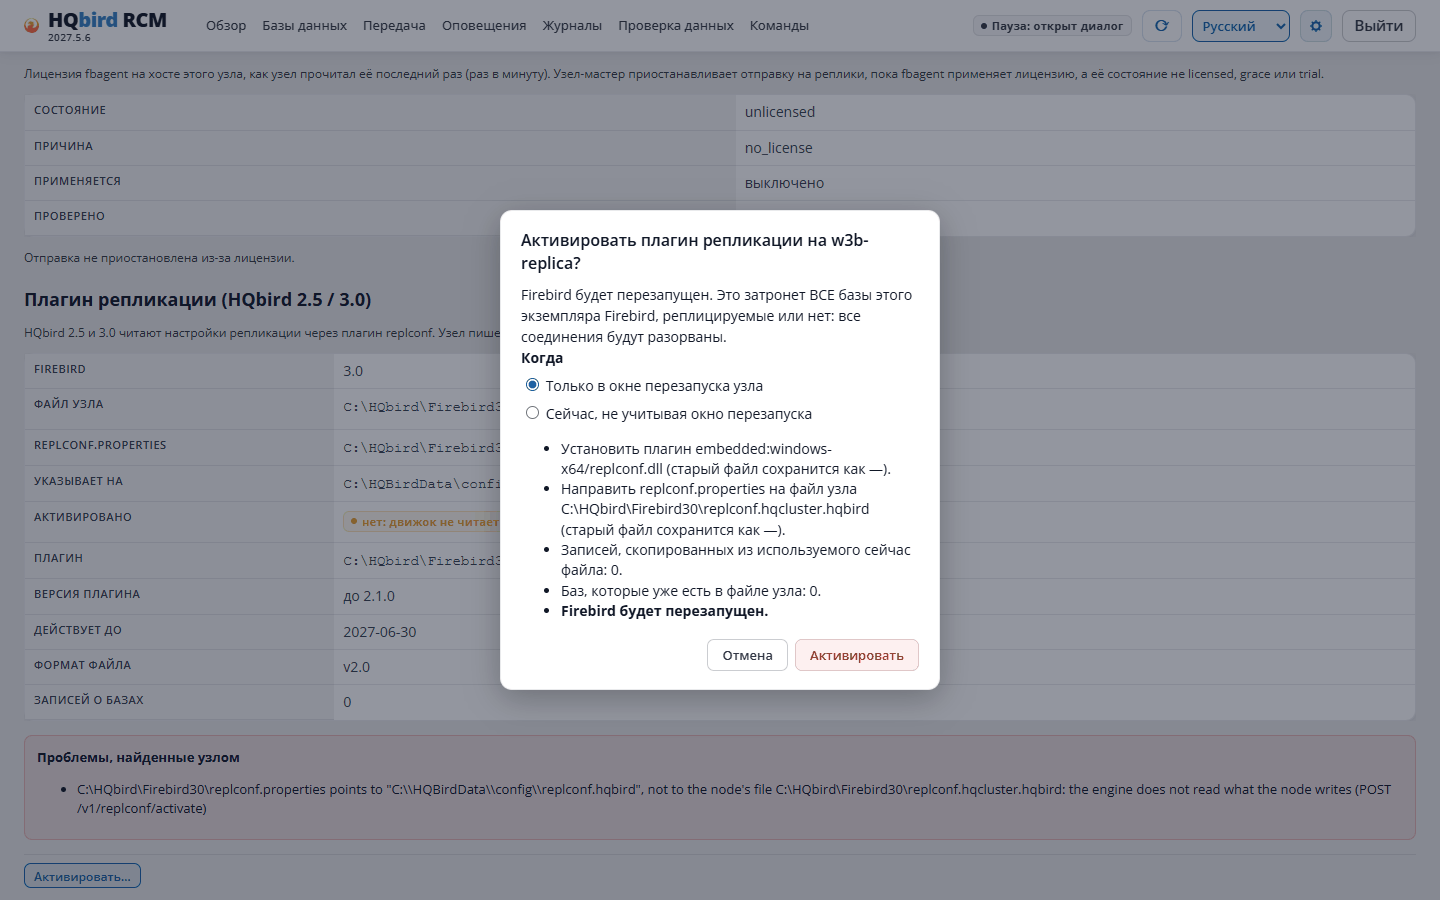
激活… 窗口列出节点将做的事:安装插件, 把
replconf.properties指向节点的文件,迁移旧文件的条目。 选择何时:仅在节点重启窗口内 或 现在,忽略 重启窗口。
-
Firebird 重启之后,已激活 字段显示“是:引擎 读取节点的文件”。
激活会重启 Firebird,并影响这个 Firebird 的 所有数据库。 在安静时段进行。
7. 其他复制选项
7.1. 复制参数
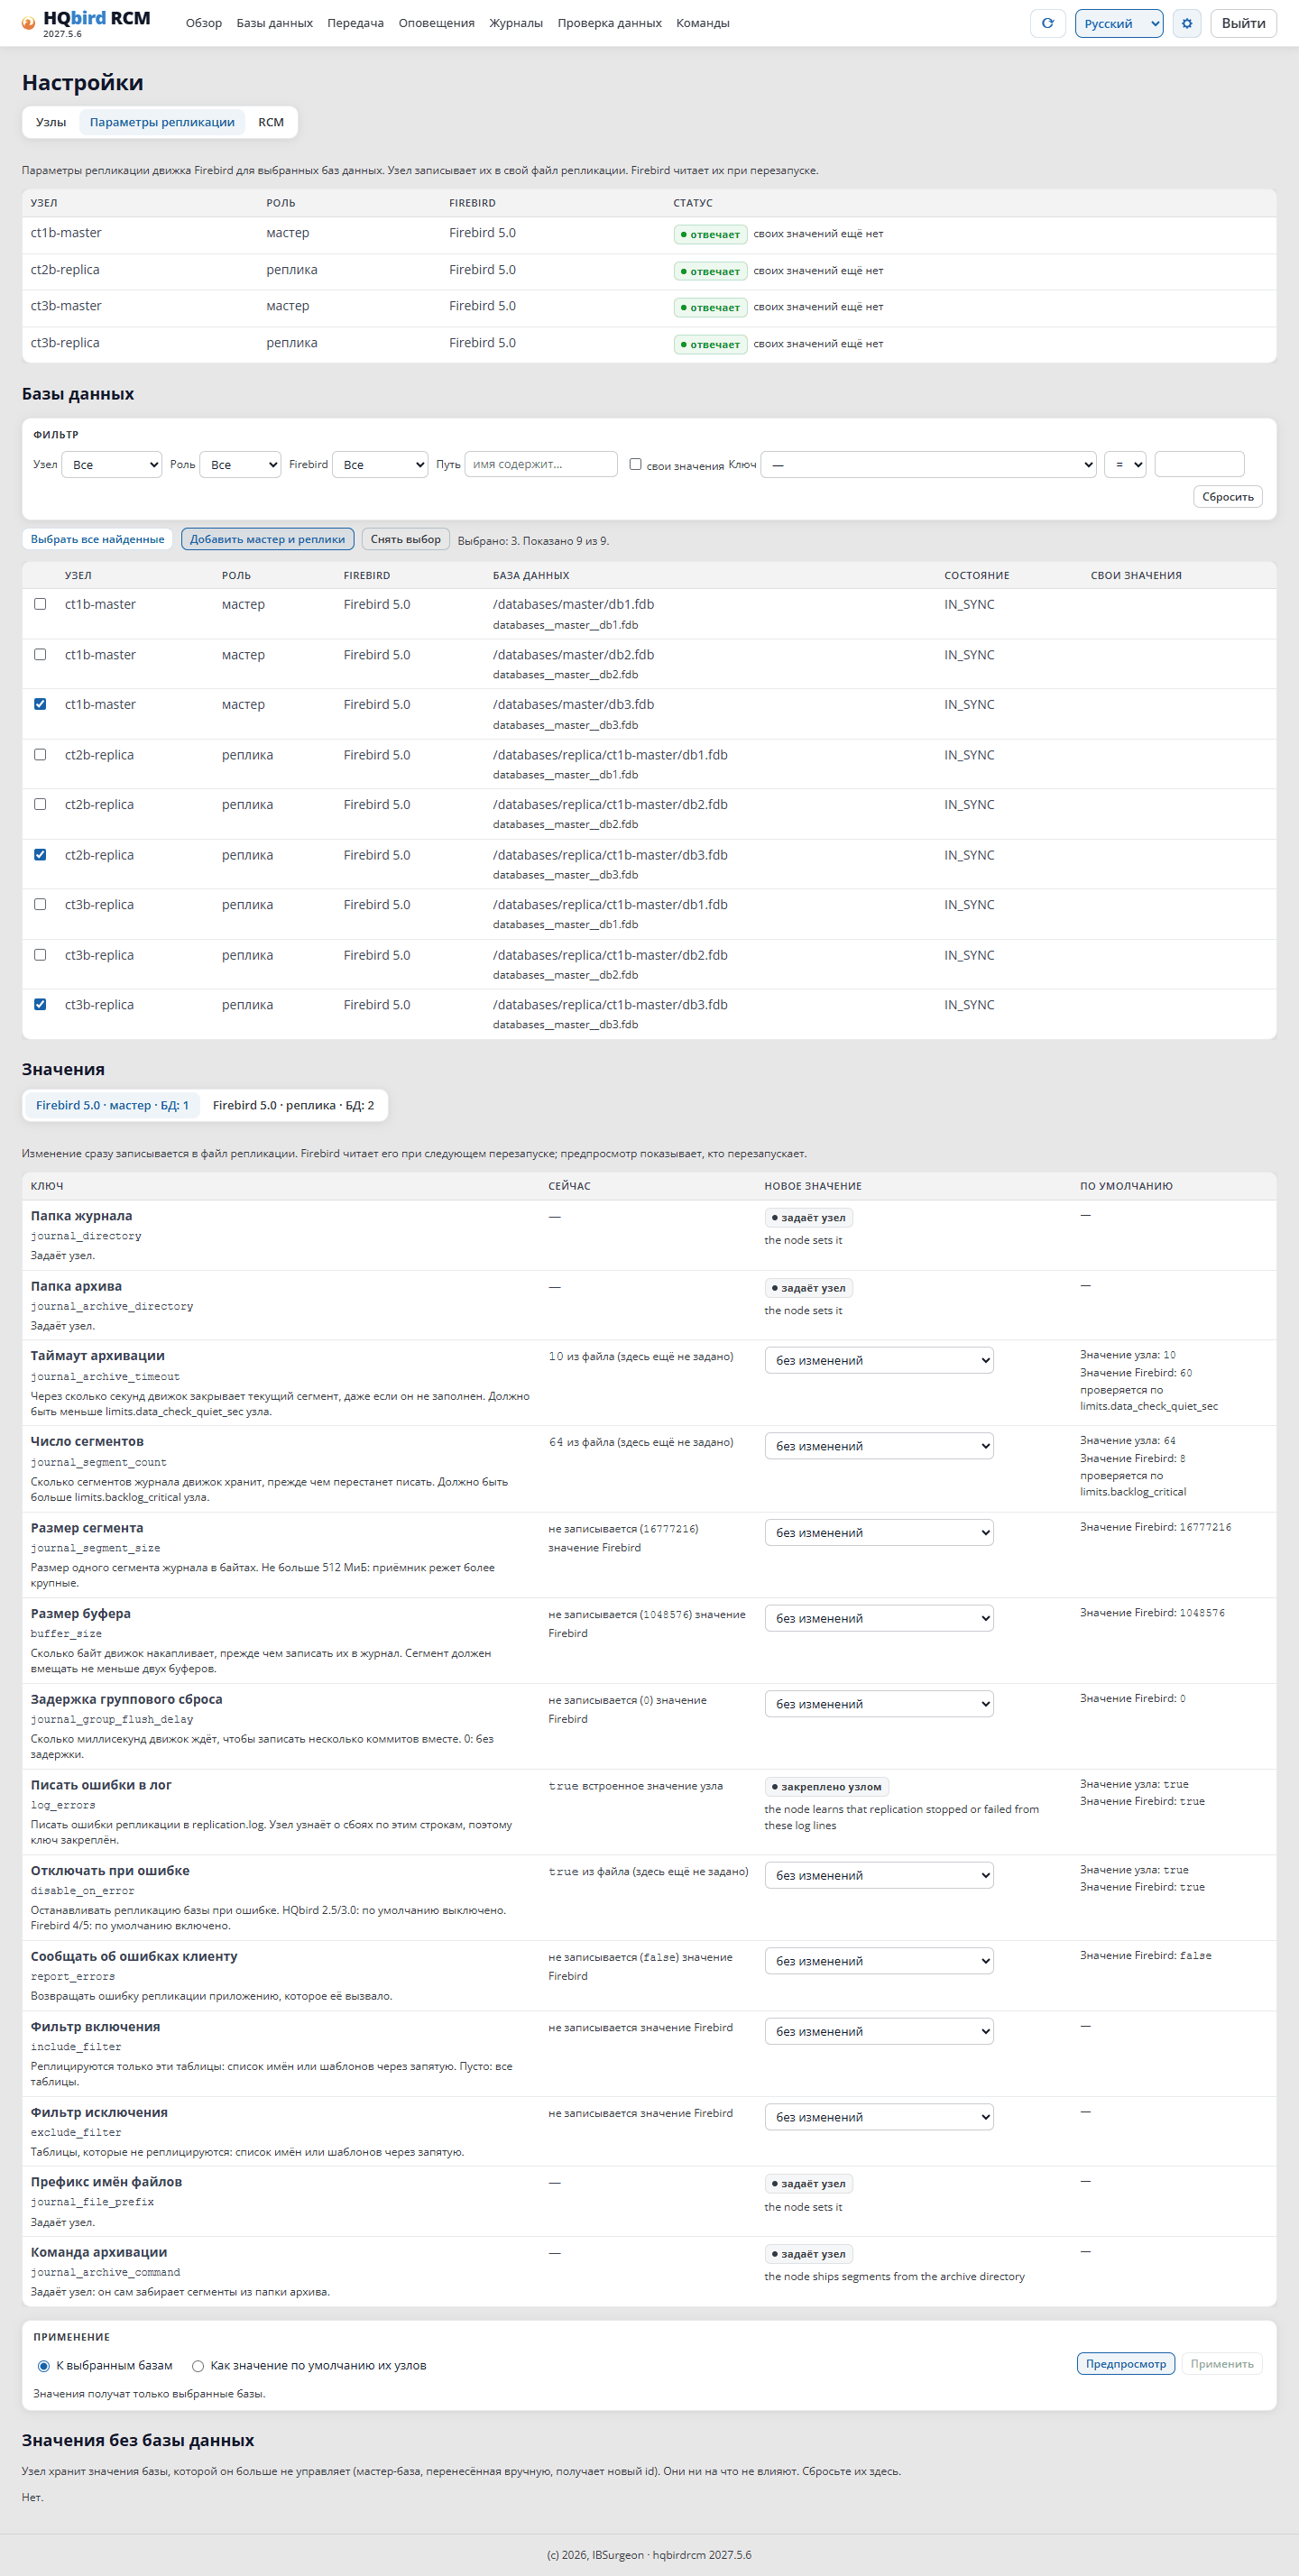
设置 → 复制参数 页更改所选数据库或整个节点的
replication.conf 中的键。
-
添加主库和副本 — 选择数据库。RCM 按 Firebird 版本和角色分组:主库和副本各有单独的表单。
-
对每个参数选择一个动作:
动作 作用 不更改 值不更改 设置值 新值 重置(到上一级) 去掉自己的值,取上一级的值 不写入(Firebird 值) 不写该键,使用 Firebird 的值 -
选择应用到何处:到所选数据库 或 作为其节点的 默认值。
-
预览 — 节点检查值,不更改任何东西。
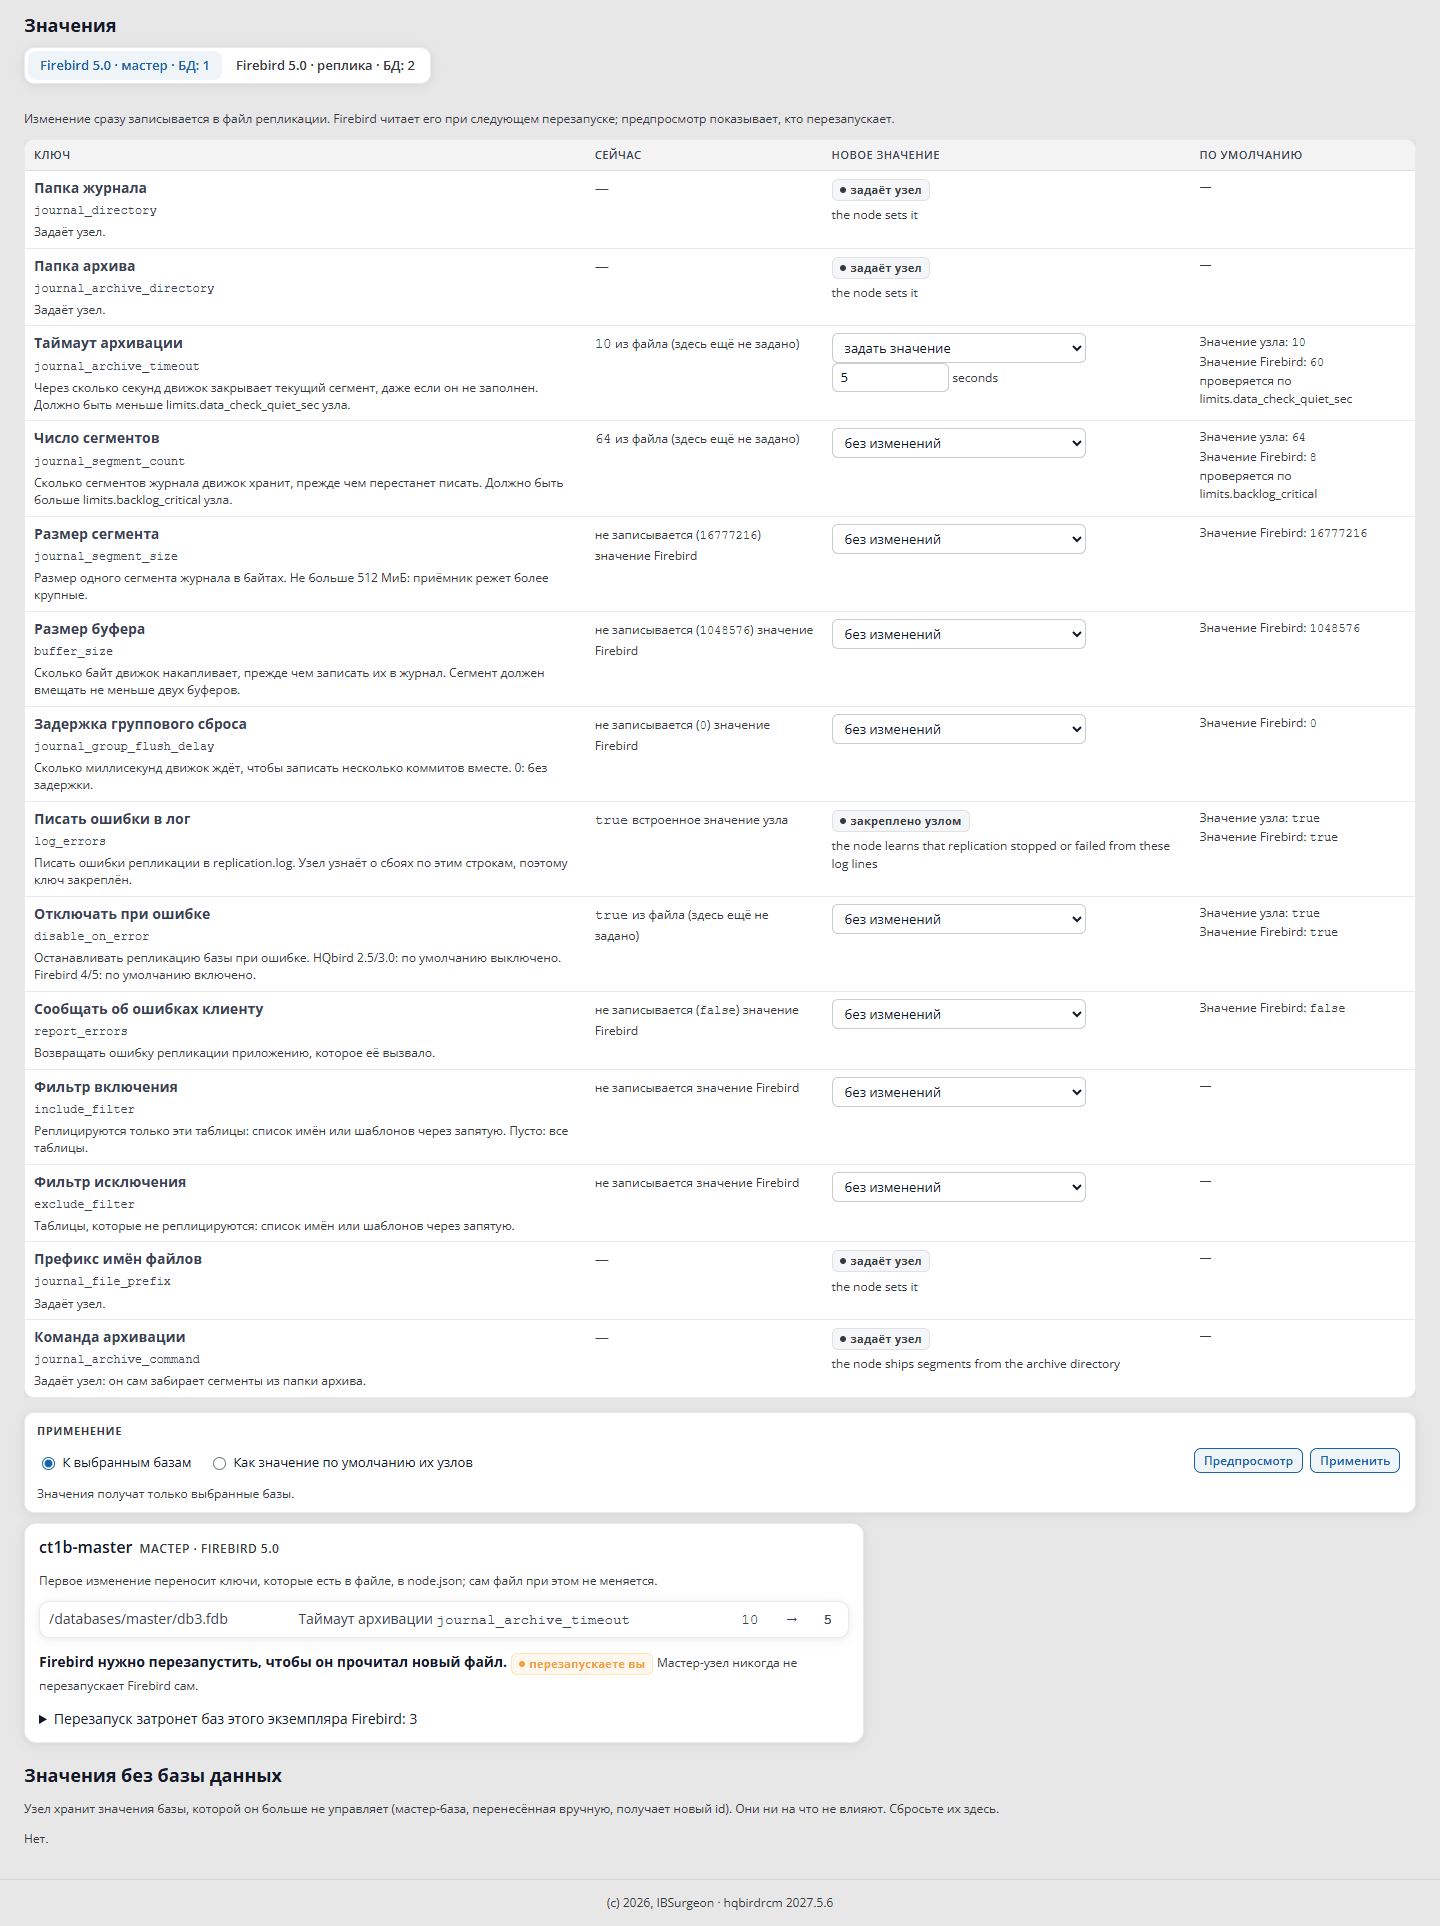
- 应用。RCM 把命令发给每个节点。
值从何处来(当前 列):
| 来源 | 值 |
|---|---|
| 此数据库 | 为该数据库设置 |
| 节点值 | 作为节点的默认值设置 |
| 内置节点值 | 代码中的节点值 |
| Firebird 值 | 不写该键 |
| 来自文件(此处尚未设置) | replication.conf 中的值,RCM 尚未更改 |
| 由节点设置 | 只读(路径、前缀) |
没有响应的节点会把它的数据库显示为不可选择。
更改需要 fbagent(否则 fbagent_required)。
谁重启 Firebird(Firebird 只在
启动时读取 replication.conf):
| 节点 | 谁 |
|---|---|
| 主节点 | 你重启它:主节点从不自己重启 Firebird |
firebird.auto_restart: never 的副本 |
你 |
| 其 Firebird 也服务于主库数据库的副本 | 你 |
| 其他副本 | 节点在自己的重启窗口中重启它 |
手动重启时,页面上有 重启 Firebird 按钮。
7.2. 主要参数
主节点,Firebird 4/5:
| 参数 | RCM 中的标签 | 节点值 | Firebird | 提示 |
|---|---|---|---|---|
journal_archive_timeout |
归档超时 | 10 秒 | 60 秒 | Firebird 在关闭未完成的段之前等待多少秒。更低 — 副本更接近主库。必须小于 limits.data_check_quiet_sec(90) |
journal_segment_count |
段数 | 64 | 8 | .ReplLog 中可以有多少个段。必须大于 limits.backlog_critical(48) |
journal_segment_size |
段大小 | — | 16 MB | 从 1 MB 到 512 MB;接收方不接受超过 512 MB |
buffer_size |
— | 1 MB |
节点还写入 log_errors = true(不能更改)和
disable_on_error = true。
副本,Firebird 4/5:
| 参数 | RCM 中的标签 | Firebird | 值 |
|---|---|---|---|
apply_idle_timeout |
空闲暂停 | 10 秒 | 没有新段时的暂停 |
apply_error_timeout |
应用错误后的暂停 | 60 秒 | 错误之后重试前的暂停 |
verbose_logging |
节点:true |
详细的 replication.log;不建议禁用 |
|
skip_upddel_without_pk |
节点:true |
跳过没有键的表上的 UPDATE/DELETE |
仅 Firebird 5:include_filter、exclude_filter、cascade_replication。
HQbird 2.5/3.0 — 含义相同的 log_* 键:log_archive_timeout、
log_segment_count、log_segment_size(不小于 2 × buffer_size)。
alert_command 键只在 node.json 中设置。
每个参数的提示在 RCM 表单中。
7.3. 归档存储
主节点上的 <database>.LogArch 归档分阶段清理:
- 所有副本都已 应用、并且早于
retention_days的段。 - 如果空闲空间小于
free_space_floor_gb— 比保留期更年轻的已应用段。警报disk_serious_cleanup。 - 如果空间仍然紧张 — 未应用 的段,从最旧的开始。
副本得到
NEEDS_REINIT,警报replication_paused_reinit_scheduled。
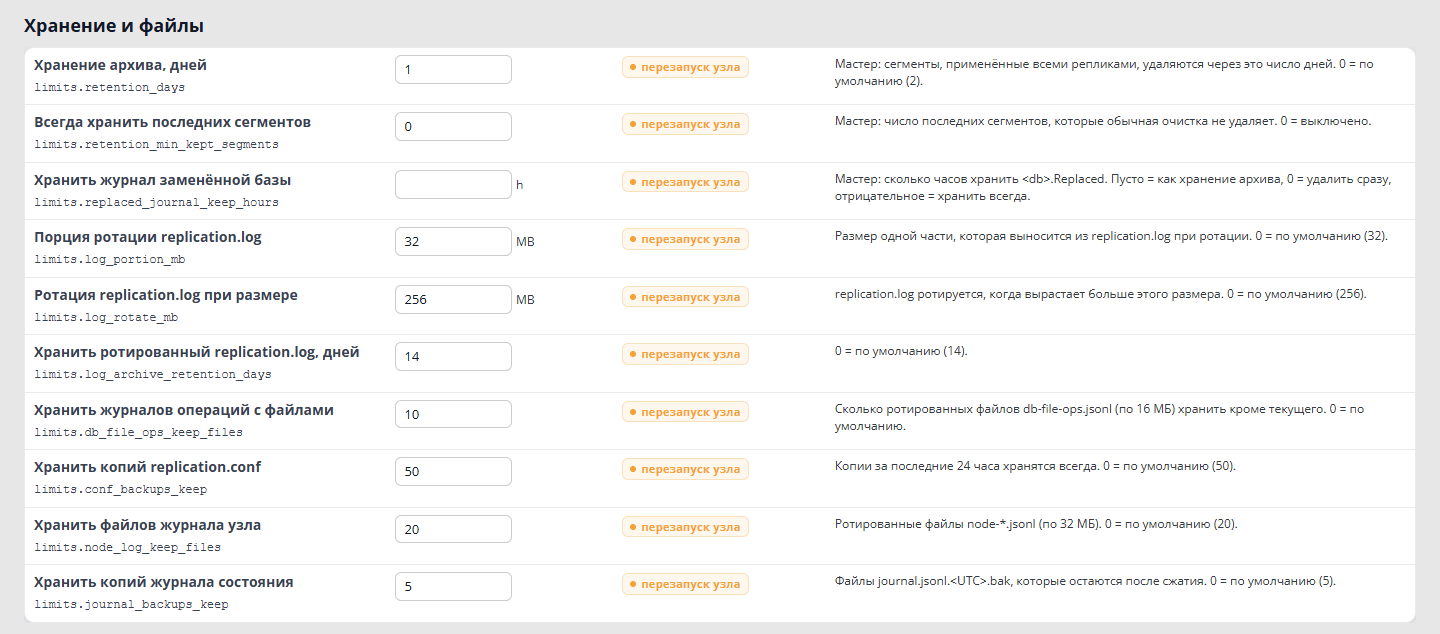
| 参数(设置 → 节点,存储和文件) | 默认 |
|---|---|
limits.retention_days — 归档保留,天 |
2 |
limits.retention_min_kept_segments — 始终保留最后的段 |
0(禁用) |
limits.free_space_floor_gb — 最小空闲空间 |
1 GB |
手动清理归档:
hqbirdrcm cleanuparchive -node node-a              # stages for all databases on the node
hqbirdrcm cleanuparchive -node node-a -db <db_id> # a single database-orphaned(只能与 -db 一起)删除处于
ORPHANED 状态的数据库的 全部 段(第 3.8 章)。对任何其他数据库,节点会响应 not_orphaned。
绝不要 对提升的捐赠方运行 -orphaned(第 8.5 章)。
7.4. 传输:压缩、速度、窗口
压缩 按对等方设置:设置 → 节点 → 对等方,列
compress。
| 值 | 含义 |
|---|---|
空或 none |
不压缩(默认) |
zstd |
zstd 压缩 |
更改立即生效。压缩在慢网络上有用。
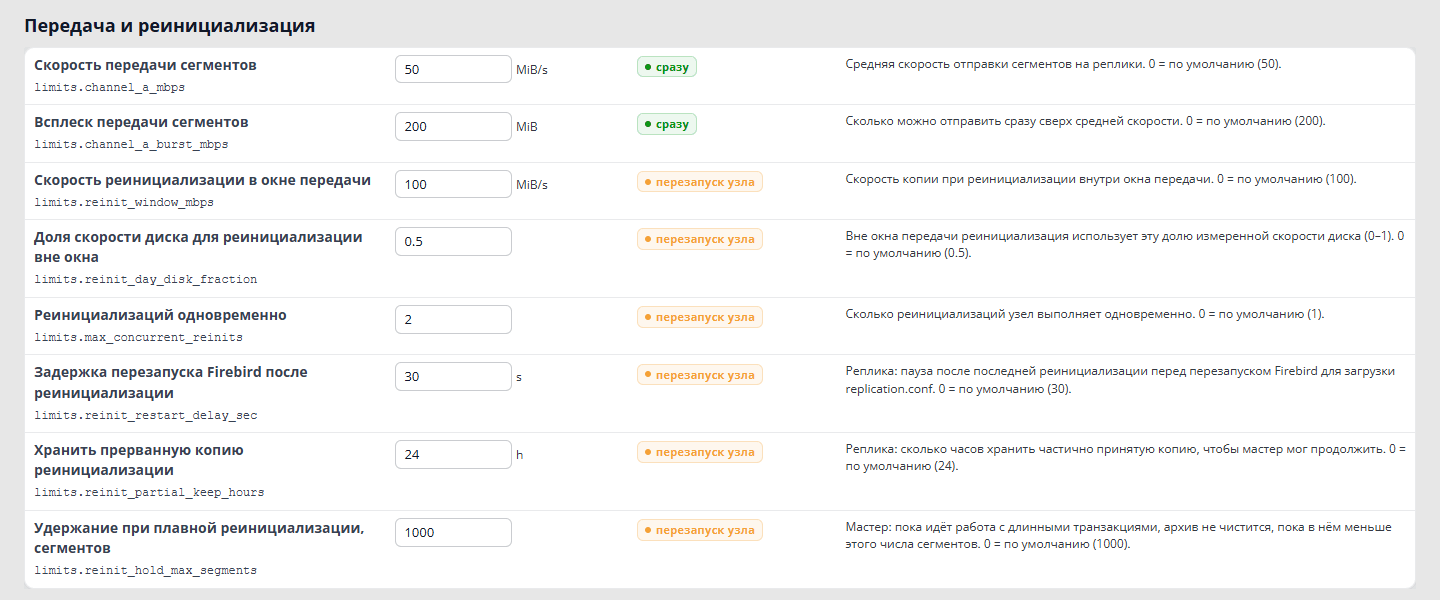
段传输速度(设置 → 节点,传输和 重新初始化):
| 参数 | 默认 | 何时生效 |
|---|---|---|
limits.channel_a_mbps — 段传输速度 |
50 MB/s | 立即 |
limits.channel_a_burst_mbps — 段传输突发 |
200 MB | 立即 |
单位是兆字节(MiB),尽管名称写着 “mbps”。突发不能 小于速度。
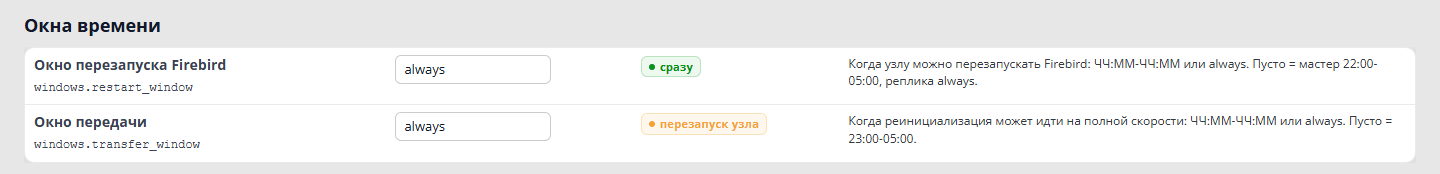
时间窗口(时间窗口):
| 参数 | 默认 | 何时生效 | 影响什么 |
|---|---|---|---|
windows.restart_window — Firebird 重启窗口 |
主节点 22:00-05:00,副本 always |
立即 | 副本节点何时可以重启 Firebird |
windows.transfer_window — 传输窗口 |
23:00-05:00 |
节点重启之后 | 全速初始化(第 5.5 章) |
每个字段旁边的标签显示更改何时生效:立即 或 节点重启。
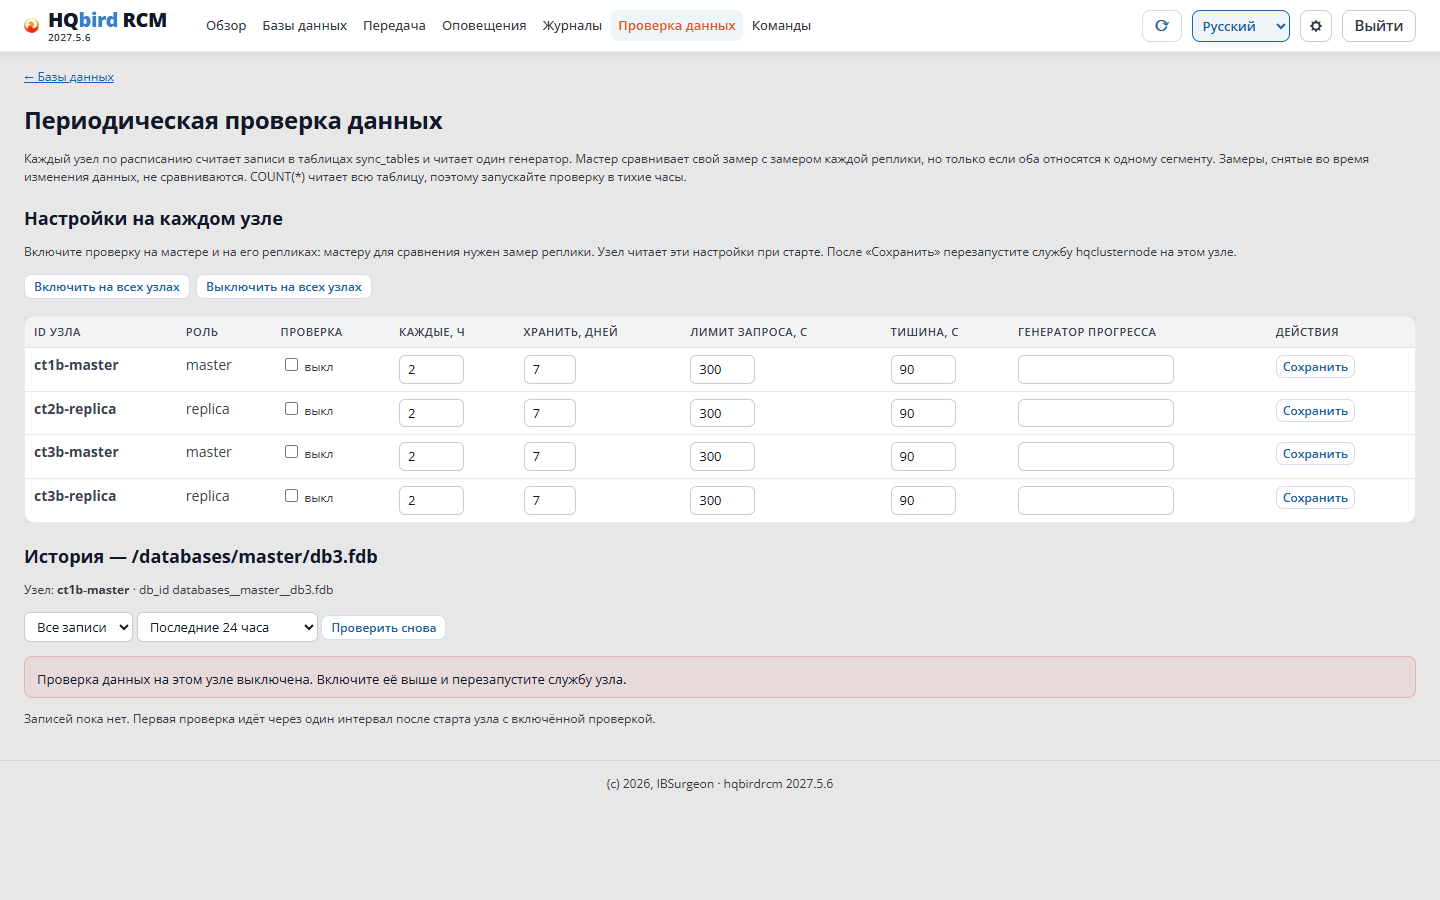
7.5. 数据验证
- 验证 — 一次性比较主库和副本上的行数 (第 5.10 章)。
- 数据验证 — 定期比较(第 5.10 章)。当主库和副本处于同一个段时,节点进行比较。
- HQbird 2027.2.24 起,验证设置在 保存 之后立即生效;不需要重启节点服务。RCM 显示“已保存并且已经 生效”。启用之后,第一次验证在一个间隔之后运行。 禁用之后,正在进行的验证被中断并且什么都不写。新的 间隔从上次验证结束时起算。保留,天、查询 限制、安静 和 进度生成器 从下一次 验证起生效。
- 节点 2027.5.7 只在启动时读取这些设置:保存 之后,重启该节点上的
hqclusternode服务。RCM 2027.2.24 显示“已保存,但尚未生效”并说明原因。 - 比较哪些表由数据库的表列表定义(第 3.1 章)。HQbird
2027.2.24 起,每个数据库可以有自己的列表:登记时的字段,或主库数据库页上的
同步跟踪表 块
(第 3.3 章)。数据验证 页显示使用了哪个列表,
以及“不在数据库中”的表的数量。在 2027.5.7 中列表按节点
(
sync_tables)。 - 从发布中排除的表显示为“未发布” (第 6.3 章)。
7.6. 警报
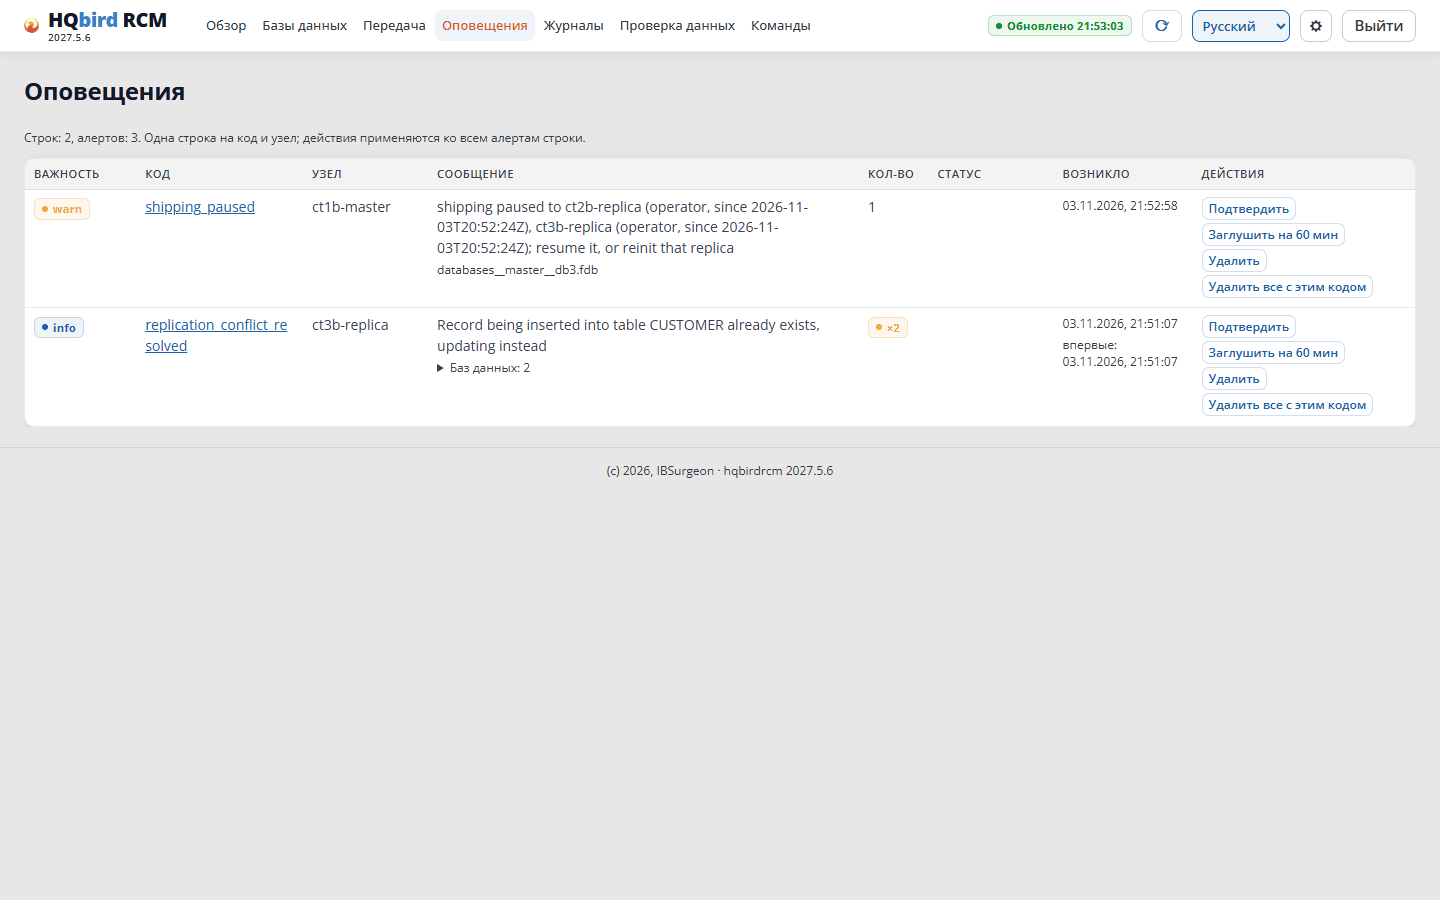
警报 页。动作:
- 确认 — 警报仍然可见,但标记为 已确认;
- 静音 60 分钟 — 隐藏一小时;
- 删除 / 删除此代码的全部 — RCM 把删除传给发出警报的节点。如果原因仍在,警报会再次出现。
hqbirdrcm clearalerts -code backlog_warn # also -id, -acked, -all自 HQbird 2027.2.33 起,RCM 把警报发到 Telegram、webhook(Slack、
Teams、JSON)和电子邮件。通道在 rcm.json 文件的 notify.channels
节中配置。警报 页上的 通知通道 块
显示通道并发送测试消息。RCM 报告
warn 及以上级别的问题:问题已出现、变得更
严重,或已清除。没有通道时,RCM 什么都不发送。更早的
版本没有发送:看 警报 页或轮询 RCM API。
主要代码:
| 代码 | 含义 |
|---|---|
backlog_warn / backlog_critical |
.ReplLog 中 32 / 48 个未归档的段 |
disk_serious_cleanup |
归档正在第 2 阶段清理(7.3) |
replication_paused_reinit_scheduled |
未应用的段已删除,需要初始化 |
shipping_paused |
发往对等方的发送已暂停(7.7) |
apply_error、replication_stopped、replication_unrecoverable_error |
副本无法应用段 |
replication_guid_mismatch |
主库数据库 GUID 已更改 |
segment_missing、segment_rejected、sequence_gap |
段序列问题 |
firebird_down、firebird_log_error |
Firebird 没有运行或正在记录错误 |
firebird_not_answering |
自 HQbird 2027.2.30 起:Firebird 一分钟没有应答数据库连接(挂起)。这也包括因超时而未能建立的连接;firebird_down 只是连接被拒绝 |
master_publication_off |
发布关闭(第 6 章);自 HQbird 2027.2.24 起,以及 publication_off 失败之后(第 6.1 章) |
replica_removed_for_reinit |
自 HQbird 2027.2.24 起:副本为初始化删除了旧副本,新副本尚未就位(第 4.4 章) |
orphaned_database |
扫描之外的数据库(第 3.8 章) |
restart_required_after_reinit |
副本的 Firebird 需要重启(第 5.6 章) |
data_mismatch |
定期检查发现差异 |
license_paused |
fbagent 没有许可证(第 2.8 章) |
7.7. 暂停发送
在 数据库 页上,主库行中:暂停发送 / 恢复发送。对多个数据库 — 通过 操作 列表。
hqbirdrcm pauseshipping  -node node-a -db <db_id>
hqbirdrcm resumeshipping -node node-a -db <db_id>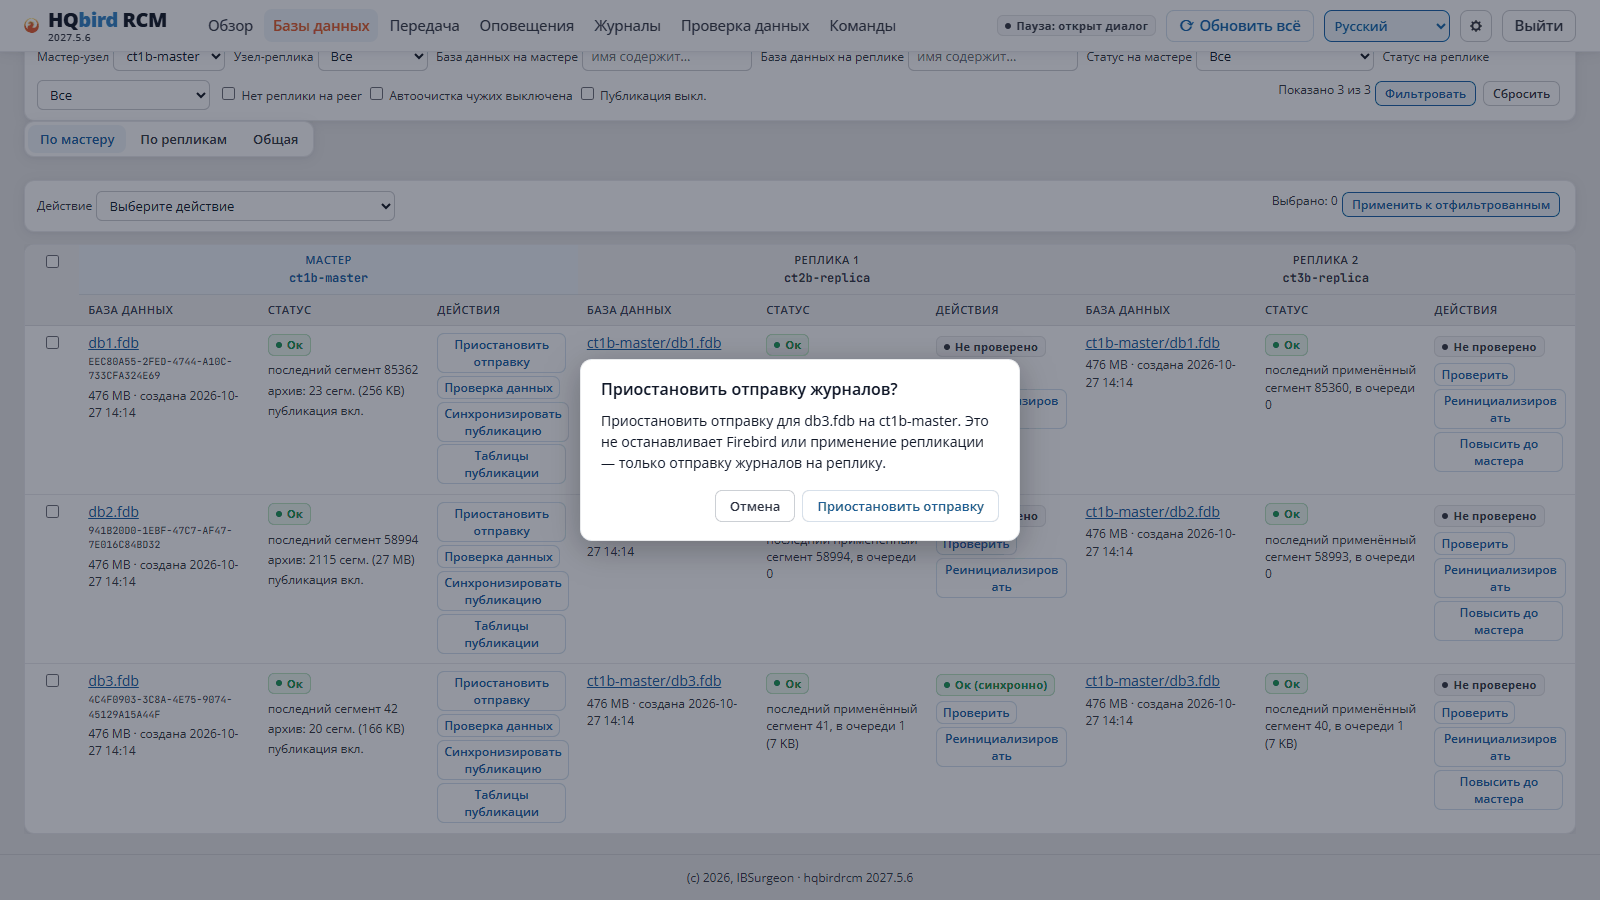
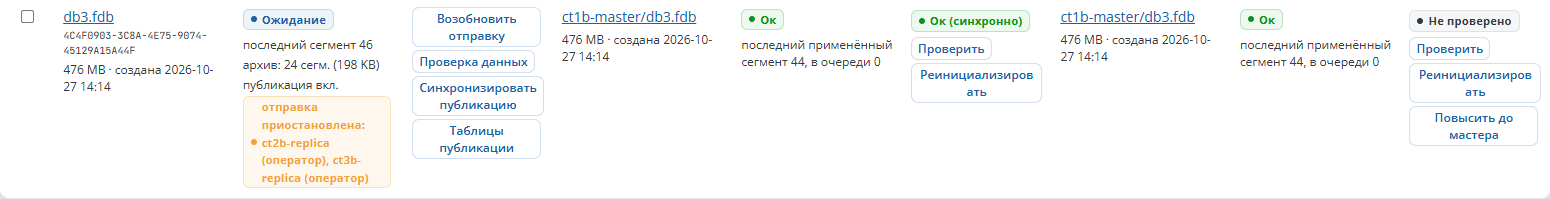
- 暂停一直有效,直到 恢复发送 或直到初始化。
- 主库 Firebird 继续写段。
.LogArch归档增长:副本 停止期间,第 1 阶段(7.3)不删除它的段。 - 长时间暂停可能到达第 3 阶段和
NEEDS_REINIT。留意空间。 - 如果数据库没有副本或发布被禁用,没有该按钮。 暂停:无许可证 图标表示与许可证有关的暂停(第 2.8 章);它只由许可证清除。
7.8. 日志
| 日志 | 位置 |
|---|---|
| 节点 | <安装文件夹>/logs/node-YYYYMMDD.jsonl(/opt/hqclusternode 或 C:\hqclusternode),每个 32 MB,20 个文件 |
Firebird replication.log、firebird.log |
node.json 中的路径:firebird.replication_log、firebird.firebird_log |
| RCM | Linux:journalctl -u hqbirdrcm |
| RCM 审计 | rcm-data/audit.jsonl |
远程节点日志 — 日志 页:选择节点和来源 (replication.log、firebird.log、节点代理)。
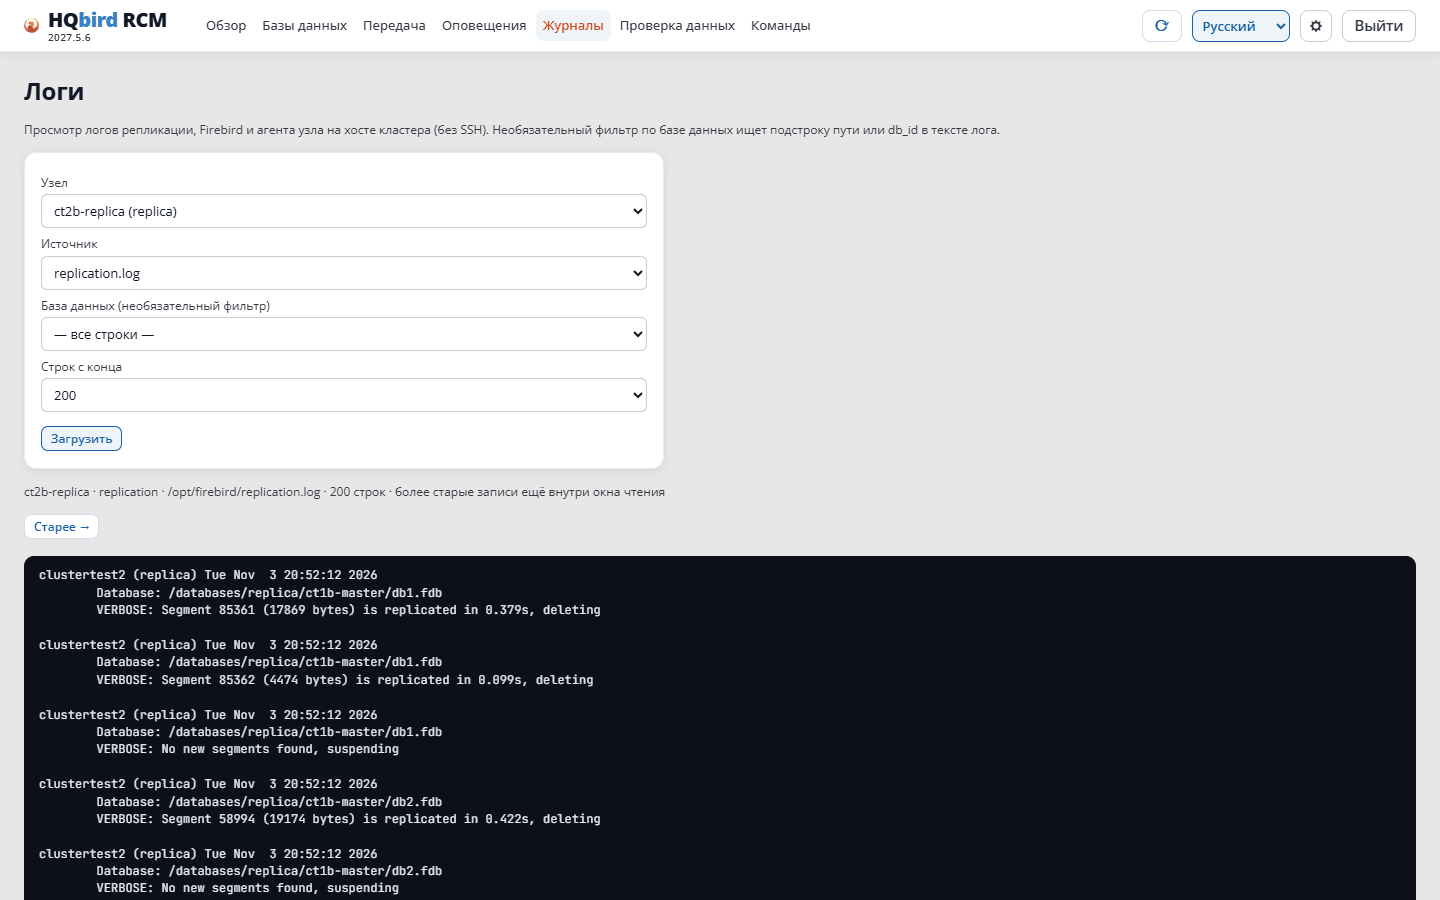
hqbirdrcm getlogs -node node-b -source replication -tail 2008. 如何把副本转为普通数据库
有两条路径:
| 路径 | 何时 | 你得到什么 |
|---|---|---|
| 转为普通,8.1 | 需要一份单独的工作副本:报表、测试、没有新主节点的故障 | 复制之外的普通数据库 |
| 提升为主节点,8.3 | 副本应当成为新主节点 | 由角色为主节点的伴随节点管理的数据库 |
两条路径都不能通过界面撤销。
8.1. 转为普通
-
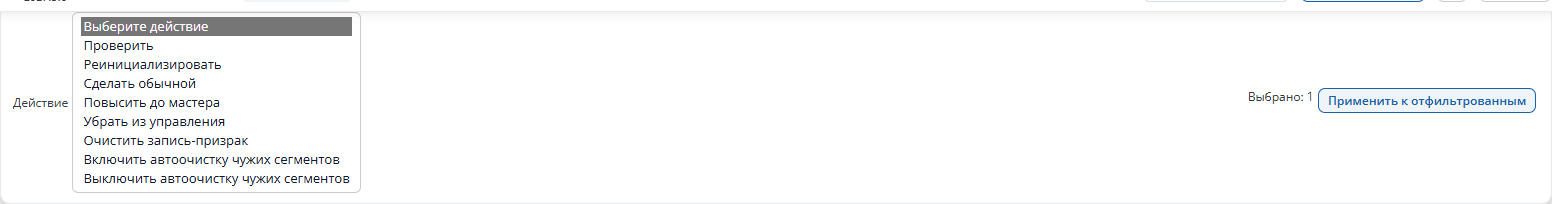
数据库,副本一侧:勾选副本行。
-
在 操作 列表中选择 转为普通 并确认。 行中没有单独的按钮。也没有命令行命令。
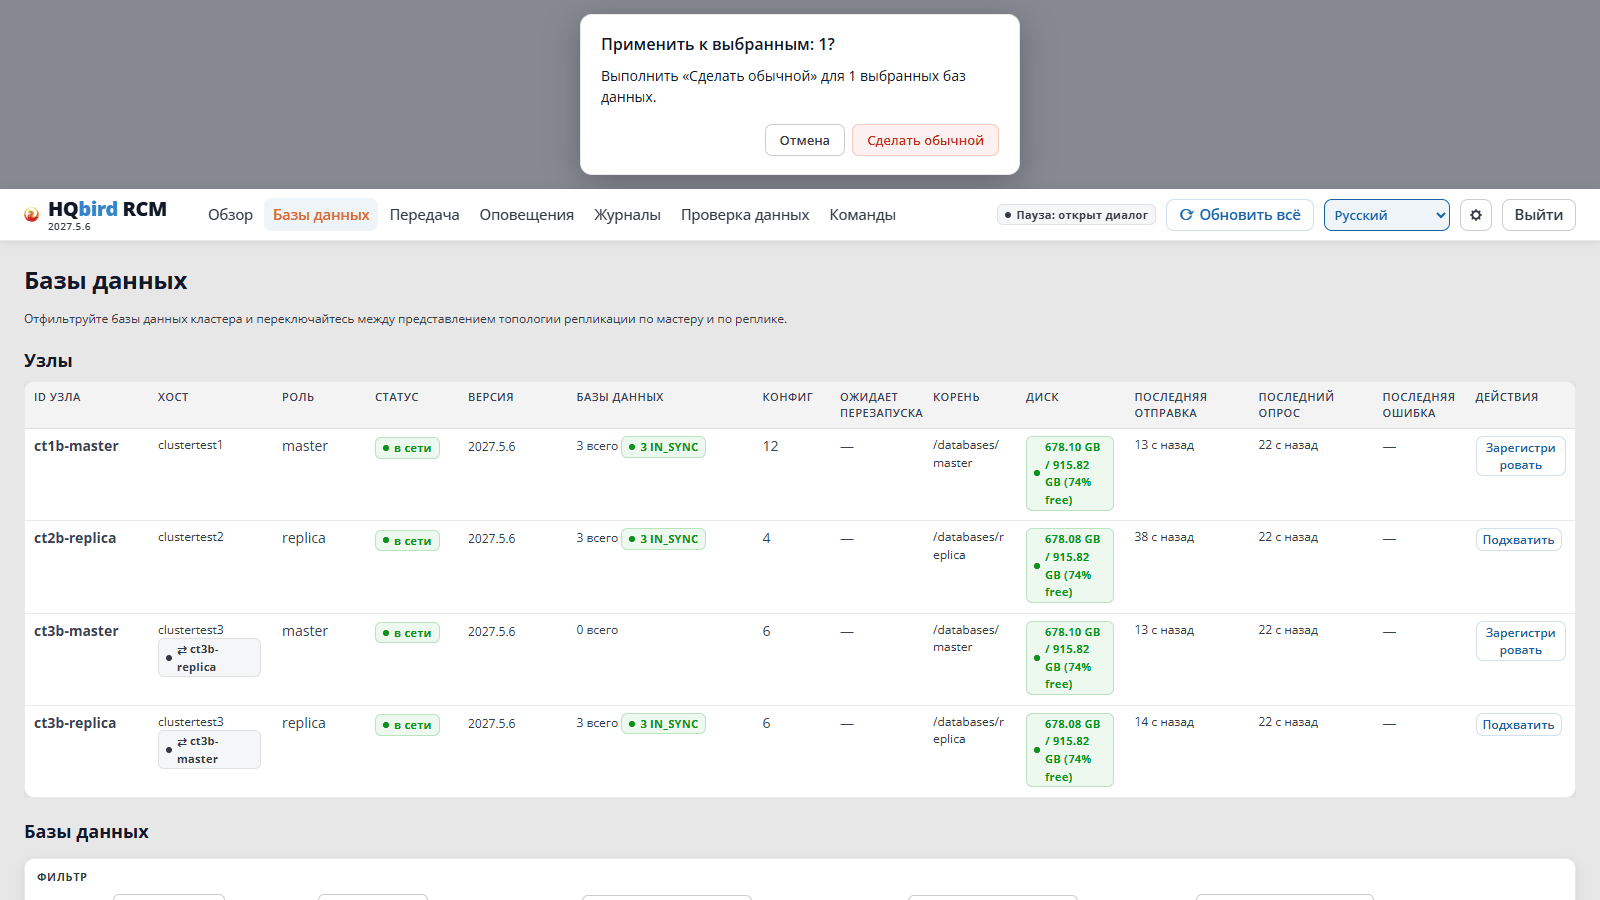
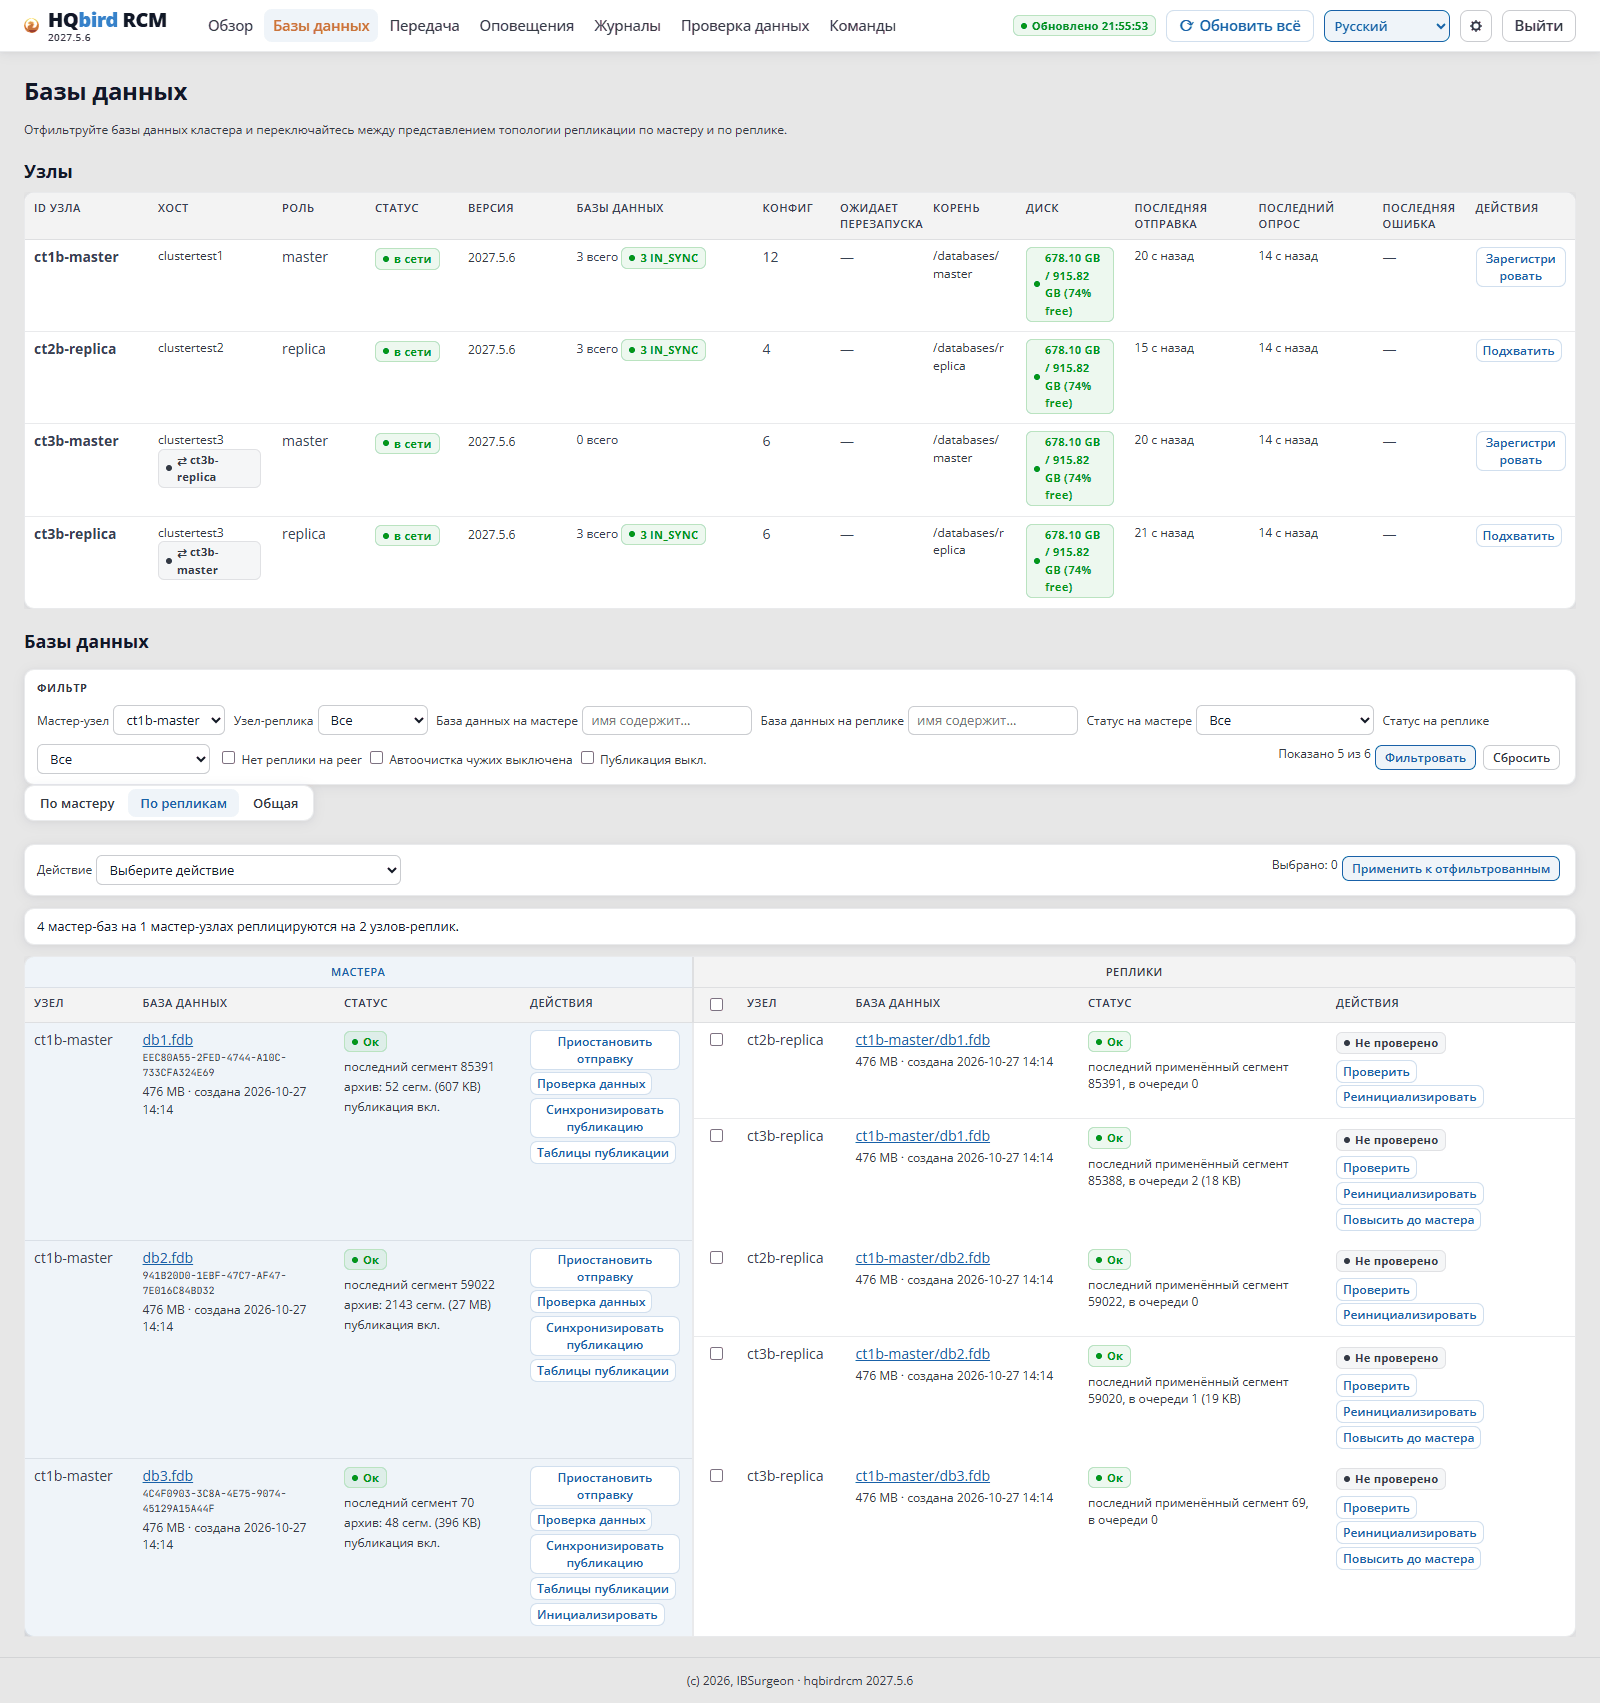
此后,数据库可以写入。
从 replication.conf 中移除副本块。 节点在下次
扫描时移除它,Firebird 在启动时读取该文件:
hqbirdrcm scansync -node node-b
hqbirdrcm restartfirebird -node node-b
在此之前,该数据库的“数据库不在副本模式”错误不会 作为警报发出。
标记文件保护数据库。 初始化不会覆盖这样的数据库:
它以 target_not_replica 被拒绝(第 5.9 章)。只删除标记不够:
节点还检查数据库头中的副本模式。删除旧
副本 复选框(第 4.4 章)也不删除这样的数据库。
HQbird 2027.2.24 起,当副本正在为
初始化删除该数据库的旧副本时,转为普通 以 reclaim_in_progress 被拒绝:
稍后重试。
如果数据库需要再次成为副本 — 只能用带
覆盖的新初始化。这通过节点 API 完成(overwrite_non_replica: true);RCM 中没有这样的按钮。旧文件保存为
<database>.pre-reinit-<UTC 时间>.fdb,标记被删除。
8.2. 段会怎样
- 在节点扫描数据库之前,主节点继续发送段。副本节点每 30 秒删除旧段,只保留 最后 100 个(
keep_segments)。 - 扫描之后,副本上的数据库记录得到状态
ORPHANED。副本节点用unknown_database答复主节点。主节点停止向该副本发送段,停止为它保留归档,并每 10 分钟重新检查一次。 - 该数据库的其他副本不受影响。
ORPHANED记录可以删除(第 3.8 章):hqbirdrcm forgetdatabase。数据库文件本身不删除。
8.3. 提升为主节点
副本成为新主节点。它的文件留在原地,控制 交给 伴随节点。
条件:
| 条件 | 拒绝 |
|---|---|
| 数据库是副本 | bad_request |
同一主机上有角色为主节点的节点 — 伴随节点 — 正在运行(rcm.json 中相同的 host 标签,第 2.1 章) |
no_companion |
| 该数据库的提升尚未在进行 | already_running |
| 没有进入该数据库或来自其主节点的初始化 | reinit_running |
RCM 不创建伴随节点:事先安装它(第 1 章)。
如何开始:
-
在副本行中,提升为主节点,或在 操作 列表中;
-
从命令行:
hqbirdrcm promotetomaster -node node-b -db <db_id> # -timeout 10m
RCM 会要求确认并指出伴随节点。
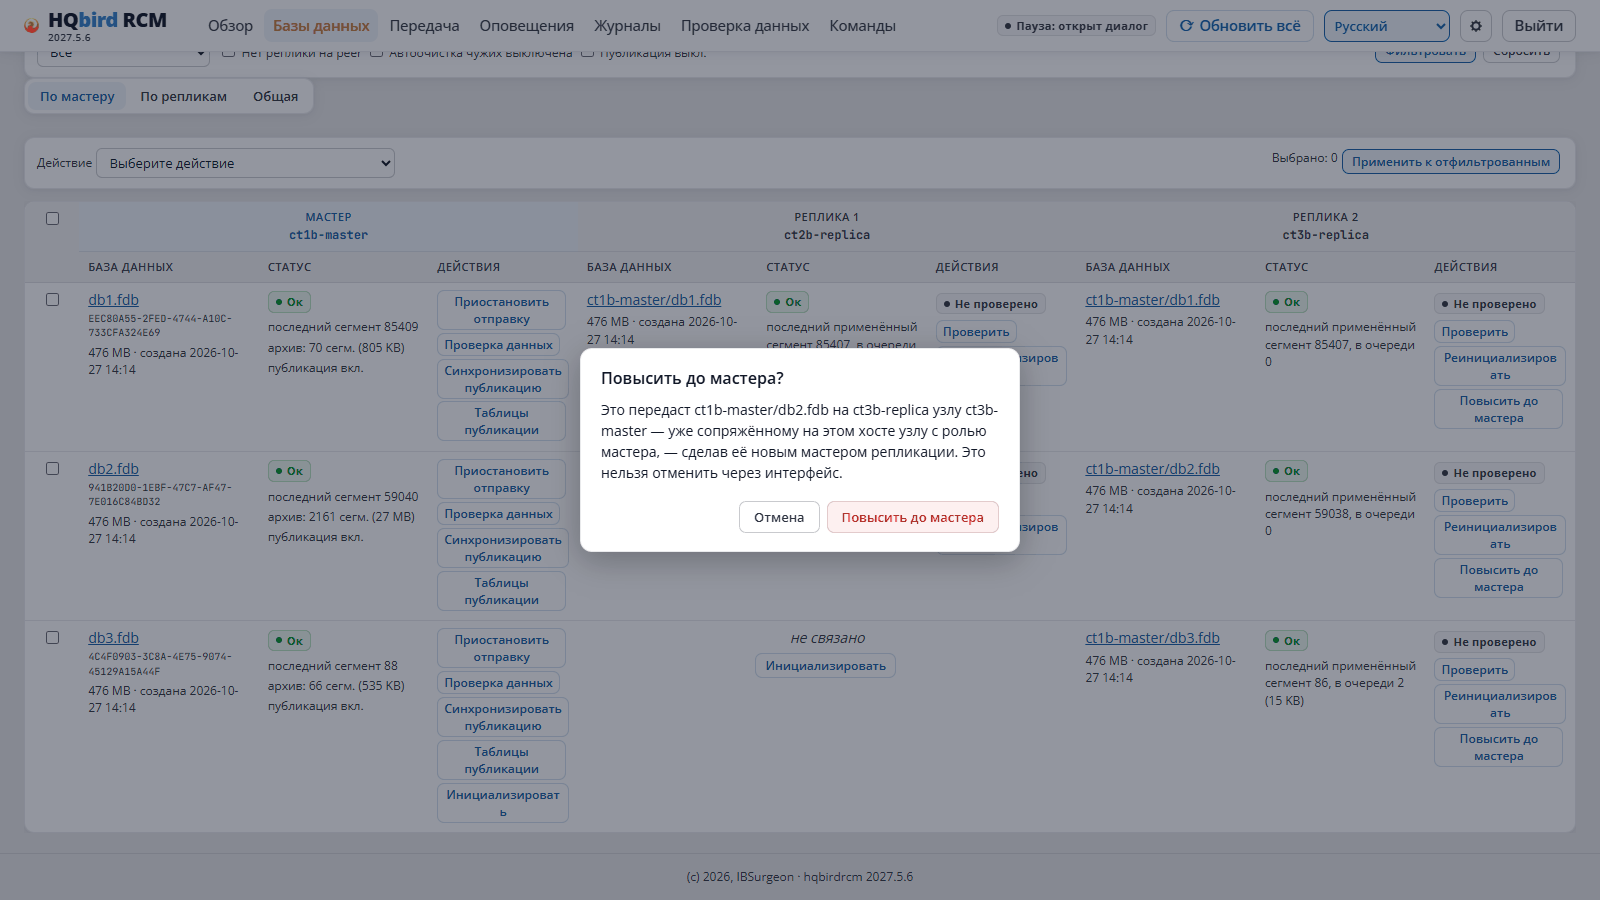
步骤(在副本行中可见,名称用英语):
| 序号 | 步骤 | 作用 |
|---|---|---|
| 1 | TURN TO NORMAL | 与 8.1 相同;如果数据库已经是普通库则跳过 |
| 2 | NEW GUID | 就地得到新的数据库 GUID(8.4) |
| 3 | EXCLUDE ON DONOR | 副本节点(捐赠方)把文件排除出自己的扫描(exclude_paths) |
| 4 | ENROLL ON |
伴随节点把文件登记为主库数据库 |
| 5 | PUBLICATION SYNC | 同步发布;被排除表的列表从旧主节点带来(第 6.3 章) |
| 6 | RESTART DONOR FIREBIRD | 重启捐赠方的 Firebird,不等待窗口 |
| 7 | RESTART |
重启伴随节点的 Firebird,不等待窗口 |
| 8 | FINALIZE | 捐赠方行变成 幽灵副本;旧主节点可能变成 主节点降级(8.5) |
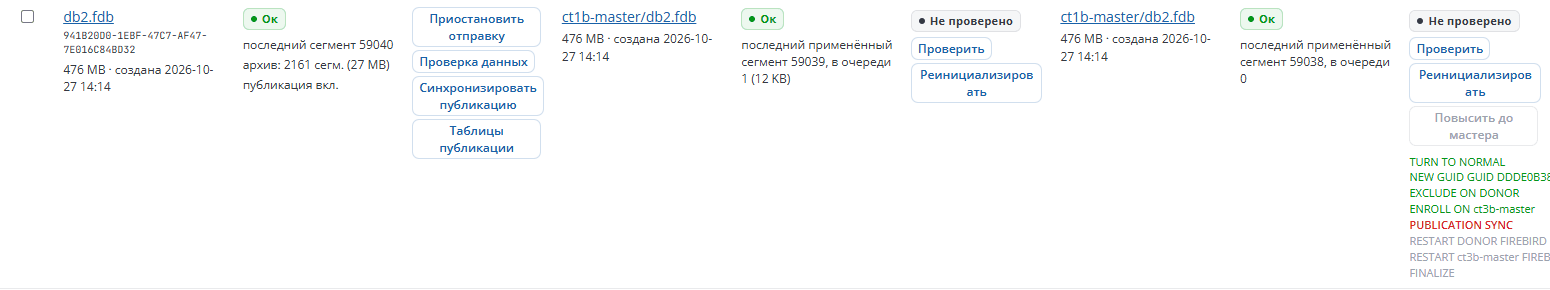
HQbird 2.5 和 3.0 没有发布:PUBLICATION SYNC 步骤 以文字“此引擎没有发布”完成。
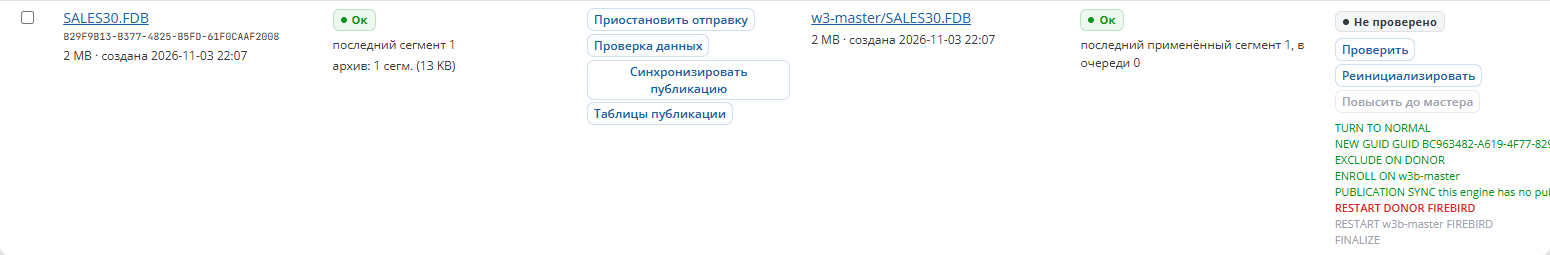
如果捐赠方和伴随节点使用同一个 Firebird,该 Firebird 会被 重启:到它的 所有 数据库的连接都会断开。
如果某一步失败,作业得到 failed 以及错误文本。修正
原因并再次单击 提升为主节点:已完成的步骤不会
重复。如果提升期间 RCM 重启,作业也会变成
failed — 检查节点状态并重试。
许可证。 如果主节点主机上的 fbagent 没有许可证,主节点 已暂停发送。提升仍然可能。RCM 会警告你: 暂停开始之后所做的变更会丢失。
8.4. 新 GUID
提升之后,数据库必须得到自己的 GUID。否则新主节点会在
旧主节点的 GUID 下写段,它的副本会以
duplicate_guid 被拒绝。
节点上的 NEW GUID 步骤:
gfix -shut single -force 0— 到该数据库的全部连接被终止;nbackup -L,然后不带-SEQUENCE的nbackup -F;- 删除
<database>.delta; - 检查文件头:新 GUID,
REPLICATION_SEQUENCE= 0; gfix -online normal。
Firebird 不重启。该方法在所有版本上有效(2.5、3.0、4.0、 5.0)。
如果该步骤被中断,节点发出警报 newguid_interrupted。数据库可能
留在 single 关闭中。重复 提升为主节点:该步骤
会继续。
如果捐赠方节点是旧
版本,或文件已经有自己的 GUID,该步骤被跳过(文字以 skipped: 开头)。
新 GUID 之后,旧的 nbackup 链不再适用。制作新的 0 级 nbackup 副本。
如果数据库是用 ADD DIFFERENCE FILE 创建的,它的 .delta 在不同的
位置:手动删除它。
8.5. 提升之后
捐赠方记录。 在副本节点上数据库保持 ORPHANED,路径留在
exclude_paths 中,.Incoming 文件夹和标签保留。在 RCM 中这是
带按钮 在新主节点上打开 和 清除 的 幽灵副本 行。
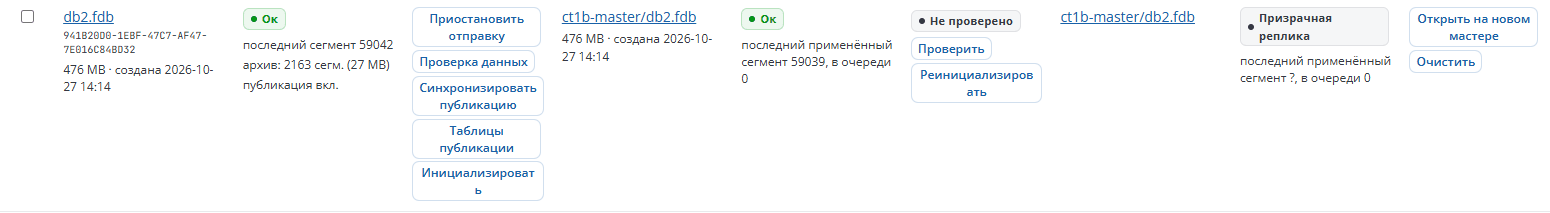
- 要去掉该行,单击 清除。这只更改 RCM。
- 要从副本节点去掉捐赠方记录,运行
forgetdatabase。 文件和.Incoming文件夹保留。HQbird 2027.2.30 及更新不会 拒绝该命令(mailbox_active),因为捐赠方路径在exclude_paths中。更早版本的节点在文件和.Incoming文件夹存在时拒绝它。 - 绝不要对捐赠方运行
cleanuparchive -orphaned。 捐赠方和 伴随节点共享同一个<database>.LogArch文件夹。该命令会删除新主节点的活动 归档。
旧主节点。
-
如果捐赠方是它最后一个正在工作的副本,RCM 把旧 主节点设为 主节点降级,并暂停向捐赠方发送 (“发送已暂停:……(提升为主节点)”)。不要恢复 向捐赠方的发送:它已经持有一个正在工作的数据库。要清除此状态, 把数据库初始化到另一个副本上。
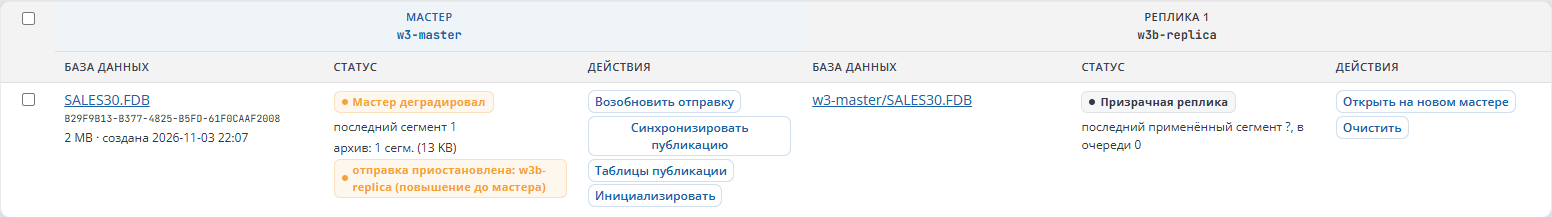
旧主节点:“主节点降级”,发送已暂停
- 从旧主节点到捐赠方节点的初始化会被拒绝
(
target_not_replica):它已经持有一个正在工作的数据库。 - 如果跳过了 NEW GUID 步骤,旧主节点和新主节点有相同的 GUID。
这时从旧主节点初始化需要
-force(第 5.9 章)。 - 手动提升之后,RCM 不会把旧主节点变成新 主节点的副本。停止旧主节点上的应用程序,并把其数据库移出 管理(第 3.8 章)。对于描述为服务的数据库,这由重新加入 完成(8.7)。
新主节点。 为它设置副本:副本节点、对等方(第 2 章)、 发布(第 6 章)、初始化(第 5 章)。
8.6. 计划切换:核对清单
这是手动切换的步骤。对于描述为服务的数据库,RCM 自己切换主节点(8.7)。手动提升不检查应用程序是否正在写入旧主节点。步骤:
- 事先。 在副本主机上,角色为主节点的伴随节点正在运行,两个节点有相同的
host标签(第 2.1 章)。为新主节点准备好未来副本的节点。 - 停止对旧主节点数据库的应用程序写入。
- 等到副本已接收并应用全部内容:数据库 →
IN_SYNC,没有队列。 - 检查(第 5.10 章):行数一致。
- 提升为主节点(8.3)。等待 FINALIZE 步骤。
- 检查:数据库在伴随节点的主库列表中,发布开启。
- 把应用程序切换到新主节点。
- 为新数据库制作 nbackup 0 级副本(8.4)。
- 清除捐赠方行的幽灵记录(8.5)。
- 把副本连接到新主节点并初始化它(第 5 章)。
- 旧主节点:把数据库移出管理,或留作归档(8.5)。
8.7. 服务:RCM 中的切换和故障转移
自 HQbird 2027.2.30 起,RCM 自己把主节点移到另一台主机。为此,数据库被描述为一个 服务:几台主机上的一个逻辑数据库。服务的每台主机上都有一个主节点和一个副本节点,数据库文件的路径相同。服务在 服务 页上创建(自 HQbird 2027.2.31 起),或用命令 hqbirdrcm services put -id <id> -file <file>.json。
| 动作 | 作用 | 命令 |
|---|---|---|
| 切换 | 计划转移主节点,不丢失数据。之后旧主节点自动成为新主节点的副本 | hqbirdrcm switchover -service <id> -check,然后 hqbirdrcm switchover -service <id> -to <host> |
| 故障转移 | 主节点主机丢失:RCM 提升副本。主节点最近的变更可能丢失 | hqbirdrcm failover -service <id> -check,然后 hqbirdrcm failover -service <id> -to <host> -accept-data-loss |
| 重新加入 | 故障转移之后,把旧主机作为新主节点的副本加回来 | hqbirdrcm rejoin -service <id> |
| 恢复 | 把服务从 failed 状态中取出 |
hqbirdrcm resume -service <id> -check,然后 hqbirdrcm resume -service <id> |
服务页上有同样的动作:切换…、故障转移…、重新加入… 和 恢复… 按钮。
- 自动故障转移 默认关闭。它按每个服务单独启用:
hqbirdrcm policy -service <id> -auto-failover on -max-data-loss 30。 它需要路由器。只有当主节点沉默、大多数路由器看不到主节点的 Firebird,并且副本滞后不超过max_data_loss_sec时,RCM 才启动故障转移。 - 路由器(
hqclusternode router,Linux)把 HAProxy 保持在服务的当前主节点上。应用程序连接到<路由器主机>:<router_port>,切换时不更改连接字符串。 - 故障转移之后,旧主节点再次响应时,RCM 会隔离它(角色
fenced)。用rejoin命令把它加回来。