Clúster HQbird 2027 en Linux: maestro y réplica con RCM
Otros idiomas: Русский, Português.
Esta guía va desde dos servidores limpios hasta una réplica de Firebird 5.0 en funcionamiento.
Todo se hace en el navegador, en la consola de RCM, excepto la
instalación y una carpeta. Las capturas de pantalla provienen de la ejecución del
2026-11-17: kit 2027.2.33, RCM y nodos 2027.5.12, Ubuntu 24.04, la
interfaz en inglés. El informe de la ejecución anterior del 2026-11-08:
hqbird2027-rcm-cluster-check-report.ru.md
(en ruso, sección «Прогон 2»). Solo comandos, sin capturas de pantalla:
hqbird2027-linux-cluster-runbook.md. Cada página de RCM en detalle:
la guía de usuario de RCM (repositorio hqcluster-node, docs/user-guide/).
Esta guía es para el kit 2027.2.24 y posteriores. Para el kit 2027.2.22, consulte la edición de este archivo del 2026-11-07 en el historial de git.
El kit que hay que descargar es 2027.2.33 (2026-11-16): agent 3.4.0, HQ Monitor 1.57.0, RCM y nodos 2027.5.12, Firebird 5.0.5.1917. Esta guía se comprobó con él el 2026-11-17 (dos servidores, Ubuntu 24.04, bases de datos de 3 MB y 167 MB): todos los pasos pasaron. El texto denomina los resultados de esa ejecución como “la ejecución del 2026-11-17”. Las capturas de pantalla provienen de una segunda pasada de ese día con el mismo kit (bases de datos de 3 MB y 2.88 GB). Las demás cifras siguen proviniendo de la ejecución del 2026-11-08. Qué cambiaron los kits posteriores a 2027.2.27 para un clúster:
| Kit | Cambio |
|---|---|
| 2027.2.29 (agent 3.1.0, RCM 2027.5.9) | Sin clúster por defecto (ver más abajo). Varios agentes de un mismo host pueden unirse a un clúster: cada uno tiene su propio puerto de emparejamiento (7450–7459) y puerto de nodo. fbagent --cluster-leave. La página Clusters de HQ Monitor |
| 2027.2.30 (RCM 2027.5.10) | Switchover y failover de un servicio, routers |
| 2027.2.31 (agent 3.3.0, RCM 2027.5.11) | El instalador abre una interfaz de texto en un terminal (paso 1). Las páginas Services de RCM. Un servidor que no está vinculado a ningún HQCenter actualiza el agent, HQ Monitor y fbmcp por sí mismo |
| 2027.2.33 (agent 3.4.0, RCM 2027.5.12) | RCM envía sus alertas a Telegram, a un webhook o por correo electrónico (“Qué observar a continuación”). Un clúster de dos contenedores Docker: guía de Docker |
Todos los cambios: What’s New.
Los kits con agent (fbagent) 3.1.0 y posteriores (a partir de 2027.2.29) no crean clúster por defecto: ni RCM, ni ventana de emparejamiento, y los puertos del clúster permanecen cerrados en el firewall. En el paso 1 se activa RCM en el maestro y el modo de descubrimiento en la réplica.
Tiempo: ≈30 minutos más la copia de las bases de datos (≈1 minuto por cada 3 GB en una red de 1 Gbit/s).
Qué se obtiene
| Servidor 1 | Servidor 2 | |
|---|---|---|
| Rol | maestro + consola RCM | réplica |
| Bases de datos | /databases/master/*.fdb |
/databases/replica/<replica node>/<master node>/*.fdb |
| Servicios | firebird, hqbirdfbagent-fb50, hqbirdmonitor-fb50, fbmcp, hqbirdrcm, hqclusternode-master-p3050 |
los mismos, pero hqclusternode-replica-p3050 y sin hqbirdrcm (un kit anterior deja allí su propio RCM, detenido) |
Qué se necesita
- Dos servidores Linux x86-64 (comprobados en Ubuntu 24.04), 2 núcleos, 4 GB de memoria.
- Espacio en disco. Maestro: libre ≥ 105 % del tamaño de la base de datos (el archivo
.deltacrece durante el bloqueo). Réplica: libre ≥ 105 % del tamaño de la base de datos más el mínimolimits.free_space_floor_gb(por defecto 1 GB). Una reinicialización sobre una réplica existente conserva el archivo antiguo hasta el final, por lo que el volumen de la réplica necesita aproximadamente 2 × el tamaño de la base de datos. Con la casilla Remove the old replica if space is short (paso 8), basta con el 105 % más el mínimo. - Red entre los servidores: puertos 3050, 7051, 7443, 7444, 7450. Estos son los puertos de la primera instancia de un servidor (slot 0). Una segunda instancia de un servidor usa el puerto de emparejamiento 7451 y el puerto de nodo 7052.
- Su PC puede alcanzar el puerto 7444 del maestro (la consola de RCM), directamente o mediante un túnel SSH.
- Un usuario con
sudo.
Firewall. El instalador abre puertos en un firewalld o ufw habilitado (con cualquier idioma del sistema): 3050 y 23050 siempre, los puertos del clúster solo para las opciones del paso 1. Maestro: 7443, 7444, 7051. Réplica: 7450, 7051. El agent vuelve a cerrar 7450 cuando termina la ventana de emparejamiento o el host está vinculado. En Ubuntu, ufw suele estar deshabilitado. Entonces el instalador escribe una línea, por ejemplo en el maestro:
no active firewall (firewalld or ufw): ports 3050, 23050, 7443, 7444, 7051/tcp are not opened by this install; they are reachable from every network; close them or enable a firewall. En la nube, cierre los puertos con el firewall de la nube: desde fuera, solo su dirección; entre los servidores, la red interna.
A continuación figuran las direcciones de la ejecución: maestro 10.114.0.5, réplica
10.114.0.6 (red privada). Utilice sus propias direcciones.
Paso 1. Instalar en ambos servidores
En cada servidor:
V=2027.2.33
wget https://ib-aid.com/download/hqbird/v2027/hqbird2027-fb50-linux-$V.run
wget https://ib-aid.com/download/hqbird/v2027/hqbird2027-fb50-linux-$V.run.sha256
sha256sum -c hqbird2027-fb50-linux-$V.run.sha256
sudo sh hqbird2027-fb50-linux-$V.run
En un terminal, el instalador abre su interfaz de texto (kits a partir de
2027.2.31). La primera página tiene la línea Cluster RCM off, discovery mode off. Abra Cluster y cambie una línea:
| Línea de la página Cluster | Maestro | Réplica |
|---|---|---|
| Cluster manager (RCM) | on |
off |
| Discovery mode (24 h) | off (este agent ejecuta el RCM) |
on |
Las líneas Cluster id (por defecto: el nombre del host), RCM admin password
(por defecto: generada) y Pairing port (por defecto: el primero libre,
7450) pueden quedar como están. Vuelva atrás (Esc) y elija Install. El
instalador muestra el plan: pulse Enter. Luego pregunta Nothing on this host was changed yet. Start the install now?. El cursor está en No: muévalo
a Yes y pulse Enter. El instalador añade las bibliotecas que faltan (por
ejemplo, libtommath1) por sí mismo. La interfaz de texto completa:
hqbird2027-linux-setup-guide.md.
Con --no-tui, y en los kits 2027.2.29–2027.2.30, el instalador hace
preguntas. La primera es Install as planned? Yes/No: responda y. Luego
hace dos preguntas sobre el clúster. La respuesta es No por defecto (Enter):
| Pregunta | Maestro | Réplica |
|---|---|---|
Install the cluster manager (RCM) on this host and make a new cluster? [y/N] |
y |
Enter (No) |
Turn on discovery mode for 24 hours (an RCM on the network may invite this agent into its cluster; port 7450)? [y/N] |
no se pregunta: este agent ejecuta el RCM | y |
O dé las respuestas como opciones: en un terminal establecen los valores de la
página Cluster antes de que se abra. Úselas también para una ejecución sin terminal:
--yes por sí solo significa No para ambas.
sudo sh hqbird2027-fb50-linux-$V.run --rcm on               # master
sudo sh hqbird2027-fb50-linux-$V.run --cluster-pairing on   # replica
La instalación tarda aproximadamente un minuto (la ejecución del 2026-11-17: 61 segundos
en el maestro, 43 segundos en la réplica). El final de la salida en el
maestro con el kit 2027.2.33 (el hash está acortado aquí; el id del clúster de
los ejemplos siguientes es hq27d-m, de la ejecución del 2026-11-08):
Done: agent hqbirdfbagent-fb50 in /opt/hqbird/fbagent-fb50, Firebird 5.0.5.1917 in /opt/firebird (port 3050).
HQ Monitor: http://localhost:23050/ (login admin; password in /opt/hqbird/conf/access.properties)
RCM:        https://10.114.0.5:7444 (cluster hq27d-m)
CA hash:    sha256:9754e0be…087cb195
Login:      rcmadmin
Password:   in /opt/hqbird/fbagent-fb50/clusterca/hq27d-m/rcm-initial-password (read it with sudo; RCM asks for a new one at the first login)
Pairing:    not needed: this agent runs the RCM; other agents link through it
fbmcp:      2027.2.24, service running; local only (remote mode: sudo fbmcp ctl hqbird-install --allow-from CIDR)
En la réplica:
RCM:        off; turn it on in HQbird Monitor or with fbagent --cluster-init <id>
Pairing:    port 7450 open until 2026-11-09T16:25:27Z (fingerprint sha256:0d137a71…09fe44cf); an RCM may invite this host
Un kit anterior imprime Pairing: not opened (this agent runs the RCM) en
el maestro.
Anote las líneas RCM: y CA hash: del maestro y la
línea Pairing: de la réplica. Necesita el fingerprint en el paso 3.
Kits anteriores (agent anterior a 3.1.0, por ejemplo el kit 2027.2.27) no hacen preguntas sobre el clúster. Instalan RCM en cada servidor y abren la ventana de emparejamiento en todas partes. Use el RCM del maestro; el RCM del segundo servidor se detiene por sí mismo tras el vínculo.
Más adelante, sin el instalador. En HQ Monitor del servidor, abra Clusters, sección Cluster on this server. En el maestro: Enable the cluster console (RCM); HQ Monitor abre 7443 y 7444 en el firewall. En la réplica: Open the pairing window for 24 hours. Lo mismo con comandos, como el usuario del agent:
cd /opt/hqbird/fbagent-fb50
sudo -u firebird ./fbagent --cluster-init hq27d-m     # master; open 7443 and 7444 yourself
sudo -u firebird ./fbagent --cluster-pairing on       # replica
Mientras la ventana de emparejamiento está abierta, el agent abre su puerto de emparejamiento en el firewall. Cierra el puerto cuando termina la ventana o el host está vinculado.
La salida no contiene contraseñas. La contraseña de RCM está en el archivo de la
línea Password:, la contraseña de SYSDBA está en
/root/fbagent-install-sysdba.txt, y la contraseña de HQ Monitor está en
/opt/hqbird/conf/access.properties.
No es necesario instalar una licencia: un agent nuevo inicia una prueba de 7 días por sí mismo, y los nodos del clúster funcionan.
Paso 2. Iniciar sesión en RCM
Abra la dirección de la línea RCM: del maestro. Si el puerto 7444 está cerrado
para su PC, use un túnel SSH y https://localhost:7444:
ssh -L 7444:127.0.0.1:7444 <user>@<master>Si el puerto 7444 está ocupado en su PC, use otro puerto local, por ejemplo
-L 17444:127.0.0.1:7444 y https://localhost:17444.
El navegador advierte sobre el certificado: la CA del clúster firmó el certificado
de RCM. La página de inicio de sesión muestra el Cluster CA hash: compárelo con
la línea CA hash: de la salida del instalador. Si coinciden, instale el certificado
de la CA (el enlace Download the CA certificate (hqcluster-ca.crt) en
la misma página) como de confianza, o acepte la advertencia. Si no coinciden, no
inicie sesión, y compruebe la dirección.
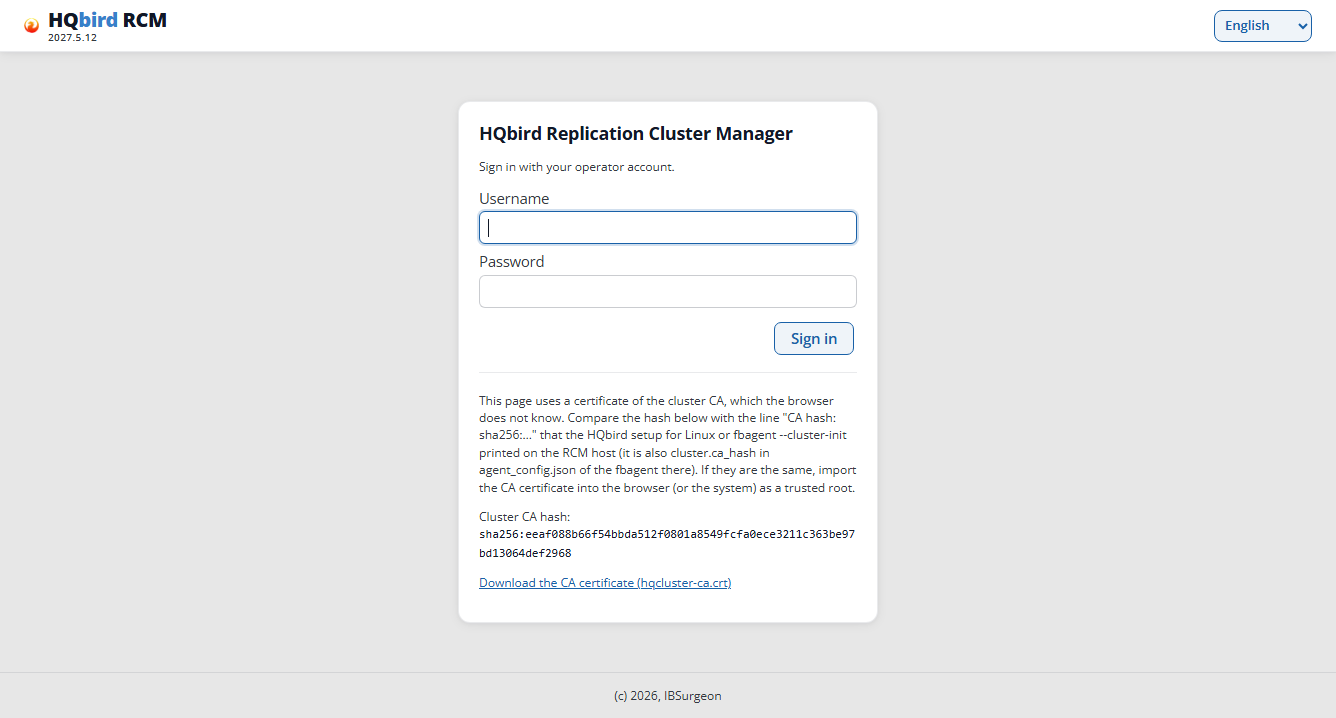
El nombre de usuario es rcmadmin. La contraseña está en el archivo de la línea Password::
# the path is from the Password: line of your output
sudo cat /opt/hqbird/fbagent-fb50/clusterca/hq27d-m/rcm-initial-password
RCM pide una nueva contraseña de inmediato (al menos 12 caracteres):
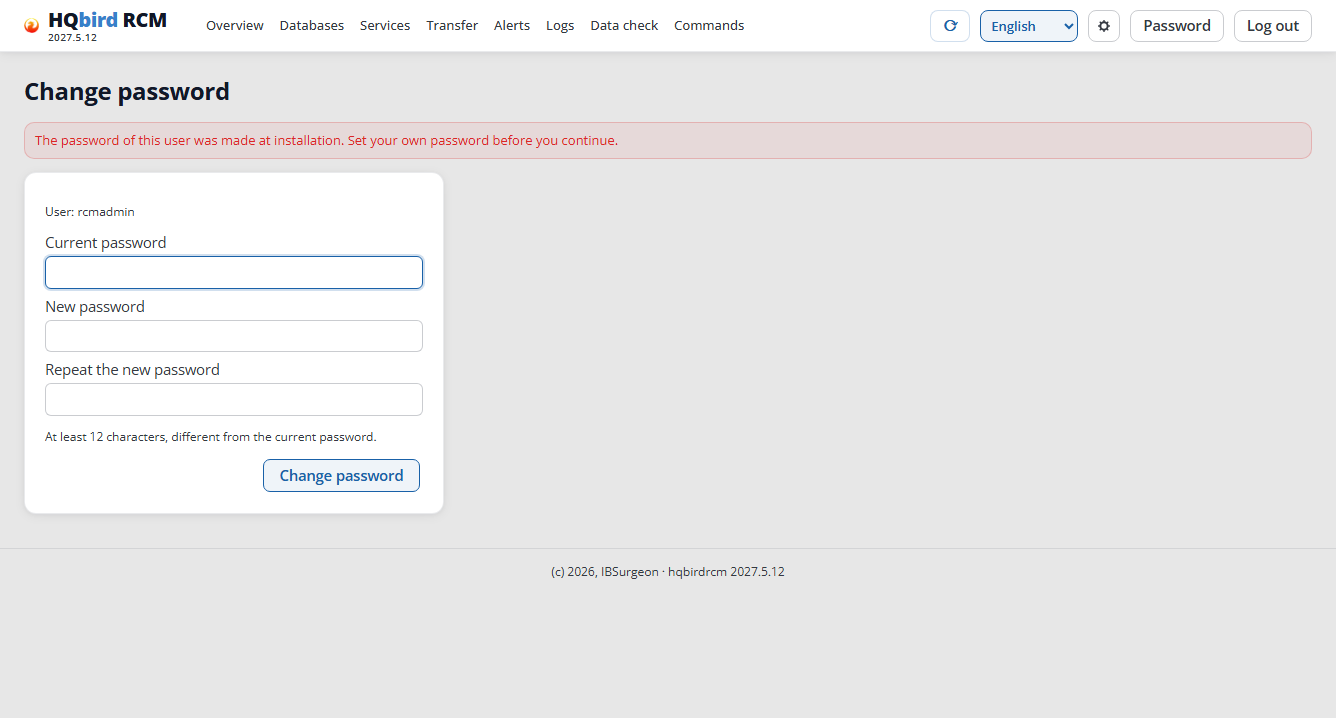
Un RCM anterior a 2027.5.12 podía cargar esta página una y otra vez. RCM 2027.5.12 (kit 2027.2.33) tiene la corrección.
Tras el cambio de contraseña, el agent del maestro elimina el archivo
rcm-initial-password por sí mismo en el plazo de un minuto. Con un kit anterior, el
segundo servidor también tiene un RCM propio. Tras el vínculo, el agent mueve
ese clúster anterior a la carpeta cluster/left/. El agent 3.1.0 elimina
su rcm-initial-password allí; un agent anterior no lo hace. Entonces elimine el
archivo usted mismo:
# on server 2, after step 3
sudo find /opt/hqbird -name rcm-initial-password
sudo rm <path from the find output>
No elimine el archivo /opt/hqbirdrcm/initial-admin.json: solo contiene
el hash de la contraseña antigua, y sin él un RCM que perdió su
archivo de usuario arranca con la contraseña por defecto.
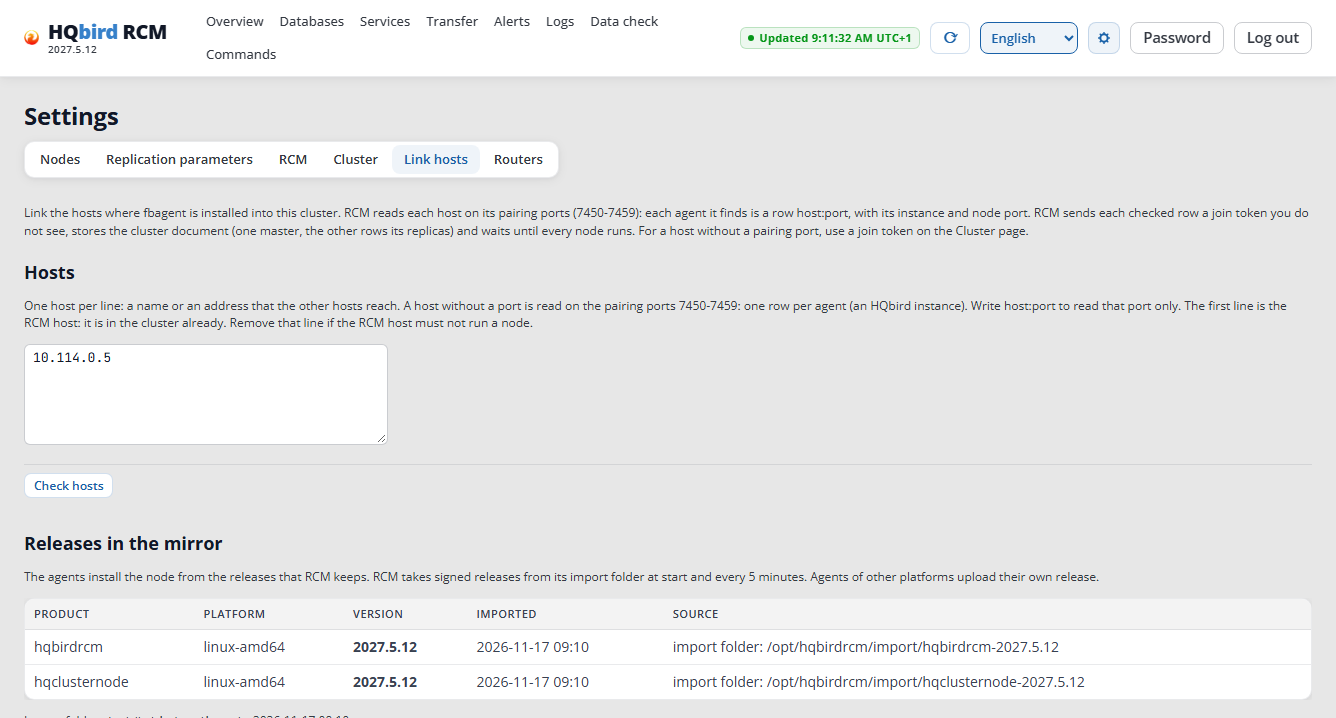
Tras el cambio de contraseña, RCM abre Settings → Link hosts de inmediato: el
clúster aún no tiene nodos. La lista Releases in the mirror muestra las
versiones de hqbirdrcm y hqclusternode desde las que los agents instalan los
nodos.
Paso 3. Vincular los hosts
La primera fila de la lista ya está completada (el host RCM). Añada una segunda fila: la dirección de la réplica a la que el maestro puede llegar. Introduzca una IP si los servidores no tienen un DNS común: RCM mantiene la cadena tal cual, y los nodos se encuentran entre sí mediante ella.
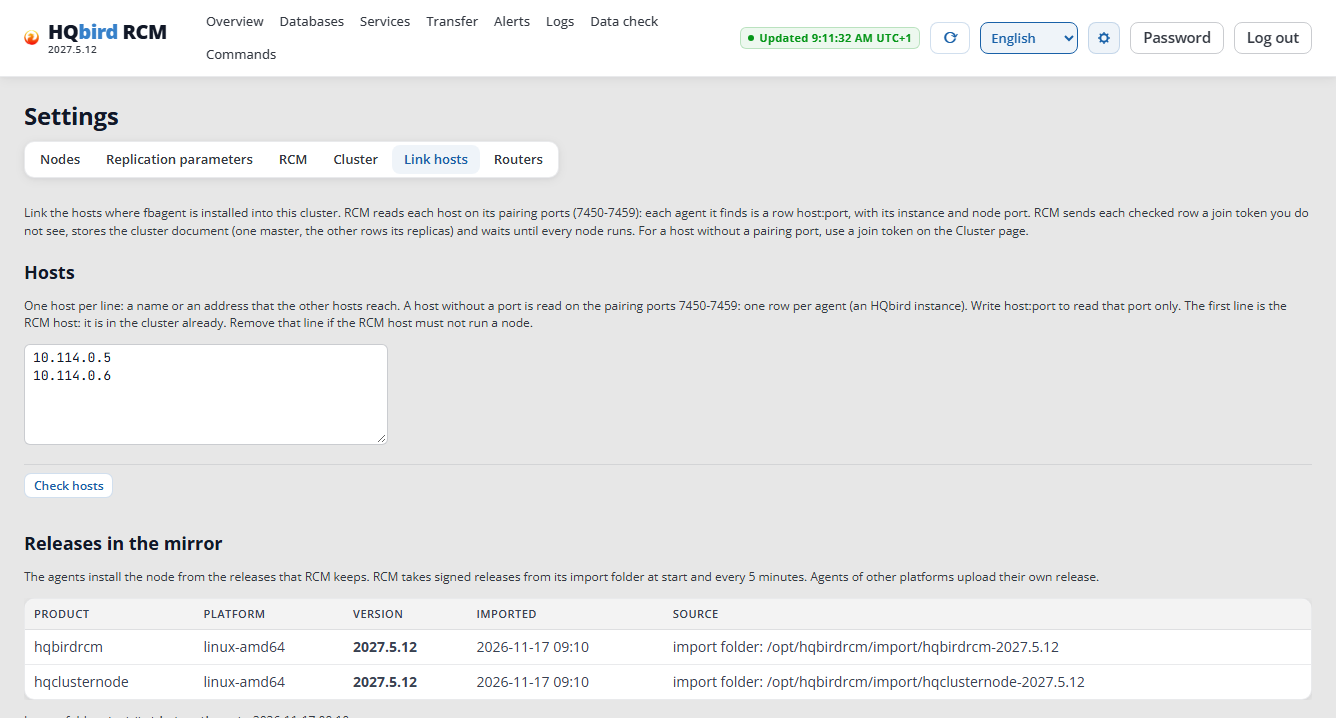
Haga clic en Check hosts. Para un host sin puerto, RCM lee los puertos
de emparejamiento 7450–7459 y muestra una fila por cada agente que responde, como
host:port (aquí 10.114.0.6:7450). Escriba host:port para leer un solo puerto.
El host RCM no necesita ventana de emparejamiento: RCM encuentra su agente en su propio
registro. Compare el Certificate fingerprint con la salida del instalador
(la línea Pairing: de la réplica): deben coincidir. El estado del
segundo host es Ready to link.
La columna Member ID muestra el nombre que recibe el host en el clúster:
<host name>-<role>, por ejemplo hq27d-m-master. El sufijo de instancia
(-fb50) se añade solo cuando el host tiene varios agentes.
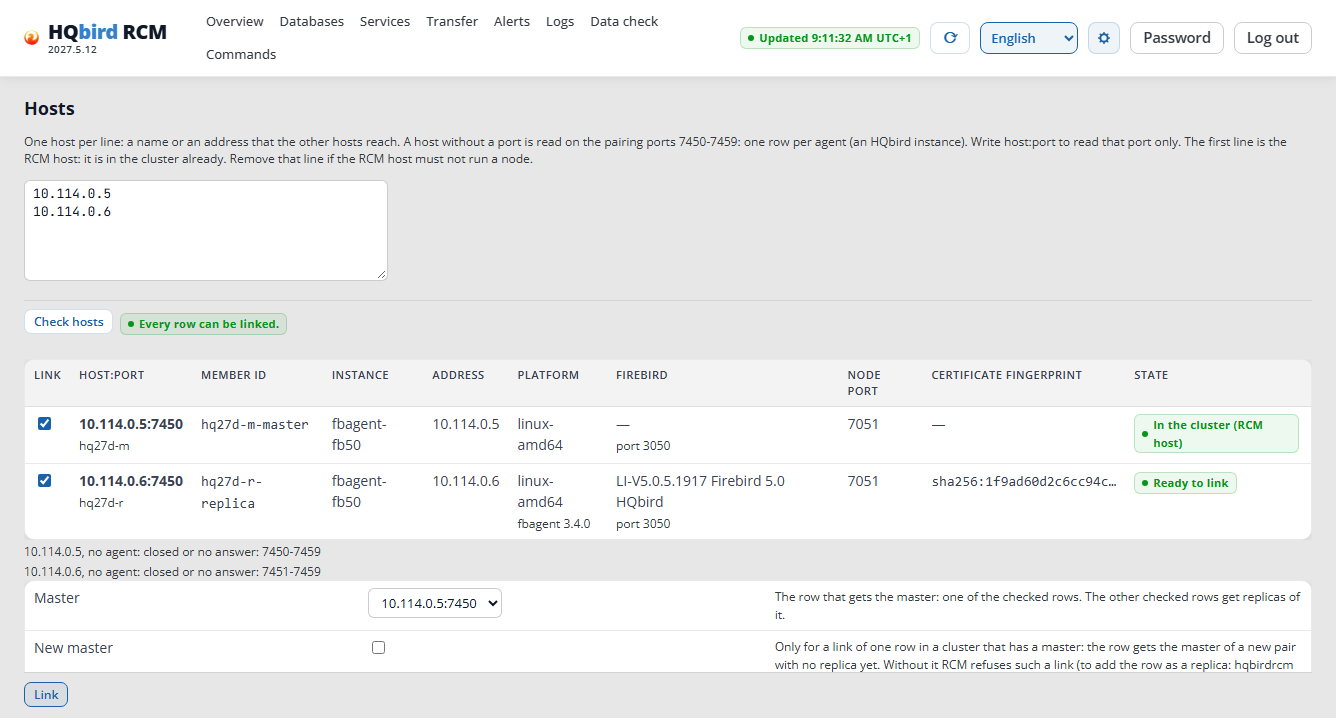
Cada fila tiene una casilla de verificación, el puerto, la instancia y el puerto del nodo. Link toma solo
las filas marcadas. Una fila con error no se puede marcar y no detiene a las
demás. Bajo la tabla, RCM 2027.5.12 escribe líneas como 10.114.0.6, no agent: closed or no answer: 7451-7459: nombran los puertos de emparejamiento del
host donde no responde ningún otro agente. No son errores.
El master es el host donde estarán las bases de datos de producción. Haga clic en Link y confirme:
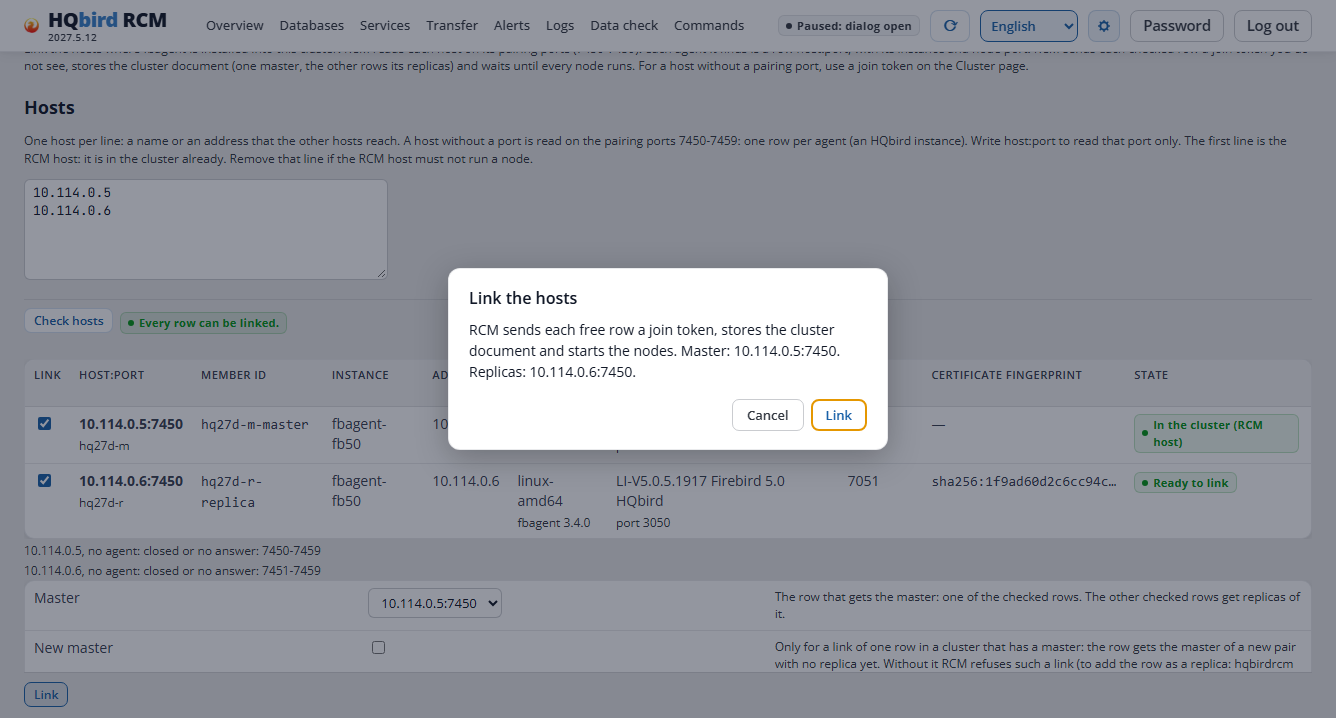
Progreso: «Joining → Joined → The node starts → Running». En la ejecución, la vinculación tardó 56 segundos (la ejecución del 2026-11-17: 47 segundos).
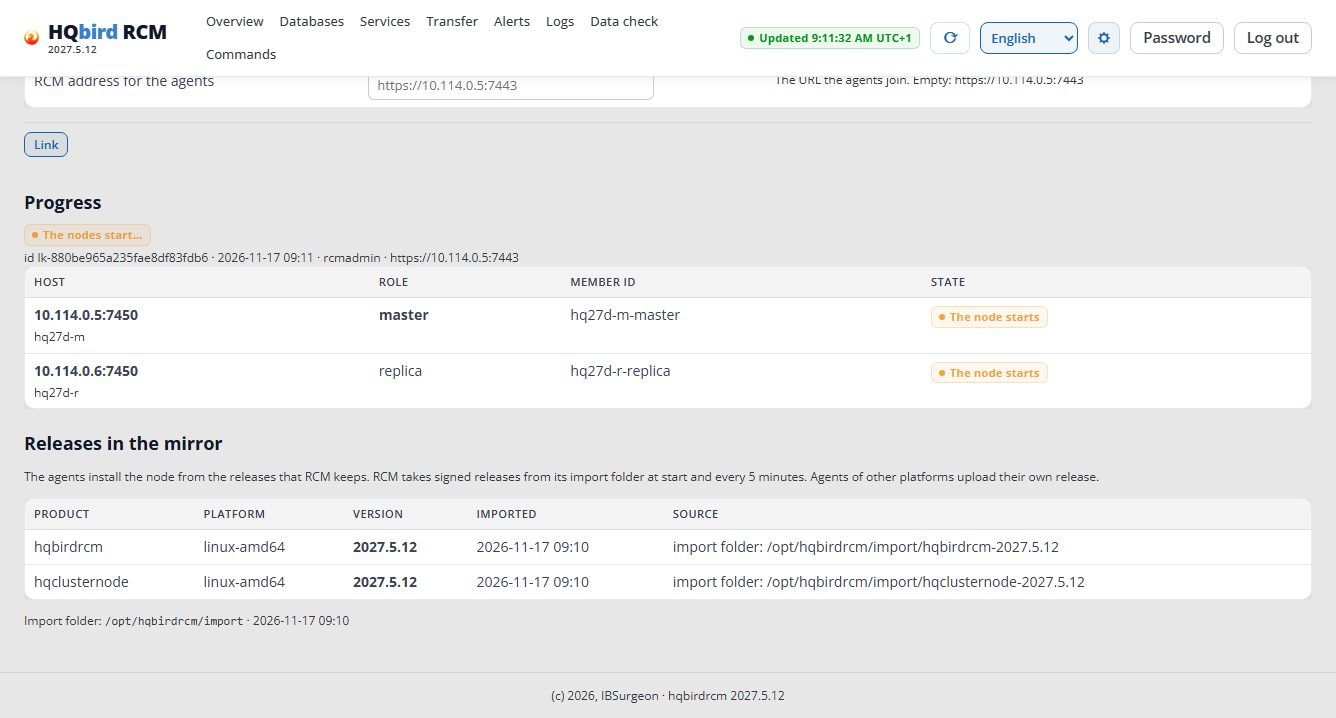
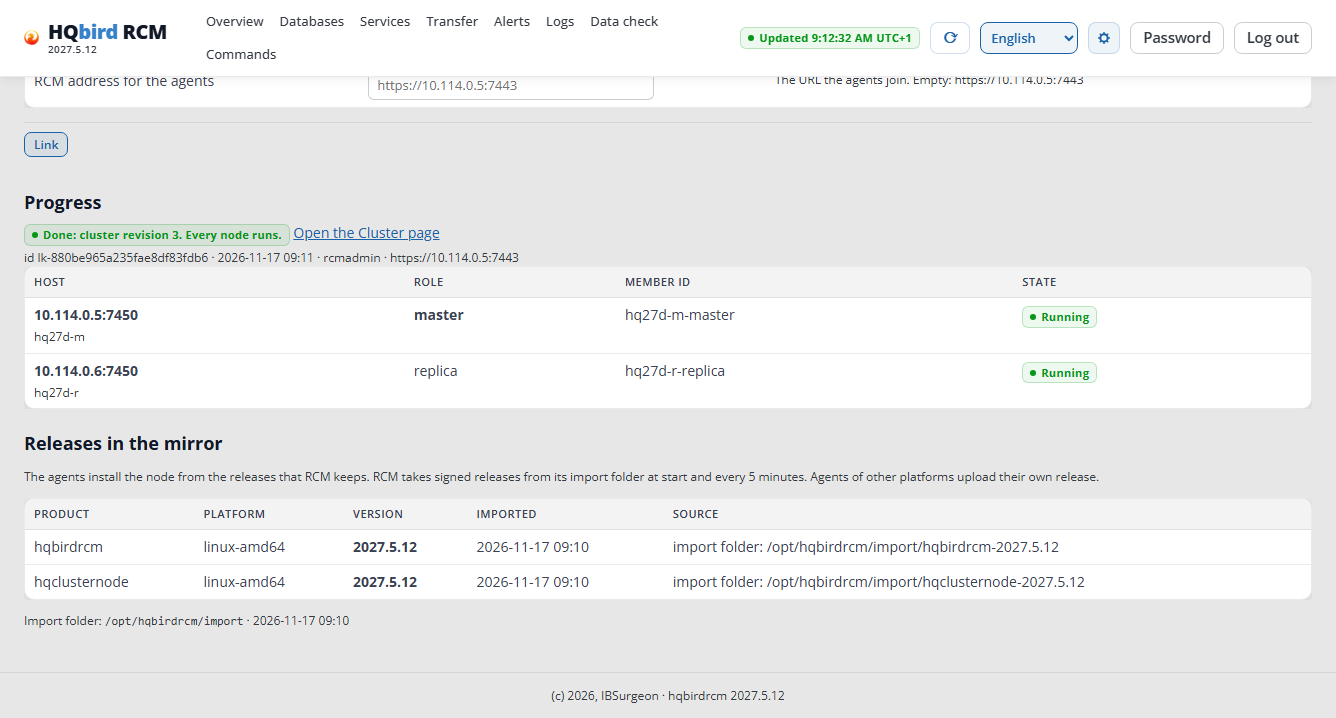
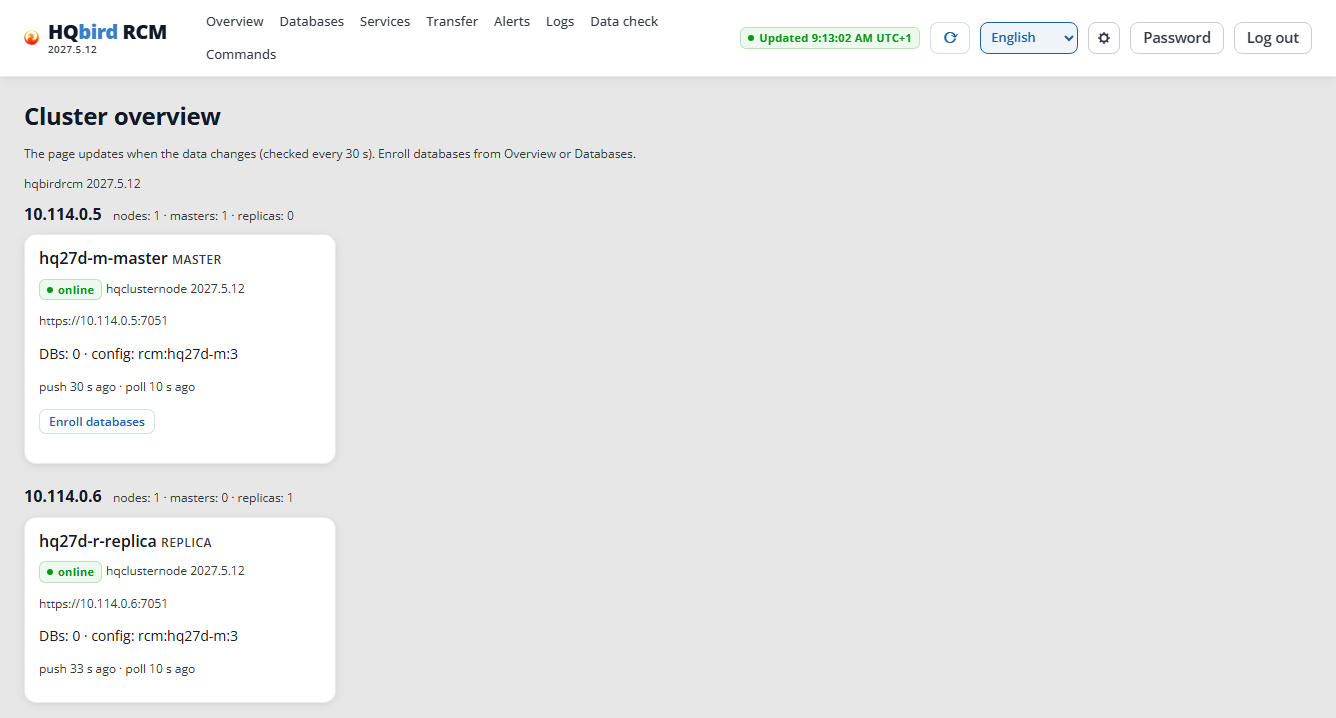
La Overview ahora muestra dos nodos: el maestro y la réplica. Justo después de la vinculación, la réplica puede estar «stale» durante un minuto; luego está «online».
Si hace clic de nuevo en Check hosts para un host que ya está vinculado, muestra que ningún agente responde en los puertos de emparejamiento, o que el host es inaccesible: la ventana de emparejamiento en ese host está cerrada, y también lo está su puerto de emparejamiento en el firewall. Esto no es un error.
Un host en un clúster que tiene un maestro. Una vinculación de una fila se rechaza
con lone_master: indique qué será la fila. Añada -replica-of <master member>
para una réplica de ese maestro, o -new-master (la casilla en la página Link hosts)
para un maestro propio.
Paso 4. Carpeta de bases de datos en el maestro
En el master, la base de datos debe estar en una carpeta a la que el usuario
firebird pueda acceder:
sudo install -d -o firebird -g firebird -m 0770 /databases/master
# example: the sample database from the kit
sudo cp /opt/firebird/examples/empbuild/employee.fdb /databases/master/
sudo chown firebird:firebird /databases/master/employee.fdb
No necesita preparar nada en la réplica: el botón Create folder del diálogo Initialize crea la carpeta para las copias (paso 6).
Paso 5. Registrar las bases de datos en el maestro
Databases → en la tabla Nodes, en la fila del maestro → Enroll.
- Folder path on that server:
/databases/master, recursive. - Include file mask:
*.fdb. - Sync tracking tables: las tablas cuyos recuentos de filas compara el botón Verify. Usted establece la lista para cada base de datos que registra. Deje el campo vacío: entonces la base de datos cuenta sus tablas de publicación. Para una base de datos que ya está gestionada, cambie la lista en la página de la base de datos maestra.
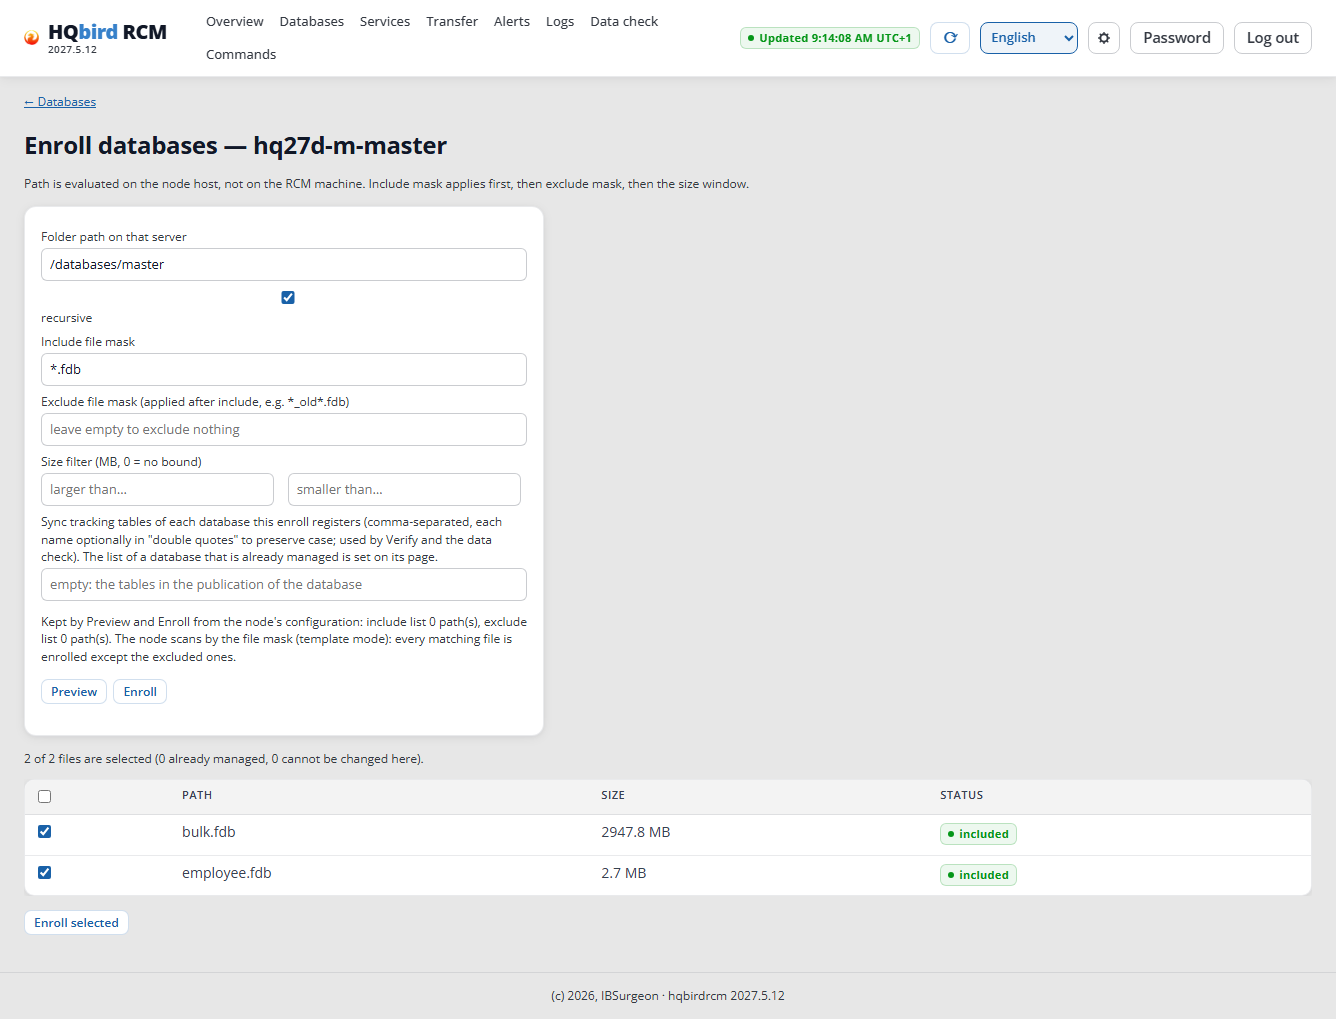
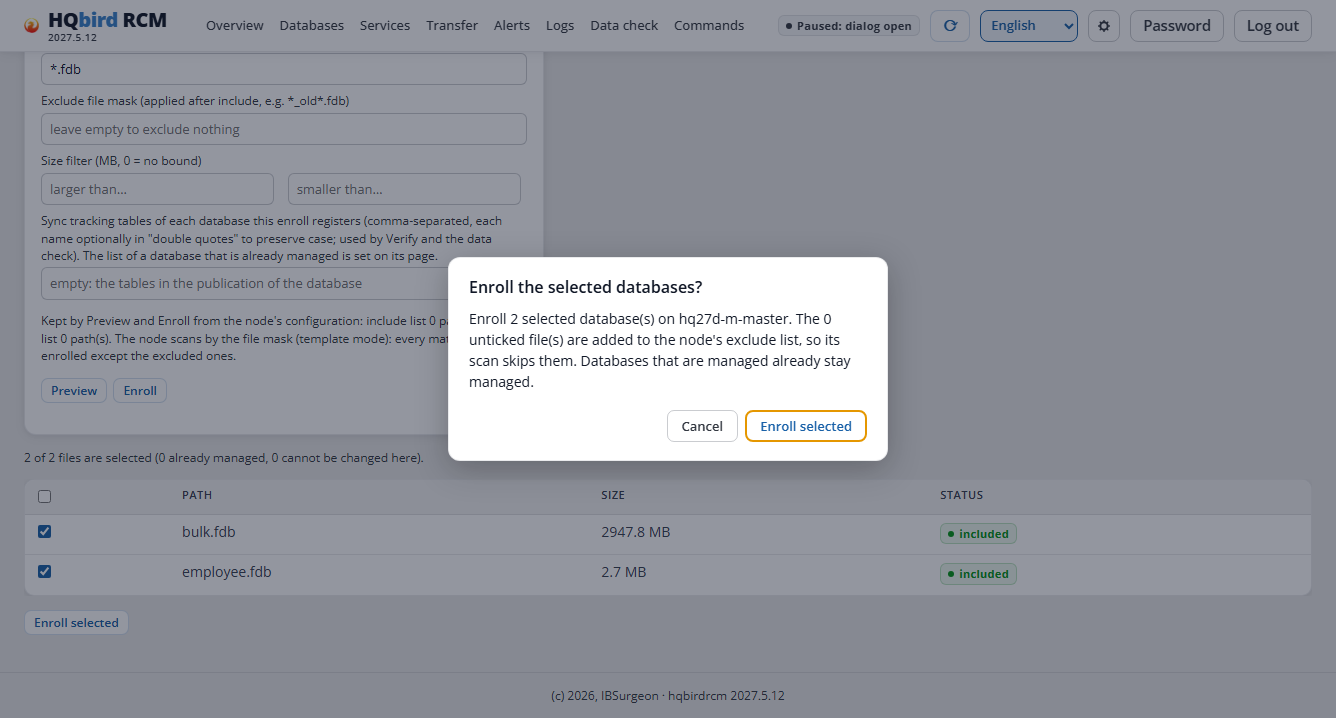
Preview → seleccione las bases de datos → Enroll selected y confirme.
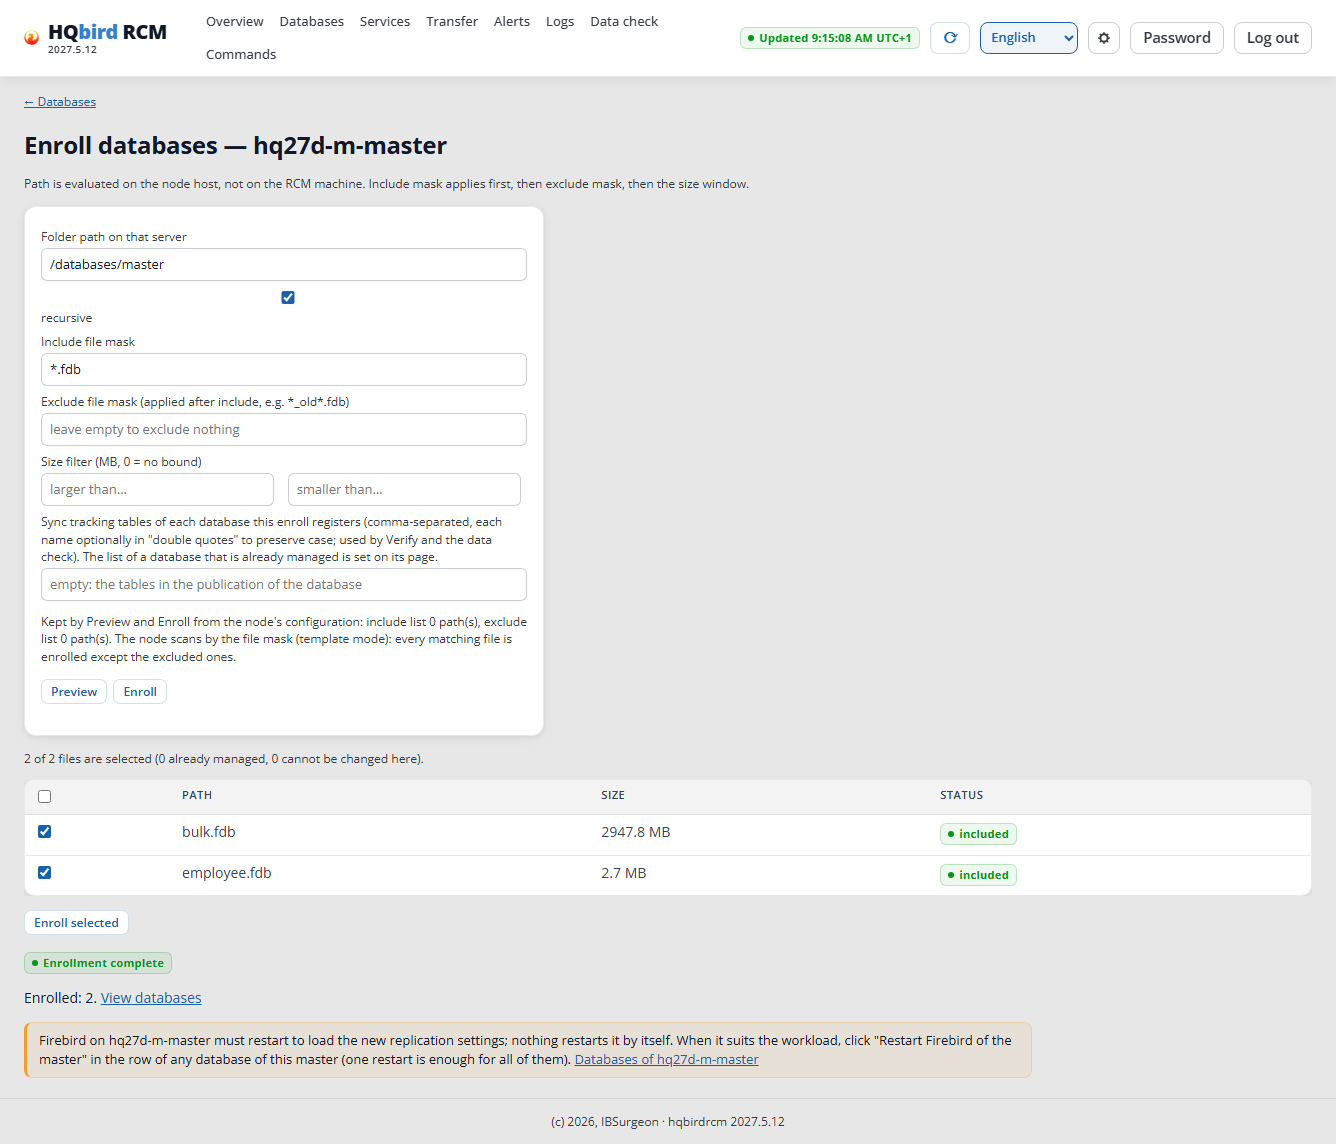
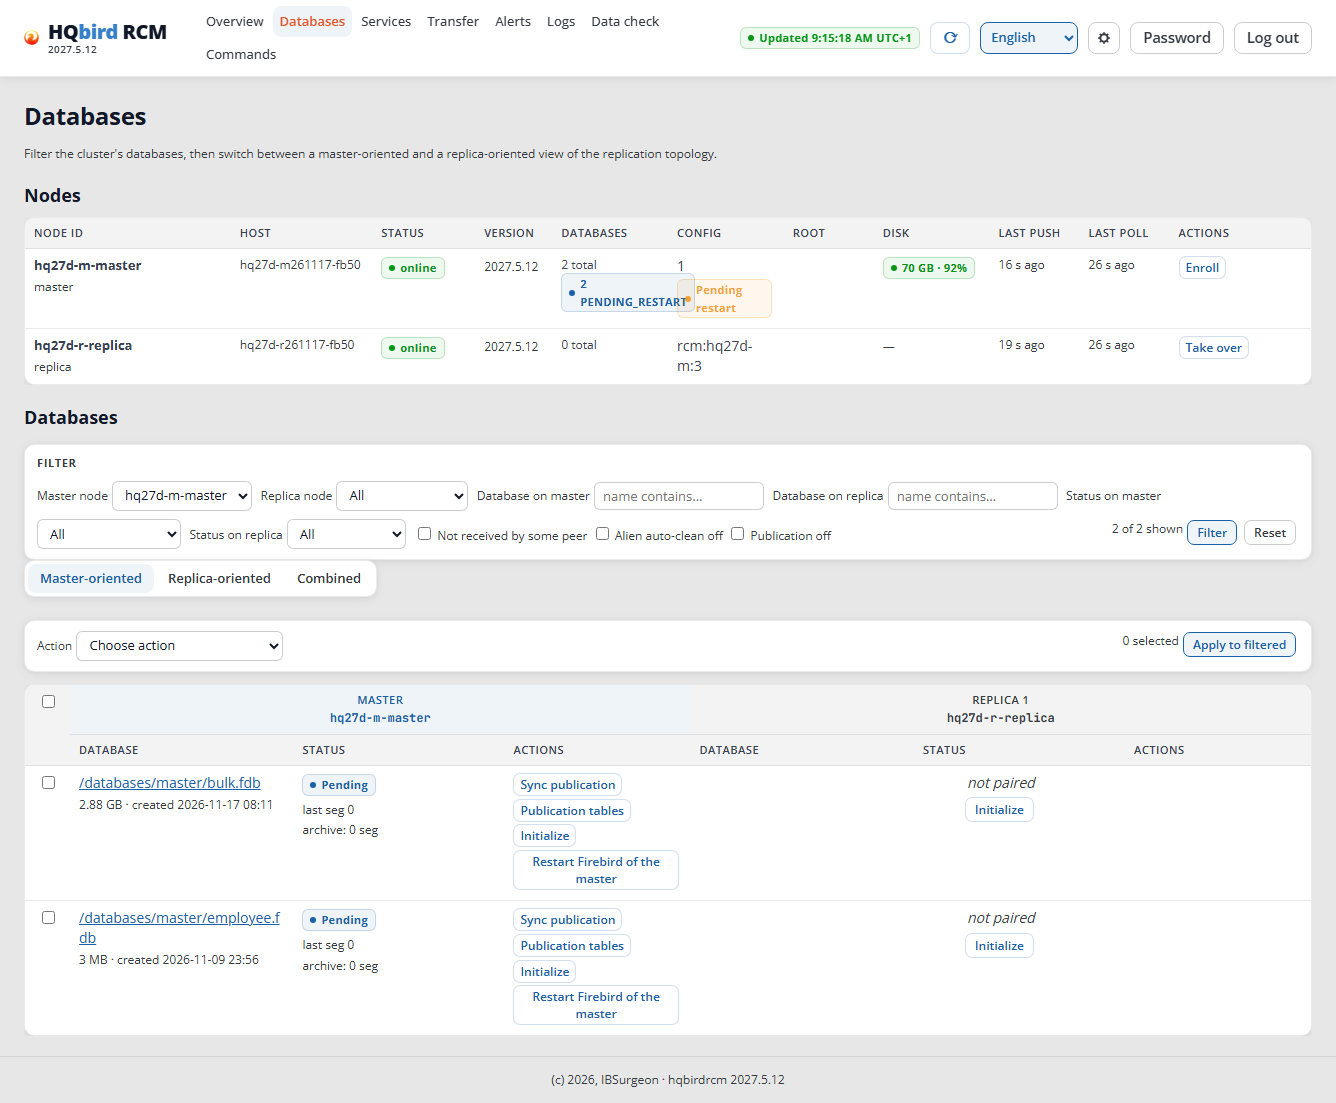
El resultado es «Enrolled: 2.» y una sugerencia: Firebird del maestro debe reiniciarse. El texto «No new databases matched.» debajo no es un error: las bases de datos ya están registradas.
Las bases de datos esperan el reinicio:
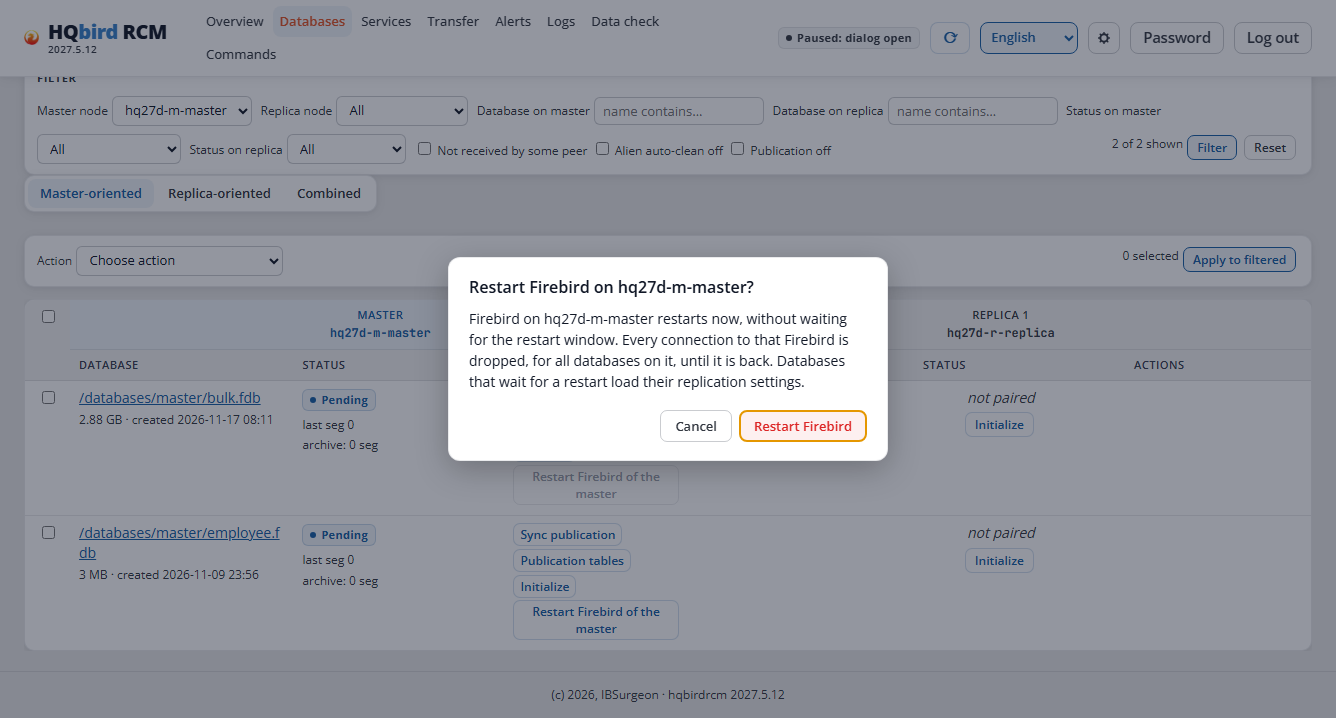
Haga clic en Restart Firebird of the master en la fila de cualquier base de datos del maestro (un reinicio basta para todas ellas) y confirme. Todas las conexiones a Firebird del maestro se interrumpen durante unos segundos (4 segundos en la ejecución): elija un buen momento.
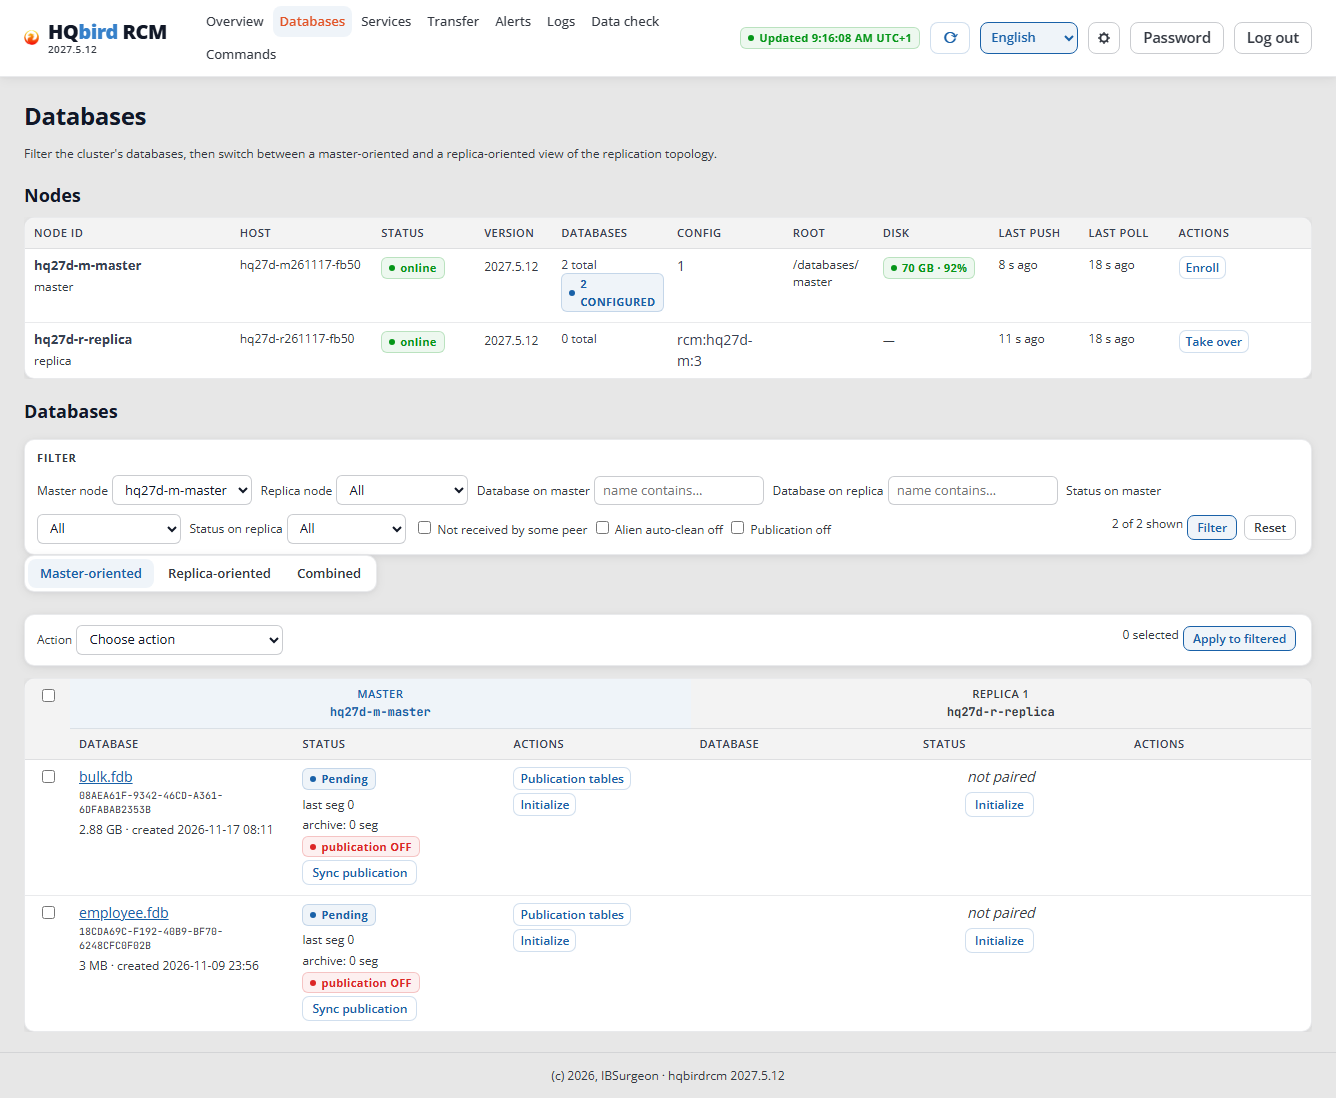
Tras el reinicio, el nodo maestro está CONFIGURED. Cada base de datos tiene la
insignia publication OFF, y la réplica muestra «not paired».
Paso 6. Inicializar la réplica
En la fila de la base de datos, en la columna de la réplica → Initialize. El diálogo tiene el título «Initialize database?».
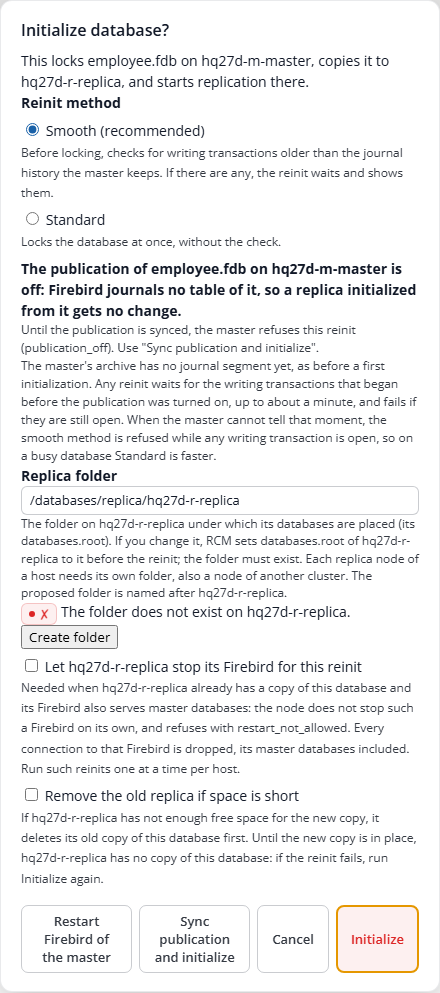
- Publication. Mientras la publicación de la base de datos está desactivada, Firebird
no escribe los cambios en el journal, y la réplica no recibe nada.
El diálogo lo indica y muestra un botón Sync publication and initialize.
Haga clic en él: RCM añade todas las tablas con clave primaria o única a la
publicación e inicia la inicialización de inmediato. El botón Initialize
no ayuda mientras la publicación está desactivada: el nodo maestro
lo rechaza (
publication_off). - Replica folder: el diálogo propone
/databases/replica/<replica node>, en la ejecución/databases/replica/hq27d-r-replica. Cada nodo de réplica de un host necesita su propia carpeta. Consérvela. Si el campo muestra «✗ The folder does not exist», haga clic en Create folder; entonces verá «✓ The folder was created.» La copia va a/databases/replica/hq27d-r-replica/hq27d-m-master/. Para las siguientes bases de datos la carpeta ya está establecida, y el diálogo no la cambia. - Method: Smooth (el predeterminado). Comprueba las transacciones de escritura antes del bloqueo. Standard bloquea la base de datos de inmediato.
- No necesita las casillas «Let … stop its Firebird for this reinit» y «Remove the old replica if space is short» para una réplica nueva.
Reconecte las aplicaciones después de la primera sincronización de publicación. Una conexión a la base de datos maestra que se abrió antes de que la publicación estuviera activada no se registra en el journal hasta que se vuelve a conectar. En la ejecución del 2026-11-17, una conexión que se abrió antes de Sync publication and initialize escribió unas 9.500 filas después de la copia, y la réplica no recibió ninguna de ellas. RCM mostró «Ok» para ambos lados; solo Verify (paso 9) mostró «Not ok (desynced)». Las filas de una conexión nueva se replicaron de inmediato. Por lo tanto, después de la primera Sync publication de una base de datos: reconecte las aplicaciones (o reinicie Firebird del maestro), luego ejecute Verify sin escrituras. Si la réplica pierde filas, ejecute una reinicialización (paso 7).
Primera inicialización bajo carga. Mientras el archivo del maestro no
tiene aún ningún segmento de journal, Smooth puede rechazar si se está escribiendo en la base de datos. La fila de la base de datos muestra
long_transactions: … the archive holds no segment yet y una sugerencia en el
idioma de la interfaz:
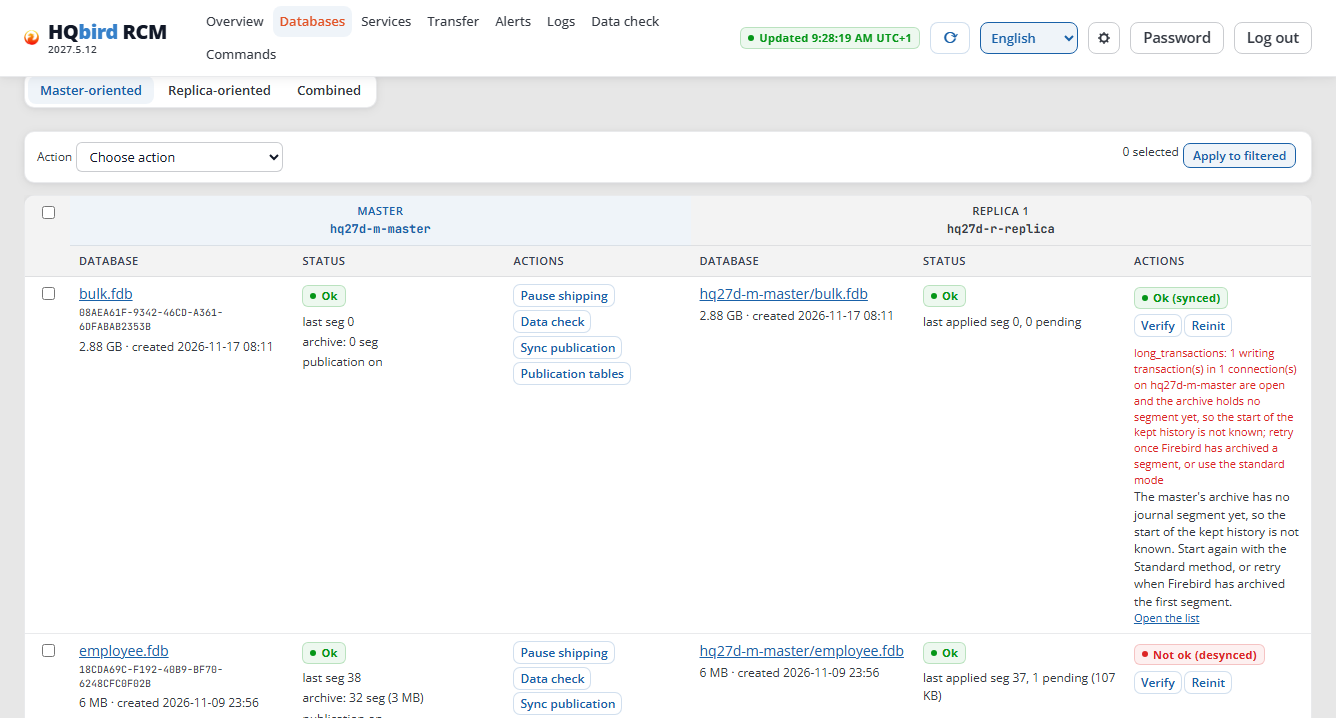
En la ejecución, esto ocurrió también después de Sync publication and initialize (hallazgo G-04 en el informe). La publicación ya está activada en este punto. Espere hasta que la base de datos maestra muestre «archive: 1 seg» o más (15 segundos en la ejecución), y haga clic en Initialize de nuevo con el método Smooth. O elija Standard. En la ejecución del 2026-11-17 (≈49 transacciones/s desde una conexión), Smooth no fue rechazado.
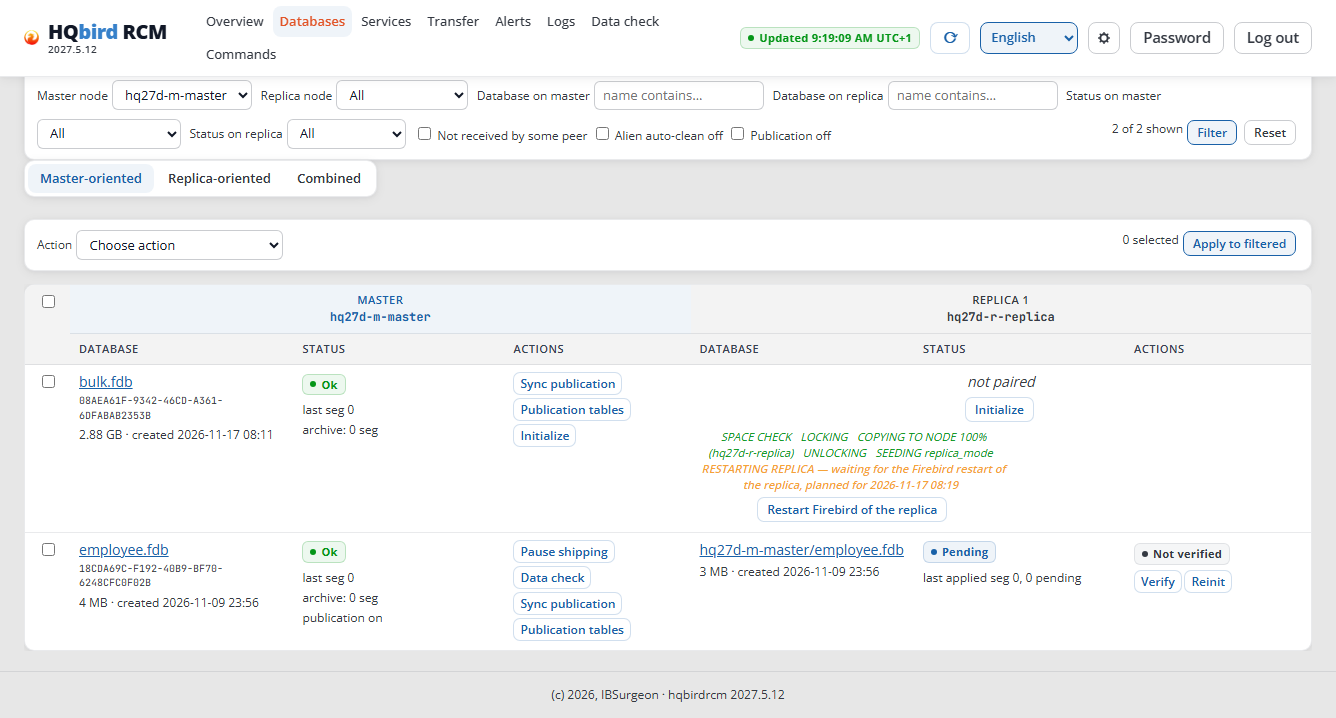
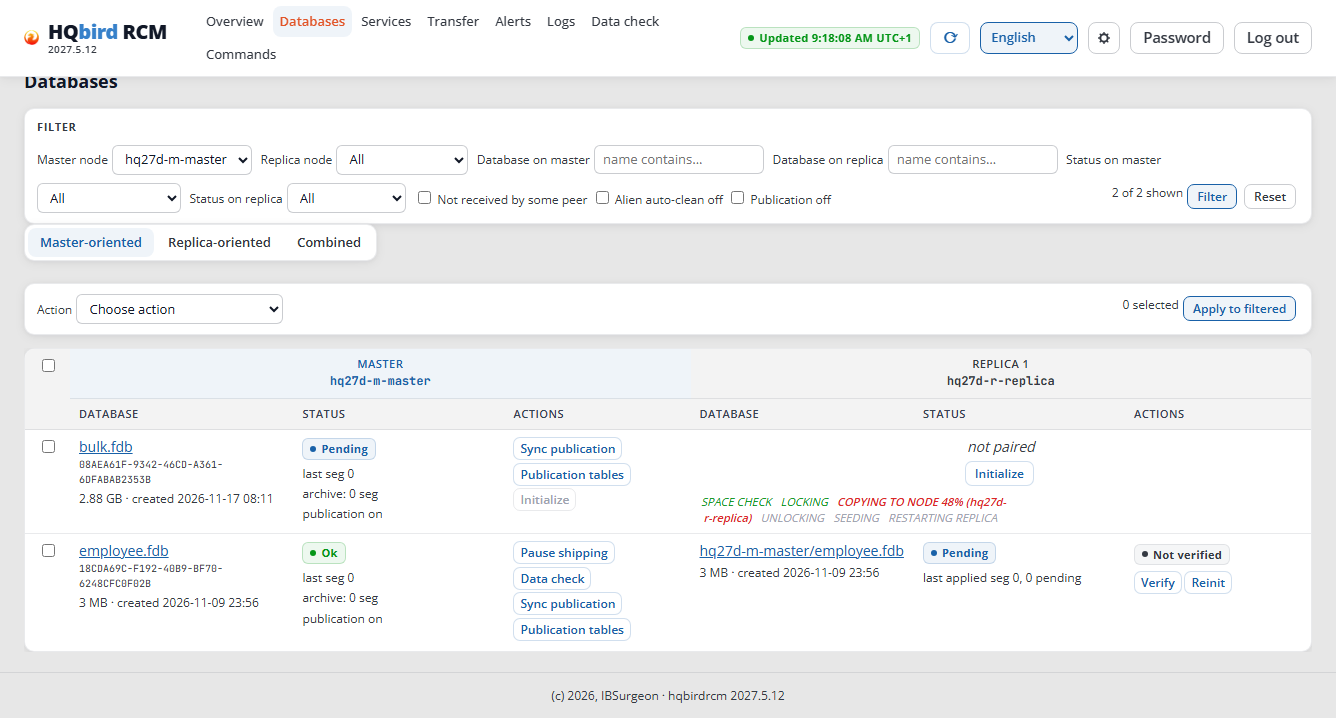
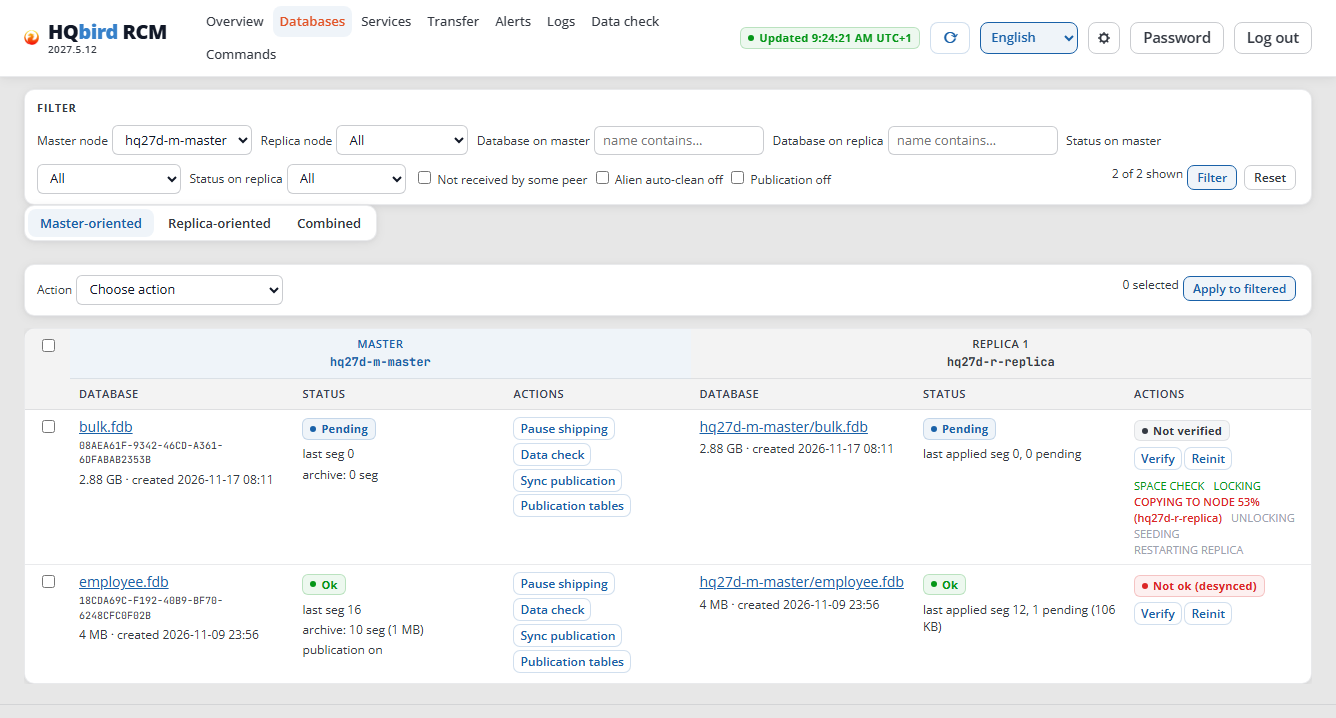
El progreso se muestra en la fila de la base de datos: SPACE CHECK → LOCKING → COPYING TO NODE (%) → UNLOCKING → SEEDING → RESTARTING REPLICA. El progreso es visible también tras recargar la página. El botón Initialize está inactivo durante este tiempo.
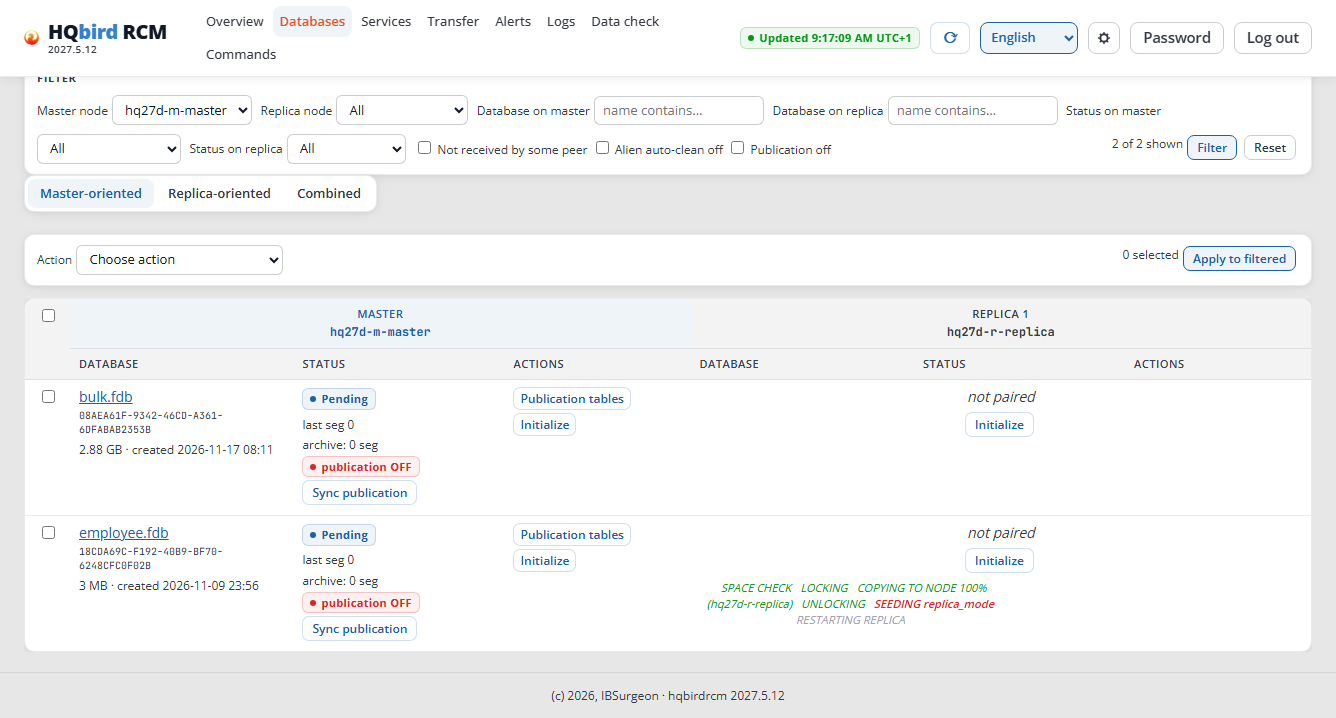
Tras la copia, el nodo de réplica reinicia Firebird de la réplica por sí mismo en el minuto planificado. La fila indica cuándo; el botón Restart Firebird of the replica lo hace de inmediato. Todas las conexiones a Firebird de la réplica se interrumpen en ese momento.
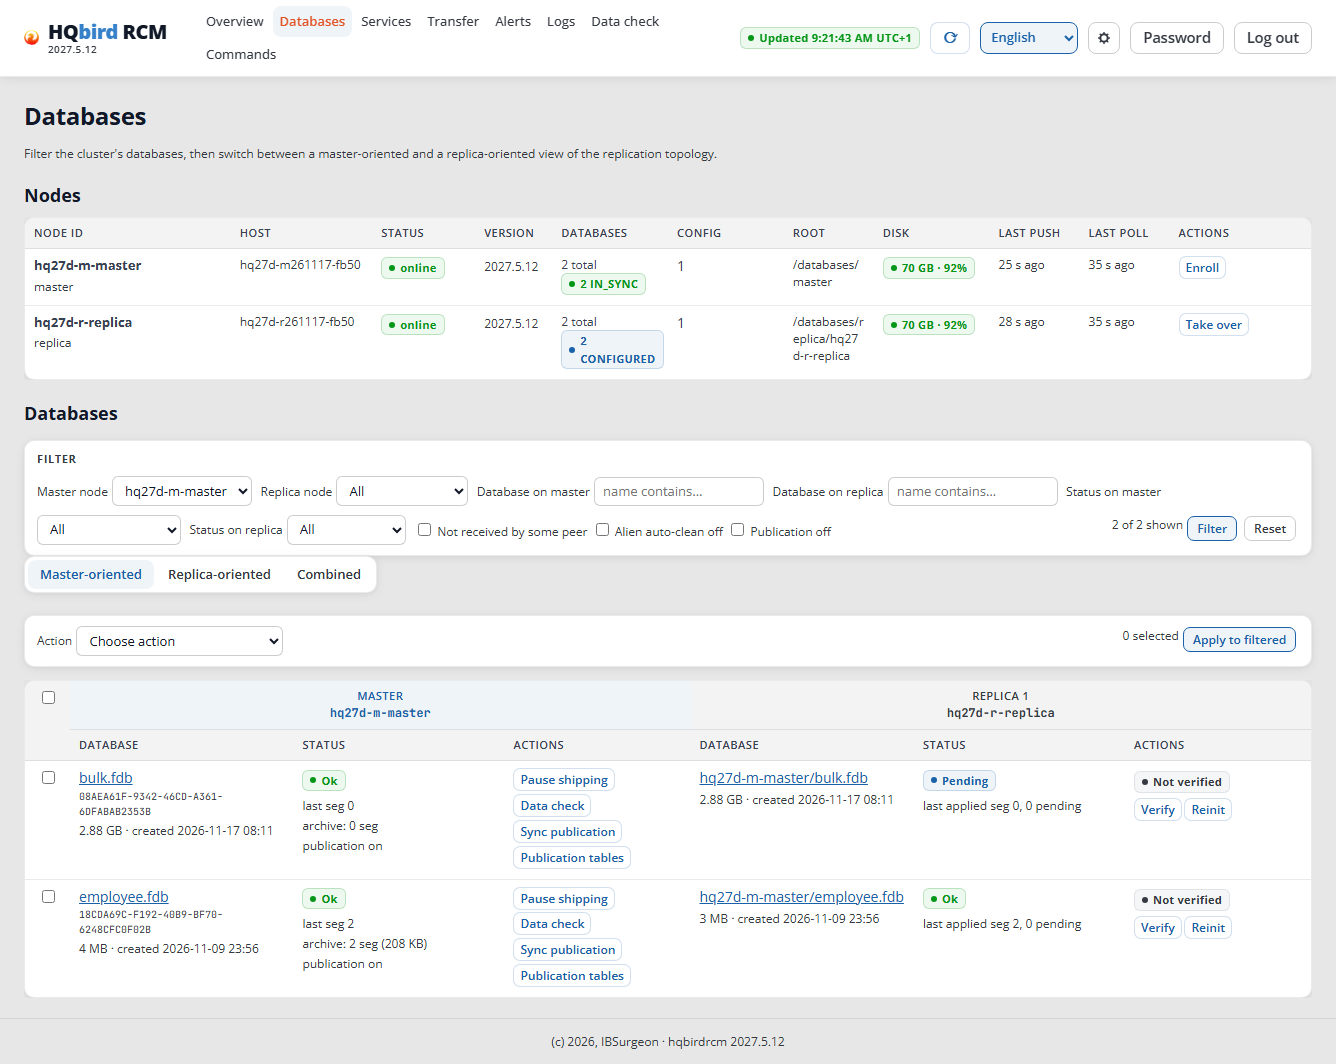
Una base de datos grande funciona de la misma manera. En la ejecución, bulk.fdb (3,13 GB) se
inicializó con el botón Sync publication and initialize, sin carga sobre ella:
Está hecho cuando el maestro y la réplica muestran «Ok», y el «last applied
seg» de la réplica alcanza el «last seg» del maestro. Una base de datos sin
nuevas escrituras (aquí bulk.fdb) muestra «Pending» con el segmento 0 para la
réplica: esto es normal.
Mediciones de la ejecución (employee.fdb bajo una carga de ≈55
transacciones/s):
| Base de datos | Tamaño | Maestro: de inicio a fin | Bloqueo en el maestro | Par «Ok» |
|---|---|---|---|---|
employee.fdb |
4 MB | 0,7 s | 0,35 s | tras ≈1 min (esperó el reinicio de la réplica) |
bulk.fdb |
3,13 GB | 64 s (≈55 MB/s) | 59 s | tras ≈2 min |
La ejecución del 2026-11-17 (kit 2027.2.33): employee.fdb (3 MB) tardó 3 segundos
en el maestro, bulk.fdb (167 MB) 15 segundos. El lado de la réplica se emparejó
≈40 segundos después del inicio (esperó el reinicio de Firebird de la
réplica).
Durante el bloqueo la base de datos maestra funciona: los cambios van al archivo
.delta.
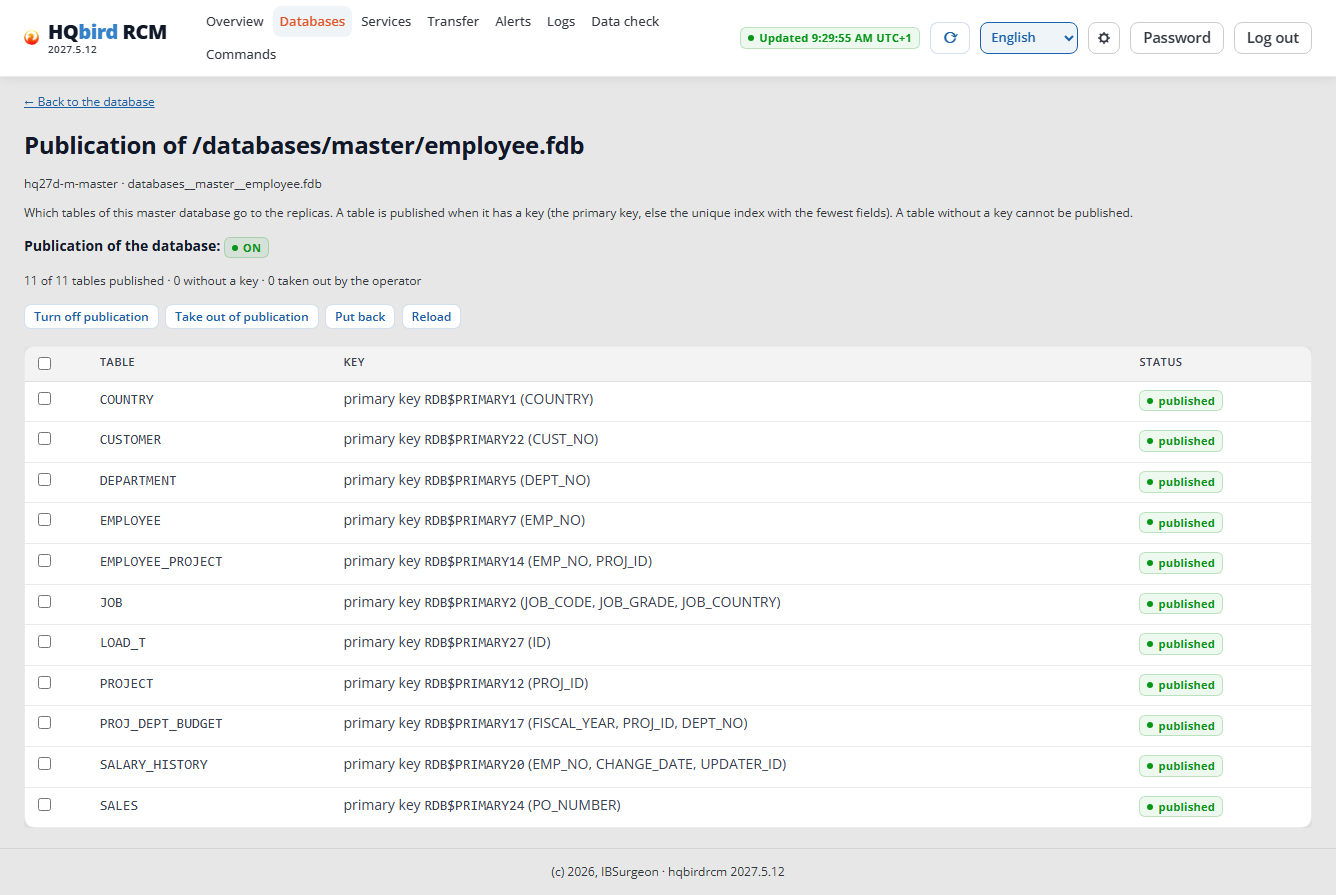
Publicación posterior. Necesita el botón Sync publication de una base de datos maestra cuando aparecen nuevas tablas en la base de datos. Hace que la publicación coincida con las tablas en una sola transacción; Firebird no se reinicia.
Publication tables muestra qué tablas se replican. No puede publicar una tabla sin una clave: asígnele una clave primaria.
Paso 7. Reinitialization
Lo necesita cuando la réplica difiere del maestro, o cuando el nodo lo solicita
(NEEDS_REINIT). En la fila de la réplica → Reinit, método
Smooth. Ya hay un archivo de segmentos, y el método smooth funciona
bajo carga. Espera a las transacciones de escritura que son más antiguas que el
historial del journal, y las muestra.
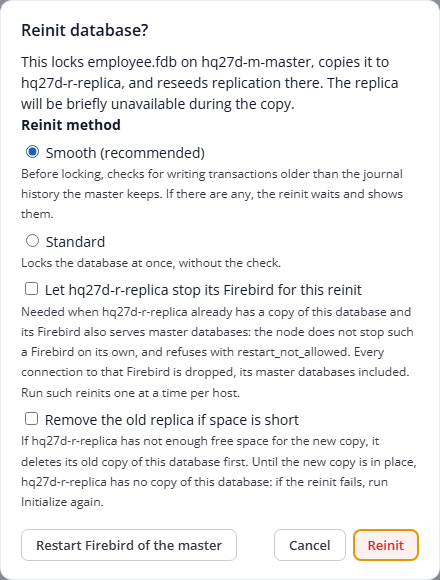
El progreso es el mismo que en la inicialización. Un reinit normalmente no
necesita un reinicio de Firebird de la réplica. En la ejecución del 2026-11-17 el
reinit de employee.fdb sí reinició Firebird de la réplica: prevea una
interrupción de las conexiones a la réplica. Ese reinit tomó 4 segundos en el
maestro bajo ≈49 transacciones/s; después de que se detuvieran las escrituras, los recuentos de filas
coincidieron (14.418 filas en la tabla de carga en ambos lados).
Mediciones de la ejecución:
| Base de datos | Carga | Tiempo | Bloqueo | Otro |
|---|---|---|---|---|
employee.fdb |
≈55 transacciones/s | 1,7 s | 0,32 s | 417 transacciones reproducidas desde los segmentos |
bulk.fdb |
ninguna | 61 s | 55 s | sin reinicio de Firebird de la réplica |
Después de un reinit smooth bajo carga, la réplica puede mostrar la alerta info
replication_conflict_resolved (“Record being inserted … already exists,
updating instead”): la réplica reprodujo transacciones que ya estaban en
la copia. Los datos coinciden: en la ejecución, los recuentos de filas de todas las tablas coincidieron.
Puede reconocer la alerta (hallazgo G-07 en el informe).
Paso 8. Poco espacio en disco en la réplica
El volumen de la réplica necesita ≥ 105 % del tamaño de la base de datos más 1 GB por encima de la copia antigua: la copia antigua permanece hasta el final, y el nuevo archivo toma su tamaño completo de una vez. Si el espacio es escaso, el diálogo muestra cuánto espacio se necesita, cuánto está libre y cuánto ocupa la copia antigua (una estimación del RCM; el nodo de la réplica decide). Si el espacio es suficiente sin la copia antigua, el diálogo sugiere la casilla Remove the old replica if space is short.
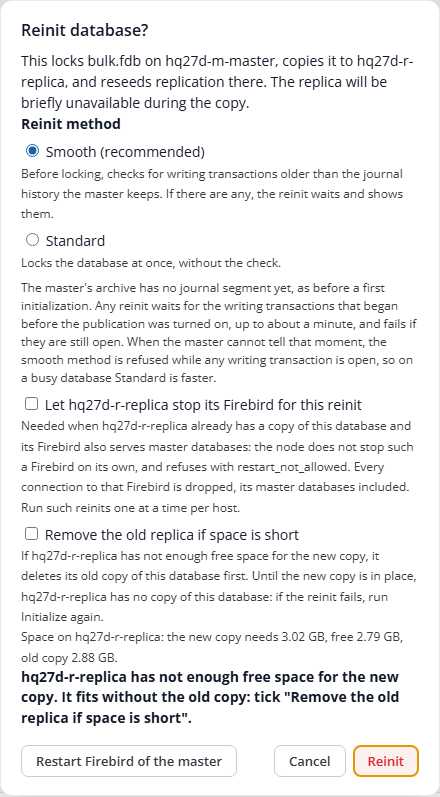
Con la casilla, el nodo de la réplica, después del bloqueo en el maestro, detiene
Firebird de la réplica, elimina la copia antigua y vuelve a iniciar Firebird.
En la ejecución (2,97 GB libres, la nueva copia necesita 3,29 GB, la copia antigua es
de 3,13 GB), el reinit de bulk.fdb con la casilla tomó 65 segundos. Sin
la casilla, el nodo se niega con insufficient disk space on replica.
El diálogo puede no mostrar números cuando solo falta el mínimo de 1 GB. En la
ejecución del 2026-11-17 (1,1 GB libres, la base de datos es de 167 MB) el diálogo no mostró
ninguna estimación, y el reinit sin la casilla falló en 3 segundos. La
fila de la base de datos y la página Commands mostraron el motivo: insufficient disk space on replica: need 184125850 bytes (105% of the database) + 1073741824 bytes free_space_floor_gb; free 1152950272 … Removing the old replica copy would free 175357952 bytes: ask again with remove_old_replica. El mismo reinit con la casilla tomó 9 segundos.
Riesgo de la casilla. Mientras se ejecuta la copia, no hay réplica de esta base de datos. Si el reinit falla, el par queda en
NEEDS_REINIT, la réplica tiene la alertareplica_removed_for_reinit(warn), y un reintento es un nuevo reinit completo. Un reinit automático elimina la copia antigua solo si la clave del RCMauto_reinit.remove_old_replica_when_shortestá activada (desactivada por defecto).
Paso 9. Verification
Verify en la fila de la réplica compara COUNT(*) de las tablas de seguimiento en
el maestro y en la réplica. No compara las filas en sí. La
línea “Table list source” nombra la lista: la lista propia de la base de datos, la
lista del nodo, las tablas de la publicación, o RDB$FIELDS. Los recuentos de filas tienen
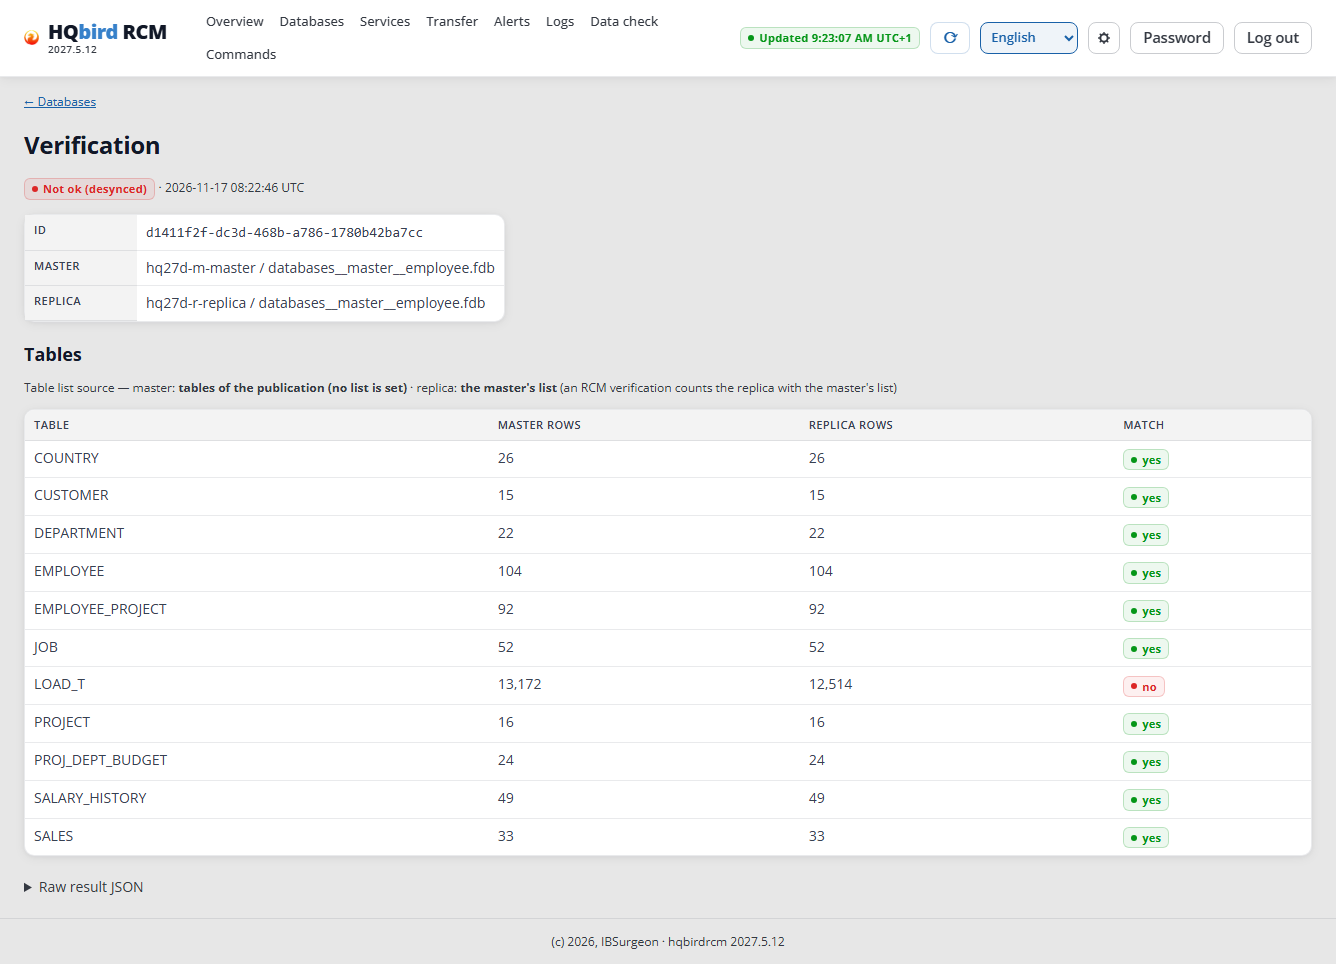
grupos de dígitos.
Bajo carga, la réplica va unos segundos por detrás, y Verify da “Not ok” para las tablas en las que se está escribiendo:
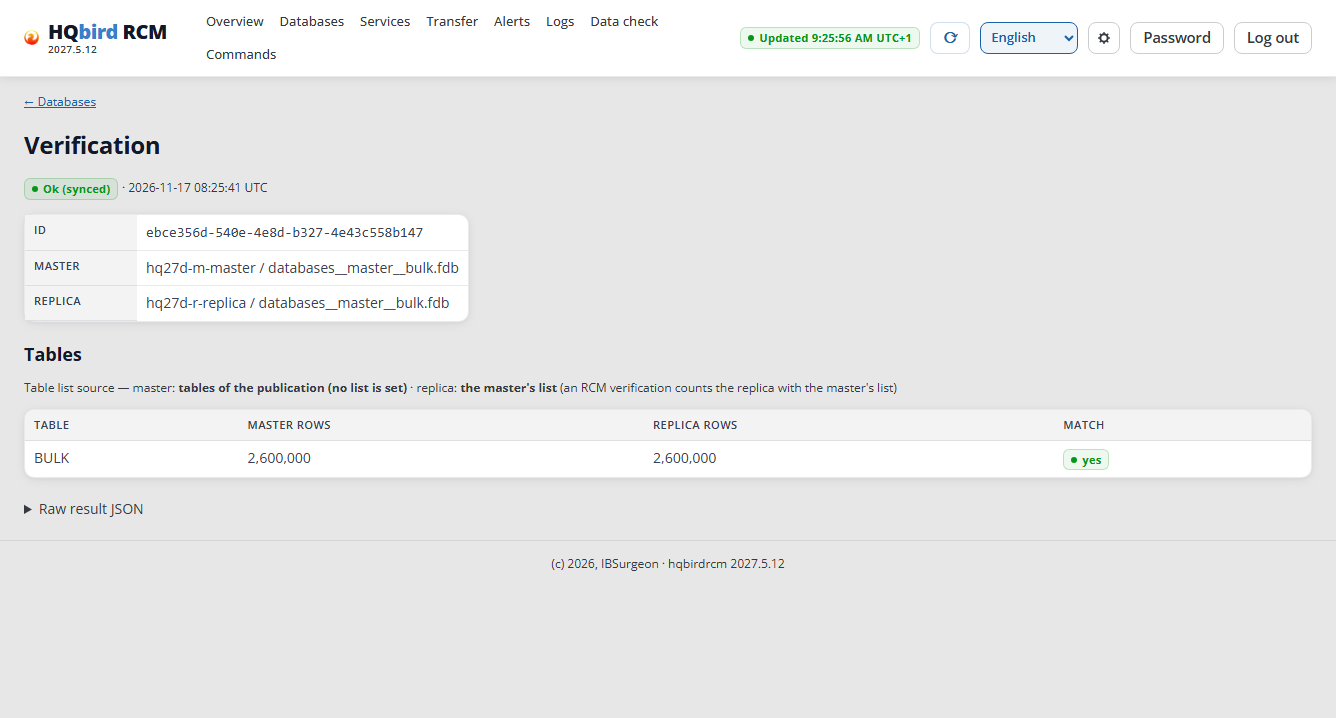
Sin escrituras, los recuentos coinciden:
Una tabla que no está en ninguna de las dos bases de datos es “not in the database”: esto no es una discrepancia. Una tabla en un solo lado es “no table”: esto es una discrepancia.
Una comprobación más segura es el recuento de filas de todas las tablas en ambos lados después de que
se detengan las escrituras (el script está en el
hqbird2027-linux-cluster-runbook.md). En la
ejecución, las 11 tablas coincidieron (employee.fdb: 10, bulk.fdb: 1, con
2.800.000 filas).
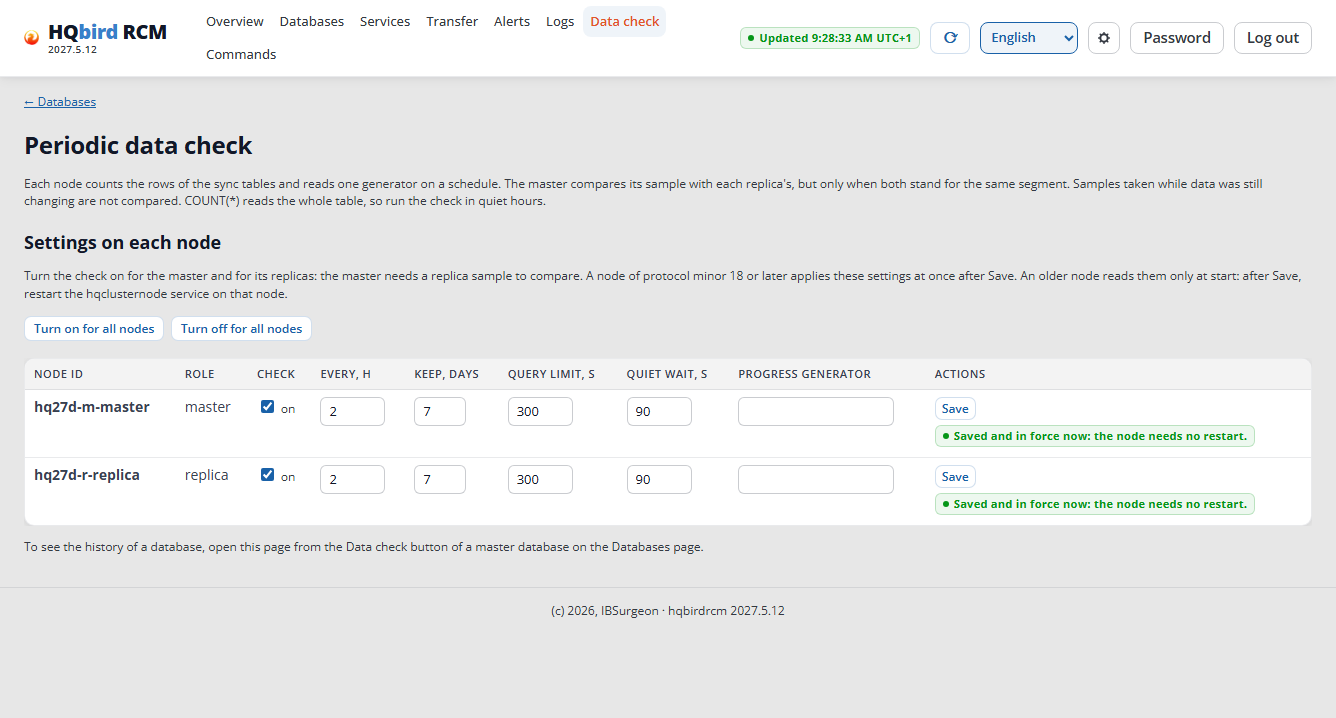
La comprobación periódica (Data check) está desactivada por defecto. Haga clic en Turn on for all nodes y confirme: cada nodo cuenta sus filas, y el maestro compara los recuentos. No necesita un reinicio: el RCM muestra “Saved and in force now: the node needs no restart.” La primera comprobación se ejecuta un intervalo después (por defecto 2 horas).
Qué observar a continuación
-
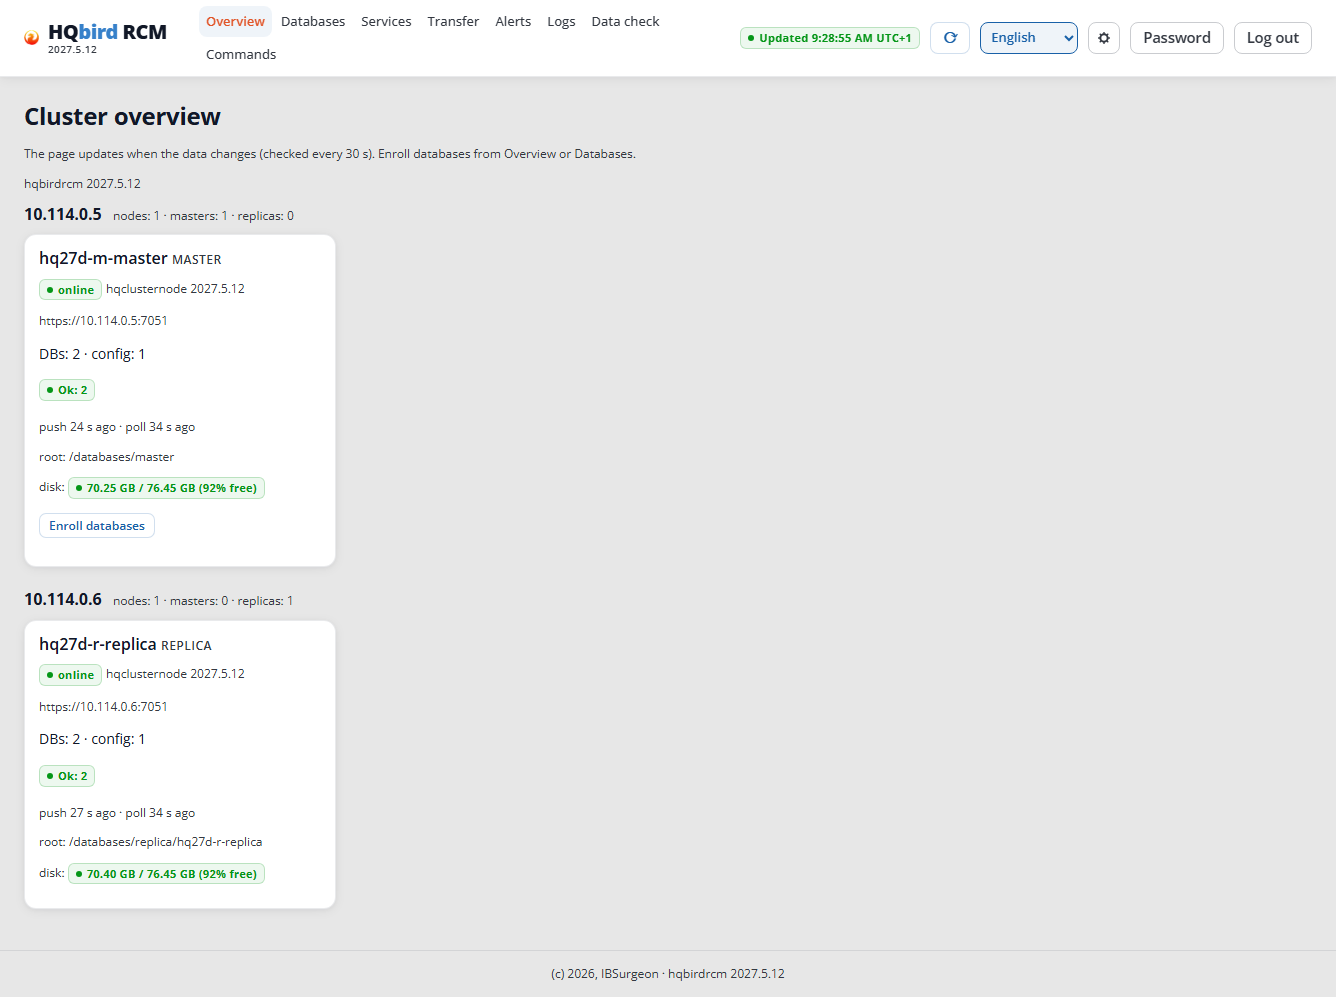
Overview: los nodos, su estado, la raíz de la base de datos y el espacio en disco.
Overview -
Alerts: problemas de nodos y bases de datos. La ejecución tuvo dos alertas, y puede reconocer ambas:
replication_conflict_resolveddespués del reinit smooth (paso 7), yparse_no_observationsen el maestro (“no events parsed from /opt/firebird/replication.log”). Firebird del maestro escribe solo errores enreplication.log, así que un log vacío es normal (hallazgo G-06 en el informe).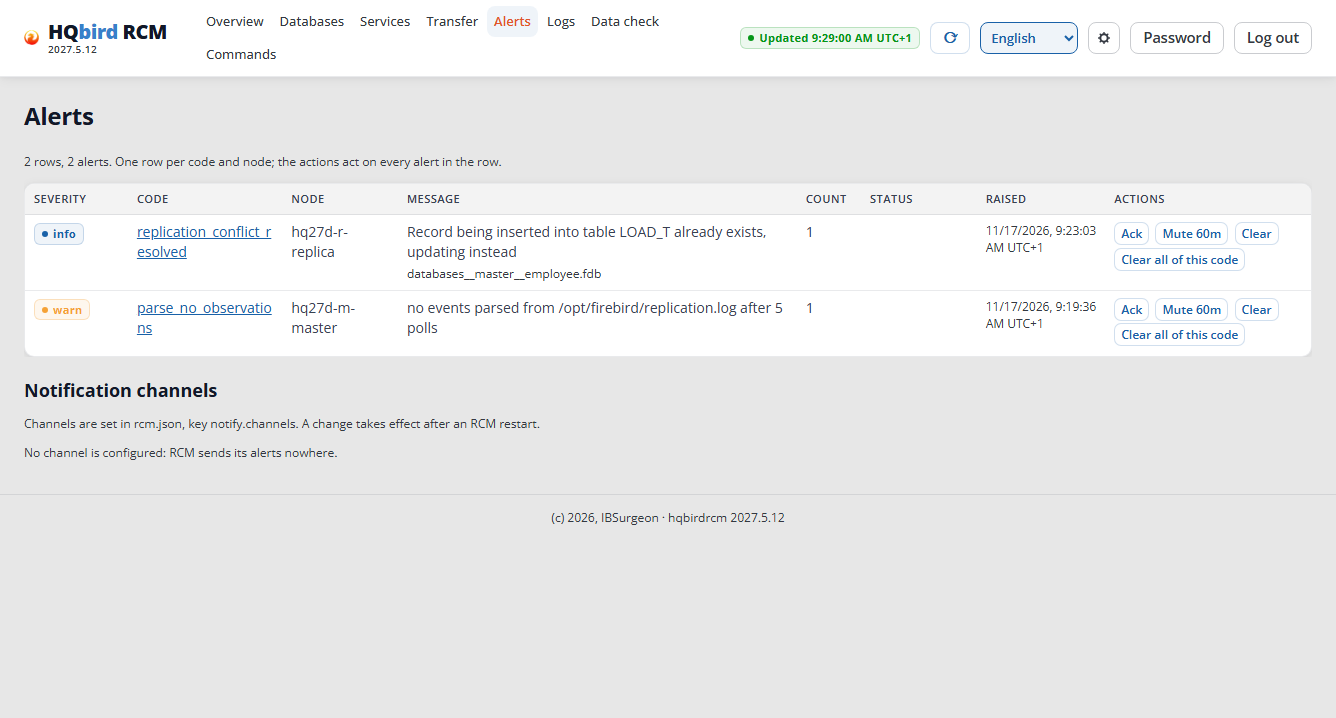
Alerts RCM 2027.5.12 y posteriores (kit 2027.2.33) pueden enviar las alertas de gravedad
warny superior a un bot de Telegram propio, un webhook o correo electrónico. Usted configura los canales en el archivo/opt/hqbirdrcm/rcm.json, clavenotify.channels, y reinicia el RCM (sudo systemctl restart hqbirdrcm). El bloque Notification channels de esta página entonces lista los canales, cada uno con un botón Send test. Sin ningún canal dice “No channel is configured: RCM sends its alerts nowhere.” Un canal de Telegram:"notify": { "channels": [ { "name": "ops", "type": "telegram", "token_file": "secrets/telegram-ops.token", "chat_id": "-1001234567890" } ] }La ejecución del 2026-11-17 comprobó el bloque sin ningún canal; no se envió ningún mensaje.
-
Services (RCM 2027.5.11 y posteriores, kits desde 2027.2.31): el maestro, las réplicas y los routers de un servicio, y las operaciones switchover, failover y rejoin. Esta guía no las cubre: consulte la guía de usuario del RCM. Actualice el RCM y los nodos a la misma versión antes de usarlas.
-
Commands: cada operación del RCM con su resultado. La hora es la hora local del navegador con su zona (por ejemplo,
17:59:45 UTC+1); la información emergente muestra la hora en UTC. Los logs de los nodos usan UTC.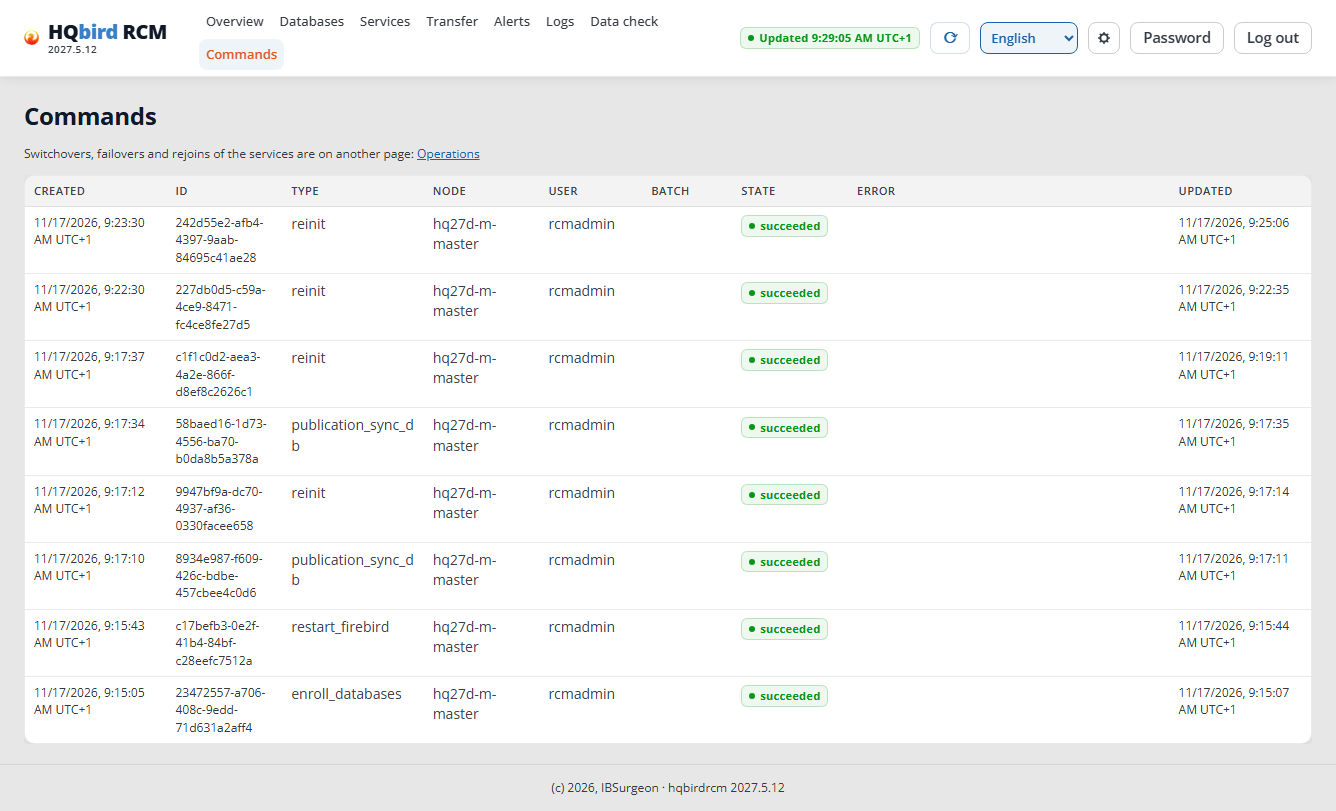
Commands -
HQ Monitor:
http://<server>:23050/, usuarioadmin, la contraseña está en/opt/hqbird/conf/access.properties. Muestra el servidor y las bases de datos. En los kits con agente 3.1.0 y posteriores, HQ Monitor tiene la página Clusters. En el maestro (el host del RCM) muestra el clúster a través del agente, sin ajustes del RCM en HQ Monitor. En la réplica nombra el host del RCM y enlaza a su consola. HQ Monitor 1.49.0 no tiene estado de replicación ni enlace al RCM. Desde el kit 2027.2.33 (agente 3.4.0) el agente envía los problemas de su servidor también a sus canales: Servers → Notifications.
Actualizar el clúster
Actualice primero HQbird RCM, luego los nodos. Desde el kit 2027.2.31, un servidor que no está adjunto a ningún HQCenter actualiza el agente, HQ Monitor y fbmcp por sí mismo (“Updates without HQCenter” en hqbird2027-linux-setup-guide.md); un servidor adjunto a un HQCenter toma sus actualizaciones de ese HQCenter.
Sacar un host del clúster
cd /opt/hqbird/fbagent-fb50
sudo ./fbagent --cluster-leave
El agente se detiene y desregistra sus servicios de nodo, cierra sus puertos de nodo,
elimina sus certificados de clúster y establece cluster.source en none. La carpeta
del nodo permanece (--remove-data la elimina). El agente que ejecuta el RCM es
rechazado. El agente también se va por sí mismo cuando el RCM lo revoca o le quita su último
miembro. Una desinstalación siempre abandona el clúster: una reinstalación en la misma
carpeta comienza libre. En la ejecución del 2026-11-17 el comando imprimió Cluster: left <cluster id>, las bases de datos de la réplica permanecieron en su carpeta, y el RCM
seguía mostrando el nodo de ese host un minuto después. La eliminación de HQbird
de un servidor del clúster, también del
servidor que ejecuta el RCM:
hqbird2027-removal-guide.md, sección 4.
Errores comunes
| Lo que ve | Causa | Qué hacer |
|---|---|---|
publication_off en la inicialización |
la publicación está desactivada, o no tiene ninguna tabla aunque la base de datos tiene tablas con una clave | el botón Sync publication and initialize (paso 6) |
long_transactions … the archive holds no segment yet |
primera inicialización con el método smooth mientras se está escribiendo en la base de datos, y el archivo del maestro está vacío | espere a “archive: 1 seg” y reintente Smooth, o elija Standard |
reinit_pre_publication_transactions |
una transacción de escritura comenzó antes de que se activara la publicación y está abierta más de un minuto | termínela (COMMIT o ROLLBACK) y reintente |
| “✗ The folder does not exist on …” en el diálogo | nadie creó la carpeta de la réplica | el botón Create folder en el diálogo, o install -d -o firebird -g firebird -m 0770 <folder> en la réplica |
| “Not ok (desynced)” en Verify | se está escribiendo en la base de datos, y la réplica va segundos por detrás | reintente sin carga; mire la columna Match |
| “Not ok (desynced)” en Verify sin escrituras; ambos lados muestran “Ok” | se abrió una conexión de aplicación antes de que se activara la publicación: no está registrada en el journal | reconecte la aplicación, luego Reinit (paso 6, la nota sobre la primera sincronización de la publicación) |
| Host “unreachable” o “no agent” en Link hosts | la ventana de emparejamiento del host está cerrada (desactivada por defecto, o las 24 h terminaron), o un firewall entre los servidores cierra 7450–7459 | abra la ventana en el host: HQ Monitor → Clusters → Open the pairing window for 24 hours, o fbagent --cluster-pairing on; abra el puerto en el firewall de la nube |
| insufficient disk space on replica en una reinicialización | la réplica antigua permanece hasta el final, y el nuevo archivo ocupa su tamaño completo | libere ≥ 105 % del tamaño de la base de datos + 1 GB por encima del archivo antiguo en el volumen de la réplica, o la casilla Remove the old replica if space is short (paso 8) |
| El nodo no aparece después de Link hosts | el espejo RCM no tiene una versión firmada de hqclusternode | Releases in the mirror en la página Link hosts (paso 2) |